
شبکه عصبی مصنوعی چیست؟ آموزش ANN، پرسپترون و MLP باPyTorch
شبکه عصبی مصنوعی چیست و چگونه یاد میگیرد؟ در این راهنما، نورون، لایه پنهان، تابع فعالسازی و پسانتشار را میشناسید و یک شبکه MLP را با PyTorch برای طبقهبندی داده میسازید و ارزیابی میکنید.

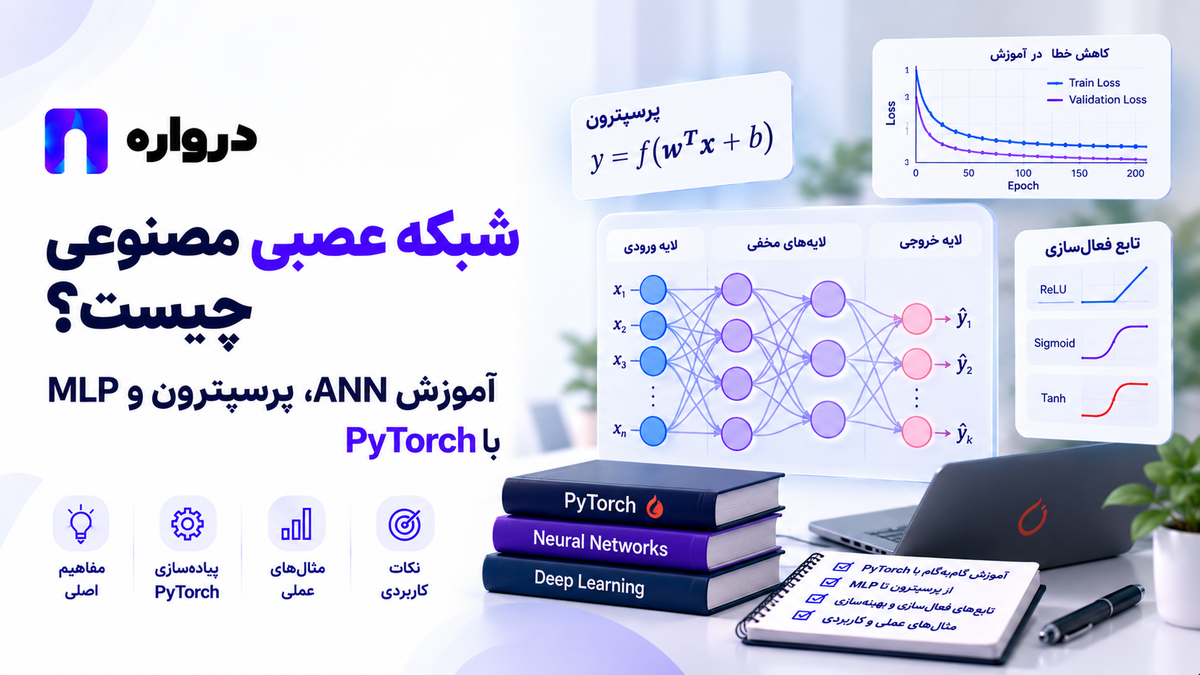
شبکه عصبی مصنوعی یا Artificial Neural Network مدلی است که از مجموعهای از واحدهای محاسباتی و ارتباطهای قابلآموزش میان آنها ساخته میشود. این واحدها در لایههایی قرار میگیرند و داده را مرحلهبهمرحله پردازش میکنند.
برای مثال، اگر بخواهیم بر اساس چند ویژگی عددی پیشبینی کنیم یک نمونه به کدام گروه تعلق دارد، شبکه ابتدا ویژگیها را دریافت میکند. لایههای میانی ترکیبهای تازهای از آنها میسازند و لایه آخر نتیجه را تولید میکند. هنگام آموزش، مدل خروجی خود را با پاسخ درست مقایسه میکند و پارامترهایش را تغییر میدهد تا خطا کاهش یابد.
شبکه عصبی مصنوعی پایه بسیاری از معماریهای شناختهشده است، از جمله:
- شبکههای کانولوشنی یا CNN برای بسیاری از مسائل تصویری
- شبکههای بازگشتی مانند RNN و LSTM برای دادههای ترتیبی
- خودرمزگذارها یا Autoencoder برای یادگیری بازنمایی
- مدلهای مبتنی بر Transformer برای پردازش متن و دیگر دادهها
در این مقاله، ابتدا مفاهیم اصلی را بدون فرمول ریاضی توضیح میدهیم. سپس یک شبکه MLP را با PyTorch آموزش میدهیم، نتیجه آن را با یک مدل خطی مقایسه میکنیم و روش ارزیابی درست را بررسی میکنیم.
شبکه عصبی مصنوعی چیست؟
شبکه عصبی مصنوعی مدلی شامل لایههایی از واحدهای محاسباتی است. هر لایه خروجی لایه قبل را دریافت میکند و آن را به نمایش تازهای تبدیل میکند.
یک شبکه ساده میتواند این ساختار را داشته باشد:
ویژگیهای ورودی
↓
لایه پنهان اول
↓
لایه پنهان دوم
↓
لایه خروجی
↓
پیشبینیمقدار ارتباطها میان واحدها با پارامترهایی به نام وزن تعیین میشود. مدل در جریان آموزش وزنها را تنظیم میکند. معمولاً هر واحد یک بایاس نیز دارد که به انعطافپذیری تبدیل کمک میکند.
وقتی تعداد لایههای میانی افزایش پیدا میکند، مدل میتواند بازنماییهای چندمرحلهای پیچیدهتری بسازد. بااینحال، عمیقتر یا بزرگتر کردن شبکه بهتنهایی کیفیت بهتر را تضمین نمیکند؛ اندازه داده، تعریف مسئله و روش ارزیابی اهمیت زیادی دارند.
مستندات PyTorch شبکه عصبی را مجموعهای از لایهها و ماژولهایی معرفی میکند که عملیات را به ترتیب روی داده انجام میدهند. PyTorch Tutorials 2.14.0+cu130 documentation
نورون مصنوعی چگونه کار میکند؟
یک نورون مصنوعی چند مقدار را از ورودی دریافت میکند. هر مقدار با وزن مربوط به خود ترکیب میشود، بایاس به نتیجه افزوده میشود و سپس معمولاً یک تابع فعالسازی روی آن اعمال میشود.
میتوان نقش اجزا را اینگونه فهمید:
| جزء | نقش |
|---|---|
| ورودی | ویژگیهای نمونه یا خروجی لایه قبل |
| وزن | تعیین میزان اثر هر ورودی |
| بایاس | جابهجا کردن پاسخ واحد محاسباتی |
| تابع فعالسازی | ایجاد رفتار غیرخطی یا تبدیل خروجی |
| خروجی | مقداری که به لایه بعد منتقل میشود |
تشبیه نورون مصنوعی به نورون زیستی فقط برای فهم اولیه مفید است. یک واحد در شبکه عصبی، شبیهسازی کامل عملکرد مغز یا سلول عصبی واقعی نیست.
لایههای شبکه عصبی چه تفاوتی دارند؟
لایه ورودی
لایه ورودی ویژگیهای نمونه را به مدل میرساند. اگر هر نمونه دو ویژگی عددی داشته باشد، ورودی مدل نیز دو مقدار میگیرد. اگر یک رکورد ۳۰ ویژگی داشته باشد، شکل ورودی باید با همان تعداد هماهنگ باشد.
نام «لایه ورودی» معمولاً برای اشاره به شکل دادهای به کار میرود که به نخستین لایه محاسباتی داده میشود؛ لزوماً به معنی وجود یک لایه قابلآموزش جداگانه نیست.
لایههای پنهان
لایه پنهان میان ورودی و خروجی قرار دارد. این لایهها ترکیبهای تازهای از ویژگیها میسازند.
برای مثال، در داده دوبعدی ممکن است یک لایه الگویی مربوط به ناحیهای از صفحه را بیاموزد و لایه بعدی از ترکیب چند الگو برای تشخیص کلاس استفاده کند. این توصیف، تصویری شهودی از فرایند است؛ هر نورون الزاماً یک مفهوم انسانی مشخص و قابلنامگذاری را نمایش نمیدهد.
لایه خروجی
شکل لایه خروجی به مسئله بستگی دارد:
- رگرسیون: یک یا چند مقدار پیوسته
- طبقهبندی دودویی: معمولاً یک مقدار خام برای تمایز دو کلاس
- طبقهبندی چندکلاسه: معمولاً یک مقدار خام برای هر کلاس
- طبقهبندی چندبرچسبی: یک خروجی مستقل برای هر برچسب
در نمونه عملی این مقاله، مسئله دودویی است. بنابراین شبکه یک مقدار خام تولید میکند. سپس هنگام ارزیابی، آن مقدار را به نمرهای بین صفر و یک تبدیل میکنیم.
پرسپترون چیست؟
پرسپترون یکی از مدلهای اولیه شبکه عصبی است. در سادهترین شکل، ویژگیهای ورودی را دریافت میکند و بر اساس وزنهای آموختهشده یک تصمیم دودویی میگیرد.
یک پرسپترون ساده مرز تصمیم خطی میسازد. بنابراین برای مسئلهای که جداسازی کلاسهای آن به مرز پیچیده نیاز دارد، ممکن است کافی نباشد.
وقتی چند لایه از واحدهای محاسباتی را همراه با تابع فعالسازی غیرخطی کنار هم قرار دهیم، به مدلی میرسیم که میتواند مرزهای پیچیدهتری یاد بگیرد. یکی از شکلهای رایج آن پرسپترون چندلایه است.
MLPچیست؟
MLP مخفف Multi-Layer Perceptron یا «پرسپترون چندلایه» است. این شبکه معمولاً از چند لایه کاملاً متصل تشکیل میشود؛ یعنی هر واحد یک لایه میتواند به خروجیهای لایه قبل متصل باشد.
در PyTorch میتوان یک MLP ساده را با nn.Linear و تابع فعالسازی ساخت:
from torch import nnmodel = nn.Sequential( nn.Linear(2, 32), nn.ReLU(), nn.Linear(32, 16), nn.ReLU(), nn.Linear(16, 1),)این شبکه دو ویژگی دریافت میکند، آنها را از دو لایه پنهان عبور میدهد و در پایان یک خروجی خام تولید میکند. مستندات رسمی PyTorch از nn.Sequential برای قرار دادن ماژولها در یک زنجیره مرتب استفاده میکند. PyTorch Tutorials 2.14.0+cu130 documentation
آیا هر شبکه عصبی یک MLP است؟
خیر. MLP تنها یکی از معماریهای شبکه عصبی است. معماریهای دیگر، ساختار خود را با نوع داده و هدف پردازش هماهنگ میکنند:
| معماری | ویژگی اصلی | نمونه کاربرد |
|---|---|---|
| MLP | لایههای کاملاً متصل | داده عددی، مسئلههای ساده طبقهبندی |
| CNN | پردازش الگوهای مکانی با لایه کانولوشنی | تصویر |
| RNN و LSTM | پردازش ترتیبی | برخی دادههای زمانی و متنی |
| Transformer | سازوکار توجه برای ارتباط میان بخشهای ورودی | متن و کاربردهای چندوجهی |
| Autoencoder | رمزگذاری و بازسازی ورودی | یادگیری بازنمایی و تشخیص ناهنجاری |
برای آشنایی با معماریهای پیشرفتهتر، مقالات CNN، RNN و LSTM و Transformer را ببینید.
چرا شبکه به تابع فعالسازی نیاز دارد؟
اگر چند لایه تنها تبدیلهای خطی را پشت سر هم انجام دهند، ترکیب آنها همچنان یک تبدیل خطی خواهد بود. اضافه کردن تعداد زیادی از چنین لایههایی، بهتنهایی توان مدل را برای ساخت مرز تصمیم غیرخطی ایجاد نمیکند.
تابع فعالسازی غیرخطی این محدودیت را تغییر میدهد. چند تابع رایج عبارتاند از:
ReLU
تابع ReLU مقادیر منفی را صفر میکند و مقادیر مثبت را عبور میدهد. استفاده از آن در لایههای پنهان رایج است. در مثال عملی مقاله، از ReLU استفاده میکنیم.
Sigmoid
تابع Sigmoid یک مقدار را به بازه بین صفر و یک تبدیل میکند. برای نمایش خروجی یک طبقهبند دودویی مناسب است، اما در نمونه آموزشی ما آن را داخل لایه آخر مدل قرار نمیدهیم؛ دلیل این تصمیم به تابع خطا مربوط است.
Tanh
خروجی Tanh میان منفی یک و مثبت یک قرار میگیرد. این تابع در برخی معماریها و تنظیمات آموزش کاربرد دارد.
Softmax
Softmax چند مقدار خام خروجی را به نمرههایی تبدیل میکند که مجموع آنها یک میشود. معمولاً برای نمایش خروجی طبقهبندی چندکلاسه استفاده میشود.
| تابع | استفاده رایج در این بحث | نکته |
|---|---|---|
| ReLU | لایههای پنهان | ساده و پرکاربرد |
| Sigmoid | نمایش خروجی دودویی | برای محاسبه نمره پس از خروجی خام |
| Tanh | برخی لایههای پنهان | خروجی مثبت و منفی |
| Softmax | نمایش خروجی چندکلاسه | برای چند کلاس انحصاری |
انتخاب تابع فعالسازی باید با معماری، نوع خروجی و تابع خطا هماهنگ باشد.
شبکه عصبی چگونه یاد میگیرد؟
آموزش معمولاً در یک چرخه تکراری انجام میشود:
- تعدادی نمونه به شبکه داده میشود.
- شبکه برای هر نمونه خروجی تولید میکند.
- تابع خطا اختلاف خروجی و پاسخ درست را اندازه میگیرد.
- پسانتشار اثر پارامترها بر خطا را محاسبه میکند.
- بهینهساز وزنها و بایاسها را بهروزرسانی میکند.
- همین روند با دستههای بعدی داده تکرار میشود.
در PyTorch، سامانه autograd محاسبه گرادیانهای لازم برای پسانتشار را انجام میدهد. سپس بهینهساز از گرادیانها برای تغییر پارامترها استفاده میکند. PyTorch Tutorials 2.14.0+cu130 documentation
Forward Passچیست؟
عبور رو به جلو مرحلهای است که داده از ورودی تا خروجی شبکه حرکت میکند و پیشبینی ساخته میشود.
Lossچیست؟
Loss یا تابع خطا عددی است که نشان میدهد خروجی مدل تا چه اندازه با هدف آموزش اختلاف دارد. پایین آمدن Loss روی داده آموزش مفید است، اما بهتنهایی ثابت نمیکند مدل روی داده جدید نیز خوب کار میکند.
Backpropagationچیست؟
Backpropagation یا پسانتشار، مسیر اثر پارامترها بر خطا را در شبکه محاسبه میکند. در کد PyTorch معمولاً با loss.backward() گرادیانها محاسبه میشوند.
Optimizerچیست؟
بهینهساز از گرادیانها استفاده میکند تا پارامترهای مدل تغییر کنند. در مثال ما از AdamW استفاده میشود. مقدار نرخ یادگیری و دیگر تنظیمات بهینهساز باید در جریان آزمایش انتخاب شوند.
شبکه عصبی چه تفاوتی با رگرسیون لجستیک دارد؟
رگرسیون لجستیک یک خط مبنای مهم برای طبقهبندی دودویی است. این مدل، با ویژگیهای اولیه داده، مرز تصمیم خطی میسازد. MLP با لایههای پنهان و فعالساز غیرخطی میتواند مرز پیچیدهتری یاد بگیرد.
| معیار | رگرسیون لجستیک | MLP |
|---|---|---|
| مرز تصمیم بر اساس ویژگیهای اولیه | خطی | میتواند غیرخطی باشد |
| تعداد تنظیمات معماری | کم | بیشتر |
| زمان و پیچیدگی آموزش | معمولاً کمتر | معمولاً بیشتر |
| مناسب برای خط مبنا | بسیار مناسب | مدل مرحله بعد |
| خطر بیشبرازش با افزایش ظرفیت | وجود دارد | میتواند بیشتر شود |
| نیاز به مقایسه روی داده آزمون | بله | بله |
این جدول به معنی برتری همیشگی MLP نیست. در داده جدولی کوچک یا مسئلهای با مرز تقریباً خطی، مدل سادهتر ممکن است عملکردی مشابه یا بهتر داشته باشد. در نمونه عملی، هر دو مدل را روی همان تقسیم داده مقایسه میکنیم.
آموزش عملی شبکه عصبی باPyTorch
برای دیدن اثر تابع فعالسازی و لایه پنهان، از داده مصنوعی make_moons استفاده میکنیم. این داده شامل دو گروه با شکل خمیده است و یک مثال آموزشی مناسب برای مقایسه مرز تصمیم خطی و غیرخطی فراهم میکند. تابع make_moons در scikit-learn برای ساخت چنین داده دوبعدی همراه با نویز قابلتنظیم ارائه شده است. scikit-learn 1.10.dev0 documentation
محدودیت مهم: موفقیت روی داده مصنوعی، عملکرد خوب روی داده واقعی شرکت را ثابت نمیکند. هدف این مثال، فهم جریان آموزش و ارزیابی است.
نصب کتابخانهها
python -m pip install torch scikit-learn numpy matplotlibبرای نصب PyTorch متناسب با سیستمعامل و نوع شتابدهنده، میتوانید از صفحه نصب رسمیPyTorch استفاده کنید. pytorch.org
مرحله اول: ساخت و تقسیم داده
ابتدا داده را به سه بخش آموزش، اعتبارسنجی و آزمون تقسیم میکنیم. مجموعه اعتبارسنجی برای انتخاب بهترین مرحله آموزش است؛ مجموعه آزمون را تا پایان این انتخاب کنار میگذاریم.
import numpy as npimport torchfrom sklearn.datasets import make_moonsfrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScalerSEED = 42np.random.seed(SEED)torch.manual_seed(SEED)X, y = make_moons( n_samples=3000, noise=0.25, random_state=SEED,)X = X.astype(np.float32)y = y.astype(np.float32)# ابتدا مجموعه آزمون مستقل جدا میشود.X_development, X_test, y_development, y_test = ( train_test_split( X, y, test_size=0.20, stratify=y, random_state=SEED, ))# داده باقیمانده به آموزش و اعتبارسنجی تقسیم میشود.X_train, X_validation, y_train, y_validation = ( train_test_split(در این تقسیم، ۶۰ درصد کل نمونهها برای آموزش، ۲۰ درصد برای اعتبارسنجی و ۲۰ درصد برای آزمون کنار گذاشته میشوند.
چرا scaler.fit فقط روی آموزش اجرا شد؟ اگر میانگین و پراکندگی ویژگیها را از کل داده، از جمله آزمون، محاسبه کنیم، اطلاعات مجموعه آزمون وارد آمادهسازی مدل میشود. مستندات scikit-learn تأکید میکند که تبدیلهایی از این نوع باید از داده آموزش یاد گرفته شوند و سپس روی اعتبارسنجی و آزمون اعمال شوند. scikit-learn 1.5.2 documentation
مرحله دوم: ساختDataLoader
PyTorchبا Dataset نمونهها را نگه میدارد و با DataLoader آنها را در دستههای قابلپردازش به حلقه آموزش میرساند. PyTorch Tutorials 2.14.0+cu130 documentation
from torch.utils.data import ( DataLoader, TensorDataset,)train_dataset = TensorDataset( torch.from_numpy(X_train), torch.from_numpy(y_train).unsqueeze(1),)train_loader = DataLoader( train_dataset, batch_size=64, shuffle=True,)هدفها را به شکل یک ستون درآوردهایم تا شکل آنها با خروجی مدل سازگار باشد.
مرحله سوم: ساختMLP
from torch import nndevice = torch.device( "cuda" if torch.cuda.is_available() else "cpu")model = nn.Sequential( nn.Linear(2, 32), nn.ReLU(), nn.Linear(32, 16), nn.ReLU(), nn.Linear(16, 1),).to(device)print(model)print("Device:", device)دو ویژگی ورودی داریم. لایههای پنهان بهترتیب ۳۲ و ۱۶ خروجی دارند و لایه آخر یک مقدار خام تولید میکند.
در لایه آخر Sigmoid نگذاشتهایم. تابع خطای BCEWithLogitsLoss تبدیل لازم برای آموزش طبقهبندی دودویی را در خود دارد و از نظر عددی از اجرای جداگانه Sigmoid و سپس BCELoss پایدارتر است. برای نمایش نمره در مرحله پیشبینی، Sigmoid را جداگانه روی خروجی مدل اعمال میکنیم. PyTorch main documentation
مرحله چهارم: تعریف تابع خطا و بهینهساز
criterion = nn.BCEWithLogitsLoss()optimizer = torch.optim.AdamW( model.parameters(), lr=0.001, weight_decay=0.0001,)نرخ یادگیری و weight_decay این مثال، تنظیمات آغازین آموزشی هستند. برای داده واقعی باید اثر آنها را با مجموعه اعتبارسنجی بررسی کنید.
مرحله پنجم: آموزش همراه با اعتبارسنجی
کد زیر بهترین وضعیت مدل را بر اساس Lossاعتبارسنجی نگه میدارد. اگر نتیجه چند دوره پیاپی بهتر نشود، آموزش متوقف میشود.
import copyX_validation_tensor = torch.from_numpy( X_validation).to(device)y_validation_tensor = torch.from_numpy( y_validation).unsqueeze(1).to(device)MAX_EPOCHS = 200PATIENCE = 20best_validation_loss = float("inf")best_model_state = Noneepochs_without_improvement = 0train_losses = []validation_losses = []for epoch in range(MAX_EPOCHS): model.train() total_train_loss = 0.0 total_train_samples = 0 for batch_features, batch_targets in train_loader: batch_features = batch_features.to(device) batch_targets = batch_targets.to(device) optimizer.zero_grad() logits = model(batch_features) loss = criterion(logits, batch_targets)در هر دسته، optimizer.zero_grad() گرادیانهای گام قبلی را پاک میکند، loss.backward() گرادیانهای جدید را محاسبه میکند و optimizer.step() پارامترها را تغییر میدهد. این ترتیب با گردش کار آموزش در مستندات PyTorch هماهنگ است. PyTorch Tutorials 2.14.0+cu130 documentation
نمودار Loss چه چیزی نشان میدهد؟
میتوان روند خطای آموزش و اعتبارسنجی را کنار هم دید:
import matplotlib.pyplot as pltplt.figure(figsize=(8, 4))plt.plot( train_losses, label="Train loss",)plt.plot( validation_losses, label="Validation loss",)plt.xlabel("Epoch")plt.ylabel("Loss")plt.legend()plt.tight_layout()plt.show()چند الگوی رایج:
- اگر هر دو خطا بالا بمانند، مدل شاید الگوی کافی یاد نگرفته باشد یا تنظیمات آموزش مناسب نباشند.
- اگر خطای آموزش پایین برود ولی خطای اعتبارسنجی پس از مدتی بالا برود، احتمال بیشبرازش وجود دارد.
- اگر هر دو کاهش یابند، روند آموزش امیدوارکننده است؛ بااینحال نتیجه نهایی همچنان باید روی آزمون مستقل سنجیده شود.
تفسیر این نمودار قطعی و مستقل از داده نیست. برای توضیح بیشتر، مقاله بیشبرازش و کمبرازش در یادگیری ماشین را بخوانید.
ارزیابی نهایی روی مجموعه آزمون
پس از بازگرداندن بهترین وضعیت مدل، برای نخستین بار مجموعه آزمون را ارزیابی میکنیم:
from sklearn.metrics import ( accuracy_score, classification_report, confusion_matrix, roc_auc_score,)model.eval()X_test_tensor = torch.from_numpy( X_test).to(device)with torch.inference_mode(): test_logits = model( X_test_tensor ) test_scores = torch.sigmoid( test_logits ).squeeze(1).cpu().numpy()test_predictions = ( test_scores >= 0.5).astype(int)true_labels = y_test.astype(int)print( "Accuracy:", accuracy_score( true_labels, test_predictions, ),)مقادیر خروجی را نمیتوان از پیش اعلام کرد. نتیجه به اجرای واقعی کد، داده، محیط محاسباتی و تغییرات احتمالی نسخه کتابخانهها بستگی دارد. حتی با بذر تصادفی ثابت، برخی عملیات یا محیطهای محاسباتی ممکن است نتیجه کاملاً یکسانی تولید نکنند.
معیارها را چگونه بخوانیم؟
- Accuracy: سهم کل پیشبینیهای درست
- Precision: از نمونههای پیشبینیشده در یک کلاس، چه تعداد واقعاً متعلق به آن کلاساند
- Recall: از نمونههای واقعی یک کلاس، چه تعداد پیدا شدهاند
- F1: خلاصهای از Precision وRecall
- ROC AUC: معیاری برای بررسی توان رتبهبندی نمونههای دو کلاس در آستانههای مختلف
- ماتریس خطا: تعداد پیشبینیهای درست و انواع خطا
آستانه 0.5 در این مثال برای شروع است. اگر در کاربرد واقعی هزینه خطاها یکسان نیست، آستانه را با داده اعتبارسنجی و بر اساس هدف عملیاتی انتخاب کنید؛ سپس همان آستانه انتخابشده را روی آزمون مستقل گزارش دهید. برای توضیح معیارها مقاله ماتریس درهمریختگی، Precision، Recall وF1 را ببینید.
مقایسه MLP با رگرسیون لجستیک
اکنون یک مدل خطی را روی همان داده آموزش میدهیم:
from sklearn.linear_model import ( LogisticRegression,)baseline = LogisticRegression( max_iter=1000,)baseline.fit( X_train, y_train.astype(int),)baseline_scores = ( baseline.predict_proba( X_test )[:, 1])baseline_predictions = ( baseline_scores >= 0.5).astype(int)print( "Logistic Regression accuracy:", accuracy_score( true_labels, baseline_predictions, ),)print( "Logistic Regression ROC AUC:", roc_auc_score( true_labels,هدف از این مقایسه، اثبات برتری همیشگی شبکه عصبی نیست. این داده عمداً ساختاری خمیده دارد؛ به همین دلیل مقایسه مدل خطی با شبکه دارای فعالساز غیرخطی، مفهوم تفاوت ظرفیت مدلها را روشن میکند.
در داده واقعی باید علاوه بر کیفیت پیشبینی، زمان آموزش، زمان پاسخ، هزینه اجرا و سهولت نگهداری را نیز مقایسه کنید. اگر مدل سادهتر به کیفیت لازم میرسد، پیچیدهتر کردن راهحل ممکن است ارزشی ایجاد نکند.
نمایش مرز تصمیم شبکه عصبی
چون داده فقط دو ویژگی دارد، میتوان ناحیهای را که مدل به هر کلاس اختصاص میدهد رسم کرد:
import matplotlib.pyplot as pltimport numpy as npimport torchx_min = X[:, 0].min() - 0.5x_max = X[:, 0].max() + 0.5y_min = X[:, 1].min() - 0.5y_max = X[:, 1].max() + 0.5grid_x, grid_y = np.meshgrid( np.linspace(x_min, x_max, 250), np.linspace(y_min, y_max, 250),)grid = np.column_stack( ( grid_x.ravel(), grid_y.ravel(), )).astype(np.float32)scaled_grid = scaler.transform( grid).astype(np.float32)model.eval()with torch.inference_mode(): grid_tensor = torch.from_numpy( scaled_grid ).to(device) grid_scores = torch.sigmoid( model(grid_tensor)شکل مرز تصمیم، تصویری از رفتار مدل در این داده دوبعدی است. برای دادههایی با دهها یا صدها ویژگی، دیگر نمیتوان کل فضای تصمیم را به همین سادگی در یک نمودار دوبعدی نمایش داد.
ذخیره مدل و آمادهسازی یک پیشبینی جدید
در استقرار، فقط ذخیره وزنهای شبکه کافی نیست. باید روش مقیاسبندی ویژگیها و ترتیب آنها نیز حفظ شود. در غیر این صورت، ورودی تازه با همان شکلی که مدل هنگام آموزش دیده پردازش نخواهد شد.
برای این نمونه کوچک، وزنها و پارامترهای مقیاسساز را در یک فایل ذخیره میکنیم:
torch.save(
    {
        "model_state": model.state_dict(),
        "scaler_mean": scaler.mean_.tolist(),
        "scaler_scale": scaler.scale_.tolist(),
        "input_features": [
            "feature_1",
            "feature_2",
        ],
    },
    "mlp_moons.pt",
)
برای بارگذاری و پیشبینی:
import numpy as npimport torchfrom torch import nndevice = torch.device("cpu")checkpoint = torch.load( "mlp_moons.pt", map_location=device, weights_only=True,)loaded_model = nn.Sequential( nn.Linear(2, 32), nn.ReLU(), nn.Linear(32, 16), nn.ReLU(), nn.Linear(16, 1),)loaded_model.load_state_dict( checkpoint["model_state"])loaded_model.eval()new_sample = np.array( [[0.5, 0.2]], dtype=np.float32,)mean = np.array(معماری هنگام بارگذاری باید با معماری زمان ذخیره یکسان باشد. مستندات PyTorch ذخیره و بارگذاری state_dict را روش معمول نگهداری پارامترهای مدل معرفی میکند. PyTorch Tutorials 2.14.0+cu130 documentation
در محصول واقعی، افزون بر وزنها باید نسخه کد، تعریف ویژگیها، سیاست پیشپردازش و معیارهای ارزیابی نیز ثبت شوند.
چگونه معماری MLP را انتخاب کنیم؟
تعداد لایهها و تعداد واحدهای هر لایه پاسخ ثابت ندارد. انتخاب آنها به پیچیدگی مسئله، مقدار داده و محدودیت زمان پاسخ بستگی دارد.
یک روند عملی این است:
- ابتدا یک خط مبنای ساده مانند رگرسیون لجستیک بسازید.
- یک MLP کوچک با یک یا دو لایه پنهان آزمایش کنید.
- معیارهای اعتبارسنجی و زمان اجرا را ثبت کنید.
- تنها وقتی شواهدی از کمبود ظرفیت دارید، شبکه را بزرگتر کنید.
- اگر شکاف آموزش و اعتبارسنجی افزایش یافت، اندازه مدل و روش کنترل بیشبرازش را بازبینی کنید.
- انتخاب نهایی را یکبار روی مجموعه آزمون مستقل بسنجید.
آزمایش ساختارهای متعدد روی داده اعتبارسنجی مجاز است، اما هرچه بیشتر بر اساس یک مجموعه محدود تصمیم بگیرید، احتمال سازگار شدن تصمیمها با ویژگیهای اتفاقی همان مجموعه افزایش مییابد.
شبکه عصبی برای چه دادههایی مناسب است؟
داده جدولی
MLPرا میتوان روی ویژگیهای عددی و دستهایِ آمادهسازیشده آموزش داد؛ مانند داده فروش، رفتار کاربر یا شاخصهای عملیاتی. بااینحال، در بسیاری از مسائل جدولی، روشهای دیگر نیز رقیب جدی هستند. مدل را با خط مبنا و گزینههای مرتبط با همان داده مقایسه کنید.
تصویر
شبکه کاملاً متصل میتواند تصویر کوچک را پس از تبدیل به بردار دریافت کند، اما در این کار از ساختار مکانی تصویر به شکل مستقیم استفاده نمیکند. معماری CNN برای بسیاری از مسائل تصویری انتخاب طبیعیتری است.
متن
متن پیش از ورود به MLP باید به ویژگی عددی تبدیل شود. این ویژگیها میتوانند از روشهای سادهتر یا مدلهای embedding به دست بیایند. برای بسیاری از کاربردهای پیچیده متن، مدلهای از پیشآموزشدیده مناسبتر از آموزش یک MLP از صفر هستند.
صوت و سری زمانی
میتوان از ویژگیهای استخراجشده صوت یا سری زمانی بهعنوان ورودی MLP استفاده کرد. اگر ترتیب، وابستگی زمانی یا ساختار محلی داده نقش اصلی دارد، معماریهای متناسب با آن ساختار را نیز ارزیابی کنید.
آیا شبکه عصبی همان یادگیری عمیق است؟
یادگیری عمیق معمولاً به استفاده از مدلهایی با چندین مرحله یادگیری بازنمایی اشاره میکند؛ شبکههای عصبی ابزار اصلی این حوزه هستند. بااینحال، هر نمونه بسیار کوچک از شبکه عصبی را نباید بدون توجه به معماری و مسئله، معادل یک سامانه عمیق پیشرفته دانست.
اگر میخواهید تصویر بزرگتری از این حوزه داشته باشید، مقاله یادگیری عمیق چیست؟ و راهنمای PyTorch را بخوانید.
بیشبرازش و کمبرازش در شبکه عصبی
کمبرازش
وقتی شبکه حتی روی داده آموزش نیز الگوی لازم را یاد نمیگیرد، ممکن است با کمبرازش روبهرو باشیم. علتهای احتمالی شامل معماری ناکافی، ویژگیهای نامناسب، آموزش ناکافی یا تنظیم نامناسب نرخ یادگیری است.
بیشبرازش
وقتی مدل روی داده آموزش خوب عمل میکند اما کیفیت آن روی داده جدید افت میکند، احتمال بیشبرازش وجود دارد. علت میتواند ظرفیت زیاد مدل نسبت به داده، نمونههای آموزشی محدود یا تفاوت میان داده آموزش و کاربرد واقعی باشد.
راهکارهای قابلآزمایش شامل موارد زیر هستند:
- گردآوری داده مرتبط و باکیفیتتر
- کوچکتر کردن شبکه
- توقف زودهنگام
- تنظیم
weight_decay - استفاده سنجیده ازDropout
- بازبینی نشت اطلاعات میان بخشهای داده
- بررسی اینکه داده اعتبارسنجی واقعاً نماینده کاربرد آینده است
هیچکدام از این روشها بهتنهایی جایگزین ارزیابی مستقل نمیشوند.
اشتباهات رایج هنگام ساخت شبکه عصبی
۱. مقیاسبندی پیش از تقسیم داده
اگر مقیاسساز را روی کل داده تنظیم کنید، اطلاعات آزمون به مراحل آمادهسازی راه پیدا میکند. ابتدا داده را تقسیم کنید، سپس fit را فقط روی آموزش اجرا کنید.
۲. قرار دادن Sigmoid در مدل همراه با BCEWithLogitsLoss
این تابع خطا خروجی خام مدل را میخواهد. اعمال Sigmoid در لایه آخر و سپس دادن نتیجه به این تابع، ترکیب مورد انتظار آن نیست.
۳. فراموش کردن optimizer.zero_grad()
گرادیانها در PyTorch میتوانند میان گامها انباشته شوند. اگر قصد انباشت کنترلشده ندارید، پیش از پسانتشار هر دسته، گرادیان قبلی را پاک کنید.
۴. ارزیابی بدون model.eval()
برخی لایهها مانند Dropout یا Batch Normalization در حالت آموزش و ارزیابی رفتار متفاوت دارند. پیش از ارزیابی، مدل را به حالت ارزیابی ببرید.
۵. انتخاب معماری بر اساس نتیجهTest
مجموعه آزمون برای گزارش عملکرد نهایی است. معماری، تعداد دورهها و آستانه تصمیم را با داده اعتبارسنجی انتخاب کنید.
۶. فرض اینکه Loss پایین یعنی محصول خوب
تابع خطای آموزشی و معیار موفقیت محصول یکسان نیستند. ممکن است مدل Loss پایینی داشته باشد، اما همان نوع خطایی را مرتکب شود که برای کاربر یا تیم عملیاتی بیشترین هزینه را دارد.
۷. استفاده از شبکه بزرگ بدون خط مبنا
بدون مدل سادهتر نمیدانید پیچیدگی شبکه چه بهبودی ایجاد کرده است. خط مبنا، تصمیم مهندسی را قابلسنجش میکند.
۸. ناهماهنگی ویژگیها هنگام استقرار
اگر ترتیب ستونها، مقیاس آنها یا شیوه ساخت ویژگیها تغییر کند، مدل دیگر همان ورودی زمان آموزش را دریافت نمیکند.
شبکه عصبی اختصاصی یا مدل آماده از طریق API؟
در برخی مسائل، آموزش یک MLP اختصاصی مناسب است: ویژگیهای مسئله روشناند، داده برچسبدار دارید و خروجی محدود و مشخص است. در برخی مسائل دیگر، مانند فهم متن آزاد، خلاصهسازی، استخراج اطلاعات و تولید پاسخ، آزمایش یک مدل از پیشآموزشدیده میتواند مسیر سریعتری برای ساخت نمونه اولیه باشد.
| نیاز | گزینهای که ارزش آزمایش دارد |
|---|---|
| طبقهبندی ویژگیهای عددی مشخص | مدل ساده و MLP اختصاصی |
| تحلیل متن آزاد فارسی | مدل متنی از پیشآموزشدیده |
| تولید پاسخ یا خلاصه | مدل مولد |
| جستوجوی معنایی | مدل embedding و سامانه بازیابی |
| تصویر تخصصی با داده برچسبدار | یادگیری انتقالی یا معماری تصویری مناسب |
انتخاب نهایی باید با آزمایش روی داده همان کاربرد انجام شود. کیفیت، هزینه هر درخواست، زمان پاسخ، الزامات استقرار و نگهداری مدل را کنار هم بررسی کنید.
اگر میخواهید قابلیتهای مدلهای آماده را به نرمافزار اضافه کنید، APIدرواره یک مسیر یکپارچه برای دسترسی به مدلهای موجود فراهم میکند. برای مثال میتوانید یک قابلیت طبقهبندی متن یا استخراج اطلاعات را با مدل مناسب آزمایش کنید و نتیجه را با مدل اختصاصی خود مقایسه کنید. شناسه، قابلیت و شرایط فعلی هر مدل را پیش از پیادهسازی از مستندات و فهرست مدلهای درواره بررسی کنید.
پرسشهای متداول
ANNمخفف چیست؟
ANNمخفف Artificial Neural Network و به معنی شبکه عصبی مصنوعی است.
تفاوت ANN و MLP چیست؟
ANN نام یک خانواده گسترده از مدلهاست. MLPیکی از اعضای این خانواده است که معمولاً از چند لایه کاملاً متصل و تابع فعالسازی تشکیل میشود.
پرسپترون و شبکه عصبی چندلایه چه تفاوتی دارند؟
پرسپترون ساده مرز تصمیم خطی میسازد. شبکه چندلایه با تابع فعالسازی غیرخطی میتواند الگوهای پیچیدهتری را یاد بگیرد.
آیا هرچه تعداد لایهها بیشتر باشد، مدل بهتر میشود؟
خیر. شبکه بزرگتر به داده، منابع محاسباتی و تنظیم دقیقتری نیاز دارد و ممکن است بیشبرازش کند. کیفیت باید روی دادهای که مدل در آموزش ندیده سنجیده شود.
آیا برای آموزش شبکه عصبی به GPU نیاز داریم؟
برای شبکه کوچک و دادهای مانند مثال این مقاله، CPU کافی است. GPU میتواند آموزش مدلهای بزرگتر یا داده حجیم را سریعتر کند.
تابع فعالسازی چه کاری انجام میدهد؟
تابع فعالسازی به شبکه امکان میدهد تبدیل غیرخطی بسازد. بدون آن، قرار دادن چند لایه خطی پشت سر هم بهتنهایی مدل را برای یادگیری مرز تصمیم غیرخطی توانا نمیکند.
تفاوت Loss و Accuracy چیست؟
Loss معیاری است که در آموزش برای اصلاح پارامترها استفاده میشود. Accuracy سهم پیشبینیهای درست است. ممکن است Loss تغییر کند اما Accuracyدر یک آستانه مشخص ثابت بماند؛ بنابراین هر دو را متناسب با هدف بررسی کنید.
چرا باید داده را به Train، Validation و Test تقسیم کنیم؟
Train برای یادگیری پارامترها، Validation برای انتخاب تنظیمات و Testبرای سنجش نهایی روی داده مستقل به کار میرود. این تفکیک به جلوگیری از گزارش نتیجه بیشازحد خوشبینانه کمک میکند.
آیا MLP برای تصویر و متن مناسب است؟
میتوان ویژگیهای عددی استخراجشده از تصویر یا متن را به MLP داد. اما برای پردازش مستقیم تصویر و متن پیچیده، معماریها و مدلهای متناسب با ساختار آن دادهها نیز باید بررسی شوند.
آیا خروجی Sigmoid احتمال قطعی درستبودن پیشبینی است؟
خروجی بین صفر و یک میتواند بهعنوان نمره مدل تفسیر شود، اما نباید آن را بدون ارزیابی، احتمال دقیق و کالیبرهشده در دنیای واقعی دانست. کیفیت نمره و آستانه تصمیم را روی داده مرتبط بسنجید.
جمعبندی
شبکه عصبی مصنوعی مدلی است که با تنظیم وزنها و بایاسها، رابطه میان ورودی و خروجی را یاد میگیرد. لایههای پنهان و توابع فعالسازی به آن امکان میدهند الگوهایی پیچیدهتر از یک مرز خطی ساده بسازد.
در این مقاله، یک MLP را با PyTorch روی داده دوبعدی آموزش دادیم. داده را به آموزش، اعتبارسنجی و آزمون تقسیم کردیم، مقیاسساز را فقط با داده آموزش تنظیم کردیم، با BCEWithLogitsLoss و AdamW مدل را آموزش دادیم و نتیجه را با رگرسیون لجستیک مقایسه کردیم.
مهمترین نکته عملی این است که پیچیدگی مدل باید با بهبود قابلاندازهگیری توجیه شود. برای مسئله خودتان، خط مبنا بسازید، انواع خطا را بررسی کنید و کیفیت را روی داده مستقل همراه با هزینه و زمان پاسخ بسنجید. برای کاربردهای متنی و مولد نیز مدلهای آماده قابلدسترسی از طریق API درواره میتوانند در همین مقایسه قرار بگیرند.
مقالات مرتبط
- یادگیری عمیق چیست؟
- PyTorchچیست؟ آموزش یادگیری عمیق با پایتون
- یادگیری نظارتشده چیست؟
- رگرسیون لجستیک چیست؟
- گرادیان کاهشی چیست؟
- بیشبرازش و کمبرازش در یادگیری ماشین
- شبکه عصبی CNN چیست؟
- آموزش استفاده از API هوش مصنوعی در برنامهنویسی
منابع
- PyTorch:ساخت شبکه عصبی
- PyTorch:مشتقگیری خودکار و پسانتشار
- PyTorch:بهینهسازی پارامترهای مدل
- PyTorch: Dataset و DataLoader
- PyTorch:ذخیره و بارگذاری مدل
- scikit-learn: ساخت داده آزمایشی make_moons
- scikit-learn:خطاهای رایج و نشت داده
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. عملکرد مدلها و شرایط استفاده ابزارها باید پیش از بهکارگیری عملی روی داده و محیط واقعی بررسی شود. صفحه سلب مسئولیت درواره را نیز مطالعه کنید.



