
گرادیان نزولی چیست؟ آموزش Gradient Descent با پایتون و PyTorch
گرادیان نزولی روش اصلی بهینهسازی بسیاری از مدلهای یادگیری ماشین است. در این راهنما نحوه کار Gradient Descent، تفاوت Batch و SGD و Mini-batch، نرخ یادگیری، Adam، پیادهسازی با پایتون و PyTorch و خطاهای رایج را میآموزید.

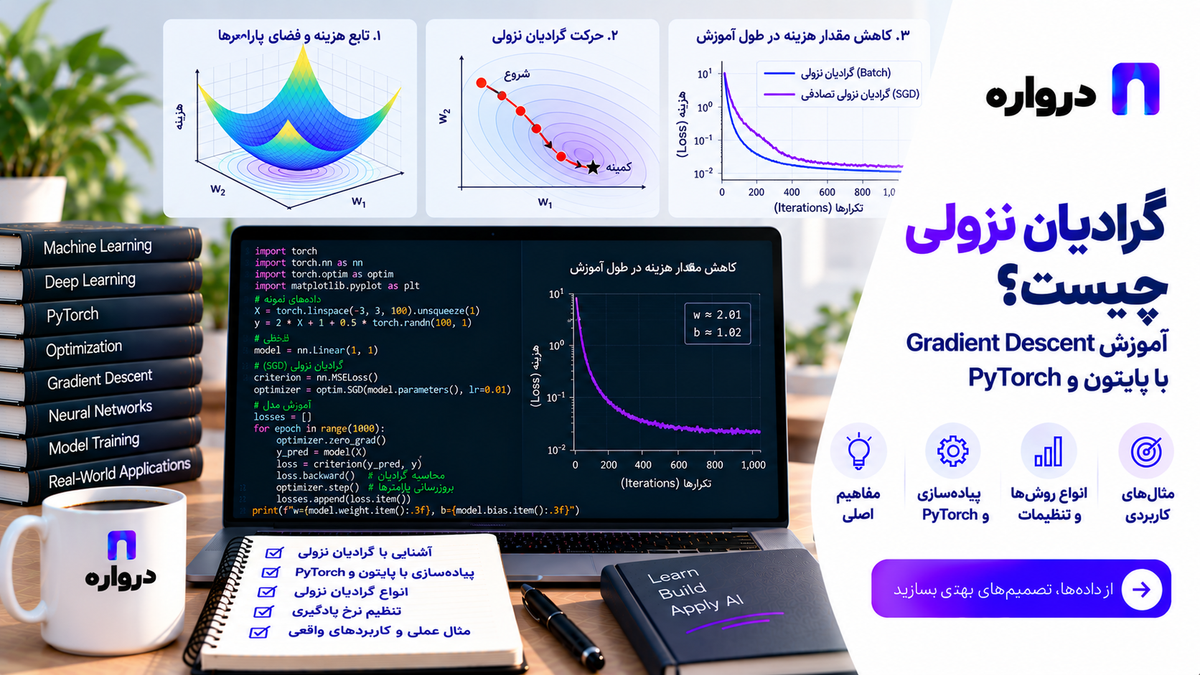
گرادیان نزولی یا Gradient Descent یکی از مهمترین روشهای بهینهسازی در یادگیری ماشین و یادگیری عمیق است. بسیاری از مدلها برای یادگیری پارامترهای مناسب، از گرادیان نزولی یا نسخههای توسعهیافته آن استفاده میکنند.
وقتی یک مدل پیشبینی اشتباهی انجام میدهد، باید مشخص شود پارامترهای آن در چه جهتی تغییر کنند تا خطا کمتر شود. گرادیان نزولی همین مسیر اصلاح را مشخص میکند.
از این روش در آموزش مدلهای مختلف استفاده میشود:
- رگرسیون خطی
- رگرسیون لجستیک
- ماشین بردار پشتیبان خطی
- شبکههای عصبی
- مدلهای بینایی ماشین
- مدلهای پردازش زبان طبیعی
- مدلهای Transformer
- مدلهای تولید متن، تصویر و صوت
در این مقاله، Gradient Descent را بدون فرمولهای ریاضی توضیح میدهیم و آن را با پایتون، NumPy، Scikit-learn و PyTorch پیادهسازی میکنیم.
گرادیان نزولی چیست؟
گرادیان نزولی روشی برای پیدا کردن پارامترهایی است که خطای مدل را کاهش میدهند.
فرض کنید یک مدل ساده میخواهد قیمت محصول را بر اساس چند ویژگی پیشبینی کند. در ابتدای آموزش، پارامترهای مدل هنوز مناسب نیستند و خروجی آن با مقدار واقعی اختلاف زیادی دارد.
فرایند یادگیری بهصورت تکراری انجام میشود:
۱. مدل با پارامترهای فعلی پیشبینی میکند.
۲. مقدار خطا محاسبه میشود.
۳. مشخص میشود هر پارامتر در چه جهتی باید تغییر کند.
۴. پارامترها کمی اصلاح میشوند.
۵. مدل دوباره پیشبینی میکند.
۶. این مراحل تا رسیدن به نتیجه مناسب ادامه پیدا میکنند.
هدف گرادیان نزولی رسیدن به نقطهای است که مقدار تابع خطا تا حد ممکن کم باشد.
یک مثال ساده برای درک Gradient Descent
تصور کنید روی یک تپه مهآلود ایستادهاید و میخواهید به پایینترین نقطه دره برسید. به دلیل مه، کل مسیر را نمیبینید؛ اما میتوانید شیب زمین زیر پای خود را بررسی کنید.
در هر مرحله:
- جهت سرازیری را پیدا میکنید.
- یک قدم در همان جهت برمیدارید.
- دوباره شیب را بررسی میکنید.
- این کار را تا رسیدن به بخش کمشیب ادامه میدهید.
در این مثال:
- موقعیت شما مانند پارامترهای مدل است.
- ارتفاع زمین مانند میزان خطاست.
- جهت سرازیری مانند جهت گرادیان است.
- اندازه هر قدم مانند نرخ یادگیری است.
- رسیدن به پایین دره مانند پیدا کردن پارامترهای مناسب است.
این تشبیه تمام جزئیات فنی را پوشش نمیدهد، اما ایده اصلی Gradient Descent را بهخوبی نشان میدهد.
تابع خطا چیست؟
تابع خطا یا Loss Function مشخص میکند پیشبینی مدل چقدر با خروجی واقعی تفاوت دارد.
مدلهای مختلف از توابع خطای متفاوتی استفاده میکنند:
| نوع مسئله | نمونه تابع خطا |
|---|---|
| رگرسیون | میانگین مربعات خطا |
| طبقهبندی دودستهای | Log Loss |
| طبقهبندی چندکلاسه | Cross-Entropy |
| مدل مقاومتر به داده پرت | Huber Loss |
| مدلهای رتبهبندی | Ranking Loss |
| مدلهای زبانی | Cross-Entropy توکنها |
Gradient Descent مستقیماً هدف کسبوکار را نمیفهمد. فقط تلاش میکند تابع خطایی را که توسعهدهنده انتخاب کرده است، کاهش دهد.
اگر تابع خطا با هدف واقعی پروژه هماهنگ نباشد، کاهش آن الزاماً به بهبود ارزش کسبوکار منجر نمیشود.
گرادیان چیست؟
گرادیان نشان میدهد تغییر کوچک هر پارامتر چه اثری بر خطای مدل دارد.
برای هر پارامتر، گرادیان دو نوع اطلاعات فراهم میکند:
- جهت تغییر
- شدت اثر تغییر
اگر تغییر یک پارامتر باعث افزایش خطا شود، الگوریتم آن را در جهت مخالف اصلاح میکند. اگر یک پارامتر اثر زیادی بر خطا داشته باشد، مقدار اصلاح آن نیز میتواند بیشتر باشد.
در شبکههای عصبی، تعداد پارامترها ممکن است بسیار زیاد باشد. محاسبه این اثرها با فرایندی به نام Backpropagation انجام میشود.
تفاوت Gradient Descent و Backpropagation
این دو مفهوم به یکدیگر مرتبطاند، اما یکسان نیستند.
Backpropagation
پسانتشار یا Backpropagation گرادیان پارامترهای شبکه عصبی را محاسبه میکند. این مرحله مشخص میکند هر پارامتر چه سهمی در خطای نهایی داشته است.
Gradient Descent
گرادیان نزولی از گرادیانهای محاسبهشده برای بهروزرسانی پارامترهای مدل استفاده میکند.
به زبان ساده:
- Backpropagation میگوید پارامترها چگونه باید تغییر کنند.
- Optimizer تصمیم میگیرد تغییر دقیق چگونه اعمال شود.
- Gradient Descent خانوادهای از روشهای انجام این بهروزرسانی است.
در PyTorch، متد loss.backward() گرادیانها را محاسبه میکند و متد optimizer.step() پارامترها را بهروزرسانی میکند. مستندات رسمی PyTorch نیز حلقه بهینهسازی را شامل پاککردن گرادیانهای قبلی، محاسبه گرادیان با Backpropagation و اجرای مرحله Optimizer معرفی میکند.
پارامترهای مدل چه هستند؟
پارامترها مقادیری هستند که مدل در فرایند آموزش یاد میگیرد.
در یک رگرسیون خطی، پارامترها شامل ضرایب ویژگیها و مقدار پایه هستند. در شبکه عصبی، وزنها و Biasهای لایهها پارامتر محسوب میشوند.
پارامتر را نباید با Hyperparameter اشتباه گرفت.
پارامتر
مدل آن را از داده یاد میگیرد:
- وزنها
- Biasها
- ضرایب
Hyperparameter
پیش از آموزش یا در فرایند تنظیم مدل توسط توسعهدهنده انتخاب میشود:
- نرخ یادگیری
- اندازه Batch
- تعداد Epoch
- نوع Optimizer
- مقدار Weight Decay
- تعداد لایهها
نرخ یادگیری چیست؟
نرخ یادگیری یا Learning Rate اندازه هر قدم در مسیر بهینهسازی را تعیین میکند.
نرخ یادگیری بسیار کوچک
اگر Learning Rate بیش از حد کوچک باشد:
- آموزش بسیار کند میشود.
- مدل به تعداد Epoch بیشتری نیاز دارد.
- هزینه محاسباتی افزایش پیدا میکند.
- مدل ممکن است پیش از رسیدن به نتیجه مناسب متوقف شود.
نرخ یادگیری بسیار بزرگ
اگر Learning Rate بیش از حد بزرگ باشد:
- مدل از نقطه مناسب عبور میکند.
- مقدار خطا نوسان میکند.
- آموزش ناپایدار میشود.
- مقدار خطا ممکن است افزایش پیدا کند.
- پارامترها ممکن است به مقادیر نامعتبر برسند.
نرخ یادگیری مناسب
Learning Rate مناسب باعث میشود مدل با سرعت قابل قبول و بدون نوسان شدید به سمت نتیجه بهتر حرکت کند.
نرخ یادگیری یکی از مهمترین Hyperparameterهای آموزش مدل است و معمولاً باید با آزمایش کنترلشده انتخاب شود.
Epoch چیست؟
یک Epoch زمانی کامل میشود که مدل تمام نمونههای داده آموزشی را یک بار مشاهده کرده باشد.
اگر مجموعه آموزشی شامل ۱۰۰ هزار نمونه باشد، پایان یک Epoch یعنی همه این نمونهها یک بار در فرایند آموزش استفاده شدهاند.
آموزش معمولاً چند Epoch ادامه پیدا میکند. تعداد بسیار کم Epoch میتواند باعث کمبرازش شود. تعداد بسیار زیاد نیز ممکن است مدل را دچار بیشبرازش کند.
Batch چیست؟
Batch گروهی از نمونههای آموزشی است که در یک مرحله پردازش میشوند.
برای مثال، اگر ۱۰ هزار نمونه و Batch Size برابر با ۱۰۰ داشته باشیم، هر Epoch شامل ۱۰۰ مرحله بهروزرسانی خواهد بود.
اندازه Batch بر موارد زیر اثر میگذارد:
- مصرف حافظه
- سرعت آموزش
- پایداری گرادیان
- تعداد بهروزرسانیها
- کیفیت تعمیم مدل
- بهرهبرداری از GPU
انواع Gradient Descent
سه نوع اصلی گرادیان نزولی بر اساس میزان داده استفادهشده در هر مرحله وجود دارد.
Batch Gradient Descent
در Batch Gradient Descent، تمام دادههای آموزشی برای محاسبه یک مرحله بهروزرسانی استفاده میشوند.
مزایا
- جهت بهروزرسانی نسبتاً پایدار است.
- نمودار خطا معمولاً هموارتر است.
- پیادهسازی مفهومی سادهای دارد.
محدودیتها
- برای دادههای بزرگ کند است.
- حافظه زیادی مصرف میکند.
- تا پردازش کامل داده، بهروزرسانی انجام نمیشود.
- برای آموزش مدلهای بزرگ عملی نیست.
Batch Gradient Descent بیشتر برای آموزش مفهومی یا مجموعهدادههای کوچک مناسب است.
Stochastic Gradient Descent یا SGD
در SGD، هر مرحله بهروزرسانی با یک نمونه آموزشی انجام میشود.
Scikit-learn توضیح میدهد که SGD یک روش بهینهسازی است، نه یک خانواده مستقل از مدلها. برای مثال، میتوان رگرسیون لجستیک یا مدل خطی SVM را با SGD آموزش داد.
مزایا
- بهروزرسانیها سریع آغاز میشوند.
- برای دادههای بزرگ مناسب است.
- امکان آموزش تدریجی وجود دارد.
- نوسانها گاهی به عبور از نقاط نامناسب کمک میکنند.
محدودیتها
- مسیر آموزش نوسان زیادی دارد.
- خطا در هر مرحله الزاماً کاهش پیدا نمیکند.
- به نرخ یادگیری حساس است.
- ترتیب دادهها میتواند بر نتیجه اثر بگذارد.
Scikit-learn توصیه میکند داده آموزشی قبل از استفاده از SGD جابهجا شود و ویژگیهای عددی نیز در بیشتر کاربردها استاندارد شوند.
Mini-batch Gradient Descent
در Mini-batch Gradient Descent، هر مرحله روی گروه کوچکی از نمونهها انجام میشود.
این روش رایجترین انتخاب برای آموزش شبکههای عصبی است؛ زیرا تعادلی میان پایداری Batch Gradient Descent و سرعت SGD ایجاد میکند.
مزایا
- استفاده مؤثر از GPU
- مصرف حافظه کنترلشده
- بهروزرسانیهای سریعتر
- نوسان کمتر از SGD تکنمونهای
- مناسب برای مجموعهدادههای بزرگ
محدودیتها
- اندازه Batch باید تنظیم شود.
- Batch بسیار بزرگ به حافظه بیشتری نیاز دارد.
- Batch بسیار کوچک میتواند آموزش را پرنوسان کند.
مقایسه انواع گرادیان نزولی
| روش | داده در هر مرحله | پایداری | سرعت هر بهروزرسانی | کاربرد |
|---|---|---|---|---|
| Batch | تمام داده | زیاد | کم | داده کوچک |
| SGD | یک نمونه | کم | زیاد | آموزش آنلاین |
| Mini-batch | گروهی از نمونهها | متوسط | مناسب | شبکه عصبی و GPU |
در عمل، اصطلاح SGD گاهی برای روش Mini-batch نیز به کار میرود؛ بهخصوص در کتابخانههای یادگیری عمیق.
پیادهسازی ساده Gradient Descent با پایتون
در این مثال، میخواهیم یک رابطه خطی ساده را از داده یاد بگیریم.
import numpy as np


X = np.array(
    [
        1.0,
        2.0,
        3.0,
        4.0,
        5.0,
    ]
)

y = np.array(
    [
        5.0,
        8.0,
        11.0,
        14.0,
        17.0,
    ]
)

weight = 0.0
bias = 0.0

learning_rate = 0.01
epochs = 1000

sample_count = len(X)

for epoch in range(epochs):
    predictions = (
        weight * X + bias
    )

    errors = predictions - y

    weight_gradient = (
        2
        * np.mean(
            errors * X
        )
    )

    bias_gradient = (
        2
        * np.mean(errors)
    )

    weight -= (
        learning_rate
        * weight_gradient
    )

    bias -= (
        learning_rate
        * bias_gradient
    )

    if epoch % 100 == 0:
        loss = np.mean(
            errors ** 2
        )

        print(
            f"Epoch {epoch}: "
            f"loss={loss:.4f}"
        )

print("Weight:", weight)
print("Bias:", bias)
این مثال نشان میدهد مدل چگونه در چند مرحله پارامترهای خود را اصلاح میکند.
عبارتهای محاسباتی داخل کد بخشی از پیادهسازی هستند و برای اجرای برنامه ضرورت دارند؛ اما برای درک مفهوم، کافی است بدانید مدل جهت کاهش خطا را پیدا میکند و پارامترها را کمی در همان جهت تغییر میدهد.
نمایش روند کاهش خطا
import matplotlib.pyplot as plt
import numpy as np


weight = 0.0
bias = 0.0

learning_rate = 0.01
epochs = 500

loss_history = []

for epoch in range(epochs):
    predictions = (
        weight * X + bias
    )

    errors = predictions - y

    loss = np.mean(
        errors ** 2
    )

    loss_history.append(loss)

    weight_gradient = (
        2
        * np.mean(
            errors * X
        )
    )

    bias_gradient = (
        2
        * np.mean(errors)
    )

    weight -= (
        learning_rate
        * weight_gradient
    )

    bias -= (
        learning_rate
        * bias_gradient
    )

plt.plot(loss_history)

plt.xlabel("Epoch")
plt.ylabel("Loss")
plt.title(
    "Training Loss"
)

plt.show()
نمودار مناسب معمولاً در ابتدا کاهش سریعتری دارد و سپس بهتدریج کمشیب میشود.
اگر نمودار خطا افزایش پیدا کند یا نوسان شدید داشته باشد، Learning Rate میتواند بیش از حد بزرگ باشد.
آموزش رگرسیون با SGDRegressor
Scikit-learn کلاس SGDRegressor را برای آموزش مدلهای رگرسیون خطی با SGD ارائه میکند.
from sklearn.datasets import (
    make_regression,
)
from sklearn.linear_model import (
    SGDRegressor,
)
from sklearn.metrics import (
    mean_absolute_error,
    r2_score,
)
from sklearn.model_selection import (
    train_test_split,
)
from sklearn.pipeline import (
    make_pipeline,
)
from sklearn.preprocessing import (
    StandardScaler,
)


X, y = make_regression(
    n_samples=5000,
    n_features=20,
    noise=15,
    random_state=42,
)

X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.2,
        random_state=42,
    )
)

model = make_pipeline(
    StandardScaler(),
    SGDRegressor(
        loss="squared_error",
        penalty="l2",
        max_iter=2000,
        tol=1e-4,
        early_stopping=True,
        validation_fraction=0.1,
        n_iter_no_change=10,
        random_state=42,
    ),
)

model.fit(
    X_train,
    y_train,
)

predictions = model.predict(
    X_test
)

print(
    "MAE:",
    mean_absolute_error(
        y_test,
        predictions,
    ),
)

print(
    "R-squared:",
    r2_score(
        y_test,
        predictions,
    ),
)
Scikit-learn، SGDRegressor را برای مسائل رگرسیون دارای تعداد زیاد نمونه مناسب میداند و امکان انتخاب تابع خطا، Regularization و توقف زودهنگام را فراهم میکند.
آموزش طبقهبندی متن با SGDClassifier
SGD برای داده متنی پُربعد و Sparse نیز مناسب است.
import pandas as pd

from sklearn.feature_extraction.text import (
    TfidfVectorizer,
)
from sklearn.linear_model import (
    SGDClassifier,
)
from sklearn.metrics import (
    classification_report,
)
from sklearn.model_selection import (
    train_test_split,
)
from sklearn.pipeline import Pipeline


data = pd.read_csv(
    "persian_messages.csv"
)

X_train, X_test, y_train, y_test = (
    train_test_split(
        data["text"],
        data["label"],
        test_size=0.2,
        random_state=42,
        stratify=data["label"],
    )
)

pipeline = Pipeline(
    steps=[
        (
            "tfidf",
            TfidfVectorizer(
                ngram_range=(1, 2),
                min_df=2,
                sublinear_tf=True,
            ),
        ),
        (
            "classifier",
            SGDClassifier(
                loss="log_loss",
                penalty="elasticnet",
                alpha=0.0001,
                max_iter=2000,
                early_stopping=True,
                validation_fraction=0.1,
                n_iter_no_change=10,
                random_state=42,
            ),
        ),
    ]
)

pipeline.fit(
    X_train,
    y_train,
)

predictions = pipeline.predict(
    X_test
)

print(
    classification_report(
        y_test,
        predictions,
    )
)
با loss="log_loss"، مدل رفتاری مشابه رگرسیون لجستیک دارد؛ اما با روش SGD آموزش میبیند. با loss="hinge" نیز میتوان یک مدل خطی مشابه SVM ایجاد کرد.
آموزش مدل با PyTorch
در PyTorch، حلقه آموزش معمولاً شامل مراحل زیر است:
۱. داده وارد مدل میشود.
۲. مدل خروجی را تولید میکند.
۳. Loss محاسبه میشود.
۴. گرادیانهای قبلی پاک میشوند.
۵. Backpropagation گرادیانهای جدید را محاسبه میکند.
۶. Optimizer پارامترها را بهروزرسانی میکند.
نمونه کامل:
import torch

from torch import nn
from torch.utils.data import (
    DataLoader,
    TensorDataset,
)


torch.manual_seed(42)

X = torch.randn(
    2000,
    10,
)

true_weights = torch.tensor(
    [
        2.0,
        -1.5,
        0.8,
        0.0,
        3.2,
        -2.4,
        1.1,
        0.5,
        -0.7,
        1.8,
    ]
)

noise = (
    torch.randn(2000)
    * 0.5
)

y = (
    X @ true_weights
    + 4.0
    + noise
)

dataset = TensorDataset(
    X,
    y.unsqueeze(1),
)

loader = DataLoader(
    dataset,
    batch_size=64,
    shuffle=True,
)

model = nn.Linear(
    in_features=10,
    out_features=1,
)

loss_function = nn.MSELoss()

optimizer = torch.optim.SGD(
    model.parameters(),
    lr=0.01,
    momentum=0.9,
)

epochs = 50

for epoch in range(epochs):
    model.train()

    total_loss = 0.0

    for features, targets in loader:
        predictions = model(
            features
        )

        loss = loss_function(
            predictions,
            targets,
        )

        optimizer.zero_grad()

        loss.backward()

        optimizer.step()

        total_loss += (
            loss.item()
            * features.size(0)
        )

    average_loss = (
        total_loss
        / len(dataset)
    )

    if epoch % 5 == 0:
        print(
            f"Epoch {epoch}: "
            f"loss={average_loss:.4f}"
        )
طبق آموزش رسمی PyTorch، گرادیانها بهصورت پیشفرض روی هم جمع میشوند. بنابراین باید پیش از محاسبه مرحله جدید، با optimizer.zero_grad() پاک شوند. سپس loss.backward() گرادیانها را محاسبه و optimizer.step() پارامترها را اصلاح میکند.
Momentum چیست؟
SGD ساده ممکن است در مسیر بهینهسازی مدام تغییر جهت دهد. Momentum از جهت حرکت مرحلههای قبلی استفاده میکند تا حرکت مدل پایدارتر شود.
تشبیه مناسب، حرکت یک توپ روی سطح شیبدار است. توپ فقط بر اساس شیب لحظه فعلی حرکت نمیکند؛ بلکه بخشی از سرعت قبلی خود را نیز حفظ میکند.
مزایای احتمالی Momentum:
- کاهش نوسان
- عبور سریعتر از بخشهای کمشیب
- همگرایی سریعتر
- حرکت پایدارتر در بعضی مسائل
در PyTorch میتوان Momentum را هنگام ساخت Optimizer تعیین کرد:
optimizer = torch.optim.SGD(
    model.parameters(),
    lr=0.01,
    momentum=0.9,
)
پیادهسازی SGD در PyTorch از Momentum و گزینههای دیگری مانند Weight Decay و Nesterov پشتیبانی میکند.
Adam چیست؟
Adam یکی از Optimizerهای پرکاربرد در یادگیری عمیق است.
این روش برای هر پارامتر، روند گرادیانها و شدت تغییرات اخیر را در نظر میگیرد و اندازه بهروزرسانی را بهصورت تطبیقی تنظیم میکند.
مزایای رایج Adam:
- شروع مناسب برای بسیاری از شبکههای عصبی
- نیاز کمتر به تنظیم دستی نسبت به SGD ساده
- عملکرد مناسب روی گرادیانهای Sparse
- سازگاری خوب با مسائل پیچیده
- همگرایی سریع در بسیاری از پروژهها
استفاده در PyTorch:
optimizer = torch.optim.Adam(
    model.parameters(),
    lr=0.001,
)
PyTorch علاوه بر SGD و Adam، Optimizerهای متنوعی مانند AdamW، RMSprop، Adagrad و Adafactor ارائه میکند.
AdamW چیست؟
AdamW نسخهای از Adam است که Weight Decay را به شکل جداگانهتری از بهروزرسانی اصلی پارامترها اعمال میکند.
این Optimizer در آموزش و Fine-tuning بسیاری از مدلهای مدرن، بهویژه مدلهای Transformer، استفاده میشود.
optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=0.0001,
    weight_decay=0.01,
)
انتخاب AdamW به این معنا نیست که تنظیم Learning Rate، Batch Size و Scheduler دیگر اهمیتی ندارند. این پارامترها همچنان باید بر اساس داده و معماری مدل انتخاب شوند.
مقایسه SGD، Adam و AdamW
| Optimizer | ویژگی اصلی | کاربرد متداول |
|---|---|---|
| SGD | ساده و کمحافظه | مدلهای خطی و بعضی شبکههای عصبی |
| SGD با Momentum | حرکت پایدارتر | بینایی ماشین و شبکههای عمیق |
| Adam | نرخ یادگیری تطبیقی | شروع سریع پروژههای یادگیری عمیق |
| AdamW | Weight Decay جداشده | Transformer و Fine-tuning |
| RMSprop | تنظیم تطبیقی قدمها | بعضی مدلهای ترتیبی |
| Adagrad | مناسب ویژگیهای Sparse | برخی مسائل متن و داده Sparse |
بهترین Optimizer به نوع مدل، داده، Batch Size و هدف پروژه وابسته است. نتیجه باید با آزمایش کنترلشده ارزیابی شود.
Learning Rate Scheduler چیست؟
Learning Rate Scheduler نرخ یادگیری را در طول آموزش تغییر میدهد.
یک روش رایج این است که آموزش با Learning Rate نسبتاً بزرگ آغاز شود و سپس مقدار آن کاهش یابد. در ابتدا مدل سریعتر حرکت میکند و در مراحل بعد با قدمهای کوچکتر تنظیم دقیقتری انجام میدهد.
نمونه در PyTorch:
optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=0.001,
)

scheduler = (
    torch.optim.lr_scheduler
    .ReduceLROnPlateau(
        optimizer,
        mode="min",
        factor=0.5,
        patience=3,
    )
)
در پایان هر Epoch:
scheduler.step(
    validation_loss
)
روشهای متداول زمانبندی نرخ یادگیری عبارتاند از:
- کاهش مرحلهای
- کاهش نمایی
- کاهش بر اساس توقف بهبود
- Cosine Annealing
- One Cycle
- Warmup همراه با کاهش تدریجی
Warmup چیست؟
در Warmup، آموزش با Learning Rate بسیار کوچک شروع میشود و طی چند مرحله به مقدار اصلی میرسد.
این روش در آموزش مدلهای بزرگ و Transformerها کاربرد دارد؛ زیرا تغییر شدید پارامترها در ابتدای آموزش میتواند باعث ناپایداری شود.
پس از پایان Warmup، Scheduler معمولاً Learning Rate را بهتدریج کاهش میدهد.
Early Stopping چیست؟
Early Stopping آموزش را زمانی متوقف میکند که عملکرد مدل روی داده اعتبارسنجی دیگر بهتر نمیشود.
این روش دو مزیت اصلی دارد:
- کاهش زمان آموزش
- کاهش احتمال بیشبرازش
Scikit-learn در SGDClassifier و SGDRegressor امکان توقف بر اساس عملکرد داده اعتبارسنجی را فراهم میکند. اگر نتیجه برای چند Epoch بهبود پیدا نکند، آموزش متوقف میشود.
نمونه تنظیم:
model = SGDClassifier(
    early_stopping=True,
    validation_fraction=0.1,
    n_iter_no_change=10,
    max_iter=3000,
    random_state=42,
)
پیادهسازی Early Stopping در PyTorch
best_validation_loss = float(
    "inf"
)

patience = 5
epochs_without_improvement = 0

for epoch in range(100):
    train_one_epoch(
        model,
        train_loader,
        optimizer,
        loss_function,
    )

    validation_loss = evaluate(
        model,
        validation_loader,
        loss_function,
    )

    if (
        validation_loss
        < best_validation_loss
    ):
        best_validation_loss = (
            validation_loss
        )

        epochs_without_improvement = 0

        torch.save(
            model.state_dict(),
            "best_model.pt",
        )
    else:
        epochs_without_improvement += 1

    if (
        epochs_without_improvement
        >= patience
    ):
        print(
            "Early stopping"
        )
        break
مدل نهایی باید از بهترین Checkpoint اعتبارسنجی بارگذاری شود، نه الزاماً آخرین Epoch.
چرا استانداردسازی داده مهم است؟
اگر مقیاس ویژگیها بسیار متفاوت باشد، مسیر Gradient Descent نامتعادل میشود.
برای مثال:
- سن بین ۱۸ تا ۷۰
- درآمد بین چند میلیون تا چند میلیارد
- تعداد خرید بین صفر تا ۱۰۰
ویژگی درآمد میتواند به دلیل مقیاس بزرگتر اثر نامتناسبی بر حرکت Optimizer داشته باشد.
Scikit-learn تأکید میکند که SGD نسبت به مقیاس ویژگیها حساس است و استفاده از StandardScaler در Pipeline را توصیه میکند.
from sklearn.pipeline import (
    make_pipeline,
)
from sklearn.preprocessing import (
    StandardScaler,
)
from sklearn.linear_model import (
    SGDClassifier,
)


model = make_pipeline(
    StandardScaler(),
    SGDClassifier(
        random_state=42
    ),
)
Shuffle کردن دادهها
اگر دادهها بر اساس کلاس یا زمان مرتب شده باشند، Batchهای متوالی میتوانند نماینده مناسبی از کل داده نباشند.
برای مثال، اگر تمام پیامهای پرداخت در ابتدای فایل و تمام پیامهای ارسال در انتهای آن باشند، مدل برای مدتی فقط یک کلاس را مشاهده میکند.
در آموزش عمومی باید دادههای آموزشی را Shuffle کرد:
loader = DataLoader(
    dataset,
    batch_size=64,
    shuffle=True,
)
اما در تقسیم داده زمانی نباید آینده را به گذشته مخلوط کرد. ابتدا Train و Validation باید بر اساس زمان جدا شوند و سپس فقط داده آموزشی Shuffle شود.
مشکل Vanishing Gradient چیست؟
در بعضی شبکههای عمیق، گرادیان هنگام عبور از لایههای متعدد بسیار کوچک میشود. در نتیجه، لایههای ابتدایی تقریباً بهروزرسانی نمیشوند.
نشانههای احتمالی:
- Loss بهکندی کاهش مییابد.
- وزن لایههای ابتدایی تقریباً ثابت میماند.
- مدل با افزایش عمق بهتر نمیشود.
راهکارهای رایج:
- استفاده از تابع فعالسازی مناسب
- مقداردهی اولیه مناسب وزنها
- Normalization
- اتصالهای Residual
- معماری مناسبتر
- بررسی Learning Rate
مشکل Exploding Gradient چیست؟
گاهی گرادیانها بیش از حد بزرگ میشوند و بهروزرسانی پارامترها ناپایدار میشود.
نشانهها:
- افزایش ناگهانی Loss
- ایجاد مقدار
NaN - تغییر بسیار بزرگ وزنها
- شکست آموزش پس از چند مرحله
یکی از راهکارها Gradient Clipping است:
optimizer.zero_grad()

loss.backward()

torch.nn.utils.clip_grad_norm_(
    model.parameters(),
    max_norm=1.0,
)

optimizer.step()
Gradient Clipping باید همراه با بررسی علت اصلی مشکل استفاده شود. Learning Rate نامناسب، داده خراب یا معماری ناپایدار نیز میتوانند عامل باشند.
Local Minimum و Saddle Point
سطح خطای یک مدل پیچیده میتواند بخشهای متعددی داشته باشد:
- نقاط کمینه محلی
- نقاط زینی
- نواحی تقریباً مسطح
- درههای باریک
- جهتهای دارای انحنای متفاوت
در مدلهای بزرگ، مشکل همیشه گیرکردن در یک Local Minimum نامناسب نیست. نقاط زینی و نواحی مسطح نیز میتوانند سرعت آموزش را کاهش دهند.
Momentum و Optimizerهای تطبیقی میتوانند عبور از بعضی از این نواحی را سادهتر کنند.
Regularization چه ارتباطی با Gradient Descent دارد؟
Regularization مدل را از یادگیری وزنهای بیش از حد بزرگ یا الگوهای بسیار پیچیده بازمیدارد.
روشهای رایج:
- L1
- L2
- Elastic Net
- Weight Decay
- Dropout
- Early Stopping
در Scikit-learn، مدلهای مبتنی بر SGD از تنظیمات l1، l2 و elasticnet پشتیبانی میکنند.
model = SGDClassifier(
    loss="log_loss",
    penalty="elasticnet",
    alpha=0.0001,
    l1_ratio=0.15,
    random_state=42,
)
تنظیم پارامترهای SGD با GridSearchCV
from sklearn.model_selection import (
    GridSearchCV,
)


parameter_grid = {
    "sgdclassifier__alpha": [
        0.00001,
        0.0001,
        0.001,
    ],
    "sgdclassifier__penalty": [
        "l2",
        "l1",
        "elasticnet",
    ],
    "sgdclassifier__loss": [
        "log_loss",
        "hinge",
    ],
}

search = GridSearchCV(
    estimator=model,
    param_grid=parameter_grid,
    scoring="f1_macro",
    cv=5,
    n_jobs=-1,
)

search.fit(
    X_train,
    y_train,
)

print(
    search.best_params_
)
اگر Pipeline دارای نامهای متفاوتی است، کلیدهای پارامتر باید با نام مرحله آن هماهنگ شوند.
آموزش آنلاین با Partial Fit
SGD میتواند دادهها را بهصورت تدریجی دریافت کند. این قابلیت برای دادههای جریانی یا مجموعههایی که در حافظه جا نمیشوند مفید است.
import numpy as np

from sklearn.linear_model import (
    SGDClassifier,
)


classes = np.array(
    [
        "payment",
        "shipping",
        "technical",
        "other",
    ]
)

model = SGDClassifier(
    loss="log_loss",
    random_state=42,
)

for X_batch, y_batch in (
    training_batches
):
    model.partial_fit(
        X_batch,
        y_batch,
        classes=classes,
    )
در نخستین فراخوانی باید تمام کلاسهای ممکن مشخص شوند. همچنین لازم است تغییر توزیع داده، کیفیت نسخه جدید و احتمال فراموشی الگوهای قبلی پایش شود.
چگونه متوجه شویم آموزش درست پیش میرود؟
در طول آموزش موارد زیر را ثبت کنید:
- Training Loss
- Validation Loss
- معیار اصلی کسبوکار
- Learning Rate
- اندازه گرادیان
- زمان هر Epoch
- مصرف حافظه
- تعداد نمونه پردازششده
- بهترین Checkpoint
- دلیل توقف آموزش
حالت مناسب
Training Loss و Validation Loss تا حدی کاهش مییابند و معیار اصلی روی داده اعتبارسنجی بهتر میشود.
بیشبرازش
Training Loss کاهش پیدا میکند، اما Validation Loss افزایش مییابد.
کمبرازش
هر دو Loss بالا باقی میمانند و مدل الگوی داده را یاد نمیگیرد.
ناپایداری
Loss نوسان شدید دارد یا به مقدار نامعتبر تبدیل میشود.
خطاهای رایج هنگام استفاده از Gradient Descent
انتخاب Learning Rate بسیار بزرگ
این کار باعث نوسان یا شکست آموزش میشود.
انتخاب Learning Rate بسیار کوچک
مدل بسیار کند آموزش میبیند و ممکن است پیش از رسیدن به نتیجه مناسب متوقف شود.
استاندارد نکردن ویژگیها
در مدلهای حساس به مقیاس، حرکت Optimizer نامتعادل میشود.
فراموشکردن پاکسازی گرادیانها
در PyTorch، گرادیانها بهصورت پیشفرض جمع میشوند. اگر این رفتار موردنظر نیست، باید پیش از هر مرحله پاک شوند.
ارزیابی فقط با Training Loss
کاهش خطای آموزش بهتنهایی نشاندهنده عملکرد مناسب روی داده جدید نیست.
استفاده از Test Set برای تنظیم مدل
Test Set باید برای ارزیابی نهایی نگه داشته شود. تنظیم Hyperparameter با Validation Set انجام میشود.
Shuffle نکردن داده آموزشی
ترتیب نامناسب داده میتواند جهت بهروزرسانیها را منحرف کند.
ذخیرهکردن آخرین مدل بهجای بهترین مدل
بهترین عملکرد اعتبارسنجی ممکن است چند Epoch پیش از پایان آموزش اتفاق افتاده باشد.
نادیدهگرفتن داده خراب
وجود مقدارهای نامعتبر، برچسب اشتباه یا نمونههای پرت میتواند Gradient را ناپایدار کند.
تغییر همزمان چند پارامتر
اگر Learning Rate، Batch Size، Optimizer و معماری را همزمان تغییر دهید، تشخیص علت بهبود یا افت دشوار میشود.
Gradient Descent در آموزش مدلهای زبانی
مدلهای زبانی بزرگ نیز با Optimizerهای مبتنی بر گرادیان آموزش میبینند. در هر مرحله، مدل تلاش میکند توکن بعدی یا خروجی موردنظر را بهتر پیشبینی کند و پارامترهای آن بر اساس خطا اصلاح میشوند.
آموزش یک مدل زبانی بزرگ از ابتدا به موارد زیر نیاز دارد:
- داده بسیار زیاد
- GPU یا شتابدهندههای متعدد
- حافظه بالا
- آموزش توزیعشده
- Checkpointing
- مدیریت خطا و بازیابی
- ارزیابی گسترده
- هزینه محاسباتی قابل توجه
برای بیشتر کسبوکارها، آموزش مدل پایه از ابتدا منطقی نیست. استفاده از یک مدل آماده از طریق API، RAG، Prompt Engineering یا Fine-tuning محدود معمولاً مسیر عملیتری است.
چه ارتباطی میان Gradient Descent و API درواره وجود دارد؟
کاربر API معمولاً Gradient Descent را مستقیماً اجرا نمیکند. مدلهای موجود قبلاً با فرایندهای بهینهسازی آموزش دیدهاند و از طریق API برای Inference در دسترس قرار میگیرند.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
یک درخواست ساده:
import os

from openai import OpenAI


client = OpenAI(
    api_key=os.environ[
        "DARVAREH_API_KEY"
    ],
    base_url=(
        "https://api.darvareh.ir/v1"
    ),
)

response = (
    client.chat.completions.create(
        model=os.environ[
            "DARVAREH_MODEL"
        ],
        messages=[
            {
                "role": "user",
                "content": (
                    "گرادیان نزولی را "
                    "با یک مثال ساده "
                    "توضیح بده."
                ),
            }
        ],
    )
)

print(
    response
    .choices[0]
    .message
    .content
)
استفاده از API به این معناست که کسبوکار میتواند از قابلیت مدل آموزشدیده استفاده کند، بدون اینکه زیرساخت آموزش آن را مدیریت کند.
چه زمانی مدل را آموزش دهیم و چه زمانی از API استفاده کنیم؟
| نیاز | مسیر مناسب |
|---|---|
| پیشبینی عددی با داده داخلی ساختاریافته | آموزش مدل سبک محلی |
| طبقهبندی ساده متن با داده کافی | مدل محلی مانند SGDClassifier |
| تولید متن و تحلیل پیچیده | مدل آماده از طریق API |
| پاسخ بر اساس اسناد اختصاصی | RAG همراه با مدل API |
| تغییر سبک و قالب خروجی | Prompt یا Fine-tuning محدود |
| ساخت مدل پایه از ابتدا | فقط با داده، سرمایه و تیم تخصصی کافی |
| نمونه اولیه سریع | استفاده از API درواره |
در بسیاری از محصولات، معماری ترکیبی بهترین انتخاب است. مدلهای کوچک و قطعی برای وظایف پرتکرار اجرا میشوند و مدلهای زبانی از طریق API برای مسائل پیچیدهتر استفاده میشوند.
پایش فرایند آموزش در Production
برای آموزشهای تکرارشونده، اطلاعات زیر را ثبت کنید:
- نسخه داده
- نسخه کد
- تنظیمات Optimizer
- Learning Rate
- Batch Size
- تعداد Epoch
- مقدار اولیه Seed
- معیارهای Train و Validation
- بهترین Checkpoint
- زمان و هزینه آموزش
- سختافزار استفادهشده
- نسخه کتابخانهها
- نتیجه ارزیابی نهایی
ابزارهای رایج برای ثبت آزمایشها عبارتاند از:
- MLflow
- Weights & Biases
- TensorBoard
- ClearML
- Aim
- DVC
ثبت آزمایشها کمک میکند نتایج قابل تکرار باشند و تیم بتواند دلیل تفاوت نسخههای مدل را پیدا کند.
چه زمانی Gradient Descent انتخاب مناسبی است؟
Gradient Descent زمانی مناسب است که:
- تابع خطا نسبت به پارامترها قابل بهینهسازی باشد.
- تعداد پارامترها زیاد باشد.
- داده در حجم بالا وجود داشته باشد.
- محاسبه مستقیم بهترین پارامترها دشوار باشد.
- مدل باید بهصورت مرحلهای آموزش ببیند.
- از شبکه عصبی یا مدل خطی بزرگ استفاده شود.
چه زمانی بهینهساز دیگری لازم است؟
Gradient Descent یک خانواده کلی از روشها است و نسخه مناسب آن به مسئله بستگی دارد.
ممکن است نیاز باشد موارد زیر را بررسی کنید:
- SGD با Momentum
- Adam
- AdamW
- RMSprop
- Adagrad
- Adafactor
- روشهای بدون گرادیان
- بهینهسازی بیزی
- الگوریتم ژنتیک
- Particle Swarm Optimization
برای تنظیم Hyperparameterهایی مانند Learning Rate، Batch Size یا تعداد لایهها، خود Gradient Descent همیشه کافی نیست. روشهایی مانند Grid Search، Random Search و Bayesian Optimization میتوانند مناسبتر باشند.
پرسشهای متداول
Gradient Descent چیست؟
Gradient Descent روشی برای کاهش خطای مدل از طریق اصلاح مرحلهای پارامترها در جهت مناسب است.
Gradient به چه معنا است؟
Gradient جهت و شدت تغییر خطا نسبت به پارامترهای مدل را نشان میدهد.
Learning Rate چیست؟
Learning Rate اندازه تغییر پارامترها در هر مرحله آموزش را کنترل میکند.
تفاوت SGD و Gradient Descent چیست؟
در Batch Gradient Descent تمام داده برای یک بهروزرسانی استفاده میشود، اما SGD از یک نمونه و Mini-batch از گروه کوچکی از نمونهها استفاده میکند.
Mini-batch چیست؟
Mini-batch بخشی از داده آموزشی است که در یک مرحله وارد مدل میشود و برای محاسبه گرادیان استفاده میشود.
Epoch چیست؟
یک Epoch یعنی مدل تمام داده آموزشی را یک بار مشاهده کرده است.
تفاوت Gradient Descent و Backpropagation چیست؟
Backpropagation گرادیانها را محاسبه میکند و Gradient Descent یا Optimizer از آنها برای اصلاح پارامترها استفاده میکند.
تفاوت SGD و Adam چیست؟
SGD از روش سادهتری برای بهروزرسانی استفاده میکند. Adam اندازه بهروزرسانی هر پارامتر را با توجه به سابقه گرادیانها تطبیق میدهد.
بهترین Learning Rate چقدر است؟
مقدار ثابتی برای همه مدلها وجود ندارد. این مقدار به Optimizer، معماری، Batch Size و داده بستگی دارد و باید با آزمایش انتخاب شود.
چرا Loss به NaN تبدیل میشود؟
Learning Rate بزرگ، داده نامعتبر، گرادیان انفجاری، عملیات عددی ناپایدار یا مقداردهی اولیه نامناسب میتوانند عامل باشند.
آیا برای استفاده از API هوش مصنوعی باید Gradient Descent بدانیم؟
برای ارسال درخواست به API لازم نیست، اما شناخت آن به درک آموزش، Fine-tuning، رفتار مدل و تنظیم مدلهای محلی کمک میکند.
جمعبندی
گرادیان نزولی یکی از پایههای آموزش مدلهای یادگیری ماشین و شبکههای عصبی است. این روش با محاسبه جهت کاهش خطا، پارامترهای مدل را بهصورت مرحلهای اصلاح میکند.
برای اجرای موفق Gradient Descent:
۱. تابع خطای متناسب با مسئله انتخاب کنید.
۲. Learning Rate را با دقت تنظیم کنید.
۳. دادههای عددی را در صورت نیاز استاندارد کنید.
۴. داده آموزشی را پس از تقسیم مناسب Shuffle کنید.
۵. Batch Size را با توجه به حافظه و پایداری انتخاب کنید.
۶. Training Loss و Validation Loss را همزمان پایش کنید.
۷. از Early Stopping و ذخیره بهترین Checkpoint استفاده کنید.
۸. برای گرادیانهای ناپایدار، Gradient Clipping را بررسی کنید.
۹. SGD، Momentum، Adam و AdamW را روی داده واقعی مقایسه کنید.
۱۰. نسخه داده، کد و تنظیمات آموزش را ثبت کنید.
اگر هدف شما ساخت یک محصول مبتنی بر هوش مصنوعی است، همیشه لازم نیست مدل بزرگی را از ابتدا آموزش دهید. میتوانید مدلهای سبک اختصاصی را برای وظایف محدود آموزش دهید و قابلیتهای پیشرفته تولید و تحلیل را از طریق API درواره به نرمافزار خود اضافه کنید.
مقالات مرتبط
- یادگیری ماشین چیست؟
- یادگیری عمیق چیست؟
- شبکه عصبی مصنوعی چیست؟
- رگرسیون خطی چیست؟
- رگرسیون لجستیک چیست؟
- الگوریتم SVM چیست؟
- بهینهسازی بیزی و Optuna
- PyTorch چیست؟
- آموزش استفاده از GPU برای هوش مصنوعی
- آموزش اتصال API هوش مصنوعی به نرمافزار
منابع
- راهنمای Stochastic Gradient Descent در Scikit-learn
- مستندات SGDClassifier
- مستندات SGDRegressor
- آموزش بهینهسازی پارامترها در PyTorch
- مستندات Optimizerهای PyTorch
- مستندات SGD در PyTorch
- مستندات Adam در PyTorch
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



