Self-RAG چیست؟ آموزش بازیابی، تولید و ارزیابی پاسخ با Python
Self-RAG چیست و چگونه درباره بازیابی، ارتباط منابع و پشتوانه پاسخ تصمیم میگیرد؟ در این راهنما، روش پژوهشی اصلی، تفاوت با RAG معمولی، محدودیت خودارزیابی و ساخت یک گردشکار مشابه با Python و API را بررسی میکنیم.

وجود چند سند در ورودی یک مدل زبانی، بهتنهایی پاسخ درست را تضمین نمیکند.
ممکن است موتور جستوجو سندی درباره محصول دیگری پیدا کرده باشد. ممکن است سند مرتبط باشد، اما پاسخ پرسش در آن وجود نداشته باشد. حتی با دریافت منبع مناسب، مدل میتواند شرایط مهم را حذف کند یا ادعایی بنویسد که از متن نتیجه نمیشود.
در یک سامانه RAG ساده، معمولاً پرسش دریافت میشود، چند قطعه بازیابی میشوند و مدل بر اساس آنها پاسخ میدهد. اما تصمیمهای مهمی در این مسیر باقی میمانند:
- آیا بازیابی برای این درخواست لازم است؟
- آیا منابع پیداشده به پرسش مربوطاند؟
- آیا منابع برای پاسخ کافی هستند؟
- آیا ادعاهای پاسخ از منابع پشتیبانی میشوند؟
- آیا پاسخ، نیاز کاربر را برآورده میکند؟
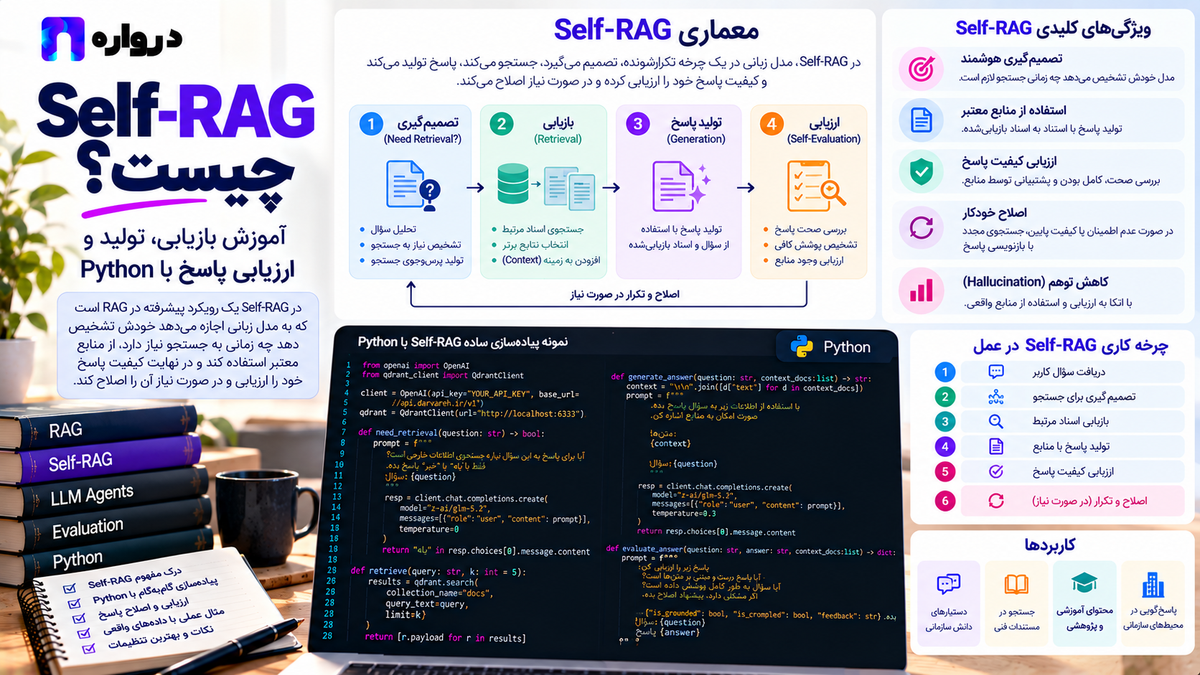
Self-RAG چارچوبی پژوهشی برای واردکردن تصمیم درباره بازیابی و ارزیابی به فرایند تولید متن است.
در این مقاله، ابتدا روش اصلی را توضیح میدهیم و سپس یک گردشکار آموزشی مبتنی بر API میسازیم که برخی از همین ایدهها را در سطح برنامه اجرا میکند.
Self-RAGچیست؟
Self-RAGمخفف Self-Reflective Retrieval-Augmented Generation است؛ یعنی تولید تقویتشده با بازیابی همراه با بازاندیشی.
در روش اصلی، مدل آموزش میبیند علاوه بر متن معمول، توکنهای ویژهای برای تصمیم درباره بازیابی و نقد منابع و خروجی تولید کند.
مقاله Self-RAG توسط Akari Asai و همکاران در سال ۲۰۲۳ منتشر و در ICLR 2024 ارائه شد. چارچوب آن، بازیابی در صورت نیاز و ارزیابی تولید را با مدل آموزشدیده ترکیب میکند. arxiv.org
در اینجا «بازاندیشی» یک سازوکار محاسباتی است. منظور، تولید نشانههای ارزیابی و استفاده از آنها برای هدایت فرایند تولید است.
تفاوت Self-RAG اصلی با چند درخواست نقد پاسخ
این تفاوت برای طراحی و نامگذاری سامانه اهمیت دارد.
در Self-RAG اصلی، رفتارهای بازیابی و ارزیابی با توکنهای ویژه در مدل آموزش داده میشوند. در یک برنامه مبتنی بر API، میتوان چند درخواست مستقل فرستاد: یکی برای ارزیابی منبع، یکی برای تولید پاسخ و دیگری برای نقد آن.
روش دوم میتواند مفید باشد، اما بازتولید کامل الگوریتم مقاله نیست.
| ویژگی | Self-RAG پژوهشی | گردشکار مبتنی بر API |
|---|---|---|
| تصمیمهای ارزیابی | توکنهای ویژه مدل | خروجی درخواستهای مستقل |
| نیاز به مدل آموزشدیده مخصوص | بله | الزاماً خیر |
| کنترل اجرا | تولید و امتیازدهی در مدل | منطق برنامه |
| اجرای ارزیابی | میتواند در سطح بخشهای پاسخ باشد | معمولاً روی متن یا منابع انتخابشده |
| دسترسی به احتمال توکنهای ویژه | در پیادهسازی مناسب | معمولاً در API عمومی فراهم نیست |
| هدف نمونه این مقاله | توضیح روش اصلی | آموزش یک طراحی الهامگرفته از آن |
کد عملی این مقاله یک گردشکار RAG با ارزیابی منابع و پاسخ است، نه پیادهسازی دقیق Self-RAG اصلی.
توکنهای بازاندیشی چه چیزی را ارزیابی میکنند؟
در Self-RAG، نشانههای مختلف برای جنبههای متفاوتی از فرایند استفاده میشوند.
| گروه | پرسش مورد بررسی |
|---|---|
Retrieve | آیا دریافت اطلاعات بیرونی مفید است؟ |
ISREL | آیا قطعه بازیابیشده مرتبط است؟ |
ISSUP | آیا متن تولیدشده از منبع پشتیبانی میشود؟ |
ISUSE | آیا خروجی در مجموع مفید است؟ |
در پیادهسازی رسمی، پارامترهایی برای تأکید بر ارتباط، پشتیبانی و کیفیت خروجی وجود دارد. آستانه بازیابی و تنظیمات جستوجوی بخشهای پاسخ نیز قابل تنظیماند. GitHub
این ارزیابیها معادل حقیقت قطعی نیستند. مدل میتواند در تشخیص ارتباط یا پشتوانه یک ادعا نیز اشتباه کند.
Self-RAGاصلی چگونه آموزش میبیند؟
در توضیح رسمی پروژه، ابتدا یک مدل منتقد برای تولید نشانههای ارزیابی آموزش داده میشود. سپس دادههای آموزشی با قطعات بازیابیشده و نشانههای بازاندیشی تکمیل میشوند.
مدل مولد روی این دادهها آموزش میبیند تا متن و نشانههای لازم را تولید کند. هنگام اجرا، این نشانهها برای کنترل بازیابی و انتخاب ادامههای پاسخ استفاده میشوند. selfrag.github.io
بنابراین، افزودن عبارتهایی مانند «پاسخ خودت را بررسی کن» به دستور یک مدل معمولی، همان فرایند آموزشی را ایجاد نمیکند.
اگر هدف بازتولید پژوهش است، باید مدلها، دادهها و تنظیمات رسمی را بررسی کنید. اگر هدف ساخت محصول است، میتوان یک گردشکار مستقل طراحی کرد و آن را با معیارهای همان محصول سنجید.
ارتباط منبع با کفایت منبع فرق دارد
فرض کنید پرسش این است:
آیا طرح سازمانی از ورود یکپارچه پشتیبانی میکند؟
سندی با عنوان «امکانات طرح سازمانی» مرتبط است، اما اگر فقط درباره تعداد کاربران توضیح دهد، پاسخ این پرسش را فراهم نمیکند.
سه مفهوم را جدا نگه دارید:
- ارتباط: سند به موضوع پرسش نزدیک است.
- کفایت: اطلاعات لازم برای پاسخ در منابع وجود دارد.
- پشتیبانی: ادعاهای پاسخ از منابع قابل استنتاجاند.
یک پاسخ میتواند با منابع سازگار باشد، اما بخشی از پرسش را بیپاسخ بگذارد. همچنین ممکن است پاسخ کامل به نظر برسد، ولی جزئیاتی بدون پشتوانه داشته باشد.
تفاوت Self-RAG باCorrective RAG
Corrective RAG یا CRAGنیز کیفیت بازیابی را بررسی میکند، اما چارچوب اصلی آن بر ارزیابی منابع و اقدام اصلاحی بر اساس نتیجه این ارزیابی تمرکز دارد.
در مقاله CRAG، یک ارزیاب بازیابی برای تعیین کیفیت نتایج و فعالکردن مسیرهای متفاوت دریافت دانش معرفی شده است. arxiv.org
Self-RAGاصلی، تصمیم درباره بازیابی و نقد تولید را از طریق رفتار آموزشدیده مدل وارد فرایند تولید میکند.
همچنین «CRAG» نام یک بنچمارک مستقل با عنوان Comprehensive RAG Benchmark نیز هست؛ این بنچمارک را نباید با الگوریتم Corrective RAG یکسان دانست. GitHub
آیا خودارزیابی مدل قابل اعتماد است؟
خودارزیابی میتواند یک ابزار کمکی باشد، اما تضمین اصلاح خطا نیست.
پژوهش «Large Language Models Cannot Self-Correct Reasoning Yet» نشان داده است که در آزمایشهای استدلالی بررسیشده، خوداصلاحی بدون بازخورد بیرونی همیشه موفق نبوده و گاهی عملکرد را کاهش داده است.
این نتیجه را نباید به تمام مدلها و وظایف تعمیم داد، اما فرض «نقد بیشتر همیشه پاسخ بهتر میسازد» را زیر سؤال میبرد. arxiv.org
برای کاربرد عملی، نقد را به شواهد مشخص متصل کنید. بهجای «آیا پاسخ خوب است؟» بپرسید:
- کدام ادعا پشتیبانی نمیشود؟
- کدام شرط حذف شده است؟
- کدام بخش پرسش بیپاسخ مانده است؟
- کدام منبع، ادعای موردنظر را پشتیبانی میکند؟
حتی با این پرسشها، عملکرد ارزیاب باید روی نمونههای برچسبخورده سنجیده شود.
معماری نمونه آموزشی
در نمونه این مقاله، درخواستها درباره اسناد سازمانی هستند؛ بنابراین، بازیابی را الزامی در نظر میگیریم.
گردشکار این مراحل را دارد:
- دریافت منابع از بازیاب
- ارزیابی کفایت منابع
- تولید پاسخ
- بررسی پشتیبانی پاسخ
- در صورت نیاز، یک بار اصلاح پرسش جستوجو
- توقف با پاسخ پذیرفتهشده یا اعلام کمبود شواهد
این طراحی دو محدودیت عمدی دارد: تعداد تلاشها محدود است و پذیرش مدل منتقد، تأیید قطعی صحت تلقی نمیشود.
آموزش عملی با Python و API درواره
نصب کتابخانهها:
pip install openai pydanticتنظیم متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_CHAT_MODEL="YOUR_CHAT_MODEL_ID"
شناسه مدل را از مدلهای پشتیبانیشده انتخاب کنید. نمونه زیر از خروجی JSON در متن استفاده میکند و به پشتیبانی اختصاصی از Structured Outputs وابسته نیست.
ساخت کلاینت و تابع درخواست
import json
import os
from typing import Callable

from openai import OpenAI
from pydantic import BaseModel, ConfigDict, StrictBool


client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)


def ask_model(
    instruction: str,
    payload: dict,
) -> str:
    response = client.chat.completions.create(
        model=os.environ["DARVAREH_CHAT_MODEL"],
        messages=[
            {
                "role": "system",
                "content": instruction,
            },
            {
                "role": "user",
                "content": json.dumps(
                    payload,
                    ensure_ascii=False,
                ),
            },
        ],
    )

    content = (
        response.choices[0].message.content or ""
    ).strip()

    if not content:
        raise ValueError(
            "The model returned an empty response"
        )

    return content
در این نمونه، مدل مولد و ارزیاب یکساناند. در ارزیابیهای بعدی میتوان مدل دیگری برای داوری آزمایش کرد، اما صرف متفاوتبودن مدل، خطای ارزیابی را حذف نمیکند.
تعریف خروجی ارزیابی
class EvidenceAssessment(BaseModel): model_config = ConfigDict( extra="forbid" ) sufficient: StrictBool supporting_ids: list[str] missing_information: list[str]class AnswerAssessment(BaseModel): model_config = ConfigDict( extra="forbid" ) supported: StrictBool issues: list[str]استفاده از نوع سختگیرانه برای مقدارهای منطقی کمک میکند خروجیهایی مانند رشته "true" با مقدار واقعی JSON اشتباه نشوند.
اعتبارسنجی ساختار، فقط قالب خروجی را بررسی میکند. تشخیص معنایی مدل ممکن است همچنان نادرست باشد.
ارزیابی کفایت منابع
def assess_evidence( question: str, sources: list[dict],) -> EvidenceAssessment: raw = ask_model( instruction=( "کفایت منابع برای پاسخ به پرسش را بررسی کن. " "فقط از متن منابع استفاده کن. " "ارتباط موضوعی بهتنهایی کافی نیست. " "اگر اطلاعات ضروری وجود ندارد، " "sufficient را false قرار بده. " "فقط JSON با این فیلدها برگردان: " "sufficient، supporting_ids، " "missing_information. " "شناسهها باید از منابع موجود باشند." ), payload={ "question": question, "sources": sources, }, ) assessment = ( EvidenceAssessment.model_validate_json(raw) ) available_ids = { source["id"] for source in sources } if not set( assessment.supporting_ids ).issubset(available_ids): raise ValueError( "The evaluator returned unknown source IDs"این تابع مانع استفاده از شناسه ساختگی میشود، اما وجود شناسه معتبر ثابت نمیکند متن آن منبع واقعاً پاسخ را پشتیبانی میکند.
تولید پاسخ از منابع منتخب
def generate_answer(
question: str,
sources: list[dict],
) -> str:
return ask_model(
instruction=(
"فقط بر اساس منابع ارائهشده پاسخ بده. "
"شرایط و استثناهای مرتبط را حفظ کن. "
"برای ادعاهای مبتنی بر منبع، "
"شناسه منبع را در کروشه بیاور. "
"اطلاعات غایب را با حدس تکمیل نکن."
),
payload={
"question": question,
"sources": sources,
},
)در پروژه واقعی، اطلاعات نسخه و محل متن در سند را نیز همراه هر منبع نگه دارید تا استناد قابل بررسی باشد.
نقد پاسخ با تکیه بر منابع
def assess_answer( question: str, answer: str, sources: list[dict],) -> AnswerAssessment: raw = ask_model( instruction=( "پاسخ را با منابع تطبیق بده. " "ادعاهای بدون پشتوانه، تناقضها، " "شرایط حذفشده و بخشهای بیپاسخ پرسش " "را بررسی کن. " "وجود استناد بهتنهایی کافی نیست. " "فقط JSON با دو فیلد برگردان: " "supported و issues. " "اگر ایراد مهمی وجود دارد، " "supported را false قرار بده." ), payload={ "question": question, "answer": answer, "sources": sources, }, ) assessment = ( AnswerAssessment.model_validate_json(raw) ) if assessment.supported and assessment.issues: raise ValueError( "The assessment contains conflicting fields" ) return assessmentاین بررسی، یک داوری مدلمحور است. نام supported در خروجی به معنی آن است که ارزیاب پاسخ را پذیرفته؛ نباید آن را برچسب حقیقت قطعی دانست.
اصلاح پرسش جستوجو
اگر منابع کافی نیستند، میتوان جستوجو را با صورت دقیقتری از پرسش تکرار کرد.
def rewrite_search_query( question: str, feedback: list[str],) -> str: return ask_model( instruction=( "یک عبارت جستوجوی دقیقتر بساز. " "معنای پرسش، نامها، اعداد و شرایط آن " "را حفظ کن. " "از بازخورد برای تمرکز جستوجو استفاده کن، " "اما ادعای تازه نساز. " "فقط عبارت جستوجو را برگردان." ), payload={ "original_question": question, "feedback": feedback, }, )پرسش اصلی برای پاسخگویی ثابت میماند. بازنویسی فقط ورودی موتور جستوجو را تغییر میدهد.
اگر مشکل، نبودن اطلاعات در پایگاه دانش باشد، بازنویسی الزاماً کمکی نمیکند.
اجرای گردشکار با حداکثر دو تلاش
تابع زیر بازیاب را بهعنوان ورودی میگیرد. بازیاب واقعی میتواند جستوجوی برداری، BM25 یا ترکیبی از آنها باشد.
def run_reflective_rag(
question: str,
retrieve: Callable[[str], list[dict]],
max_attempts: int = 2,
) -> dict:
if max_attempts < 1:
raise ValueError(
"max_attempts must be positive"
)
search_query = question
trace = []
for attempt in range(max_attempts):
sources = retrieve(search_query)
trace.append({
"stage": "retrieval",
"attempt": attempt + 1,
"query": search_query,
"source_ids": [
source["id"]
for source in sources
],
})
if not sources:
feedback = [
"هیچ منبعی بازیابی نشده است."
]
else:
evidence = assess_evidence(
question,
sources,
)
trace.append({
"stage": "evidence_assessment",
**evidence.model_dump(),
})
if evidence.sufficient:
supporting_ids = set(
evidence.supporting_ids
)
selected_sources = [
source
for source in sources
if source["id"] in supporting_ids
]
answer = generate_answer(
question,
selected_sources,
)
critique = assess_answer(
question,
answer,
selected_sources,
)
trace.append({
"stage": "answer_assessment",
**critique.model_dump(),
})
if critique.supported:
return {
"status": "accepted_by_evaluator",
"answer": answer,
"sources": selected_sources,
"trace": trace,
}
feedback = critique.issues
else:
feedback = (
evidence.missing_information
)
if attempt + 1 < max_attempts:
search_query = rewrite_search_query(
question,
feedback,
)
return {
"status": "insufficient_evidence",
"answer": (
"شواهد کافی برای ارائه پاسخ قابل اتکا "
"در منابع بازیابیشده پیدا نشد."
),
"sources": [],
"trace": trace,
}اگر مدل JSON نامعتبر تولید کند، اعتبارسنجی خطا میدهد. در محصول واقعی، این حالت را بهعنوان خطای پردازش مدیریت کنید؛ آن را پاسخ پذیرفتهشده یا نبود اطلاعات در منبع تلقی نکنید.
همچنین اگر منابع انتخابشده بخشی از شواهد لازم را کنار بگذارند، پاسخ ممکن است ناقص شود. انتخاب منبع توسط ارزیاب نیز باید در آزمایشها بررسی شود.
اتصال به بازیاب موجود
قرارداد ساده بازیاب در این مثال چنین است:
def retrieve_from_your_index(
    query: str,
) -> list[dict]:
    # این بخش را به نمایه واقعی خود متصل کنید.
    # هر نتیجه باید شناسه و متن منبع داشته باشد.
    raise NotImplementedError
نمونه شکل خروجی:
[
{
"id": "subscription-v1:refund",
"text": (
"بازگشت وجه فقط تا هفت روز پس از خرید "
"و پیش از شروع استفاده امکانپذیر است."
),
},
{
"id": "subscription-v1:cancel",
"text": (
"ثبت درخواست لغو، بهتنهایی "
"به معنی تأیید بازگشت وجه نیست."
),
},
]این متنها فرضیاند. بهجای آنها باید خروجی واقعی جستوجوی اسناد خود را برگردانید.
اجرای گردشکار:
result = run_reflective_rag(
question=(
"اگر از سرویس استفاده کرده باشم، "
"با لغو اشتراک مبلغ برمیگردد؟"
),
retrieve=retrieve_from_your_index,
max_attempts=2,
)هزینه و زمان پاسخ
افزودن ارزیابی، تعداد درخواستها را افزایش میدهد.
در مسیر موفق نمونه بالا، علاوه بر بازیابی، سه درخواست مدل داریم:
- بررسی منابع
- تولید پاسخ
- نقد پاسخ
تلاش دوم و بازنویسی میتوانند هزینه بیشتری ایجاد کنند. بنابراین، این طراحی را برای همه درخواستها بدون مقایسه به کار نبرید.
روشهای قابل آزمایش برای کنترل هزینه عبارتاند از:
- اجرای نقد فقط برای پاسخهای دارای ادعاهای مهم
- استفاده از مدل کوچکتر برای ارزیابی ساده
- محدودکردن تعداد منابع
- تعیین سقف تلاش و زمان کل
- بررسی جداگانه کیفیت هر مدل ارزیاب
کاهش هزینه زمانی ارزش دارد که افت کیفیت قابل قبول و اندازهگیریشده باشد.
چگونه Self-RAG و گردشکار مشابه را ارزیابی کنیم؟
نتیجه را با یک RAG ساده و تنظیمات یکسان مقایسه کنید.
این حالتها کمک میکنند اثر مراحل مشخص شود:
| حالت | هدف |
|---|---|
| RAG ساده | خط مبنا |
| RAG همراه ارزیابی منابع | اثر بررسی پیش از تولید |
| RAG همراه نقد پاسخ | اثر بررسی پس از تولید |
| گردشکار با یک تلاش مجدد | اثر اصلاح بازیابی |
| مدل Self-RAG آموزشدیده | ارزیابی روش پژوهشی در محیط مناسب |
معیارها باید چند جنبه را پوشش دهند:
- درستی پاسخ
- کاملبودن پاسخ
- سازگاری با منابع
- صحت استناد
- نرخ پاسخهای نادرستِ پذیرفتهشده
- نرخ رد پاسخهای درست
- زمان و هزینه هر پاسخ
معیار Faithfulness در Ragas، سازگاری ادعاهای پاسخ با زمینه بازیابیشده را بررسی میکند. این معیار با درستبودن منبع در جهان واقعی یا کاملبودن پاسخ یکسان نیست. Ragas
ارزیابی مدل منتقد روی فارسی
ارزیاب باید با پاسخهای درست و خطادار فارسی آزمایش شود.
نمونههای خطا میتوانند شامل این موارد باشند:
- حذف واژه «فقط»
- تغییر «هفت روز» به «ده روز»
- اشتباهگرفتن نام دو محصول
- تبدیل امکان مشروط به حکم عمومی
- استناد به منبع مرتبط اما ناکافی
- پاسخدادن به یک بخش از پرسش چندبخشی
برای هر نمونه، برچسب انسانی داشته باشید. سپس بررسی کنید مدل کدام خطاها را میبیند و کدام را تأیید میکند.
این ارزیابی مهمتر از آن است که صرفاً تعداد زیادی نقد تولید شود.
اشتباهات رایج
معرفی حلقه نقد بهعنوان Self-RAG اصلی
روش پژوهشی به رفتار آموزشدیده و توکنهای ویژه متکی است. نامگذاری دقیق، مقایسه فنی را روشنتر میکند.
تلقی امتیاز ارزیاب بهعنوان احتمال صحت
عدد یا برچسب مدل بدون کالیبراسیون، احتمال قابل اتکای درستبودن نیست.
تکرار تا زمان تأیید
تلاش نامحدود میتواند هزینه ایجاد کند و در نهایت فقط پاسخی پیدا کند که ارزیاب آن را میپسندد.
تغییر پرسش اصلی هنگام بازنویسی
اگر شرط یا نام مهم حذف شود، سامانه ممکن است به پرسش دیگری پاسخ دهد.
اعتماد به وجود استناد
شناسه معتبر، پشتوانه معنایی ادعا را ثابت نمیکند.
ارزیابی فقط پاسخهای پذیرفتهشده
ردهای اشتباه نیز اهمیت دارند. سامانهای که تقریباً همه پرسشها را رد میکند، الزاماً سامانه خوبی نیست.
پرسشهای متداول
Self-RAGچیست؟
چارچوبی است که مدل را برای تصمیم درباره بازیابی، تولید متن و ارزیابی منابع و خروجی با توکنهای ویژه آموزش میدهد.
آیا Self-RAG به آموزش نیاز دارد؟
روش اصلی بله. یک گردشکار الهامگرفته از آن را میتوان با درخواستهای مستقل API ساخت.
آیا Self-RAG خطای مدل را حذف میکند؟
خیر. ارزیابی منابع و پاسخ نیز ممکن است خطا داشته باشد.
آیا نقد پاسخ توسط همان مدل کافی است؟
کافیبودن آن باید روی داده واقعی سنجیده شود. استفاده از همان مدل ممکن است خطاهای مشترک ایجاد کند.
آیا منابع مرتبط همیشه برای پاسخ کافیاند؟
خیر. ارتباط موضوعی با وجود اطلاعات لازم تفاوت دارد.
تفاوت Self-RAG و CRAG چیست؟
Self-RAG اصلی تصمیم و نقد را در رفتار آموزشدیده مدل وارد میکند. Corrective RAGبر ارزیابی بازیابی و اقدام اصلاحی تمرکز دارد.
آیا برای فارسی مناسب است؟
امکان استفاده وجود دارد، اما عملکرد مدل مولد، بازیاب و ارزیاب باید جداگانه روی فارسی بررسی شود.
چه زمانی باید تلاش مجدد متوقف شود؟
با رسیدن به سقف تلاش، زمان یا هزینه، یا زمانی که شواهد کافی فراهم نمیشوند.
جمعبندی
Self-RAGنشان میدهد بازیابی، تولید و ارزیابی را میتوان بهصورت تصمیمهای مرتبط در نظر گرفت.
روش اصلی از مدل آموزشدیده و توکنهای بازاندیشی استفاده میکند. در معماری مبتنی بر API نیز میتوان برخی ایدههای آن را با بررسی منابع، نقد پاسخ و اصلاح محدود جستوجو اجرا کرد.
ارزش این مراحل با تعداد نقدها مشخص نمیشود؛ باید نشان دهند خطاهای واقعی کمتر شدهاند و هزینه و تأخیر اضافه، برای کاربرد موردنظر قابل قبول است.
مقالات مرتبط
- RAGچیست؟
- ارزیابی بازیابی و تولید پاسخ درRAG
- Contextual Retrievalو بازیابی زمینهمند
- Parent Document Retrievalو بازیابی والد و فرزند
- جستوجوی ترکیبی با BM25 و بردار
- Reranking و Cross-Encoder
- HyDEو جستوجو با سند فرضی
منابع
- مقاله اصلیSelf-RAG
- وبسایت رسمی پژوهشSelf-RAG
- کد، مدلها و راهنمای رسمیSelf-RAG
- مقالهCorrective Retrieval Augmented Generation
- مقاله محدودیت خوداصلاحی مدلهای زبانی
- مستندات معیار Faithfulness درRagas
- Comprehensive RAG Benchmark
- مستندات API درواره
ساخت گردشکار ارزیابی پاسخ با درواره
برای آزمایش این معماری، میتوانید از مدلهای پشتیبانیشده درواره برای تولید پاسخ، بررسی منابع و نقد خروجی استفاده کنید. اگر بازیابی شما برداری است، مدل Embedding نیز میتواند بخشی از همین مسیر باشد.
با مجموعهای از پرسشهای فارسی و پاسخهای بررسیشده شروع کنید. مدلهای مولد و ارزیاب را از نظر کیفیت، هزینه و زمان مقایسه کنید و فقط مراحلی را نگه دارید که بهبود قابل اندازهگیری ایجاد میکنند.
برای بررسی مدلها و شروع استفاده از API هوش مصنوعی، به درواره مراجعه کنید.
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.