
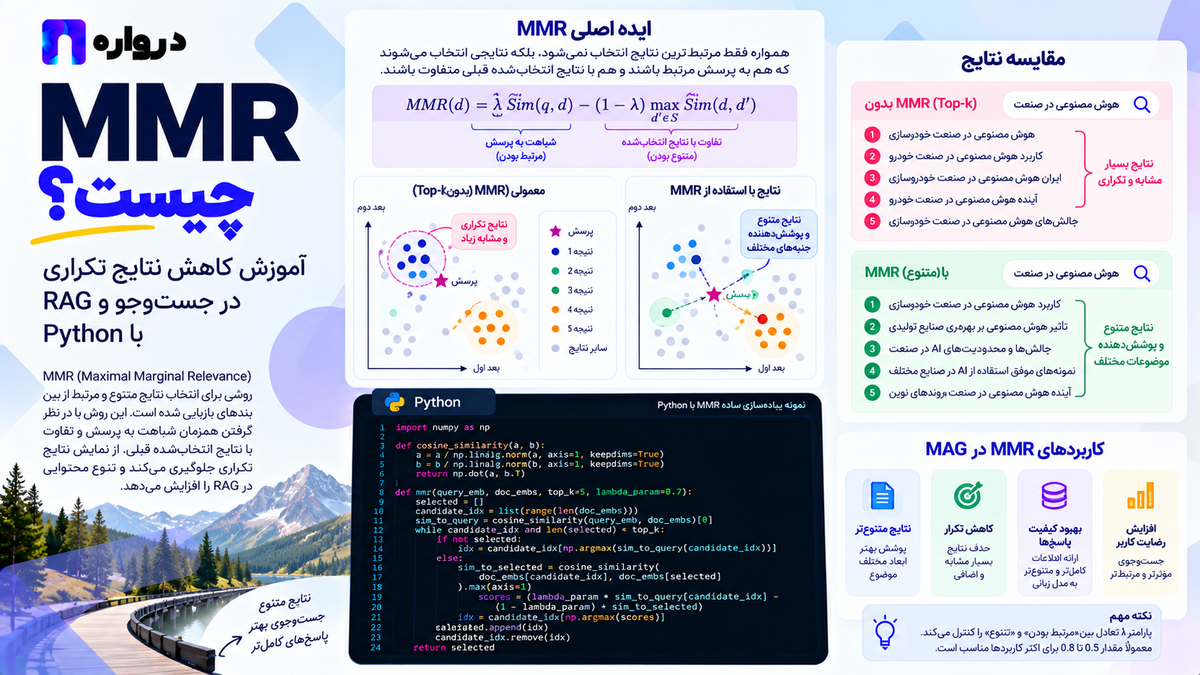
MMR چیست؟ آموزش کاهش نتایج تکراری در جستوجو و RAG با Python
MMR چیست و چگونه نتایج تکراری جستوجو را کاهش میدهد؟ در این راهنما، تعادل ارتباط و تنوع، تفاوت با Reranking، انتخاب پارامترها و پیادهسازی عملی برای جستوجوی فارسی و RAG با Python را میآموزید.

فرض کنید از یک سامانه جستوجو میخواهید روشهای کاهش تأخیر API را پیدا کند. پنج نتیجه اول، همگی یک توضیح مشابه درباره کوتاهکردن خروجی هستند.
این نتایج ممکن است مرتبط باشند، اما در کنار هم اطلاعات تازهای ارائه نمیکنند. موضوعاتی مانند انتخاب مدل، پردازش همزمان یا زمان انتظار در صف، از فهرست کنار ماندهاند.
در سامانه RAG نیز همین مسئله رخ میدهد: چند قطعه مشابه وارد ورودی مدل زبانی میشوند، اما بخشی از شواهد لازم برای پاسخ کامل حضور ندارد.
MMR یا Maximal Marginal Relevance روشی برای انتخاب نتایج است که دو عامل را همزمان بررسی میکند:
- ارتباط نتیجه با پرسش؛
- شباهت نتیجه به مواردی که قبلاً انتخاب شدهاند.
هدف، ساخت مجموعهای مرتبط با تکرار کمتر است. این ایده در پژوهشهای Carbonell و Goldstein درباره بازیابی و خلاصهسازی مطرح شد. ACL Anthology
در این مقاله، سازوکار MMR، محدودیتهای آن، تفاوت با بازرتبهبندی و پیادهسازی عملی با Python را بررسی میکنیم.
MMRچیست؟
MMRیک الگوریتم انتخاب تدریجی است.
ابتدا مرتبطترین نامزد انتخاب میشود. سپس الگوریتم برای انتخاب نتیجه بعدی، هم ارتباط آن با پرسش و هم میزان تکرار نسبت به نتایج منتخب را در نظر میگیرد.
سندی که بسیار مرتبط است اما تقریباً همان اطلاعات نتیجه قبلی را دارد، ممکن است جای خود را به سندی بدهد که کمی ارتباط کمتر و اطلاعات متفاوتتری دارد.
مستندات Qdrant همین سازوکار را بهصورت انتخاب مرحلهای با تعادل ارتباط و فاصله از نتایج قبلی توضیح میدهد. Qdrant
MMRمعمولاً روی مجموعهای از نامزدهای بازیابیشده اجرا میشود. بنابراین وظیفه آن در این طراحی، انتخاب بهتر از میان نامزدهاست.
چرا نتایج جستوجو تکراری میشوند؟
چند علت رایج وجود دارد:
- نسخههای تکراری یک سند؛
- قطعههای همپوشان از یک متن؛
- چند صفحه با توضیح تقریباً یکسان؛
- شباهت معنایی بالای یک دسته از اسناد؛
- وجود تعداد زیادی نمونه درباره یک جنبه از موضوع.
برای مثال، یک راهنمای طولانی ممکن است به قطعههایی با همپوشانی زیاد تقسیم شود. جستوجوی برداری چند قطعه مجاور را در رتبههای اول قرار میدهد.
هر قطعه بهتنهایی مرتبط است، اما انتخاب همه آنها ممکن است فضای کافی برای یک بخش مکمل باقی نگذارد.
پیش از افزودن MMR، بررسی کنید آیا حذف نسخههای تکراری یا اصلاح قطعهبندی، مسئله را سادهتر حل میکند.
تفاوت Top-K وMMR
در انتخاب ساده Top-K، نتایج با بیشترین امتیاز ارتباط انتخاب میشوند.
در MMR، ارزش یک نامزد به مواردی که قبلاً انتخاب شدهاند نیز وابسته است.
| معیار | Top-K بر اساس شباهت | MMR |
|---|---|---|
| توجه به پرسش | دارد | دارد |
| توجه به نتایج منتخب | معمولاً ندارد | دارد |
| رفتار با نتایج مشابه | ممکن است همه را انتخاب کند | شباهت را جریمه میکند |
| ترتیب انتخاب | بر اساس امتیاز ثابت | وابسته به مراحل قبلی |
| هدف | بیشترین ارتباط فردی | تعادل ارتباط و تکرار کمتر |
بهتر بودن MMR به هدف بستگی دارد.
اگر کاربر یک پاسخ دقیق درباره یک بند مشخص میخواهد، چند قطعه مجاور ممکن است ضروری باشند. اگر درخواست چند جنبه دارد، کاهش تکرار میتواند ارزش بیشتری داشته باشد.
MMRچگونه امتیاز میدهد؟
در پیادهسازی رایج، برای هر نامزد دو مقدار محاسبه میشود:
- شباهت به پرسش؛
- بیشترین شباهت به یکی از نتایج منتخب.
سپس ارتباط با پرسش امتیاز مثبت و شباهت به نتایج قبلی جریمه ایجاد میکند.
استفاده از بیشترین شباهت مهم است. یک نامزد ممکن است با بیشتر نتایج تفاوت داشته باشد، اما تقریباً تکرار یک نتیجه باشد. همین شباهت زیاد میتواند در انتخاب آن اثر بگذارد.
این معیار، الگوریتم را به یک انتخاب تدریجی تبدیل میکند؛ نه مرتبسازی یکباره با امتیازهای ثابت.
پارامتر Lambda چه نقشی دارد؟
در قرارداد رایج MMR، پارامتر lambda_mult میان صفر و یک قرار دارد.
| مقدار | رفتار مورد انتظار |
|---|---|
| نزدیک یک | تأکید بیشتر بر ارتباط با پرسش |
| حدود میانه | توجه همزمان به ارتباط و تکرار |
| نزدیک صفر | تأکید بیشتر بر تفاوت از نتایج منتخب |
پیادهسازی رسمی Elastic نیز از همین ترکیب ارتباط و جریمه شباهت استفاده میکند. GitHub
مقدار میانه، انتخاب قطعی و عمومی نیست. یک تنظیم مناسب برای مرور مقالات ممکن است برای یافتن بند دقیق قرارداد یا مستندات مناسب نباشد.
قرارداد نام پارامتر را بررسی کنید
بعضی ابزارها پارامتری با نام diversity دارند که جهت آن معکوس Lambda است.
در Qdrant، مقدار بیشتر diversity به معنای تأکید بیشتر بر تنوع است. بنابراین دو مقدار عددی یکسان در دو قرارداد، الزاماً رفتار یکسان ندارند. Qdrant
تفاوت MMR و حذف متن تکراری
حذف تکرار دقیق، متنها یا شناسههای یکسان را کنار میگذارد.
MMRمیتواند شباهت معنایی را بررسی کند؛ حتی وقتی متن دو نتیجه یکسان نیست.
| وضعیت | اقدام قابلآزمایش |
|---|---|
| یک فایل دوبار وارد شده | حذف تکرار با شناسه یا اثر انگشت |
| متن یکسان با عنوان متفاوت | حذف تکرار متنی |
| بیان متفاوت از اطلاعات مشابه | بررسی شباهت و MMR |
| قطعات مکمل یک سند | حفظ زمینه و ارزیابی انتخاب |
این روشها مکمل یکدیگرند.
MMRنباید راهی برای پنهانکردن مشکل ورود داده تکراری باشد. ابتدا کیفیت داده را اصلاح کنید و سپس تنوع انتخاب را بسنجید.
تفاوت MMR وCross-Encoder Reranking
یک Cross-Encoder معمولاً ارتباط هر جفت پرسش و سند را ارزیابی میکند.
MMRارتباط را در کنار شباهت به مجموعه منتخب بررسی میکند.
| معیار | بازرتبهبندی ارتباط | MMR |
|---|---|---|
| سؤال اصلی | این سند چقدر به پرسش مرتبط است؟ | این سند چقدر مرتبط و غیرتکراری است؟ |
| وابستگی به نتایج قبلی | معمولاً ندارد | دارد |
| نیاز به مدل جدید | به روش وابسته است | الگوریتم بهتنهایی ندارد |
| کاربرد | اصلاح ترتیب ارتباط | انتخاب مجموعه با تکرار کمتر |
میتوان ابتدا ارتباط را با یک مدل بهتر سنجید و سپس انتخاب متنوع انجام داد. اما مقیاس امتیاز ارتباط و شباهت بین اسناد باید هماهنگ یا تنظیم شود.
در نمونه این مقاله، برای هر دو مقایسه از شباهت کسینوسی استفاده میکنیم.
پیادهسازی MMR باNumPy
این بخش به دانلود مدل یا فراخوانی API نیاز ندارد.
pip install numpyابتدا تابع نرمالسازی:
import numpy as np


def normalize_rows(vectors):
    vectors = np.asarray(
        vectors,
        dtype=np.float32,
    )

    if vectors.ndim != 2:
        raise ValueError("Expected a 2D matrix.")

    if not np.isfinite(vectors).all():
        raise ValueError("Vectors must be finite.")

    norms = np.linalg.norm(
        vectors,
        axis=1,
        keepdims=True,
    )

    if np.any(norms <= 1e-12):
        raise ValueError("Zero-length vector.")

    return vectors / norms
سپس الگوریتم:
def mmr_select(
    query_vector,
    candidate_vectors,
    k=3,
    lambda_mult=0.5,
):
    if not 0.0 <= lambda_mult <= 1.0:
        raise ValueError("lambda_mult must be between 0 and 1.")

    if k <= 0:
        return []

    candidates = normalize_rows(candidate_vectors)

    if len(candidates) == 0:
        return []

    query = normalize_rows(
        np.asarray(query_vector).reshape(1, -1)
    )[0]

    if candidates.shape[1] != query.shape[0]:
        raise ValueError("Embedding dimensions do not match.")

    relevance = candidates @ query

    first = int(np.argmax(relevance))
    selected = [first]

    redundancy = candidates @ candidates[first]
    available = np.ones(len(candidates), dtype=bool)
    available[first] = False

    while len(selected) < min(k, len(candidates)):
        selection_scores = (
            lambda_mult * relevance
            - (1.0 - lambda_mult) * redundancy
        )

        selection_scores[~available] = -np.inf

        next_index = int(np.argmax(selection_scores))
        selected.append(next_index)
        available[next_index] = False

        redundancy = np.maximum(
            redundancy,
            candidates @ candidates[next_index],
        )

    return selected
تابع، شماره ردیفهای منتخب را برمیگرداند.
در این پیادهسازی، بیشترین شباهت به نتایج قبلی بهصورت تدریجی بهروزرسانی میشود. ماتریس کامل شباهت تمام جفتهای نامزدها ساخته نمیشود.
مثال عددی: نتیجه مشابه یا نتیجه مکمل؟
چهار بردار ساختگی در نظر میگیریم:
query = np.array([1.0, 0.0, 0.0])

vectors = np.array([
    [0.95, 0.31, 0.00],
    [0.94, 0.34, 0.00],
    [0.85, 0.00, 0.53],
    [0.00, 0.00, 1.00],
])

normalized = normalize_rows(vectors)

top_k = np.argsort(
    -(normalized @ query),
    kind="stable",
)[:2]

mmr_indices = mmr_select(
    query,
    vectors,
    k=2,
    lambda_mult=0.5,
)

print("Top-K:", top_k.tolist())
print("MMR:", mmr_indices)
خروجی:
Top-K: [0, 1]
MMR: [0, 2]
بردارهای صفر و یک بسیار شبیهاند. انتخاب ساده، هر دو را برمیدارد. MMR پس از انتخاب بردار صفر، بردار دوم را انتخاب میکند که نسبت به نتیجه قبلی متفاوتتر است.
این بردارها معنای واقعی متن ندارند؛ فقط سازوکار الگوریتم را نشان میدهند.
استفاده از MMR برای متن فارسی
برای مثال فارسی، باید متنها را به Embedding تبدیل کنیم.
میتوانید از مدل محلی مناسب یا API مدل Embedding استفاده کنید. مدل و پردازش آن باید برای پرسش و اسناد سازگار باشند.
نصب کتابخانه:
pip install openai numpyمتغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_EMBEDDING_MODEL="YOUR_EMBEDDING_MODEL_ID"
تعریف اسناد آموزشی
documents = [
{
"id": "output_a",
"text": (
"کاهش طول خروجی مدل میتواند زمان "
"تکمیل پاسخ را کاهش دهد."
),
},
{
"id": "output_b",
"text": (
"برای کوتاهتر شدن زمان تولید پاسخ، "
"از مدل خروجی مختصر بخواهید."
),
},
{
"id": "model",
"text": (
"مدلهای مختلف سرعت و کیفیت متفاوتی "
"دارند. مدل مناسب را با داده واقعی "
"و معیار یکسان مقایسه کنید."
),
},
{
"id": "stream",
"text": (
"نمایش جریانی پاسخ میتواند زمان "
"انتظار تا مشاهده اولین بخش خروجی "
"را کاهش دهد، بدون تضمین کاهش "
"زمان تکمیل کل پاسخ."
),
},
{
"id": "invoice",
"text": (
"فاکتور خرید از بخش صورتحسابهای "
"حساب کاربری دریافت میشود."
),
},
]
question = "چه روشهایی برای کاهش انتظار پاسخ API وجود دارد؟"دو سند اول نزدیکاند. سند سوم و چهارم جنبههای دیگری را پوشش میدهند.
این مجموعه ساختگی است و برای آموزش استفاده میشود.
دریافت بردارها
import os

from openai import OpenAI


client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)

embedding_model = os.environ[
    "DARVAREH_EMBEDDING_MODEL"
]


def embed(texts):
    response = client.embeddings.create(
        model=embedding_model,
        input=texts,
    )

    ordered = sorted(
        response.data,
        key=lambda item: item.index,
    )

    if len(ordered) != len(texts):
        raise ValueError("Unexpected embedding count.")

    return normalize_rows([
        item.embedding
        for item in ordered
    ])


document_vectors = embed([
    item["text"]
    for item in documents
])

query_vector = embed([question])[0]
اگر مدل به پیشوند یا گزینه مخصوص پرسش و سند نیاز دارد، این تابع را مطابق مستندات همان مدل تنظیم کنید.
ابتدا نامزدها را بازیابی کنید
MMRرا در این مثال روی چهار نتیجه اول اجرا میکنیم:
relevance_scores = document_vectors @ query_vector

candidate_indices = np.argsort(
    -relevance_scores,
    kind="stable",
)[:4]

candidate_vectors = document_vectors[
    candidate_indices
]

selected_local_indices = mmr_select(
    query_vector,
    candidate_vectors,
    k=3,
    lambda_mult=0.6,
)

selected_document_indices = [
    int(candidate_indices[index])
    for index in selected_local_indices
]

for index in selected_document_indices:
    print(
        documents[index]["id"],
        round(float(relevance_scores[index]), 4),
        documents[index]["text"],
    )
نتیجه واقعی به مدل Embedding وابسته است؛ نباید ترتیب مثال را از پیش تضمین کرد.
تفاوت دو تعداد را حفظ کنید:
- تعداد نامزدها: ورودی MMR؛
- تعداد منتخبها: خروجی نهایی.
اگر فقط سه نامزد بگیرید و هر سه را انتخاب کنید، آزادی کمی برای حذف تکرار خواهید داشت.
MMR در Qdrant
Qdrant نیز MMRرا برای جستوجوی نزدیکترین بردارها ارائه میکند.
برای مجموعهای که از قبل ساخته و پر شده است، نمونه درخواست به این صورت است:
from qdrant_client import QdrantClient, models


database = QdrantClient(
    url="http://localhost:6333"
)

result = database.query_points(
    collection_name="documents",
    query=models.NearestQuery(
        nearest=query_vector.tolist(),
        mmr=models.Mmr(
            diversity=0.4,
            candidates_limit=40,
        ),
    ),
    limit=5,
    with_payload=True,
)
این کد به مجموعه موجود، بردارهای سازگار و نسخه پشتیبان MMR نیاز دارد؛ برنامه مستقل کامل نیست.
همچنین Qdrant توضیح میدهد که ترتیب پاسخ، ترتیب انتخاب MMR است و امتیازهای بازگشتی شباهت به پرسش را نشان میدهند. مرتبسازی دوباره پاسخ بر اساس آن امتیازها میتواند ترتیب انتخاب را تغییر دهد. Qdrant
MMR چگونه به RAGکمک میکند؟
در RAG، تعداد قطعهها و ظرفیت ورودی محدود است.
اگر بیشتر این ظرفیت صرف متنهای مشابه شود، ممکن است شواهد مکمل حذف شوند. MMR میتواند برای انتخاب مجموعهای با تکرار کمتر آزمایش شود.
مثلاً پرسش «روشهای کاهش انتظار پاسخ» ممکن است به شواهدی درباره طول خروجی، انتخاب مدل و نمایش جریانی نیاز داشته باشد.
اما برای پرسش «شرط دقیق استفاده از یک قابلیت چیست؟»، چند قطعه مجاور از همان سند ممکن است مهمتر از تنوع موضوعی باشند.
بنابراین MMR را با نوع پرسش ارزیابی کنید، نه فقط یک میانگین کلی.
آیا شباهت کمتر یعنی اطلاعات تازهتر؟
الزاماً خیر.
شباهت برداری، جانشینی تقریبی برای تکرار اطلاعات است. دو متن ممکن است:
- بیان متفاوت ولی ادعای یکسان داشته باشند؛
- شبیه باشند اما شرطهای متفاوتی ارائه کنند؛
- موضوع مشابه و اطلاعات متناقض داشته باشند؛
- کاملاً متفاوت اما نامرتبط باشند.
MMRاعتبار منبع، تازگی اطلاعات یا صحت ادعا را بهطور خودکار تشخیص نمیدهد.
برای مثال، سند قدیمی و سند جدید یک قابلیت ممکن است مشابه باشند. انتخاب یکی از آنها باید بر اساس نسخه و تاریخ نیز کنترل شود.
انتخاب پارامترها
برای آزمایش اولیه، چند ترکیب محدود بسازید:
| تنظیم | نمونههای قابلآزمایش |
|---|---|
| وزن ارتباط | ۰٫۴، ۰٫۶، ۰٫۸ و ۱ |
| تعداد نامزدها | ۲۰، ۴۰ و ۸۰ |
| تعداد خروجی | متناسب با محصول |
| قطعهبندی | چند اندازه و همپوشانی مشخص |
این اعداد نقطه شروع آزمایشاند، نه تنظیم پیشنهادی قطعی.
تنوع زیاد چه خطری دارد؟
اگر ارتباط وزن کمی داشته باشد، نامزد نامرتبطی که با نتایج قبلی تفاوت دارد ممکن است انتخاب شود.
یک راه قابلآزمایش، محدودکردن نامزدها به نتایج دارای ارتباط قابلقبول است. اما آستانه شباهت باید برای همان مدل و داده تنظیم شود؛ عدد عمومی برای تمام مدلها وجود ندارد.
تعداد نامزد بیشتر همیشه بهتر نیست
تعداد بیشتر، انتخابهای بیشتری فراهم میکند، اما هزینه را افزایش میدهد و ممکن است نامزدهای ضعیفتری وارد مرحله انتخاب شوند.
کیفیت و تأخیر را همزمان بسنجید.
تفاوت MMR و گروهبندی بر اساس سند
گروهبندی میتواند مثلاً اجازه دهد از هر document_id فقط یک نتیجه نمایش داده شود.
MMRچنین محدودیتی را الزاماً اعمال نمیکند. ممکن است چند قطعه از یک سند را انتخاب کند، اگر متفاوت به نظر برسند.
| نیاز | طراحی قابلآزمایش |
|---|---|
| یک نتیجه از هر سند | گروهبندی با شناسه |
| کاهش شباهت معنایی | MMR |
| حفظ چند قطعه مکمل | انتخاب همراه زمینه |
| محدودیت سهم هر منبع | قاعده صریح انتخاب |
اگر محصول به سهم مشخص از هر منبع نیاز دارد، آن را با قاعده روشن پیادهسازی کنید؛ انتظار نداشته باشید Lambda چنین تضمینی بدهد.
هزینه محاسباتی
در پیادهسازی این مقاله، برای هر انتخاب جدید، شباهت آن با تمام نامزدها محاسبه میشود.
بنابراین هزینه به این عوامل وابسته است:
- تعداد نامزدها؛
- تعداد نتایج منتخب؛
- تعداد ابعاد بردار.
اگر بردار نامزدها از قبل موجود باشند، اجرای MMR به فراخوانی مدل زبانی نیاز ندارد. اما دریافت بردارها از پایگاه داده نیز هزینه انتقال و پردازش دارد.
برای مجموعه بزرگ، MMR را روی فهرست نامزدهای محدود اجرا کنید و هزینه دریافت بردارها را در زمان کل لحاظ کنید.
چگونه کیفیت را ارزیابی کنیم؟
تنوع بیشتر بهتنهایی معیار موفقیت نیست. مجموعهای کاملاً نامرتبط نیز میتواند متنوع باشد.
ارزیابی پیشنهادی سه بخش دارد:
ارتباط
Recall،کیفیت رتبههای اول و حضور شواهد ضروری را اندازه بگیرید.
تکرار و پوشش
بررسی کنید چه تعداد نتیجه اطلاعات تکراری دارند و چند جنبه موردنیاز پرسش پوشش داده شده است.
پاسخ نهایی
در RAG بسنجید آیا پاسخ کاملتر، دقیقتر و دارای ارجاع مناسب شده است.
| معیار | کاربرد |
|---|---|
| Recall@K | پوشش اسناد مرتبط |
| nDCG@K | کیفیت ترتیب ارتباط |
| پوشش جنبههای پرسش | حضور شواهد مکمل |
| تکرار اطلاعات | ارزیابی افزونگی |
| صحت پاسخ | اثر نهایی در RAG |
| تأخیر صدک ۹۵ | هزینه زمانی |
کاهش میانگین شباهت میان نتایج، یک علامت قابل بررسی است؛ اثبات افزایش اطلاعات مفید نیست.
تنظیمات را روی Validation انتخاب کنید و نتیجه نهایی را روی Test مستقل گزارش دهید.
اشتباهات رایج
اجرای MMR روی نامزدهای ضعیف
MMRسند غایب را بازیابی نمیکند. ابتدا پوشش بازیابی اولیه را بررسی کنید.
یکیدانستن تنوع و کیفیت
متفاوتبودن یک نتیجه، مرتبطبودن آن را ثابت نمیکند.
حذف قطعه مکمل
دو قطعه مشابه ممکن است بخشهای لازم یک پاسخ باشند.
نادیدهگرفتن مقیاس امتیازها
ترکیب امتیاز Cross-Encoder با شباهت کسینوسی نیازمند تنظیم است.
مرتبسازی دوباره خروجی
ترتیب انتخاب MMR را بدون بررسی تغییر ندهید.
فرض محدودیت منبع
MMRالزاماً از هر سند یک نتیجه انتخاب نمیکند.
استفاده از آستانه عمومی
امتیازهای مدلهای مختلف را با یک آستانه ثابت ارزیابی نکنید.
پرسشهای متداول
MMRچیست؟
الگوریتمی برای انتخاب نتایج است که ارتباط با پرسش را با کاهش شباهت به نتایج قبلی ترکیب میکند.
آیا MMR مدل هوش مصنوعی است؟
خود الگوریتم به آموزش مدل جدید نیاز ندارد؛ میتواند از بردارها یا امتیازهای تولیدشده توسط مدل استفاده کند.
آیا همان حذف متن تکراری است؟
خیر. میتواند شباهت معنایی را نیز در انتخاب لحاظ کند.
آیا همیشه Recall را بهتر میکند؟
خیر. ممکن است برای تنوع بیشتر، بعضی نتایج مرتبط را کنار بگذارد.
بهترین Lambda چقدر است؟
به نوع پرسش، داده و هدف محصول بستگی دارد و باید ارزیابی شود.
آیا برای فارسی قابل استفاده است؟
بله، اگر نمایش و امتیازدهی برای متن فارسی کیفیت مناسبی داشته باشند.
آیا MMR جای Cross-Encoder را میگیرد؟
خیر. این دو هدف متفاوتی دارند و میتوانند در یک طراحی مقایسه یا ترکیب شوند.
آیا به تولید متن اضافی نیاز دارد؟
در نمونه مبتنی بر Embedding این مقاله، خیر؛ روی بردارهای موجود اجرا میشود.
جمعبندی
MMRبرای انتخاب مجموعهای مرتبط با تکرار کمتر طراحی شده است.
ارزش آن زمانی مشخص میشود که نتایج مشابه، جای شواهد مکمل را گرفته باشند. در مقابل، تنوع بیشازحد میتواند ارتباط را کاهش دهد یا قطعههای ضروری را حذف کند.
بازیابی اولیه، انتخاب متنوع و کیفیت پاسخ نهایی را جدا ارزیابی کنید و تنظیمات را با هدف محصول هماهنگ نگه دارید.
استفاده از Embedding درواره برای انتخاب نتایج متنوع
برای ساخت جستوجوی فارسی، ابتدا به بردارهای معنایی مناسب نیاز دارید. میتوانید مدلهای Embedding در دسترس درواره را بررسی و خروجی آنها را در لایه بازیابی و انتخاب MMR استفاده کنید.
شناسه مدل و تنظیمات ورودی را از مستندات درواره انتخاب کنید. سپس Top-K و MMR را روی پرسشهای واقعی کاربران مقایسه کنید.
این تفکیک اجازه میدهد مدل Embedding، تعداد نامزدها و وزن تنوع را مستقل آزمایش کنید و بر اساس کیفیت و هزینه تصمیم بگیرید.
برای بررسی مدلها و شروع ساخت جستوجوی معنایی یا دستیار مبتنی بر اسناد، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- Embeddingچیست؟
- جستوجوی معنایی چیست؟
- بازرتبهبندی و Cross-Encoder درRAG
- قطعهبندی متن یا Chunking چیست؟
- ارزیابی بازیابی و تولید پاسخ درRAG
- BGE-M3برای جستوجوی معنایی فارسی
منابع
- پژوهش Goldstein و Carbonell درباره MMR و خلاصهسازی
- مستندات رسمی MMR درQdrant
- آموزش تنوع نتایج درQdrant
- راهنمای MMR درElasticsearch Labs
- پیادهسازی MMR در کتابخانه رسمیElastic
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



