
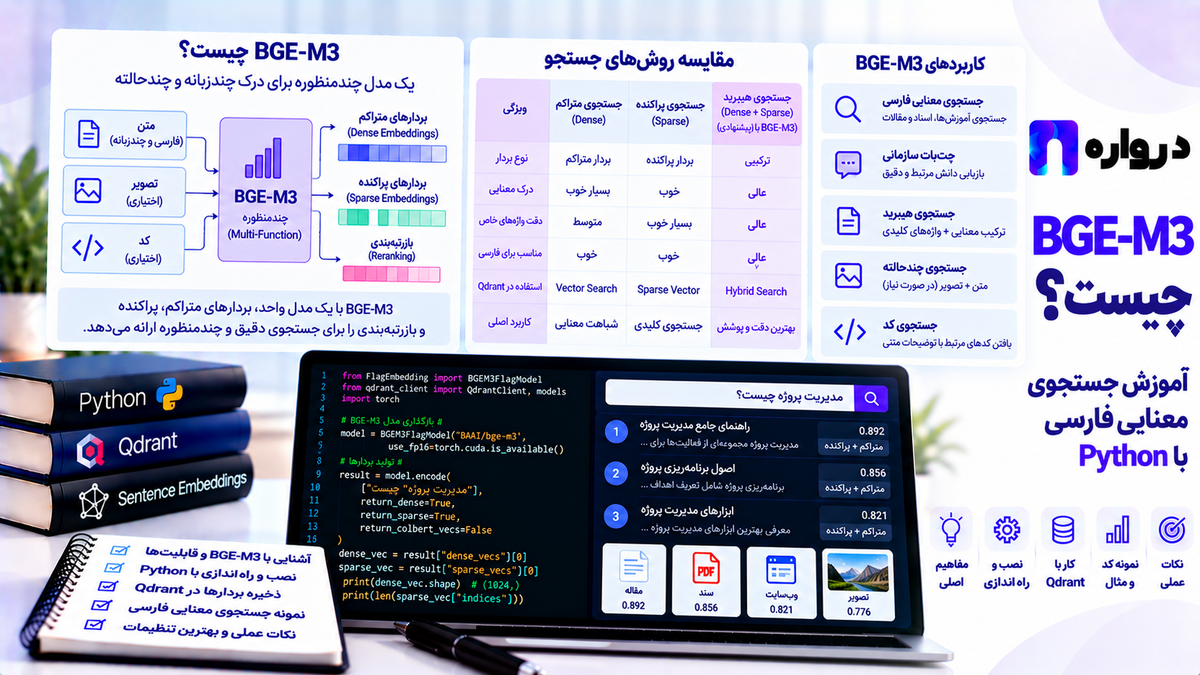
BGE-M3 چیست؟ آموزش جستوجوی معنایی فارسی با Python
BGE-M3 چیست و چگونه جستوجوی معنایی فارسی را با سه نمایش متراکم، پراکنده و چندبرداری انجام میدهد؟ در این راهنما، مدل را با Python اجرا میکنیم و کیفیت بازیابی، هزینه پردازش و کاربرد آن در RAGرا بررسی میکنیم. عنوان متا:

در یک سامانه جستوجوی فارسی، کاربران ممکن است یک درخواست را با چند بیان متفاوت مطرح کنند:
- «چگونه مبلغ پرداختشده را پس بگیرم؟»
- «شرایط استرداد وجه چیست؟»
- «پولم کی برمیگرده؟»
بازیاب باید ارتباط این پرسشها را تشخیص دهد. در عین حال، باید میان «بازگشت وجه»، «انتقال اعتبار» و «لغو سفارش بدون بازپرداخت» تفاوت بگذارد.
BGE-M3 یک مدل Embedding چندزبانه است که سه نوع نمایش برای بازیابی متن ارائه میکند: متراکم، پراکنده و چندبرداری. این قابلیت امکان میدهد چند روش تطبیق پرسش و سند را با یک خانواده نمایش آزمایش کنیم.
مقاله M3-Embedding این مدل را برای بازیابی چندزبانه، چند نوع نمایش و ورودیهایی با طولهای متفاوت معرفی کرده است. arxiv.org
در این مقاله، BGE-M3 را با FlagEmbedding اجرا میکنیم، سه روش امتیازدهی را روی متن فارسی مقایسه میکنیم و سپس مسیر انتخاب و ارزیابی آن برای سامانههای RAG را بررسی خواهیم کرد.
BGE-M3چیست؟
BGE-M3 مدلی از مجموعه BGEمتعلق به Beijing Academy of Artificial Intelligence یا BAAI است.
سه ویژگی نام M3 عبارتاند از:
- Multi-Linguality: کار با زبانهای متعدد؛
- Multi-Functionality: ارائه چند روش نمایش و بازیابی؛
- Multi-Granularity: پردازش متنهایی با طولهای متفاوت.
کارت رسمی مدل، خروجی متراکم ۱۰۲۴بعدی، ظرفیت ورودی تا ۸۱۹۲ توکن و پشتیبانی چندزبانه را معرفی میکند. Hugging Face
این مشخصات به معنای کیفیت یکسان در تمام زبانها، موضوعات و طولهای ورودی نیست. برای پروژه فارسی، مدل باید روی پرسشها و اسناد همان پروژه ارزیابی شود.
آیا BGE-M3 یک مدل زبانی پاسخدهنده است؟
خیر. وظیفه اصلی BGE-M3 تولید نمایش برای مقایسه و بازیابی متن است.
برای مثال، میتواند کمک کند مشخص شود کدام بخش از راهنمای محصول به پرسش کاربر مرتبطتر است. سپس مدل زبانی دیگری از متن بازیابیشده برای تولید پاسخ استفاده میکند.
در معماری RAG، این دو مسئولیت را جدا نگه دارید:
- بازیاب: انتخاب شواهد مرتبط؛
- مدل پاسخدهنده: نوشتن پاسخ بر اساس شواهد.
اگر بازیاب سند اشتباه را انتخاب کند، مدل پاسخدهنده ممکن است پاسخ نامناسبی بسازد. اگر سند درست انتخاب شده باشد، باز هم باید استفاده صحیح از آن بررسی شود.
سه نوع خروجیBGE-M3
BGE-M3سه نمایش متفاوت ارائه میکند:
| خروجی | ساختار | کاربرد قابلآزمایش |
|---|---|---|
dense_vecs | یک بردار متراکم برای هر متن | جستوجوی معنایی تکبرداری |
lexical_weights | وزنهای پراکنده توکنها | تطبیق واژگانی آموختهشده |
colbert_vecs | مجموعه بردارهای وابسته به توکن | تعامل چندبرداری پرسش و سند |
این خروجیها یکسان نیستند و به روش ذخیرهسازی و امتیازدهی متفاوت نیاز دارند.
خروجی متراکم
در این مسیر، هر پرسش یا قطعه متن یک بردار دارد.
این نمایش برای ساخت یک نقطه شروع ساده مناسب است: اسناد را رمزگذاری کنید، پرسش را رمزگذاری کنید و نزدیکترین بردارها را بیابید.
خروجی پراکنده
در نمایش پراکنده، توکنها وزن دارند و امتیاز از موقعیتهای مشترک پرسش و سند محاسبه میشود.
این خروجی را نباید صرفاً به دلیل پراکندهبودن، معادل SPLADE دانست. مسیر واژگانی BGE-M3 بر وزندهی به توکنهای متن متکی است؛ گسترش واژگان SPLADE سازوکار دیگری دارد.
خروجی چندبرداری
در این مسیر، متن با مجموعهای از بردارهای توکن نمایش داده میشود.
برای امتیازدهی، نمایشهای پرسش با نمایشهای سند مقایسه میشوند. این خروجی میتواند برای آزمایش تطبیق در سطح جزئیتر مفید باشد، اما هزینه آن نیز باید اندازهگیری شود.
معماری پایهBGE-M3
مستندات رسمی BGE، پایه مدل را XLM-RoBERTa-large معرفی میکند. در مسیر متراکم، نمایش توکن ویژه آغاز متن برای ساخت بردار به کار میرود. BGE documentation
برای استفاده عملی، لازم نیست این معماری را از ابتدا پیادهسازی کنید. کتابخانه FlagEmbedding مسیر تولید نمایشها را فراهم میکند.
بااینحال، دانستن تفاوت میان رمزگذار مشترک و خروجیهای متفاوت به طراحی هزینه کمک میکند: فعالکردن چند خروجی به معنای آن نیست که نگهداری، انتقال و جستوجوی آنها هزینه یکسانی دارد.
آموزش عملی BGE-M3 باPython
در این مثال، یک مجموعه کوچک از راهنماهای فرضی کسبوکار داریم.
این متنها قوانین واقعی درواره نیستند؛ فقط داده آموزشی برای مقایسه بازیابیاند.
نصب کتابخانهها
pip install -U FlagEmbedding numpy torchبرای بازتولید آزمایش، پس از انتخاب نسخههای سازگار، نسخه کتابخانهها و نسخه مدل را ثبت کنید.
تعریف اسناد فارسی
documents = [ { "id": "refund", "text": ( "اگر سفارش پیش از ارسال لغو شود، " "درخواست استرداد وجه از بخش پرداختها " "ثبت میشود. زمان بازپرداخت پس از بررسی " "درخواست اعلام خواهد شد." ), }, { "id": "shipping", "text": ( "پس از ارسال سفارش، کد رهگیری در صفحه " "سفارش نمایش داده میشود. با این کد " "میتوان وضعیت مرسوله را پیگیری کرد." ), }, { "id": "invoice", "text": ( "برای دریافت فاکتور خرید، به بخش " "صورتحسابها بروید و فاکتور سفارش " "موردنظر را دانلود کنید." ), }, { "id": "wallet", "text": ( "اعتبار کیف پول برای خریدهای بعدی " "قابل استفاده است. انتقال اعتبار " "به حساب کاربر دیگر در این نمونه " "سامانه امکانپذیر نیست." ), }, {وجود یک سند مرتبط، الزاماً به معنای امکان انجام درخواست نیست. برای مثال، سند انتقال اعتبار مرتبط است، اما میگوید این عمل در سامانه فرضی امکانپذیر نیست.
این تفاوت در RAG اهمیت دارد: بازیاب باید سند پاسخگو را پیدا کند، حتی اگر پاسخ سند «خیر» باشد.
بارگذاری مدل و تولید نمایشها
برای سازگاری با مثال CPU، از دقت float32 استفاده میکنیم:
import numpy as npfrom FlagEmbedding import BGEM3FlagModelmodel = BGEM3FlagModel( "BAAI/bge-m3", devices=["cpu"], use_fp16=False, normalize_embeddings=True,)document_outputs = model.encode_corpus( [item["text"] for item in documents], batch_size=2, max_length=512, return_dense=True, return_sparse=True, return_colbert_vecs=True,)query_outputs = model.encode_queries( queries, batch_size=2, max_length=128, return_dense=True, return_sparse=True, return_colbert_vecs=True,)روشهای encode_queries و encode_corpus و گزینههای انتخاب خروجی در نمونه رسمی FlagEmbedding ارائه شدهاند. GitHub
در اولین اجرا، فایلهای مدل دانلود میشوند. اجرای CPU برای آزمایش ممکن است زمانبر باشد.
مقادیر max_length در این مثال برای محدودکردن طول پردازش انتخاب شدهاند. اگر متن از محدودیت تعیینشده بیشتر باشد، باید رفتار قطع ورودی را در ارزیابی لحاظ کنید.
بررسی شکل خروجی
print(
    "Dense:",
    document_outputs["dense_vecs"].shape,
)

print(
    "Sparse features:",
    len(document_outputs["lexical_weights"][0]),
)

print(
    "Multi-vector:",
    document_outputs["colbert_vecs"][0].shape,
)
تعداد ویژگیهای پراکنده و بردارهای توکن میتواند برای متنهای مختلف متفاوت باشد. شکل واقعی خروجی را مشاهده کنید و ثابت فرض نکنید.
امتیازدهی متراکم
چون در تنظیم مدل، نرمالسازی بردارهای متراکم فعال است، از ضرب داخلی برای مقایسه استفاده میکنیم:
dense_scores = ( query_outputs["dense_vecs"] @ document_outputs["dense_vecs"].T)ماتریس خروجی برای هر پرسش، امتیاز تمام اسناد را دارد.
تابع نمایش نتایج:
def show_results(scores, query_index, top_k=3): ranking = np.argsort( -scores[query_index], kind="stable", )[:top_k] print("پرسش:", queries[query_index]) for index in ranking: index = int(index) print( documents[index]["id"], round( float(scores[query_index, index]), 4, ), )show_results(dense_scores, query_index=0)خروجی واقعی مدل باید هنگام اجرا مشاهده شود. ترتیب یا امتیازی برای آن از پیش فرض نشده است.
امتیازدهی پراکنده
برای نمایش واژگانی از تابع خود کتابخانه استفاده میکنیم:
sparse_scores = model.compute_lexical_matching_score(
    query_outputs["lexical_weights"],
    document_outputs["lexical_weights"],
)

show_results(
    sparse_scores,
    query_index=0,
)
در این روش، وزنهای موقعیتهای مشترک در امتیاز نقش دارند. پیادهسازی رسمی همین تطبیق وزنها را انجام میدهد. GitHub
برای مشاهده توکنهای وزندار یک پرسش:
weighted_tokens = model.convert_id_to_token(
    query_outputs["lexical_weights"][0]
)

print(weighted_tokens)توکنها ممکن است بخشی از کلمه باشند. مشاهده آنها برای بررسی رفتار مدل مفید است، اما توضیح کامل تصمیمگیری شبکه محسوب نمیشود.
امتیازدهی چندبرداری
ماتریس امتیاز چندبرداری را برای مثال کوچک میسازیم:
multi_scores = np.empty(
    (len(queries), len(documents)),
    dtype=np.float32,
)

for query_index, query_vectors in enumerate(
    query_outputs["colbert_vecs"]
):
    for document_index, document_vectors in enumerate(
        document_outputs["colbert_vecs"]
    ):
        score = model.colbert_score(
            query_vectors,
            document_vectors,
        )

        multi_scores[
            query_index,
            document_index,
        ] = float(score.item())

show_results(
    multi_scores,
    query_index=0,
)
در پیادهسازی فعلی FlagEmbedding، برای هر بردار پرسش بهترین تطبیق سند انتخاب میشود و نتیجه بر تعداد بردارهای پرسش تقسیم میشود. بنابراین مقیاس آن را با یک پیادهسازی مبتنی بر مجموع MaxSim یکسان فرض نکنید. GitHub
این حلقه تمام جفتهای پرسش و سند را بررسی میکند. برای مجموعه بزرگ، چنین طراحیای باید با بازیابی نامزدها یا موتور مناسب جایگزین شود.
مقایسه کیفیت سه روش
برای هر پرسش، سند مرتبط را مشخص کردهایم. اکنون Recall@K را محاسبه میکنیم:
def mean_recall_at_k(scores, relevance, k):
    ranking = np.argsort(
        -scores,
        axis=1,
        kind="stable",
    )[:, :k]

    recalls = []

    for retrieved, relevant in zip(
        ranking,
        relevance,
    ):
        retrieved = set(
            int(index)
            for index in retrieved
        )

        recalls.append(
            len(retrieved & relevant)
            / len(relevant)
        )

    return float(np.mean(recalls))


score_matrices = {
    "dense": dense_scores,
    "sparse": sparse_scores,
    "multi-vector": multi_scores,
}

for name, scores in score_matrices.items():
    print(
        name,
        "Recall@1:",
        round(
            mean_recall_at_k(
                scores,
                relevant_document_indices,
                k=1,
            ),
            3,
        ),
    )
این آزمایش برای فهم روش مناسب است، اما پنج سند و چهار پرسش مبنای کافی برای انتخاب مدل استقرار نیستند.
ممکن است هر سه روش روی داده ساده موفق باشند. برای آشکارکردن تفاوتها، اسناد نزدیک اما نامرتبط اضافه کنید.
برای مثال، پرسش بازپرداخت را در میان اسناد مربوط به انتقال اعتبار، پرداخت ناموفق، سفارش لغوشده و سفارش ارسالشده آزمایش کنید.
آیا باید سه امتیاز را با هم جمع کنیم؟
جمع وزندار یکی از گزینههای قابلآزمایش است، اما مقیاس امتیازهای سه مسیر الزاماً یکسان نیست.
اگر بدون بررسی مقیاسها جمع انجام دهید، یک مسیر ممکن است بر نتیجه غالب شود.
دو طراحی پیشنهادی برای آزمایش:
| طراحی | روش |
|---|---|
| ادغام رتبهها | ترکیب فهرستهای نتایج بر اساس جایگاه |
| امتیاز ترکیبی | تنظیم مقیاس و وزنها روی Validation |
وزنها را روی داده آزمون انتخاب نکنید.
همچنین لازم نیست هر سه خروجی را از ابتدا وارد سامانه کنید. یک آزمایش مرحلهای روشنتر است:
- مسیر متراکم را اندازه بگیرید.
- اثر افزودن مسیر پراکنده را بررسی کنید.
- سپس هزینه و کیفیت مسیر چندبرداری را بسنجید.
اگر افزودن یک مسیر بهبود قابلتوجهی ایجاد نکرد، نگهداری آن ممکن است توجیه نداشته باشد.
تفاوت BGE-M3 با مدلهایReranker
BGE-M3نمایشهایی تولید میکند که میتوان برای اسناد از قبل محاسبه کرد.
در مقابل، یک Cross-Encoder معمولاً پرسش و سند را با هم پردازش میکند و برای همان جفت امتیاز میدهد.
بنابراین مدلهایی مانند BGE Reranker را با BGE-M3 یکسان ندانید. حتی خروجی چندبرداری BGE-M3 نیز به معنای اجرای Cross-Encoder نیست.
در طراحی پیشنهادی برای آزمایش، ابتدا نامزدها با بازیاب پیدا میشوند و سپس یک بازرتبهبند مستقل ترتیب آنها را بررسی میکند.
بازرتبهبند به سندی که از مرحله اول حذف شده دسترسی ندارد. پوشش نامزدها را پیش از ارزیابی ترتیب نهایی اندازه بگیرید.
ورودی ۸۱۹۲توکنی چه معنایی دارد؟
ظرفیت ورودی بلند، امکان پردازش متن بیشتری را فراهم میکند؛ اما بهترین اندازه قطعه را تعیین نمیکند.
سه عدد را از هم جدا کنید:
- حداکثر ظرفیت معرفیشده برای مدل؛
- محدودیتی که کتابخانه یا سرویس اعمال میکند؛
- طولی که در برنامه خود تنظیم کردهاید.
در مثال ما، اسناد با حداکثر ۵۱۲ توکن پردازش میشوند؛ بنابراین از ظرفیت بلند مدل استفاده نشده است.
آیا دیگر به Chunking نیاز نداریم؟
همچنان باید قطعهبندی را ارزیابی کنید.
یک متن بلند ممکن است چند موضوع داشته باشد. بازیابی کل آن میتواند زمینه زیادی وارد مرحله پاسخگویی کند، در حالی که فقط یک بند پاسخگو است.
از طرف دیگر، قطعه بسیار کوتاه ممکن است شرطی مانند «فقط پیش از ارسال سفارش» را از توضیح اصلی جدا کند.
برای آزمایش اولیه، قطعهبندی بر اساس عنوان، بند و ساختار سند را با چند اندازه متفاوت مقایسه کنید.
آیا BGE-M3 برای فارسی مناسب است؟
چندزبانهبودن، آن را به گزینهای قابلآزمایش تبدیل میکند؛ انتخاب نهایی به داده واقعی وابسته است.
برای مقایسه عمومی، مجموعه MIRACL بخش فارسی با کد fa دارد و پرسشها و قضاوتهای ارتباط آن توسط گویشوران زبان تهیه شدهاند. Datasets at Hugging Face
بااینحال، موفقیت روی یک مجموعه عمومی جای ارزیابی دامنه سازمان را نمیگیرد. متن راهنمای محصول، تیکت پشتیبانی و مقاله عمومی ویژگیهای یکسانی ندارند.
گروههای مهم در ارزیابی فارسی
| گروه | چیزی که باید آزمایش شود |
|---|---|
| رسمی و محاورهای | «استرداد وجه» در برابر «پولم برگرده» |
| نیمفاصله | شکلهای متفاوت نوشتن یک عبارت |
| عدد و نسخه | تفاوت نسخهها و مقادیر |
| نام محصول | تطبیق شناسه دقیق |
| متن ترکیبی | فارسی همراه اصطلاح انگلیسی |
| شرط و نفی | «مجاز است» در برابر «مجاز نیست» |
| پرسش چندبخشی | پوشش تمام بخشهای درخواست |
پرسش نفیشده را جدی بگیرید. سند «امکان انتقال اعتبار وجود ندارد» ممکن است از نظر موضوعی بسیار نزدیک باشد، اما پاسخ آن باید منفی باقی بماند.
هزینه پردازش و ذخیرهسازی
یک بردار متراکم ۱۰۲۴بعدی در قالب float32 حدود چهار کیبیبایت داده خام دارد.
برای یک میلیون قطعه متن، فقط بردارهای متراکم حدود ۳٫۸۱ گیبیبایت فضا میگیرند. متن، فراداده، شاخص و نسخههای تکراری در این برآورد نیستند.
هزینه خروجی پراکنده به تعداد ویژگیهای فعال وابسته است. هزینه چندبرداری نیز به تعداد بردارهای توکن، اندازه هر بردار و نوع داده بستگی دارد.
برای برآورد عملی، نمونهای نماینده از اسناد را پردازش کنید و موارد زیر را ثبت کنید:
- حجم خروجی هر مسیر؛
- تعداد ویژگیهای فعال؛
- طول متنها؛
- زمان رمزگذاری؛
- مصرف حافظه هنگام پردازش؛
- حجم شاخص و تأخیر جستوجو.
وجود رمزگذار مشترک، هزینه ذخیره و جستوجوی سه نمایش را حذف نمیکند.
اجرای محلی یا API؟
| معیار | اجرای محلی | API |
|---|---|---|
| شروع کار | نصب و دانلود مدل | اتصال و ارسال درخواست |
| تنظیم خروجیها | تابع قابلیت کتابخانه | تابع قرارداد سرویس |
| مدیریت زیرساخت | بر عهده تیم | عمدتاً بر عهده ارائهدهنده |
| کنترل نسخه | قابل تثبیت | باید از سرویس بررسی شود |
| هزینه | زیرساخت و نگهداری | تعرفه و مصرف |
| انتخاب نهایی | بر اساس نیاز | بر اساس نیاز |
یک نکته مهم: قابلیت مدل با قابلیت API یکسان نیست.
ممکن است سرویسی BGE-M3 را ارائه کند، اما فقط بردار متراکم را برگرداند. در یک پاسخ معمولی سازگار با API Embedding، نباید وجود lexical_weights یا colbert_vecs را فرض کنید.
این خروجیها باید در قرارداد همان سرویس مستند شده باشند.
اشتباهات رایج
افزودن دستور مدل دیگر
BGE-M3را با پیشوندها و دستورهای مدل دیگری اجرا نکنید. کارت مدل اعلام میکند برای بازیابی، به دستور اضافی پرسش نیاز ندارد.
کوتاهکردن دلخواه بردار متراکم
خروجی ۱۰۲۴بعدی را بدون بررسی مستندات و ارزیابی به ابعاد کمتر برش ندهید. پشتیبانی از چند خروجی، معادل پشتیبانی Matryoshka نیست.
استفاده از امتیاز بهعنوان احتمال
امتیاز شباهت، درصد اطمینان به پاسخ نیست.
فعالکردن همه خروجیها بدون نیاز
هر نمایش را فقط زمانی نگه دارید که در کاربرد واقعی ارزش قابلاندازهگیری داشته باشد.
ارزیابی فقط با چند پرسش واضح
اسناد نزدیک، نامهای مشابه، شرطها و استثناها را وارد آزمایش کنید.
تغییر مدل بدون مدیریت شاخص
نسخه مدل، پردازش و نمایش اسناد باید با رمزگذاری پرسش هماهنگ باشد.
مقایسه ناعادلانه
اگر دو مسیر قطعهبندی، اسناد یا تعداد نامزد متفاوت دارند، علت اختلاف نتیجه روشن نخواهد بود.
پرسشهای متداول
BGE-M3چیست؟
مدل Embedding چندزبانهای است که نمایش متراکم، پراکنده و چندبرداری برای بازیابی متن ارائه میکند.
آیا متن فارسی را میتوان با آن پردازش کرد؟
بله، برای پروژه فارسی قابلآزمایش است؛ کیفیت باید روی داده فارسی همان کاربرد سنجیده شود.
خروجی متراکم چندبعدی است؟
کارت رسمی مدل، اندازه ۱۰۲۴ بعد را معرفی میکند.
آیا برای همه درخواستها باید سه خروجی بگیریم؟
خیر. انتخاب خروجی به طراحی و نتیجه ارزیابی بستگی دارد.
آیا خروجی پراکنده آن همان SPLADE است؟
خیر. هر دو نمایش پراکنده دارند، اما سازوکار آنها را نباید یکسان فرض کرد.
آیا BGE-M3 یک Cross-Encoder است؟
خیر. نمایش چندبرداری آن نیز معادل پردازش مشترک پرسش و سند در Cross-Encoder نیست.
آیا روی CPU اجرا میشود؟
کتابخانه مسیر CPU دارد؛ مناسببودن سرعت آن به حجم کار و سختافزار بستگی دارد.
آیا ظرفیت بلند مدل، Chunking را حذف میکند؟
خیر. قطعهبندی همچنان برای حفظ زمینه، کنترل هزینه و انتخاب شواهد باید ارزیابی شود.
آیا API مدل تمام خروجیها را ارائه میکند؟
الزاماً خیر. خروجیهای در دسترس را باید از مستندات همان ارائهدهنده بررسی کرد.
جمعبندی
BGE-M3امکان آزمایش سه نوع نمایش بازیابی را در یک مدل چندزبانه فراهم میکند.
برای شروع، مسیر متراکم را بهعنوان Baseline اجرا کنید. سپس اثر افزودن تطبیق پراکنده و چندبرداری را با داده، معیار و شرایط یکسان بسنجید.
در پروژه فارسی، کیفیت پرسشهای محاورهای، نامها، اعداد و شرطها اهمیت دارد. انتخاب مدل باید بر نتیجه این آزمایشها و هزینه عملی سامانه تکیه کند.
استفاده از مدلهای Embedding از طریق درواره
برای ساخت جستوجوی معنایی فارسی، پیشنهاد محتوا یا دستیار مبتنی بر اسناد، میتوانید مدلهای Embedding در دسترس درواره را بررسی و به برنامه خود متصل کنید.
شناسه مدل، طول ورودی و شکل خروجی را از مستندات درواره و فهرست فعلی مدلها انتخاب کنید. اگر به خروجی پراکنده یا چندبرداری نیاز دارید، پشتیبانی آن را برای همان مسیر سرویس بررسی کنید.
یک شروع عملی، تهیه مجموعهای از پرسشهای واقعی کاربران و مقایسه کیفیت بازیابی چند مدل است. سپس میتوانید نتایج منتخب را به مدل پاسخدهنده متصل کنید.
برای بررسی مدلها و شروع ساخت جستوجوی معنایی یا دستیار هوش مصنوعی، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- Embeddingچیست؟
- جستوجوی ترکیبی با BM25 و بردار برایRAG
- بازرتبهبندی و Cross-Encoder درRAG
- قطعهبندی متن یا Chunking چیست؟
- ارزیابی بازیابی و تولید پاسخ درRAG
- Matryoshka Embeddingو کاهش ابعاد بردارها
منابع
- مقالهM3-Embedding
- کارت رسمیBGE-M3
- آموزش رسمیBGE-M3
- نمونه رسمی اجرای مدل درFlagEmbedding
- پیادهسازی رسمی رمزگذاری و امتیازدهیM3
- مجموعه ارزیابی چندزبانهMIRACL
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



