Parent Document Retrieval چیست؟ آموزش بازیابی والد و فرزند در RAG با Python
Parent Document Retrieval چگونه دقت جستوجوی قطعات کوچک را با بافت بخشهای بزرگتر ترکیب میکند؟ در این آموزش، بازیابی والد و فرزند در RAG، پیادهسازی Python، کنترل حجم زمینه و ارزیابی اسناد فارسی را بررسی میکنیم.

فرض کنید یک دستیار هوش مصنوعی باید به این پرسش پاسخ دهد:
آیا لغو اشتراک باعث بازگشت وجه میشود؟
جستوجو این جمله را پیدا میکند:
مبلغ پرداختشده قابل بازگشت است.
اگر مدل فقط همین جمله را دریافت کند، ممکن است پاسخ مثبتی بدهد. اما جمله بعدی در سند میگوید:
این امکان فقط تا هفت روز پس از خرید و برای حسابهایی فراهم است که هنوز از سرویس استفاده نکردهاند.
جمله اول مرتبط بود، اما برای پاسخ دقیق کافی نبود.
در سامانههای RAG، قطعات کوچک میتوانند جستوجوی دقیقتری فراهم کنند؛ بااینحال، گاهی شرایط، استثناها و تعریفهای لازم خارج از همان قطعه قرار دارند.
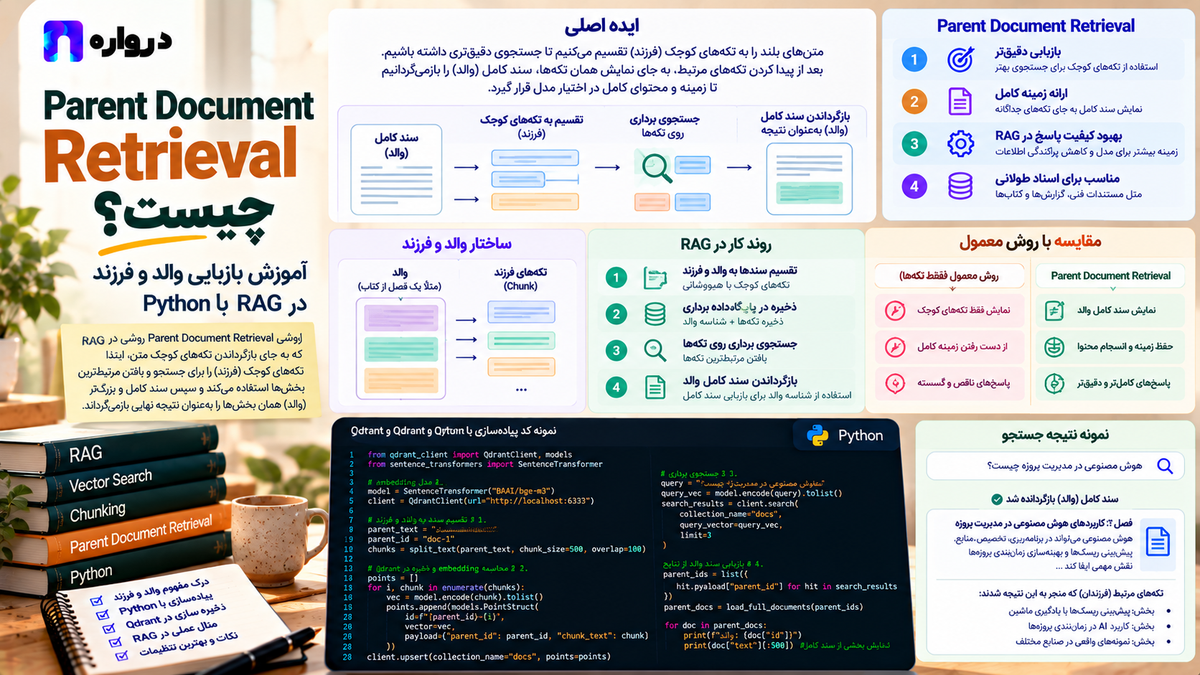
Parent Document Retrievalیا بازیابی سند والد راهی برای مدیریت این مسئله است: ابتدا قطعه کوچک مرتبط را پیدا میکنیم و سپس بخش بزرگتری را که آن قطعه درونش قرار دارد، به مدل پاسخگو میدهیم.
در این مقاله، ساختار والد و فرزند، تفاوت آن با روشهای دیگر، پیادهسازی فارسی با Python و معیارهای ارزیابی آن را بررسی میکنیم.
Parent Document Retrievalچیست؟
در این الگو، دو اندازه متفاوت از متن نگهداری میشود:
- Childیا فرزند: قطعه کوچک برای نمایهسازی و جستوجو
- Parentیا والد: متن بزرگتر برای فراهمکردن زمینه پاسخ
هر قطعه فرزند، شناسه والد خود را دارد. پس از بازیابی فرزند، سامانه از این شناسه استفاده میکند تا متن والد را از مخزن اسناد دریافت کند.
مستندات رسمی LangChain نیز ParentDocumentRetriever را با همین منطق معرفی میکند: جستوجو روی قطعات کوچک انجام میشود و سپس اسناد بزرگتر مرتبط با آنها برگردانده میشوند. LangChain Reference
برای مثال:
| سطح | نمونه محتوا | نقش |
|---|---|---|
| سند اصلی | راهنمای کامل اشتراک | منبع محتوا |
| والد | بخش «لغو و بازگشت وجه» | زمینه پاسخ |
| فرزند | جمله مربوط به امکان بازگشت وجه | هدف جستوجو |
والد الزاماً کل سند نیست. در یک راهنمای طولانی، میتواند یک بخش چندپاراگرافی باشد.
چرا اندازه متن جستوجو و متن پاسخ باید متفاوت باشد؟
این دو مرحله نیازهای یکسانی ندارند.
در جستوجو، میخواهیم موضوع مشخصی را پیدا کنیم. قطعهای که فقط درباره لغو اشتراک است، ممکن است برای این هدف مناسبتر از صفحهای باشد که همزمان درباره ثبتنام، پرداخت و تنظیمات حساب توضیح میدهد.
در پاسخگویی، مدل ممکن است علاوه بر جمله مرتبط، به اطلاعات زیر نیاز داشته باشد:
- شرایط اجرای حکم
- موارد استثنا
- تعریف اصطلاحات
- مراحل قبل و بعد
- عنوان بخش
- نام محصول
- دوره زمانی یا نسخه سند
الگوی والد و فرزند، اندازه واحد بازیابی را از اندازه واحد ارائه به مدل جدا میکند.
این جداسازی یک امکان طراحی است؛ برتری آن باید با داده واقعی بررسی شود. قطعه کوچک همیشه بهتر نیست و والد بزرگتر نیز همیشه زمینه مفیدتری ایجاد نمیکند.
تفاوت با بازیابی معمولی
در RAG معمولی، همان قطعهای که در جستوجو پیدا میشود، معمولاً وارد زمینه مدل خواهد شد.
در بازیابی والد و فرزند، نتیجه جستوجو ابتدا به متن دیگری نگاشت میشود: بخش بزرگتری که قطعه بازیابیشده را در بر دارد.
| ویژگی | بازیابی معمولی | بازیابی والد و فرزند |
|---|---|---|
| واحد نمایهسازی | قطعه متن | قطعه فرزند |
| متن ارسالی به مدل | همان قطعه | بخش والد |
| نگهداری رابطه میان قطعات | اختیاری | ضروری |
| کنترل حجم زمینه | بر تعداد و اندازه قطعات | بر تعداد و اندازه والدها |
| ردیابی نتیجه | شناسه قطعه | شناسه فرزند و والد |
| خطر اصلی | فقدان اطلاعات اطراف | ورود متن اضافی |
در پیادهسازیهای مبتنی بر MultiVectorRetriever، بردارهای قطعات کوچک در Vector Store و متن والدها در Docstore نگهداری میشوند. LangChain Reference
تفاوت با Contextual Retrieval، Sentence Window وAuto-Merging
Contextual Retrieval
در Contextual Retrieval، توضیحی درباره جایگاه قطعه در سند، پیش از نمایهسازی به متن آن اضافه میشود.
در الگوی والد و فرزند، تغییر اصلی پس از یافتن نتیجه رخ میدهد: متن بیشتری از منبع اصلی دریافت میشود.
میتوان هر دو را ترکیب کرد؛ برای مثال، فرزند را همراه با عنوان بخش نمایهسازی کرد و سپس والد را برگرداند.
Sentence Window
در Sentence Window، نتیجه میتواند یک جمله باشد و زمینه نهایی از جملههای قبل و بعد ساخته شود.
در Parent Document Retrieval، محدوده گسترش با یک رابطه از پیش تعریفشده مشخص میشود. این محدوده میتواند یک بخش کامل باشد، حتی اگر تعداد جملههای آن با بخشهای دیگر متفاوت باشد.
Auto-Merging Retrieval
در Auto-Merging، گسترش همیشه برای هر نتیجه انجام نمیشود. اگر تعداد کافی از فرزندان یک والد بازیابی شوند، سامانه میتواند آنها را به والد ادغام کند و این فرایند را در سلسلهمراتب ادامه دهد.
LlamaIndexاین الگو را با ساختار سلسلهمراتبی گرهها و آستانه ادغام پیادهسازی میکند. Developer Documentation
چگونه والد مناسب را انتخاب کنیم؟
بزرگترین متن ممکن، لزوماً بهترین والد نیست.
اگر یک نتیجه مرتبط باعث ورود یک فایل صدصفحهای شود، اطلاعات نامرتبط میتوانند هزینه پاسخ را افزایش دهند و یافتن شاهد اصلی را دشوار کنند.
پژوهش «Lost in the Middle» نیز نشان داده است که در مدلها و وظایف بررسیشده، استفاده از اطلاعات زمینه طولانی به موقعیت آن اطلاعات وابسته بوده است. بنابراین، ظرفیت ورودی بزرگتر را نباید تضمین استفاده مؤثر از تمام محتوا دانست. arxiv.org
برای طراحی اولیه، والد میتواند یکی از این واحدها باشد:
- بخش زیر یک تیتر
- یک پرسش و پاسخ کامل
- یک دستورالعمل همراه با هشدارها
- یک جدول همراه عنوان و توضیحات
- یک بند قرارداد همراه تبصرههای مستقیم آن
والد باید بافت لازم را حفظ کند و تا حد امکان از موضوعات دیگر جدا باشد.
آموزش عملی باPython
در مثال زیر، از اسناد فرضی استفاده میکنیم. دو بخش درباره بازگشت وجه و تغییر طرح هستند.
برای سادهبودن نمونه، والدها را بر اساس ساختار محتوا تعریف میکنیم و جملههای هر بخش را بهعنوان فرزند در نظر میگیریم.
نصب کتابخانهها
pip install openai numpyمتغیرهای محیطی را تنظیم کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_EMBEDDING_MODEL="YOUR_EMBEDDING_MODEL_ID"
export DARVAREH_CHAT_MODEL="YOUR_CHAT_MODEL_ID"شناسهها باید مربوط به مدلهای پشتیبانیشده در حساب و مسیر API شما باشند.
تعریف والدها
parents = {
"subscription-v1:refund": {
"document_id": "subscription-guide",
"version": "example-v1",
"title": "لغو اشتراک و بازگشت وجه",
"text": (
"کاربر میتواند درخواست لغو اشتراک ثبت کند. "
"مبلغ پرداختشده قابل بازگشت است. "
"این امکان فقط تا هفت روز پس از خرید و "
"برای حسابهایی فراهم است که هنوز از "
"سرویس استفاده نکردهاند. "
"پس از شروع استفاده، بازگشت وجه انجام نمیشود."
),
},
"subscription-v1:upgrade": {
"document_id": "subscription-guide",
"version": "example-v1",
"title": "تغییر طرح اشتراک",
"text": (
"کاربر میتواند طرح اشتراک را ارتقا دهد. "
"اعتبار استفادهنشده طرح قبلی در محاسبه "
"هزینه ارتقا لحاظ میشود. "
"کاهش سطح طرح از ابتدای دوره بعد اعمال میشود."
),
},
}این شرایط صرفاً برای آموزش ساخته شدهاند و سیاست هیچ سرویس واقعی را بیان نمیکنند.
ساخت قطعات فرزند
import refrom dataclasses import dataclass@dataclass(frozen=True)class ChildChunk: id: str parent_id: str text: str search_text: strdef split_sentences(text: str) -> list[str]: return [ part.strip() for part in re.split( r"(?<=[.!?؟])\s+", text.strip(), ) if part.strip() ]children = []for parent_id, parent in parents.items(): sentences = split_sentences( parent["text"] ) for position, sentence in enumerate(sentences): children.append( ChildChunk( id=f"{parent_id}:child:{position}", parent_id=parent_id, text=sentence,در این نمونه، عنوان واقعی بخش به متن جستوجو اضافه شده است. بنابراین، فرزند فقط یک جمله کاملاً جداافتاده نیست.
تقسیم جمله با عبارت منظم برای این متن ساده کافی است، اما برای اختصارها، اعداد اعشاری و اسناد پیچیده باید از روش مناسبتری استفاده کنید.
اگر تقسیم بازگشتی را انتخاب میکنید، به واحد اندازهگیری توجه داشته باشید. در نمونه مستندات LangChain، اندازه قطعات با len و بر اساس کاراکتر اندازهگیری میشود؛ چنین عددی را نباید تعداد توکن فرض کرد. Docs by LangChain
ساخت بردارهای فرزند با API درواره
import osimport numpy as npfrom openai import OpenAIclient = OpenAI( api_key=os.environ["DARVAREH_API_KEY"], base_url="https://api.darvareh.ir/v1",)def embed_texts(texts: list[str]) -> np.ndarray: response = client.embeddings.create( model=os.environ[ "DARVAREH_EMBEDDING_MODEL" ], input=texts, ) items = sorted( response.data, key=lambda item: item.index, ) if len(items) != len(texts): raise ValueError( "Unexpected number of embeddings" ) vectors = np.asarray( [item.embedding for item in items], dtype=np.float32, ) if vectors.ndim != 2:در پروژه واقعی، این بردارها هنگام ورود اسناد ساخته و ذخیره میشوند. لازم نیست هنگام هر پرسش، بردار تمام فرزندان را دوباره تولید کنید.
جستوجوی قطعات کوچک
def search_children(
    query: str,
    child_k: int = 5,
) -> list[dict]:
    if child_k < 1:
        raise ValueError(
            "child_k must be positive"
        )

    query_vector = embed_texts([query])[0]

    scores = child_vectors @ query_vector

    positions = sorted(
        range(len(children)),
        key=lambda index: (
            -float(scores[index]),
            children[index].id,
        ),
    )[:child_k]

    return [
        {
            "child_id": children[index].id,
            "parent_id": children[index].parent_id,
            "score": float(scores[index]),
            "matched_text": children[index].text,
        }
        for index in positions
    ]
چون بردارها نرمال شدهاند، ضرب داخلی برای محاسبه شباهت کسینوسی استفاده میشود.
این نمونه تمام بردارها را در حافظه بررسی میکند. برای مجموعه بزرگتر، جستوجو را به پایگاه برداری منتقل کنید و همان شناسههای والد را در Metadata نگه دارید.
تبدیل نتایج فرزند به والد
ممکن است چند نتیجه برتر متعلق به یک والد باشند. در این حالت، نباید متن والد چند بار وارد زمینه شود.
در تابع زیر:
- والدها یکتا میشوند.
- شناسه فرزندان بازیابیشده حفظ میشود.
- امتیاز والد، بیشترین امتیاز فرزندان آن است.
- تعداد والدها و حجم متن محدود میشود.
- والدهای حذفشده به دلیل محدودیت حجم گزارش میشوند.
def expand_to_parents(
    hits: list[dict],
    parents: dict,
    max_parents: int = 3,
    max_chars: int = 2500,
):
    if max_parents < 1 or max_chars < 1:
        raise ValueError(
            "Limits must be positive"
        )

    groups = {}

    for hit in hits:
        parent_id = hit["parent_id"]

        if parent_id not in parents:
            raise KeyError(
                f"Missing parent: {parent_id}"
            )

        if parent_id not in groups:
            groups[parent_id] = {
                "parent_id": parent_id,
                "score": hit["score"],
                "child_ids": [],
            }

        group = groups[parent_id]

        group["score"] = max(
            group["score"],
            hit["score"],
        )

        if hit["child_id"] not in group["child_ids"]:
            group["child_ids"].append(
                hit["child_id"]
            )

    ranked_groups = sorted(
        groups.values(),
        key=lambda group: (
            -group["score"],
            group["parent_id"],
        ),
    )

    selected = []
    skipped = []
    used_chars = 0

    for group in ranked_groups:
        if len(selected) >= max_parents:
            break

        parent_id = group["parent_id"]
        parent = parents[parent_id]

        source_text = (
            f"[{parent_id}] {parent['title']}\n"
            f"{parent['text']}"
        )

        if (
            used_chars + len(source_text)
            > max_chars
        ):
            skipped.append(parent_id)
            continue

        selected.append(
            {
                **group,
                "source_text": source_text,
            }
        )

        used_chars += len(source_text)

    return selected, skipped
بیشترین امتیاز فرزند، یک قاعده ساده برای این نمونه است. میتوان روشهای دیگری را مقایسه کرد، اما جمع امتیاز تمام فرزندان ممکن است والدهای دارای قطعات بیشتر یا تکراری را بهطور نامتناسب تقویت کند.
اجرای جستوجو و گسترش
query = (
"بعد از استفاده از سرویس، "
"میتوانم مبلغ اشتراک را پس بگیرم؟"
)
child_hits = search_children(
query,
child_k=5,
)
selected_parents, skipped_parents = (
expand_to_parents(
child_hits,
parents,
max_parents=2,
max_chars=2500,
)
)
for result in selected_parents:
print(result["source_text"])
print("Matched children:", result["child_ids"])
print("Skipped by budget:", skipped_parents)ترتیب واقعی نتایج به مدل Embedding وابسته است. هدف ارزیابی این است که بخش بازگشت وجه پیدا شود و استثنای «پس از شروع استفاده» نیز در زمینه نهایی باقی بماند.
ساخت پاسخ با استناد به والد
def answer_question(
query: str,
selected_parents: list[dict],
) -> str:
if not selected_parents:
return (
"منبع کافی برای پاسخ در زمینه موجود نیست."
)
evidence = "\n\n".join(
item["source_text"]
for item in selected_parents
)
response = client.chat.completions.create(
model=os.environ[
"DARVAREH_CHAT_MODEL"
],
messages=[
{
"role": "system",
"content": (
"فقط بر اساس منابع ارائهشده پاسخ بده. "
"شرایط و استثناهای مرتبط را لحاظ کن. "
"برای هر حکم، شناسه منبع را در "
"کروشه بیاور. "
"اگر منابع کافی نیستند، "
"این محدودیت را بیان کن."
),
},
{
"role": "user",
"content": (
f"پرسش:\n{query}\n\n"
f"منابع:\n{evidence}"
),
},
],
)
return (
response.choices[0].message.content or ""
).strip()
answer = answer_question(
query,
selected_parents,
)
print(answer)دستور پاسخگویی جای ارزیابی را نمیگیرد. بررسی کنید پاسخ، استثناها را حفظ کرده و شناسهای را ذکر نکرده باشد که در منابع ارائهشده وجود ندارد.
محدودیت کاراکتر با محدودیت توکن فرق دارد
پارامتر max_chars در مثال، فقط یک کنترل ساده برای حجم متن است.
در استقرار واقعی، باید بودجه ورودی را بر اساس توکن محاسبه کنید. این بودجه شامل منابع، پرسش، تاریخچه گفتگو و دستورهای مدل میشود.
همچنین فضای کافی برای خروجی لازم است.
اگر والد مرتبط از بودجه بزرگتر است، بریدن انتهای آن ممکن است همان استثنای مهم را حذف کند. راههای قابل آزمایش عبارتاند از:
- تعریف والدهای کوچکتر و ساختاریافتهتر
- دریافت پنجره اطراف فرزند مرتبط
- انتخاب زیربخشهای کامل
- پاسخگویی مرحلهای برای پرسشهای چندبخشی
در کد آموزشی، والد بزرگ حذف و شناسه آن گزارش میشود. در محصول واقعی، این وضعیت باید ثبت شود؛ پاسخ ناقص نباید بدون اطلاع از حذف منبع، پاسخ قطعی تلقی شود.
انتخاب child_k و تعداد والدها
تعداد نتیجههای فرزند با تعداد والدهای نهایی یکسان نیست.
اگر پنج فرزند برتر همگی متعلق به یک بخش باشند، پس از یکتاسازی فقط یک والد خواهید داشت.
بنابراین، افزایش child_k گاهی برای یافتن والدهای دیگر لازم میشود. اما نتیجههای پایینتر ممکن است نامرتبط باشند.
این پارامترها را جدا تنظیم کنید:
| پارامتر | اثر |
|---|---|
| تعداد فرزندان بازیابیشده | دامنه نامزدهای اولیه |
| تعداد والدهای نهایی | تعداد بخشهای واردشده به زمینه |
| اندازه والد | مقدار بافت هر بخش |
| بودجه کل زمینه | حجم نهایی ورودی مدل |
برای پرسشهای چندمرحلهای، تنوع والدها نیز اهمیت دارد. بااینحال، افزودن تنوع نباید به ورود بخشهای نامرتبط منجر شود.
جایگاه Reranking و جستوجوی ترکیبی
بازیابی والد و فرزند با جستوجوی ترکیبی قابل استفاده است.
میتوان فرزندان را هم با BM25 و هم با Embedding بازیابی کرد، نتایج را ترکیب کرد و سپس والدها را دریافت کرد.
Rerankingنیز میتواند در دو نقطه قرار بگیرد:
- روی فرزندان، برای انتخاب نامزدهای دقیقتر
- روی والدها، برای بررسی ارتباط بخش بزرگتر با پرسش
انتخاب محل مناسب به طول ورودی مدل بازرتبهبندی و نوع پرسش وابسته است. اگر والد از سقف ورودی Reranker بزرگتر باشد، بخشی از آن ممکن است پردازش نشود.
ارزیابی علمی این روش
فقط بررسی کنید «والد مرتبط پیدا شد» کافی نیست.
ممکن است والد درست باشد، اما بخش لازم به دلیل بودجه کنار گذاشته شود. همچنین ممکن است مدل با وجود دریافت متن کامل، استثنا را نادیده بگیرد.
سه سطح را جدا ارزیابی کنید:
بازیابی فرزند
آیا قطعه مرتبط در نامزدهای اولیه وجود دارد؟
انتخاب زمینه
آیا والد یا بخش لازم، واقعاً در ورودی نهایی مدل قرار گرفته است؟
پاسخ نهایی
آیا پاسخ، حکم و شرایط آن را درست بیان میکند؟
برای مقایسه، این حالتها مفیدند:
- ارسال فرزند بهتنهایی
- ارسال فرزند همراه عنوان
- ارسال پنجره جملههای اطراف
- ارسال والد ساختاریافته
بودجه توکن را در مقایسه ثبت کنید. بهبود با چند برابر متن، باید همراه هزینه و زمان پاسخ گزارش شود.
پرسشهای آزمایشی را نیز به گروههای مختلف تقسیم کنید: سؤال مستقیم، سؤال دارای استثنا، سؤال درباره چند بخش و سؤال بدون پاسخ در اسناد.
نکات مهم برای اسناد فارسی
کیفیت رابطه والد و فرزند به استخراج درست سند وابسته است.
در PDF فارسی، ترتیب متن، تیترها و جدولها ممکن است هنگام استخراج تغییر کند. اگر فرزند به والد اشتباه متصل شود، گسترش زمینه نیز محتوای اشتباه برمیگرداند.
برای نمونههای استخراجشده بررسی کنید:
- جملهها در ترتیب درست هستند.
- عنوان بخش به محتوای درست متصل است.
- شماره صفحه و محل متن حفظ شدهاند.
- سرستون جدول از ردیفها جدا نشده است.
- متن پاورقی با بدنه اشتباه نشده است.
یکسانسازی حروف فارسی برای جستوجو مفید است، اما نسخه اصلی متن را برای نمایش و استناد نگه دارید.
نسخهبندی و نگهداری نمایه
فرزند و والد باید از یک نسخه سند باشند.
اگر بردار فرزند از نسخه قدیمی باقی بماند و شناسه آن به والد جدید اشاره کند، نتیجه جستوجو و زمینه پاسخ دیگر یک مجموعه سازگار نیستند.
برای هر رکورد، این اطلاعات را نگهداری کنید:
- شناسه سند و نسخه
- شناسه والد و فرزند
- محل متن در منبع
- نسخه روش قطعهبندی
- شناسه مدلEmbedding
بهروزرسانی باید رابطهها را نیز اصلاح کند. وجود والدهای حذفشده، فرزندان بدون والد یا نسخههای مخلوط را با بررسی دورهای شناسایی کنید.
اشتباهات رایج
انتخاب کل فایل بهعنوان والد
برای فایل طولانی، یک نتیجه کوچک میتواند متن زیادی وارد زمینه کند.
ارسال چندباره یک والد
چند فرزند مشترک نباید باعث تکرار همان بخش در ورودی مدل شوند.
قطع متن بدون بررسی ساختار
ممکن است جمله شرط یا استثنا از دست برود.
فرض مرتبطبودن تمام والد
امتیاز فرزند نشان نمیدهد همه قسمتهای والد به پرسش مرتبطاند.
ارزیابی فقط در سطح سند
پیداشدن سند درست، حضور شاهد لازم در زمینه نهایی را ثابت نمیکند.
مخلوطکردن نسخهها
نمایه برداری و مخزن متن باید به نسخه سازگار اشاره کنند.
پرسشهای متداول
Parent Document Retrievalچیست؟
الگویی است که قطعات کوچک را جستوجو میکند و سپس بخش بزرگتر حاوی آنها را برای پاسخگویی برمیگرداند.
آیا والد باید کل سند باشد؟
خیر. میتواند یک بخش، بند کامل یا مجموعهای از پاراگرافهای مرتبط باشد.
آیا والد هم به Embedding نیاز دارد؟
در نمونه این مقاله، خیر. بردار فرزند جستوجو میشود و والد با شناسه دریافت میشود.
آیا این روش به مدل زبانی در مرحله نمایهسازی نیاز دارد؟
خیر. رابطهها را میتوان از ساختار سند ساخت.
آیا برای فارسی مناسب است؟
بله، اما کیفیت استخراج، قطعهبندی و مدل بازیابی باید روی فارسی ارزیابی شود.
آیا این روش جایگزین Contextual Retrieval است؟
خیر. این دو تغییر متفاوتی ایجاد میکنند و قابل ترکیباند.
آیا همیشه پاسخ دقیقتر میشود؟
خیر. والد ممکن است متن نامرتبط وارد کند یا مدل از اطلاعات لازم استفاده نکند.
چگونه اندازه والد را تعیین کنیم؟
با توجه به ساختار سند، نوع پرسش و بودجه زمینه؛ سپس با مقایسه تجربی.
جمعبندی
Parent Document Retrievalبرای جداکردن واحد جستوجو از واحد زمینه پاسخ به کار میرود.
قطعه کوچک، محل اطلاعات مرتبط را مشخص میکند و والد، شرایط و توضیحات اطراف آن را فراهم میکند. کیفیت نهایی به تعریف درست والدها، رابطههای سازگار، کنترل بودجه و ارزیابی پاسخ وابسته است.
برای شروع، بخشهای ساختاریافته را والد قرار دهید، فرزندان را با شناسه مشخص نمایهسازی کنید و خروجی را با ارسال مستقیم قطعات کوچک مقایسه کنید.
مقالات مرتبط
- RAGچیست؟
- Chunkingو قطعهبندی متن
- Contextual Retrievalو بازیابی زمینهمند
- جستوجوی ترکیبی با BM25 و بردار
- RRFو ترکیب رتبههای جستوجو
- Reranking و Cross-Encoder
- ارزیابی بازیابی و تولید پاسخ درRAG
منابع
- ParentDocumentRetriever — مستندات رسمی LangChain
- MultiVectorRetriever — مستندات رسمی LangChain
- Recursive Text Splitter — مستندات رسمی LangChain
- Auto-Merging Retriever — مستندات رسمی LlamaIndex
- Lost in the Middle: How Language Models Use Long Contexts
- مستندات API درواره
ساخت دستیار اسناد با درواره
برای آزمایش این معماری، میتوانید بردارهای فرزند را با مدل Embedding پشتیبانیشده درواره بسازید و بخشهای والد را همراه پرسش به مدل زبانی بدهید. نگهداری رابطهها، انتخاب منابع و کنترل زمینه در برنامه شما انجام میشود.
با چند سند فارسی دارای شرایط و استثنا شروع کنید. مقایسه پاسخ بر اساس «فرزند تنها» و «بخش والد» نشان میدهد دریافت بافت بیشتر برای کاربرد شما چه ارزشی دارد.
برای بررسی مدلها و شروع استفاده از API هوش مصنوعی، به درواره مراجعه کنید.
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.