RRF چیست؟ آموزش ترکیب رتبهها در جستوجوی ترکیبی و RAG با Python
RRF چیست و چگونه رتبههای جستوجوی واژگانی و معنایی را ترکیب میکند؟ در این راهنما، Reciprocal Rank Fusion، تنظیم پارامترها، پیادهسازی Python و کاربرد آن در جستوجوی ترکیبی و RAGرا بررسی میکنیم.

در بسیاری از سامانههای جستوجو، یک روش بازیابی برای تمام پرسشها کافی نیست.
جستوجوی واژگانی میتواند اسنادی را پیدا کند که عبارت، نام محصول یا کد خطای موردنظر را دقیقاً دارند. جستوجوی معنایی نیز میتواند ارتباط میان پرسش و سند را شناسایی کند، حتی وقتی کلمات آنها یکسان نیست.
برای مثال، کاربری میپرسد:
چرا درخواست API بعد از مدتی قطع میشود؟
یک سند ممکن است عبارت «خطای Timeout» را داشته باشد و سند دیگر درباره «تنظیم مدت انتظار اتصال» توضیح دهد. هر دو میتوانند مفید باشند، اما احتمال دارد در دو روش جستوجو رتبههای متفاوتی بگیرند.
اکنون باید نتایج این روشها را به یک فهرست تبدیل کنیم. چالش این است که امتیازهای آنها الزاماً مقیاس یکسانی ندارند.
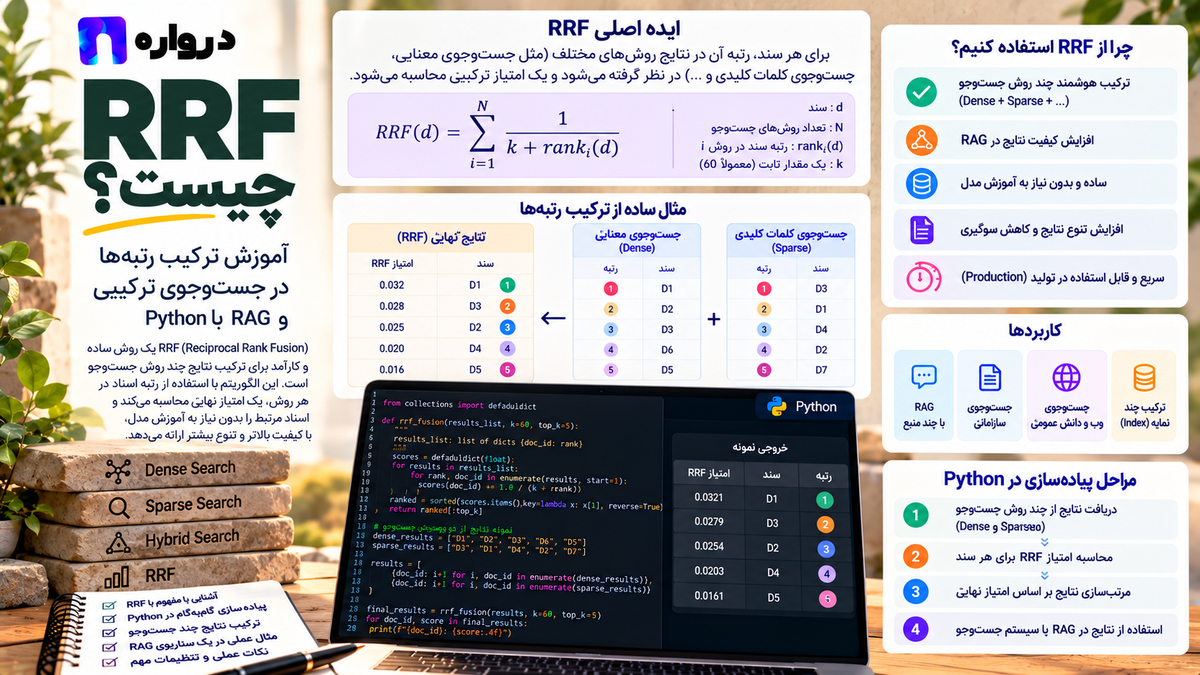
RRF یا Reciprocal Rank Fusion روشی برای ترکیب فهرستهای رتبهبندیشده است. این روش بهجای جمعکردن امتیازهای خام موتورهای جستوجو، از جایگاه هر سند در فهرستهای ورودی استفاده میکند.
در این مقاله، منطق RRF، تفاوت آن با روشهای دیگر، پیادهسازی Python و کاربرد آن در جستوجوی فارسی و RAG را بررسی میکنیم.
RRFچیست؟
RRFمخفف Reciprocal Rank Fusion است و میتوان آن را «ترکیب رتبههای معکوس» نامید.
ورودی این الگوریتم چند فهرست مرتبشده از اسناد است. خروجی آن یک فهرست واحد است که اسناد را بر اساس مجموع سهم رتبههایشان مرتب میکند.
این روش در مقالهای از Cormack، Clarke و Buettcher در کنفرانس SIGIR سال ۲۰۰۹ بررسی شد. پژوهشگران آن را روی مجموعههای ارزیابی بازیابی اطلاعات آزمایش کردند و نتایج مطلوبی گزارش دادند. بااینحال، نتیجه آن آزمایشها به معنی برتری تضمینشده RRF روی تمام دادهها و کاربردها نیست. plg.uwaterloo.ca
RRFمیتواند خروجی روشهای مختلف را ترکیب کند؛ از جمله:
- جستوجوی واژگانی مانندBM25
- جستوجوی برداری باEmbedding
- بازیابی پراکنده عصبی
- چند مدل Embedding متفاوت
- جستوجو با چند بازنویسی از یک پرسش
خود RRF متن پرسش یا سند را تحلیل نمیکند. کیفیت آن به فهرستهایی وابسته است که دریافت میکند.
چرا نباید امتیازهای BM25 و شباهت برداری را مستقیم جمع کنیم؟
فرض کنید دو موتور جستوجو برای یک سند این امتیازها را برگردانند:
| روش بازیابی | امتیاز نمونه |
|---|---|
| جستوجوی واژگانی | ۱۲٫۴ |
| جستوجوی برداری | ۰٫۸۳ |
بزرگتر بودن عدد اول بهتنهایی نشان نمیدهد جستوجوی واژگانی ارتباط قویتری تشخیص داده است.
امتیازها میتوانند بر اساس تعریف، دامنه و توزیع متفاوتی محاسبه شوند. حتی توزیع امتیاز یک روش ممکن است میان پرسشهای مختلف تغییر کند.
اگر این دو عدد را بدون بررسی جمع کنیم، روشی که اعداد بزرگتری تولید میکند ممکن است بر نتیجه غالب شود.
RRFاین مسئله را با استفاده از رتبه حل میکند. سندی که در یک فهرست اول است، سهم بیشتری از سندی میگیرد که در همان فهرست دهم است؛ اندازه امتیاز خام آنها وارد محاسبه نمیشود.
این ویژگی، ترکیب روشهایی با امتیازهای نامتجانس را سادهتر میکند. در مقابل، فاصله واقعی امتیازها نیز کنار گذاشته میشود. اگر سند اول بسیار بهتر از سند دوم باشد، RRF این فاصله را مستقیماً نمیبیند.
RRFچگونه کار میکند؟
فرایند ترکیب در چند مرحله انجام میشود:
- هر روش بازیابی، فهرست مرتبشده خود را تولید میکند.
- شناسههای مشترک میان فهرستها شناسایی میشوند.
- هر سند بر اساس جایگاهش در هر فهرست سهمی دریافت میکند.
- سهمهای آن سند جمع میشوند.
- اسناد بر اساس امتیاز نهایی مرتب میشوند.
در پیادهسازی این مقاله، رتبه از یک شروع میشود. سهم هر رتبه از معکوس مجموع رتبه و یک ثابت مثبت به دست میآید.
اگر سند در یک فهرست حضور نداشته باشد، از آن فهرست سهمی نمیگیرد.
نسخه پایه به همه فهرستها وزن یکسان میدهد. در نسخه وزندار میتوان سهم یک روش بازیابی را بیشتر یا کمتر کرد.
آیا حضور در چند فهرست همیشه باعث رتبه اول میشود؟
خیر.
رتبه سند در هر فهرست، تعداد فهرستها، ثابت رتبه و وزنها بر نتیجه اثر دارند. حضور مشترک معمولاً امتیاز سند را افزایش میدهد، اما بهتنهایی تعیینکننده نیست.
همچنین این حضور را نباید تأیید مستقل حقیقت دانست. دو روش بازیابی ممکن است به دلایل مشابه یک سند نامناسب را بالا بیاورند.
مثال ساده ترکیب دو فهرست
فرض کنید برای پرسش «چرا درخواست API قطع میشود؟» این نتایج را داریم:
| رتبه | جستوجوی واژگانی | جستوجوی معنایی |
|---|---|---|
| ۱ | api-timeout | streaming |
| ۲ | invoice | api-timeout |
| ۳ | streaming | model-choice |
با ثابت رتبه ۶۰ و وزن برابر، خروجی محاسبه چنین است:
| رتبه نهایی | شناسه سند | امتیاز RRF |
|---|---|---|
| ۱ | api-timeout | ۰٫۰۳۲۵۲۲ |
| ۲ | streaming | ۰٫۰۳۲۲۶۶ |
| ۳ | invoice | ۰٫۰۱۶۱۲۹ |
| ۴ | model-choice | ۰٫۰۱۵۸۷۳ |
سند api-timeout در هر دو روش جایگاه بالایی دارد و در خروجی اول میشود. سند streaming نیز از هر دو فهرست سهم میگیرد.
این مثال فقط رفتار الگوریتم را نشان میدهد. برای تشخیص اینکه رتبهبندی نهایی واقعاً بهتر است، باید ارتباط اسناد با پرسش را ارزیابی کنیم.
تفاوت RRF، ترکیب امتیاز، Reranking وMMR
این روشها در مراحل مختلف سامانه قابل استفادهاند.
| روش | اطلاعات مورد استفاده | هدف اصلی |
|---|---|---|
| RRF | جایگاه اسناد در چند فهرست | ترکیب رتبهبندیها |
| ترکیب امتیاز | امتیازهای خام یا تبدیلشده | ادغام شواهد امتیازی |
| Cross-Encoder Reranking | متن پرسش و هر سند | ارزیابی دقیقتر ارتباط |
| MMR | ارتباط با پرسش و شباهت میان نتایج | کاهش تکرار و افزایش تنوع |
یک Cross-Encoder میتواند پرسش و سند را با هم پردازش کند و برای ارتباط آنها امتیاز بسازد. به همین دلیل، معمولاً روی مجموعه محدودی از نامزدهای بازیابیشده اجرا میشود. مستندات Sentence Transformers نیز این معماری دو مرحلهای را در الگوی Retrieve & Re-Rank توضیح میدهد. Sentence Transformers documentation
RRF چنین پردازشی انجام نمیدهد. بنابراین میتوان ابتدا فهرستها را با RRF ترکیب کرد و سپس بخشی از خروجی را به Rerankerداد.
MMR نیز جایگزین مستقیم RRFنیست. ممکن است خروجی ترکیب هنوز شامل چند قطعه بسیار مشابه باشد و برای انتخاب زمینه نهایی به مرحلهای برای کنترل تکرار نیاز داشته باشیم.
پیادهسازی RRF باPython
برای ساخت نسخه پایه به کتابخانه خارجی نیاز نداریم.
تابع زیر چند فهرست از شناسههای متنی را دریافت میکند. امکانات آن عبارتاند از:
- وزن جداگانه برای هر فهرست
- محدودکردن تعداد نامزدهای ورودی
- محدودکردن خروجی نهایی
- جلوگیری از چند بار امتیازگرفتن یک شناسه در یک فهرست
- تعیین ترتیب ثابت هنگام برابر بودن امتیازها
from collections import defaultdict
from math import isfinite


def reciprocal_rank_fusion(
    rankings: list[list[str]],
    *,
    rank_constant: float = 60.0,
    weights: list[float] | None = None,
    window: int = 100,
    limit: int = 10,
) -> list[tuple[str, float]]:

    if (
        not isfinite(rank_constant)
        or rank_constant <= 0
    ):
        raise ValueError(
            "rank_constant must be finite and positive"
        )

    if window < 1 or limit < 1:
        raise ValueError(
            "window and limit must be positive"
        )

    if weights is None:
        weights = [1.0] * len(rankings)
    else:
        weights = list(weights)

    if len(weights) != len(rankings):
        raise ValueError(
            "one weight is required per ranking"
        )

    if any(
        not isfinite(weight) or weight < 0
        for weight in weights
    ):
        raise ValueError(
            "weights must be finite and nonnegative"
        )

    scores = defaultdict(float)

    for ranking, weight in zip(rankings, weights):
        if weight == 0:
            continue

        unique_ids = list(
            dict.fromkeys(ranking)
        )[:window]

        for rank, document_id in enumerate(
            unique_ids,
            start=1,
        ):
            contribution = (
                weight / (rank_constant + rank)
            )

            scores[document_id] += contribution

    ordered_results = sorted(
        scores.items(),
        key=lambda item: (
            -item[1],
            item[0],
        ),
    )

    return ordered_results[:limit]
در این کد، تکرارهای درون هر فهرست ابتدا حذف میشوند و رتبهها برای فهرست یکتا محاسبه میشوند. برای مثال، ورودی ["a", "a", "b"] مانند ["a", "b"] پردازش میشود.
بهتر است موتورهای بازیابی از ابتدا شناسههای یکتا برگردانند تا نیازی به این اصلاح نباشد.
اجرای مثال
lexical_ranking = [
    "api-timeout",
    "invoice",
    "streaming",
]

semantic_ranking = [
    "streaming",
    "api-timeout",
    "model-choice",
]

results = reciprocal_rank_fusion(
    [
        lexical_ranking,
        semantic_ranking,
    ],
    rank_constant=60,
    window=100,
    limit=10,
)

for document_id, score in results:
    print(document_id, f"{score:.6f}")
خروجی:
api-timeout 0.032522
streaming 0.032266
invoice 0.016129
model-choice 0.015873
اجرای نسخه وزندار
اگر بخواهیم سهم روش واژگانی بیشتر باشد:
weighted_results = reciprocal_rank_fusion(
    [
        lexical_ranking,
        semantic_ranking,
    ],
    weights=[2.0, 1.0],
    rank_constant=60,
    limit=10,
)
وزن دو به معنی دو برابرشدن سهم آن فهرست در این پیادهسازی است. این عدد احتمال درستبودن نتایج را بیان نمیکند.
افزایش وزن باید با داده ارزیابی توجیه شود؛ برای مثال، اگر پرسشهای مربوط به کد خطا با روش واژگانی بهتر پاسخ داده میشوند.
ثابت رتبه چه اثری دارد؟
ثابت رتبه تعیین میکند اختلاف سهم جایگاههای ابتدایی و انتهایی چقدر باشد.
ثابت کوچکتر
با ثابت کوچکتر، تفاوت رتبههای اول و پایینتر بیشتر میشود. در این حالت، جایگاه بسیار خوب در یک فهرست میتواند اهمیت بیشتری پیدا کند.
ثابت بزرگتر
با ثابت بزرگتر، تفاوت سهم رتبهها کمتر میشود. در نتیجه، حضور سند در چند فهرست میتواند نسبت به فاصله رتبههای آن اهمیت بیشتری پیدا کند.
عدد ۶۰ در مقاله اصلی استفاده شده است، اما نباید آن را بهترین مقدار قطعی برای هر کاربرد دانست. مقدار مناسب به رفتار بازیابها و پرسشهای واقعی وابسته است. plg.uwaterloo.ca
برای آزمایش اولیه میتوان چند مقدار متفاوت را روی مجموعه اعتبارسنجی مقایسه کرد. این مقایسه باید با عمق نامزدها و معیار ارزیابی یکسان انجام شود.
تفاوت عمق نامزدها و تعداد خروجی
در پیادهسازی بالا، دو پارامتر جدا داریم:
| پارامتر | کاربرد |
|---|---|
window | حداکثر تعداد نتیجه یکتا از هر فهرست |
limit | حداکثر تعداد نتیجه نهایی |
برای مثال، میتوان از هر روش ۵۰ نتیجه گرفت، آنها را ترکیب کرد و فقط ۱۰ نتیجه برگرداند.
اگر از هر روش فقط پنج نتیجه بگیریم، سند مرتبطی که رتبه ششم دارد اصلاً وارد ترکیب نمیشود.
در مقابل، افزایش بیشازحد عمق نامزدها میتواند کار بازیابی، حجم داده و هزینه مرحله Reranking را افزایش دهد. عمق بیشتر نیز تضمین نمیکند خروجی بهتر شود.
در Elasticsearch، پارامترهای rank_window_size و size این دو نقش را از هم جدا میکنند. مستندات این ابزار همچنین برای rank_constant مقدار پیشفرض ۶۰ را مشخص کرده است. Elasticsearch Reference
چرا RRF نمیتواند همه خطاهای بازیابی را اصلاح کند؟
RRFفقط میتواند اسنادی را مرتب کند که در فهرستهای ورودی حضور دارند.
اگر پاسخ یک پرسش در سندی باشد که هیچ بازیابی آن را پیدا نکرده است، ترکیب رتبهها آن سند را اضافه نمیکند.
بنابراین، هنگام ارزیابی باید دو مسئله را جدا بررسی کنیم:
- آیا سند لازم وارد مجموعه نامزدها شده است؟
- آیا سند لازم در خروجی نهایی جایگاه مناسبی دارد؟
ضعف مرحله اول ممکن است به مدل Embedding، پردازش فارسی، تنظیمات جستوجو یا قطعهبندی مربوط باشد. تغییر ثابت RRF بهتنهایی این مشکلات را حل نمیکند.
استفاده از RRF درQdrant
Qdrant امکان ترکیب نتایج بازیابی بردارهای متراکم و پراکنده را در Query APIفراهم میکند. در این ساختار، هر Prefetch نامزدهای یک مسیر را میگیرد و مرحله Fusion آنها را ترکیب میکند. Qdrant
مثال زیر فرض میکند:
- Collectionقبلاً ساخته شده است.
- هر سند دارای بردارهای نامگذاریشده
denseوsparseاست. - بردارهای پرسش با همان روشهای مرحله نمایهسازی تولید شدهاند.
from qdrant_client import QdrantClient, models


def hybrid_search(
    client: QdrantClient,
    collection_name: str,
    dense_query_vector: list[float],
    sparse_query_vector: models.SparseVector,
):
    response = client.query_points(
        collection_name=collection_name,
        prefetch=[
            models.Prefetch(
                query=dense_query_vector,
                using="dense",
                limit=50,
            ),
            models.Prefetch(
                query=sparse_query_vector,
                using="sparse",
                limit=50,
            ),
        ],
        query=models.FusionQuery(
            fusion=models.Fusion.RRF,
        ),
        limit=10,
        with_payload=True,
    )

    return response.points
این قطعهکد تولید بردار یا نمایهسازی اسناد را انجام نمیدهد. بردار پراکنده نیز باید از مدل یا روش سازگار با نمایه موجود تولید شود؛ تبدیل دلخواه بردار متراکم به بردار پراکنده کافی نیست.
تنظیمات RRF در ابزارها الزاماً یکسان نیست
نام مشترک RRF به معنی یکسانبودن تمام پیشفرضها و قراردادها نیست.
مستندات فعلی Qdrant، مقدار پیشفرض k را ۲ اعلام میکند و توضیح میدهد که برای بازتولید قرارداد مقاله اصلی با رتبههای یکمبنا و ثابت ۶۰، در قرارداد Qdrant باید از k=61 استفاده شود.
همچنین تعریف وزنها در تنظیمات پیشرفته Qdrant با ضرب مستقیم سهم در تابع آموزشی بالا یکسان نیست. بنابراین، وزنهای این تابع را نباید بدون بررسی به ابزار دیگری منتقل کرد. qdrant.tech
نکات مهم برای جستوجوی فارسی
RRFمستقل از زبان است، اما کیفیت فهرستهای ورودی به پردازش زبان وابسته میماند.
یکسانسازی متن در مسیر واژگانی
تفاوت «ی» و «ي»، «ک» و «ك»، نیمفاصله و شیوه نگارش اعداد میتواند بر تطبیق واژگانی اثر بگذارد.
پیشپردازش پرسش و سند باید هماهنگ باشد. در عین حال، حذف یا تغییر نشانهها نباید کد محصول، نسخه نرمافزار یا عبارت فنی مهم را خراب کند.
ارزیابی مدل معنایی روی فارسی واقعی
وجود پشتیبانی چندزبانه بهتنهایی کیفیت مدل روی اسناد سازمان شما را ثابت نمیکند.
مجموعه آزمایش بهتر است شامل پرسشهای رسمی، محاورهای، غلطهای تایپی و ترکیب فارسی با اصطلاحات انگلیسی باشد.
استفاده از شناسه مشترک
دو مسیر بازیابی باید برای یک قطعه متن، شناسه یکسان برگردانند.
اگر همان محتوا در یک مسیر با شناسه doc-17 و در مسیر دیگر با شناسه chunk-93 نمایش داده شود، RRF آنها را دو نتیجه متفاوت در نظر میگیرد.
تفکیک سند و قطعه
اگر بازیابی در سطح Chunk انجام میشود، ترکیب نیز معمولاً باید در همان سطح انجام شود.
یکیکردن تمام قطعات یک سند میتواند بخش مرتبط را پنهان کند. از طرف دیگر، انتخاب چند قطعه نزدیک از یک سند ممکن است زمینه نهایی را تکراری کند. این مسئله به سیاست انتخاب زمینه نیاز دارد.
ترکیب چند بازنویسی پرسش
میتوان برای یک پرسش چند نسخه ساخت و نتایج جستوجوی آنها را ترکیب کرد.
بااینحال، تعداد فهرستها بر امتیاز نهایی اثر دارد. اگر پنج بازنویسی مشابه از مسیر معنایی و فقط یک فهرست واژگانی داشته باشیم، وزن برابر هر فهرست به معنی وزن برابر دو خانواده بازیابی نیست.
برای کنترل این مسئله میتوان:
- تعداد بازنویسیها را محدود کرد.
- بازنویسیهای بسیار مشابه را کنار گذاشت.
- مجموع وزن فهرستهای هر خانواده را کنترل کرد.
- خروجی هر خانواده را ابتدا جداگانه ترکیب کرد.
اینها انتخابهای طراحیاند و باید با آزمایش مقایسه شوند. افزودن فهرستهای بیشتر، بهخودیخود شواهد مستقل بیشتری ایجاد نمیکند.
چگونه کیفیت RRF را ارزیابی کنیم؟
ارزیابی باید نشان دهد ترکیب چه چیزی را نسبت به هر روش مستقل بهتر کرده است.
حداقل این حالتها را مقایسه کنید:
| آزمایش | هدف |
|---|---|
| فقط بازیابی واژگانی | ساخت خط مبنا |
| فقط بازیابی معنایی | سنجش مسیر برداری |
| RRF با وزن برابر | سنجش اثر ترکیب |
| RRF با تنظیمات منتخب | سنجش اثر تنظیم پارامتر |
| RRF همراه Reranker | سنجش ارزش مرحله اضافی |
برای هر پرسش، اسناد مرتبط را مشخص کنید. اگر ارتباط درجهبندیشده است، میان «کاملاً مرتبط»، «تا حدی مرتبط» و «نامرتبط» تفاوت بگذارید.
معیارهای مفید عبارتاند از:
- Recall@K: چه سهمی از اسناد مرتبط در K نتیجه حضور دارد؟
- nDCG@K: آیا اسناد مرتبطتر جایگاه بالاتری گرفتهاند؟
- MRR: نخستین نتیجه مرتبط چقدر زود ظاهر میشود؟
- زمان پاسخ: ترکیب چه اثری بر تجربه کاربر دارد؟
- هزینه پردازش: نامزدهای بیشتر چه هزینهای ایجاد میکنند؟
نمونه محاسبهRecall
def recall_at_k(
    ranking: list[str],
    relevant_ids: set[str],
    k: int,
) -> float:
    if not relevant_ids:
        raise ValueError(
            "relevance labels are required"
        )

    retrieved_ids = set(ranking[:k])

    found_ids = (
        retrieved_ids & relevant_ids
    )

return len(found_ids) / len(relevant_ids)پرسشهای واقعاً بدون پاسخ باید گروه ارزیابی جداگانه داشته باشند. آنها را نباید با پرسشهایی که هنوز برچسب ارتباط ندارند یکسان دانست.
تنظیم وزن و ثابت را روی مجموعه اعتبارسنجی انجام دهید و نتیجه نهایی را روی پرسشهای کنارگذاشتهشده بسنجید. میانگین کلی را نیز به تفکیک نوع پرسش بررسی کنید؛ ممکن است بهبود پرسشهای عمومی، افت عملکرد روی کدهای خطا را پنهان کند.
آیا بهترشدن بازیابی، پاسخ RAG را هم بهتر میکند؟
بازیابی بهتر میتواند زمینه مناسبتری فراهم کند، اما کافی نیست.
مدل مولد ممکن است از سند مرتبط استفاده نکند، بخش مهم آن را نادیده بگیرد یا پاسخ را با استناد نامناسب بنویسد.
بنابراین، علاوه بر رتبهبندی اسناد، خروجی نهایی را نیز بررسی کنید:
- آیا پاسخ با منابع بازیابیشده سازگار است؟
- آیا بخش لازم برای پاسخ در زمینه وجود دارد؟
- آیا استناد به قطعه درست انجام شده است؟
- آیا پاسخ، محدودیتها و استثناهای سند را حفظ کرده است؟
- آیا برای پرسش بدون پاسخ، رفتار مناسب دارد؟
برای مقایسه منصفانه اثر RRF، مدل مولد، دستور پاسخگویی و بودجه زمینه را در آزمایش ثابت نگه دارید.
اشتباهات رایج هنگام استفاده ازRRF
تلقی امتیاز RRF بهعنوان احتمال
امتیاز ۰٫۰۳ به معنی سه درصد احتمال ارتباط نیست. این عدد حاصل ترکیب رتبههاست.
استفاده از آستانه ثابت برای همه تنظیمات
تعداد فهرستها، وزنها و ثابت رتبه مقیاس امتیاز را تغییر میدهند. آستانهای که در یک تنظیم کاربرد دارد، الزاماً به تنظیم دیگر منتقل نمیشود.
افزودن بازیاب ضعیف بدون ارزیابی
فهرست نامناسب میتواند به اسناد نامرتبط سهم بدهد و رتبهبندی را خراب کند.
تنظیم پارامتر روی داده آزمون
اگر بارها تنظیمات را بر اساس نتیجه Test تغییر دهید، آن مجموعه دیگر ارزیابی مستقلی نیست.
نادیدهگرفتن نتایج تکراری
شناسههای متفاوت برای محتوای یکسان، یا چند قطعه مشابه، میتوانند فضای خروجی را اشغال کنند.
مرتبسازی ناپایدار در امتیازهای برابر
برای نتایج مساوی، یک قاعده ثابت مانند شناسه تعیین کنید تا مقایسه آزمایشها قابل تکرار باشد.
اتصال مسیر معنایی به API درواره
در معماری جستوجوی ترکیبی، میتوان بردارهای معنایی را از API دریافت کرد و بازیابی واژگانی و ترکیب رتبهها را در برنامه خود انجام داد.
مثال زیر نحوه دریافت Embedding را با ساختار کلاینت سازگار نشان میدهد. شناسه مدل باید از مدلهای موجود و پشتیبانیشده انتخاب شود.
pip install openaiimport os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
texts = [
"چرا درخواست API بعد از مدتی قطع میشود؟",
"راهنمای تنظیم Timeout در درخواستهای API",
"آموزش دریافت پاسخ بهصورت Streaming",
"راهنمای دریافت فاکتور",
]
response = client.embeddings.create(
model=os.environ[
"DARVAREH_EMBEDDING_MODEL"
],
input=texts,
)
ordered_items = sorted(
response.data,
key=lambda item: item.index,
)
vectors = [
item.embedding
for item in ordered_items
]
query_vector = vectors[0]
document_vectors = vectors[1:]در پروژه واقعی، بردار اسناد هنگام نمایهسازی تولید و ذخیره میشود. هنگام دریافت پرسش، فقط بردار پرسش را میسازید، نتایج معنایی را میگیرید و شناسههای آنها را همراه نتایج واژگانی به تابع RRF میدهید.
مدل، ابعاد بردار و پیشپردازش باید میان مرحله نمایهسازی و پرسوجو سازگار باشند. محدودیت ورودی و امکانات مدل منتخب را در مستندات درواره بررسی کنید.
پرسشهای متداول
RRFچیست؟
روشی برای تبدیل چند فهرست رتبهبندیشده به یک فهرست واحد است. سهم هر سند بر اساس جایگاه آن در فهرستهای ورودی محاسبه میشود.
آیا RRF به آموزش مدل نیاز دارد؟
نسخه پایه نیازمند آموزش نیست. بااینحال، انتخاب تنظیمات مناسب به ارزیابی روی پرسشهای واقعی نیاز دارد.
آیا RRF همیشه بهتر از جستوجوی معنایی است؟
خیر. کیفیت ترکیب به کیفیت و مکملبودن مسیرهای بازیابی بستگی دارد.
آیا برای RRF باید امتیازهای BM25 را نرمال کنیم؟
خود RRF از رتبه استفاده میکند و به نرمالسازی امتیاز خام نیاز ندارد.
آیا ثابت رتبه همیشه باید ۶۰ باشد؟
خیر. این مقدار یک انتخاب شناختهشده است. مقدار مناسب و حتی قرارداد پارامتر در ابزارهای مختلف باید بررسی شود.
آیا RRF اسناد تکراری را حذف میکند؟
شناسه مشترک در خروجی یکبار نمایش داده میشود، اما محتوای مشابه با شناسههای متفاوت الزاماً حذف نمیشود.
آیا RRF جایگزین Reranker است؟
این دو کار متفاوتی انجام میدهند و میتوانند در یک خط لوله استفاده شوند.
آیا RRF برای فارسی مناسب است؟
الگوریتم محدودیت زبانی خاصی ندارد. کیفیت عملی آن به پردازش فارسی و عملکرد بازیابهای ورودی وابسته است.
جمعبندی
RRFراهی ساده برای ترکیب نتایج چند روش بازیابی است. استفاده از رتبه، مسئله مقایسه مستقیم امتیازهای نامتجانس را کاهش میدهد و پیادهسازی آن هزینه کمی دارد.
بااینحال، موفقیت آن به کیفیت نامزدها، شناسههای سازگار، عمق بازیابی و تنظیمات ترکیب وابسته است. RRF سند گمشده را پیدا نمیکند و ارتباط یا صحت محتوا را تضمین نمیکند.
برای شروع، روشهای مستقل را با ترکیب وزن برابر مقایسه کنید. سپس تنظیمات را روی داده اعتبارسنجی انتخاب کنید و اثر نهایی را هم در رتبهبندی و هم در پاسخ RAG بسنجید.
مقالات مرتبط
- جستوجوی ترکیبی؛ ترکیب BM25 و جستوجوی برداری
- Reranking و Cross-Encoder در RAG
- Embeddingچیست؟
- جستوجوی معنایی چیست؟
- Chunkingو قطعهبندی متن
- ارزیابی بازیابی و تولید پاسخ درRAG
- RAGچیست؟
منابع
- مقاله اصلی Reciprocal Rank Fusion؛SIGIR 2009
- مستندات رسمی RRF درElasticsearch
- مستندات رسمی Hybrid Queries درQdrant
- راهنمای تنظیم جستوجوی ترکیبی درQdrant
- مستندات Retrieve & Re-Rank درSentence Transformers
- مستندات API درواره
شروع ساخت جستوجوی ترکیبی با درواره
برای ساخت جستوجوی اسناد یا دستیار پاسخگویی، میتوانید مسیر معنایی را با مدل Embedding پشتیبانیشده درواره آزمایش کنید و نتایج آن را در برنامه خود با جستوجوی واژگانی ترکیب کنید.
یک نمونه اولیه کوچک بسازید، چند پرسش فارسی واقعی انتخاب کنید و کیفیت بازیابی مستقل و RRF را کنار هم بسنجید. این مقایسه به شما نشان میدهد ترکیب نتایج برای داده و کاربردتان ارزش دارد یا خیر.
برای بررسی خدمات و شروع استفاده از API هوش مصنوعی، به درواره مراجعه کنید.
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.