Contextual Retrieval چیست؟ آموزش بازیابی زمینهمند در RAG با Python
Contextual Retrieval چیست و چگونه بافت ازدسترفته قطعات متن را به RAG بازمیگرداند؟ در این راهنما، بازیابی زمینهمند، Contextual Embeddings و Contextual BM25 را با مثال فارسی، کد Pythonو روش ارزیابی بررسی میکنیم.

فرض کنید یک دستیار هوش مصنوعی باید از میان اسناد محصولات یک شرکت، شرایط تمدید اشتراک را پیدا کند.
در یکی از قطعات متن آمده است:
تمدید این طرح فقط با پرداخت سالانه امکانپذیر است.
این جمله روشن به نظر میرسد، اما وقتی از سند اصلی جدا شود، چند سؤال بیپاسخ میماند:
- منظور کدام محصول است؟
- «این طرح» به کدام اشتراک اشاره میکند؟
- آیا جمله مربوط به نسخه فعلی شرایط است؟
- آیا محدودیت برای همه مشتریان اعمال میشود؟
در سامانههای RAG، اسناد معمولاً به قطعات کوچکتر تقسیم میشوند. این کار برای جستوجو مفید است، اما گاهی اطلاعاتی را که معنای یک قطعه به آن وابسته است، از آن جدا میکند.
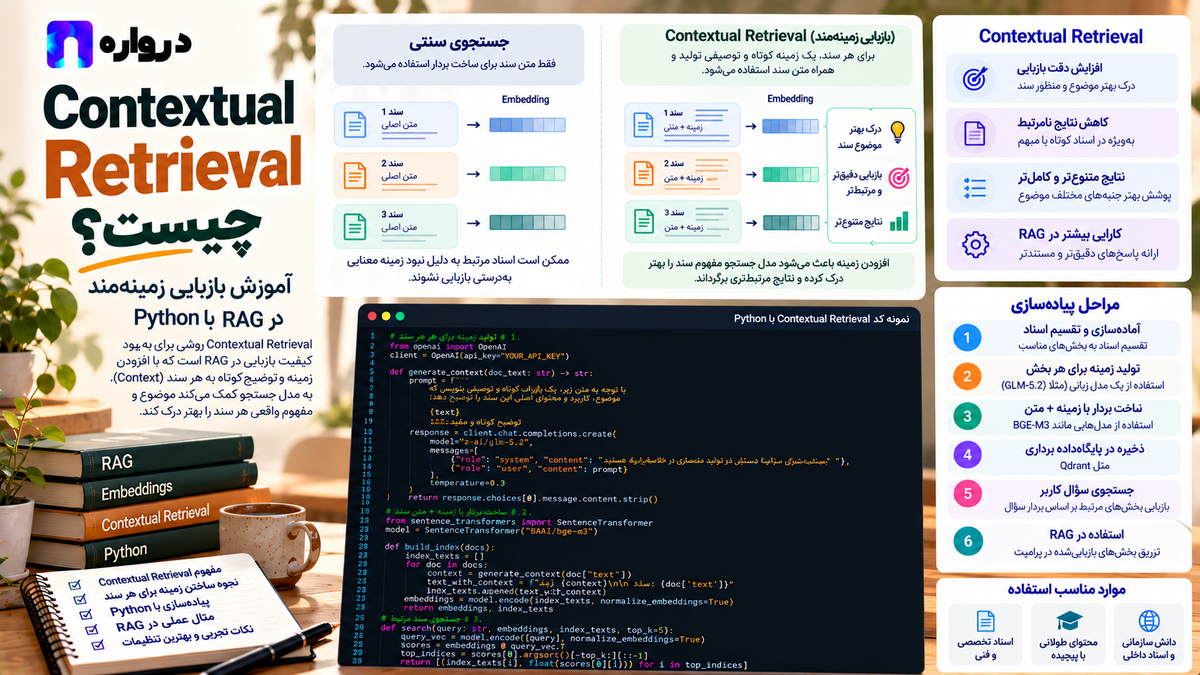
Contextual Retrievalیا بازیابی زمینهمند برای کاهش همین مشکل به کار میرود: پیش از نمایهسازی، توضیح کوتاهی درباره جایگاه هر قطعه در سند به آن اضافه میکنیم.
هدف این است که موتور جستوجو فقط یک جمله جداافتاده را نبیند؛ بلکه بداند آن جمله درباره چه موضوع، محصول یا بخش مشخصی از سند است.
در این مقاله، سازوکار این روش، محدودیتها، پیادهسازی فارسی با Python و نحوه ارزیابی آن را بررسی میکنیم.
Contextual Retrievalچیست؟
در روش معرفیشده توسط Anthropic، برای هر قطعه متن یک توضیح مختصر و مخصوص همان قطعه تولید میشود. این توضیح پیش از ساخت بردار معنایی و نمایه واژگانی به متن قطعه اضافه میشود.
دو جزء اصلی این روش عبارتاند از:
- Contextual Embeddings: ساخت بردار از قطعه همراه با توضیح زمینهای
- Contextual BM25: نمایهسازی واژگانی همان متن تکمیلشده
Anthropic این روش را در سپتامبر ۲۰۲۴ معرفی کرد. این تغییر در مرحله آمادهسازی اسناد انجام میشود و بهخودیخود به معنی آموزش مجدد مدل Embeddingنیست. anthropic.com
برای مثال، قطعه قبلی میتواند هنگام نمایهسازی چنین نمایش داده شود:
زمینه: این بخش از راهنمای اشتراک محصول «الف» درباره شیوه پرداخت برای تمدید طرح حرفهای است.
متن اصلی: تمدید این طرح فقط با پرداخت سالانه امکانپذیر است.
اگر کاربر نام محصول و طرح را در پرسش بیاورد، متن نمایهشده اکنون اطلاعات لازم برای تطبیق را دارد.
این مثال فرضی است و شرایط هیچ سرویس واقعی را بیان نمیکند.
چرا قطعهبندی باعث ازدسترفتن بافت میشود؟
معنای یک عبارت همیشه در همان جمله قرار ندارد.
عنوان سند، تیتر بخش، جملههای قبلی، سرستونهای جدول و تعریف اصطلاحات میتوانند برای فهم یک قطعه ضروری باشند.
برای نمونه، عبارتهای زیر به اطلاعات اطراف خود وابستهاند:
- «این سرویس»
- «در حالت دوم»
- «شرایط فوق»
- «نسخه جدید»
- «مبلغ یادشده»
- «برای مشتریان این گروه»
اگر عنوان بخش «اشتراک سازمانی» در قطعه دیگری قرار گرفته باشد، موتور بازیابی ممکن است نتواند ارتباط یک جمله با پرسش درباره همان اشتراک را تشخیص دهد.
مشکل فقط ضمیرها نیست. یک قطعه از جدول ممکن است مقدار و واحد داشته باشد، اما نام محصول یا دوره زمانی آن در بخش دیگری از سند آمده باشد.
پیش از اضافهکردن مدل زبانی، باید بررسی کنیم آیا استخراج بهتر متن و حفظ ساختار سند مشکل را حل میکند یا خیر. گاهی افزودن عنوان و مسیر بخش، راهحل کافی و کمهزینهتری است.
تفاوت Contextual Retrieval با بزرگکردنChunk
افزایش اندازه قطعه میتواند بخشی از بافت را حفظ کند، اما پیامدهای دیگری دارد.
یک قطعه بزرگ ممکن است همزمان درباره چند موضوع صحبت کند. در این حالت، یافتن بخش دقیق پاسخ دشوارتر میشود و متن بیشتری نیز وارد زمینه مدل مولد خواهد شد.
در بازیابی زمینهمند، تلاش میکنیم قطعه اصلی نسبتاً مشخص باقی بماند و فقط اطلاعات لازم برای شناخت جایگاه آن اضافه شود.
| روش | تغییر اصلی | محدودیت احتمالی |
|---|---|---|
| بزرگکردن Chunk | افزودن متن بیشتری از سند | ورود موضوعات نامرتبط |
| افزایش Overlap | تکرار بخشی از قطعات مجاور | افزایش حجم و نتایج مشابه |
| افزودن عنوان و مسیر بخش | تکمیل قطعه با ساختار واقعی سند | ناکافیبودن برای بعضی ارجاعها |
| Contextual Retrieval | افزودن توضیح مخصوص هر قطعه | هزینه تولید و احتمال خطای توضیح |
| گسترش متن پس از بازیابی | دریافت بخشهای اطراف نتیجه | رفعنشدن بعضی خطاهای بازیابی اولیه |
این روشها قابل ترکیباند. برای مثال، میتوان عنوان بخش را حفظ کرد و فقط برای قطعات مبهم توضیح تولید کرد.
تفاوت با خلاصهسازی سند، HyDE وSentence Window
خلاصه عمومی سند
خلاصه عمومی میگوید کل سند درباره چیست. اما توضیح زمینهای باید جایگاه همان قطعه را مشخص کند.
اگر یک راهنما شامل پرداخت، نصب، خطاها و تمدید باشد، افزودن خلاصه یکسان به تمام قطعات ممکن است واژگان نامرتبط را در سراسر نمایه پخش کند.
HyDE
در HyDE، یک پاسخ یا سند فرضی بر اساس پرسش کاربر تولید میشود و برای جستوجو به کار میرود.
در Contextual Retrieval، اسناد واقعی پیش از دریافت پرسش تکمیل میشوند. بنابراین، محل تغییر در خط لوله متفاوت است.
Sentence Window
در روش Sentence Window میتوان جملههای کوتاه را بازیابی کرد و پس از یافتن نتیجه، جملههای اطراف آن را به مدل داد. مستندات LlamaIndex این الگو را با نگهداری پنجره همسایه در Metadata و جایگزینی متن پس از بازیابی نشان میدهد. Developer Documentation
Contextual Document Embeddings
این نام نیز الزاماً به روش افزودن توضیح متنی اشاره نمیکند. پژوهش «Contextual Document Embeddings» روشهایی برای واردکردن اطلاعات اسناد همسایه در آموزش و معماری بازنمایی معرفی میکند. این موضوع با پیشپردازش متنی مورد بحث این مقاله تفاوت دارد. arxiv.org
شواهد پژوهشی چه میگویند؟
در گزارش Anthropic، نرخ شکست بازیابی در ۲۰ نتیجه نخست برای ترکیب Contextual Embeddings و Contextual BM25 از ۵٫۷ درصد به ۲٫۹ درصد کاهش یافت. با اضافهشدن Reranking، مقدار گزارششده به ۱٫۹ درصد رسید.
کاهشهای نسبی اعلامشده بهترتیب حدود ۴۹ و ۶۷ درصد بودند. این اعداد مربوط به خطای بازیابی در آزمایشهای گزارششده هستند؛ به معنی افزایش ۶۷ درصدی دقت پاسخ یا بهبود تضمینشده روی فارسی نیستند. anthropic.com
برای استفاده عملی باید آزمایش مشابهی روی اسناد خود انجام دهیم. مهم است بدانیم روش جدید چه نوع خطایی را اصلاح میکند و آیا هزینه آن با بهبود بهدستآمده تناسب دارد.
معماری پیشنهادی برای پیادهسازی
در طراحی این مقاله، برای هر قطعه سه متن جدا نگه میداریم:
| فیلد | محتوا | کاربرد |
|---|---|---|
original_text | متن اصلی قطعه | نمایش و استناد |
context_text | توضیح زمینهای تولیدشده | کمک به بازیابی |
retrieval_text | ترکیب زمینه و متن اصلی | Embedding و نمایه واژگانی |
همچنین شناسه سند، شناسه قطعه و نسخه سند را ذخیره میکنیم.
این جداسازی اجازه میدهد در زمان بررسی خطا بفهمیم اطلاعات از منبع آمدهاند یا در توضیح تولیدشده اضافه شدهاند.
در Cookbook رسمی Anthropic نیز متن اصلی و توضیح زمینهای در Metadata جدا نگهداری میشوند. Claude Cookbook
آموزش عملی با Python و API درواره
در مثال زیر، دو سند فرضی فارسی داریم. هدف، ساخت یک نمونه کوچک برای مقایسه بازیابی معمولی و زمینهمند است.
این مثال:
- اسناد را بر اساس پاراگراف تقسیم میکند.
- برای هر قطعه توضیح کوتاه تولید میکند.
- متن اصلی و توضیح را جدا ذخیره میکند.
- بردارهای معمولی و زمینهمند را میسازد.
- رتبهبندی معنایی را مقایسه میکند.
- نمایه BM25 زمینهمند میسازد.
نصب کتابخانهها
pip install openai numpy rank-bm25مدلهای مورد استفاده را از فهرست فعلی مدلهای پشتیبانیشده انتخاب کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_CHAT_MODEL="YOUR_CHAT_MODEL_ID"
export DARVAREH_EMBEDDING_MODEL="YOUR_EMBEDDING_MODEL_ID"
تعریف اسناد و قطعات
import osfrom dataclasses import dataclassfrom openai import OpenAIclient = OpenAI( api_key=os.environ["DARVAREH_API_KEY"], base_url="https://api.darvareh.ir/v1",)documents = [ { "id": "product-a", "title": "راهنمای اشتراک محصول الف", "version": "example-v1", "text": ( "طرح حرفهای محصول الف برای تیمهای کوچک " "ارائه میشود.\n\n" "تمدید این طرح فقط با پرداخت سالانه " "امکانپذیر است." ), }, { "id": "product-b", "title": "راهنمای اشتراک محصول ب", "version": "example-v1", "text": ( "طرح حرفهای محصول ب برای استفاده فردی " "ارائه میشود.\n\n" "تمدید این طرح با پرداخت ماهانه یا سالانه " "امکانپذیر است." ), },]تقسیم بر اساس پاراگراف برای این نمونه کافی است. در اسناد واقعی، تیترها، فهرستها و جدولها نیز باید در طراحی قطعهبندی لحاظ شوند.
تولید توضیح زمینهای
دستور تولید باید بر تعیین موضوع قطعه تمرکز کند. توضیح نباید حکم جدیدی بسازد یا شرایط سند را تغییر دهد.
def generate_context(
document: dict,
chunk_text: str,
) -> str:
response = client.chat.completions.create(
model=os.environ["DARVAREH_CHAT_MODEL"],
messages=[
{
"role": "system",
"content": (
"برای نمایهسازی متن فارسی، یک توضیح "
"زمینهای کوتاه بنویس. "
"فقط از اطلاعات سند استفاده کن. "
"مشخص کن قطعه درباره کدام محصول، طرح "
"یا موضوع سند است. "
"شرط، عدد یا نتیجه جدید اضافه نکن. "
"اگر اطلاعات کافی نیست، حدس نزن. "
"فقط یک یا دو جمله توضیح برگردان."
),
},
{
"role": "user",
"content": (
f"عنوان سند:\n{document['title']}\n\n"
f"متن کامل سند:\n{document['text']}\n\n"
f"قطعه موردنظر:\n{chunk_text}"
),
},
],
)
context = (
response.choices[0].message.content or ""
).strip()
if not context:
raise ValueError(
"The model returned an empty context"
)
if len(context) > 600:
raise ValueError(
"Context is too long; revise the prompt"
)
return contextکنترل طول فقط از خروجی بسیار بلند جلوگیری میکند؛ صحت توضیح را تضمین نمیکند. در مرحله آزمایشی، تمام توضیحهای این نمونه را با سند اصلی تطبیق دهید.
ساخت رکوردهای نمایهسازی
chunks = []for document in documents: paragraphs = [ paragraph.strip() for paragraph in document["text"].split("\n\n") if paragraph.strip() ] for position, paragraph in enumerate(paragraphs): context = generate_context( document, paragraph, ) chunks.append( Chunk( id=f"{document['id']}:{position}", document_id=document["id"], document_version=document["version"], original_text=paragraph, context_text=context, retrieval_text=( f"زمینه: {context}\n" f"متن اصلی: {paragraph}" ), ) )for chunk in chunks: print(chunk.id) print(chunk.context_text) print(chunk.original_text) print()این مرحله هنگام ورود یا بهروزرسانی اسناد انجام میشود. لازم نیست برای هر پرسش کاربر دوباره زمینه تمام قطعات تولید شود.
ساخت Embedding معمولی و زمینهمند
برای مقایسه، از دو نمایش استفاده میکنیم:
- بردار متن اصلی
- بردار متن اصلی همراه با توضیح زمینهای
import numpy as npdef embed_texts(texts: list[str]) -> np.ndarray: response = client.embeddings.create( model=os.environ[ "DARVAREH_EMBEDDING_MODEL" ], input=texts, ) items = sorted( response.data, key=lambda item: item.index, ) if len(items) != len(texts): raise ValueError( "Unexpected number of embeddings" ) vectors = np.asarray( [item.embedding for item in items], dtype=np.float32, ) if not np.isfinite(vectors).all(): raise ValueError( "Embeddings contain non-finite values" ) norms = np.linalg.norm( vectors, axis=1, keepdims=True, )در این نمونه، بردارها نرمال میشوند تا ضرب داخلی آنها برای مقایسه شباهت کسینوسی استفاده شود.
همچنین باید محدودیت طول ورودی مدل را بررسی کنید. Cookbook رسمی هشدار میدهد که افزودن زمینه میتواند باعث عبور از سقف ورودی بعضی مدلها و بریدهشدن متن شود. Claude Cookbook
مقایسه رتبهبندی معنایی
def semantic_ranking( query_vector: np.ndarray, document_vectors: np.ndarray, limit: int = 4,): scores = document_vectors @ query_vector positions = sorted( range(len(scores)), key=lambda index: ( -float(scores[index]), chunks[index].id, ), )[:limit] return [ ( chunks[index].id, float(scores[index]), ) for index in positions ]query = ( "تمدید طرح حرفهای محصول الف " "با پرداخت ماهانه امکانپذیر است؟")query_vector = embed_texts([query])[0]plain_results = semantic_ranking( query_vector, plain_vectors,)رتبههای واقعی به مدل و توضیحهای تولیدشده وابستهاند. نباید پیش از اجرا فرض کرد خروجی زمینهمند حتماً بهتر خواهد بود.
قطعه پاسخ در این نمونه، product-a:1 است. بررسی کنید آیا این قطعه در رتبههای بالاتر قرار گرفته و آیا نتیجه مربوط به محصول ب با آن اشتباه شده است.
ساختContextual BM25
برای ساخت نمایه واژگانی نیز از retrieval_text استفاده میکنیم.
کتابخانه rank_bm25 انتظار دارد متنها پیش از ورود توکنسازی شوند و خودش پیشپردازش زبانی را انجام نمیدهد. GitHub
import refrom rank_bm25 import BM25Okapidef tokenize_fa(text: str) -> list[str]: normalized = ( text.replace("ي", "ی") .replace("ك", "ک") .replace("\u200c", " ") .lower() ) return re.findall( r"\w+", normalized, )bm25 = BM25Okapi( [ tokenize_fa(chunk.retrieval_text) for chunk in chunks ])def lexical_ranking( query: str, limit: int = 4,): scores = bm25.get_scores( tokenize_fa(query) ) positions = sorted(این توکنساز برای آموزش ساده شده است. در کاربرد واقعی، حفظ کدهای محصول، اعداد، نسخهها و اصطلاحات انگلیسی نیز اهمیت دارد.
همچنین مجموعه چهارقطعهای برای نتیجهگیری درباره کیفیت BM25 کافی نیست. از آن فقط برای شناخت مسیر اجرا استفاده کنید.
ترکیب دو مسیر باRRF
پس از دریافت رتبههای واژگانی و معنایی، میتوان آنها را با RRF ترکیب کرد:
from collections import defaultdict


def fuse_rankings(
    rankings: list[list[str]],
    rank_constant: int = 60,
    limit: int = 4,
):
    scores = defaultdict(float)

    for ranking in rankings:
        unique_ids = list(dict.fromkeys(ranking))

        for rank, chunk_id in enumerate(
            unique_ids,
            start=1,
        ):
            scores[chunk_id] += (
                1.0 / (rank_constant + rank)
            )

    return sorted(
        scores.items(),
        key=lambda item: (
            -item[1],
            item[0],
        ),
    )[:limit]


fused_results = fuse_rankings(
    [
        [
            chunk_id
            for chunk_id, _ in lexical_results
        ],
        [
            chunk_id
            for chunk_id, _ in contextual_results
        ],
    ]
)

print(fused_results)
افزودن زمینه و ترکیب رتبهها دو تغییر جداگانهاند. برای فهم اثر هر کدام، باید آزمایشهای مستقل داشته باشید.
متن بازیابیشده را چگونه به مدل پاسخگو بدهیم؟
برای استناد، متن اصلی را نگه دارید. توضیح تولیدشده میتواند به مدل در شناخت موضوع کمک کند، اما باید از منبع اصلی قابل تشخیص باشد.
یک قالب پیشنهادی:
chunk_by_id = {
    chunk.id: chunk
    for chunk in chunks
}


def build_evidence(results):
    sections = []

    for chunk_id, _ in results:
        chunk = chunk_by_id[chunk_id]

        sections.append(
            f"شناسه منبع: {chunk.id}\n"
            f"نسخه سند: {chunk.document_version}\n"
            f"توضیح کمکی تولیدشده: "
            f"{chunk.context_text}\n"
            f"متن اصلی منبع:\n"
            f"{chunk.original_text}"
        )

    return "\n\n".join(sections)


evidence = build_evidence(fused_results)
در دستور پاسخگویی مشخص کنید که حکمها و استنادها باید بر متن اصلی تکیه داشته باشند.
اگر توضیحی برای یک قطعه با اطلاعات بخش دیگری از سند ساخته شده است، آن بخش پشتیبان را نیز نگهداری کنید. برای ادعایی که فقط در توضیح کمکی دیده میشود، ارجاع به همان قطعه اصلی کافی نیست.
چگونه یک توضیح زمینهای خوب بسازیم؟
توضیح مناسب، اطلاعات لازم برای شناسایی موضوع را اضافه میکند و از تبدیلشدن به پاسخ مستقل پرهیز میکند.
برای قطعهای درباره شرایط تمدید، ممکن است این موارد مفید باشند:
- نام محصول
- نام طرح
- عنوان بخش
- نوع مشتری، اگر در سند مشخص است
- نسخه یا دوره زمانی، اگر واقعاً در منبع وجود دارد
در مقابل، عبارتهایی مانند «بهترین انتخاب برای همه شرکتها» معمولاً به بازیابی کمک مشخصی نمیکنند و ممکن است ادعایی بدون پشتوانه باشند.
برای کنترل کیفیت، نمونهها را در چند گروه بررسی کنید: توضیح درست، توضیح بیشازحد عمومی، توضیح دارای اطلاعات اضافه و توضیح مربوط به موضوع اشتباه.
هزینه و بهروزرسانی نمایه
هزینه این روش فقط ساخت Embedding نیست. تولید توضیح برای هر قطعه نیز ورودی و خروجی مدل زبانی مصرف میکند.
اگر سند کامل برای تکتک قطعات ارسال شود، بخشی از ورودی بارها تکرار خواهد شد.
برای کنترل هزینه میتوان:
- ابتدا عنوان و مسیر بخش را بهعنوان خط مبنا آزمایش کرد.
- فقط قطعات مبهم را زمینهمند کرد.
- خروجی قطعات تغییریافته را دوباره تولید کرد.
- نسخه مدل و دستور تولید را ذخیره کرد.
- میزان مصرف واقعی را هنگام ورود اسناد اندازه گرفت.
اگر سرویس و مدل منتخب قابلیت Prompt Caching دارند، میتوان اثر آن را جداگانه بررسی کرد. وجود این قابلیت را برای هر مسیر API فرض نکنید.
هنگام تغییر سند، تنها قطعه ویرایششده ممکن است نیازمند بازسازی نباشد؛ تغییر عنوان، تعریف اصطلاح یا دامنه کاربرد میتواند توضیح سایر قطعات را نیز نامعتبر کند.
ارزیابی علمی بازیابی زمینهمند
برای مقایسه منصفانه، این حالتها را جدا بسنجید:
| حالت | هدف آزمایش |
|---|---|
| متن اصلی | خط مبنای بازیابی |
| متن اصلی همراه عنوان بخش | اثر Metadata واقعی |
| متن اصلی همراه توضیح تولیدشده | اثر زمینهمندکردن |
| زمینهمند همراه جستوجوی ترکیبی | اثر ترکیب مسیرها |
| حالت منتخب همراه Reranker | اثر بازرتبهبندی |
پرسشهای ارزیابی بهتر است شامل مواردی باشند که سند اصلی در آنها واقعاً بافت مهمی دارد: چند محصول مشابه، نسخههای متفاوت، ضمیرها، جدولها و شرایط دارای استثنا.
برای سنجش رتبهبندی میتوان از Recall@K، nDCG@K و MRR استفاده کرد. ابزار BEIR نیز چارچوبی برای ارزیابی روشهای بازیابی با معیارهای استاندارد فراهم میکند. GitHub
علاوه بر میانگین، خطاهای جدید را بررسی کنید. ممکن است توضیحها بازیابی نام محصول را بهتر کنند، اما با تکرار واژگان عمومی، قطعات نامرتبط را نیز بالاتر بیاورند.
پرسشهای آزمون را وارد دستور تولید زمینه نکنید. نمایه باید از اسناد ساخته شود، نه با اطلاع از پاسخهای مورد انتظار مجموعه آزمون.
اشتباهات رایج
جایگزینی متن اصلی با توضیح
این کار امکان بررسی و استناد دقیق را کاهش میدهد. متن اصلی باید حفظ شود.
افزودن خلاصه یکسان به همه قطعات
خلاصه عمومی ممکن است تفاوت موضوعی قطعات را کمرنگ کند.
اعتماد به دستور تولید بهعنوان تضمین صحت
دستور «حدس نزن» مفید است، اما جای ارزیابی خروجی را نمیگیرد.
اصلاح استخراج ضعیف PDF با مدل زبانی
اگر ترتیب متن یا سرستونهای جدول خراب شده باشد، ابتدا استخراج را اصلاح کنید.
فرض بهبود قطعی روی فارسی
نتایج یک آزمایش خارجی باید روی اسناد و پرسشهای فارسی دوباره سنجیده شوند.
تغییر همزمان تمام اجزای خط لوله
اگر مدل، قطعهبندی، RRF و Reranker را همزمان تغییر دهید، تشخیص علت بهبود یا افت دشوار میشود.
پرسشهای متداول
Contextual Retrievalچیست؟
روشی برای تکمیل قطعات متن با توضیحی کوتاه درباره جایگاه آنها در سند، پیش از نمایهسازی و بازیابی است.
Contextual Embeddingsچیست؟
بردارهایی هستند که از متن قطعه همراه با توضیح زمینهای ساخته میشوند.
آیا این روش به Fine-tuning نیاز دارد؟
در پیادهسازی مطرحشده، خیر. تغییر در متن ورودی مرحله نمایهسازی انجام میشود.
آیا باید از Claude استفاده کنیم؟
الزام فنی ندارد. میتوان مدل دیگری را آزمایش کرد، اما کیفیت و هزینه آن باید جداگانه ارزیابی شود.
آیا توضیح زمینهای برای هر پرسش ساخته میشود؟
در الگوی این مقاله، توضیح هنگام آمادهسازی اسناد ساخته و ذخیره میشود.
آیا عنوان سند کافی است؟
گاهی بله. به همین دلیل، عنوان و مسیر بخش باید یکی از خطهای مبنای ارزیابی باشند.
آیا توضیح تولیدشده قابل استناد است؟
استناد اصلی باید به متن منبع برگردد. توضیح کمکی جای سند اصلی را نمیگیرد.
آیا Contextual Retrieval خطای پاسخ را حذف میکند؟
خیر. هم تولید توضیح و هم تولید پاسخ ممکن است خطا داشته باشند.
جمعبندی
بازیابی زمینهمند برای قطعاتی مفید است که بدون عنوان، نام محصول یا اطلاعات بخشهای اطراف، معنای ناقصی دارند.
در این روش، توضیح کوتاهی پیش از ساخت Embedding و نمایه واژگانی به قطعه اضافه میشود. موفقیت آن به صحت توضیح، کیفیت استخراج متن و نتیجه ارزیابی وابسته است.
برای شروع، ابتدا افزودن ساختار واقعی سند را آزمایش کنید. سپس اثر توضیح تولیدشده را جدا بسنجید و متن اصلی را برای نمایش و استناد حفظ کنید.
مقالات مرتبط
- RAGچیست؟
- Chunkingو قطعهبندی متن
- جستوجوی ترکیبی با BM25 و بردار
- RRFو ترکیب رتبههای جستوجو
- HyDEو جستوجو با سند فرضی
- Reranking و Cross-Encoder
- ارزیابی بازیابی و تولید پاسخ درRAG
منابع
- Introducing Contextual Retrieval — Anthropic
- Contextual Retrieval Cookbook — Anthropic
- Sentence Window و Metadata Replacement — LlamaIndex
- Contextual Document Embeddings —مقاله پژوهشی
- مخزن رسمیrank_bm25
- مخزن رسمیBEIR
- مستندات API درواره
ساخت بازیابی زمینهمند با درواره
برای آزمایش این معماری، میتوانید از مدل زبانی پشتیبانیشده درواره برای تولید توضیح قطعات و از مدل Embedding برای ساخت مسیر جستوجوی معنایی استفاده کنید. نمایه واژگانی، ترکیب نتایج و نگهداری منابع نیز در برنامه شما انجام میشود.
با مجموعهای کوچک از اسناد فارسی شروع کنید و سه حالت «متن اصلی»، «متن همراه عنوان» و «متن زمینهمند» را مقایسه کنید. نتیجه این آزمایش مبنای مناسبی برای تصمیم درباره توسعه و هزینه پردازش خواهد بود.
برای بررسی مدلها و شروع استفاده از API هوش مصنوعی، به درواره مراجعه کنید.
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.