
HyDE چیست؟ آموزش بهبود بازیابی در RAG با سند فرضی و Python
HyDE چیست و چگونه با تولید یک سند فرضی، اسناد واقعی را پیدا میکند؟ در این راهنما، تفاوت با بازنویسی پرسش، محدودیتهای روش و پیادهسازی بازیابی فارسی با Python و API درواره را میآموزید.

در جستوجوی معنایی، پرسش کاربر و سند پاسخگو ممکن است از نظر شکل نوشتار تفاوت زیادی داشته باشند.
کاربر میپرسد:
چرا برنامهام بعضی وقتها منتظر پاسخ میماند و بعد خطا میدهد؟
اما مستندات فنی درباره «مهلت انتظار درخواست»، «تأخیر سرویس» و «زمان پاسخ» صحبت میکند.
یک مدل Embedding مناسب ممکن است این ارتباط را تشخیص دهد. بااینحال، اگر پرسش کوتاه، مبهم یا دور از زبان اسناد باشد، بازیابی مستقیم میتواند دشوار شود.
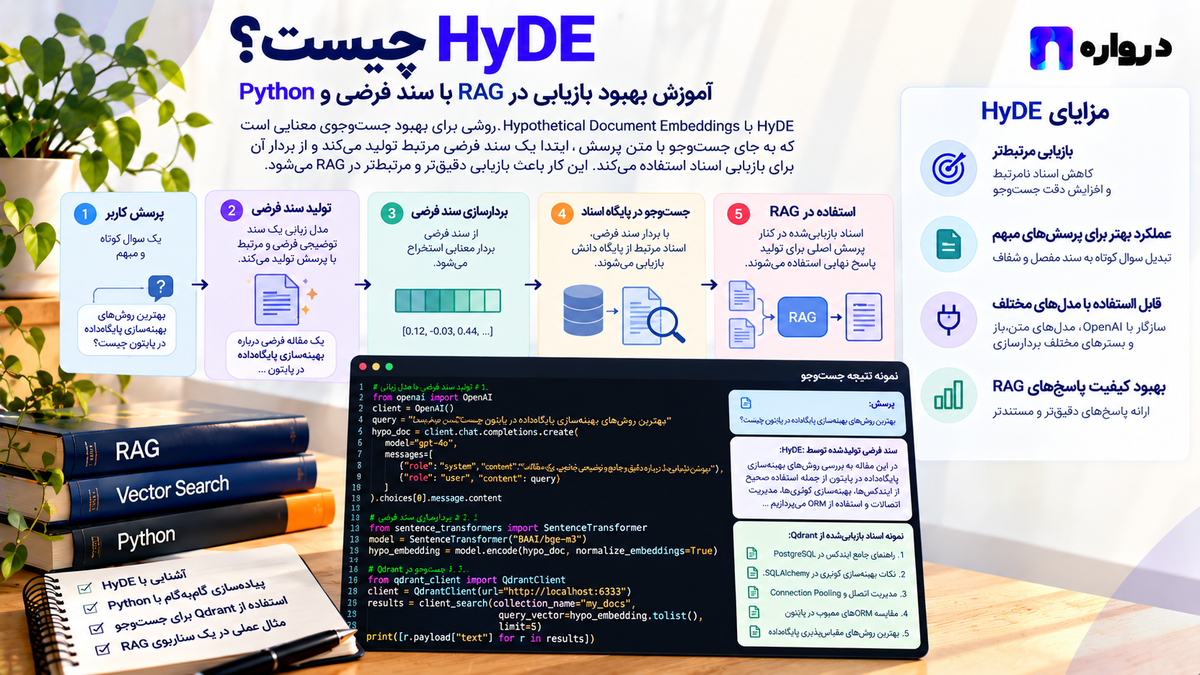
HyDE روشی است که ابتدا از مدل زبانی میخواهد یک سند فرضی مرتبط با پرسش بنویسد. سپس نمایش برداری آن سند را برای یافتن اسناد واقعی به کار میگیرد.
نکته اصلی همین است: سند فرضی، ابزار جستوجو است؛ منبع پاسخ نهایی نیست.
این روش در مقاله Precise Zero-Shot Dense Retrieval without Relevance Labels معرفی شد. پژوهش از یک مدل زبانی برای تولید متن فرضی و یک رمزگذار برای یافتن متنهای واقعی مشابه استفاده میکند. ACL Anthology
در این مقاله، سازوکار HyDE، تفاوت آن با بازنویسی پرسش، هزینهها و محدودیتها را بررسی میکنیم و یک نمونه آموزشی فارسی با Python میسازیم.
HyDEچیست؟
HyDEمخفف Hypothetical Document Embeddings است؛ یعنی استفاده از نمایش برداری سندهای فرضی.
در بازیابی مستقیم، خود پرسش به بردار تبدیل میشود. در HyDE، ابتدا متنی ساخته میشود که از نظر موضوع و سبک، شبیه یک سند پاسخگو باشد. سپس آن متن به بردار تبدیل میشود.
این بردار برای جستوجو در مجموعه اسناد واقعی استفاده خواهد شد.
سند تولیدشده ممکن است اطلاعات نادرست داشته باشد. روش HyDE آن را بهعنوان واقعیت تأیید نمیکند؛ بلکه از الگوی معنایی متن برای جهتدادن به بازیابی استفاده میکند.
HyDEچگونه کار میکند؟
اجرای ساده شامل چهار مرحله است:
- دریافت پرسش کاربر؛
- تولید یک متن فرضی مرتبط؛
- تبدیل متن فرضی به Embedding؛
- یافتن اسناد واقعی نزدیک به آن بردار.
پس از این مراحل، سامانه میتواند اسناد واقعی را بازرتبهبندی کند یا به مدل پاسخدهنده بدهد.
در مقاله اصلی، رمزگذار Contriever و مدل زبانی دنبالکننده دستور برای این طراحی استفاده شدند. نمونه این مقاله، یک اقتباس آموزشی با API سازگار و مدلهای انتخابی شماست؛ بازتولید دقیق آزمایش مقاله اصلی نیست. GitHub
چرا سند فرضی ممکن است به بازیابی کمک کند؟
یک پرسش کوتاه میتواند اطلاعات زبانی کمی داشته باشد. متن فرضی فرصت بیشتری برای بیان اصطلاحات و ارتباطهای موضوعی ایجاد میکند.
برای مثال:
پرسش:
چرا درخواست API دیر جواب میدهد؟
متن فرضی آموزشی:
تأخیر پاسخ API میتواند به زمان پردازش مدل، صف درخواستها، طول ورودی و مدت تولید خروجی مربوط باشد. برای بررسی، زمان دریافت اولین بخش پاسخ و زمان تکمیل درخواست را جدا اندازهگیری میکنند.
این متن، اصطلاحاتی دارد که ممکن است در مستندات مرتبط نیز دیده شوند.
اما همین گسترش میتواند مسئلهساز شود. اگر مدل فرض کند مشکل از شبکه است، در حالی که پرسش درباره صف پردازش است، جهت جستوجو ممکن است تغییر کند.
بنابراین فایده HyDE یک فرض قابلآزمایش است، نه نتیجهای تضمینشده.
تفاوت HyDE و بازنویسی پرسش
بازنویسی پرسش معمولاً تلاش میکند درخواست را روشنتر بیان کند.
HyDEتلاش میکند متنی شبیه سند پاسخگو بسازد.
| روش | خروجی نمونه |
|---|---|
| پرسش اصلی | «چرا برنامه دیر جواب میدهد؟» |
| بازنویسی پرسش | «علت افزایش زمان پاسخ درخواست API چیست؟» |
| گسترش پرسش | پرسش همراه اصطلاحات مرتبط |
| HyDE | یک پاراگراف شبیه توضیح فنی درباره زمان پاسخ |
این تفاوت بر انتخاب نوع رمزگذاری اثر دارد.
اگر مدل Embedding برای پرسش و سند پردازش متفاوتی دارد، متن فرضی HyDE معمولاً باید مطابق مسیر سند رمزگذاری شود. پیشوندها یا تنظیمات را از مستندات همان مدل بگیرید.
تفاوت HyDE وMulti-Query Retrieval
در Multi-Query، چند پرسش متفاوت تولید میشود و نتایج جستوجوی آنها ترکیب میشود.
در HyDE، متنهای فرضی تولید و نمایش برداری آنها برای جستوجو استفاده میشود.
| معیار | HyDE | Multi-Query |
|---|---|---|
| متن تولیدشده | سند فرضی | پرسشهای جایگزین |
| هدف اولیه | نزدیکشدن به زبان اسناد | پوشش بیانهای مختلف پرسش |
| روش ترکیب | میانگین بردارها یا ادغام نتایج | معمولاً ادغام نتایج |
| خطر قابلآزمایش | فرض پاسخ نادرست | تغییر معنا یا دامنه پرسش |
میتوان چند طراحی را مقایسه کرد، اما بهتر است در هر آزمایش فقط یک تغییر اصلی داشته باشید. افزودن همزمان چند تکنیک، تشخیص علت بهبود یا افت کیفیت را دشوار میکند.
آیا HyDE خطای مدل زبانی را حذف میکند؟
خیر.
ممکن است نمایش برداری متن فرضی، اسناد مرتبطی پیدا کند حتی اگر جزئیات متن نادرست باشند. اما هیچ تضمینی وجود ندارد که رمزگذار تمام اطلاعات ساختگی را بیاثر کند.
فرض کنید متن فرضی یک زمان بازپرداخت مشخص اختراع کند. این زمان ممکن است جهت بازیابی را به اسنادی با همان عدد ببرد.
برای طراحی عملی، پیشنهاد میشود:
- متن فرضی از منابع پاسخ نهایی جدا بماند؛
- پرسش اصلی حفظ شود؛
- اعداد، نامها و شرطهای پرسش تغییر نکنند؛
- نتیجه با بازیابی مستقیم مقایسه شود؛
- پاسخ نهایی فقط با اسناد واقعی ساخته شود.
اینها پیشنهادهای اجرایی برای کنترل خطا هستند، نه تضمین صحت خروجی.
چه زمانی HyDE را آزمایش کنیم؟
مستندات Haystack، HyDE را برای شرایطی مانند ضعف Recall بازیابی و تفاوت دامنه داده با دادههای معمول آموزش بازیاب مطرح میکند. Haystack Documentation
برای شروع، پرسشهایی را بررسی کنید که سند پاسخگو دارند اما بازیاب مستقیم آن را پیدا نمیکند.
نمونههای قابلآزمایش:
- پرسش محاورهای در برابر سند رسمی؛
- توضیح نشانه مشکل بدون اصطلاح فنی؛
- پرسش کوتاه درباره یک مفهوم تخصصی؛
- پرسشی که به شرح بیشتری برای تطبیق نیاز دارد.
در مقابل، برای شناسه دقیق، کد خطا یا نام محصول، ابتدا تطبیق واژگانی مناسب را بررسی کنید. تولید یک متن طولانی ممکن است جزئیات تعیینکننده را کمرنگ کند.
آموزش عملی HyDE باPython
در این مثال، مدل زبانی متن فرضی را تولید میکند و مدل Embedding بردارها را میسازد. از API درواره با کتابخانه Python سازگار استفاده میکنیم.
نمونه برای آموزش جریان پردازش است. اسناد آن ساختگیاند و شرایط واقعی خدمات درواره را بیان نمیکنند.
نصب کتابخانهها
pip install openai numpyتنظیم متغیرهای محیطی
شناسه مدلها را از فهرست فعلی مدلها و مستندات سرویس انتخاب کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_CHAT_MODEL="YOUR_CHAT_MODEL_ID"
export DARVAREH_EMBEDDING_MODEL="YOUR_EMBEDDING_MODEL_ID"
مدل Embedding باید برای زبان داده و مقایسه پرسش با اسناد مناسب باشد. تنظیمات ورودی آن را پیش از اجرای مثال بررسی کنید.
ساخت کلاینت
import osimport numpy as npfrom openai import OpenAIclient = OpenAI( api_key=os.environ["DARVAREH_API_KEY"], base_url="https://api.darvareh.ir/v1", timeout=45.0, max_retries=1,)CHAT_MODEL = os.environ["DARVAREH_CHAT_MODEL"]EMBEDDING_MODEL = os.environ["DARVAREH_EMBEDDING_MODEL"]کتابخانه رسمی Python امکان تنظیم آدرس پایه، مهلت انتظار و تعداد تلاش مجدد را دارد. GitHub
تعریف اسناد آموزشی
documents = [
{
"id": "latency",
"text": (
"برای بررسی تأخیر API، زمان دریافت اولین "
"بخش پاسخ و زمان تکمیل درخواست را جدا "
"اندازهگیری کنید. طول ورودی، طول خروجی "
"و زمان انتظار در صف را نیز بررسی کنید."
),
},
{
"id": "timeout",
"text": (
"اگر درخواست پیش از دریافت پاسخ قطع "
"میشود، تنظیم مهلت انتظار کلاینت و "
"واسطهای ارتباطی را بررسی کنید."
),
},
{
"id": "invoice",
"text": (
"فاکتور خرید از بخش صورتحسابهای حساب "
"کاربری قابل دریافت است."
),
},
{
"id": "embedding",
"text": (
"مدل Embedding متن را به بردار تبدیل "
"میکند. این بردار برای جستوجوی معنایی "
"و مقایسه متنها استفاده میشود."
),
},
]در مجموعه واقعی، شناسه هر قطعه، عنوان سند و محل آن در منبع را نیز نگه دارید.
تولید و نرمالسازی بردارها
تابع زیر بردارها را به ترتیب ورودی برمیگرداند:
def embed_texts(texts): response = client.embeddings.create( model=EMBEDDING_MODEL, input=texts, ) items = sorted( response.data, key=lambda item: item.index, ) if len(items) != len(texts): raise ValueError("Unexpected embedding count.") vectors = np.asarray( [item.embedding for item in items], dtype=np.float32, ) if vectors.ndim != 2 or not np.isfinite(vectors).all(): raise ValueError("Invalid embedding matrix.") norms = np.linalg.norm( vectors, axis=1, keepdims=True, ) if np.any(norms <= 1e-12): raise ValueError("Received a zero-length vector.") return vectors / normsdocument_vectors = embed_texts([ document["text"]در این مثال از شباهت کسینوسی استفاده میکنیم. اگر مدل به پیشوند پرسش، پیشوند سند یا گزینه مخصوص وظیفه نیاز دارد، تابع را مطابق همان مستندات تنظیم کنید.
ساخت Baseline با پرسش اصلی
پیش از HyDE، بازیابی مستقیم را اجرا میکنیم:
question = ( "چرا برنامهام برای جواب گرفتن از API " "خیلی منتظر میماند؟")def retrieve(vector, top_k=2): if vector.shape[0] != document_vectors.shape[1]: raise ValueError("Embedding dimensions do not match.") scores = document_vectors @ vector ranking = np.argsort( -scores, kind="stable", )[:top_k] return [ { **documents[int(index)], "score": float(scores[index]), } for index in ranking ]direct_vector = embed_texts([question])[0]direct_results = retrieve(direct_vector)for result in direct_results: print( result["id"], round(result["score"], 4), )این نتیجه، مبنای مقایسه است. اگر HyDE را بدون Baseline اجرا کنید، مشخص نمیشود مرحله تولید متن ارزش افزوده داشته است یا خیر.
تولید سند فرضی
پرامپت زیر یک پیشنهاد برای آزمایش است:
HYDE_INSTRUCTION = """
برای کمک به بازیابی اسناد، یک پاراگراف فرضی فارسی بنویس
که شبیه بخشی از مستندات مرتبط با پرسش باشد.
پرسش را با توضیح کوتاه و اصطلاحات مرتبط پوشش بده.
نام محصول، عدد، نسخه و شرطهای موجود در پرسش را حفظ کن.
زمان، قیمت، قابلیت یا قانون اختصاصی جدید اختراع نکن.
اگر جزئیات معلوم نیست، توضیح عمومی و مشروط بنویس.
حداکثر حدود ۱۲۰ کلمه بنویس.
این متن فقط برای جستوجو است و پاسخ تأییدشده نیست.
"""
def generate_hypothetical_document(question):
response = client.chat.completions.create(
model=CHAT_MODEL,
messages=[
{
"role": "system",
"content": HYDE_INSTRUCTION,
},
{
"role": "user",
"content": question,
},
],
)
text = response.choices[0].message.content
if not text or not text.strip():
raise ValueError("The model returned no text.")
return text.strip()
hypothetical_document = generate_hypothetical_document(
question
)
print(hypothetical_document)درخواست محدودیت طول در پرامپت، تضمین اجرای آن نیست. برای کنترل مصرف، پارامتر خروجی مورد پشتیبانی همان مدل و سرویس را نیز تنظیم کنید.
این دستور به دنبال محدودکردن جزئیات ساختگی است، اما ممکن است اثر آن بر بازیابی مثبت یا منفی باشد. نسخه پرامپت را همراه نتایج آزمایش ثبت کنید.
بازیابی با سند فرضی
hyde_vector = embed_texts([
    hypothetical_document
])[0]

hyde_results = retrieve(hyde_vector)

print("Direct retrieval:")
for result in direct_results:
    print(result["id"], round(result["score"], 4))

print("HyDE retrieval:")
for result in hyde_results:
    print(result["id"], round(result["score"], 4))
ترتیب و امتیاز واقعی به مدلهای انتخابشده و متن تولیدشده وابستهاند.
اگر دو مسیر اسناد یکسانی پیدا کنند، نمیتوان از همین مثال نتیجه گرفت HyDE بهتر است. باید پرسشهای بیشتری و معیارهای برچسبدار داشته باشید.
تولید پاسخ فقط از اسناد واقعی
در مرحله پاسخگویی، متن فرضی را وارد منابع نمیکنیم:
context = "\n\n".join(
f"[{item['id']}]\n{item['text']}"
for item in hyde_results
)
answer_response = client.chat.completions.create(
model=CHAT_MODEL,
messages=[
{
"role": "system",
"content": (
"به فارسی پاسخ بده. فقط از متن منابع "
"دادهشده استفاده کن. کنار ادعاها شناسه "
"منبع را بنویس. اگر منابع کافی نیستند، "
"این کمبود را روشن بیان کن."
),
},
{
"role": "user",
"content": (
f"پرسش:\n{question}\n\n"
f"منابع واقعی:\n{context}"
),
},
],
)
print(answer_response.choices[0].message.content)پرامپت ارجاع، جای بررسی کیفیت پاسخ را نمیگیرد. باید ارزیابی کنید که شناسهها درستاند و متن منبع واقعاً ادعای پاسخ را پشتیبانی میکند.
استفاده از چند سند فرضی
میتوان برای یک پرسش چند متن فرضی تولید کرد و بردارهای آنها را ترکیب کرد.
مستندات Haystack نمونهای ارائه میکند که چند سند فرضی را رمزگذاری و میانگین بردارهای آنها را برای بازیابی استفاده میکند. Haystack Documentation
در ادامه نمونه:
hypothetical_documents = [
    generate_hypothetical_document(question)
    for _ in range(3)
]

hypothetical_vectors = embed_texts(
    hypothetical_documents
)

average_vector = hypothetical_vectors.mean(axis=0)

norm = np.linalg.norm(average_vector)

if norm <= 1e-12:
    raise ValueError("The average vector has zero norm.")

average_vector = average_vector / norm

multi_hyde_results = retrieve(average_vector)
این انتخاب، سه فراخوانی تولید متن دارد. بیشترشدن تعداد نمونهها الزاماً کیفیت را بهتر نمیکند.
اگر مدل چند برداشت متفاوت از پرسش بسازد، میانگین ممکن است بین آنها قرار گیرد. در چنین حالتی، جستوجوی جداگانه و ادغام نتایج نیز گزینهای برای مقایسه است.
حفظ مسیر جستوجوی مستقیم
یک طراحی پیشنهادی این است که HyDE در کنار بازیابی مستقیم اجرا شود و نتایج دو مسیر ادغام شوند.
این کار امکان میدهد سند فرضی تنها جهت جستوجو نباشد. بااینحال، هزینه و تعداد نتایج نامرتبط ممکن است افزایش یابد.
برای ادغام، میتوان از روش مبتنی بر رتبه مانند RRF استفاده کرد. Qdrant این روش را در مستندات جستوجوی ترکیبی معرفی میکند. Qdrant
بهتر است این مسیرها را جدا مقایسه کنید:
| مسیر | هدف آزمایش |
|---|---|
| پرسش اصلی | Baseline |
| بازنویسی پرسش | روشنترشدن درخواست |
| HyDE تکسند | اثر متن فرضی |
| HyDE چندسند | اثر چند نمونه |
| مستقیم همراه HyDE | اثر ادغام |
هزینه و تأخیرHyDE
HyDEمرحله تولید متن را پیش از بازیابی اضافه میکند.
برای برآورد هزینه، این بخشها را جدا اندازه بگیرید:
- تولید متن فرضی؛
- تولید بردار آن؛
- جستوجوی اسناد؛
- بازرتبهبندی احتمالی؛
- تولید پاسخ نهایی.
ممکن است هزینه اضافی با بهبود بازیابی توجیه شود، اما این تصمیم به کاربرد وابسته است.
برای جستوجویی که باید فوراً نتیجه بدهد، حتی یک فراخوانی اضافی میتواند مهم باشد. در مقابل، برای یک پرسش پژوهشی پیچیده، تأخیر بیشتر ممکن است قابلقبول باشد.
اجرای انتخابی
بهعنوان یک آزمایش، میتوانید HyDE را فقط برای گروهی از پرسشها اجرا کنید؛ مثلاً پرسشهای کوتاهی که در ارزیابی، بازیابی مستقیم ضعیفی دارند.
از امتیاز شباهت خام بهعنوان آستانه عمومی اطمینان استفاده نکنید. معیار فعالسازی باید با داده برچسبدار بررسی شود.
ارزیابی HyDE برای فارسی
برای هر پرسش، اسناد پاسخگو را مشخص کنید. سپس مسیر مستقیم و HyDE را با همان مجموعه اسناد مقایسه کنید.
گروههای پیشنهادی:
- پرسش رسمی و محاورهای؛
- توصیف نشانه بدون اصطلاح فنی؛
- پرسش دارای نام یا شناسه؛
- پرسش دارای عدد و نسخه؛
- پرسش دارای نفی؛
- پرسش مبهم یا چندبخشی.
مثلاً این دو پرسش را جدا ارزیابی کنید:
آیا اعتبار قابل انتقال است؟
چرا اعتبار قابل انتقال نیست؟
اگر تولید متن فرضی نفی را تغییر دهد، مسیر جستوجو ممکن است منحرف شود.
معیارهای پیشنهادی
| معیار | کاربرد |
|---|---|
| Recall@K | پوشش اسناد مرتبط |
| MRR | رتبه اولین نتیجه مرتبط |
| nDCG@K | کیفیت ترتیب نتایج |
| افتهای موردی | پرسشهایی که HyDE خراب کرده است |
| تأخیر صدک ۹۵ | هزینه زمانی |
| هزینه هر پرسش | هزینه عملی |
| صحت پاسخ نهایی | اثر بر RAG |
| صحت ارجاعها | پشتیبانی ادعاها توسط منابع |
فقط میانگین بهبود را گزارش نکنید. نمونههایی را که HyDE خراب کرده است نیز بررسی کنید.
اشتباهات رایج
استفاده از متن فرضی بهعنوان مدرک
متن فرضی از مجموعه دانش واقعی بازیابی نشده است و نباید منبع پاسخ باشد.
فرض حذف اطلاعات ساختگی
رمزگذاری متن، تضمین بیاثرشدن خطاهای آن نیست.
تولید متن بیشازحد طولانی
توضیح طولانی میتواند موضوعات فرعی اضافه کند و هزینه را افزایش دهد.
تغییر شرط پرسش
نام، عدد، نسخه، زمان و نفی باید در ارزیابی کنترل شوند.
اجرای HyDE برای همه درخواستها
ارزش مرحله اضافی را برای گروههای مختلف پرسش اندازه بگیرید.
حذفBaseline
بدون بازیابی مستقیم، نسبتدادن نتیجه به HyDE ممکن نیست.
ناهماهنگی مدلEmbedding
نمایش اسناد واقعی و متن فرضی باید از همان فضای برداری سازگار باشند.
تنظیم پرامپت رویTest
پرامپت، تعداد نمونه و شیوه ادغام را روی Validation انتخاب کنید.
پرسشهای متداول
HyDEچیست؟
روشی است که متن فرضی مرتبط با پرسش تولید میکند و از بردار آن برای بازیابی اسناد واقعی استفاده میکند.
آیا متن فرضی باید صحیح باشد؟
متن فرضی منبع تأییدشده نیست، اما خطاهای آن میتوانند بازیابی را منحرف کنند.
آیا HyDE همان بازنویسی پرسش است؟
خیر. بازنویسی معمولاً پرسش دیگری میسازد؛ HyDE متنی شبیه سند پاسخگو تولید میکند.
آیا همیشه بازیابی را بهتر میکند؟
خیر. نتیجه به پرسش، مدلها، پرامپت و مجموعه اسناد وابسته است.
آیا به آموزش مدل جدید نیاز دارد؟
اجرای ساده میتواند با مدلهای آماده انجام شود. انتخاب و تنظیم مسیر همچنان به ارزیابی نیاز دارد.
چند سند فرضی تولید کنیم؟
تعداد عمومی و قطعی وجود ندارد. از یک نمونه شروع کنید و هزینه و کیفیت چند نمونه را مقایسه کنید.
آیا برای فارسی قابل استفاده است؟
بله، با مدلهای مناسب قابلآزمایش است؛ کیفیت باید روی داده فارسی واقعی سنجیده شود.
آیا HyDE جایگزین RAG است؟
خیر. میتواند بخشی از مرحله بازیابی در RAG باشد.
جمعبندی
HyDEبا تولید سند فرضی، یک نمایش جایگزین برای جستوجوی اسناد واقعی ایجاد میکند.
این روش زمانی ارزشمند است که در مقایسه با بازیابی مستقیم، بهبود قابلاندازهگیری ایجاد کند و هزینه اضافی آن برای کاربرد قابلقبول باشد.
پرسش اصلی را حفظ کنید، متن فرضی را از شواهد جدا نگه دارید و کیفیت بازیابی و پاسخ نهایی را مستقل بسنجید.
ساخت و آزمایش HyDE با خدمات درواره
برای آزمایش این معماری، به یک مدل تولید متن و یک مدل Embedding مناسب نیاز دارید. میتوانید مدلهای در دسترس درواره را بررسی و از طریق API به برنامه خود متصل کنید.
شناسه مدلها، محدودیت ورودی و پارامترهای پشتیبانیشده را از مستندات درواره انتخاب کنید. سپس چند ترکیب مدل را روی مجموعه یکسانی از پرسشهای واقعی مقایسه کنید.
بهترین ترکیب، ترکیبی است که کیفیت بازیابی و پاسخ را با هزینه و تأخیر قابلقبول برای محصول شما فراهم کند.
برای بررسی مدلها و شروع ساخت جستوجوی معنایی یا دستیار مبتنی بر اسناد، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- RAGچیست؟
- جستوجوی معنایی چیست؟
- Embeddingچیست؟
- ساخت RAG با LangChain، LlamaIndex و API درواره
- جستوجوی ترکیبی با BM25 و بردار
- ارزیابی بازیابی و تولید پاسخ درRAG
منابع
- مقاله اصلی HyDE درACL Anthology
- مخزن رسمی پژوهشHyDE
- مستندات HyDE درHaystack
- کتابخانه رسمیPython
- مستندات ادغام نتایج درQdrant
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



