
Matryoshka Embedding چیست؟ آموزش کاهش ابعاد بردارهای معنایی با Python
Matryoshka Embedding چیست و چگونه ابعاد بردارهای معنایی را کاهش میدهد؟ در این راهنما، تفاوت با PCA و Quantization، محاسبه هزینه ذخیرهسازی و پیادهسازی جستوجوی دومرحلهای با Python را میآموزید.

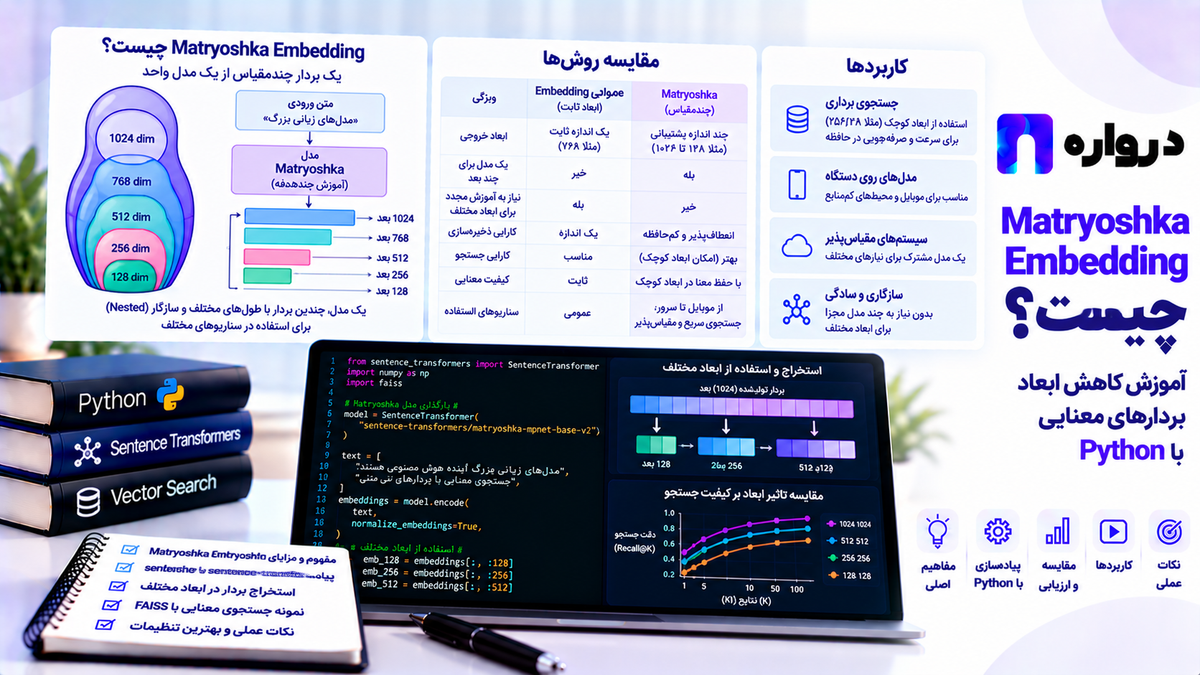
وقتی یک سامانه جستوجوی معنایی فقط چند هزار سند دارد، ذخیره بردارهای بزرگ معمولاً مسئله اصلی نیست. اما با افزایش تعداد اسناد، اندازه بردارها مستقیماً بر حجم داده، انتقال شبکه و هزینه محاسبه شباهت اثر میگذارد.
فرض کنید برای هر قطعه متن یک بردار ۷۶۸بعدی نگه میدارید. اگر بتوانید همان کاربرد را با بردار ۲۵۶بعدی و کیفیت قابلقبول اجرا کنید، حجم خام داده برداری به یکسوم میرسد.
مشکل این است که نمیتوان از هر بردار معنایی، تعدادی مقدار را حذف کرد و انتظار داشت کیفیت حفظ شود. مدل باید برای چنین استفادهای آموزش دیده باشد.
Matryoshka Embeddingیا امبدینگ ماتریوشکا به نمایشهایی گفته میشود که بخشهای ابتدایی آنها، در اندازههای مختلف، برای وظیفه موردنظر آموزش دیدهاند. بنابراین میتوان از یک نمایش بزرگ، چند نمایش کوچکتر استخراج کرد و میان کیفیت و هزینه انتخاب داشت.
مقاله Matryoshka Representation Learning این ایده را برای ساخت نمایشهای انعطافپذیر معرفی کرد؛ نمایشهایی که با محدودیتهای محاسباتی کاربردهای مختلف سازگار شوند. arxiv.org
در این مقاله، سازوکار Matryoshka، تفاوت آن با کاهش ابعاد معمولی و نحوه استفاده عملی از آن در جستوجوی معنایی و RAG را بررسی میکنیم.
Matryoshka Embeddingچیست؟
Matryoshka Embeddingیک نوع نمایش برداری با ساختار تودرتو است.
برای مثال، مدلی میتواند بردار ۷۶۸بعدی تولید کند و در زمان آموزش، استفاده از بخشهای ابتدایی آن در اندازههای ۵۱۲، ۲۵۶، ۱۲۸ و ۶۴ را نیز یاد گرفته باشد.
در این حالت، نمایش ۱۲۸بعدی از ابتدای همان بردار بزرگ استخراج میشود. نمایش ۲۵۶بعدی نیز همان بخش ابتدایی را به همراه مقدارهای بیشتری در بر دارد.
نام Matryoshka از عروسکهای روسی تودرتو گرفته شده است: نمایش کوچکتر درون نمایش بزرگتر قرار دارد.
البته هر مدل، اندازهها و تنظیمات خاص خود را دارد. پشتیبانی از یک اندازه خروجی باید در مستندات مدل بررسی شود.
تفاوت Embedding معمولی وMatryoshka
در یک مدل معمولی، کیفیت بردار غالباً برای اندازه کامل خروجی ارزیابی میشود. اگر فقط بخشی از بردار نگه داشته شود، ممکن است اطلاعات موردنیاز برای مقایسه متنها از دست برود.
در آموزش Matryoshka، مدل در چند اندازه خروجی تحت نظارت قرار میگیرد. هدف این است که نمایشهای کوچکتر نیز مفید باشند.
| معیار | Embedding معمولی | Matryoshka Embedding |
|---|---|---|
| اندازه اصلی خروجی | مشخص | مشخص |
| آموزش برای چند اندازه | الزاماً انجام نشده | بخشی از روش آموزش |
| حذف مقدارهای انتهایی | نیازمند ارزیابی مستقل | در اندازههای پشتیبانیشده طراحی شده است |
| انتخاب اندازه هنگام استفاده | محدودتر | انعطافپذیرتر |
| حفظ کامل کیفیت پس از کوتاهسازی | تضمین ندارد | همچنان تضمین ندارد |
| کاربرد | نمایش معنایی متن | نمایش معنایی با امکان انتخاب ابعاد |
مستندات Sentence Transformers توضیح میدهد که در این روش، تابع آموزش علاوه بر بردار کامل، روی بخشهای کوتاهشده آن نیز اعمال میشود. Sentence Transformers documentation
نکته مهم این است که امکان کوتاهسازی با حفظ تمام کیفیت برابر نیست. اندازه مناسب باید برای داده و کاربرد واقعی انتخاب شود.
آیا میتوان هر Embedding را کوتاه کرد؟
از نظر برنامهنویسی، بله. میتوان از یک آرایه فقط ۱۲۸ مقدار اول را نگه داشت.
اما این عملیات بهتنهایی یک مدل معمولی را به مدل Matryoshka تبدیل نمیکند.
سه پرسش را جداگانه بررسی کنید:
- آیا مدل برای نمایشهای کوتاهتر آموزش دیده است؟
- آیا روش کوتاهسازی و نرمالسازی آن مشخص است؟
- آیا کیفیت اندازه انتخابشده برای کاربرد شما کافی است؟
حتی اگر مدل Matryoshka باشد، یک اندازه بسیار کوچک ممکن است در تشخیص تفاوتهای ظریف میان اسناد عملکرد مناسبی نداشته باشد.
برای مثال، جستوجوی موضوع کلی «پرداخت» با تفکیک دقیق «پرداخت ناموفق»، «پرداخت تکراری» و «بازگشت وجه» یکسان نیست. اندازه مناسب را باید با همین تفاوتهای واقعی آزمایش کرد.
کاهش ابعاد چه هزینهای را کم میکند؟
کاهش تعداد مقدارهای بردار میتواند حجم نمایش ذخیرهشده و مقدار داده لازم برای مقایسه بردارها را کاهش دهد.
اما باید دو مرحله را از هم جدا کرد:
- تولید بردار توسط مدل
- ذخیره و پردازش بردار تولیدشده
در Matryoshka معمولی، کوتاهکردن خروجی به معنای حذف لایههای رمزگذار نیست. مدل ممکن است همچنان همان پردازش اصلی را انجام دهد و سپس خروجی کوتاه شود.
Sentence Transformersنیز تصریح میکند که مزیت اصلی این روش در پردازش و ذخیره خروجی است؛ کوچکترشدن بردار، بهخودیخود مدل را کوچکتر یا اجرای رمزگذار را سریعتر نمیکند. Sentence Transformers documentation
بنابراین اگر گلوگاه برنامه، زمان فراخوانی مدل Embedding باشد، ابتدا باید اندازهگیری کنید که چه سهمی از تأخیر به تولید بردار و چه سهمی به جستوجو مربوط است.
محاسبه حجم ذخیرهسازی بردارها
یک مثال فرضی با یک میلیون قطعه متن و ذخیره مقادیر در قالب float32 در نظر بگیریم.
هر مقدار float32 چهار بایت فضا میگیرد.
| تعداد ابعاد | حجم خام یک میلیون بردار | کاهش نسبت به ۷۶۸ بعد |
|---|---|---|
| ۷۶۸ | حدود ۲٫۸۶ گیبیبایت | — |
| ۵۱۲ | حدود ۱٫۹۱ گیبیبایت | حدود ۳۳٪ |
| ۲۵۶ | حدود ۰٫۹۵ گیبیبایت | حدود ۶۷٪ |
| ۱۲۸ | حدود ۰٫۴۸ گیبیبایت | حدود ۸۳٪ |
| ۶۴ | حدود ۰٫۲۴ گیبیبایت | حدود ۹۲٪ |
این اعداد فقط حجم خام بردارها را نشان میدهند.
موارد زیر در آنها محاسبه نشدهاند:
- متن اصلی اسناد؛
- شناسهها و فراداده؛
- ساختار شاخص جستوجو؛
- نسخههای تکراری داده؛
- سربار پایگاه داده؛
- فایلهای پشتیبان.
همچنین کاهش حجم بردارها الزاماً به همان درصد کاهش صورتحساب سرویس منجر نمیشود. هزینه نهایی ممکن است بیشتر به حافظه رزروشده، پردازش مدل، تعداد درخواست یا زیرساخت بستگی داشته باشد.
تفاوت Matryoshka باPCA
PCAیک روش کاهش ابعاد است که از داده، جهتهای خطی جدیدی استخراج میکند. سپس نمونهها در فضای کوچکتری نمایش داده میشوند.
طبق مستندات scikit-learn، PCA داده را پیش از تحلیل مرکز میکند و بر مؤلفههای اصلی آن تمرکز دارد. scikit-learn 1.9.1 documentation
Matryoshkaبهجای ساخت یک تبدیل مستقل پس از تولید بردار، ساختار قابلکوتاهسازی را در آموزش مدل دنبال میکند.
| معیار | Matryoshka | PCA روی Embedding |
|---|---|---|
| محل ایجاد نمایش کوچکتر | آموزش مدل | تبدیل پس از تولید بردار |
| روش استفاده | انتخاب بخش ابتدایی طبق دستور مدل | اعمال تبدیل آموختهشده |
| نیاز به برازش تبدیل مستقل | معمولاً ندارد | دارد |
| وابستگی به نمونههای برازش تبدیل | کمتر در مرحله کوتاهسازی | مهم |
| نیاز به ارزیابی بازیابی | دارد | دارد |
اگر از PCA استفاده میکنید، همان تبدیل باید برای بردار پرسش و اسناد اعمال شود. همچنین برازش و انتخاب تعداد مؤلفهها نباید با استفاده از پاسخهای مجموعه آزمون انجام شود.
هیچکدام از این دو روش را صرفاً بر اساس حجم خروجی انتخاب نکنید. معیار اصلی، کیفیت کاربرد نهایی در کنار هزینه است.
تفاوت Matryoshka باQuantization
این دو روش دو بخش متفاوت از نمایش را تغییر میدهند.
Matryoshka تعداد ابعاد را کاهش میدهد.
Quantizationیا کوانتیزهسازی نحوه نمایش مقدار هر بُعد را تغییر میدهد؛ برای مثال، بهجای float32 از نمایش کمحجمتری استفاده میشود.
مستندات Sentence Transformers، کوانتیزهسازی بردارها و امکان ترکیب آن با Matryoshka را توضیح میدهد. Sentence Transformers documentation
| روش | تغییر اصلی | مثال |
|---|---|---|
| کاهش ابعاد Matryoshka | تعداد مقدارها | ۷۶۸ بعد به ۲۵۶ بعد |
| کوانتیزهسازی بردار | دقت نمایش مقدارها | float32 به int8 |
| ترکیب دو روش | تعداد و دقت مقدارها | بردار ۲۵۶بعدی با نمایش کمحجم |
ترکیب دو روش ممکن است حجم را بیشتر کاهش دهد، اما باید کیفیت ترکیب نهایی را اندازه گرفت. افت کیفیت دو مرحله را نمیتوان همیشه مستقل یا قابلجمع فرض کرد.
همچنین کوانتیزهسازی بردار خروجی با کوانتیزهسازی وزنهای مدل متفاوت است. اولی نمایش ذخیرهشده را تغییر میدهد؛ دومی به خود مدل مربوط است.
آموزش عملی باPython
در این مثال از مدل nomic-ai/nomic-embed-text-v1.5 استفاده میکنیم.
کارت رسمی مدل، آن را انگلیسی معرفی میکند. بنابراین مثال عملی انگلیسی است و نتیجه آن نباید به کیفیت بازیابی فارسی تعمیم داده شود.
دستور پردازش مدل شامل پیشوندهای مخصوص پرسش و سند، اعمال Layer Normalization، انتخاب ابعاد و سپس نرمالسازی بردار است. Hugging Face
نصب کتابخانهها
برای محیط جدید:
pip install "sentence-transformers>=5.3" "transformers>=5.5" torch numpyکارت فعلی مدل اعلام میکند که در نسخههای یادشده، مسیر متن به trust_remote_code=True نیاز ندارد.
تعریف اسناد و پرسشها
داده زیر آموزشی است:
documents = [ { "id": "cpu", "text": ( "A small language model can run on a CPU. " "Its speed depends on model size, memory, " "and the inference implementation." ), }, { "id": "gpu", "text": ( "Distributed training uses multiple GPUs " "to train a large neural network." ), }, { "id": "embedding", "text": ( "Text embeddings represent documents as " "vectors for semantic search." ), }, { "id": "chunking", "text": ( "Chunking divides a long document into " "smaller passages for retrieval." ), }, { "id": "batching", "text": ( "Batching processes several model requests " "together to improve throughput." ),در این مجموعه کوچک، برای هر پرسش یک سند مرتبط مشخص کردهایم. در داده واقعی، یک پرسش ممکن است چند سند مرتبط با درجات ارتباط متفاوت داشته باشد.
تولید نمایش پایه
import numpy as np
import torch.nn.functional as F

from sentence_transformers import SentenceTransformer


model = SentenceTransformer(
    "nomic-ai/nomic-embed-text-v1.5",
)


def encode_base(texts, prefix):
    inputs = [
        f"{prefix}: {text}"
        for text in texts
    ]

    embeddings = model.encode(
        inputs,
        convert_to_tensor=True,
        normalize_embeddings=False,
        show_progress_bar=False,
    )

    embeddings = embeddings.float()

    embeddings = F.layer_norm(
        embeddings,
        normalized_shape=(embeddings.shape[-1],),
    )

    return embeddings.cpu().numpy()


document_base = encode_base(
    [item["text"] for item in documents],
    prefix="search_document",
)

query_base = encode_base(
    queries,
    prefix="search_query",
)

print(document_base.shape)
print(query_base.shape)
بردار پایه را یک بار تولید میکنیم و در ادامه، اندازههای مختلف را از آن استخراج خواهیم کرد.
ترتیب پردازش بالا مخصوص مدل انتخابشده است. برای یک مدل دیگر، روش کوتاهسازی و نرمالسازی را از مستندات همان مدل بگیرید.
کوتاهسازی و نرمالسازی
پس از انتخاب بخش ابتدایی بردار، آن را دوباره نرمال میکنیم:
def prefix_vectors(vectors, dimension): vectors = np.asarray( vectors, dtype=np.float32, ) if vectors.ndim != 2: raise ValueError("Expected a 2D matrix.") if not 1 <= dimension <= vectors.shape[1]: raise ValueError("Invalid output dimension.") shortened = vectors[:, :dimension].copy() norms = np.linalg.norm( shortened, axis=1, keepdims=True, ) if np.any(norms <= 1e-12): raise ValueError("A shortened vector has zero norm.") return shortened / normsاگر یک بردار پیش از کوتاهسازی طول واحد داشته باشد، حذف مقدارهای انتهایی میتواند این ویژگی را تغییر دهد.
در مثال ما، نرمالسازی باعث میشود ضرب داخلی بردارها برای مقایسه مبتنی بر شباهت کسینوسی مناسب باشد.
مقایسه بازیابی در چند اندازه
اکنون اندازههای مختلف را روی همان پرسشها آزمایش میکنیم:
def search_scores(query_vectors, document_vectors):
    return query_vectors @ document_vectors.T


def recall_at_k(scores, documents, relevant_ids, k):
    ranking = np.argsort(
        -scores,
        axis=1,
        kind="stable",
    )[:, :k]

    recalls = []

    for row, relevant in zip(ranking, relevant_ids):
        retrieved = {
            documents[int(index)]["id"]
            for index in row
        }

        recalls.append(
            len(retrieved & relevant) / len(relevant)
        )

    return float(np.mean(recalls))


for dimension in [64, 128, 256, 512, 768]:
    document_vectors = prefix_vectors(
        document_base,
        dimension,
    )

    query_vectors = prefix_vectors(
        query_base,
        dimension,
    )

    scores = search_scores(
        query_vectors,
        document_vectors,
    )

    recall = recall_at_k(
        scores,
        documents,
        relevant_ids,
        k=1,
    )

    print(
        f"dimension={dimension:3d} | "
        f"recall@1={recall:.3f} | "
        f"document_bytes={document_vectors.nbytes}"
    )
این کد حجم آرایههای برداری و Recall@1 را گزارش میکند. مقدار واقعی معیارها را باید پس از اجرای مدل مشاهده کنید؛ نتیجهای برای آن از پیش فرض نشده است.
چرا این مثال برای انتخاب نهایی کافی نیست؟
پنج سند و سه پرسش برای یادگیری سازوکار مناسباند، اما برای انتخاب ابعاد استقرار کافی نیستند.
ممکن است تمام اندازهها روی این داده ساده نتیجه یکسانی داشته باشند. اختلاف واقعی معمولاً باید در میان اسناد نزدیک به هم و پرسشهای دشوار بررسی شود.
برای مثال، مجموعه ارزیابی را با چند سند درباره اجرای مدل روی CPU، چند سند درباره اجرای آن روی GPU و چند سند درباره آموزش مدل گسترش دهید.
جستوجوی دومرحلهای با بردار کوچک و بزرگ
یکی از کاربردهای Matryoshka این است که ابتدا با بردار کوچک نامزدها را پیدا کنیم و سپس همان نامزدها را با بردار بزرگتر دوباره امتیاز بدهیم.
این الگو در مستندات رسمی Sentence Transformers با عنوان انتخاب نامزد و بازرتبهبندی مطرح شده است. Sentence Transformers documentation
در مثال زیر:
- مرحله اول از ۱۲۸ بعد استفاده میکند.
- مرحله دوم از ۷۶۸ بعد استفاده میکند.
- خروجی نهایی دو سند است.
small_documents = prefix_vectors(document_base, 128)
small_queries = prefix_vectors(query_base, 128)

full_documents = prefix_vectors(document_base, 768)
full_queries = prefix_vectors(query_base, 768)


def two_stage_search(query_index, candidate_count=4, top_k=2):
    if not 1 <= top_k <= candidate_count <= len(documents):
        raise ValueError("Invalid candidate_count or top_k.")

    first_scores = (
        small_documents @ small_queries[query_index]
    )

    candidates = np.argsort(
        -first_scores,
        kind="stable",
    )[:candidate_count]

    second_scores = (
        full_documents[candidates]
        @ full_queries[query_index]
    )

    order = np.argsort(
        -second_scores,
        kind="stable",
    )[:top_k]

    return [
        {
            "id": documents[int(candidates[index])]["id"],
            "text": documents[int(candidates[index])]["text"],
            "score": float(second_scores[index]),
        }
        for index in order
    ]


for result in two_stage_search(query_index=0):
    print(result["id"], round(result["score"], 4))
این مثال با NumPy تمام بردارهای کوچک را بررسی میکند. برای مجموعه بزرگ، مرحله اول میتواند از شاخص جستوجوی مناسب استفاده کند.
بازامتیازدهی با بردار کامل، Cross-Encoder نیست
در مرحله دوم مثال، پرسش و سند همچنان مستقل رمزگذاری شدهاند. فقط از بردار بزرگتر استفاده میکنیم.
Cross-Encoderروش دیگری است که جفت پرسش و سند را با هم پردازش میکند. بنابراین نام «بازرتبهبندی» به معنای یکسانبودن این دو روش نیست.
محدودیت تعداد نامزدها
اگر سند درست در مرحله اول انتخاب نشود، مرحله دوم به آن دسترسی ندارد.
برای انتخاب تعداد نامزدها، این آزمایش را انجام دهید:
- چند اندازه کوچک برای مرحله اول انتخاب کنید.
- برای هر اندازه، چند تعداد نامزد آزمایش کنید.
- پوشش اسناد مرتبط در نامزدها را اندازه بگیرید.
- کیفیت خروجی نهایی و تأخیر را مقایسه کنید.
تعداد نامزد مناسب، به دشواری جستوجو و بودجه پردازش بستگی دارد.
آیا جستوجوی دومرحلهای همیشه فضای کمتری میگیرد؟
خیر. اگر بردار کوچک و بردار کامل را همزمان ذخیره کنید، هر دو فضا میگیرند.
برای مثال، نگهداری یک بردار ۱۲۸بعدی در کنار یک بردار ۷۶۸بعدی، از نظر داده خام بیشتر از نگهداری فقط بردار ۷۶۸بعدی است.
مزیت چنین طراحیای ممکن است کاهش حجم شاخص فعال یا کاهش کار مرحله اول باشد، در حالی که بردارهای کامل در لایه دیگری نگهداری میشوند.
برای برآورد هزینه، مشخص کنید:
- کدام داده در RAM است؟
- کدام داده روی دیسک است؟
- برای هر پرسش چه مقدار داده خوانده میشود؟
- دریافت بردارهای کامل چقدر تأخیر دارد؟
- آیا نسخه کوچک جداگانه ذخیره میشود یا هنگام نیاز ساخته میشود؟
صرف کوتاهبودن بردار مرحله اول، اثبات کاهش کل هزینه سامانه نیست.
انتخاب ابعاد مناسب برای متن فارسی
برای پروژه فارسی، ابتدا مدلی انتخاب کنید که زبان و کاربرد آن با داده شما سازگار باشد. سپس پشتیبانی Matryoshka را بررسی کنید.
پشتیبانی چندزبانه و پشتیبانی کوتاهسازی دو ویژگی جداگانهاند.
یک مجموعه ارزیابی پیشنهادی برای فارسی بهتر است شامل این گروهها باشد:
| گروه پرسش | مثال |
|---|---|
| رسمی | «چگونه کلید API ایجاد کنم؟» |
| محاورهای | «از کجا کلید ایپیآی بگیرم؟» |
| ترکیبی | «خطای timeout در درخواست API» |
| دارای عدد | «مدل با ورودی بیشتر از ۳۲ هزار توکن» |
| دارای نفی | «اجرای مدل بدون GPU» |
| نام و شناسه | نام دقیق محصول، مدل یا کد خطا |
بهتر است چند سند نزدیک اما نامرتبط نیز برای هر پرسش داشته باشید. اگر فقط یک سند واضح در مجموعه باشد، آزمایش توانایی تفکیک مدل را بهخوبی نشان نمیدهد.
میانگین کلی را کافی ندانید
ممکن است کاهش ابعاد روی پرسشهای عمومی اثر کمی داشته باشد، اما روی نام محصول یا عبارتهای عددی افت بیشتری ایجاد کند.
معیارها را به تفکیک گروه گزارش کنید. یک بهبود میانگین نباید عملکرد ضعیف در گروه مهم کاربران را پنهان کند.
چه معیارهایی را اندازه بگیریم؟
برای انتخاب ابعاد، کیفیت و هزینه باید در یک آزمایش مشترک بررسی شوند.
| معیار | کاربرد |
|---|---|
| Recall@K | پوشش اسناد مرتبط |
| MRR | رتبه اولین نتیجه مرتبط |
| nDCG@K | کیفیت ترتیب با ارتباط درجهبندیشده |
| تأخیر میانه | رفتار درخواست معمولی |
| تأخیر صدک ۹۵ | رفتار درخواستهای کندتر |
| حجم شاخص | هزینه ذخیرهسازی |
| مصرف RAM | نیاز عملی زیرساخت |
| زمان بهروزرسانی | هزینه افزودن و اصلاح سند |
در سامانه RAG، یک ارزیابی دیگر نیز لازم است: آیا تغییر اندازه بردار، کیفیت پاسخ نهایی را تغییر میدهد؟
ممکن است جابهجایی جزئی رتبه اسناد اثری بر پاسخ نداشته باشد. در مقابل، حذف یک قطعه شامل شرط یا استثنا میتواند پاسخ را بهطور جدی تغییر دهد.
انتخاب روی Validation، گزارش رویTest
ابعاد، تعداد نامزدها و سایر تنظیمات را روی مجموعه اعتبارسنجی انتخاب کنید.
سپس تنظیم نهایی را روی مجموعه آزمون مستقلی ارزیابی کنید. اگر بارها نتیجه آزمون را ببینید و تنظیمات را تغییر دهید، دیگر آن مجموعه آزمون مستقل محسوب نمیشود.
مهاجرت از بردار کامل به بردار کوتاه
اگر نمایشهای کامل یک مدل Matryoshka را نگه داشتهاید، ممکن است بتوانید نمایش کوتاهتر را بدون رمزگذاری مجدد متن استخراج کنید.
اما ابتدا بررسی کنید که بردار ذخیرهشده در چه مرحلهای از پردازش تولید شده است. اعمال دوباره یا حذف یک تبدیل مخصوص مدل میتواند نمایش را تغییر دهد.
یک مسیر اجرایی پیشنهادی:
- نسخه مدل و پردازش فعلی را ثبت کنید.
- نمایش کوتاه را برای نمونهای از داده بسازید.
- کیفیت را روی پرسشهای برچسبدار بسنجید.
- شاخص جدید را با ابعاد مشخص ایجاد کنید.
- رمزگذاری پرسش را با همان تنظیمات هماهنگ کنید.
- عملکرد شاخص جدید را در کنار مسیر فعلی مقایسه کنید.
- پس از تأیید معیارها، ترافیک را به مسیر جدید منتقل کنید.
بردارها را فقط به دلیل برابر بودن تعداد ابعاد، سازگار فرض نکنید. بردار ۲۵۶بعدی از دو مدل متفاوت معمولاً فضای معنایی مشترکی ندارد.
اشتباهات رایج در استفاده ازMatryoshka
حذف ابعاد از مدل نامناسب
وجود پارامتری مانند truncate_dim در کتابخانه، بهتنهایی ثابت نمیکند مدل برای آن اندازه آموزش دیده است. مستندات Sentence Transformers این پارامتر را برای کوتاهکردن خروجی ارائه میکند؛ کیفیت به مدل وابسته است. Sentence Transformers documentation
ناهماهنگی پرسش و سند
مدل، اندازه، پیشوند، ترتیب پردازش و نرمالسازی باید با یکدیگر سازگار باشند.
تصور کاهش تعداد توکنها
کمکردن ابعاد بردار، متن ورودی را کوتاه نمیکند. اگر API بر اساس توکن ورودی قیمتگذاری شود، کوتاهسازی محلی خروجی لزوماً هزینه تولید Embedding را کاهش نمیدهد.
تعمیم سرعت از روی تعداد ابعاد
بردار کوچکتر کار عددی کمتری دارد، اما تأخیر کل ممکن است تحت تأثیر خواندن دیسک، شبکه یا اجرای مدل باشد.
فرض بهترشدن همیشگی با افزایش ابعاد
بردار بزرگتر را نیز باید اندازه گرفت. انتخاب نهایی باید از نتیجه ارزیابی بیاید، نه صرفاً از تعداد مقدارها.
استفاده از آستانه قدیمی
توزیع امتیازهای شباهت ممکن است با تغییر ابعاد عوض شود. آستانه تصمیمگیری را برای نمایش جدید دوباره ارزیابی کنید.
گزارش فقط حجم آرایه
nbytes حجم آرایه NumPy را نشان میدهد؛ حجم پایگاه داده یا نیاز RAM کل سرویس را نشان نمیدهد.
پرسشهای متداول
Matryoshka Embeddingچیست؟
نمایشی برداری است که بخشهای ابتدایی آن در چند اندازه برای استفاده مفید آموزش دیدهاند.
آیا میتوان هر بردار را به ۱۲۸ بعد کاهش داد؟
از نظر فنی میتوان آن را برش داد، اما حفظ کیفیت به آموزش مدل و نتیجه ارزیابی وابسته است.
آیا Matryoshka مدل را کوچکتر میکند؟
کوتاهسازی خروجی بهخودیخود وزنها یا تعداد لایههای مدل را کاهش نمیدهد.
تفاوت آن با PCA چیست؟
PCA یک تبدیل آموختهشده پس از تولید نمایش است. Matryoshkaساختار قابلکوتاهسازی را در آموزش نمایش دنبال میکند.
تفاوت آن با Quantization چیست؟
Matryoshka تعداد ابعاد را تغییر میدهد؛ Quantizationدقت نمایش مقدارها را تغییر میدهد.
آیا نرمالسازی دوباره لازم است؟
برای روش مبتنی بر بردارهای واحد در این مقاله، بله. ترتیب دقیق پردازش را از دستور مدل بگیرید.
بهترین تعداد ابعاد برای RAG چقدر است؟
عدد عمومی وجود ندارد. کیفیت بازیابی و پاسخ، تعداد اسناد و هزینه زیرساخت باید همزمان بررسی شوند.
آیا مدل مثال برای فارسی مناسب است؟
مدل انتخابشده در کارت رسمی انگلیسی معرفی شده است. برای فارسی باید مدل مناسب و مجموعه ارزیابی فارسی داشته باشید.
آیا جستوجوی دومرحلهای همیشه فضای کمتری مصرف میکند؟
خیر. نگهداری همزمان بردار کوچک و کامل میتواند حجم کل را افزایش دهد، حتی اگر شاخص مرحله اول کوچکتر باشد.
جمعبندی
Matryoshka Embeddingامکان انتخاب ابعاد خروجی را در مدلهایی فراهم میکند که برای نمایشهای تودرتو آموزش دیدهاند.
این قابلیت میتواند برای کاهش حجم بردارها یا طراحی جستوجوی دومرحلهای مفید باشد. بااینحال، کیفیت، سرعت و هزینه نهایی باید در سامانه واقعی اندازهگیری شوند.
برای انتخاب ابعاد، از پرسشهای واقعی و اسناد نزدیک به هم استفاده کنید، پردازش مخصوص مدل را رعایت کنید و نتیجه را با نمایش کامل مقایسه کنید.
استفاده از Embedding در پروژههای درواره
برای ساخت جستوجوی معنایی، پیشنهاد محتوا یا دستیار مبتنی بر اسناد، میتوانید مدلهای Embedding در دسترس را از طریق خدمات درواره بررسی و در برنامه خود استفاده کنید.
هنگام انتخاب مدل، کیفیت فارسی، محدودیت ورودی، اندازه خروجی و هزینه را در کنار هم بسنجید. قابلیت Matryoshka یا انتخاب ابعاد را تنها زمانی به کار بگیرید که برای همان مدل و مسیر ارائه سرویس مستند شده باشد.
یک شروع عملی، ساخت مجموعهای از پرسشهای واقعی کسبوکار و مقایسه چند مدل روی همان داده است. پس از انتخاب مدل، میتوان درباره ابعاد، شاخص جستوجو و اتصال نتایج به مدل پاسخدهنده تصمیم گرفت.
برای بررسی مدلها و شروع اتصال جستوجوی معنایی یا دستیار هوش مصنوعی به برنامه خود، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- Embeddingچیست؟
- جستوجوی ترکیبی با BM25 و بردار برایRAG
- بازرتبهبندی و Cross-Encoder درRAG
- قطعهبندی متن یا Chunking چیست؟
- ارزیابی مدلهای هوش مصنوعی
- آموزش اتصال برنامه به API هوش مصنوعی
منابع
- مقالهMatryoshka Representation Learning
- مستندات Matryoshka درSentence Transformers
- کارت رسمیNomic Embed Text v1.5
- مرجع SentenceTransformer و تنظیمات خروجی
- مستندات کوانتیزهسازیEmbedding
- مستندات رسمی PCA درscikit-learn
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



