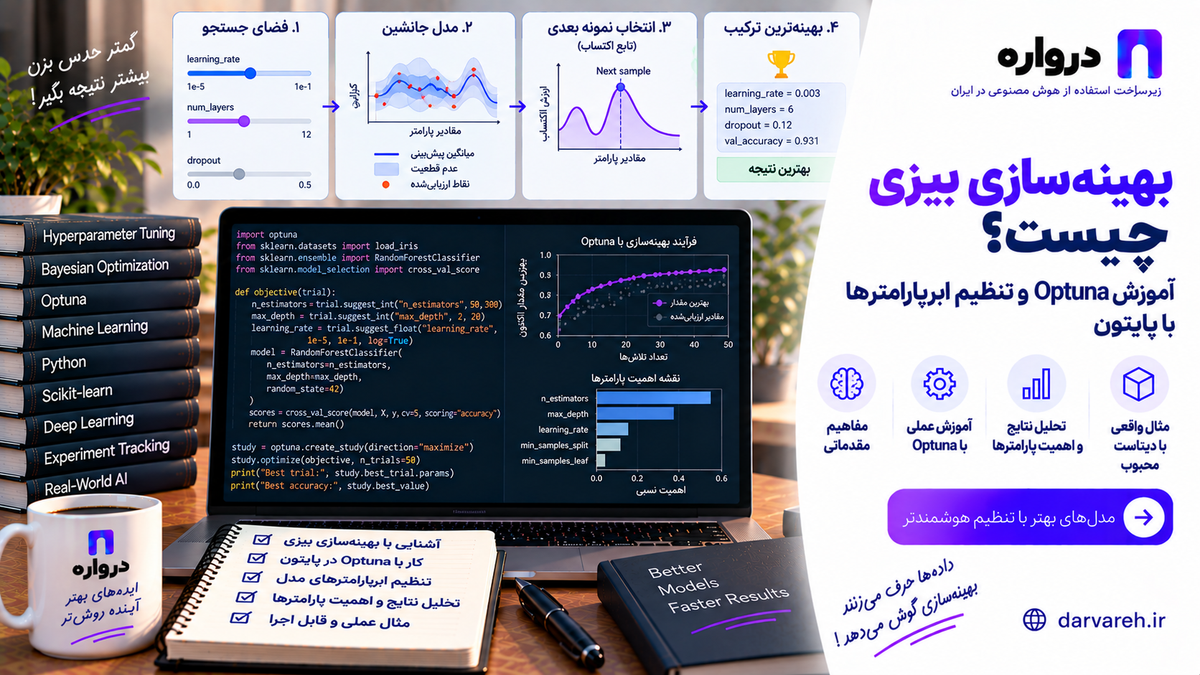
بهینهسازی بیزی چیست؟ آموزش Optuna و تنظیم ابرپارامترها با پایتون
بهینهسازی بیزی روشی هوشمند برای پیدا کردن بهترین تنظیمات مدل با تعداد آزمایش کمتر است. در این راهنمای جامع با مدل جانشین و برنامه متصل به API درواره را با پایتون پیادهسازی میکنید.
انتخاب تنظیمات مناسب یکی از مهمترین مراحل ساخت مدلهای یادگیری ماشین و برنامههای مبتنی بر هوش مصنوعی است. پارامترهایی مانند نرخ یادگیری، عمق درخت، تعداد همسایهها، مقدار Temperature، تعداد نتایج بازیابیشده و مدل مورد استفاده میتوانند کیفیت، سرعت و هزینه سیستم را بهشدت تغییر دهند.
آزمایش دستی تمام ترکیبها معمولاً زمانبر و غیرقابلاعتماد است. Grid Search نیز با بزرگشدن فضای جستوجو خیلی زود پرهزینه میشود. Random Search انتخابهای متنوعتری انجام میدهد، اما از نتایج آزمایشهای قبلی برای پیشنهاد هوشمندانه آزمایش بعدی استفاده نمیکند.
بهینهسازی بیزی یا Bayesian Optimization تلاش میکند با یادگیری از نتایج قبلی، امیدوارکنندهترین تنظیمات را برای آزمایش بعدی انتخاب کند. این روش بهخصوص زمانی ارزشمند است که هر ارزیابی پرهزینه باشد؛ برای مثال، آموزش یک مدل، اجرای یک مجموعه Evals یا ارسال چند صد درخواست به API مدلهای هوش مصنوعی.
در این مقاله علاوه بر مفاهیم نظری، از کتابخانه Optuna برای تنظیم ابرپارامترهای یک مدل یادگیری ماشین و بهینهسازی تنظیمات برنامه متصل به API درواره استفاده میکنیم.
ابرپارامتر چیست؟
ابرپارامتر یا Hyperparameter مقداری است که پیش از آموزش یا اجرای مدل تعیین میشود و الگوریتم آن را مستقیماً از دادههای آموزشی یاد نمیگیرد.
برای مثال، در Random Forest موارد زیر ابرپارامتر هستند:
- تعداد درختها
- حداکثر عمق هر درخت
- حداقل نمونه لازم برای تقسیم یک گره
- تعداد ویژگیهای بررسیشده در هر تقسیم
- روش نمونهبرداری
در شبکه عصبی نیز این موارد ابرپارامتر محسوب میشوند:
- Learning Rate
- Batch Size
- تعداد لایهها
- تعداد نورونها
- Dropout
- نوع Optimizer
- Weight Decay
- تعداد Epochها
در یک برنامه مبتنی بر مدل زبانی، ابرپارامترها میتوانند شامل موارد زیر باشند:
- مدل مورد استفاده
- Temperature
- Top P
- حداکثر تعداد توکن خروجی
- نسخه پرامپت
- تعداد نمونههای Few-shot
- تعداد قطعات بازیابیشده در RAG
- حداقل امتیاز شباهت
- وزن جستوجوی معنایی
- آستانه مسیریابی به مدل قویتر
تفاوت پارامتر و ابرپارامتر چیست؟
پارامترهای مدل در جریان آموزش از دادهها یاد گرفته میشوند. وزنهای یک شبکه عصبی و ضرایب رگرسیون نمونههایی از پارامترهای مدل هستند.
ابرپارامترها خارج از فرایند یادگیری اصلی تعیین میشوند و نحوه آموزش یا رفتار مدل را کنترل میکنند.
| ویژگی | پارامتر | ابرپارامتر |
|---|---|---|
| روش تعیین | یادگیری از داده | انتخاب توسط توسعهدهنده یا الگوریتم جستوجو |
| نمونه | وزن شبکه عصبی | Learning Rate |
| زمان تعیین | هنگام آموزش | پیش یا حین فرایند بهینهسازی |
| هدف | نمایش الگوهای داده | کنترل معماری یا فرایند یادگیری |
تنظیم ابرپارامتر چیست؟
تنظیم ابرپارامتر یا Hyperparameter Tuning فرایند پیدا کردن ترکیبی از ابرپارامترها است که بر اساس یک معیار مشخص بهترین عملکرد را ایجاد کند.
فرایند کلی:
- فضای جستوجو تعریف میشود.
- یک ترکیب از ابرپارامترها انتخاب میشود.
- مدل با آن تنظیمات آموزش میبیند.
- عملکرد مدل روی داده اعتبارسنجی اندازهگیری میشود.
- نتیجه ثبت میشود.
- ترکیب بعدی انتخاب میشود.
- بهترین تنظیمات نهایی روی داده آزمایش ارزیابی میشوند.
مهمترین بخش این فرایند، تعریف صحیح معیار ارزیابی و جلوگیری از بیشبرازش به داده اعتبارسنجی است.
فضای جستوجو چیست؟
فضای جستوجو یا Search Space مجموعه مقادیر مجاز هر ابرپارامتر است.
مثال:
learning_rate: بین 0.0001 و 0.1
max_depth: یکی از اعداد 3 تا 12
booster: یکی از gbtree یا dart
subsample: بین 0.5 و 1
فضای جستوجو میتواند شامل چند نوع متغیر باشد:
متغیر پیوسته
learning_rate = trial.suggest_float(
    "learning_rate",
    1e-5,
    1e-1,
    log=True,
)
متغیر صحیح
max_depth = trial.suggest_int(
    "max_depth",
    3,
    12,
)
متغیر دستهای
optimizer = trial.suggest_categorical(
    "optimizer",
    ["adam", "sgd", "rmsprop"],
)
فضای شرطی
booster = trial.suggest_categorical(
    "booster",
    ["gbtree", "dart"],
)

if booster == "dart":
    rate_drop = trial.suggest_float(
        "rate_drop",
        0.0,
        0.5,
    )
یکی از مزایای Optuna رابط Define-by-run است که امکان ساخت پویا و شرطی فضای جستوجو را فراهم میکند.
روشهای تنظیم ابرپارامتر
تنظیم دستی
در تنظیم دستی، توسعهدهنده چند مقدار را بر اساس تجربه آزمایش میکند.
مزایا:
- ساده
- مناسب آزمایش اولیه
- امکان استفاده از دانش تخصصی
معایب:
- غیرقابلبازتولید
- وابسته به تجربه فرد
- احتمال ازدسترفتن ترکیبهای بهتر
- زمانبر در فضای بزرگ
Grid Search
Grid Search تمام ترکیبهای از پیش تعریفشده را بررسی میکند.
مثال:
learning_rate: [0.001, 0.01, 0.1]
max_depth: [3, 6, 9]
batch_size: [16, 32, 64]
تعداد ترکیبها:
3 × 3 × 3 = 27
اگر ۱۰ پارامتر داشته باشیم و برای هرکدام پنج مقدار تعریف کنیم:
5¹⁰ = 9,765,625
Scikit-learn در GridSearchCV تمام ترکیبهای مشخصشده را بهصورت جامع بررسی میکند.
Grid Search برای فضای کوچک مفید است، اما با افزایش تعداد پارامترها دچار انفجار ترکیبی میشود.
Random Search
Random Search ترکیبها را بهصورت تصادفی از توزیعهای تعریفشده انتخاب میکند.
مزایا:
- پوشش بهتر فضای بزرگ
- امکان تعیین بودجه ثابت
- مناسب پارامترهای پیوسته
- ساده و قابل موازیسازی
Scikit-learn کلاس RandomizedSearchCV را برای نمونهبرداری تصادفی ابرپارامترها ارائه میکند.
مشکل اصلی Random Search این است که انتخاب بعدی از نتایج قبلی یاد نمیگیرد.
الگوریتمهای تکاملی
الگوریتمهایی مانند Genetic Algorithm و Particle Swarm Optimization مجموعهای از جوابها را در طول چند نسل بهبود میدهند.
این روشها برای فضای ترکیبی و پیچیده مناسباند، اما ممکن است به ارزیابیهای زیادی نیاز داشته باشند.
برای مطالعه بیشتر:
بهینهسازی بیزی
بهینهسازی بیزی نتایج آزمایشهای قبلی را مدل میکند و با استفاده از آن تصمیم میگیرد کدام نقطه در مرحله بعد بررسی شود.
هدف این است که با تعداد ارزیابی کمتر به تنظیمات مناسبی برسیم.
بهینهسازی بیزی چیست؟
فرض کنید تابعی داریم که ابرپارامترها را دریافت و عملکرد مدل را برمیگرداند:
y=f(x)y=f(x)
در این رابطه:
xترکیب ابرپارامترها است.f(x)هزینه یا کیفیت واقعی مدل است.- محاسبه
fمیتواند بسیار پرهزینه باشد.
در بهینهسازی بیزی معمولاً خود تابع f ناشناخته یا Black-box در نظر گرفته میشود. الگوریتم بهجای ارزیابی تعداد بسیار زیادی نقطه، یک مدل تقریبی از رفتار تابع ایجاد میکند.
این مدل تقریبی Surrogate Model یا مدل جانشین نام دارد.
فرایند کلی:
- چند نقطه اولیه آزمایش میشوند.
- مدل جانشین با نتایج موجود آموزش میبیند.
- عدمقطعیت و مقدار پیشبینیشده نقاط جدید تخمین زده میشود.
- تابع اکتساب بهترین نقطه بعدی را پیشنهاد میکند.
- تابع واقعی در آن نقطه ارزیابی میشود.
- نتیجه به دادههای قبلی اضافه میشود.
- فرایند تکرار میشود.
مدل جانشین چیست؟
مدل جانشین تقریب کمهزینهای از تابع هدف اصلی است.
روشهای رایج:
- Gaussian Process
- Random Forest
- Tree-structured Parzen Estimator
- مدلهای رگرسیون احتمالاتی
- شبکههای عصبی در مسائل بزرگتر
مدل جانشین دو نوع اطلاعات مهم ارائه میکند:
- مقدار احتمالی تابع هدف
- میزان عدمقطعیت پیشبینی
عدمقطعیت کمک میکند الگوریتم میان امتحانکردن مناطق ناشناخته و تمرکز روی مناطق امیدوارکننده تعادل برقرار کند.
تابع اکتساب چیست؟
تابع اکتساب یا Acquisition Function بر اساس پیشبینی و عدمقطعیت مدل جانشین، نقطه بعدی را انتخاب میکند.
روشهای شناختهشده:
- Expected Improvement
- Probability of Improvement
- Upper Confidence Bound
- Knowledge Gradient
تابع اکتساب باید میان دو رفتار تعادل ایجاد کند:
Exploration
بررسی بخشهایی از فضا که اطلاعات کمی درباره آنها داریم.
Exploitation
تمرکز روی ناحیههایی که احتمال میدهیم جواب خوبی داشته باشند.
اگر الگوریتم فقط Exploitation انجام دهد، ممکن است در یک جواب محلی متوقف شود. اگر فقط Exploration انجام دهد، از اطلاعات آزمایشهای قبلی بهخوبی استفاده نمیکند.
TPE چیست؟
TPE مخفف Tree-structured Parzen Estimator است. این روش بهجای مدلکردن مستقیم احتمال نتیجه بهازای ابرپارامترها، توزیع ابرپارامترها را بر اساس نتیجههای خوب و ضعیف مدل میکند.
TPE معمولاً مشاهدات را به دو گروه تقسیم میکند:
- مجموعه جوابهای بهتر با توزیع
l(x) - مجموعه جوابهای ضعیفتر با توزیع
g(x)
سپس تنظیماتی را ترجیح میدهد که احتمال حضور آنها در گروه خوب نسبت به گروه ضعیف بیشتر باشد.
در Optuna، TPESampler برای هر پارامتر مدلهای احتمالاتی مربوط به نتایج بهتر و سایر نتایج را میسازد و نمونههایی را انتخاب میکند که نسبت احتمال مناسبی داشته باشند.
نکته مهم این است که TPE دقیقاً همان بهینهسازی بیزی کلاسیک مبتنی بر Gaussian Process نیست، اما در خانواده روشهای بهینهسازی ترتیبی مبتنی بر مدل قرار میگیرد و در تنظیم ابرپارامترها کاربرد گستردهای دارد.
Optuna چیست؟
Optuna یک چارچوب متنباز برای بهینهسازی خودکار ابرپارامترها است که بهطور ویژه برای یادگیری ماشین طراحی شده است. این ابزار امکان تعریف پویای فضای جستوجو، استفاده از Samplerهای مختلف، توقف زودهنگام آزمایشهای نامناسب و اجرای موازی را فراهم میکند.
مفاهیم اصلی Optuna:
| مفهوم | توضیح |
|---|---|
| Study | کل پروژه بهینهسازی |
| Trial | یک آزمایش با مجموعهای از پارامترها |
| Objective | تابعی که باید کمینه یا بیشینه شود |
| Sampler | روش پیشنهاد پارامترها |
| Pruner | روش توقف آزمایشهای ضعیف |
| Storage | محل ذخیره نتایج Trialها |
نصب Optuna
pip install optuna
برای مثال یادگیری ماشین:
pip install optuna scikit-learn
اولین مثال Optuna
در این مثال مقدار x را طوری پیدا میکنیم که تابع زیر کمینه شود:
f(x)=(x−3)2f(x)=(x-3)^2
import optuna


def objective(trial):
    x = trial.suggest_float(
        "x",
        -10.0,
        10.0,
    )

    return (x - 3.0) ** 2


study = optuna.create_study(
    direction="minimize",
)

study.optimize(
    objective,
    n_trials=100,
)

print("Best value:", study.best_value)
print("Best parameters:", study.best_params)
نتیجه باید مقداری از x نزدیک عدد ۳ باشد.
آموزش تنظیم ابرپارامترهای مدل با Optuna
در این مثال ابرپارامترهای یک مدل SVM را روی مجموعه داده Breast Cancer موجود در Scikit-learn تنظیم میکنیم.
واردکردن کتابخانهها
import optuna

from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import (
    StratifiedKFold,
    cross_val_score,
)
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
بارگذاری داده
data = load_breast_cancer()

X = data.data
y = data.target
تعریف تابع Objective
def objective(trial):
    kernel = trial.suggest_categorical(
        "kernel",
        ["rbf", "poly", "sigmoid"],
    )

    c_value = trial.suggest_float(
        "C",
        1e-3,
        1e3,
        log=True,
    )

    gamma = trial.suggest_float(
        "gamma",
        1e-5,
        1e0,
        log=True,
    )

    model_params = {
        "kernel": kernel,
        "C": c_value,
        "gamma": gamma,
        "class_weight": "balanced",
    }

    if kernel == "poly":
        model_params["degree"] = trial.suggest_int(
            "degree",
            2,
            5,
        )

    pipeline = Pipeline(
        [
            ("scaler", StandardScaler()),
            ("model", SVC(**model_params)),
        ]
    )

    cross_validation = StratifiedKFold(
        n_splits=5,
        shuffle=True,
        random_state=42,
    )

    scores = cross_val_score(
        pipeline,
        X,
        y,
        cv=cross_validation,
        scoring="roc_auc",
        n_jobs=-1,
    )

    return scores.mean()
ایجاد Study
sampler = optuna.samplers.TPESampler(
    seed=42,
)

study = optuna.create_study(
    direction="maximize",
    sampler=sampler,
    study_name="svm-breast-cancer",
)

study.optimize(
    objective,
    n_trials=100,
    n_jobs=1,
)
مشاهده نتیجه
print("Best ROC AUC:", study.best_value)

print("Best parameters:")

for name, value in study.best_params.items():
    print(f"{name}: {value}")
چرا از Cross-validation استفاده کردیم؟
اگر هر ترکیب فقط روی یک تقسیم آموزش و اعتبارسنجی سنجیده شود، نتیجه ممکن است به آن تقسیم خاص وابسته باشد.
Cross-validation داده را به چند بخش تقسیم میکند و مدل چند بار آموزش میبیند. میانگین نتایج تخمین پایدارتری از عملکرد مدل ارائه میدهد.
بااینحال، Cross-validation نیز هزینه محاسباتی را افزایش میدهد:
تعداد آموزشها =
تعداد Trialها × تعداد Foldها
در مثال بالا:
۱۰۰ × ۵ = ۵۰۰ بار آموزش
جلوگیری از نشت داده
تمام عملیات وابسته به داده مانند StandardScaler باید داخل Pipeline قرار گیرد.
اگر قبل از Cross-validation کل داده را نرمالسازی کنیم، اطلاعات Fold اعتبارسنجی وارد فرایند آمادهسازی داده میشود و نتیجه میتواند بیشازحد خوشبینانه باشد.
این مشکل Data Leakage نام دارد.
Pruning در Optuna چیست؟
Pruning یعنی متوقفکردن Trialهایی که در مراحل اولیه امید کمی به نتیجه مناسب دارند.
فرض کنید آموزش یک شبکه عصبی ۱۰۰ Epoch طول میکشد. اگر پس از ۱۰ Epoch مشخص شود عملکرد Trial بسیار ضعیف است، ادامه آموزش منابع را هدر میدهد.
Optuna از الگوریتمهای نمونهبرداری و Prunerها برای متوقفکردن مؤثر Trialهای نامناسب پشتیبانی میکند.
نمونه کلی:
def objective(trial):
    model = build_model(trial)

    for epoch in range(100):
        train_one_epoch(model)

        validation_score = evaluate(model)

        trial.report(
            validation_score,
            step=epoch,
        )

        if trial.should_prune():
            raise optuna.TrialPruned()

    return validation_score
ساخت Study با Pruner:
pruner = optuna.pruners.MedianPruner(
    n_startup_trials=10,
    n_warmup_steps=5,
)

study = optuna.create_study(
    direction="maximize",
    pruner=pruner,
)
Pruning باید با احتیاط استفاده شود. بعضی مدلها در مراحل اولیه کند یاد میگیرند اما در ادامه به نتیجه خوبی میرسند.
Samplerهای مهم Optuna
TPESampler
گزینه مناسب برای بسیاری از مسائل دارای متغیرهای پیوسته، صحیح، دستهای و شرطی است.
sampler = optuna.samplers.TPESampler(
    seed=42,
)
RandomSampler
برای ایجاد خط مبنا و بررسی تصادفی فضای جستوجو مناسب است.
sampler = optuna.samplers.RandomSampler(
    seed=42,
)
CmaEsSampler
CMA-ES برای فضای عمدتاً پیوسته کاربرد دارد:
sampler = optuna.samplers.CmaEsSampler(
    seed=42,
)
GPSampler
در نسخههای پشتیبانیشده Optuna میتوان از Sampler مبتنی بر Gaussian Process برای برخی مسائل پیوسته استفاده کرد. پیش از استفاده باید مستندات نسخه نصبشده، محدودیتها و هزینه محاسباتی آن بررسی شود.
NSGAIISampler
برای مسائل چندهدفه قابلاستفاده است:
sampler = optuna.samplers.NSGAIISampler(
    seed=42,
)
Optuna مجموعهای از Samplerها را از طریق ماژول رسمی optuna.samplers ارائه میکند.
ذخیره Study در پایگاه داده
اگر Storage مشخص نشود، نتایج Study معمولاً در حافظه فرایند قرار میگیرند و با پایان برنامه از بین میروند.
برای ذخیره محلی:
study = optuna.create_study(
    study_name="my-study",
    storage="sqlite:///optuna.db",
    direction="maximize",
    load_if_exists=True,
)
مزایای Storage:
- ادامه آزمایش پس از توقف
- مشاهده تاریخچه Trialها
- اجرای چند Worker
- مقایسه آزمایشها
- جلوگیری از تکرار بعضی کارها
- ثبت تنظیمات و نتایج
در محیط سازمانی بهتر است از یک پایگاه داده مناسب، نسخهبندی کد، ثبت نسخه داده و ثبت نسخه مدل نیز استفاده شود.
اجرای موازی Optuna
میتوان چند Trial را همزمان اجرا کرد:
study.optimize(
    objective,
    n_trials=100,
    n_jobs=4,
)
اما اجرای موازی یک ملاحظه مهم دارد: Trialهای همزمان هنوز نتیجه یکدیگر را نمیدانند. بنابراین موازیسازی بسیار زیاد میتواند بخشی از مزیت جستوجوی ترتیبی را کاهش دهد.
در فراخوانی API نیز باید محدودیت نرخ، ظرفیت سرویس، هزینه و تعداد اتصال همزمان در نظر گرفته شود.
بهینهسازی چندهدفه چیست؟
در پروژه واقعی معمولاً فقط یک معیار وجود ندارد.
برای مثال، در انتخاب مدل هوش مصنوعی میخواهیم:
- کیفیت را افزایش دهیم.
- هزینه را کاهش دهیم.
- زمان پاسخ را کاهش دهیم.
ممکن است هیچ تنظیمی در هر سه معیار بهترین نباشد. در این حالت مجموعهای از جوابهای غیرمغلوب یا Pareto-optimal به دست میآید.
ساخت Study چندهدفه:
study = optuna.create_study(
    directions=[
        "maximize",
        "minimize",
        "minimize",
    ],
)
تابع Objective:
def objective(trial):
    quality = evaluate_quality(trial)
    cost = calculate_cost(trial)
    latency = measure_latency(trial)

    return quality, cost, latency
پس از اجرا، بهجای یک جواب نهایی مجموعهای از Trialهای Pareto در اختیار داریم:
for trial in study.best_trials:
    print(
        trial.values,
        trial.params,
    )
انتخاب نهایی باید بر اساس محدودیتها و اولویتهای محصول انجام شود.
استفاده از Optuna برای تنظیم مدلهای زبانی
در یک برنامه متصل به مدل زبانی میتوان پارامترهای زیر را بهینه کرد:
- شناسه مدل
- نسخه پرامپت
- Temperature
- Top P
- Max Tokens
- تعداد مثالهای Few-shot
- فعال یا غیرفعال بودن RAG
- تعداد Chunkهای بازیابیشده
- آستانه Reranker
- آستانه Fallback
- تعداد مراحل Agent
- سقف فراخوانی ابزار
نمونه فضای جستوجو:
model = trial.suggest_categorical(
    "model",
    [
        "FAST_MODEL_ID",
        "BALANCED_MODEL_ID",
        "QUALITY_MODEL_ID",
    ],
)

prompt_version = trial.suggest_categorical(
    "prompt_version",
    ["v1", "v2", "v3"],
)

temperature = trial.suggest_float(
    "temperature",
    0.0,
    0.8,
)

max_tokens = trial.suggest_int(
    "max_tokens",
    200,
    1000,
    step=100,
)
اتصال Optuna به API درواره
API درواره با ساختار OpenAI سازگار است و میتوان مدلها و تنظیمات مختلف را با یک Client مشترک ارزیابی کرد.
نصب:
pip install openai optuna
متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL_FAST="YOUR_FAST_MODEL_ID"
export DARVAREH_MODEL_QUALITY="YOUR_QUALITY_MODEL_ID"
ساخت Client:
import os
import time

from openai import OpenAI


client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)

MODELS = [
    os.environ["DARVAREH_MODEL_FAST"],
    os.environ["DARVAREH_MODEL_QUALITY"],
]
تعریف نسخههای پرامپت
PROMPTS = {
"short": (
"پاسخی دقیق، کوتاه و فارسی ارائه کن. "
"از بیان اطلاعات حدسی خودداری کن."
),
"structured": (
"پرسش را دقیق تحلیل کن. پاسخ را به زبان "
"فارسی و با ساختار مرحلهبهمرحله بنویس. "
"اگر اطلاعات کافی نیست، این موضوع را شفاف بگو."
),
"support": (
"شما کارشناس پشتیبانی فنی هستید. پاسخ باید "
"روشن، کاربردی، محترمانه و بدون ادعای "
"تأییدنشده باشد."
),
}
مجموعه ارزیابی
EVAL_SET = [
{
"question": (
"چطور شناسه مدل را در برنامه تغییر بدهم؟"
),
"required_terms": [
"مدل",
"شناسه",
],
},
{
"question": (
"خطای 429 در API به چه معناست؟"
),
"required_terms": [
"محدودیت",
"درخواست",
],
},
{
"question": (
"چرا کلید API نباید در فرانتاند باشد؟"
),
"required_terms": [
"سرور",
"کلید",
],
},
]
فراخوانی مدل
def call_model(
    model,
    system_prompt,
    question,
    temperature,
    max_tokens,
):
    started_at = time.perf_counter()

    response = client.chat.completions.create(
        model=model,
        temperature=temperature,
        max_tokens=max_tokens,
        messages=[
            {
                "role": "system",
                "content": system_prompt,
            },
            {
                "role": "user",
                "content": question,
            },
        ],
    )

    latency = time.perf_counter() - started_at

    answer = (
        response.choices[0].message.content
        or ""
    )

    total_tokens = 0

    if response.usage is not None:
        total_tokens = (
            response.usage.total_tokens
        )

    return {
        "answer": answer,
        "latency": latency,
        "total_tokens": total_tokens,
    }
امتیازدهی ساده و قطعی
def score_answer(answer, required_terms):
    if not answer.strip():
        return 0.0

    term_score = sum(
        term in answer
        for term in required_terms
    ) / len(required_terms)

    length_score = (
        1.0
        if 80 <= len(answer) <= 900
        else 0.5
    )

    return (
        0.8 * term_score
        + 0.2 * length_score
    )
این امتیازدهی صرفاً آموزشی است. در پروژه عملی باید از مجموعه Evals واقعی، آزمونهای قطعی، بررسی استناد، ارزیابی انسانی و در صورت نیاز مدل داور استفاده شود.
تعریف Objective
import optuna


def objective(trial):
    model = trial.suggest_categorical(
        "model",
        MODELS,
    )

    prompt_name = trial.suggest_categorical(
        "prompt",
        list(PROMPTS.keys()),
    )

    temperature = trial.suggest_float(
        "temperature",
        0.0,
        0.7,
        step=0.1,
    )

    max_tokens = trial.suggest_int(
        "max_tokens",
        200,
        800,
        step=100,
    )

    scores = []
    latencies = []
    token_counts = []

    for item in EVAL_SET:
        result = call_model(
            model=model,
            system_prompt=PROMPTS[prompt_name],
            question=item["question"],
            temperature=temperature,
            max_tokens=max_tokens,
        )

        scores.append(
            score_answer(
                result["answer"],
                item["required_terms"],
            )
        )

        latencies.append(result["latency"])
        token_counts.append(
            result["total_tokens"]
        )

    mean_quality = sum(scores) / len(scores)
    mean_latency = (
        sum(latencies) / len(latencies)
    )
    mean_tokens = (
        sum(token_counts) / len(token_counts)
    )

    trial.set_user_attr(
        "mean_latency",
        mean_latency,
    )

    trial.set_user_attr(
        "mean_tokens",
        mean_tokens,
    )

    latency_penalty = min(
        mean_latency / 20.0,
        0.2,
    )

    token_penalty = min(
        mean_tokens / 20_000,
        0.1,
    )

    final_score = (
        mean_quality
        - latency_penalty
        - token_penalty
    )

    return final_score
اجرای Study
sampler = optuna.samplers.TPESampler(
    seed=42,
)

study = optuna.create_study(
    study_name="darvareh-llm-tuning",
    storage="sqlite:///darvareh_optuna.db",
    direction="maximize",
    sampler=sampler,
    load_if_exists=True,
)

study.optimize(
    objective,
    n_trials=30,
)

print("Best score:", study.best_value)
print("Best parameters:", study.best_params)
print("Metadata:", study.best_trial.user_attrs)
نسخه چندهدفه برای کیفیت، زمان و مصرف
استفاده از یک فرمول وزنی همیشه مناسب نیست؛ زیرا وزنها میتوانند نتیجه را پنهان کنند.
میتوان سه معیار را جداگانه برگرداند:
def multi_objective(trial):
    result = evaluate_configuration(trial)

    return (
        result["quality"],
        result["latency"],
        result["total_tokens"],
    )


study = optuna.create_study(
    directions=[
        "maximize",
        "minimize",
        "minimize",
    ],
)

study.optimize(
    multi_objective,
    n_trials=50,
)
سپس تیم محصول میتواند از میان جوابهای Pareto، تنظیمی را انتخاب کند که با SLA، بودجه و سطح کیفیت موردنیاز هماهنگ باشد.
چگونه هزینه بهینهسازی API را محاسبه کنیم؟
هزینه آزمایش فقط به تعداد Trialها وابسته نیست.
تعداد درخواستها =
تعداد Trialها
× تعداد نمونههای ارزیابی
× تعداد تکرار هر نمونه
× تعداد مراحل هر گردشکار
برای مثال:
۳۰ Trial
× ۲۰ پرسش
× ۲ تکرار
× ۱ فراخوانی
= ۱۲۰۰ درخواست
اگر هر پاسخ بهطور متوسط ۱۵۰۰ توکن ورودی و خروجی داشته باشد:
۱۲۰۰ × ۱۵۰۰
= ۱,۸۰۰,۰۰۰ توکن
پیش از شروع باید سقف هزینه، تعداد Trial و شرط توقف مشخص شود.
برای آشنایی بیشتر، مقاله محاسبه هزینه API هوش مصنوعی را مطالعه کنید.
Cache کردن نتایج
ممکن است چند Trial تنظیمات یکسان یا نزدیک به هم ایجاد کنند. Cache از فراخوانیهای تکراری جلوگیری میکند.
کلید Cache میتواند از این مقادیر ساخته شود:
model
prompt_version
temperature
max_tokens
question_id
dataset_version
نمونه ساده:
import hashlib
import json


def build_cache_key(payload):
    normalized = json.dumps(
        payload,
        sort_keys=True,
        ensure_ascii=False,
    )

    return hashlib.sha256(
        normalized.encode("utf-8")
    ).hexdigest()
در سیستم واقعی بهتر است پاسخ، زمان، مصرف، نسخه مدل و تاریخ ارزیابی نیز ذخیره شوند.
نکته مهم درباره تغییر نسخه مدل
مدلهای ارائهشده از طریق API ممکن است در طول زمان تغییر کنند. نتایج بهینهسازی باید همراه با اطلاعات زیر ثبت شوند:
- شناسه دقیق مدل
- ارائهدهنده یا مسیر اجرا
- تاریخ آزمایش
- نسخه پرامپت
- نسخه مجموعه ارزیابی
- پارامترهای درخواست
- Seed در صورت پشتیبانی
- زمان پاسخ
- مصرف توکن
- قیمت ثبتشده در زمان آزمایش
اگر مدل یا مسیر ارائه تغییر کند، نتیجه Study قدیمی ممکن است دیگر معتبر نباشد.
طراحی تابع هدف مناسب
تابع هدف باید با ارزش واقعی محصول هماهنگ باشد.
یک تابع هدف برای دستیار پشتیبانی میتواند شامل این موارد باشد:
Score=w1Accuracy+w2Groundedness+w3ResolutionRate−w4Cost−w5Latency−w6FailureRateScore = w_1 Accuracy +w_2 Groundedness +w_3 ResolutionRate -w_4 Cost -w_5 Latency -w_6 FailureRate
معیارهای احتمالی:
- صحت پاسخ
- نرخ حل مسئله
- رعایت قالب خروجی
- معتبر بودن JSON
- کیفیت استناد
- نرخ توهم
- هزینه
- زمان پاسخ
- نرخ Timeout
- تعداد فراخوانی ابزار
- نیاز به ارجاع انسانی
- رضایت کاربر
اگر تابع هدف فقط شباهت متنی را اندازهگیری کند، ممکن است تنظیماتی پیدا شود که از نظر عددی خوب اما از نظر کاربر نامناسب باشد.
آیا باید از مدل داور استفاده کنیم؟
مدل داور یا LLM-as-a-Judge میتواند کیفیت پاسخها را بر اساس یک Rubric ارزیابی کند، اما نباید تنها معیار باشد.
مدل داور ممکن است:
- پاسخ طولانیتر را ترجیح دهد.
- به سبک خاصی سوگیری داشته باشد.
- خطای factual را تشخیص ندهد.
- در اجراهای مختلف امتیاز متفاوتی بدهد.
- پاسخ تولیدشده توسط خانواده خودش را ترجیح دهد.
روش مناسبتر:
امتیاز نهایی =
معیارهای قطعی
+ مدل داور
+ ارزیابی انسانی
+ معیارهای عملیاتی
برای طراحی ارزیابی، مقاله ارزیابی مدلهای هوش مصنوعی و Evals را مطالعه کنید.
جلوگیری از بیشبرازش در تنظیم ابرپارامترها
اگر صدها Trial روی یک مجموعه اعتبارسنجی اجرا شوند، تنظیمات نهایی ممکن است به همان مجموعه بیشبرازش پیدا کنند.
راهکار مناسب تقسیم داده به سه بخش است:
- Training Set
- Validation Set
- Test Set
فرایند:
- مدل روی Training Set آموزش میبیند.
- Optuna بر اساس Validation Set تصمیم میگیرد.
- فقط تنظیمات نهایی روی Test Set ارزیابی میشوند.
- Test Set نباید در انتخاب ابرپارامترها دخالت داشته باشد.
در برنامه مدل زبانی نیز بهتر است یک مجموعه Holdout مستقل برای ارزیابی نهایی نگه داشته شود.
Nested Cross-validation چیست؟
اگر مجموعه داده کوچک باشد و بخواهیم تخمین کمسوگیرانهتری از عملکرد نهایی داشته باشیم، میتوان از Nested Cross-validation استفاده کرد.
در این روش:
- حلقه داخلی برای تنظیم ابرپارامترها است.
- حلقه خارجی برای ارزیابی عملکرد نهایی است.
این روش از نظر محاسباتی گران است، اما اثر انتخاب ابرپارامتر روی برآورد عملکرد را بهتر کنترل میکند.
انتخاب دامنه مناسب پارامترها
فضای بیشازحد بزرگ باعث هدررفتن Trialها میشود. فضای بسیار محدود نیز ممکن است بهترین تنظیمات را حذف کند.
اصول پیشنهادی:
- از دانش مسئله برای تعیین حدود استفاده کنید.
- پارامترهای مقیاسی مانند Learning Rate را لگاریتمی تعریف کنید.
- پارامترهای بیاثر را حذف کنید.
- فضای جستوجو را مرحلهای توسعه دهید.
- از فضای شرطی برای تنظیمات وابسته استفاده کنید.
- مقدارهای پیشفرض معتبر را در فضای جستوجو نگه دارید.
مثال نادرست برای Learning Rate:
trial.suggest_float(
    "learning_rate",
    0.000001,
    1.0,
)
نمونه مناسبتر:
trial.suggest_float(
    "learning_rate",
    1e-6,
    1e-1,
    log=True,
)
انتخاب تعداد Trial
تعداد مناسب Trial به عوامل زیر بستگی دارد:
- تعداد ابرپارامترها
- نوع متغیرها
- وسعت فضای جستوجو
- هزینه هر ارزیابی
- میزان نویز تابع هدف
- امکان Pruning
- کیفیت اولیه فضای جستوجو
برای یک آزمایش اولیه میتوان با ۲۰ تا ۵۰ Trial شروع کرد. پس از بررسی نمودارها و اهمیت پارامترها، فضای جستوجو اصلاح و Study ادامه داده میشود.
عدد ثابت و جهانی برای همه مسائل وجود ندارد.
تحلیل نتایج Optuna
Optuna ابزارهای تصویری مختلفی ارائه میکند.
نصب وابستگیهای ترسیم:
pip install plotly
تاریخچه بهینهسازی
from optuna.visualization import (
    plot_optimization_history,
)


figure = plot_optimization_history(study)
figure.show()
اهمیت پارامترها
from optuna.visualization import (
    plot_param_importances,
)


figure = plot_param_importances(study)
figure.show()
نمودار Parallel Coordinate
from optuna.visualization import (
    plot_parallel_coordinate,
)


figure = plot_parallel_coordinate(study)
figure.show()
رابطه پارامترها و نتیجه
from optuna.visualization import (
    plot_slice,
)


figure = plot_slice(study)
figure.show()
این نمودارها کمک میکنند:
- پارامترهای مهم شناسایی شوند.
- دامنههای نامناسب اصلاح شوند.
- Trialهای غیرعادی بررسی شوند.
- همگرایی Study ارزیابی شود.
بازتولیدپذیری
برای بازتولید نتایج:
- Seed را ثبت کنید.
- نسخه کتابخانهها را ذخیره کنید.
- نسخه داده را مشخص کنید.
- نسخه کد را در Git ثبت کنید.
- فضای جستوجو را نسخهبندی کنید.
- شناسه مدل و پرامپت را ثبت کنید.
- نتایج را در Storage پایدار نگه دارید.
مثال:
sampler = optuna.samplers.TPESampler(
    seed=42,
)
بااینحال، اجرای موازی، GPU و سرویسهای خارجی ممکن است بازتولید دقیق را دشوار کنند.
تفاوت بهینهسازی بیزی و الگوریتم ژنتیک
| ویژگی | بهینهسازی بیزی | الگوریتم ژنتیک |
|---|---|---|
| استفاده از مدل جانشین | دارد | معمولاً ندارد |
| تعداد ارزیابی موردنیاز | اغلب کمتر | معمولاً بیشتر |
| اجرای کاملاً موازی | محدودتر | سادهتر |
| فضای شرطی | با TPE مناسب | با نمایش مناسب |
| مناسب تابع بسیار پرهزینه | بله | گاهی |
| حفظ جمعیت | ندارد | دارد |
| سازوکار اصلی | مدل احتمالاتی و پیشنهاد بعدی | انتخاب، ترکیب و جهش |
تفاوت بهینهسازی بیزی و PSO
| ویژگی | بهینهسازی بیزی | PSO |
|---|---|---|
| حافظه نتایج | مدل جانشین | pbest و gbest |
| مناسب ارزیابی پرهزینه | معمولاً بهتر | نیازمند ارزیابی بیشتر |
| فضای پیوسته | مناسب | بسیار مناسب |
| عدمقطعیت | مدل میشود | معمولاً مدل نمیشود |
| موازیسازی گسترده | میتواند کارایی ترتیبی را کم کند | طبیعیتر |
| پیچیدگی | بیشتر | پیادهسازی سادهتر |
چه زمانی از Optuna استفاده کنیم؟
Optuna زمانی مناسب است که:
- چند ابرپارامتر قابلتنظیم دارید.
- هر ارزیابی زمان یا هزینه دارد.
- فضای جستوجو شامل متغیرهای ترکیبی است.
- به فضای شرطی نیاز دارید.
- میخواهید Trialهای ضعیف زودتر متوقف شوند.
- باید نتایج و تاریخچه آزمایشها ذخیره شوند.
- به بهینهسازی چندهدفه نیاز دارید.
- میخواهید آزمایشها را مرحلهای ادامه دهید.
احتمالاً نیازی به Optuna نیست اگر:
- فقط یک یا دو انتخاب ساده دارید.
- جواب تحلیلی یا تنظیم استاندارد مشخصی وجود دارد.
- هزینه ساخت زیرساخت آزمایش از منفعت آن بیشتر است.
- داده اعتبارسنجی قابلاعتماد ندارید.
- معیار موفقیت هنوز مشخص نشده است.
اشتباهات رایج در تنظیم ابرپارامترها
استفاده از Test Set در Objective
این کار باعث نشت اطلاعات و گزارش عملکرد بیشازحد خوشبینانه میشود.
فضای جستوجوی غیرمنطقی
دامنههای بیشازحد بزرگ یا پارامترهای بیربط بودجه Trialها را هدر میدهند.
بهینهسازی تنها یک معیار
ممکن است مدلی با کیفیت اندکی بهتر اما هزینه و تأخیر چندبرابر انتخاب شود.
ثبتنکردن نسخهها
بدون ثبت نسخه داده، مدل، کد و پرامپت، نتیجه قابلبازتولید نیست.
اجرای Trialهای بیشازحد کم
در فضای بزرگ، پنج یا ده Trial معمولاً برای نتیجهگیری کافی نیست.
مقایسهنکردن با Random Search
باید بررسی شود که روش هوشمند واقعاً نسبت به یک خط مبنای ساده بهتر عمل میکند.
Pruning زودهنگام
ممکن است Trialهایی حذف شوند که شروع ضعیف اما نتیجه نهایی مناسبی دارند.
نادیدهگرفتن نویز
اگر یک تنظیم در اجراهای مختلف نتایج متفاوتی ایجاد کند، ارزیابی یکباره قابلاعتماد نیست.
تنظیم همزمان تعداد زیادی پارامتر
بهتر است ابتدا پارامترهای مؤثرتر انتخاب و سپس فضای جستوجو توسعه داده شود.
نادیدهگرفتن هزینه API
تعداد Trialها، نمونهها، تکرارها و مراحل گردشکار باید پیش از اجرا محاسبه شوند.
چکلیست اجرای پروژه بهینهسازی
پیش از شروع این موارد را مشخص کنید:
- هدف دقیق بهینهسازی چیست؟
- معیار اصلی کیفیت چیست؟
- محدودیت هزینه و زمان چقدر است؟
- فضای جستوجو چگونه تعریف میشود؟
- کدام پارامترها شرطی هستند؟
- داده آموزش، اعتبارسنجی و آزمایش چگونه جدا شدهاند؟
- هر Trial چقدر هزینه دارد؟
- آیا Pruning امکانپذیر است؟
- نتایج کجا ذخیره میشوند؟
- خط مبنای Grid یا Random Search چیست؟
- چند اجرای مستقل لازم است؟
- جواب نهایی چگونه تأیید میشود؟
پرسشهای متداول
بهینهسازی بیزی به زبان ساده چیست؟
روشی است که از نتایج آزمایشهای قبلی یاد میگیرد و تلاش میکند امیدوارکنندهترین تنظیمات را برای آزمایش بعدی انتخاب کند.
Optuna چیست؟
Optuna یک کتابخانه متنباز پایتون برای بهینهسازی خودکار ابرپارامترها است. این ابزار از فضای جستوجوی پویا، Samplerهای مختلف، Pruning، اجرای موازی و بهینهسازی چندهدفه پشتیبانی میکند.
آیا Optuna فقط برای یادگیری ماشین است؟
خیر. هر تابعی که پارامتر دریافت کند و یک یا چند معیار عددی برگرداند میتواند با Optuna بهینه شود؛ از جمله تنظیمات API، شبیهسازی، طراحی مهندسی و گردشکار مدلهای زبانی.
تفاوت Grid Search و Optuna چیست؟
Grid Search همه ترکیبهای تعریفشده را بررسی میکند، اما Optuna میتواند با استفاده از نتایج قبلی پارامترهای امیدوارکنندهتری پیشنهاد دهد و Trialهای ضعیف را متوقف کند.
آیا TPE همان بهینهسازی بیزی است؟
TPE یک روش بهینهسازی ترتیبی مبتنی بر مدل است که در تنظیم ابرپارامترها بهعنوان یکی از روشهای بهینهسازی هوشمند استفاده میشود. سازوکار آن با Bayesian Optimization کلاسیک مبتنی بر Gaussian Process متفاوت است.
چند Trial برای Optuna لازم است؟
عدد ثابتی وجود ندارد. برای آزمایش اولیه میتوان از ۲۰ تا ۵۰ Trial شروع کرد و بر اساس ابعاد فضا، هزینه ارزیابی و روند همگرایی تصمیم گرفت.
آیا Optuna بهترین تنظیمات را تضمین میکند؟
خیر. Optuna میتواند جستوجو را کارآمدتر کند، اما تضمینی برای یافتن بهینه سراسری وجود ندارد.
آیا Optuna با Scikit-learn کار میکند؟
بله. میتوان مدلهای Scikit-learn را داخل تابع Objective ساخت و با Cross-validation ارزیابی کرد.
آیا Optuna برای مدلهای زبانی مناسب است؟
بله. Optuna میتواند مدل، پرامپت، Temperature، تعداد نتایج RAG و سایر تنظیمات را بهینه کند. هزینه API، نویز خروجی و کیفیت Evals باید کنترل شوند.
آیا میتوان Optuna را به API درواره متصل کرد؟
بله. هر Trial میتواند یک ترکیب مدل و تنظیمات را از طریق API درواره اجرا و کیفیت، هزینه و زمان پاسخ را ثبت کند.
جمعبندی
بهینهسازی بیزی راهی برای جستوجوی هوشمندانه ابرپارامترها با استفاده از نتایج آزمایشهای قبلی است. این روش بهخصوص زمانی ارزشمند است که هر ارزیابی هزینه یا زمان زیادی نیاز داشته باشد.
Optuna یک ابزار کاربردی برای پیادهسازی این فرایند است و امکانات زیر را فراهم میکند:
- تعریف پویای فضای جستوجو
- پشتیبانی از پارامترهای پیوسته، صحیح و دستهای
- فضای شرطی
- TPE و Samplerهای دیگر
- Pruning
- ذخیره و ادامه Study
- اجرای موازی
- بهینهسازی چندهدفه
- تحلیل تصویری نتایج
برای اجرای صحیح باید:
- معیار موفقیت را دقیق تعریف کنید.
- فضای جستوجوی منطقی بسازید.
- داده آزمایش را از بهینهسازی جدا نگه دارید.
- هزینه هر Trial را محاسبه کنید.
- نتیجه را با Random Search مقایسه کنید.
- نسخه داده، کد، مدل و پرامپت را ثبت کنید.
- کیفیت، هزینه و تأخیر را همزمان بسنجید.
- تنظیمات نهایی را روی مجموعه مستقل آزمایش کنید.
برای آزمایش مدلهای مختلف و ساخت برنامههای هوش مصنوعی میتوانید از مستندات API درواره شروع کنید.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
API درواره با ساختار OpenAI سازگار است و به توسعهدهندگان اجازه میدهد مدلهای مختلف را از طریق یک اتصال یکپارچه آزمایش و در نرمافزار خود استفاده کنند.
مقالات مرتبط
- یادگیری ماشین چیست؟
- الگوریتم ژنتیک چیست؟
- الگوریتم ازدحام ذرات چیست؟
- الگوریتم کلونی مورچگان چیست؟
- ارزیابی مدلهای هوش مصنوعی و Evals
- محاسبه هزینه API هوش مصنوعی
- مسیریابی هوشمند میان مدلها
- API سازگار با OpenAI چیست؟
منابع
- Optuna Documentation
- Optuna GitHub Repository
- Optuna Official Website
- Optuna TPESampler
- Optuna Efficient Optimization Algorithms
- Scikit-learn Hyperparameter Tuning
- Scikit-learn GridSearchCV
- Scikit-learn RandomizedSearchCV
- Hugging Face: Optuna with Transformers
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.