الگوریتم ژنتیک چیست؟ آموزش Genetic Algorithm با مثال عملی پایتون
الگوریتم ژنتیک یکی از روشهای جستوجو و بهینهسازی الهامگرفته از تکامل طبیعی است. در این راهنمای جامع با مفاهیم جمعیت، کروموزوم، تابع Fitness، انتخاب، Crossover و Mutation آشنا میشوید و یک مسئله واقعی بهینهسازی را با پایتون و PyGAD حل میکنید. همچنین کاربرد الگوریتم ژنتیک بررسی میکنیم.
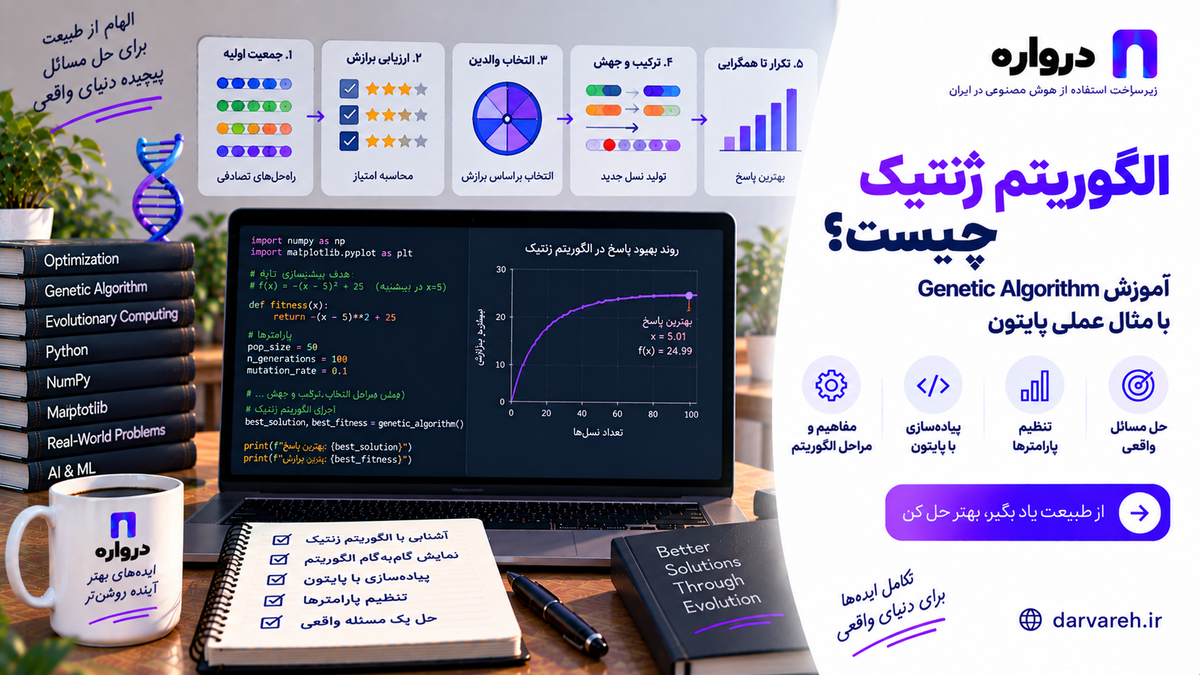
الگوریتم ژنتیک یا Genetic Algorithm یکی از روشهای شناختهشده برای حل مسائل جستوجو و بهینهسازی است. این الگوریتم زمانی کاربرد دارد که تعداد جوابهای احتمالی بسیار زیاد باشد، محاسبه مشتق امکانپذیر نباشد یا روشهای کلاسیک بهینهسازی در نقطهای نامناسب متوقف شوند.
در الگوریتم ژنتیک بهجای اصلاح مستقیم یک جواب، مجموعهای از جوابهای احتمالی ساخته میشود. جوابهای بهتر شانس بیشتری برای انتقال ویژگیهای خود به نسل بعد دارند. با تکرار انتخاب، ترکیب و جهش، کیفیت جمعیت بهتدریج افزایش پیدا میکند.
الگوریتم ژنتیک در مسائلی مانند زمانبندی، مسیریابی، انتخاب ویژگیهای مدل یادگیری ماشین، طراحی مهندسی، تخصیص منابع، تنظیم ابرپارامترها و حتی انتخاب ترکیب مناسبی از مدلها و پرامپتهای هوش مصنوعی استفاده میشود.
الگوریتم ژنتیک چیست؟
الگوریتم ژنتیک یک روش جستوجوی تصادفی و جمعیتمحور از خانواده الگوریتمهای تکاملی است. این روش از مفاهیمی مانند انتخاب طبیعی، وراثت، ترکیب ژنتیکی و جهش الهام میگیرد.
فرایند ساده الگوریتم ژنتیک به این شکل است:
- چند جواب تصادفی ساخته میشود.
- کیفیت هر جواب با تابع Fitness اندازهگیری میشود.
- جوابهای مناسبتر برای تولید نسل بعد انتخاب میشوند.
- بخشی از ویژگیهای والدین با یکدیگر ترکیب میشود.
- تعدادی تغییر تصادفی یا Mutation روی فرزندان انجام میشود.
- نسل جدید ارزیابی میشود.
- این مراحل تا رسیدن به شرط توقف ادامه پیدا میکنند.
الگوریتم ژنتیک یک روش ابتکاری یا فراابتکاری است؛ بنابراین معمولاً تضمین نمیکند بهترین جواب ریاضی ممکن را پیدا کند. هدف آن یافتن یک جواب بسیار مناسب در زمانی قابلقبول است.
الگوریتم ژنتیک چه ارتباطی با هوش مصنوعی دارد؟
جستوجو و بهینهسازی از مسائل بنیادی هوش مصنوعی هستند. یک سیستم هوشمند در بسیاری از کاربردها باید از میان تعداد زیادی انتخاب، ترکیب مناسبتری را پیدا کند.
الگوریتم ژنتیک میتواند برای موارد زیر استفاده شود:
- انتخاب ویژگیهای ورودی مدل
- تنظیم ابرپارامترهای یادگیری ماشین
- طراحی معماری شبکه عصبی
- بهینهسازی وزنهای یک مدل کوچک
- برنامهریزی حرکت ربات
- انتخاب بهترین مجموعه قوانین
- زمانبندی وظایف عاملهای هوش مصنوعی
- پیدا کردن ترکیب مناسب مدل، پرامپت و پارامترها
- مسیریابی درخواستها میان چند مدل
- بهینهسازی همزمان کیفیت، هزینه و زمان پاسخ
برای آشنایی با مفاهیم پایه میتوانید مقاله یادگیری ماشین چیست؟ را نیز مطالعه کنید.
مفاهیم اصلی الگوریتم ژنتیک
ژن چیست؟
ژن کوچکترین بخش قابلتغییر یک جواب است.
اگر مسئله انتخاب تنظیمات یک مدل باشد، هرکدام از موارد زیر میتواند یک ژن باشد:
- شناسه مدل
- مقدار Temperature
- حداکثر طول خروجی
- نوع پرامپت سیستمی
- تعداد نمونههای Few-shot
کروموزوم یا فرد چیست؟
کروموزوم نمایش کامل یک جواب احتمالی است. به هر کروموزوم Individual یا فرد نیز گفته میشود.
برای مثال، کروموزوم زیر میتواند تنظیمات یک برنامه هوش مصنوعی را نمایش دهد:
[model_2, temperature=0.2, max_tokens=500, prompt_version=3]
نوع نمایش کروموزوم به مسئله بستگی دارد. کروموزوم میتواند یکی از ساختارهای زیر باشد:
- رشته دودویی
- آرایه اعداد صحیح
- آرایه اعداد اعشاری
- ترتیب چند عنصر
- درخت
- ترکیبی از متغیرهای مختلف
DEAP امکان تعریف افراد با نمایشهایی مانند List، Array، Set، Dictionary، Tree و NumPy Array را فراهم میکند.
جمعیت چیست؟
جمعیت یا Population مجموعهای از جوابهای احتمالی است.
اگر جمعیت شامل ۱۰۰ فرد باشد، الگوریتم در هر نسل ۱۰۰ جواب را ارزیابی میکند. جمعیت بزرگتر میتواند تنوع بیشتری ایجاد کند، اما تعداد محاسبات تابع Fitness را نیز افزایش میدهد.
نسل چیست؟
پس از انتخاب والدین و تولید فرزندان، یک نسل جدید ساخته میشود. الگوریتم ممکن است دهها یا صدها نسل اجرا شود.
تابع Fitness چیست؟
تابع Fitness مشخص میکند هر جواب چقدر مناسب است.
برای مثال، اگر هدف انتخاب تنظیمات مناسب یک مدل هوش مصنوعی باشد، میتوان Fitness را با ترکیبی از کیفیت، هزینه و سرعت تعریف کرد:
Fitness = Quality - CostPenalty - LatencyPenalty
در یک مسئله زمانبندی نیز Fitness میتواند بر اساس زمان پایان کارها، تأخیر و مصرف منابع محاسبه شود.
تعریف تابع Fitness مهمترین بخش طراحی الگوریتم ژنتیک است. اگر تابع Fitness با هدف واقعی پروژه هماهنگ نباشد، الگوریتم ممکن است یک جواب عددی مناسب اما از نظر کسبوکار نامطلوب پیدا کند.
انتخاب والدین چیست؟
در مرحله Selection، تعدادی از افراد برای تولید نسل بعد انتخاب میشوند. افراد دارای Fitness بالاتر معمولاً شانس بیشتری دارند، اما همیشه نباید فقط بهترین افراد انتخاب شوند؛ زیرا این کار تنوع جمعیت را خیلی سریع کاهش میدهد.
روشهای رایج انتخاب عبارتاند از:
- Roulette Wheel Selection
- Tournament Selection
- Rank Selection
- Stochastic Universal Sampling
- انتخاب بهترین افراد
در Tournament Selection چند فرد بهصورت تصادفی انتخاب میشوند و بهترین فرد آن گروه بهعنوان والد برگزیده میشود.
Crossover چیست؟
Crossover یا ترکیب، بخشی از ژنهای دو والد را با یکدیگر ترکیب میکند.
فرض کنید دو والد دودویی زیر را داریم:
والد اول:  1100|1010
والد دوم:  0011|0101
در Crossover تکنقطهای، نتیجه میتواند چنین باشد:
فرزند اول: 1100|0101
فرزند دوم: 0011|1010
انواع رایج Crossover عبارتاند از:
- تکنقطهای
- دونقطهای
- یکنواخت
- حسابی
- Ordered Crossover برای مسائل ترتیبی
انتخاب روش Crossover باید با ساختار کروموزوم هماهنگ باشد. برای مثال، در مسئله مسیریابی نباید ترکیب باعث تکرار یا حذف غیرمجاز شهرها شود.
Mutation چیست؟
Mutation یا جهش، یک یا چند ژن را بهصورت تصادفی تغییر میدهد.
نمونه جهش در یک کروموزوم دودویی:
قبل از جهش: 11001010
بعد از جهش: 11001110
جهش به حفظ تنوع کمک میکند و احتمال خروج الگوریتم از ناحیههای نامناسب فضای جستوجو را افزایش میدهد.
انواع جهش عبارتاند از:
- Bit Flip
- تغییر تصادفی عدد
- Gaussian Mutation
- جابهجایی دو ژن
- معکوسکردن بخشی از کروموزوم
- Scramble Mutation
نرخ جهش بیشازحد پایین میتواند باعث همگرایی زودرس شود. نرخ بسیار بالا نیز فرایند جستوجو را به جستوجوی تقریباً تصادفی تبدیل میکند.
Elitism چیست؟
در Elitism تعدادی از بهترین افراد بدون تغییر به نسل بعد منتقل میشوند. این کار مانع ازدسترفتن بهترین جواب کشفشده میشود.
بااینحال، انتقال تعداد زیادی از افراد برتر میتواند تنوع جمعیت را کاهش دهد. بنابراین Elitism باید محدود و کنترلشده باشد.
الگوریتم ژنتیک چگونه کار میکند؟
شبهکد ساده الگوریتم به این صورت است:
یک جمعیت اولیه تصادفی بساز
تا زمانی که شرط توقف برقرار نشده است:
Fitness همه افراد را محاسبه کن
والدین را انتخاب کن
والدین را با Crossover ترکیب کن
روی تعدادی از فرزندان Mutation انجام بده
بهترین افراد را حفظ کن
جمعیت نسل بعد را بساز
بهترین جواب پیداشده را برگردان
کتابخانه DEAP نیز الگوریتم تکاملی ساده خود را بر مبنای ارزیابی جمعیت، انتخاب، تولید فرزندان، جهش و ارزیابی دوباره پیادهسازی میکند. پارامترهای اصلی آن شامل احتمال Crossover، احتمال Mutation و تعداد نسلها هستند.
مثال ساده الگوریتم ژنتیک
فرض کنید میخواهیم بیشترین مقدار تابع زیر را در بازه منفی ۱۰ تا مثبت ۱۰ پیدا کنیم:
f(x, y) = sin(x) + cos(y) - 0.01(x² + y²)
هر جواب شامل دو ژن است:
[x, y]
تابع Fitness نیز همان مقدار تابع خواهد بود. الگوریتم ابتدا مجموعهای از نقاط تصادفی میسازد و در نسلهای بعدی نقاط مناسبتر را با هم ترکیب میکند.
این مثال را میتوان با کتابخانههایی مانند PyGAD یا DEAP پیادهسازی کرد.
ابزارهای پایتون برای الگوریتم ژنتیک
PyGAD
PyGAD یک کتابخانه متنباز پایتون برای ساخت الگوریتمهای ژنتیک و بهینهسازی مسائل یادگیری ماشین است. این کتابخانه از روشهای مختلف انتخاب، Crossover و Mutation پشتیبانی میکند و امکان تعریف مسائل تکهدفه و چندهدفه را دارد.
نصب PyGAD:
pip install pygad numpy
DEAP
DEAP یک چارچوب انعطافپذیر برای محاسبات تکاملی در پایتون است. این کتابخانه برای الگوریتم ژنتیک، برنامهنویسی ژنتیک، مسائل چندهدفه و اجرای موازی مناسب است.
نصب DEAP:
pip install deap
SciPy
SciPy تابع differential_evolution را برای بهینهسازی تصادفی و بدون مشتق ارائه میکند. Differential Evolution یکی از الگوریتمهای تکاملی است، اما دقیقاً همان الگوریتم ژنتیک کلاسیک نیست. این روش فضای وسیعی را جستوجو میکند و معمولاً نسبت به روشهای گرادیانی به ارزیابیهای بیشتری از تابع هدف نیاز دارد.
آموزش عملی الگوریتم ژنتیک با PyGAD
در این مثال میخواهیم توزیع درخواستهای یک برنامه را میان سه مسیر فرضی هوش مصنوعی بهینه کنیم:
- مسیر سریع
- مسیر متعادل
- مسیر باکیفیت
هر مسیر کیفیت، هزینه و زمان پاسخ متفاوتی دارد. هدف این است که درصد تخصیص درخواستها را طوری انتخاب کنیم که:
- مجموع تخصیصها نزدیک ۱۰۰ درصد باشد.
- کیفیت متوسط حداقل ۰٫۸۵ باشد.
- هزینه متوسط از ۰٫۰۳ واحد بیشتر نشود.
- زمان پاسخ تا حد امکان پایین بماند.
اعداد این مثال آموزشی و فرضی هستند و قیمت یا عملکرد مدل خاصی را نشان نمیدهند.
تعریف دادههای مسئله
import numpy as np
import pygad


QUALITY = np.array([0.78, 0.87, 0.94])
COST = np.array([0.010, 0.025, 0.060])
LATENCY = np.array([0.7, 1.4, 3.2])

MAX_COST = 0.030
MIN_QUALITY = 0.850
هر کروموزوم شامل سه ژن است:
[درصد مسیر سریع، درصد مسیر متعادل، درصد مسیر باکیفیت]
برای مثال:
[40, 45, 15]
یعنی ۴۰ درصد درخواستها به مسیر سریع، ۴۵ درصد به مسیر متعادل و ۱۵ درصد به مسیر باکیفیت ارسال شوند.
تعریف تابع Fitness
def fitness_func(ga_instance, solution, solution_idx):
    total = np.sum(solution)

    if total <= 0:
        return -1_000_000

    weights = solution / total

    quality = np.dot(weights, QUALITY)
    cost = np.dot(weights, COST)
    latency = np.dot(weights, LATENCY)

    fitness = (
        quality * 100
        - cost * 700
        - latency * 4
    )

    sum_penalty = abs(total - 100) * 2

    quality_penalty = 0
    if quality < MIN_QUALITY:
        quality_penalty = (MIN_QUALITY - quality) * 1000

    cost_penalty = 0
    if cost > MAX_COST:
        cost_penalty = (cost - MAX_COST) * 3000

    return fitness - sum_penalty - quality_penalty - cost_penalty
در این تابع:
- کیفیت بیشتر امتیاز را افزایش میدهد.
- هزینه و تأخیر امتیاز را کاهش میدهند.
- جوابهایی که مجموع تخصیص آنها از ۱۰۰ فاصله دارد جریمه میشوند.
- نقض محدودیت کیفیت و هزینه نیز جریمه سنگینی دارد.
ساخت و اجرای الگوریتم
ga = pygad.GA(
    num_generations=150,
    num_parents_mating=12,
    sol_per_pop=60,
    num_genes=3,
    fitness_func=fitness_func,
    gene_type=int,
    gene_space=list(range(0, 101, 5)),
    parent_selection_type="tournament",
    K_tournament=4,
    crossover_type="single_point",
    crossover_probability=0.85,
    mutation_type="random",
    mutation_probability=0.12,
    keep_elitism=2,
    random_seed=42,
    stop_criteria=["saturate_30"],
)

ga.run()
PyGAD برای هر جواب تابع Fitness را فراخوانی میکند. مستندات این کتابخانه همچنین شرطهای توقفی مانند رسیدن به یک Fitness مشخص، ثابتماندن نتیجه، محدودیت زمان و محدودیت تعداد ارزیابیها را ارائه میدهد.
نمایش نتیجه
solution, fitness, solution_index = ga.best_solution()

weights = solution / np.sum(solution)

quality = np.dot(weights, QUALITY)
cost = np.dot(weights, COST)
latency = np.dot(weights, LATENCY)

print("Best raw solution:", solution)
print("Normalized allocation:", weights)
print("Fitness:", fitness)
print("Expected quality:", quality)
print("Expected cost:", cost)
print("Expected latency:", latency)
نتیجه دقیق ممکن است به دلیل ماهیت تصادفی الگوریتم در اجراهای مختلف تغییر کند. تعیین random_seed امکان بازتولید یک اجرای مشخص را فراهم میکند.
در یک پروژه واقعی باید دادههای فرضی را با نتایج آزمونهای واقعی مدلها جایگزین کنید.
استفاده از الگوریتم ژنتیک برای بهینهسازی برنامه هوش مصنوعی
فرض کنید یک سامانه پشتیبانی هوشمند دارید و میخواهید بهترین ترکیب تنظیمات زیر را پیدا کنید:
- مدل مورد استفاده
- نسخه پرامپت
- Temperature
- حداکثر تعداد توکن
- تعداد نمونههای Few-shot
- فعال یا غیرفعال بودن RAG
یک کروموزوم میتواند چنین باشد:
[
  model_index,
  prompt_version,
  temperature_index,
  max_tokens_index,
  few_shot_count,
  rag_enabled
]
برای هر کروموزوم، برنامه روی یک مجموعه ارزیابی ثابت اجرا میشود. سپس Fitness بر اساس معیارهای زیر محاسبه میشود:
Fitness =
    AnswerQuality
    - HallucinationPenalty
    - CostPenalty
    - LatencyPenalty
این روش در عمل یک مسئله بهینهسازی پرهزینه است؛ زیرا ارزیابی هر فرد ممکن است چندین درخواست API ایجاد کند. برای کنترل هزینه باید:
- تعداد نمونههای ارزیابی را محدود اما نماینده انتخاب کنید.
- پاسخهای تکراری را Cache کنید.
- ابتدا از جمعیت و نسلهای کوچک استفاده کنید.
- ارزیابیهای مستقل را موازی اجرا کنید.
- جوابهای برتر را روی مجموعه بزرگتری بررسی کنید.
- از توقف زودهنگام استفاده کنید.
اتصال ارزیابیها به API درواره
API درواره با ساختار OpenAI سازگار است. در نتیجه میتوان از کتابخانه رسمی OpenAI و آدرس پایه درواره استفاده کرد.
ابتدا کتابخانه را نصب کنید:
pip install openai pygad
متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL_FAST="YOUR_FAST_MODEL_ID"
export DARVAREH_MODEL_QUALITY="YOUR_QUALITY_MODEL_ID"
ساخت Client:
import os

from openai import OpenAI


client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)
تعریف نسخههای پرامپت
PROMPTS = [
(
"به پرسش کاربر کوتاه، دقیق و فقط بر اساس اطلاعات "
"ارائهشده پاسخ بده."
),
(
"نقش شما کارشناس پشتیبانی است. پاسخ باید فارسی، "
"شفاف، کاربردی و فاقد اطلاعات حدسی باشد."
),
(
"ابتدا مسئله کاربر را تشخیص بده و سپس یک پاسخ "
"مرحلهبهمرحله و مختصر ارائه کن."
),
]
MODELS = [
os.environ["DARVAREH_MODEL_FAST"],
os.environ["DARVAREH_MODEL_QUALITY"],
]
TEMPERATURES = [0.0, 0.2, 0.5]
ارسال درخواست با یک کروموزوم
def generate_answer(candidate, user_message):
    model_index = int(candidate[0])
    prompt_index = int(candidate[1])
    temperature_index = int(candidate[2])

    response = client.chat.completions.create(
        model=MODELS[model_index],
        temperature=TEMPERATURES[temperature_index],
        max_tokens=400,
        messages=[
            {
                "role": "system",
                "content": PROMPTS[prompt_index],
            },
            {
                "role": "user",
                "content": user_message,
            },
        ],
    )

    return response.choices[0].message.content or ""
مجموعه ارزیابی
EVAL_SET = [
    {
        "input": "برای دریافت کلید API باید چه کاری انجام بدهم؟",
        "required_terms": ["کلید", "API"],
    },
    {
        "input": "چطور مدل مورد استفاده را در برنامه تغییر بدهم؟",
        "required_terms": ["مدل"],
    },
    {
        "input": "علت خطای 429 چیست؟",
        "required_terms": ["محدودیت", "درخواست"],
    },
]
امتیازدهی ساده و قطعی
def deterministic_score(answer, required_terms):
    normalized = answer.strip().lower()

    if not normalized:
        return 0.0

    term_score = sum(
        1 for term in required_terms
        if term.lower() in normalized
    ) / len(required_terms)

    length_score = 1.0 if 40 <= len(answer) <= 800 else 0.5

    return 0.8 * term_score + 0.2 * length_score
Fitness متصل به API
def api_fitness(ga_instance, solution, solution_idx):
    scores = []

    for item in EVAL_SET:
        answer = generate_answer(solution, item["input"])

        score = deterministic_score(
            answer,
            item["required_terms"],
        )

        scores.append(score)

    return sum(scores) / len(scores)
ساخت الگوریتم:
ga = pygad.GA(
    num_generations=8,
    num_parents_mating=4,
    sol_per_pop=8,
    num_genes=3,
    fitness_func=api_fitness,
    gene_type=int,
    gene_space=[
        range(len(MODELS)),
        range(len(PROMPTS)),
        range(len(TEMPERATURES)),
    ],
    parent_selection_type="tournament",
    crossover_type="single_point",
    mutation_type="random",
    mutation_probability=0.15,
    keep_elitism=1,
    random_seed=42,
)

ga.run()

solution, fitness, _ = ga.best_solution()

print("Best candidate:", solution)
print("Fitness:", fitness)
این مثال برای آموزش ساده شده است. در پروژه واقعی امتیازدهی فقط با وجود چند کلمه کافی نیست. بهتر است ترکیبی از معیارهای زیر استفاده شود:
- صحت پاسخ
- کاملبودن پاسخ
- رعایت ساختار خروجی
- نرخ پاسخهای غیرمستند
- ارزیابی انسانی
- آزمونهای قطعی
- هزینه مصرف
- زمان پاسخ
- نرخ خطا
برای طراحی مجموعه آزمون مناسب، مقاله ارزیابی مدل هوش مصنوعی و Evals را مطالعه کنید.
چرا نباید فقط از یک مدل داور استفاده کنیم؟
گاهی برای ارزیابی پاسخها از یک مدل زبانی دیگر بهعنوان Judge استفاده میشود. این روش مفید است، اما نباید تنها معیار تصمیمگیری باشد.
مدل داور ممکن است:
- پاسخهای همسبک با خودش را ترجیح دهد.
- در اجرای مجدد امتیاز متفاوتی بدهد.
- اشتباه factual را تشخیص ندهد.
- پاسخ طولانیتر را بهتر ارزیابی کند.
- با هدف واقعی کاربران هماهنگ نباشد.
بهتر است Fitness از چند بخش تشکیل شود:
Fitness =
    0.40 × معیارهای قطعی
  + 0.25 × امتیاز مدل داور
  + 0.20 × ارزیابی انسانی
  + 0.15 × معیارهای عملیاتی
وزنها باید متناسب با کاربرد واقعی تعیین شوند.
کاربردهای الگوریتم ژنتیک
انتخاب ویژگی در یادگیری ماشین
اگر یک مجموعه داده صدها ویژگی داشته باشد، بررسی همه ترکیبهای ممکن عملی نیست. میتوان هر ویژگی را با یک ژن دودویی نمایش داد:
1 = ویژگی انتخاب شود
0 = ویژگی حذف شود
Fitness میتواند ترکیبی از دقت مدل و تعداد ویژگیها باشد:
Fitness = ValidationScore - λ × SelectedFeatureCount
تنظیم ابرپارامترها
موارد زیر میتوانند ژنهای الگوریتم باشند:
- Learning Rate
- Batch Size
- تعداد لایهها
- تعداد درختها
- عمق درخت
- Dropout
- نوع Optimizer
الگوریتم ژنتیک مخصوصاً زمانی مناسب است که فضای پارامترها شامل متغیرهای پیوسته، گسسته و دستهای باشد.
مسیریابی و زمانبندی
در مسائلی مانند Travelling Salesman Problem، ترتیب شهرها بهصورت یک کروموزوم نمایش داده میشود.
در زمانبندی نیز هر فرد میتواند ترتیب اجرای وظایف، تخصیص کارها به ماشینها یا تخصیص وظایف به عاملهای هوش مصنوعی را مشخص کند.
معماری شبکه عصبی
الگوریتمهای تکاملی میتوانند برای انتخاب موارد زیر استفاده شوند:
- تعداد لایهها
- تعداد نورونها
- نوع Activation
- اتصالات شبکه
- اندازه Kernel
- ساختار بلوکها
به این حوزه Neuroevolution گفته میشود.
بهینهسازی پرامپت
اجزای یک پرامپت را میتوان بهصورت ژن نمایش داد:
- نقش مدل
- ترتیب قوانین
- مثالهای Few-shot
- قالب خروجی
- سطح جزئیات
- لحن پاسخ
Crossover بخشهای پرامپتهای موفق را ترکیب میکند و Mutation یک قانون، مثال یا ساختار را تغییر میدهد.
مسیریابی میان چند مدل
در یک معماری چندمدلی، میتوان از الگوریتم ژنتیک برای بهینهسازی موارد زیر استفاده کرد:
- آستانه ارسال درخواست به مدل قویتر
- سهم ترافیک هر مدل
- مسیرهای Fallback
- سقف هزینه
- محدودیت تأخیر
- وزن کیفیت، هزینه و سرعت
برای مطالعه بیشتر به مقاله مسیریابی هوشمند میان مدلهای هوش مصنوعی مراجعه کنید.
الگوریتم ژنتیک چه تفاوتی با Grid Search دارد؟
| ویژگی | الگوریتم ژنتیک | Grid Search |
|---|---|---|
| روش جستوجو | تکاملی و احتمالاتی | بررسی شبکه منظم |
| مناسب فضای بزرگ | بله | معمولاً خیر |
| نیاز به مشتق | ندارد | ندارد |
| تضمین بررسی همه نقاط | خیر | فقط نقاط تعریفشده |
| متغیرهای ترکیبی | مناسب | پرهزینه |
| امکان توقف تدریجی | دارد | دارد |
| وابستگی به تصادف | زیاد | کم |
| تنظیمات داخلی | نسبتاً زیاد | ساده |
Grid Search برای فضای کوچک و تعداد محدود پارامترها انتخاب مناسبی است. در فضای بزرگ، تعداد ترکیبها بهسرعت افزایش پیدا میکند.
تفاوت الگوریتم ژنتیک با Random Search
Random Search جوابها را مستقل از یکدیگر نمونهبرداری میکند. الگوریتم ژنتیک از نتایج نسلهای گذشته برای هدایت جستوجو استفاده میکند.
الگوریتم ژنتیک ممکن است در فضاهایی که جوابهای خوب ساختار مشترک دارند عملکرد بهتری داشته باشد. بااینحال، Random Search سادهتر است و میتواند خط مبنای مناسبی برای مقایسه باشد.
تفاوت الگوریتم ژنتیک با Gradient Descent
| ویژگی | الگوریتم ژنتیک | Gradient Descent |
|---|---|---|
| نیاز به مشتق | ندارد | معمولاً دارد |
| نوع متغیر | پیوسته، گسسته و ترکیبی | بیشتر پیوسته |
| تعداد جوابهای همزمان | یک جمعیت | معمولاً یک نقطه |
| هزینه محاسباتی | بیشتر | معمولاً کمتر |
| مناسب تابع ناپیوسته | بله | محدود |
| احتمال گیرکردن محلی | وجود دارد، اما کمتر | بسته به مسئله قابلتوجه |
| تضمین بهینه سراسری | ندارد | ندارد |
اگر تابع هدف مشتقپذیر و آموزش مدل بسیار پرهزینه باشد، روشهای گرادیانی معمولاً انتخاب عملیتری هستند.
تفاوت الگوریتم ژنتیک با Reinforcement Learning
الگوریتم ژنتیک یک روش بهینهسازی جمعیتمحور است. یادگیری تقویتی بر تعامل عامل با محیط، دریافت پاداش و یادگیری سیاست تمرکز دارد.
در یادگیری تقویتی تصمیمها معمولاً دنبالهدار هستند، اما در الگوریتم ژنتیک هر فرد غالباً یک جواب کامل را نمایش میدهد.
این دو روش میتوانند ترکیب شوند؛ برای مثال، الگوریتم ژنتیک پارامترها یا ساختار یک عامل را بهینه کند و عامل با یادگیری تقویتی سیاست خود را بیاموزد.
برای جزئیات بیشتر، مقاله یادگیری تقویتی، Q-Learning و RLHF را مطالعه کنید.
الگوریتم ژنتیک چندهدفه چیست؟
در بسیاری از پروژهها یک هدف کافی نیست. برای مثال، هنگام انتخاب مدل هوش مصنوعی ممکن است سه هدف داشته باشیم:
- افزایش کیفیت
- کاهش هزینه
- کاهش تأخیر
این اهداف میتوانند با یکدیگر تعارض داشته باشند. الگوریتمهای چندهدفه بهجای تولید یک جواب نهایی، مجموعهای از جوابهای غیرمغلوب را ارائه میکنند که به آن Pareto Front گفته میشود.
یک جواب زمانی مغلوب است که جواب دیگری در همه معیارها برابر یا بهتر و حداقل در یک معیار بهتر باشد.
کتابخانه PyGAD از مسائل تکهدفه و چندهدفه پشتیبانی میکند و مجموعه ابزارهای آن شامل پیادهسازی NSGA-II و NSGA-III نیز میشود.
چگونه پارامترهای الگوریتم ژنتیک را انتخاب کنیم؟
اندازه جمعیت
جمعیت کوچک سریعتر است، اما تنوع کمتری دارد. جمعیت بزرگ فضای جستوجو را بهتر پوشش میدهد، ولی تعداد ارزیابیها را افزایش میدهد.
برای شروع میتوان اندازههای ۲۰، ۵۰ و ۱۰۰ را آزمایش کرد. عدد مناسب به تعداد ژنها و هزینه Fitness بستگی دارد.
تعداد نسلها
اگر کیفیت جواب هنوز در حال افزایش باشد، نسلهای بیشتری لازم است. اگر بهترین Fitness برای چندین نسل ثابت مانده باشد، میتوان الگوریتم را متوقف کرد.
احتمال Crossover
مقدارهای متوسط تا بالا مانند ۰٫۶ تا ۰٫۹ نقطه شروع متداولی هستند، اما قانون ثابتی برای همه مسائل وجود ندارد.
احتمال Mutation
مقدار Mutation به نوع ژن و طول کروموزوم وابسته است. بهتر است چند مقدار روی یک بودجه ارزیابی یکسان مقایسه شود.
تعداد افراد نخبه
حفظ یک یا چند فرد برتر معمولاً مفید است. اگر درصد بزرگی از جمعیت بدون تغییر منتقل شود، تنوع کاهش مییابد.
همگرایی زودرس چیست؟
همگرایی زودرس زمانی رخ میدهد که افراد جمعیت خیلی زود شبیه یکدیگر شوند. در این حالت الگوریتم توانایی بررسی بخشهای دیگر فضای جستوجو را از دست میدهد.
نشانههای همگرایی زودرس:
- اختلاف کم میان Fitness افراد
- تکرار زیاد کروموزومها
- ثابتماندن نتیجه برای نسلهای متوالی
- کاهش شدید تنوع ژنها
راهکارهای کاهش این مشکل:
- افزایش اندازه جمعیت
- افزایش کنترلشده نرخ جهش
- کاهش فشار انتخاب
- افزودن افراد تصادفی جدید
- محدودکردن Elitism
- استفاده از روشهای حفظ تنوع
- اجرای چندباره با Seedهای مختلف
چگونه محدودیتها را مدیریت کنیم؟
مسائل واقعی معمولاً محدودیت دارند. برای مثال:
- مجموع تخصیصها باید ۱۰۰ باشد.
- هزینه نباید از بودجه بیشتر شود.
- یک وظیفه باید قبل از وظیفه دیگر انجام شود.
- هر کاربر فقط به یک منبع تخصیص داده شود.
روشهای رایج عبارتاند از:
تابع جریمه
اگر جواب محدودیت را نقض کند، از Fitness آن کم میشود:
Fitness = Objective - Penalty
اصلاح جواب
پس از Crossover یا Mutation، جواب نامعتبر اصلاح میشود.
نمایش تضمینکننده
کروموزوم طوری طراحی میشود که اصولاً امکان ساخت جواب نامعتبر وجود نداشته باشد.
حذف جواب نامعتبر
این روش ساده است، اما اگر بخش بزرگی از فضای جستوجو نامعتبر باشد، میتواند ناکارآمد شود.
اشتباهات رایج در استفاده از الگوریتم ژنتیک
تعریف نادرست Fitness
الگوریتم دقیقاً همان چیزی را بهینه میکند که اندازهگیری کردهاید، نه هدفی را که در ذهن دارید.
مقایسهنکردن با روش سادهتر
ممکن است Random Search یا یک روش حریصانه با هزینه بسیار کمتر به جواب مشابهی برسد.
استفاده از یک اجرای تصادفی
نتیجه یک اجرا کافی نیست. الگوریتم را با چند Seed اجرا و میانگین، انحراف معیار و بهترین نتیجه را گزارش کنید.
ارزیابی روی داده آموزش
اگر Fitness روی همان نمونههایی محاسبه شود که برای انتخاب جواب استفاده شدهاند، نتیجه ممکن است به آنها بیشبرازش پیدا کند. جواب نهایی را روی مجموعه آزمایش مستقل بررسی کنید.
نادیدهگرفتن هزینه ارزیابی
در بهینهسازی مدلهای زبانی، هر فراخوانی Fitness ممکن است چند درخواست API ایجاد کند. بودجه کل را پیش از اجرا محاسبه کنید:
تعداد تقریبی ارزیابیها =
اندازه جمعیت × تعداد نسلها × نمونههای ارزیابی
انتخاب نمایش نامناسب
نمایش کروموزوم باید با ماهیت مسئله سازگار باشد. نمایش نامناسب باعث تولید تعداد زیادی جواب غیرمعتبر میشود.
Mutation بیشازحد یا بسیار کم
جهش کم تنوع را از بین میبرد و جهش بسیار زیاد اثر انتخاب و Crossover را کمرنگ میکند.
آیا الگوریتم ژنتیک همیشه انتخاب مناسبی است؟
خیر. الگوریتم ژنتیک معمولاً زمانی ارزش بررسی دارد که:
- فضای جستوجو بزرگ باشد.
- متغیرها از انواع متفاوت باشند.
- تابع هدف مشتقپذیر نباشد.
- چند هدف یا محدودیت پیچیده وجود داشته باشد.
- محاسبه جواب دقیق بسیار پرهزینه باشد.
- بتوان ارزیابیها را موازی اجرا کرد.
این الگوریتم احتمالاً انتخاب اول نیست اگر:
- مسئله راهحل تحلیلی دارد.
- فضای جستوجو بسیار کوچک است.
- هر ارزیابی فوقالعاده پرهزینه است.
- یک روش گرادیانی سریع و پایدار وجود دارد.
- محدودیت زمانی بسیار سخت است.
- به تضمین ریاضی برای جواب بهینه نیاز دارید.
چکلیست اجرای الگوریتم ژنتیک در پروژه واقعی
پیش از اجرا این پرسشها را پاسخ دهید:
- کروموزوم دقیقاً چه چیزی را نمایش میدهد؟
- هر ژن چه نوع و چه محدودهای دارد؟
- Fitness چگونه با ارزش واقعی کسبوکار مرتبط است؟
- محدودیتهای مسئله چیست؟
- هزینه هر ارزیابی چقدر است؟
- خط مبنای سادهتر چیست؟
- شرط توقف چگونه تعریف میشود؟
- چگونه تنوع جمعیت اندازهگیری خواهد شد؟
- چند اجرای مستقل انجام میشود؟
- جواب نهایی روی چه دادهای ارزیابی میشود؟
پرسشهای متداول
الگوریتم ژنتیک به زبان ساده چیست؟
الگوریتم ژنتیک روشی برای پیدا کردن جوابهای مناسب است که با مجموعهای از جوابهای اولیه شروع میکند و با انتخاب جوابهای بهتر، ترکیب آنها و ایجاد تغییرات تصادفی، نسلهای جدیدی از جوابها میسازد.
آیا الگوریتم ژنتیک نوعی یادگیری ماشین است؟
الگوریتم ژنتیک بیشتر یک روش جستوجو و بهینهسازی تکاملی محسوب میشود. این روش میتواند مستقلاً استفاده شود یا برای انتخاب ویژگی، تنظیم پارامترها و طراحی مدلهای یادگیری ماشین به کار رود.
آیا الگوریتم ژنتیک به داده آموزشی نیاز دارد؟
خود الگوریتم الزاماً به داده آموزشی نیاز ندارد، اما به تابع Fitness نیاز دارد. اگر Fitness بر اساس عملکرد یک مدل یادگیری ماشین محاسبه شود، داده آموزشی و اعتبارسنجی لازم خواهد بود.
آیا الگوریتم ژنتیک بهترین جواب را تضمین میکند؟
خیر. این الگوریتم معمولاً جواب مناسبی پیدا میکند، اما تضمینی برای پیدا کردن بهینه سراسری وجود ندارد.
بهترین زبان برای پیادهسازی الگوریتم ژنتیک چیست؟
پایتون به دلیل کتابخانههایی مانند DEAP، PyGAD، NumPy و SciPy یکی از گزینههای محبوب است. الگوریتم ژنتیک را میتوان با زبانهای JavaScript، Java، C++، C# و سایر زبانها نیز پیادهسازی کرد.
DEAP بهتر است یا PyGAD؟
PyGAD برای شروع سریع و تعریف مسئله از طریق یک کلاس آماده مناسب است. DEAP انعطاف بیشتری برای طراحی ساختار افراد، عملگرهای سفارشی و الگوریتمهای تکاملی پژوهشی ارائه میکند.
آیا میتوان الگوریتم ژنتیک را به API درواره متصل کرد؟
بله. الگوریتم ژنتیک میتواند ترکیبهای مختلف مدل، پرامپت و پارامترها را بسازد و آنها را با ارسال درخواست به API درواره ارزیابی کند. بهتر است نتیجه درخواستها Cache و هزینه کل آزمایش از قبل محدود شود.
آیا الگوریتم ژنتیک برای بهینهسازی پرامپت مناسب است؟
میتواند مناسب باشد، بهخصوص اگر اجزای پرامپت ساختار مشخصی داشته باشند. بااینحال، کیفیت Fitness و مجموعه ارزیابی نقش تعیینکننده دارند و نتیجه باید با ارزیابی انسانی نیز بررسی شود.
جمعبندی
الگوریتم ژنتیک یک روش جستوجو و بهینهسازی جمعیتمحور است که با استفاده از انتخاب، Crossover و Mutation جوابهای جدید تولید میکند. این روش برای مسائل بزرگ، غیرخطی، ناپیوسته یا ترکیبی مناسب است؛ بهویژه زمانی که روشهای کلاسیک بهینهسازی قابلاستفاده نباشند.
برای اجرای موفق الگوریتم ژنتیک باید:
- نمایش مناسبی برای کروموزوم انتخاب کنید.
- تابع Fitness را با هدف واقعی پروژه هماهنگ کنید.
- محدودیتها را در نمایش، اصلاح جواب یا تابع جریمه لحاظ کنید.
- تعادل میان انتخاب، ترکیب و جهش را حفظ کنید.
- نتیجه را با روشهای سادهتر مقایسه کنید.
- چند اجرای مستقل انجام دهید.
- جواب نهایی را روی داده آزمایش ارزیابی کنید.
- هزینه فراخوانی تابع Fitness را کنترل کنید.
در پروژههای هوش مصنوعی میتوان الگوریتم ژنتیک را برای انتخاب مدل، تنظیم پرامپت، مسیریابی چندمدلی و ایجاد تعادل میان کیفیت، هزینه و سرعت به کار برد.
برای شروع اتصال نرمافزار خود به مدلهای مختلف میتوانید به مستندات API درواره مراجعه کنید. API درواره با ساختار OpenAI سازگار است و امکان استفاده از مدلهای مختلف را با یک آدرس پایه یکپارچه فراهم میکند:
https://api.darvareh.ir/v1
مقالات مرتبط
- یادگیری ماشین چیست؟
- یادگیری نظارتشده چیست؟
- یادگیری بدون نظارت چیست؟
- یادگیری تقویتی، Q-Learning و RLHF
- ارزیابی مدل هوش مصنوعی و Evals
- مسیریابی هوشمند میان مدلهای هوش مصنوعی
- معماری چندمدلی و چندارائهدهنده
- راهنمای API سازگار با OpenAI
منابع
- DEAP Algorithms Documentation
- DEAP Evolutionary Tools
- DEAP GitHub Repository
- PyGAD Documentation
- PyGAD Module Reference
- SciPy Differential Evolution
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.