یادگیری نظارتشده چیست؟ آموزش Supervised Learning با مثال عملی پایتون
یادگیری نظارتشده یکی از اصلیترین روشهای یادگیری ماشین است که در آن مدل با استفاده از دادههای برچسبدار، رابطه میان ورودی و خروجی را یاد میگیرد.
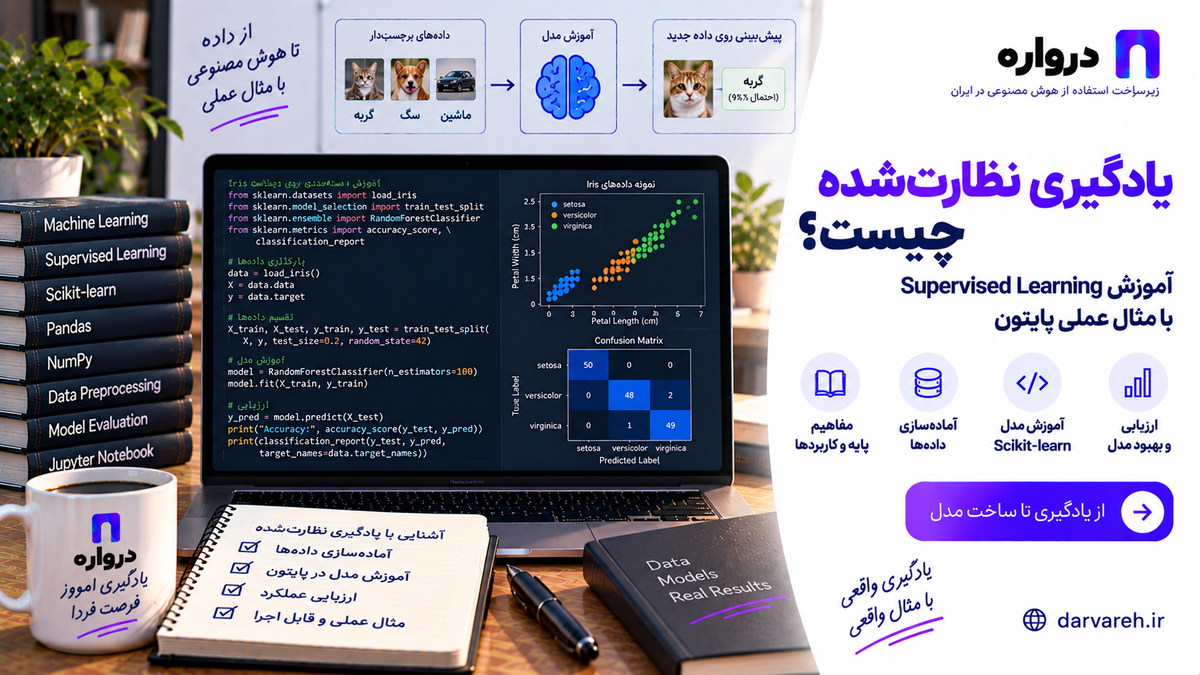
یادگیری نظارتشده یا Supervised Learning یکی از پرکاربردترین روشهای یادگیری ماشین است. در این روش، مدل با استفاده از نمونههایی آموزش میبیند که پاسخ صحیح آنها از قبل مشخص شده است.
برای مثال، اگر بخواهیم مدلی بسازیم که پیامهای مشتریان را به دستههای فروش، پرداخت و مشکل فنی تقسیم کند، باید مجموعهای از پیامهای قبلی را همراه با برچسب صحیح در اختیار مدل قرار دهیم.
مدل تلاش میکند رابطه میان ورودی و خروجی را یاد بگیرد تا بعداً بتواند برچسب پیامهای جدید را پیشبینی کند.
یادگیری نظارتشده در بسیاری از سامانههای واقعی استفاده میشود:
- تشخیص ایمیل ناخواسته
- طبقهبندی پیام مشتری
- پیشبینی قیمت مسکن
- تشخیص احساس متن
- پیشبینی فروش
- شناسایی اشیا در تصویر
- امتیازدهی سرنخهای فروش
- پیشبینی ریزش مشتری
- تبدیل گفتار به متن
- استخراج اطلاعات از اسناد
- پیشبینی زمان تحویل
- تشخیص موضوع درخواست پشتیبانی
در این مقاله، مفاهیم یادگیری نظارتشده را از پایه بررسی میکنیم، تفاوت Classification و Regression را توضیح میدهیم و یک مدل واقعی برای طبقهبندی پیامهای فارسی با Python و Scikit-learn میسازیم.
یادگیری نظارتشده چیست؟
در یادگیری نظارتشده، مدل با مجموعهای از زوجهای ورودی و خروجی آموزش داده میشود:
D={(x1,y1),(x2,y2),…,(xn,yn)}D = \{(x_1,y_1),(x_2,y_2),\dots,(x_n,y_n)\}
در این رابطه:
- xix_i ورودی یا Featureهای نمونه است.
- yiy_i پاسخ صحیح یا Target است.
- nn تعداد نمونههای آموزشی است.
هدف مدل یادگیری تابعی است که ورودی را به خروجی نگاشت کند:
f(x)≈yf(x) \approx y
پس از آموزش، مدل برای یک ورودی جدید مانند xnewx_{new}، خروجی زیر را پیشبینی میکند:
y^=f(xnew)\hat{y}=f(x_{new})
علامت y^\hat{y} نشاندهنده مقدار پیشبینیشده است و ممکن است با مقدار واقعی yy تفاوت داشته باشد.
چرا به آن یادگیری «نظارتشده» میگویند؟
منظور از نظارت این نیست که یک انسان در تمام لحظات اجرای مدل حضور دارد. نظارت از طریق برچسبهای موجود در داده آموزشی انجام میشود.
مدل میتواند پیشبینی خود را با پاسخ صحیح مقایسه کند، مقدار خطا را به دست آورد و پارامترهایش را برای کاهش خطا تغییر دهد.
فرایند ساده آموزش:
- مدل یک ورودی دریافت میکند.
- خروجی را پیشبینی میکند.
- پیشبینی با پاسخ صحیح مقایسه میشود.
- مقدار خطا محاسبه میشود.
- پارامترهای مدل اصلاح میشوند.
- فرایند روی نمونههای بیشتر تکرار میشود.
مثال ساده از یادگیری نظارتشده
فرض کنید دیتاست زیر را داریم:
| متن پیام | برچسب |
|---|---|
| مبلغ از حسابم کم شد ولی کیف پول شارژ نشد | پرداخت |
| برای اتصال API نمونه کد میخواهم | فنی |
| برای خرید سازمانی با چه کسی صحبت کنم؟ | فروش |
| پاسخ API خطای 429 میدهد | فنی |
| امکان دریافت فاکتور وجود دارد؟ | پرداخت |
مدل با مشاهده این نمونهها یاد میگیرد کدام واژهها و الگوها با هر دسته ارتباط دارند.
وقتی پیام جدید زیر وارد شود:
کلید API من کار نمیکند.
مدل میتواند آن را در دسته «فنی» قرار دهد.
تفاوت Feature، Label و Target
Feature
Feature اطلاعاتی است که مدل برای پیشبینی استفاده میکند.
در پیشبینی قیمت مسکن، Featureها ممکن است شامل این موارد باشند:
- متراژ
- محله
- تعداد اتاق
- سن ساختمان
- طبقه
- پارکینگ
Label
Label معمولاً به خروجی دستهای در مسائل Classification گفته میشود؛ مانند:
- مثبت
- منفی
- خنثی
Target
Target اصطلاح عمومیتری برای خروجی موردانتظار است و میتواند دسته یا مقدار عددی باشد.
انواع اصلی یادگیری نظارتشده
یادگیری نظارتشده معمولاً به دو گروه اصلی تقسیم میشود:
- Classification یا طبقهبندی
- Regression یا رگرسیون
Classification چیست؟
در Classification، خروجی یکی از چند دسته مشخص است.
نمونهها:
- ایمیل سالم یا Spam
- نظر مثبت، منفی یا خنثی
- پرداخت، فروش یا پشتیبانی فنی
- تصویر گربه یا سگ
- تراکنش عادی یا مشکوک
- کاربر فعال یا در معرض ریزش
Binary Classification
خروجی فقط دو کلاس دارد:
- بله یا خیر
- مثبت یا منفی
- سالم یا معیوب
Multiclass Classification
خروجی یکی از چند کلاس است:
- فروش
- پرداخت
- فنی
- بازخورد
- سایر
Multilabel Classification
هر نمونه میتواند همزمان چند برچسب داشته باشد.
برای مثال، یک تیکت ممکن است همزمان این برچسبها را داشته باشد:
- مشکل فنی
- پرداخت
- اولویت بالا
Multiclass و Multilabel یکسان نیستند. در Multiclass معمولاً یک کلاس انتخاب میشود، اما در Multilabel چند برچسب میتوانند همزمان فعال باشند.
Regression چیست؟
در Regression، خروجی یک مقدار عددی پیوسته است.
نمونهها:
- قیمت خانه
- میزان فروش ماه آینده
- زمان تحویل سفارش
- مصرف انرژی
- دمای فردا
- ارزش طول عمر مشتری
- تعداد درخواستهای آینده
برای مثال:
قیمت خانه=f(متراژ,محله,سن,تعداد اتاق)\text{قیمت خانه} = f( \text{متراژ}, \text{محله}, \text{سن}, \text{تعداد اتاق} )
تفاوت Classification و Regression
| ویژگی | Classification | Regression |
|---|---|---|
| نوع خروجی | دسته | مقدار عددی |
| مثال | تشخیص موضوع پیام | پیشبینی زمان پاسخ |
| خروجی نمونه | technical | 12.5 دقیقه |
| معیارها | Precision، Recall و F1 | MAE، RMSE و R² |
| مدل پایه | Logistic Regression | Linear Regression |
| تصمیم نهایی | انتخاب کلاس | تخمین مقدار |
با وجود نام مشابه، Logistic Regression معمولاً یک الگوریتم طبقهبندی است، نه الگوریتم پیشبینی مقدار پیوسته.
الگوریتمهای مهم یادگیری نظارتشده
Linear Regression
یکی از سادهترین الگوریتمهای رگرسیون است. مدل رابطه خطی میان Featureها و Target را یاد میگیرد:
y^=w1x1+w2x2+⋯+wnxn+b\hat{y} = w_1x_1+ w_2x_2+ \dots+ w_nx_n+b
مزایا:
- ساده
- سریع
- قابلتفسیر
- مناسب بهعنوان Baseline
محدودیت:
- رابطههای غیرخطی پیچیده را بهخوبی مدل نمیکند.
- به داده پرت و همبستگی میان Featureها حساس است.
Logistic Regression
برای طبقهبندی استفاده میشود و احتمال تعلق نمونه به کلاس را تخمین میزند.
برای طبقهبندی دودویی معمولاً از تابع Sigmoid استفاده میشود:
P(y=1∣x)=11+e−zP(y=1\mid x) = \frac{1} {1+e^{-z}}
Logistic Regression برای متن، داده Sparse و بسیاری از Baselineهای تجاری بسیار مفید است.
Decision Tree
درخت تصمیم با مجموعهای از سؤالها داده را تقسیم میکند.
نمونه:
آیا مبلغ پرداخت شده؟
├─ بله: آیا اعتبار اضافه شده؟
│ ├─ خیر: مشکل پرداخت
│ └─ بله: بدون مشکل
└─ خیر: بررسی دستههای دیگر
مزایا:
- قابلتفسیر
- پشتیبانی از رابطههای غیرخطی
- نیاز کمتر به Scaling
محدودیت:
- ممکن است روی داده آموزشی Overfit شود.
- تغییر کوچک داده ممکن است ساختار درخت را تغییر دهد.
Random Forest
Random Forest مجموعهای از درختهای تصمیم است. هر درخت روی بخشی از داده و Featureها آموزش میبیند و خروجی نهایی از ترکیب آنها به دست میآید.
مزایا:
- عملکرد مناسب روی داده جدولی
- مقاومت بیشتر در برابر Overfitting نسبت به یک درخت
- امکان تخمین اهمیت Featureها
محدودیت:
- از یک درخت منفرد کمتر قابلتفسیر است.
- اندازه و زمان اجرای مدل بیشتر است.
Gradient Boosting
در Boosting، مدلها بهترتیب ساخته میشوند و هر مدل تلاش میکند خطاهای قبلی را اصلاح کند.
ابزارهای رایج:
- XGBoost
- LightGBM
- CatBoost
این خانواده در بسیاری از مسائل داده جدولی عملکرد قدرتمندی دارد.
Support Vector Machine
SVM مرزی را پیدا میکند که کلاسها را با حاشیه مناسب جدا کند.
مزایا:
- مناسب برای داده با ابعاد زیاد
- مؤثر روی بعضی دیتاستهای کوچک و متوسط
- پشتیبانی از Kernel برای مرز غیرخطی
محدودیت:
- آموزش روی دیتاست بسیار بزرگ میتواند پرهزینه باشد.
- تنظیم پارامترها اهمیت زیادی دارد.
- احتمال خروجی همیشه بهصورت طبیعی کالیبره نیست.
K-Nearest Neighbors
KNN بر اساس نزدیکترین نمونههای آموزشی تصمیم میگیرد.
مزایا:
- ساده
- بدون فرایند آموزش پیچیده
- مناسب برای آزمایش اولیه
محدودیت:
- پیشبینی روی دیتاست بزرگ کند میشود.
- به Scaling و انتخاب فاصله حساس است.
- در ابعاد بالا با مشکل مواجه میشود.
Naive Bayes
بر اساس قضیه بیز و فرض استقلال شرطی Featureها کار میکند.
این الگوریتم برای بعضی مسائل طبقهبندی متن سریع و مؤثر است.
Neural Network
شبکه عصبی میتواند رابطههای پیچیده و غیرخطی را یاد بگیرد و در متن، تصویر، صوت و دادههای چندوجهی استفاده شود.
شبکه عصبی معمولاً به داده و توان محاسباتی بیشتری نیاز دارد و همیشه بهترین انتخاب برای داده جدولی کوچک نیست.
چگونه الگوریتم مناسب را انتخاب کنیم؟
انتخاب الگوریتم به این عوامل وابسته است:
- تعداد نمونهها
- تعداد Featureها
- نوع داده
- میزان داده گمشده
- نیاز به تفسیر
- محدودیت زمان پاسخ
- نامتوازنبودن کلاسها
- خطی یا غیرخطیبودن رابطه
- محدودیت حافظه
- معیار کسبوکار
یک راه عملی:
- Baseline ساده بسازید.
- Pipeline ارزیابی ثابت تعریف کنید.
- چند مدل را روی Splitهای یکسان مقایسه کنید.
- کیفیت، سرعت و پیچیدگی را با هم بسنجید.
- مدل سادهتر را در صورت عملکرد مشابه ترجیح دهید.
مراحل اجرای پروژه Supervised Learning
مرحله اول: تعریف مسئله
مشخص کنید خروجی دقیقاً چیست.
هدف مبهم:
میخواهیم پیامهای مشتری را تحلیل کنیم.
هدف دقیق:
میخواهیم موضوع هر پیام را در یکی از پنج دسته پیشبینی کنیم و پیامهای دارای اطمینان پایین را برای بررسی بیشتر ارسال کنیم.
مرحله دوم: ساخت دیتاست برچسبدار
هر نمونه باید ورودی و پاسخ صحیح داشته باشد.
مرحله سوم: تحلیل داده
موارد زیر را بررسی کنید:
- تعداد نمونه
- توزیع کلاس
- داده خالی
- نمونه تکراری
- داده پرت
- طول ورودی
- تعارض برچسب
- تغییر داده در زمان
مرحله چهارم: تقسیم داده
داده را به بخشهای زیر تقسیم کنید:
- Train
- Validation
- Test
مرحله پنجم: پیشپردازش
بسته به داده:
- Scaling
- Encoding
- پاکسازی متن
- ساخت Feature
- مدیریت مقدار گمشده
- تبدیل متن به بردار
مرحله ششم: آموزش Baseline
مدل سادهای بسازید تا حداقل کیفیت قابلدستیابی مشخص شود.
مرحله هفتم: ارزیابی
معیار مناسب را انتخاب و خطاها را تحلیل کنید.
مرحله هشتم: تنظیم مدل
Hyperparameterها را فقط با Train و Validation تنظیم کنید.
مرحله نهم: ارزیابی نهایی
پس از نهاییشدن تصمیمها، فقط یک ارزیابی نهایی روی Test انجام دهید.
مرحله دهم: استقرار و پایش
کیفیت داده و مدل پس از انتشار نیز باید بررسی شود.
تقسیم Train، Validation و Test
Train Set
برای یادگیری پارامترهای مدل استفاده میشود.
Validation Set
برای انتخاب مدل، تنظیم Hyperparameter، انتخاب Threshold و طراحی Feature استفاده میشود.
Test Set
برای ارزیابی نهایی مدل روی داده دیدهنشده استفاده میشود.
آزمایش مدل روی همان داده آموزشی یک خطای روششناختی است؛ زیرا مدل میتواند نمونهها را حفظ کند و در داده جدید عملکرد مناسبی نداشته باشد. مستندات Scikit-learn توصیه میکند بخشی از داده بهعنوان Test Set مستقل نگهداری شود.
Cross-validation چیست؟
در K-Fold Cross-validation، داده به KK بخش تقسیم میشود.
در هر مرحله:
- یک Fold برای ارزیابی استفاده میشود.
- Foldهای دیگر برای آموزش استفاده میشوند.
- این فرایند KK بار تکرار میشود.
برای مثال، در Cross-validation پنجمرحلهای:
K=5K=5
مدل پنج بار آموزش میبیند و هر بار یک بخش متفاوت نقش Validation را دارد.
مزایا:
- استفاده بهتر از داده محدود
- تخمین پایدارتر عملکرد
- مقایسه منصفانهتر مدلها
اما Cross-validation معمولی برای همه دادهها مناسب نیست.
داده زمانی
نباید آینده برای پیشبینی گذشته وارد آموزش شود.
داده گروهی
اگر چند رکورد متعلق به یک کاربر، بیمار، دستگاه، محصول یا مکالمه هستند، گروه باید در یک Fold باقی بماند.
داده نامتوازن
از StratifiedKFold میتوان برای حفظ تقریبی توزیع کلاسها استفاده کرد.
Data Leakage چیست؟
Data Leakage زمانی رخ میدهد که اطلاعات Test یا آینده به فرایند آموزش وارد شود.
نمونهها:
- محاسبه Scaling با کل دیتاست
- انتخاب Feature با استفاده از Test
- وجود رکورد تکراری در Train و Test
- تقسیم پیامهای یک مکالمه میان چند Split
- استفاده از اطلاعاتی که هنگام پیشبینی واقعی وجود ندارد
- تنظیم مکرر مدل بر اساس نتیجه Test
Scikit-learn استفاده از Pipeline را یکی از روشهای جلوگیری از Leakage در پیشپردازش معرفی میکند، زیرا هر Transformer فقط روی بخش آموزشی Fit میشود.
Overfitting و Underfitting
Underfitting
مدل بیشازحد ساده است و حتی الگوی داده آموزشی را بهخوبی یاد نمیگیرد.
نشانه:
- خطای زیاد روی Train
- خطای زیاد روی Validation
Overfitting
مدل داده آموزشی را بیشازحد یاد گرفته اما روی نمونههای جدید ضعیف است.
نشانه:
- عملکرد بسیار خوب روی Train
- عملکرد ضعیفتر روی Validation و Test
راهکارهای قابل بررسی:
- جمعآوری داده بیشتر
- کاهش پیچیدگی مدل
- Regularization
- حذف Featureهای نامناسب
- Cross-validation
- Early Stopping
- Data Augmentation
- کنترل Leakage
تابع زیان چیست؟
Loss Function اختلاف پیشبینی مدل و مقدار واقعی را اندازهگیری میکند.
Mean Squared Error
برای رگرسیون:
MSE=1n∑i=1n(yi−y^i)2MSE = \frac{1}{n} \sum_{i=1}^{n} (y_i-\hat{y}_i)^2
Binary Cross-Entropy
برای طبقهبندی دودویی:
L=−[ylog(p)+(1−y)log(1−p)]L = - \left[ y\log(p) + (1-y)\log(1-p) \right]
مدل در فرایند آموزش تلاش میکند مقدار Loss را کاهش دهد.
Loss آموزشی الزاماً همان معیار نهایی کسبوکار نیست. ممکن است مدل با Cross-Entropy آموزش ببیند، اما با Recall یا هزینه خطای تجاری انتخاب شود.
معیارهای ارزیابی Classification
Confusion Matrix
برای طبقهبندی دودویی:
| پیشبینی مثبت | پیشبینی منفی | |
|---|---|---|
| واقعاً مثبت | TP | FN |
| واقعاً منفی | FP | TN |
Accuracy
Accuracy=TP+TNTP+TN+FP+FNAccuracy = \frac{TP+TN} {TP+TN+FP+FN}
Accuracy در داده نامتوازن میتواند گمراهکننده باشد.
اگر ۹۹ درصد تراکنشها عادی باشند، مدلی که همه را عادی اعلام کند Accuracy برابر ۹۹ درصد خواهد داشت، اما هیچ مورد غیرعادی را پیدا نمیکند.
Precision
Precision=TPTP+FPPrecision = \frac{TP} {TP+FP}
از میان مواردی که مدل مثبت اعلام کرده، چند مورد واقعاً مثبتاند؟
Precision زمانی مهم است که False Positive پرهزینه باشد.
Recall
Recall=TPTP+FNRecall = \frac{TP} {TP+FN}
از میان تمام موارد مثبت واقعی، چند مورد پیدا شدهاند؟
Recall زمانی مهم است که ازدستدادن مورد مثبت پرهزینه باشد.
F1-score
F1=2×Precision×RecallPrecision+RecallF1 = 2 \times \frac{Precision \times Recall} {Precision+Recall}
F1 میانگین هارمونیک Precision و Recall است. مستندات Scikit-learn نیز F1 را میانگین هارمونیک این دو معیار تعریف میکند.
Specificity
Specificity=TNTN+FPSpecificity = \frac{TN} {TN+FP}
نشان میدهد چه سهمی از موارد منفی واقعی درست تشخیص داده شدهاند.
ROC-AUC
توان مدل در رتبهبندی نمونه مثبت بالاتر از نمونه منفی را در Thresholdهای مختلف بررسی میکند.
PR-AUC
منحنی Precision-Recall در مسائل نامتوازن معمولاً اطلاعات مفیدی ارائه میکند، زیرا مستقیماً بر عملکرد کلاس مثبت تمرکز دارد.
Macro، Micro و Weighted F1
در طبقهبندی چندکلاسه، F1 میتواند به شکلهای مختلف محاسبه شود.
Macro F1
F1 هر کلاس جداگانه محاسبه و بدون توجه به تعداد نمونهها میانگین گرفته میشود.
برای بررسی عملکرد کلاسهای کمنمونه مفید است.
Weighted F1
F1 هر کلاس بر اساس تعداد نمونههای آن وزن میگیرد.
ممکن است ضعف کلاس کوچک را پنهان کند.
Micro F1
تمام TP، FP و FN کلاسها با هم تجمیع میشوند و سپس F1 محاسبه میشود.
کتابخانه Scikit-learn ابزارهایی مانند classification_report و precision_recall_fscore_support را برای محاسبه معیارهای هر کلاس ارائه میکند.
معیارهای ارزیابی Regression
MAE
MAE=1n∑i=1n∣yi−y^i∣MAE = \frac{1}{n} \sum_{i=1}^{n} |y_i-\hat{y}_i|
تفسیر آن ساده است و نسبت به MSE حساسیت کمتری به خطاهای بسیار بزرگ دارد.
MSE
MSE=1n∑i=1n(yi−y^i)2MSE = \frac{1}{n} \sum_{i=1}^{n} (y_i-\hat{y}_i)^2
خطاهای بزرگ را بیشتر جریمه میکند.
RMSE
RMSE=MSERMSE = \sqrt{MSE}
واحد آن با Target یکسان است.
R²
R2=1−∑(yi−y^i)2∑(yi−yˉ)2R^2 = 1- \frac{ \sum(y_i-\hat{y}_i)^2 }{ \sum(y_i-\bar{y})^2 }
R² نشان میدهد مدل چه میزان از تغییرات Target را نسبت به Baseline میانگین توضیح میدهد. مقدار منفی نیز ممکن است رخ دهد.
پروژه عملی: طبقهبندی پیامهای فارسی
میخواهیم مدلی بسازیم که پیامهای کاربران را در دستههای زیر قرار دهد:
salesbillingtechnicalproduct_feedbackother
نصب کتابخانهها
pip install pandas scikit-learn joblib
ساختار دیتاست
فایل support_messages.csv:
text,label
مبلغ از حسابم کم شد ولی اعتبار اضافه نشد,billing
فاکتور خرید را از کجا دانلود کنم,billing
برای اتصال پایتون نمونه کد میخواهم,technical
API خطای 429 میدهد,technical
برای خرید سازمانی تخفیف دارید,sales
چطور قرارداد شرکتی ببندیم,sales
لطفا مدل جدید تولید تصویر اضافه کنید,product_feedback
امکان خروجی اکسل اضافه کنید,product_feedback
سلام وقت بخیر,other
ممنون از راهنمایی شما,other
این فایل فقط ساختار را نشان میدهد. برای آموزش قابلاعتماد باید نمونههای واقعی و متنوع بیشتری جمعآوری شود.
خواندن و بررسی داده
import pandas as pd


df = pd.read_csv(
    "support_messages.csv"
)

print(df.head())
print(df.info())
print(df["label"].value_counts())
پاکسازی متن فارسی
import re
import unicodedata


def normalize_persian_text(
    text: str,
) -> str:
    text = unicodedata.normalize(
        "NFKC",
        str(text),
    )

    replacements = {
        "ي": "ی",
        "ى": "ی",
        "ك": "ک",
        "ۀ": "ه",
    }

    for source, target in replacements.items():
        text = text.replace(
            source,
            target,
        )

    text = re.sub(
        r"\s+",
        " ",
        text,
    )

    return text.strip()


df["normalized_text"] = df["text"].map(
    normalize_persian_text
)

df = df[
    df["normalized_text"].str.len() > 2
].copy()
پاکسازی بیشازحد میتواند اطلاعات مفیدی مانند نشانهگذاری، شکل محاورهای یا نیمفاصله را حذف کند. هر تغییر باید با ارزیابی آزمایش شود.
بررسی داده تکراری و تعارض برچسب
duplicates = df[
    df.duplicated(
        subset=["normalized_text"],
        keep=False,
    )
].sort_values("normalized_text")

print(duplicates)
برای شناسایی متنهایی که چند برچسب متفاوت دارند:
conflicts = (
    df.groupby("normalized_text")["label"]
    .nunique()
    .loc[lambda values: values > 1]
)

print(conflicts)
تعارض میتواند ناشی از برچسبگذاری اشتباه یا مبهمبودن تعریف کلاسها باشد.
تقسیم Train و Test
from sklearn.model_selection import (
    train_test_split,
)


X_train, X_test, y_train, y_test = (
    train_test_split(
        df["normalized_text"],
        df["label"],
        test_size=0.20,
        random_state=42,
        stratify=df["label"],
    )
)
استفاده از stratify توزیع تقریبی کلاسها را حفظ میکند. برای مکالمات چندپیامی باید بهجای تقسیم ردیف، بر اساس شناسه مکالمه تقسیم شود.
ساخت Pipeline
در این پروژه از دو بخش استفاده میکنیم:
- تبدیل متن به بردار TF-IDF
- طبقهبندی با Logistic Regression
from sklearn.feature_extraction.text import (
    TfidfVectorizer,
)
from sklearn.linear_model import (
    LogisticRegression,
)
from sklearn.pipeline import Pipeline


model = Pipeline(
    steps=[
        (
            "tfidf",
            TfidfVectorizer(
                analyzer="char_wb",
                ngram_range=(3, 5),
                min_df=2,
                max_df=0.98,
                max_features=80_000,
                sublinear_tf=True,
            ),
        ),
        (
            "classifier",
            LogisticRegression(
                max_iter=1500,
                class_weight="balanced",
                random_state=42,
            ),
        ),
    ]
)

model.fit(
    X_train,
    y_train,
)
استفاده از Character N-gram میتواند برای زبان فارسی، تفاوت شکل نوشتاری و بخشی از خطاهای تایپی مفید باشد.
ارزیابی مدل
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
)


predictions = model.predict(
    X_test
)

print(
    classification_report(
        y_test,
        predictions,
        digits=3,
        zero_division=0,
    )
)

print(
    confusion_matrix(
        y_test,
        predictions,
        labels=model.classes_,
    )
)

print(
    "Class order:",
    model.classes_,
)
بهجای تمرکز صرف بر Accuracy، معیار هر کلاس و خطاهای متداول را بررسی کنید.
Cross-validation
from sklearn.model_selection import (
    StratifiedKFold,
    cross_validate,
)


cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

scores = cross_validate(
    model,
    df["normalized_text"],
    df["label"],
    cv=cv,
    scoring={
        "accuracy": "accuracy",
        "macro_f1": "f1_macro",
        "weighted_f1": "f1_weighted",
    },
    return_train_score=False,
)

print(
    "Mean accuracy:",
    scores["test_accuracy"].mean(),
)

print(
    "Mean macro F1:",
    scores["test_macro_f1"].mean(),
)

print(
    "Mean weighted F1:",
    scores["test_weighted_f1"].mean(),
)
اگر Macro F1 بسیار کمتر از Weighted F1 باشد، مدل احتمالاً روی بعضی کلاسهای کوچک عملکرد ضعیفی دارد.
پیشبینی پیام جدید
messages = [
"پول پرداخت کردم ولی کیف پول خالی است",
"برای اتصال Node.js مستندات دارید؟",
"میخواهم سرویس را برای شرکت خریداری کنم",
]
normalized_messages = [
normalize_persian_text(message)
for message in messages
]
predicted_labels = model.predict(
normalized_messages
)
predicted_probabilities = (
model.predict_proba(
normalized_messages
)
)
for message, label, probabilities in zip(
messages,
predicted_labels,
predicted_probabilities,
):
confidence = float(
probabilities.max()
)
print(
{
"message": message,
"label": label,
"confidence": round(
confidence,
3,
),
}
)
Confidence و Threshold
خروجی predict_proba همیشه معادل اطمینان واقعی نیست. ممکن است مدل بیشازحد مطمئن یا بیشازحد محتاط باشد.
برای یک طبقهبند خوبکالیبرهشده، از میان نمونههایی که احتمال حدود ۰٫۸ دریافت میکنند، انتظار میرود تقریباً ۸۰ درصد واقعاً متعلق به آن کلاس باشند. مستندات Scikit-learn همین مفهوم را برای Probability Calibration توضیح میدهد.
میتوان برای پیامهای نامطمئن یک Threshold تعریف کرد:
def classify_with_threshold(
    text: str,
    threshold: float = 0.70,
) -> dict:
    normalized = normalize_persian_text(
        text
    )

    probabilities = model.predict_proba(
        [normalized]
    )[0]

    best_index = int(
        probabilities.argmax()
    )

    label = model.classes_[best_index]
    confidence = float(
        probabilities[best_index]
    )

    if confidence < threshold:
        return {
            "label": "needs_review",
            "suggested_label": label,
            "confidence": confidence,
        }

    return {
        "label": label,
        "confidence": confidence,
    }
Threshold باید بر اساس هزینه خطا و داده Validation انتخاب شود، نه یک عدد دلخواه ثابت.
ذخیره مدل
import joblib


joblib.dump(
    model,
    "persian_support_classifier.joblib",
)
بارگذاری مدل:
loaded_model = joblib.load(
"persian_support_classifier.joblib"
)
result = loaded_model.predict(
["API خطای اتصال میدهد"]
)
print(result[0])
معماری ترکیبی مدل کلاسیک و مدل زبانی
در بسیاری از محصولات، لازم نیست همه ورودیها مستقیماً به مدل زبانی ارسال شوند.
میتوان از یک معماری ترکیبی استفاده کرد:
پیام کاربر
↓
مدل طبقهبندی محلی
↓
آیا Confidence کافی است؟
├─ بله → استفاده از برچسب محلی
└─ خیر → ارسال به مدل زبانی
↓
اعتبارسنجی خروجی
↓
ثبت برای بازبینی
مزایای این روش:
- کاهش هزینه
- پاسخ سریع برای پیامهای ساده
- کنترل بیشتر روی کلاسهای شناختهشده
- استفاده از مدل قویتر برای موارد مبهم
- جمعآوری نمونههای جدید برای آموزش بعدی
استفاده از API درواره برای موارد مبهم
آدرس پایه API درواره:
https://api.darvareh.ir/v1
نصب:
pip install openai pydantic
تنظیم متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
کد:
import os
from typing import Literal
from openai import OpenAI
from pydantic import BaseModel, Field
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
MODEL_ID = os.environ["DARVAREH_MODEL"]
class LLMClassification(BaseModel):
label: Literal[
"sales",
"billing",
"technical",
"product_feedback",
"other",
]
confidence: float = Field(
ge=0,
le=1,
)
reason: str
def classify_with_llm(
message: str,
) -> LLMClassification:
prompt = f"""
پیام مشتری را در یکی از دستههای زیر قرار بده:
- sales: قیمت، خرید و قرارداد
- billing: پرداخت، کیف پول و فاکتور
- technical: API، کد و خطای فنی
- product_feedback: درخواست قابلیت و بازخورد
- other: سایر موارد
پاسخ فقط JSON معتبر باشد:
{{
"label": "technical",
"confidence": 0.9,
"reason": "دلیل کوتاه"
}}
پیام:
{message}
"""
response = client.chat.completions.create(
model=MODEL_ID,
temperature=0,
messages=[
{
"role": "system",
"content": (
"شما طبقهبند پیامهای "
"پشتیبانی فارسی هستید."
),
},
{
"role": "user",
"content": prompt,
},
],
)
content = response.choices[0].message.content
if not content:
raise ValueError(
"مدل پاسخی برنگرداند."
)
return (
LLMClassification
.model_validate_json(content)
)
ترکیب طبقهبند محلی با API
def hybrid_classify(
    message: str,
    local_threshold: float = 0.75,
) -> dict:
    local_result = (
        classify_with_threshold(
            message,
            threshold=local_threshold,
        )
    )

    if (
        local_result["label"]
        != "needs_review"
    ):
        return {
            "source": "local_model",
            **local_result,
        }

    llm_result = classify_with_llm(
        message
    )

    return {
        "source": "llm_fallback",
        "local_suggestion": (
            local_result[
                "suggested_label"
            ]
        ),
        "local_confidence": (
            local_result["confidence"]
        ),
        **llm_result.model_dump(),
    }
این معماری کمک میکند پیامهای ساده با مدل محلی پردازش و موارد دشوار با یک مدل زبانی قویتر بررسی شوند.
خروجی مدل زبانی نیز باید اعتبارسنجی و عملکرد آن روی دیتاست مرجع اندازهگیری شود.
آیا مدل زبانی جای Supervised Learning را میگیرد؟
خیر؛ این دو رویکرد جایگزین کامل یکدیگر نیستند.
مدل کلاسیک مناسبتر است اگر:
- کلاسها ثابت و مشخصاند.
- داده برچسبدار کافی دارید.
- تأخیر پایین اهمیت دارد.
- حجم درخواست زیاد است.
- تصمیم باید تکرارپذیر باشد.
- مدل کوچک کیفیت کافی دارد.
مدل زبانی مناسبتر است اگر:
- دستورها مرتب تغییر میکنند.
- کلاسها توضیحات پیچیده دارند.
- داده آموزشی محدود است.
- ورودی نیازمند درک متنی عمیق است.
- چند وظیفه در یک درخواست انجام میشود.
- Zero-shot یا Few-shot اهمیت دارد.
معماری ترکیبی مناسب است اگر:
- حجم بالایی از ورودی ساده دارید.
- بخشی از نمونهها مبهماند.
- هزینه و کیفیت هر دو اهمیت دارند.
- میخواهید از داده واقعی برای بهبود مدل محلی استفاده کنید.
کلاسهای نامتوازن
فرض کنید توزیع داده چنین باشد:
| کلاس | تعداد |
|---|---|
| فنی | ۸۰۰۰ |
| پرداخت | ۳۰۰۰ |
| فروش | ۱۵۰۰ |
| بازخورد | ۳۰۰ |
| سایر | ۱۲۰۰ |
مدل ممکن است کلاس «بازخورد» را نادیده بگیرد.
راهکارها:
- جمعآوری داده بیشتر
- استفاده از
class_weight - Oversampling
- Undersampling
- ساخت Feature بهتر
- تنظیم Threshold هر کلاس
- ارزیابی Macro F1
- بررسی Confusion Matrix
- استفاده از داده مصنوعی کنترلشده
Test Set باید تا حد امکان توزیع واقعی محیط را نمایش دهد.
Feature Engineering چیست؟
Feature Engineering فرایند ساخت اطلاعات مفیدتر از داده خام است.
برای داده جدولی:
- نسبت دو مقدار
- زمان گذشته از آخرین خرید
- تعداد سفارش ماهانه
- میانگین مبلغ
- فصل یا روز هفته
برای متن:
- Word N-gram
- Character N-gram
- TF-IDF
- طول پیام
- وجود کلمه کلیدی
- Embedding
برای زمان:
- روند
- میانگین متحرک
- Lag
- فصل
- تعطیلات
Feature باید هنگام پیشبینی واقعی نیز در دسترس باشد. استفاده از Feature مربوط به آینده باعث Leakage میشود.
Hyperparameter چیست؟
پارامترهایی که قبل از آموزش تعیین میشوند Hyperparameter نام دارند.
نمونهها:
- عمق درخت
- تعداد درختها
- نرخ یادگیری
- مقدار Regularization
- تعداد همسایهها
- نوع Kernel
- اندازه N-gram
برای جستوجوی Hyperparameter میتوان از این روشها استفاده کرد:
- Grid Search
- Random Search
- Bayesian Optimization
جستوجو باید داخل Cross-validation و بدون استفاده از Test Set انجام شود.
پایش مدل پس از استقرار
عملکرد مدل ممکن است با تغییر داده کاهش پیدا کند.
معیارهای مناسب برای پایش:
- توزیع کلاسهای پیشبینیشده
- Confidence
- نرخ ارجاع به مدل زبانی
- نرخ بازبینی انسانی
- تأخیر پاسخ
- نرخ خطا
- حجم درخواست
- تغییر واژگان
- کیفیت روی نمونههای برچسبخورده جدید
- هزینه هر پیشبینی
Data Drift و Concept Drift
Data Drift
توزیع ورودی تغییر میکند.
برای مثال کاربران از اصطلاحات جدید یا نام مدلهای تازه استفاده میکنند.
Concept Drift
رابطه میان ورودی و خروجی تغییر میکند.
برای مثال، پیامی که قبلاً در دسته فروش قرار میگرفت پس از تغییر فرایند سازمان باید در دسته پشتیبانی قرار گیرد.
در صورت Drift ممکن است به این اقدامات نیاز باشد:
- جمعآوری داده جدید
- بازبینی برچسبها
- آموزش مجدد
- تنظیم Threshold
- تعریف کلاس جدید
- تغییر Feature
- بهروزرسانی Prompt مدل Fallback
اشتباهات رایج در Supervised Learning
آموزش و ارزیابی روی یک داده
این کار عملکرد واقعی مدل را نشان نمیدهد.
استفاده از Accuracy برای داده نامتوازن
ممکن است مدل کلاس مهم اما کوچک را کاملاً نادیده بگیرد.
پیشپردازش قبل از Split
این کار میتواند اطلاعات Test را وارد آموزش کند.
وجود داده تکراری در Splitها
نمونههای تکراری نتیجه ارزیابی را غیرواقعی میکنند.
تنظیم مدل روی Test
Test باید تا پایان توسعه مستقل باقی بماند.
نادیدهگرفتن هزینه خطا
False Positive و False Negative معمولاً هزینه یکسانی ندارند.
استفاده از الگوریتم پیچیده بدون Baseline
ممکن است مدل سادهتر همان کیفیت را با هزینه کمتر ارائه کند.
اعتماد مستقیم به Probability
احتمال خروجی ممکن است نیازمند Calibration باشد.
نداشتن نسخه مدل و دیتاست
بدون نسخهبندی نمیتوان نتیجه را بازتولید کرد.
چه زمانی یادگیری نظارتشده مناسب است؟
Supervised Learning معمولاً زمانی انتخاب مناسبی است که:
- خروجی مطلوب مشخص است.
- نمونه برچسبدار وجود دارد.
- معیار موفقیت قابلاندازهگیری است.
- داده گذشته نماینده آینده است.
- مسئله Classification یا Regression است.
- پیشبینی روی داده جدید انجام میشود.
در مقابل، اگر برچسب ندارید و هدف کشف ساختار پنهان داده است، یادگیری بدون نظارت ممکن است مناسبتر باشد.
اگر تصمیمها متوالیاند و اقدام فعلی روی آینده اثر میگذارد، یادگیری تقویتی میتواند بررسی شود.
پرسشهای متداول
یادگیری نظارتشده چیست؟
روشی در یادگیری ماشین است که مدل با استفاده از ورودیها و پاسخهای صحیح، رابطه میان آنها را یاد میگیرد.
Supervised Learning چه کاربردی دارد؟
برای طبقهبندی، پیشبینی مقدار، تشخیص تصویر، تحلیل متن، پیشبینی فروش و بسیاری از مسائل دیگر استفاده میشود.
مهمترین انواع یادگیری نظارتشده چیست؟
Classification و Regression دو نوع اصلی آن هستند.
تفاوت Classification و Regression چیست؟
Classification یک دسته را پیشبینی میکند، اما Regression مقدار عددی پیوسته را تخمین میزند.
آیا Logistic Regression برای Regression است؟
با وجود نام آن، Logistic Regression معمولاً برای Classification استفاده میشود.
Label چیست؟
پاسخ صحیح یا دسته مشخصشده برای یک نمونه آموزشی است.
آیا یادگیری نظارتشده به دیتاست نیاز دارد؟
بله، به نمونههای دارای ورودی و Target نیاز دارد.
بهترین الگوریتم Supervised Learning چیست؟
الگوریتم واحدی برای همه مسائل بهترین نیست. انتخاب باید با ارزیابی روی داده واقعی انجام شود.
Accuracy بهتر است یا F1؟
به مسئله بستگی دارد. برای داده نامتوازن، F1 و معیارهای هر کلاس معمولاً اطلاعات بیشتری از Accuracy ارائه میکنند.
Data Leakage چیست؟
ورود اطلاعات Test یا آینده به فرایند آموزش است که نتیجه ارزیابی را غیرواقعی میکند.
آیا میتوان متن فارسی را با Scikit-learn طبقهبندی کرد؟
بله. TF-IDF و مدلهایی مانند Logistic Regression یا Linear SVM میتوانند Baselineهای مناسبی برای طبقهبندی متن فارسی باشند.
آیا میتوان Supervised Learning را با مدل زبانی ترکیب کرد؟
بله. مدل محلی میتواند نمونههای ساده را طبقهبندی کند و موارد نامطمئن برای مدل زبانی ارسال شوند.
جمعبندی
یادگیری نظارتشده یکی از مهمترین روشهای ساخت مدلهای پیشبینی است. مدل با دادههای برچسبدار آموزش میبیند و تلاش میکند خروجی نمونههای جدید را تخمین بزند.
برای اجرای صحیح یک پروژه Supervised Learning:
- مسئله را دقیق تعریف کنید.
- دیتاست مرتبط و باکیفیت بسازید.
- Train، Validation و Test را جدا کنید.
- از Data Leakage جلوگیری کنید.
- یک Baseline ساده بسازید.
- معیار متناسب با مسئله انتخاب کنید.
- خطاهای هر کلاس را تحلیل کنید.
- Probability و Threshold را ارزیابی کنید.
- مدل و دیتاست را نسخهبندی کنید.
- عملکرد مدل را پس از استقرار پایش کنید.
برای وظایف پیچیدهتر میتوانید مدل طبقهبندی محلی را با مدلهای زبانی ترکیب کنید. در این معماری، موارد ساده با هزینه و تأخیر پایین پردازش میشوند و ورودیهای مبهم به مدل قویتر ارسال میشوند.
برای آزمایش مدلهای مختلف زبانی در اپلیکیشن خود میتوانید از مستندات API درواره شروع کنید.
درواره با یک API سازگار با OpenAI، پرداخت ریالی و دسترسی یکپارچه به مدلهای مختلف، امکان ساخت Pipelineهای هوش مصنوعی و مقایسه مدلها از نظر کیفیت، سرعت و هزینه را فراهم میکند.
مقالات مرتبط
- یادگیری ماشین چیست؟
- یادگیری تقویتی چیست؟
- دیتاست چیست و چگونه ساخته میشود؟
- آموزش Scikit-learn با پایتون
- آموزش Pandas برای تحلیل داده
- شبکه عصبی چیست؟
- پردازش زبان طبیعی چیست؟
- ارزیابی مدل هوش مصنوعی و Evals
- راهنمای API سازگار با OpenAI
منابع
- Scikit-learn: Supervised Learning
- Scikit-learn: Model Evaluation
- Scikit-learn: Common Pitfalls
- Scikit-learn: Cross-validation
- Scikit-learn: Probability Calibration
- Scikit-learn: Pipelines and Composite Estimators
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.