پردازش زبان طبیعی چیست؟ راهنمای کامل NLP فارسی با مثال عملی
پردازش زبان طبیعی یا NLP شاخهای از هوش مصنوعی است که به کامپیوترها امکان میدهد متن و گفتار انسان را پردازش، تحلیل و تولید کنند. در این راهنمای جامع با مفاهیم NLP، پردازش متن فارسی، مدلهای زبانی، ابزارهای متنباز و ساخت یک سیستم تحلیل پیام با پایتون و API درواره آشنا میشوید.
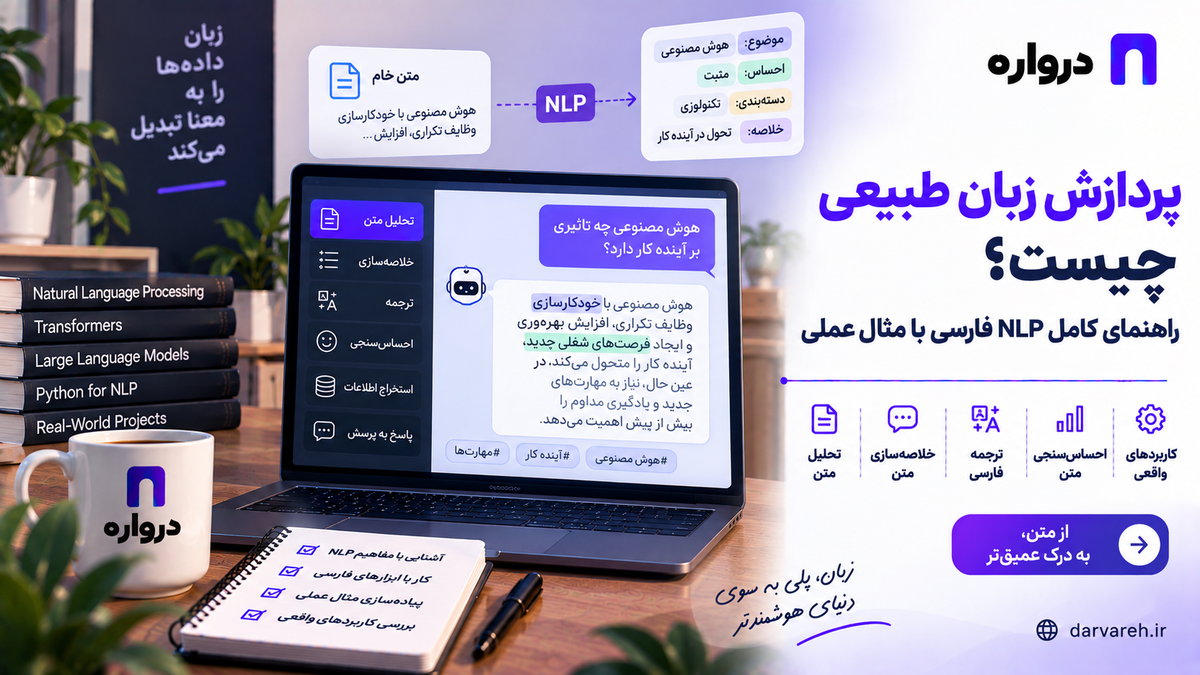
پردازش زبان طبیعی یا Natural Language Processing یکی از شاخههای مهم هوش مصنوعی است که به کامپیوترها کمک میکند زبان انسان را پردازش، تحلیل و تولید کنند.
هر زمان که یک نرمافزار متن را ترجمه میکند، پیام مشتری را دستهبندی میکند، از داخل قرارداد اطلاعات استخراج میکند، گفتار را به متن تبدیل میکند یا به پرسش کاربر پاسخ میدهد، از نوعی فناوری پردازش زبان طبیعی استفاده شده است.
NLP در ابزارهای مختلفی حضور دارد:
- موتورهای جستوجو
- چتباتها
- دستیارهای صوتی
- سامانههای ترجمه
- تحلیل احساسات
- خلاصهسازی متن
- غلطیابی نگارشی
- استخراج اطلاعات
- جستوجوی معنایی
- مدلهای زبانی بزرگ
- سیستمهای پشتیبانی مشتری
پردازش زبان فارسی چالشهای خاصی مانند نیمفاصله، شکلهای مختلف حروف، ترتیب راستبهچپ، پسوندها، افعال مرکب و متنهای محاورهای دارد. به همین دلیل، کیفیت یک ابزار در زبان انگلیسی الزاماً به معنای عملکرد مشابه آن روی فارسی نیست.
در این مقاله علاوه بر مفاهیم اصلی NLP، یک طبقهبند متن فارسی با پایتون میسازیم و سپس همان کاربرد را با مدل آماده و API درواره پیادهسازی میکنیم.
پردازش زبان طبیعی یا NLP چیست؟
پردازش زبان طبیعی حوزهای میان علوم کامپیوتر، هوش مصنوعی، یادگیری ماشین و زبانشناسی محاسباتی است.
هدف NLP این است که سیستمهای نرمافزاری بتوانند با دادههای زبانی مانند متن و گفتار کار کنند.
این پردازش ممکن است شامل یکی از اقدامات زیر باشد:
- درک موضوع متن
- تشخیص اشخاص، مکانها و سازمانها
- تعیین لحن مثبت یا منفی
- تشخیص زبان
- استخراج تاریخ، مبلغ یا شماره سفارش
- ترجمه از یک زبان به زبان دیگر
- خلاصه کردن یک سند
- پاسخ به پرسش
- تولید متن جدید
- تبدیل گفتار به متن
- تبدیل متن به گفتار
IBM پردازش زبان طبیعی را زیرشاخهای از علوم کامپیوتر و هوش مصنوعی معرفی میکند که به کامپیوترها امکان میدهد با زبان انسانی و دادههای متنی و گفتاری کار کنند. IBM: Natural Language Processing
چرا پردازش زبان انسان دشوار است؟
زبان طبیعی برخلاف زبان برنامهنویسی، دقیق و بدون ابهام نیست.
یک کلمه یا جمله ممکن است بر اساس زمینه، لحن و ترتیب واژهها معانی متفاوتی داشته باشد.
برای مثال، جمله زیر را در نظر بگیرید:
عجب سرویس سریعی!
این جمله میتواند یک تعریف واقعی یا یک کنایه درباره کند بودن سرویس باشد. تشخیص معنای درست فقط با بررسی کلمات ممکن نیست و به زمینه مکالمه نیاز دارد.
چالشهای اصلی زبان طبیعی عبارتاند از:
- چندمعنایی بودن کلمات
- وابستگی معنی به متن قبلی
- کنایه و طنز
- غلطهای املایی
- زبان محاوره
- حذف بخشی از جمله
- تفاوت گویشها
- کلمات جدید
- ترکیب فارسی و انگلیسی
- تفاوت میان متن رسمی و شبکههای اجتماعی
حتی تقسیم متن به کلمات نیز همیشه ساده نیست. مستندات spaCy اشاره میکند که ترتیب متفاوت کلمات میتواند معنای جمله را تغییر دهد و حتی جدا کردن متن به واحدهای مناسب در زبانهای مختلف نیازمند قواعد زبانی است. مستندات ویژگیهای زبانی spaCy
تفاوت NLP، NLU و NLG چیست؟
این سه اصطلاح با هم مرتبطاند، اما یکسان نیستند.
| اصطلاح | نام کامل | وظیفه |
|---|---|---|
| NLP | Natural Language Processing | حوزه کلی پردازش زبان |
| NLU | Natural Language Understanding | درک معنا و هدف متن |
| NLG | Natural Language Generation | تولید متن طبیعی |
برای مثال، در یک چتبات فروش:
- NLP متن کاربر را آماده و پردازش میکند.
- NLU تشخیص میدهد کاربر درباره قیمت محصول سؤال دارد.
- منطق برنامه اطلاعات قیمت را پیدا میکند.
- NLG پاسخ روان و مناسب تولید میکند.
در مدلهای زبانی جدید، مرز این بخشها کمتر قابلمشاهده است؛ زیرا یک مدل میتواند چند وظیفه را همزمان انجام دهد.
تفاوت NLP و مدل زبانی بزرگ چیست؟
NLP یک حوزه علمی و فنی گسترده است، اما مدل زبانی بزرگ یا LLM یک نوع مدل مورد استفاده در این حوزه محسوب میشود.
روشهای NLP مدتها قبل از مدلهای زبانی بزرگ وجود داشتهاند. برای مثال:
- قواعد منظم
- فرهنگ واژگان
- مدلهای آماری
- Naive Bayes
- رگرسیون لجستیک
- مدلهای Markov
- TF-IDF
- Word2Vec
- شبکههای RNN و LSTM
مدلهای زبانی بزرگ معمولاً بر پایه معماری Transformer ساخته میشوند و میتوانند چندین وظیفه زبانی را با تغییر دستور ورودی انجام دهند.
| ویژگی | NLP کلاسیک | مدل زبانی بزرگ |
|---|---|---|
| نوع وظیفه | معمولاً یک وظیفه مشخص | چندین وظیفه |
| داده آموزشی | کمتر و تخصصیتر | بسیار گسترده |
| خروجی | اغلب برچسب یا مقدار مشخص | متن یا خروجی ساختاریافته |
| کنترل | قابلپیشبینیتر در وظایف محدود | انعطافپذیرتر |
| هزینه اجرا | معمولاً کمتر | معمولاً بیشتر |
| نیاز به آموزش اختصاصی | در بسیاری از پروژهها بله | اغلب با Prompt قابل شروع است |
برای دستهبندی چند عبارت ثابت، یک مدل ساده ممکن است انتخاب بهتری باشد. برای تحلیل متن آزاد، خلاصهسازی یا استخراج همزمان چند نوع اطلاعات، مدل زبانی میتواند توسعه را سریعتر کند.
پردازش زبان طبیعی چگونه کار میکند؟
یک جریان کاری NLP معمولاً شامل چند مرحله است.
۱. دریافت داده زبانی
ورودی ممکن است از منابع زیر دریافت شود:
- پیامهای پشتیبانی
- دیدگاه کاربران
- ایمیل
- فایل PDF
- مکالمه صوتی
- متن شبکه اجتماعی
- توضیحات محصول
- قرارداد
- گزارش سازمانی
- مقاله
- صفحات وب
اگر ورودی صوتی باشد، معمولاً ابتدا با یک مدل تشخیص گفتار به متن تبدیل میشود.
۲. نرمالسازی متن
نرمالسازی شکلهای مختلف یک نویسه یا عبارت را به فرم استاندارد تبدیل میکند.
در فارسی ممکن است این اقدامات انجام شوند:
- تبدیل «ي» عربی به «ی» فارسی
- تبدیل «ك» عربی به «ک» فارسی
- اصلاح فاصله و نیمفاصله
- حذف کشیدگی
- یکسانسازی اعداد
- حذف فاصلههای تکراری
- استانداردسازی علائم
- اصلاح بعضی شکلهای نوشتاری
برای مثال:
ورودی:
من کتاب هاي زيــــادي دارم .
خروجی نرمالشده:
من کتابهای زیادی دارم.
نرمالسازی باید با هدف پروژه هماهنگ باشد. حذف همه علائم نگارشی یا ایموجیها همیشه درست نیست؛ زیرا در تحلیل احساسات ممکن است اطلاعات مهمی از بین برود.
۳. توکنسازی
Tokenization فرایند تقسیم متن به واحدهای کوچکتر است.
توکن ممکن است یک کلمه، بخش کلمه، علامت یا نویسه باشد.
مثال:
متن:
سفارش من هنوز ارسال نشده است.
توکنها:
["سفارش", "من", "هنوز", "ارسال", "نشده", "است", "."]
مدلهای زبانی جدید معمولاً از توکنهای زیرواژهای استفاده میکنند. در این روش یک کلمه ممکن است به چند بخش تقسیم شود.
۴. حذف Stop Word
کلمات پرتکراری مانند «از»، «به»، «که» و «را» در برخی روشهای کلاسیک حذف میشوند.
این کار همیشه مناسب نیست. برای مثال، حذف واژههای منفی مانند «نیست» میتواند معنای جمله را کاملاً تغییر دهد:
محصول خوب است.
محصول خوب نیست.
۵. ریشهیابی و Lemmatization
ریشهیابی تلاش میکند پسوندها و پیشوندها را حذف کند. Lemmatization کلمه را به صورت پایه زبانی آن تبدیل میکند.
مثال:
مینویسیم → نوشتن
کتابها → کتاب
رفتهاند → رفتن
ریشهیابی ممکن است خروجیای تولید کند که یک واژه طبیعی نباشد. Lemmatization معمولاً از اطلاعات زبانی بیشتری استفاده میکند.
۶. برچسبگذاری نقش کلمات
در Part-of-Speech Tagging نقش دستوری هر کلمه مشخص میشود:
- اسم
- فعل
- صفت
- قید
- ضمیر
- حرف اضافه
این اطلاعات در تحلیل ساختار جمله و استخراج اطلاعات کاربرد دارد.
۷. تحلیل وابستگی
Dependency Parsing رابطه دستوری میان کلمات را مشخص میکند.
برای مثال، سیستم میتواند تشخیص دهد فاعل، فعل و مفعول یک جمله کداماند.
۸. تبدیل متن به اعداد
الگوریتمهای یادگیری ماشین مستقیماً با کلمات کار نمیکنند. متن باید به نمایش عددی تبدیل شود.
روشهای رایج عبارتاند از:
- Bag of Words
- TF-IDF
- Word Embedding
- Sentence Embedding
- نمایشهای زمینهای Transformer
۹. اجرای وظیفه اصلی
پس از آمادهسازی، مدل وظیفه موردنظر را انجام میدهد:
- دستهبندی
- استخراج اطلاعات
- ترجمه
- خلاصهسازی
- پاسخگویی
- تولید متن
۱۰. ارزیابی و پسپردازش
خروجی مدل باید اعتبارسنجی و برای مصرف نرمافزار آماده شود.
برای مثال، اگر مدل اطلاعات فاکتور را استخراج کرده باشد، مبلغ و تاریخ باید با قواعد برنامه بررسی شوند.
مهمترین وظایف پردازش زبان طبیعی
دستهبندی متن
متن در یکی از گروههای مشخص قرار میگیرد.
مثالها:
- فروش
- سؤال فنی
- امور مالی
- شکایت
- پیشنهاد
- پیام تبلیغاتی
تحلیل احساسات
مدل لحن متن را مثبت، منفی یا خنثی تشخیص میدهد.
تحلیل احساسات برای بررسی دیدگاه کاربران، نظرسنجی و بازخورد مشتری استفاده میشود.
بااینحال، کنایه و متن محاورهای میتواند نتیجه را دشوار کند.
تشخیص موجودیت نامدار
Named Entity Recognition یا NER اطلاعات مشخصی را در متن پیدا میکند:
- نام شخص
- سازمان
- مکان
- تاریخ
- مبلغ
- محصول
- شماره سفارش
برای مثال:
علی رضایی روز ۱۵ مهر از فروشگاه مرکزی
یک لپتاپ به مبلغ ۵۰ میلیون تومان خرید.
مدل ممکن است این موارد را استخراج کند:
{
"person": "علی رضایی",
"date": "۱۵ مهر",
"location": "فروشگاه مرکزی",
"product": "لپتاپ",
"amount": "۵۰ میلیون تومان"
}
استخراج رابطه
پس از شناسایی موجودیتها، سیستم میتواند رابطه میان آنها را پیدا کند.
برای مثال:
خریدار: علی رضایی
محصول خریداریشده: لپتاپ
مبلغ خرید: ۵۰ میلیون تومان
خلاصهسازی
دو روش اصلی خلاصهسازی عبارتاند از:
- خلاصهسازی استخراجی: انتخاب جملات مهم متن
- خلاصهسازی تولیدی: بازنویسی مفهوم متن به شکل کوتاهتر
ترجمه ماشینی
متن از یک زبان به زبان دیگر تبدیل میشود. مدل باید علاوه بر واژهها، ساختار جمله، اصطلاحات و زمینه را در نظر بگیرد.
پاسخ به پرسش
مدل بر اساس دانش آموزشی یا اطلاعات ارائهشده به پرسش پاسخ میدهد.
در سیستمهای RAG، ابتدا اطلاعات مرتبط از منبع بازیابی و سپس برای تولید پاسخ به مدل داده میشود.
تولید متن
مدل میتواند متن جدیدی مانند توضیحات محصول، پیشنویس ایمیل یا گزارش تولید کند.
جستوجوی معنایی
بهجای تطبیق دقیق کلمات، معنای پرسش با معنای اسناد مقایسه میشود.
برای مثال، جستوجوی «چطور سفارشم را پس بدهم؟» میتواند سندی با عنوان «شرایط مرجوعی کالا» را پیدا کند.
تشخیص هدف کاربر
Intent Detection مشخص میکند کاربر چه کاری میخواهد انجام دهد.
نمونه Intentها:
- پیگیری سفارش
- درخواست قیمت
- لغو اشتراک
- گزارش خطا
- درخواست راهنما
روشهای اصلی NLP
روش مبتنی بر قواعد
در این روش، توسعهدهنده قواعد مشخصی تعریف میکند.
مثال:
def detect_order_tracking(
    message: str,
) -> bool:
    keywords = [
        "پیگیری سفارش",
        "سفارشم کجاست",
        "وضعیت سفارش",
    ]

    return any(
        keyword in message
        for keyword in keywords
    )
مزایا:
- ساده و قابلتوضیح
- هزینه پایین
- مناسب برای الگوهای ثابت
محدودیتها:
- پوشش کم عبارتهای جدید
- نگهداری دشوار در مقیاس بزرگ
- ضعف در درک زمینه
روش آماری و یادگیری ماشین
متن با TF-IDF یا روش مشابه به اعداد تبدیل و یک الگوریتم طبقهبندی روی آن آموزش داده میشود.
این روش برای وظایف محدود با داده برچسبگذاریشده مناسب است.
یادگیری عمیق
شبکههای RNN، LSTM و CNN متنی میتوانند نمایش پیچیدهتری از زبان یاد بگیرند.
این مدلها معمولاً به داده و منابع پردازشی بیشتری نیاز دارند.
Transformer
Transformer با مکانیزم Attention رابطه میان توکنهای مختلف را بررسی میکند.
معماری Transformer پایه بسیاری از مدلهای جدید پردازش زبان است. راهنمای Google توضیح میدهد که مدلهای Transformer از Self-Attention برای بررسی میزان ارتباط هر توکن با دیگر توکنهای ورودی استفاده میکنند. Google: Transformers
مدل زبانی بزرگ
LLM میتواند وظایف مختلف NLP را از طریق دستور متنی انجام دهد:
- طبقهبندی
- استخراج
- خلاصهسازی
- تولید
- بازنویسی
- ترجمه
- پاسخگویی
برای بسیاری از پروژهها میتوان ابتدا با Prompt و چند نمونه کار را آغاز کرد و فقط در صورت نیاز به Fine-tuning رفت.
چالشهای پردازش زبان فارسی
تفاوت حروف عربی و فارسی
حروف زیر ممکن است در ظاهر مشابه اما از نظر کد یونیکد متفاوت باشند:
ي و ی
ك و ک
این تفاوت میتواند جستوجو، شمارش کلمات و تطبیق را مختل کند.
نیمفاصله
کلمات زیر ممکن است به شکلهای متفاوت نوشته شوند:
میروم
می روم
میروم
نرمالسازی باید این تفاوتها را مدیریت کند.
افعال مرکب
عبارتهایی مانند «تصمیم گرفتن»، «ارسال کردن» و «بررسی شدن» از چند کلمه تشکیل شدهاند، اما یک مفهوم فعلی دارند.
پسوندها
پسوندها ممکن است به کلمه بچسبند یا با نیمفاصله نوشته شوند:
کتابها
کتاب ها
کتابهای
متن محاورهای
کاربران ممکن است بنویسند:
سفارشم چرا هنوز نرسیده؟
پولمو پس بدین
اپتون باز نمیشه
مدل باید شکل محاورهای را روی دادههای واقعی آزمایش کند.
ترکیب فارسی و انگلیسی
متنهای فنی اغلب شامل واژه، شناسه مدل، کد، URL و عدد انگلیسی هستند.
نبود اعراب
کلمه «شیر» میتواند بر اساس جمله به نوشیدنی، حیوان یا وسیله آب اشاره کند.
ترتیب راستبهچپ
ذخیرهسازی متن معمولاً مشکلی ندارد، اما نمایش ترکیب فارسی، انگلیسی، عدد و کد در رابط کاربری نیازمند توجه است.
ابزارهای پرکاربرد NLP
| ابزار | کاربرد |
|---|---|
| Hazm | نرمالسازی و تحلیل متن فارسی |
| Parsivar | پردازش و نرمالسازی فارسی |
| spaCy | پردازش سریع متن و Pipelineهای زبانی |
| Stanza | تحلیل زبانی چندزبانه |
| NLTK | آموزش و پردازش کلاسیک زبان |
| Scikit-learn | طبقهبندی متن با الگوریتمهای کلاسیک |
| Hugging Face Transformers | استفاده و آموزش مدلهای Transformer |
| Sentence Transformers | ساخت Embedding جمله |
| PyTorch | آموزش مدلهای عمیق |
| TensorFlow | ساخت و استقرار شبکههای عصبی |
| FastAPI | ارائه مدل در قالب API |
Stanza مجموعهای از ابزارهای تحلیل زبانی مانند توکنسازی، Lemmatization، برچسبگذاری نقش کلمات و تشخیص موجودیت را در یک Pipeline ارائه میکند. مستندات Stanza
Hugging Face نیز مستندات و ابزارهایی برای وظایفی مانند دستهبندی متن با مدلهای Transformer ارائه میدهد. Hugging Face: Text Classification
آموزش پردازش متن فارسی با Hazm
Hazm یک کتابخانه متنباز پایتون برای پردازش زبان فارسی است و قابلیتهایی مانند نرمالسازی، توکنسازی، Lemmatization، برچسبگذاری نقش کلمات و تحلیل وابستگی ارائه میکند. مخزن رسمی Hazm
نسخه فعلی Hazm بر اساس مستندات پروژه به Python 3.12 یا جدیدتر نیاز دارد.
نصب Hazm
pip install hazm
نرمالسازی متن
from hazm import Normalizer


normalizer = Normalizer()

text = (
    "من کتاب هاي زيــــادي "
    "درباره هوش مصنوعي دارم ."
)

normalized = normalizer.normalize(text)

print(normalized)
خروجی احتمالی:
من کتابهای زیادی درباره هوش مصنوعی دارم.
تقسیم متن به جمله
from hazm import sent_tokenize
text = (
"سفارش ثبت شد. "
"کد پیگیری برای شما ارسال میشود."
)
sentences = sent_tokenize(text)
print(sentences)
تقسیم جمله به کلمه
from hazm import word_tokenize


tokens = word_tokenize(
    "سفارش من هنوز ارسال نشده است."
)

print(tokens)
ریشهیابی و Lemmatization
from hazm import Lemmatizer
from hazm import Stemmer
stemmer = Stemmer()
lemmatizer = Lemmatizer()
print(
stemmer.stem("کتابها")
)
print(
lemmatizer.lemmatize(
"مینویسیم"
)
)
ریشهیابی و Lemmatization برای همه پروژهها ضروری نیست. مدلهای Transformer معمولاً متن را با Tokenizer اختصاصی خود پردازش میکنند و تغییر بیشازحد ورودی ممکن است کیفیت را کاهش دهد.
پروژه عملی: دستهبندی پیامهای فارسی با Machine Learning
در این پروژه پیام مشتری را در یکی از دستههای زیر قرار میدهیم:
salestechnicalbillingfeedbackother
فرض کنید فایل messages.csv دارای دو ستون باشد:
text,label
برای خرید اشتراک سازمانی راهنمایی میخواهم,sales
API خطای 401 میدهد,technical
مبلغ از حساب کم شده ولی کیف پول شارژ نشده,billing
رابط کاربری جدید خیلی بهتر شده,feedback
ساعت کاری شرکت چیست؟,other
برای مدل واقعی به تعداد بیشتری نمونه متنوع و بررسیشده نیاز دارید.
نصب کتابخانهها
pip install pandas scikit-learn hazm joblib
ساخت Pipeline
import pandas as pd

from hazm import Normalizer
from sklearn.feature_extraction.text import (
    TfidfVectorizer,
)
from sklearn.linear_model import (
    LogisticRegression,
)
from sklearn.metrics import (
    classification_report,
)
from sklearn.model_selection import (
    train_test_split,
)
from sklearn.pipeline import Pipeline


normalizer = Normalizer()


def normalize_persian(
    text: str,
) -> str:
    return normalizer.normalize(
        str(text)
    )


data = pd.read_csv("messages.csv")

X_train, X_test, y_train, y_test = (
    train_test_split(
        data["text"],
        data["label"],
        test_size=0.2,
        random_state=42,
        stratify=data["label"],
    )
)

model = Pipeline(
    steps=[
        (
            "tfidf",
            TfidfVectorizer(
                preprocessor=(
                    normalize_persian
                ),
                ngram_range=(1, 2),
                min_df=2,
                max_df=0.95,
            ),
        ),
        (
            "classifier",
            LogisticRegression(
                max_iter=1000,
                class_weight="balanced",
            ),
        ),
    ]
)

model.fit(
    X_train,
    y_train,
)
در این Pipeline:
- متن فارسی نرمال میشود.
- واژهها و ترکیبهای دوکلمهای به بردار TF-IDF تبدیل میشوند.
- رگرسیون لجستیک دسته پیام را پیشبینی میکند.
ارزیابی مدل
predictions = model.predict(
    X_test
)

print(
    classification_report(
        y_test,
        predictions,
    )
)
گزارش شامل Precision، Recall و F1 Score هر دسته است.
اگر پیامهای مربوط به امور مالی اهمیت بالاتری دارند، باید Recall این دسته جداگانه بررسی شود.
پیشبینی پیام جدید
messages = [
"سلام، برای اتصال به API "
"نمونه کد پایتون میخواهم.",
"هزینه اشتراک ماهانه چقدر است؟",
]
predicted_labels = model.predict(
messages
)
for message, label in zip(
messages,
predicted_labels,
):
print(message, "=>", label)
ذخیره مدل
import joblib


joblib.dump(
    model,
    "persian_message_classifier.joblib",
)
این روش برای دستههای ثابت، حجم زیاد درخواست و نیاز به پاسخ سریع مناسب است؛ اما برای افزودن دسته جدید معمولاً به داده و آموزش مجدد نیاز دارد.
ساخت سیستم NLP با API درواره
در روش دوم از یک مدل زبانی آماده استفاده میکنیم.
مزیت این روش آن است که مدل علاوه بر دستهبندی میتواند:
- خلاصه پیام را تولید کند.
- اطلاعات مهم را استخراج کند.
- فوریت را تشخیص دهد.
- اقدام بعدی پیشنهاد کند.
- پیشنویس پاسخ بنویسد.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
نصب کتابخانهها
pip install openai pydantic
تنظیم متغیرهای محیطی
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
شناسه مدل را از فهرست فعلی مدلهای درواره انتخاب کنید.
تعریف ساختار خروجی
from typing import Literal

from pydantic import BaseModel


class MessageAnalysis(BaseModel):
    category: Literal[
        "sales",
        "technical",
        "billing",
        "feedback",
        "other",
    ]
    urgency: Literal[
        "low",
        "medium",
        "high",
    ]
    summary: str
    order_id: str | None
    suggested_action: str
    response_draft: str
تحلیل پیام فارسی
import json
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ[
"DARVAREH_API_KEY"
],
base_url=(
"https://api.darvareh.ir/v1"
),
)
MODEL_ID = os.environ[
"DARVAREH_MODEL"
]
def analyze_message(
message: str,
) -> MessageAnalysis:
prompt = f"""
پیام مشتری را تحلیل کن.
دستههای مجاز:
- sales
- technical
- billing
- feedback
- other
سطح فوریت:
- low
- medium
- high
قواعد:
- فقط از اطلاعات خود پیام استفاده کن.
- اگر شماره سفارش وجود ندارد، order_id را null قرار بده.
- urgency را فقط بر اساس نیاز واقعی پیام تعیین کن.
- summary حداکثر دو جمله باشد.
- response_draft فارسی، کوتاه و محترمانه باشد.
- پاسخ فقط JSON معتبر باشد.
- خارج از JSON هیچ متنی ننویس.
ساختار خروجی:
{{
"category": "sales",
"urgency": "low",
"summary": "خلاصه پیام",
"order_id": null,
"suggested_action": "اقدام بعدی",
"response_draft": "پیشنویس پاسخ"
}}
پیام مشتری:
{message}
"""
response = (
client.chat.completions.create(
model=MODEL_ID,
temperature=0.1,
messages=[
{
"role": "system",
"content": (
"شما سامانه تحلیل "
"پیامهای فارسی هستید "
"و فقط JSON معتبر "
"تولید میکنید."
),
},
{
"role": "user",
"content": prompt,
},
],
)
)
content = (
response
.choices[0]
.message
.content
)
if not content:
raise ValueError(
"پاسخی از مدل دریافت نشد."
)
parsed = json.loads(content)
return (
MessageAnalysis
.model_validate(parsed)
)
اجرای نمونه
result = analyze_message(
    "سلام، سفارش ۸۴۲۱ را سه روز "
    "پیش ثبت کردم اما هنوز ارسال "
    "نشده است. لطفاً پیگیری کنید."
)

print(
    result.model_dump_json(
        indent=2
    )
)
نمونه خروجی:
{
"category": "other",
"urgency": "medium",
"summary": "مشتری درباره تأخیر در ارسال سفارش ۸۴۲۱ درخواست پیگیری دارد.",
"order_id": "۸۴۲۱",
"suggested_action": "بررسی وضعیت سفارش و اعلام زمان ارسال",
"response_draft": "سلام، وضعیت سفارش ۸۴۲۱ را بررسی میکنیم و نتیجه را در کوتاهترین زمان به شما اطلاع میدهیم."
}
در یک سامانه واقعی بهتر است دسته مستقلی مانند order_tracking تعریف شود. دستهها باید بر اساس فرایند واقعی کسبوکار انتخاب شوند، نه صرفاً نمونه عمومی مقاله.
مقایسه مدل کلاسیک و مدل زبانی
| معیار | مدل TF-IDF | مدل زبانی از طریق API |
|---|---|---|
| نیاز به داده برچسبدار | زیادتر | برای شروع کمتر |
| سرعت | معمولاً بالا | وابسته به مدل |
| هزینه هر درخواست | بسیار کم | بر اساس مصرف |
| انعطاف | محدود به وظیفه آموزش | بالا |
| توضیح و تولید پاسخ | ندارد | دارد |
| افزودن دسته جدید | نیازمند آموزش مجدد | گاهی با تغییر Prompt |
| اجرای محلی | ساده | معمولاً سرویس API |
| درک متن پیچیده | محدودتر | معمولاً بهتر |
| خروجی ساختاریافته | قابلپیادهسازی | با Prompt و اعتبارسنجی |
انتخاب درست به تعداد درخواست، پیچیدگی پیامها، هزینه، کیفیت مطلوب و زیرساخت تیم بستگی دارد.
یک معماری ترکیبی نیز ممکن است:
- مدل سبک، پیامهای ساده را طبقهبندی کند.
- پیامهای نامطمئن یا پیچیده به مدل زبانی ارسال شوند.
- خروجی با Pydantic اعتبارسنجی شود.
- اقدام نهایی توسط قوانین برنامه تعیین شود.
معماری پیشنهادی برای NLP در محصول واقعی
کاربر
↓
رابط کاربری
↓
سرور نرمافزار
↓
نرمالسازی و اعتبارسنجی
↓
مدل کلاسیک یا API درواره
↓
اعتبارسنجی خروجی
↓
قوانین کسبوکار
↓
ذخیره یا نمایش نتیجه
مدل نباید مستقیماً عملیات حساس یا قطعی انجام دهد. برای مثال، اگر مدل پیام را «درخواست بازپرداخت» تشخیص داد، نباید بدون کنترل وضعیت سفارش و مجوزهای کاربر مبلغی پرداخت شود.
معیارهای ارزیابی سیستم NLP
Precision
از میان نمونههایی که مدل در یک دسته قرار داده، چه تعداد درست بودهاند؟
Recall
از میان تمام نمونههای واقعی یک دسته، مدل چه تعداد را پیدا کرده است؟
F1 Score
تعادلی میان Precision و Recall ایجاد میکند.
Exact Match
برای استخراج اطلاعات، بررسی میکند خروجی دقیقاً با پاسخ مطلوب برابر است یا خیر.
Semantic Similarity
برای خلاصهسازی یا تولید متن میتوان شباهت معنایی خروجی و پاسخ مرجع را بررسی کرد.
ارزیابی انسانی
برای وظایفی مانند بازنویسی، پاسخگویی و خلاصهسازی، ارزیابی انسانی همچنان اهمیت زیادی دارد.
معیارهای انسانی میتوانند شامل موارد زیر باشند:
- صحت
- روانی
- کامل بودن
- وفاداری به منبع
- لحن
- قابلیت استفاده
- نبود اطلاعات ساختگی
ساخت مجموعه ارزیابی فارسی
پیش از انتشار قابلیت NLP، مجموعهای از ورودیهای واقعی آماده کنید.
این مجموعه باید شامل موارد زیر باشد:
- متن رسمی
- متن محاورهای
- غلط املایی
- نیمفاصله درست و نادرست
- اعداد فارسی و انگلیسی
- پیام کوتاه
- پیام طولانی
- چند درخواست در یک پیام
- فارسی و انگلیسی ترکیبی
- کنایه
- داده ناقص
- موارد خارج از دستهها
پس از هر تغییر مدل، Prompt یا Pipeline، همان مجموعه را دوباره اجرا و نتیجه را مقایسه کنید.
چگونه هزینه NLP با API را کاهش دهیم؟
وظیفه را محدود کنید
بهجای ارسال دستور کلی، خروجی موردنیاز را دقیق تعریف کنید.
متن غیرمرتبط را حذف کنید
برای طبقهبندی یک پیام، ارسال تمام تاریخچه مشتری همیشه ضروری نیست.
خروجی را کوتاه نگه دارید
اگر فقط دسته و شماره سفارش نیاز دارید، از مدل مقاله کامل نخواهید.
از JSON استفاده کنید
خروجی ساختاریافته پردازش نرمافزاری و کنترل خطا را آسانتر میکند.
مدل را متناسب با وظیفه انتخاب کنید
برای طبقهبندی ساده ممکن است مدل سریعتر و اقتصادیتر کافی باشد.
نتیجه را Cache کنید
متن یکسان نباید بدون دلیل چندبار پردازش شود.
پردازش دستهای را بررسی کنید
اگر پاسخ فوری لازم نیست، پردازش گروهی میتواند مدیریت عملیات را سادهتر کند.
معماری ترکیبی بسازید
قواعد و مدلهای سبک میتوانند درخواستهای ساده را مدیریت کنند و مدل قویتر فقط برای موارد پیچیده استفاده شود.
اشتباهات رایج در پروژههای NLP
حذف بیشازحد اطلاعات
حذف علائم، اعداد، ایموجی یا کلمات منفی ممکن است معنی متن را تغییر دهد.
استفاده از ابزار انگلیسی بدون ارزیابی فارسی
Tokenizer، مدل و قواعد هر زبان باید روی داده فارسی بررسی شوند.
آموزش با داده مصنوعی و ارزیابی با همان داده
مجموعه آزمون باید شامل پیامهای واقعی و دیدهنشده باشد.
نادیده گرفتن عدم توازن دستهها
اگر ۹۰ درصد پیامها درباره فروش باشند، Accuracy بهتنهایی معیار مناسبی نیست.
قراردادن منطق کسبوکار در متن آزاد مدل
خروجی مدل باید ساختار مشخص داشته باشد و قوانین قطعی در سمت سرور کنترل شوند.
اعتماد کامل به استخراج مدل
تاریخ، مبلغ، شناسه و نامها باید پیش از استفاده اعتبارسنجی شوند.
نداشتن دسته «سایر»
اجبار مدل به انتخاب یکی از دستههای نامرتبط باعث افزایش خطا میشود.
تغییر مدل بدون ارزیابی مجدد
مدل جدید ممکن است در بعضی پیامها بهتر و در بعضی دیگر ضعیفتر عمل کند.
استفاده از یک مدل برای همه کارها
مدل مناسب دستهبندی ممکن است بهترین انتخاب برای تولید متن یا استخراج موجودیت نباشد.
مسیر یادگیری NLP
مرحله اول: پایتون
با رشتهها، عبارت منظم، فایلها، JSON و کتابخانههای داده آشنا شوید.
مرحله دوم: زبانشناسی پایه
مفاهیمی مانند توکن، ریشه، نقش کلمه، ساختار جمله و معنا را یاد بگیرید.
مرحله سوم: پردازش متن
نرمالسازی، Tokenization، Stemming و Lemmatization را تمرین کنید.
مرحله چهارم: Machine Learning
مدلهای Naive Bayes، رگرسیون لجستیک، TF-IDF و معیارهای ارزیابی را یاد بگیرید.
مرحله پنجم: Embedding
نمایش برداری کلمات و جملات، شباهت کسینوسی و جستوجوی معنایی را بررسی کنید.
مرحله ششم: Transformer
Attention، Tokenizer، Fine-tuning و مدلهای از پیش آموزشدیده را یاد بگیرید.
مرحله هفتم: مدلهای زبانی و API
Prompt، خروجی ساختاریافته، RAG، Tool Calling و کنترل هزینه را تمرین کنید.
مرحله هشتم: استقرار
مدل را داخل API قرار دهید و کیفیت، زمان پاسخ و هزینه را پایش کنید.
پرسشهای متداول
NLP مخفف چیست؟
NLP مخفف Natural Language Processing و به معنای پردازش زبان طبیعی است.
پردازش زبان طبیعی به زبان ساده چیست؟
NLP مجموعهای از روشهاست که به کامپیوتر کمک میکند متن و گفتار انسان را تحلیل، درک یا تولید کند.
آیا NLP فقط برای متن است؟
خیر. پردازش گفتار نیز با NLP ارتباط دارد، هرچند تبدیل صوت به سیگنال و تشخیص گفتار حوزههای تخصصی مرتبط خود را دارند.
آیا ChatGPT از NLP استفاده میکند؟
مدلهای گفتوگویی جدید بر پایه یادگیری عمیق و مدلهای زبانی بزرگ ساخته شدهاند و بسیاری از وظایف NLP را انجام میدهند.
بهترین کتابخانه پردازش زبان فارسی چیست؟
Hazm و Parsivar از ابزارهای شناختهشده فارسی هستند. انتخاب ابزار به وظیفه، نسخه پایتون، کیفیت مدل و داده پروژه بستگی دارد.
آیا برای NLP باید مدل را آموزش دهیم؟
خیر. میتوان از مدلهای آماده یا API استفاده کرد. آموزش مدل اختصاصی زمانی بررسی میشود که مدلهای آماده روی داده واقعی کیفیت کافی نداشته باشند.
تفاوت NLP و Text Mining چیست؟
NLP بیشتر روی پردازش و درک زبان تمرکز دارد. Text Mining روی استخراج الگو و دانش از مجموعههای متنی متمرکز است. این دو حوزه همپوشانی زیادی دارند.
آیا NLP فارسی دقت خوبی دارد؟
کیفیت به مدل، داده و نوع وظیفه بستگی دارد. عملکرد باید روی متن واقعی کاربران فارسیزبان ارزیابی شود.
آیا میتوان NLP را بدون GPU اجرا کرد؟
مدلهای کلاسیک و ابزارهای سبک معمولاً روی CPU اجرا میشوند. مدلهای Transformer بزرگ برای اجرای سریعتر ممکن است به GPU نیاز داشته باشند. هنگام استفاده از API نیازی به مدیریت مستقیم GPU ندارید.
درواره چگونه برای پروژه NLP استفاده میشود؟
درواره دسترسی به مدلهای مختلف را با یک API سازگار با OpenAI فراهم میکند. میتوان از آن برای طبقهبندی، خلاصهسازی، استخراج اطلاعات، ترجمه، تولید متن و ساخت چتبات استفاده کرد.
جمعبندی
پردازش زبان طبیعی به نرمافزارها امکان میدهد با متن و گفتار انسان کار کنند. NLP از قواعد ساده و روشهای آماری تا شبکههای عصبی و مدلهای زبانی بزرگ را شامل میشود.
برای ساخت یک سیستم NLP موفق:
- مسئله را دقیق تعریف کنید.
- داده فارسی واقعی جمعآوری کنید.
- نرمالسازی را متناسب با وظیفه انجام دهید.
- یک روش ساده را بهعنوان خط مبنا بسازید.
- مدل را با Precision، Recall و F1 ارزیابی کنید.
- متنهای محاورهای و موارد دشوار را آزمایش کنید.
- خروجی مدل را ساختاریافته و اعتبارسنجی کنید.
- قوانین قطعی کسبوکار را در سمت سرور نگه دارید.
- کیفیت، سرعت و هزینه چند مدل را مقایسه کنید.
- پس از هر تغییر مدل یا Prompt، ارزیابی را تکرار کنید.
برای وظایف محدود و پرتکرار، یک مدل کلاسیک میتواند سریع و اقتصادی باشد. برای تحلیل پیچیده، خلاصهسازی، استخراج چندمرحلهای و تولید پاسخ، استفاده از مدل زبانی آماده توسعه را سریعتر میکند.
اگر قصد دارید قابلیتهای پردازش زبان فارسی را به وبسایت، CRM، فروشگاه، سامانه پشتیبانی یا اپلیکیشن خود اضافه کنید، میتوانید از مستندات API درواره شروع کنید.
درواره با یک API سازگار با OpenAI، کیف پول ریالی و دسترسی یکپارچه به مدلهای مختلف، امکان ساخت و آزمایش محصولات NLP را برای توسعهدهندگان و کسبوکارهای ایرانی فراهم میکند.
مقالات مرتبط
- مدل زبانی بزرگ چیست؟
- یادگیری ماشین چیست؟
- یادگیری عمیق چیست؟
- Embedding چیست؟
- جستوجوی معنایی چیست؟
- RAG چیست؟
- خروجی ساختاریافته در API هوش مصنوعی
- آموزش Hugging Face Transformers
- آموزش اتصال API هوش مصنوعی به نرمافزار
منابع
- IBM: Natural Language Processing
- Google: Transformer and Self-Attention
- مستندات spaCy
- مستندات Stanza
- Hugging Face: Text Classification
- مخزن رسمی Hazm
- مخزن رسمی Parsivar
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.