یادگیری عمیق چیست؟ راهنمای کامل Deep Learning با مثال عملی
یادگیری عمیق یا Deep Learning شاخهای از یادگیری ماشین است که با استفاده از شبکههای عصبی چندلایه، الگوهای پیچیده موجود در متن، تصویر، صوت و ویدیو را یاد میگیرد.
یادگیری عمیق یا Deep Learning یکی از مهمترین فناوریهای پشت مدلهای هوش مصنوعی امروزی است. مدلهای زبانی بزرگ، تولیدکنندههای تصویر، سامانههای تشخیص گفتار، ابزارهای ساخت ویدیو و بسیاری از سیستمهای بینایی ماشین بر پایه معماریهای یادگیری عمیق ساخته شدهاند.
در یادگیری ماشین سنتی معمولاً متخصص باید ویژگیهای مهم داده را مشخص کند. برای مثال، برای تشخیص یک شیء در تصویر ممکن است لازم باشد اطلاعات مربوط به لبهها، رنگها و شکلها بهصورت دستی استخراج شوند.
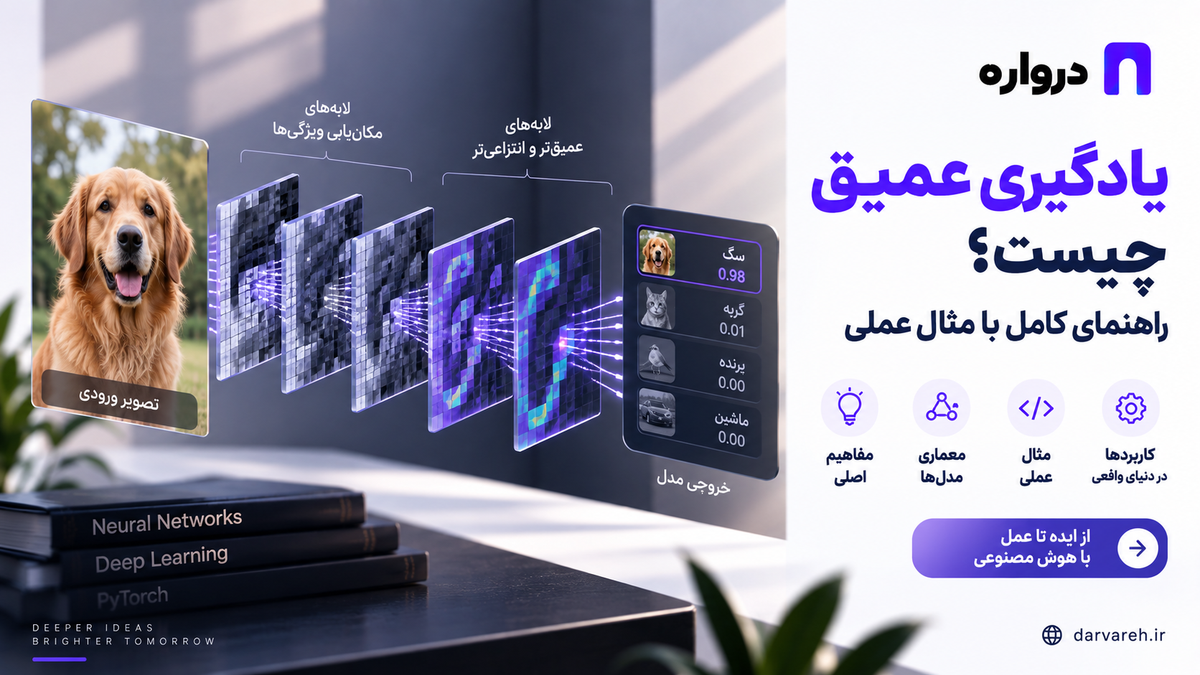
در یادگیری عمیق، شبکه عصبی میتواند بسیاری از این ویژگیها را مستقیماً از داده یاد بگیرد. لایههای ابتدایی الگوهای ساده و لایههای عمیقتر مفاهیم پیچیدهتر را تشخیص میدهند.
برای نمونه، در یک مدل تشخیص تصویر:
- لایههای ابتدایی لبهها و خطوط را پیدا میکنند.
- لایههای میانی شکلها و بافتها را تشخیص میدهند.
- لایههای عمیقتر اجزای یک شیء را یاد میگیرند.
- لایه خروجی نوع شیء را پیشبینی میکند.
در این مقاله ابتدا مفاهیم Deep Learning را توضیح میدهیم، سپس یک شبکه عصبی واقعی برای تشخیص اعداد دستنویس میسازیم و در پایان نشان میدهیم چگونه میتوان بدون آموزش مدل از ابتدا، مدلهای آماده را از طریق API درواره داخل نرمافزار استفاده کرد.
یادگیری عمیق چیست؟
یادگیری عمیق زیرمجموعهای از یادگیری ماشین است که از شبکههای عصبی دارای چندین لایه پردازشی برای یادگیری الگوهای پیچیده استفاده میکند.
عبارت «عمیق» به تعداد لایههای شبکه اشاره دارد. یک شبکه عمیق داده را از چندین مرحله تبدیل عبور میدهد تا نمایشهای سطح بالاتری از ورودی بسازد.
مقاله شناختهشده Yann LeCun، Yoshua Bengio و Geoffrey Hinton در مجله Nature، یادگیری عمیق را روشی معرفی میکند که مدلهای دارای چندین لایه پردازشی را قادر میسازد نمایش داده را در سطوح مختلف انتزاع یاد بگیرند. Nature: Deep Learning
برای مثال، اگر ورودی مدل یک تصویر باشد، هر پیکسل در ابتدا فقط یک عدد است. شبکه بهتدریج یاد میگیرد که ترکیب این اعداد چگونه میتواند نماینده لبه، شکل، چهره یا یک شیء کامل باشد.
تفاوت هوش مصنوعی، یادگیری ماشین و یادگیری عمیق
| مفهوم | تعریف | نمونه |
|---|---|---|
| هوش مصنوعی | حوزه کلی ساخت سیستمهای دارای رفتار هوشمند | دستیار هوشمند |
| یادگیری ماشین | یادگیری الگوها از داده | پیشبینی ریزش مشتری |
| یادگیری عمیق | یادگیری با شبکههای عصبی چندلایه | تشخیص تصویر |
| هوش مصنوعی مولد | تولید محتوای جدید با مدلهای آموزشدیده | تولید متن، تصویر و ویدیو |
رابطه این مفاهیم به شکل زیر است:
هوش مصنوعی
└── یادگیری ماشین
└── یادگیری عمیق
└── بسیاری از مدلهای مولد
هر مدل Deep Learning یک مدل یادگیری ماشین است؛ اما همه مدلهای یادگیری ماشین از شبکه عصبی عمیق استفاده نمیکنند.
الگوریتمهایی مانند رگرسیون خطی، درخت تصمیم، Random Forest، XGBoost و K-Means در گروه روشهای کلاسیک یادگیری ماشین قرار میگیرند.
تفاوت یادگیری ماشین و یادگیری عمیق
| معیار | یادگیری ماشین سنتی | یادگیری عمیق |
|---|---|---|
| نوع داده مناسب | داده جدولی و ساختاریافته | متن، تصویر، صوت و ویدیو |
| حجم داده موردنیاز | کم تا متوسط | معمولاً زیاد |
| استخراج ویژگی | بیشتر بهصورت دستی | عمدتاً خودکار |
| توان پردازشی | معمولاً کمتر | معمولاً بیشتر |
| توضیحپذیری | اغلب بهتر | معمولاً دشوارتر |
| زمان آموزش | کوتاهتر | طولانیتر |
| سختافزار | CPU در بسیاری از پروژهها کافی است | GPU یا شتابدهنده مفید است |
| نمونه کاربرد | پیشبینی فروش | مدل زبانی یا تشخیص تصویر |
یادگیری عمیق همیشه انتخاب بهتری نیست. برای یک مجموعهداده جدولی با چند هزار رکورد، الگوریتمی مانند XGBoost ممکن است سریعتر، کمهزینهتر و توضیحپذیرتر باشد.
Deep Learning بیشتر زمانی ارزشمند است که:
- داده پیچیده یا بدون ساختار باشد.
- تعداد نمونه کافی وجود داشته باشد.
- الگوها با قواعد ساده قابلتعریف نباشند.
- کیفیت بالاتر، هزینه محاسباتی را توجیه کند.
- مدل آماده مناسبی برای انتقال یادگیری وجود داشته باشد.
شبکه عصبی چیست؟
شبکه عصبی مصنوعی مجموعهای از واحدهای محاسباتی به نام نورون است که در چند لایه سازماندهی میشوند.
یک شبکه ساده سه نوع لایه دارد:
لایه ورودی
داده اولیه وارد این لایه میشود.
برای یک تصویر سیاهوسفید ۲۸ در ۲۸ پیکسل، ورودی میتواند شامل ۷۸۴ مقدار عددی باشد.
لایههای پنهان
بخش اصلی یادگیری در لایههای پنهان انجام میشود. هر لایه خروجی لایه قبلی را دریافت و آن را به نمایش جدیدی تبدیل میکند.
لایه خروجی
نتیجه نهایی مدل را تولید میکند. برای تشخیص اعداد صفر تا ۹، لایه خروجی میتواند ۱۰ مقدار احتمال داشته باشد.
نورون مصنوعی چگونه کار میکند؟
هر نورون چند ورودی دریافت میکند. هر ورودی در یک وزن ضرب میشود، سپس مقادیر با یک Bias جمع و از یک تابع فعالسازی عبور داده میشوند.
شکل ساده محاسبه یک نورون چنین است:
خروجی = تابع فعالسازی(
ورودی اول × وزن اول
+ ورودی دوم × وزن دوم
+ ...
+ Bias
)
وزنها مشخص میکنند هر ورودی چه میزان بر خروجی اثر دارد. در زمان آموزش، مدل این وزنها و Biasها را تغییر میدهد تا خطای پیشبینی کمتر شود.
تابع فعالسازی چیست؟
اگر همه لایههای شبکه فقط عملیات خطی انجام دهند، اضافه کردن لایههای بیشتر توانایی شبکه را به شکل معناداری افزایش نمیدهد.
توابع فعالسازی غیرخطی به شبکه اجازه میدهند روابط پیچیدهتری را یاد بگیرد.
ReLU
یکی از توابع رایج در لایههای پنهان است:
ReLU(x) = max(0, x)
اگر ورودی منفی باشد خروجی صفر و اگر مثبت باشد همان مقدار ورودی برگردانده میشود.
Sigmoid
خروجی را به بازه صفر تا یک تبدیل میکند و میتواند در دستهبندی دودویی استفاده شود.
Softmax
مجموعهای از مقادیر را به احتمالهایی تبدیل میکند که مجموع آنها برابر یک است. این تابع معمولاً در لایه خروجی دستهبندی چندکلاسه استفاده میشود.
مدل یادگیری عمیق چگونه آموزش میبیند؟
فرایند آموزش شبکه عصبی چند مرحله اصلی دارد.
۱. عبور رو به جلو
داده از لایه ورودی وارد میشود و از تمام لایههای شبکه عبور میکند تا پیشبینی تولید شود.
به این مرحله Forward Pass گفته میشود.
۲. محاسبه خطا
پیشبینی مدل با پاسخ صحیح مقایسه میشود. تابع هزینه یا Loss Function مقدار خطا را محاسبه میکند.
برای دستهبندی چندکلاسه معمولاً از Cross-Entropy و برای بعضی مسائل رگرسیون از Mean Squared Error استفاده میشود.
۳. انتشار معکوس خطا
الگوریتم Backpropagation محاسبه میکند که هر وزن چه سهمی در خطای نهایی داشته است.
این فرایند از لایه خروجی شروع میشود و به سمت لایههای ابتدایی حرکت میکند.
۴. بهروزرسانی وزنها
بهینهساز یا Optimizer با استفاده از گرادیانها، وزنهای شبکه را در جهتی تغییر میدهد که خطا کاهش پیدا کند.
بهینهسازهای رایج عبارتاند از:
- SGD
- Adam
- AdamW
- RMSprop
۵. تکرار آموزش
این فرایند روی تعداد زیادی نمونه و در چندین دور تکرار میشود. به هر دور کامل مشاهده داده آموزشی یک Epoch گفته میشود.
اصطلاحات مهم Deep Learning
Batch
به تعداد نمونههایی گفته میشود که قبل از بهروزرسانی وزنها همزمان پردازش میشوند.
Epoch
یک بار عبور کامل از تمام دادههای آموزشی است.
Learning Rate
اندازه تغییر وزنها در هر مرحله را تعیین میکند. مقدار بسیار بزرگ میتواند آموزش را ناپایدار کند و مقدار بسیار کوچک ممکن است آموزش را بیشازحد کند سازد.
Parameter
وزنها و Biasهایی هستند که مدل در زمان آموزش یاد میگیرد.
Hyperparameter
تنظیماتی مانند تعداد لایهها، تعداد نورونها، Batch Size و Learning Rate هستند که پیش از آموزش انتخاب میشوند.
Inference
استفاده از مدل آموزشدیده برای پردازش ورودی جدید و تولید نتیجه است.
Checkpoint
نسخه ذخیرهشده وزنها و وضعیت مدل در یک مرحله از آموزش است.
انواع شبکههای یادگیری عمیق
شبکه عصبی تماممتصل
در شبکه Fully Connected، هر نورون یک لایه به نورونهای لایه بعد متصل است.
این معماری برای دادههای کوچک و بعضی مسائل جدولی مناسب است، اما برای تصاویر بزرگ تعداد پارامترهای زیادی ایجاد میکند.
شبکه عصبی کانولوشنی
شبکههای CNN برای پردازش دادههایی با ساختار مکانی، بهویژه تصویر، طراحی شدهاند.
فیلترهای کانولوشنی روی بخشهای مختلف تصویر حرکت میکنند و الگوهایی مانند لبه، بافت و شکل را استخراج میکنند.
کاربردهای CNN عبارتاند از:
- دستهبندی تصویر
- تشخیص اشیا
- تشخیص چهره
- تقسیمبندی تصویر
- کنترل کیفیت محصول
- تحلیل ویدیو
شبکه عصبی بازگشتی
شبکههای RNN برای دادههای ترتیبی طراحی شدهاند. خروجی مرحله قبلی در محاسبه مرحله بعد اثر میگذارد.
از RNN در پردازش متن، صوت و سری زمانی استفاده شده است.
LSTM و GRU
این معماریها برای کاهش مشکلات RNNهای معمولی در یادگیری وابستگیهای طولانی طراحی شدهاند.
پیش از گسترش Transformerها، LSTM یکی از معماریهای رایج ترجمه ماشینی، تشخیص گفتار و پیشبینی سری زمانی بود.
Transformer
Transformer از مکانیزم Attention برای بررسی رابطه میان بخشهای مختلف ورودی استفاده میکند.
این معماری پایه بسیاری از مدلهای زبانی بزرگ، مدلهای چندوجهی و بعضی مدلهای تولید تصویر و ویدیو است.
برخلاف RNN، پردازش بخشهای مختلف دنباله در Transformer تا حد زیادی قابلیت موازیسازی دارد. این ویژگی آموزش مدلهای بزرگ را عملیتر کرده است.
Autoencoder
خودرمزگذار تلاش میکند داده ورودی را به یک نمایش فشرده تبدیل و سپس آن را بازسازی کند.
کاربردهای آن عبارتاند از:
- کاهش ابعاد
- حذف نویز
- تشخیص ناهنجاری
- فشردهسازی
- یادگیری فضای نهفته
شبکه مولد تخاصمی
GAN از دو شبکه تشکیل میشود:
- Generator داده مصنوعی تولید میکند.
- Discriminator تلاش میکند داده واقعی را از داده تولیدشده تشخیص دهد.
این دو شبکه در یک فرایند رقابتی آموزش میبینند. GANها در تولید تصویر نقش مهمی داشتهاند، هرچند آموزش آنها میتواند ناپایدار باشد.
مدل انتشار
Diffusion Model با افزودن تدریجی نویز به داده و یادگیری فرایند معکوس آن آموزش میبیند.
بسیاری از مدلهای جدید تولید و ویرایش تصویر و برخی مدلهای ویدیویی از معماریهای انتشار استفاده میکنند.
یادگیری عمیق چگونه ویژگیها را یاد میگیرد؟
یکی از مزایای اصلی Deep Learning، یادگیری خودکار نمایش داده است.
فرض کنید مدل باید تصویر خودرو را تشخیص دهد:
- پیکسلهای تصویر وارد شبکه میشوند.
- لایههای ابتدایی لبهها را شناسایی میکنند.
- لایههای بعدی منحنی، بافت و شکل را پیدا میکنند.
- لایههای عمیقتر چرخ، شیشه و بدنه را تشخیص میدهند.
- لایه خروجی احتمال تعلق تصویر به گروه خودرو را محاسبه میکند.
مدل این ویژگیها را مستقیماً با نام «چرخ» یا «شیشه» دریافت نمیکند. نمایشهای میانی در جریان آموزش و با هدف کاهش خطا شکل میگیرند.
چرا GPU برای یادگیری عمیق مهم است؟
آموزش شبکههای عصبی شامل تعداد زیادی ضرب ماتریسی است. GPU میتواند بسیاری از این عملیات را بهصورت موازی اجرا کند.
استفاده از GPU ممکن است زمان آموزش را از چند روز به چند ساعت کاهش دهد؛ اما میزان بهبود به معماری مدل، اندازه داده، حافظه GPU و نحوه پیادهسازی بستگی دارد.
برای پروژههای کوچک میتوان آموزش را با CPU شروع کرد. برای مدلهای بزرگتر معمولاً از GPU، TPU یا سایر شتابدهندهها استفاده میشود.
پیشرفت سختافزارهای پردازش موازی یکی از عوامل اصلی گسترش عملی Deep Learning بوده است. IBM: What is Deep Learning?
انتقال یادگیری چیست؟
آموزش یک مدل بزرگ از ابتدا میتواند به داده، سختافزار و زمان زیادی نیاز داشته باشد.
در Transfer Learning از مدلی استفاده میشود که قبلاً روی مجموعهداده بزرگی آموزش دیده است. سپس مدل برای کاربرد جدید تنظیم میشود.
برای مثال، یک مدل بینایی که قبلاً میلیونها تصویر دیده است، بسیاری از ویژگیهای عمومی تصویر را میشناسد. میتوان آن را با تعداد کمتری تصویر محصول برای کنترل کیفیت یک کارخانه تنظیم کرد.
مزایای انتقال یادگیری عبارتاند از:
- نیاز به داده کمتر
- زمان آموزش کوتاهتر
- هزینه پردازشی کمتر
- رسیدن سریعتر به نمونه اولیه
- استفاده از تواناییهای مدل پایه
Fine-tuning چیست؟
در Fine-tuning بخشی یا تمام وزنهای مدل از پیش آموزشدیده با داده جدید تنظیم میشوند.
فرایند معمول شامل این مراحل است:
- انتخاب مدل پایه
- آمادهسازی داده اختصاصی
- تعیین معیار ارزیابی
- آموزش با Learning Rate پایین
- ارزیابی روی داده دیدهنشده
- مقایسه با مدل پایه
- انتشار نسخه جدید
فاینتیونینگ زمانی مفید است که Prompt یا بازیابی اطلاعات بهتنهایی کیفیت لازم را ایجاد نکند و داده آموزشی مناسبی نیز وجود داشته باشد.
تفاوت آموزش، Fine-tuning و استفاده از API
| روش | هزینه و پیچیدگی | کاربرد |
|---|---|---|
| آموزش از ابتدا | بسیار زیاد | ساخت مدل پایه یا پژوهش تخصصی |
| Fine-tuning | متوسط تا زیاد | سازگار کردن مدل با وظیفه خاص |
| Prompt و RAG | متوسط | اتصال مدل به دستور و اطلاعات اختصاصی |
| استفاده مستقیم از API | کمترین زمان شروع | افزودن سریع قابلیت هوش مصنوعی |
بیشتر تیمهای نرمافزاری نیازی به آموزش مدل عمیق از ابتدا ندارند. آنها میتوانند از مدلهای آموزشدیده از طریق API استفاده کنند و منطق اختصاصی محصول را در نرمافزار خود نگه دارند.
آموزش عملی Deep Learning با TensorFlow
در این مثال یک شبکه عصبی برای تشخیص اعداد دستنویس صفر تا ۹ میسازیم.
از مجموعهداده MNIST استفاده میکنیم. این مجموعه شامل تصاویر سیاهوسفید ۲۸ در ۲۸ پیکسل از اعداد دستنویس است و از طریق Keras قابل دریافت است. مستندات MNIST در Keras
نصب کتابخانهها
pip install tensorflow matplotlib
بارگذاری داده
import tensorflow as tf

from tensorflow import keras


(
    x_train,
    y_train,
), (
    x_test,
    y_test,
) = keras.datasets.mnist.load_data()

print(x_train.shape)
print(y_train.shape)
تصاویر آموزشی در آرایه x_train و برچسب صحیح آنها در y_train قرار دارد.
آمادهسازی تصاویر
مقدار پیکسلها بین صفر تا ۲۵۵ است. آنها را به بازه صفر تا یک تبدیل میکنیم:
x_train = x_train.astype("float32") / 255.0
x_test = x_test.astype("float32") / 255.0
این مقیاسبندی معمولاً آموزش شبکه را پایدارتر میکند.
نمایش یک نمونه
import matplotlib.pyplot as plt


plt.imshow(
    x_train[0],
    cmap="gray",
)

plt.title(
    f"Label: {y_train[0]}"
)

plt.axis("off")
plt.show()
ساخت شبکه عصبی
model = keras.Sequential(
    [
        keras.layers.Input(
            shape=(28, 28)
        ),
        keras.layers.Flatten(),
        keras.layers.Dense(
            128,
            activation="relu",
        ),
        keras.layers.Dropout(0.2),
        keras.layers.Dense(
            10,
            activation="softmax",
        ),
    ]
)
نقش لایهها:
Inputشکل تصویر ورودی را تعیین میکند.Flattenتصویر دوبعدی را به بردار تبدیل میکند.Denseبا ۱۲۸ نورون الگوهای داده را یاد میگیرد.Dropoutبرای کاهش بیشبرازش بخشی از اتصالها را هنگام آموزش موقتاً غیرفعال میکند.- لایه آخر احتمال تعلق تصویر به هرکدام از ۱۰ عدد را تولید میکند.
آمادهسازی مدل برای آموزش
model.compile(
    optimizer="adam",
    loss=(
        "sparse_categorical_"
        "crossentropy"
    ),
    metrics=["accuracy"],
)
آموزش شبکه
history = model.fit(
    x_train,
    y_train,
    epochs=5,
    batch_size=64,
    validation_split=0.1,
)
ده درصد داده آموزشی برای اعتبارسنجی کنار گذاشته میشود.
راهنمای رسمی TensorFlow نیز یک نمونه مقدماتی مشابه برای دستهبندی اعداد دستنویس ارائه میکند. TensorFlow Quickstart
ارزیابی مدل
test_loss, test_accuracy = (
    model.evaluate(
        x_test,
        y_test,
        verbose=0,
    )
)

print(
    f"Test accuracy: "
    f"{test_accuracy:.4f}"
)
عملکرد داده آزمون اهمیت بیشتری از داده آموزش دارد؛ زیرا نشان میدهد مدل روی تصاویر دیدهنشده چگونه عمل میکند.
پیشبینی یک تصویر
import numpy as np


probabilities = model.predict(
    x_test[:1],
    verbose=0,
)

predicted_class = int(
    np.argmax(probabilities[0])
)

actual_class = int(y_test[0])

print(
    "Predicted:",
    predicted_class,
)

print(
    "Actual:",
    actual_class,
)
ذخیره مدل
model.save(
    "mnist_digit_model.keras"
)
بارگذاری مجدد:
loaded_model = (
    keras.models.load_model(
        "mnist_digit_model.keras"
    )
)
این مثال برای آموزش مفاهیم مناسب است. برای استفاده عملی باید نسخه داده، کد پیشپردازش، معیارها و نسخه مدل نیز ثبت شوند.
نسخه بهتر با CNN
شبکه تماممتصل موقعیت مکانی پیکسلها را بهخوبی حفظ نمیکند. برای پردازش تصویر میتوان از CNN استفاده کرد:
x_train_cnn = x_train[..., None]
x_test_cnn = x_test[..., None]

cnn_model = keras.Sequential(
    [
        keras.layers.Input(
            shape=(28, 28, 1)
        ),
        keras.layers.Conv2D(
            32,
            kernel_size=3,
            activation="relu",
        ),
        keras.layers.MaxPooling2D(),
        keras.layers.Conv2D(
            64,
            kernel_size=3,
            activation="relu",
        ),
        keras.layers.MaxPooling2D(),
        keras.layers.Flatten(),
        keras.layers.Dense(
            64,
            activation="relu",
        ),
        keras.layers.Dropout(0.3),
        keras.layers.Dense(
            10,
            activation="softmax",
        ),
    ]
)

cnn_model.compile(
    optimizer="adam",
    loss=(
        "sparse_categorical_"
        "crossentropy"
    ),
    metrics=["accuracy"],
)

cnn_model.fit(
    x_train_cnn,
    y_train,
    epochs=5,
    batch_size=64,
    validation_split=0.1,
)

cnn_model.evaluate(
    x_test_cnn,
    y_test,
)
لایههای کانولوشنی ویژگیهای محلی تصویر را استخراج میکنند و معمولاً برای این نوع داده مناسبترند.
استفاده از PyTorch
PyTorch یکی دیگر از چارچوبهای متنباز محبوب Deep Learning است.
در PyTorch معمولاً این مراحل انجام میشوند:
- تعریف Dataset و DataLoader
- ساخت کلاس مدل
- انتخاب تابع هزینه
- انتخاب Optimizer
- اجرای حلقه آموزش
- محاسبه گرادیان
- بهروزرسانی وزنها
- ارزیابی و ذخیره مدل
برای شروع میتوانید از راهنمای رسمی PyTorch استفاده کنید.
TensorFlow و PyTorch هر دو برای ساخت مدلهای واقعی مناسباند. انتخاب میان آنها به تجربه تیم، اکوسیستم پروژه، مدل موردنیاز و روش استقرار بستگی دارد.
کاربردهای یادگیری عمیق
پردازش تصویر
- دستهبندی تصاویر
- تشخیص اشیا
- خواندن متن تصویر
- تقسیمبندی تصویر
- افزایش کیفیت عکس
- تولید و ویرایش تصویر
پردازش زبان
- تولید متن
- ترجمه
- خلاصهسازی
- پاسخگویی به سؤال
- تحلیل احساسات
- استخراج اطلاعات
- جستوجوی معنایی
صوت و گفتار
- تبدیل گفتار به متن
- تبدیل متن به گفتار
- تشخیص گوینده
- حذف نویز
- ترجمه صوت
- ساخت دستیار صوتی
ویدیو
- تولید ویدیو
- تشخیص رویداد
- ردیابی اشیا
- خلاصهسازی ویدیو
- تولید زیرنویس
- ساخت انیمیشن
سیستمهای پیشنهاددهنده
مدل میتواند رفتار کاربران و ویژگیهای محتوا را تحلیل کند و محصول، فیلم، موسیقی یا مقاله مناسب پیشنهاد دهد.
دادههای سری زمانی
شبکههای عصبی برای پیشبینی تقاضا، تحلیل حسگر و شناسایی الگوهای زمانی نیز استفاده میشوند؛ اما باید عملکرد آنها با روشهای سادهتر مقایسه شود.
استفاده از مدل Deep Learning آماده با API درواره
آموزش یک مدل چندوجهی یا مدل زبانی بزرگ از ابتدا برای بیشتر کسبوکارها منطقی نیست.
از طریق درواره میتوان به مدلهای آموزشدیده مختلف با یک API سازگار با OpenAI دسترسی پیدا کرد.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
برای مثال، میتوان یک تصویر محصول را به مدل بینایی ارسال کرد و اطلاعات قابلاستفاده برای فروشگاه دریافت کرد.
ابتدا کتابخانه را نصب کنید:
pip install openai
متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_VISION_MODEL_ID"
شناسه مدلی را انتخاب کنید که از ورودی تصویر پشتیبانی کند.
تبدیل تصویر به Base64
import base64
import mimetypes


def image_to_data_url(
    image_path: str,
) -> str:
    mime_type, _ = (
        mimetypes.guess_type(
            image_path
        )
    )

    if not mime_type:
        mime_type = "image/jpeg"

    with open(
        image_path,
        "rb",
    ) as image_file:
        encoded = base64.b64encode(
            image_file.read()
        ).decode("utf-8")

    return (
        f"data:{mime_type};"
        f"base64,{encoded}"
    )
ارسال تصویر به مدل
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ[
"DARVAREH_API_KEY"
],
base_url=(
"https://api.darvareh.ir/v1"
),
)
MODEL_ID = os.environ[
"DARVAREH_MODEL"
]
def analyze_product_image(
image_path: str,
) -> str:
image_data = image_to_data_url(
image_path
)
response = (
client.chat.completions.create(
model=MODEL_ID,
temperature=0.2,
messages=[
{
"role": "system",
"content": (
"شما دستیار استخراج "
"اطلاعات محصول از تصویر "
"هستید."
),
},
{
"role": "user",
"content": [
{
"type": "text",
"text": (
"این تصویر محصول را "
"تحلیل کن. نوع محصول، "
"رنگ، جنس احتمالی و "
"ویژگیهای قابل مشاهده "
"را بنویس. درباره موارد "
"نامشخص حدس قطعی نزن."
),
},
{
"type": "image_url",
"image_url": {
"url": image_data
},
},
],
},
],
)
)
content = (
response
.choices[0]
.message
.content
)
if not content:
raise ValueError(
"پاسخی از مدل دریافت نشد."
)
return content
فراخوانی تابع:
result = analyze_product_image(
    "product.jpg"
)

print(result)
پشتیبانی از تصویر و قالب درخواست ممکن است میان مدلها متفاوت باشد. پیش از انتخاب مدل، قابلیتهای فعلی آن را در مستندات و فهرست مدلهای درواره بررسی کنید.
ساخت یک محصول مبتنی بر Deep Learning
معماری پیشنهادی برای یک قابلیت تحلیل تصویر:
کاربر
↓
بارگذاری تصویر در اپلیکیشن
↓
سرور نرمافزار
↓
اعتبارسنجی و آمادهسازی تصویر
↓
API درواره
↓
مدل بینایی انتخابشده
↓
اعتبارسنجی خروجی
↓
ذخیره یا نمایش نتیجه
کلید API باید فقط در سمت سرور نگهداری شود. رابط کاربری نباید مستقیماً کلید را دریافت کند.
چه زمانی مدل آماده بهتر است؟
مدل آماده انتخاب مناسبی است اگر:
- میخواهید سریع نمونه اولیه بسازید.
- داده کافی برای آموزش ندارید.
- مسئله عمومی مانند تولید متن یا تحلیل تصویر است.
- نمیخواهید زیرساخت GPU را مدیریت کنید.
- مصرف پروژه در ابتدا مشخص نیست.
- میخواهید چند مدل را مقایسه کنید.
- قابلیتهای مدل بهسرعت در حال تغییر هستند.
چه زمانی آموزش مدل اختصاصی منطقی است؟
آموزش یا Fine-tuning زمانی ارزش بررسی دارد که:
- داده تخصصی و کافی دارید.
- مدلهای آماده روی کاربرد شما کیفیت لازم ندارند.
- خروجی مطلوب قابلاندازهگیری است.
- مسئله در مقیاس بالا تکرار میشود.
- تیم توان ارزیابی و نگهداری مدل را دارد.
- هزینه آموزش و استقرار توجیهپذیر است.
- کنترل بیشتر روی رفتار مدل ضروری است.
در بسیاری از پروژهها، معماری ترکیبی مناسبتر است: مدل آماده برای قابلیت عمومی و مدل کوچک اختصاصی برای منطق تخصصی استفاده میشود.
چگونه هزینه Deep Learning را کاهش دهیم؟
از مدل آماده شروع کنید
پیش از آموزش از ابتدا، کیفیت مدلهای موجود را روی داده واقعی بررسی کنید.
مدل را متناسب با وظیفه انتخاب کنید
همیشه بزرگترین مدل بهترین انتخاب نیست. مدل کوچکتر ممکن است برای دستهبندی یا استخراج ساده، سریعتر و اقتصادیتر باشد.
ورودی را کنترل کنید
تصویر با ابعاد بسیار بزرگ یا متن غیرمرتبط میتواند هزینه و زمان پردازش را افزایش دهد.
پردازش را دستهای انجام دهید
اگر پاسخ فوری لازم نیست، نمونهها را در Batch پردازش کنید.
نتیجههای ثابت را Cache کنید
یک ورودی یکسان نباید بدون دلیل چندین بار پردازش شود.
از انتقال یادگیری استفاده کنید
Fine-tuning یک مدل از پیش آموزشدیده معمولاً از آموزش مدل از ابتدا ارزانتر است.
کیفیت چند مدل را مقایسه کنید
مدلها را روی یک مجموعه ارزیابی ثابت از نظر کیفیت، سرعت و هزینه بسنجید.
چالشهای یادگیری عمیق
نیاز به داده
مدلهای بزرگ معمولاً به داده فراوان نیاز دارند. داده باید مرتبط، تمیز و نماینده شرایط واقعی باشد.
هزینه محاسباتی
آموزش و اجرای شبکه عمیق میتواند به GPU، حافظه و انرژی زیادی نیاز داشته باشد.
توضیحپذیری محدود
مشخص کردن دلیل دقیق تصمیم یک شبکه بزرگ معمولاً دشوارتر از یک مدل خطی یا درخت تصمیم است.
بیشبرازش
مدل ممکن است داده آموزشی را حفظ کند و روی داده جدید عملکرد ضعیفی داشته باشد.
تغییر داده
اگر ورودی واقعی با داده آموزشی متفاوت شود، کیفیت مدل کاهش پیدا میکند.
پیچیدگی استقرار
نسخهبندی مدل، مدیریت حافظه، زمان پاسخ، مقیاسپذیری و پایش، بخشی از کار تولیدی هستند.
اشتباهات رایج در Deep Learning
انتخاب شبکه عصبی برای هر مسئله
برای بعضی دادههای جدولی، روشهای کلاسیک عملکرد بهتر یا هزینه کمتری دارند.
آموزش بدون خط مبنا
ابتدا یک مدل ساده بسازید. شبکه عمیق باید بهبود معناداری نسبت به آن ایجاد کند.
ارزیابی با داده آموزشی
عملکرد خوب روی داده آموزش به معنای تعمیم مناسب نیست.
نادیده گرفتن کیفیت برچسبها
برچسب اشتباه باعث میشود مدل رابطه نادرستی یاد بگیرد.
استفاده از Accuracy بهتنهایی
برای داده نامتوازن باید معیارهایی مانند Precision، Recall، F1 و ROC-AUC نیز بررسی شوند.
افزایش بیدلیل تعداد لایهها
شبکه بزرگتر الزاماً بهتر نیست و ممکن است هزینه و بیشبرازش را افزایش دهد.
نداشتن نسخهبندی
داده، کد، تنظیمات، وزنها و معیارهای هر نسخه باید ثبت شوند.
بازتولید نکردن آزمایش
Random Seed، نسخه کتابخانهها و محیط اجرا باید تا حد امکان مشخص باشند.
مسیر یادگیری Deep Learning
مرحله اول: پایتون
با توابع، کلاسها، آرایهها، مدیریت فایل و محیط مجازی آشنا شوید.
مرحله دوم: NumPy و Pandas
عملیات برداری، ماتریسها و آمادهسازی داده را یاد بگیرید.
مرحله سوم: یادگیری ماشین
پیش از Deep Learning باید مفاهیمی مانند آموزش، آزمون، بیشبرازش و معیارهای ارزیابی را بدانید.
مرحله چهارم: ریاضی پایه
موضوعات مهم عبارتاند از:
- بردار و ماتریس
- ضرب ماتریسی
- مشتق
- قاعده زنجیرهای
- احتمال
- توزیعها
- بهینهسازی
مرحله پنجم: شبکه عصبی ساده
یک شبکه کوچک را با TensorFlow یا PyTorch آموزش دهید و نمودار Loss را بررسی کنید.
مرحله ششم: CNN و Transformer
معماری مناسب حوزه موردنظر خود را یاد بگیرید.
مرحله هفتم: مدل از پیش آموزشدیده
انتقال یادگیری، Fine-tuning و ارزیابی مدل آماده را تمرین کنید.
مرحله هشتم: استقرار
مدل را پشت API قرار دهید و زمان پاسخ، مصرف حافظه و کیفیت خروجی را پایش کنید.
پرسشهای متداول
یادگیری عمیق به زبان ساده چیست؟
یادگیری عمیق روشی در یادگیری ماشین است که با استفاده از شبکههای عصبی چندلایه، الگوهای پیچیده موجود در دادههایی مانند متن، تصویر و صوت را یاد میگیرد.
چرا به آن یادگیری عمیق میگویند؟
کلمه عمیق به وجود چندین لایه پردازشی در شبکه عصبی اشاره دارد.
آیا Deep Learning همان شبکه عصبی است؟
این دو کاملاً مترادف نیستند. یادگیری عمیق معمولاً به آموزش شبکههای عصبی دارای چندین لایه گفته میشود.
آیا ChatGPT و مدلهای زبانی از Deep Learning استفاده میکنند؟
بله. مدلهای زبانی بزرگ بر پایه شبکههای عصبی عمیق و معمولاً معماری Transformer ساخته میشوند.
آیا برای Deep Learning باید GPU داشته باشیم؟
برای مثالهای کوچک CPU کافی است. آموزش مدلهای بزرگتر با GPU یا شتابدهنده بسیار سریعتر خواهد بود. برای استفاده از مدل آماده از طریق API، لازم نیست کاربر شخصاً GPU تهیه کند.
TensorFlow بهتر است یا PyTorch؟
هر دو چارچوب توانمند هستند. انتخاب به تجربه تیم، مدلهای موجود، ابزارهای استقرار و نیاز پروژه بستگی دارد.
آیا میتوان بدون آموزش مدل از Deep Learning استفاده کرد؟
بله. بسیاری از توسعهدهندگان از مدلهای آموزشدیده از طریق API استفاده میکنند و نیازی به آموزش یا میزبانی مستقیم مدل ندارند.
Fine-tuning چه تفاوتی با Prompt Engineering دارد؟
در Prompt Engineering وزنهای مدل تغییر نمیکنند و فقط ورودی بهینه میشود. در Fine-tuning وزنهای مدل با داده آموزشی جدید تنظیم میشوند.
آیا Deep Learning برای دادههای کم مناسب است؟
آموزش از ابتدا معمولاً دشوار است، اما انتقال یادگیری و مدلهای از پیش آموزشدیده میتوانند نیاز به داده را کاهش دهند.
چگونه مدل مناسب را انتخاب کنیم؟
چند مدل را روی مجموعهای ثابت از نمونههای واقعی مقایسه کنید و کیفیت، سرعت، هزینه، ثبات و محدودیتهای آنها را بسنجید.
درواره چه کمکی به پروژه Deep Learning میکند؟
درواره امکان دسترسی به مدلهای آموزشدیده متن، تصویر، صوت و ویدیو را از طریق یک API یکپارچه فراهم میکند. توسعهدهنده میتواند بدون مدیریت زیرساخت مدل، قابلیت هوش مصنوعی را داخل محصول خود قرار دهد.
جمعبندی
یادگیری عمیق زیرمجموعهای از یادگیری ماشین است که از شبکههای عصبی چندلایه برای یادگیری الگوهای پیچیده استفاده میکند.
برای استفاده موفق از Deep Learning باید:
- مسئله را دقیق تعریف کنید.
- روشهای سادهتر را بهعنوان خط مبنا آزمایش کنید.
- داده باکیفیت و نماینده شرایط واقعی آماده کنید.
- معماری مناسب نوع داده را انتخاب کنید.
- داده آموزش، اعتبارسنجی و آزمون را جدا نگه دارید.
- بیشبرازش و تغییر داده را پایش کنید.
- بین آموزش از ابتدا، Fine-tuning و استفاده از API آگاهانه تصمیم بگیرید.
- مدل را بر اساس کیفیت، سرعت و هزینه واقعی ارزیابی کنید.
اگر هدف شما افزودن قابلیتهایی مانند تولید متن، تحلیل تصویر، پردازش صوت یا ساخت ویدیو به یک وبسایت یا اپلیکیشن است، معمولاً استفاده از مدل آماده سریعتر از آموزش مدل از ابتدا خواهد بود.
برای شروع میتوانید به مستندات API درواره مراجعه کنید.
درواره با یک API سازگار با OpenAI، کیف پول ریالی و دسترسی یکپارچه به مدلهای مختلف، امکان آزمایش و توسعه محصولات مبتنی بر یادگیری عمیق را برای توسعهدهندگان ایرانی فراهم میکند.
مقالات مرتبط
- یادگیری ماشین چیست؟
- هوش مصنوعی چیست؟
- مدل زبانی بزرگ چیست؟
- هوش مصنوعی چندوجهی چیست؟
- آموزش TensorFlow و Keras
- آموزش PyTorch
- آموزش Hugging Face Transformers
- فاینتیونینگ مدل زبانی با LoRA و QLoRA
- آموزش اتصال API هوش مصنوعی به نرمافزار
منابع
- Nature: Deep Learning
- IBM: What is Deep Learning?
- TensorFlow Quickstart for Beginners
- PyTorch Quickstart
- Keras MNIST Dataset
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.