بینایی ماشین چیست؟ راهنمای کامل Computer Vision با مثال عملی
بینایی ماشین یا Computer Vision شاخهای از هوش مصنوعی است که به کامپیوترها امکان میدهد تصاویر و ویدیوها را تحلیل و تفسیر کنند. در این راهنمای جامع با پردازش تصویر، تشخیص اشیا، تقسیمبندی، OCR، ابزارهای متنباز و ساخت یک برنامه تحلیل تصویر با پایتون و API درواره آشنا میشوید.
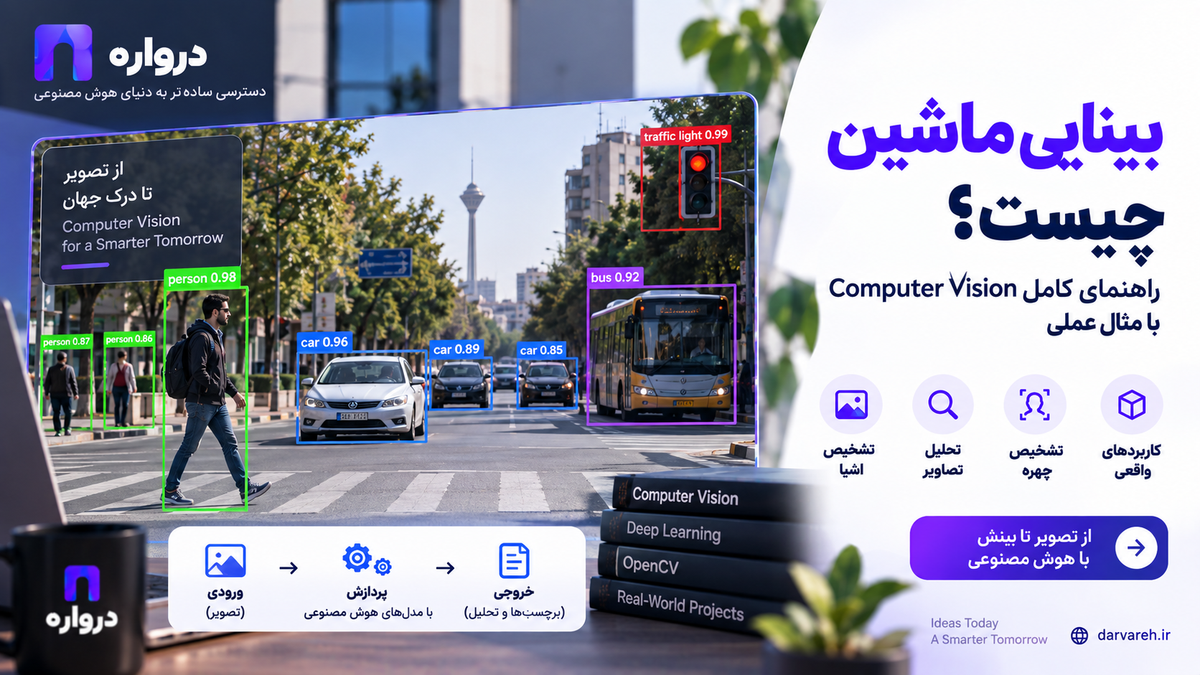
بینایی ماشین یا Computer Vision فناوریای است که به کامپیوترها کمک میکند اطلاعات موجود در تصویر و ویدیو را پردازش و تفسیر کنند.
یک سیستم بینایی ماشین میتواند محصولات موجود در تصویر را شناسایی کند، عیب یک قطعه را پیدا کند، نوشته داخل سند را بخواند، تعداد اشیا را بشمارد یا تغییر موقعیت یک شیء را در ویدیو دنبال کند.
بینایی ماشین در کاربردهای مختلفی حضور دارد:
- تشخیص اشیا در تصویر
- کنترل کیفیت خطوط تولید
- استخراج متن از اسناد
- جستوجوی تصویری محصول
- تحلیل تصاویر ماهوارهای
- فروشگاههای هوشمند
- خودروهای خودران
- رباتیک
- واقعیت افزوده
- تحلیل ویدیو
- تولید و ویرایش تصویر
- دستهبندی خودکار تصاویر
تا چند سال پیش، ساخت بسیاری از این قابلیتها به آموزش یک مدل تخصصی نیاز داشت. اکنون مدلهای بینایی و چندوجهی آماده میتوانند تصویر را همراه دستور متنی دریافت کنند و نتیجهای مانند توضیح تصویر، استخراج ویژگی محصول یا پاسخ به پرسش تولید کنند.
در این مقاله ابتدا مفاهیم Computer Vision را بررسی میکنیم، سپس یک برنامه تشخیص اشیا با YOLO میسازیم و در پایان، تحلیل تصویر با API درواره را آموزش میدهیم.
بینایی ماشین یا Computer Vision چیست؟
بینایی ماشین زیرشاخهای از هوش مصنوعی است که روی پردازش، تحلیل و تفسیر دادههای بصری مانند تصویر و ویدیو تمرکز دارد.
هدف این حوزه فقط نمایش یا ویرایش تصویر نیست. سیستم باید بتواند از داده بصری اطلاعات معنادار استخراج کند.
IBM بینایی ماشین را شاخهای از هوش مصنوعی تعریف میکند که به ماشینها توانایی پردازش، تحلیل و تفسیر ورودیهای بصری را میدهد. IBM: What Is Computer Vision?
برای مثال، یک تصویر برای انسان ممکن است نمایی از خیابان، چند خودرو و عابران پیاده باشد. برای کامپیوتر، همان تصویر در ابتدا فقط مجموعهای از مقادیر عددی پیکسلها است.
مدل بینایی ماشین باید از این اعداد به مفاهیمی مانند موارد زیر برسد:
- خودرو
- عابر پیاده
- تابلو
- خیابان
- موقعیت هر شیء
- ارتباط میان اشیا
- رویداد در حال وقوع
تفاوت بینایی ماشین و پردازش تصویر چیست؟
پردازش تصویر و بینایی ماشین با یکدیگر مرتبطاند، اما هدف یکسانی ندارند.
پردازش تصویر
در Image Processing ورودی و خروجی معمولاً تصویر هستند.
نمونهها:
- تغییر اندازه تصویر
- تنظیم روشنایی
- افزایش کنتراست
- حذف نویز
- تبدیل تصویر رنگی به خاکستری
- چرخاندن تصویر
- تشخیص لبه
- فشردهسازی تصویر
بینایی ماشین
در Computer Vision هدف استخراج مفهوم یا اطلاعات از تصویر است.
نمونهها:
- تشخیص نوع محصول
- پیدا کردن خودروها
- شمارش افراد
- خواندن شماره فاکتور
- شناسایی عیب قطعه
- تشخیص وضعیت یک صحنه
پردازش تصویر معمولاً یکی از مراحل آمادهسازی ورودی برای یک سیستم بینایی ماشین است.
| ویژگی | پردازش تصویر | بینایی ماشین |
|---|---|---|
| هدف | تغییر یا بهبود تصویر | درک محتوای تصویر |
| ورودی | تصویر | تصویر یا ویدیو |
| خروجی | تصویر جدید | برچسب، مختصات، متن یا تحلیل |
| نمونه | حذف نویز | تشخیص محصول |
| نیاز به مدل یادگیری | همیشه لازم نیست | در روشهای جدید معمولاً استفاده میشود |
تفاوت بینایی ماشین و هوش مصنوعی چندوجهی
مدل بینایی سنتی معمولاً برای یک وظیفه مشخص مانند تشخیص اشیا آموزش داده میشود.
مدل چندوجهی میتواند چند نوع داده را همزمان پردازش کند:
- متن
- تصویر
- صوت
- ویدیو
برای مثال، کاربر میتواند تصویر یک محصول را همراه این پرسش ارسال کند:
رنگ، جنس احتمالی و ویژگیهای قابل مشاهده این محصول چیست؟
مدل چندوجهی باید تصویر را تحلیل و پاسخ را به زبان طبیعی یا JSON تولید کند.
بنابراین، بینایی ماشین یک حوزه گسترده است و مدلهای Vision-Language یکی از فناوریهای جدید مورد استفاده در آن محسوب میشوند.
تصویر در کامپیوتر چگونه نمایش داده میشود؟
تصویر دیجیتال از پیکسلها تشکیل شده است.
در تصویر سیاهوسفید، هر پیکسل ممکن است مقداری میان صفر تا ۲۵۵ داشته باشد:
- صفر معمولاً نشاندهنده سیاه است.
- ۲۵۵ معمولاً نشاندهنده سفید است.
- مقادیر میان آنها درجات خاکستری هستند.
در یک تصویر RGB، هر پیکسل معمولاً سه مقدار دارد:
Red
Green
Blue
برای مثال:
[255, 0, 0] = قرمز
[0, 255, 0] = سبز
[0, 0, 255] = آبی
یک تصویر رنگی ۱۹۲۰ در ۱۰۸۰ پیکسل شامل میلیونها مقدار عددی است. مدل باید از میان این اعداد الگوهای بصری مهم را یاد بگیرد.
بینایی ماشین چگونه کار میکند؟
فرایند ساخت یک سیستم Computer Vision معمولاً شامل مراحل زیر است.
۱. تعریف مسئله
ابتدا باید خروجی موردنیاز مشخص شود.
نمونه مسئلههای دقیق:
- تشخیص وجود یا نبود محصول معیوب
- شمارش خودروهای واردشده به پارکینگ
- استخراج نام و قیمت از تصویر کالا
- پیدا کردن محل بستهها در انبار
- دستهبندی تصاویر محصولات
- خواندن کد رهگیری از بستهبندی
عبارت «میخواهیم تصاویر را با هوش مصنوعی تحلیل کنیم» هدف اجرایی دقیقی نیست.
۲. جمعآوری تصاویر
داده میتواند از منابع زیر جمعآوری شود:
- دوربین
- گوشی کاربران
- آرشیو شرکت
- اسکنر
- پهپاد
- ماهواره
- تصاویر محصول
- مجموعهداده عمومی
داده باید شرایط واقعی محصول را پوشش دهد:
- نورهای مختلف
- زاویههای متفاوت
- پسزمینههای مختلف
- کیفیتهای متفاوت دوربین
- اندازههای مختلف شیء
- اشیای ناقص یا پوشیدهشده
۳. برچسبگذاری
نوع برچسب به وظیفه بستگی دارد.
برچسب کلاس
برای دستهبندی کل تصویر:
سالم
معیوب
Bounding Box
برای مشخص کردن محل شیء با یک کادر مستطیلی.
برچسب پیکسلی
برای تعیین کلاس هر پیکسل در تقسیمبندی تصویر.
نقاط کلیدی
برای مشخص کردن نقاطی مانند مفاصل بدن یا گوشههای یک شیء.
کیفیت برچسبها مستقیماً روی کیفیت مدل اثر میگذارد.
۴. پیشپردازش
عملیات رایج پیشپردازش عبارتاند از:
- تغییر اندازه
- اصلاح نسبت تصویر
- نرمالسازی مقدار پیکسل
- کاهش نویز
- تنظیم روشنایی
- تبدیل فضای رنگی
- برش تصویر
- اصلاح جهت
پیشپردازش زمان آموزش و زمان استفاده از مدل باید یکسان باشد.
۵. افزایش داده
Data Augmentation با ایجاد تغییرات کنترلشده، تنوع داده آموزشی را افزایش میدهد.
نمونهها:
- چرخاندن
- برش
- جابهجایی
- تغییر نور
- بزرگنمایی
- معکوس کردن افقی
- افزودن نویز محدود
تغییر باید با شرایط واقعی سازگار باشد. برای مثال، وارونه کردن یک سند یا تابلو ممکن است نمونه غیرواقعی ایجاد کند.
۶. انتخاب مدل
انتخاب مدل به نوع وظیفه، سرعت موردنیاز، سختافزار و دقت مطلوب بستگی دارد.
۷. آموزش یا استفاده از مدل آماده
سه مسیر اصلی وجود دارد:
- آموزش مدل از ابتدا
- Fine-tuning مدل از پیش آموزشدیده
- استفاده مستقیم از مدل آماده یا API
۸. ارزیابی
مدل باید روی تصاویر دیدهنشده و شرایط واقعی بررسی شود.
۹. استقرار
مدل میتواند در یکی از محیطهای زیر اجرا شود:
- سرور
- فضای ابری
- اپلیکیشن موبایل
- دوربین هوشمند
- دستگاه صنعتی
- مرورگر
- سیستم Edge
۱۰. پایش
کیفیت دوربین، نور، محصولات و محیط ممکن است تغییر کند. عملکرد مدل باید پس از انتشار نیز اندازهگیری شود.
مهمترین وظایف بینایی ماشین
دستهبندی تصویر
در Image Classification کل تصویر در یک یا چند دسته قرار میگیرد.
مثال:
تصویر محصول → کفش
یا:
تصویر قطعه → سالم
دستهبندی محل شیء را مشخص نمیکند و فقط برچسب کلی تولید میکند.
تشخیص اشیا
در Object Detection مدل علاوه بر نوع شیء، محل آن را با Bounding Box مشخص میکند.
مثال:
خودرو: [x1, y1, x2, y2]
عابر پیاده: [x1, y1, x2, y2]
تشخیص اشیا برای شمارش، کنترل موجودی، تحلیل ترافیک و رباتیک استفاده میشود.
تقسیمبندی معنایی
در Semantic Segmentation برای هر پیکسل یک کلاس تعیین میشود.
برای مثال، تمام پیکسلهای مربوط به خیابان، خودرو و پیادهرو جدا میشوند.
تقسیمبندی نمونهها
Instance Segmentation علاوه بر کلاس هر پیکسل، نمونههای جداگانه یک کلاس را نیز از هم تفکیک میکند.
اگر سه خودرو در تصویر وجود داشته باشند، مرز هر خودرو جداگانه مشخص میشود.
ردیابی اشیا
Object Tracking یک شیء را در فریمهای متوالی ویدیو دنبال میکند.
کاربردها:
- شمارش افراد
- تحلیل حرکت
- مدیریت ترافیک
- ردیابی بسته
- تحلیل مسابقه
- نظارت خط تولید
تخمین وضعیت بدن
Pose Estimation موقعیت نقاط مختلف بدن یا شیء را تخمین میزند.
نمونه نقاط بدن:
- سر
- شانه
- آرنج
- مچ
- لگن
- زانو
- مچ پا
OCR
تشخیص نوری نویسه یا OCR متن را از تصویر و سند اسکنشده استخراج میکند.
کاربردها:
- خواندن فاکتور
- دیجیتالسازی اسناد
- استخراج شماره سریال
- خواندن برچسب کالا
- تبدیل دستنوشته به متن
درک صحنه
Scene Understanding فقط اشیا را تشخیص نمیدهد، بلکه رابطه و وضعیت آنها را نیز تحلیل میکند.
برای مثال:
یک خودرو کنار خیابان پارک شده است.
فردی یک بسته را روی میز قرار میدهد.
توصیف تصویر
Image Captioning توضیحی متنی درباره محتوای تصویر تولید میکند.
پاسخ به پرسش تصویری
در Visual Question Answering مدل تصویر و سؤال متنی را همزمان دریافت میکند.
مثال:
سؤال: چند صندلی در تصویر وجود دارد؟
پاسخ: چهار صندلی
جستوجوی تصویری
سیستم با استفاده از تصویر، محصولات یا تصاویر مشابه را پیدا میکند.
معماریهای پرکاربرد Computer Vision
CNN
شبکه عصبی کانولوشنی یا CNN از فیلترهایی استفاده میکند که روی تصویر حرکت میکنند و ویژگیهایی مانند لبه، شکل و بافت را یاد میگیرند.
بخشهای رایج CNN عبارتاند از:
- لایه کانولوشن
- تابع فعالسازی
- Pooling
- لایه تماممتصل
- لایه خروجی
CNNها سالها معماری اصلی بسیاری از وظایف تصویری بودهاند.
Vision Transformer
Vision Transformer یا ViT تصویر را به مجموعهای از Patchها تقسیم و آنها را مشابه توکنهای یک دنباله پردازش میکند.
مکانیزم Self-Attention رابطه میان بخشهای مختلف تصویر را یاد میگیرد.
YOLO
YOLO خانوادهای از مدلهای تشخیص اشیا است که کلاس و موقعیت اشیا را با یک جریان استنتاج سریع پیشبینی میکند.
این مدلها برای تشخیص بلادرنگ اشیا کاربرد زیادی دارند.
مدلهای Vision-Language
این مدلها تصویر و زبان را در یک فضای مشترک پردازش میکنند.
قابلیتهای آنها میتواند شامل موارد زیر باشد:
- توضیح تصویر
- پاسخ به سؤال تصویری
- استخراج اطلاعات
- مقایسه تصاویر
- درک اسناد
- تحلیل رابط کاربری
- تولید خروجی JSON
ابزارهای پرکاربرد بینایی ماشین
| ابزار | کاربرد |
|---|---|
| OpenCV | پردازش تصویر و ویدیو |
| Pillow | عملیات ساده روی تصویر در پایتون |
| Scikit-image | الگوریتمهای پردازش تصویر |
| TensorFlow و Keras | آموزش شبکههای عصبی |
| PyTorch | توسعه و آموزش مدلهای عمیق |
| Torchvision | مدلها و ابزارهای تصویری PyTorch |
| Ultralytics YOLO | تشخیص و تقسیمبندی اشیا |
| Detectron2 | تشخیص و تقسیمبندی پیشرفته |
| Albumentations | افزایش داده تصویری |
| CVAT | برچسبگذاری تصویر و ویدیو |
| Label Studio | برچسبگذاری انواع داده |
| ONNX | انتقال مدل میان محیطهای اجرا |
| OpenVINO | بهینهسازی اجرای مدل |
| TensorRT | استنتاج سریع روی GPUهای NVIDIA |
OpenCV کتابخانهای متنباز با ماژولهایی برای پردازش تصویر، ویدیو، کالیبراسیون دوربین، تشخیص اشیا و اجرای شبکههای عصبی است. مستندات OpenCV
Torchvision نیز مدلها، Datasetها و تبدیلهای پرکاربرد تصویری را در اکوسیستم PyTorch ارائه میکند. مستندات Torchvision
آموزش پردازش تصویر با OpenCV
ابتدا OpenCV را نصب کنید:
pip install opencv-python
خواندن و نمایش اطلاعات تصویر
import cv2


image = cv2.imread(
    "product.jpg"
)

if image is None:
    raise FileNotFoundError(
        "تصویر پیدا نشد."
    )

height, width, channels = (
    image.shape
)

print("Width:", width)
print("Height:", height)
print("Channels:", channels)
تغییر اندازه
resized = cv2.resize(
    image,
    (800, 600),
)

cv2.imwrite(
    "product-resized.jpg",
    resized,
)
تبدیل به خاکستری
gray = cv2.cvtColor(
    image,
    cv2.COLOR_BGR2GRAY,
)

cv2.imwrite(
    "product-gray.jpg",
    gray,
)
تشخیص لبه
edges = cv2.Canny(
    gray,
    threshold1=100,
    threshold2=200,
)

cv2.imwrite(
    "product-edges.jpg",
    edges,
)
تشخیص لبه بهتنهایی محتوای تصویر را درک نمیکند. این عملیات فقط تغییرات شدید شدت پیکسلها را پیدا میکند.
پروژه عملی تشخیص اشیا با YOLO
در این مثال از مدل از پیش آموزشدیده YOLO برای پیدا کردن اشیا در یک تصویر استفاده میکنیم.
مستندات فعلی Ultralytics، مدلهای YOLO26 را برای تشخیص اشیا ارائه میکند و خروجی آنها شامل کلاس، مختصات Bounding Box و Confidence است. مستندات تشخیص اشیا با Ultralytics YOLO
نصب کتابخانه
pip install ultralytics
اجرای مدل آماده
from ultralytics import YOLO


model = YOLO("yolo26n.pt")

results = model(
    "store.jpg",
    conf=0.35,
)

for result in results:
    result.save(
        filename=(
            "store-detected.jpg"
        )
    )
در اولین اجرا، کتابخانه وزنهای مدل را دریافت میکند. برای محیط عملی باید نسخه مدل و فایل وزن کنترل و ثابت شوند.
استخراج نتیجه بهصورت ساختاریافته
detections = []

for result in results:
    boxes = result.boxes

    for index in range(
        len(boxes)
    ):
        class_id = int(
            boxes.cls[index].item()
        )

        confidence = float(
            boxes.conf[index].item()
        )

        coordinates = (
            boxes.xyxy[index]
            .tolist()
        )

        detections.append(
            {
                "class_id": class_id,
                "class_name": (
                    result.names[
                        class_id
                    ]
                ),
                "confidence": round(
                    confidence,
                    4,
                ),
                "box": {
                    "x1": coordinates[0],
                    "y1": coordinates[1],
                    "x2": coordinates[2],
                    "y2": coordinates[3],
                },
            }
        )

print(detections)
نمونه خروجی:
[
  {
    "class_id": 0,
    "class_name": "person",
    "confidence": 0.9341,
    "box": {
      "x1": 115.2,
      "y1": 48.7,
      "x2": 342.8,
      "y2": 691.4
    }
  }
]
مدل عمومی فقط کلاسهایی را تشخیص میدهد که در داده آموزشی آن تعریف شدهاند. برای تشخیص محصول یا عیب اختصاصی باید مدل مناسب پیدا یا روی داده اختصاصی Fine-tune شود.
آموزش مدل اختصاصی YOLO
برای آموزش مدل تشخیص اشیا باید تصاویر برچسبگذاری شوند.
ساختار کلی Dataset:
dataset/
├── images/
│   ├── train/
│   └── val/
├── labels/
│   ├── train/
│   └── val/
└── dataset.yaml
نمونه فایل dataset.yaml:
path: /absolute/path/to/dataset
train: images/train
val: images/val

names:
  0: healthy_product
  1: damaged_product
آموزش:
from ultralytics import YOLO


model = YOLO("yolo26n.pt")

model.train(
    data="dataset.yaml",
    epochs=100,
    imgsz=640,
    batch=16,
)
پیش از استفاده تولیدی باید بهترین مدل ذخیرهشده را روی مجموعه آزمون مستقل و تصاویر واقعی محیط بررسی کنید.
معیارهای ارزیابی تشخیص اشیا
Precision
از میان اشیایی که مدل تشخیص داده، چه تعداد واقعاً درست بودهاند؟
Recall
از میان اشیای واقعی موجود، مدل چه تعداد را پیدا کرده است؟
IoU
Intersection over Union میزان همپوشانی کادر پیشبینیشده و کادر واقعی را محاسبه میکند.
IoU =
مساحت اشتراک دو کادر
÷
مساحت اجتماع دو کادر
mAP
Mean Average Precision یکی از معیارهای اصلی ارزیابی مدلهای تشخیص اشیا است.
در گزارشها معمولاً موارد زیر دیده میشوند:
mAP@0.5mAP@0.5:0.95
این اعداد یکسان نیستند و هنگام مقایسه مدلها باید نوع معیار، Dataset و شرایط سختافزاری یکسان باشد.
زمان استنتاج
برای ویدیو و کاربرد بلادرنگ، دقت تنها معیار نیست. زمان پردازش هر فریم و تعداد فریم در ثانیه نیز اهمیت دارند.
ساخت سیستم تحلیل تصویر با API درواره
برای بسیاری از کاربردها نیازی به آموزش مدل اختصاصی نیست. یک مدل بینایی یا چندوجهی آماده میتواند تصویر را همراه دستور متنی پردازش کند.
کاربردهای مناسب:
- استخراج ویژگی محصول
- ساخت توضیحات تصویر
- پاسخگویی درباره نمودار
- استخراج اطلاعات سند
- مقایسه دو تصویر
- دستهبندی محتوای عمومی
- پیشنهاد عنوان و برچسب
- تبدیل تصویر به داده JSON
آدرس پایه API درواره:
https://api.darvareh.ir/v1
نصب کتابخانهها
pip install openai pydantic
تنظیم متغیرهای محیطی
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_VISION_MODEL_ID"
مدلی را انتخاب کنید که از ورودی تصویر پشتیبانی کند.
تبدیل تصویر به Data URL
import base64
import mimetypes


def image_to_data_url(
    image_path: str,
) -> str:
    mime_type, _ = (
        mimetypes.guess_type(
            image_path
        )
    )

    if not mime_type:
        mime_type = "image/jpeg"

    with open(
        image_path,
        "rb",
    ) as image_file:
        encoded = base64.b64encode(
            image_file.read()
        ).decode("utf-8")

    return (
        f"data:{mime_type};"
        f"base64,{encoded}"
    )
تعریف ساختار خروجی
from pydantic import BaseModel


class ProductAnalysis(BaseModel):
    product_type: str
    colors: list[str]
    visible_features: list[str]
    possible_material: str | None
    suggested_category: str
    confidence_note: str
تحلیل تصویر محصول
import json
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ[
"DARVAREH_API_KEY"
],
base_url=(
"https://api.darvareh.ir/v1"
),
)
MODEL_ID = os.environ[
"DARVAREH_MODEL"
]
def analyze_product(
image_path: str,
) -> ProductAnalysis:
image_data = image_to_data_url(
image_path
)
response = (
client.chat.completions.create(
model=MODEL_ID,
temperature=0.1,
messages=[
{
"role": "system",
"content": (
"شما دستیار تحلیل "
"تصاویر محصول هستید و "
"فقط JSON معتبر "
"تولید میکنید."
),
},
{
"role": "user",
"content": [
{
"type": "text",
"text": """
تصویر محصول را تحلیل کن.
قواعد:
- فقط ویژگیهای قابل مشاهده را بنویس.
- درباره برند یا جنس نامشخص ادعای قطعی نکن.
- متن یا لوگوی ناخوانا را حدس نزن.
- رنگها را به فارسی بنویس.
- پاسخ فقط JSON معتبر باشد.
ساختار:
{
"product_type": "نوع محصول",
"colors": ["رنگ"],
"visible_features": ["ویژگی"],
"possible_material": null,
"suggested_category": "دسته پیشنهادی",
"confidence_note": "توضیح عدم قطعیت"
}
""",
},
{
"type": "image_url",
"image_url": {
"url": (
image_data
)
},
},
],
},
],
)
)
content = (
response
.choices[0]
.message
.content
)
if not content:
raise ValueError(
"پاسخی از مدل دریافت نشد."
)
parsed = json.loads(content)
return (
ProductAnalysis
.model_validate(parsed)
)
اجرای برنامه
result = analyze_product(
    "product.jpg"
)

print(
    result.model_dump_json(
        indent=2
    )
)
نمونه خروجی:
{
"product_type": "کفش ورزشی",
"colors": [
"سفید",
"مشکی"
],
"visible_features": [
"بنددار",
"زیره ضخیم",
"طراحی کمارتفاع"
],
"possible_material": "ترکیبی از پارچه و مواد مصنوعی",
"suggested_category": "کفش ورزشی روزمره",
"confidence_note": "جنس دقیق و برند محصول از تصویر قابل تأیید نیست."
}
پشتیبانی از تصویر و قالب پیام ممکن است میان مدلها متفاوت باشد. قبل از انتخاب مدل، قابلیتها و مستندات فعلی آن را بررسی کنید.
تفاوت YOLO و مدل بینایی چندوجهی
| معیار | YOLO | مدل بینایی چندوجهی |
|---|---|---|
| خروجی اصلی | کلاس و مختصات اشیا | پاسخ متنی یا ساختاریافته |
| سرعت | مناسب پردازش سریع | وابسته به مدل و API |
| شمارش شیء | مناسب | ممکن است دقیق نباشد |
| درک متن و زمینه | محدود | قویتر |
| تشخیص کلاس اختصاصی | نیازمند آموزش | گاهی با دستور ممکن است |
| توضیح تصویر | محدود | مناسب |
| محل دقیق شیء | مناسب | بسته به مدل |
| کاربرد | تشخیص و ردیابی | تحلیل و تعامل با تصویر |
در یک محصول واقعی میتوان این دو روش را ترکیب کرد:
- YOLO اشیا و مختصات را پیدا کند.
- تصویر یا بخشهای برشخورده برای مدل چندوجهی ارسال شوند.
- مدل چندوجهی ویژگیها و توضیحات را استخراج کند.
- خروجیها با قواعد برنامه اعتبارسنجی شوند.
معماری پیشنهادی برای تحلیل تصویر
کاربر
↓
بارگذاری تصویر
↓
اعتبارسنجی فرمت و اندازه
↓
اصلاح جهت و تغییر اندازه
↓
مدل محلی یا API درواره
↓
اعتبارسنجی JSON
↓
قواعد کسبوکار
↓
نمایش یا ذخیره نتیجه
کلید API باید فقط روی سرور نگهداری شود و نباید در کد مرورگر یا اپلیکیشن عمومی قرار بگیرد.
کاربردهای بینایی ماشین در کسبوکار
فروشگاه اینترنتی
- استخراج ویژگی محصول
- دستهبندی خودکار کالا
- جستوجوی محصول با عکس
- کنترل کیفیت تصاویر
- ساخت متن جایگزین تصویر
- شناسایی چند محصول در یک تصویر
تولید
- تشخیص خط و خش
- بررسی مونتاژ
- شمارش قطعات
- خواندن شماره سریال
- تشخیص محصول ناقص
- پایش خط تولید
انبار و لجستیک
- شمارش بستهها
- خواندن برچسب
- ردیابی کالا
- تشخیص فضای خالی
- بررسی وضعیت بستهبندی
کشاورزی
- بررسی وضعیت گیاه
- تشخیص علف هرز
- شمارش محصول
- تحلیل تصاویر پهپاد
- تخمین سطح پوشش گیاهی
اسناد
- OCR
- تشخیص نوع سند
- استخراج جدول
- استخراج مبلغ و تاریخ
- بررسی چیدمان صفحه
- دیجیتالسازی آرشیو
معماری و املاک
- دستهبندی تصاویر ملک
- تشخیص اجزای اتاق
- برآورد وضعیت ظاهری
- جستوجوی تصاویر مشابه
- پیشنهاد برچسب برای آگهی
چگونه داده تصویری مناسب جمعآوری کنیم؟
یک Dataset خوب باید نماینده محیط واقعی باشد.
موارد مهم:
- دوربینهای مختلف
- فاصلههای متفاوت
- نور روز و شب
- پسزمینههای متنوع
- زاویههای مختلف
- نمونههای سالم و معیوب
- نمونههای دشوار
- اشیای ناقص یا پوشیده
- کیفیتهای مختلف تصویر
- شرایط فصلی یا محیطی
اگر تمام تصاویر آموزشی با پسزمینه سفید باشند، مدل ممکن است در محیط واقعی عملکرد ضعیفی داشته باشد.
چه زمانی مدل اختصاصی بسازیم؟
مدل اختصاصی زمانی منطقی است که:
- کلاس یا عیب موردنظر بسیار تخصصی باشد.
- مدلهای عمومی شیء را نمیشناسند.
- به مختصات دقیق نیاز دارید.
- تعداد درخواست بسیار زیاد است.
- اجرای محلی یا Edge اهمیت دارد.
- زمان پاسخ باید بسیار کوتاه باشد.
- داده برچسبگذاریشده کافی دارید.
- امکان پایش و آموزش مجدد وجود دارد.
چه زمانی از API مدل آماده استفاده کنیم؟
API انتخاب مناسبی است اگر:
- میخواهید سریع نمونه اولیه بسازید.
- داده آموزشی کافی ندارید.
- خروجی متنی یا JSON نیاز دارید.
- تصاویر عمومی هستند.
- مسئله نیازمند درک زمینه است.
- مدیریت GPU برای شما مطلوب نیست.
- مصرف پروژه در ابتدا نامشخص است.
- میخواهید چند مدل را آزمایش کنید.
کاهش هزینه تحلیل تصویر
ابعاد تصویر را کنترل کنید
تصویر بسیار بزرگ همیشه اطلاعات مفید بیشتری ایجاد نمیکند. اندازه ورودی را متناسب با وظیفه تنظیم کنید.
ناحیه مهم را برش دهید
اگر فقط برچسب محصول مهم است، لازم نیست کل تصویر محیط ارسال شود.
نتایج را Cache کنید
تصویر یکسان نباید بدون دلیل چندین بار پردازش شود.
از مدل مناسب وظیفه استفاده کنید
برای تشخیص سریع اشیا میتوان از مدل تخصصی سبک و برای تحلیل پیچیده از مدل چندوجهی استفاده کرد.
پردازش غیرهمزمان بسازید
برای عملیات سنگین، درخواست را در صف قرار دهید و نتیجه را بعداً با Polling یا Webhook تحویل دهید.
بازتولید محدود انجام دهید
اگر فقط یک فیلد خروجی اشتباه است، در صورت امکان همان بخش را دوباره پردازش کنید.
اشتباهات رایج در پروژههای Computer Vision
استفاده از تصاویر تمیز آزمایشگاهی
مدل باید روی تصاویر واقعی کاربران یا محیط عملی آزمایش شود.
نشت داده
فریمهای بسیار مشابه یک ویدیو نباید تصادفی میان آموزش و آزمون توزیع شوند؛ زیرا نتیجه ارزیابی غیرواقعی میشود.
بررسی نکردن کلاسهای جداگانه
دقت کلی ممکن است خوب باشد، اما مدل روی یک نوع محصول خاص ضعیف عمل کند.
اعتماد به Confidence
Confidence احتمال آماری مدل است و تضمین صحت نیست.
انتخاب آستانه ثابت بدون آزمایش
Threshold مناسب باید بر اساس هزینه مثبت کاذب و منفی کاذب تعیین شود.
استفاده از Accuracy برای تشخیص اشیا
در تشخیص اشیا باید Precision، Recall، IoU و mAP نیز بررسی شوند.
نادیده گرفتن زمان پاسخ
مدل دقیق اما کند ممکن است برای دوربین بلادرنگ قابلاستفاده نباشد.
استفاده مستقیم از خروجی مدل
خروجی باید پیش از اجرای اقدام در نرمافزار اعتبارسنجی شود.
نداشتن امکان بررسی انسانی
برای موارد کماطمینان بهتر است مسیر بررسی انسانی وجود داشته باشد.
مسیر یادگیری بینایی ماشین
مرحله اول: پایتون
توابع، کلاسها، NumPy، فایلها و محیط مجازی را یاد بگیرید.
مرحله دوم: مبانی تصویر
با پیکسل، کانال رنگ، رزولوشن، Histogram و فضای رنگی آشنا شوید.
مرحله سوم: OpenCV
خواندن تصویر، تغییر اندازه، فیلتر، لبهیابی و پردازش ویدیو را تمرین کنید.
مرحله چهارم: یادگیری ماشین
مفاهیم داده آموزش، آزمون، بیشبرازش و معیارهای ارزیابی را یاد بگیرید.
مرحله پنجم: Deep Learning
CNN، Backpropagation و Transfer Learning را مطالعه کنید.
مرحله ششم: تشخیص و تقسیمبندی
یک مدل YOLO یا مدل تقسیمبندی را روی داده نمونه اجرا کنید.
مرحله هفتم: مدلهای چندوجهی
تحلیل تصویر با Prompt، خروجی JSON و ارزیابی مدل بینایی را تمرین کنید.
مرحله هشتم: استقرار
مدل را روی سرور، موبایل یا Edge اجرا و سرعت، حافظه و کیفیت را پایش کنید.
پرسشهای متداول
بینایی ماشین به زبان ساده چیست؟
بینایی ماشین مجموعهای از روشهاست که به کامپیوتر کمک میکند اطلاعات موجود در تصویر و ویدیو را شناسایی و تحلیل کند.
Computer Vision چه تفاوتی با پردازش تصویر دارد؟
پردازش تصویر معمولاً ظاهر یا ساختار تصویر را تغییر میدهد؛ اما Computer Vision تلاش میکند از تصویر اطلاعات و مفهوم استخراج کند.
آیا OCR بخشی از بینایی ماشین است؟
بله. OCR یکی از وظایف بینایی ماشین است که متن موجود در تصویر یا سند اسکنشده را استخراج میکند.
YOLO چیست؟
YOLO خانوادهای از مدلهای تشخیص اشیا است که نوع و موقعیت اشیا را در تصویر یا ویدیو پیشبینی میکند.
آیا برای Computer Vision به GPU نیاز داریم؟
برای مثالهای کوچک و بعضی مدلهای سبک CPU کافی است. آموزش یا اجرای سریع مدلهای بزرگ معمولاً از GPU بهره میبرد. هنگام استفاده از API نیازی به مدیریت مستقیم GPU ندارید.
بهترین زبان برنامهنویسی برای بینایی ماشین چیست؟
پایتون به دلیل وجود کتابخانههایی مانند OpenCV، PyTorch، TensorFlow و Ultralytics یکی از انتخابهای اصلی است. برای سیستمهای سریع و Embedded از C++ نیز استفاده میشود.
آیا میتوان تصویر فارسی را تحلیل کرد؟
بله. نوع زبان برای اشیای عمومی اهمیت کمتری دارد، اما استخراج متن فارسی، تحلیل سند و خواندن برچسبها باید با نمونههای واقعی فارسی ارزیابی شود.
آیا مدل بینایی میتواند تعداد اشیا را بشمارد؟
مدل تشخیص اشیا میتواند پس از شناسایی نمونهها، آنها را بشمارد. دقت شمارش به همپوشانی اشیا، اندازه، زاویه و کیفیت مدل بستگی دارد.
آیا مدل چندوجهی جای YOLO را میگیرد؟
نه در همه کاربردها. YOLO برای مکانیابی و پردازش سریع مناسب است؛ مدل چندوجهی برای درک زمینه و تولید پاسخ متنی توانمندتر است.
درواره چگونه در پروژه بینایی ماشین استفاده میشود؟
با API درواره میتوان به مدلهای دارای قابلیت ورودی تصویر متصل شد و قابلیتهایی مانند استخراج ویژگی، توضیح تصویر، تحلیل سند یا پاسخ به پرسش تصویری را به نرمافزار اضافه کرد.
جمعبندی
بینایی ماشین به سیستمها امکان میدهد تصاویر و ویدیوها را پردازش و تفسیر کنند.
یک پروژه موفق Computer Vision باید:
- مسئله تصویری مشخصی داشته باشد.
- تصاویر نماینده شرایط واقعی جمعآوری کند.
- برچسبهای دقیق و سازگار داشته باشد.
- مدل ساده و مدل آماده را ابتدا آزمایش کند.
- معیار مناسب وظیفه را انتخاب کند.
- کیفیت را برای هر کلاس جداگانه بسنجد.
- زمان پاسخ و هزینه اجرا را اندازهگیری کند.
- موارد کماطمینان را به بررسی انسانی هدایت کند.
- خروجی مدل را پیش از استفاده اعتبارسنجی کند.
- تغییر شرایط محیط را پس از استقرار پایش کند.
برای تشخیص سریع و دقیق موقعیت اشیا، مدلهایی مانند YOLO مناسباند. برای توضیح تصویر، استخراج چند ویژگی و تعامل زبانی، مدلهای بینایی چندوجهی انتخاب انعطافپذیرتری هستند.
اگر قصد دارید قابلیت تحلیل تصویر را به فروشگاه، اپلیکیشن، سامانه اسناد یا نرمافزار سازمانی خود اضافه کنید، میتوانید از مستندات API درواره شروع کنید.
درواره با یک API سازگار با OpenAI، کیف پول ریالی و دسترسی یکپارچه به مدلهای مختلف، امکان ساخت و آزمایش قابلیتهای بینایی هوش مصنوعی را برای توسعهدهندگان ایرانی فراهم میکند.
مقالات مرتبط
- آموزش OpenCV با پایتون
- هوش مصنوعی چندوجهی چیست؟
- استفاده از ورودی تصویر در API هوش مصنوعی
- تبدیل عکس به متن با هوش مصنوعی و OCR
- جستوجوی محصول با تصویر
- یادگیری عمیق چیست؟
- پردازش زبان طبیعی چیست؟
- آموزش PyTorch
- آموزش TensorFlow و Keras
منابع
- IBM: What Is Computer Vision?
- مستندات OpenCV
- TensorFlow: Image Classification
- Ultralytics: Object Detection
- مستندات Torchvision
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.