الگوریتم SVM چیست؟ آموزش ماشین بردار پشتیبان با پایتون
ماشین بردار پشتیبان یا SVM یکی از الگوریتمهای قدرتمند یادگیری ماشین برای طبقهبندی، رگرسیون و تشخیص ناهنجاری است.
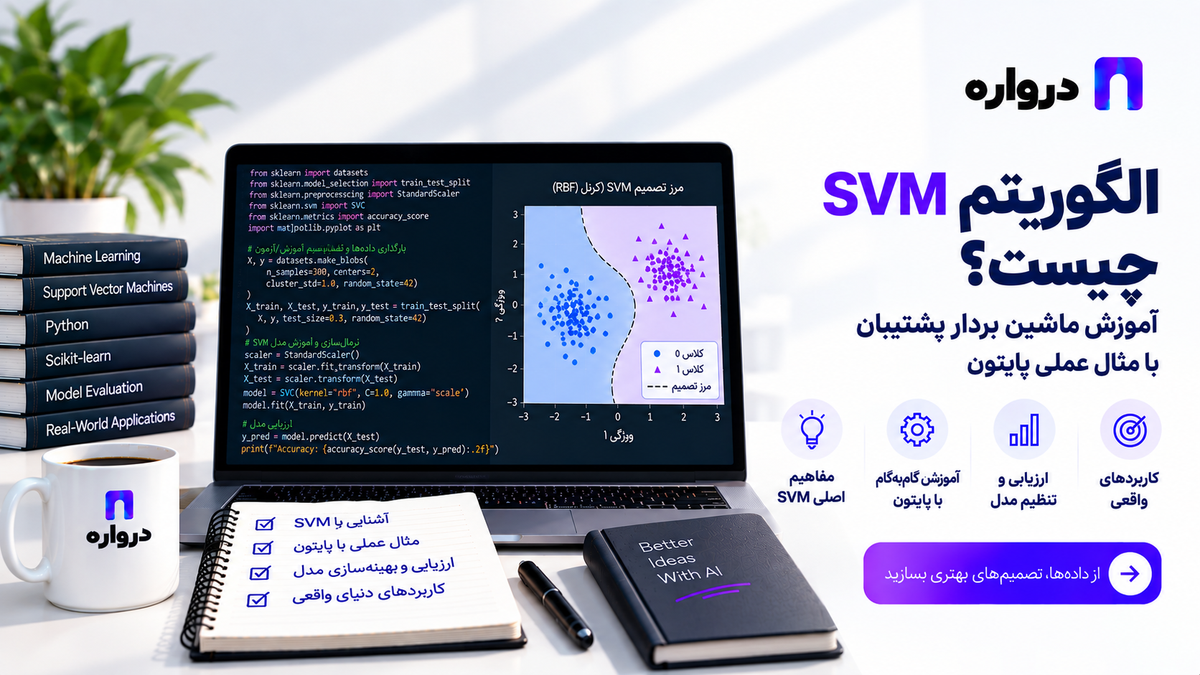
ماشین بردار پشتیبان یا Support Vector Machine که بهاختصار SVM نامیده میشود، یکی از الگوریتمهای شناختهشده یادگیری ماشین برای طبقهبندی، رگرسیون و تشخیص نقاط غیرعادی است.
ایده اصلی SVM پیدا کردن مرزی است که کلاسها را با بیشترین فاصله ممکن از یکدیگر جدا کند. این مرز در فضای دوبعدی یک خط، در فضای سهبعدی یک صفحه و در ابعاد بالاتر یک Hyperplane یا ابرصفحه نامیده میشود.
SVM بهخصوص در این مسائل کاربرد دارد:
- طبقهبندی متن
- دستهبندی پیامهای پشتیبانی
- تشخیص هرزنامه
- تحلیل احساسات
- تشخیص تصویر با ویژگیهای استخراجشده
- طبقهبندی دادههای زیستی
- پیشبینی مقدار عددی با SVR
- تشخیص ناهنجاری با One-Class SVM
- دستهبندی Embeddingهای متنی
در این مقاله ابتدا مفاهیم ریاضی SVM را به زبان ساده توضیح میدهیم، سپس مدل را با Scikit-learn پیادهسازی میکنیم و در پایان از Embeddingهای API درواره برای ساخت یک طبقهبند متن فارسی استفاده خواهیم کرد.
SVM چیست؟
SVM یک الگوریتم یادگیری نظارتشده است که تلاش میکند بهترین مرز تصمیم را میان کلاسها پیدا کند.
فرض کنید دو گروه نقطه داریم:
کلاس آبی: پیامهای فروش
کلاس قرمز: پیامهای پشتیبانی
ممکن است چند خط بتوانند این دو گروه را از هم جدا کنند. SVM خطی را ترجیح میدهد که فاصله آن تا نزدیکترین نمونههای هر دو کلاس بیشترین مقدار ممکن باشد.
این فاصله Margin نام دارد.
نمونههایی که نزدیکترین فاصله را با مرز تصمیم دارند، Support Vector یا بردار پشتیبان نامیده میشوند. این نقاط نقش تعیینکنندهای در موقعیت مرز دارند.
Scikit-learn خانواده SVM را برای طبقهبندی، رگرسیون و تشخیص نقاط غیرعادی ارائه میکند.
ابرصفحه یا Hyperplane چیست؟
در یک مسئله خطی دودویی، مرز تصمیم با رابطه زیر نمایش داده میشود:
wTx+b=0w^Tx+b=0
در این رابطه:
xبردار ویژگیهای ورودی است.wجهت و شیب مرز را تعیین میکند.bمقدار جابهجایی مرز است.
مدل برای پیشبینی میتواند علامت عبارت زیر را بررسی کند:
f(x)=wTx+bf(x)=w^Tx+b
اگر مقدار مثبت باشد، نمونه در یک سمت مرز قرار میگیرد و اگر منفی باشد، به سمت دیگر تعلق دارد.
Margin چیست؟
Margin فاصله میان مرز تصمیم و نزدیکترین نمونههای آموزشی است.
SVM تلاش میکند این فاصله را بیشینه کند. شهود اصلی این است که مرزی با حاشیه بزرگتر احتمالاً روی دادههای جدید تعمیم بهتری دارد.
برای SVM خطی، عرض Margin با اندازه بردار w ارتباط معکوس دارد:
Margin∝1∥w∥Margin \propto \frac{1}{\|w\|}
بنابراین مسئله بهینهسازی SVM شامل کوچککردن اندازه w در کنار طبقهبندی صحیح نمونهها است.
Support Vector چیست؟
Support Vectorها نمونههایی هستند که روی حاشیه یا داخل محدوده Margin قرار گرفتهاند و موقعیت مرز تصمیم را تعیین میکنند.
اگر نمونهای دور از مرز باشد، تغییر کوچک آن معمولاً مرز را تغییر نمیدهد. اما جابهجایی یک Support Vector میتواند موقعیت Hyperplane را تغییر دهد.
نام Support Vector Machine نیز از همین نمونههای پشتیبان گرفته شده است.
Hard Margin SVM چیست؟
در Hard Margin فرض میشود دادهها کاملاً خطی و بدون خطا قابلجداسازی هستند.
محدودیت مدل:
yi(wTxi+b)≥1y_i(w^Tx_i+b)\geq1
برای تمام نمونهها باید این شرط برقرار باشد.
Hard Margin در داده واقعی معمولاً انتخاب مناسبی نیست؛ زیرا:
- دادهها ممکن است نویز داشته باشند.
- کلاسها میتوانند همپوشانی داشته باشند.
- وجود یک Outlier مرز را بهشدت تغییر میدهد.
- جداسازی کامل همیشه امکانپذیر نیست.
Soft Margin SVM چیست؟
Soft Margin اجازه میدهد بعضی نمونهها داخل Margin قرار بگیرند یا اشتباه طبقهبندی شوند.
برای این منظور متغیرهای خطا یا Slack Variables اضافه میشوند:
yi(wTxi+b)≥1−ξiy_i(w^Tx_i+b)\geq1-\xi_i
تابع هدف:
minw,b,ξ12∥w∥2+C∑iξi\min_{w,b,\xi} \frac{1}{2}\|w\|^2 + C\sum_i\xi_i
در این رابطه پارامتر C تعادل میان دو هدف را کنترل میکند:
- بزرگبودن Margin
- کاهش خطاهای آموزشی
پارامتر C در SVM چیست؟
C میزان جریمه خطا را تعیین میکند.
C بزرگ
مدل تلاش بیشتری برای طبقهبندی صحیح نمونههای آموزشی انجام میدهد:
- Margin ممکن است باریکتر شود.
- مدل میتواند پیچیدهتر شود.
- احتمال بیشبرازش افزایش پیدا میکند.
- خطاهای آموزشی کمتر تحمل میشوند.
C کوچک
مدل خطاهای بیشتری را میپذیرد:
- Margin میتواند پهنتر شود.
- منظمسازی قویتر است.
- مرز سادهتر میشود.
- احتمال کمبرازش افزایش پیدا میکند.
مقدار مناسب C باید با Cross-validation و داده واقعی انتخاب شود.
اگر داده خطی جدا نشود چه میشود؟
بسیاری از دادهها با یک خط مستقیم یا ابرصفحه خطی جدا نمیشوند.
برای مثال، ممکن است یک کلاس بهشکل دایرهای داخل کلاس دیگر قرار گرفته باشد. در فضای دوبعدی هیچ خطی این دو گروه را بهخوبی جدا نمیکند.
یک راهحل، انتقال داده به فضایی با ابعاد بیشتر است؛ جایی که جداسازی خطی ممکن شود.
اما محاسبه صریح این تبدیل میتواند پرهزینه باشد. SVM از Kernel Trick استفاده میکند تا شباهت نمونهها را در فضای جدید، بدون محاسبه مستقیم تمام مختصات آن فضا به دست آورد.
Kernel Trick چیست؟
Kernel تابعی است که شباهت دو نمونه را در یک فضای ویژگی، مستقیم یا غیرمستقیم، محاسبه میکند:
K(xi,xj)=ϕ(xi)Tϕ(xj)K(x_i,x_j)=\phi(x_i)^T\phi(x_j)
در این رابطه φ تبدیل داده به فضای جدید است.
با Kernel Trick لازم نیست همیشه مقدار φ(x) بهطور صریح محاسبه شود.
Scikit-learn برای SVC کرنلهایی مانند linear، poly، rbf، sigmoid و Kernel ازپیشمحاسبهشده را پشتیبانی میکند.
انواع Kernel در SVM
Linear Kernel
K(x,z)=xTzK(x,z)=x^Tz
کرنل خطی برای دادههایی مناسب است که مرز تقریباً خطی دارند.
کاربردهای متداول:
- طبقهبندی متن با TF-IDF
- دادههای دارای ویژگیهای زیاد
- دادههای Sparse
- مجموعه دادههای بزرگتر
در مسائل متنی، تعداد ویژگیها ممکن است دهها هزار کلمه یا عبارت باشد. مدل خطی در چنین فضاهایی اغلب خط مبنای قدرتمندی ایجاد میکند.
Polynomial Kernel
K(x,z)=(γxTz+r)dK(x,z)=(\gamma x^Tz+r)^d
پارامترهای مهم:
degree: درجه چندجملهایgamma: مقیاس اثر نمونههاcoef0: جمله مستقل
Polynomial Kernel میتواند تعاملهای چندجملهای میان ویژگیها را مدل کند، اما تنظیم آن دشوارتر است.
RBF Kernel
K(x,z)=exp(−γ∥x−z∥2)K(x,z)= \exp(-\gamma\|x-z\|^2)
RBF یا Gaussian Kernel یکی از رایجترین گزینهها برای مرزهای غیرخطی است.
این Kernel میتواند مرزهای انعطافپذیری بسازد، اما به تنظیم صحیح C و gamma نیاز دارد. مستندات Scikit-learn نیز این دو پارامتر را برای SVM با کرنل RBF از تنظیمات اصلی معرفی میکند.
Sigmoid Kernel
K(x,z)=tanh(γxTz+r)K(x,z)= \tanh(\gamma x^Tz+r)
رفتار این Kernel تا حدی به تابع فعالسازی Sigmoid در شبکههای عصبی شباهت دارد، اما معمولاً انتخاب پیشفرض نیست.
پارامتر gamma در SVM چیست؟
gamma میزان اثر هر نمونه آموزشی را در Kernelهایی مانند RBF کنترل میکند.
gamma کوچک
اثر هر نمونه محدوده وسیعتری دارد:
- مرز تصمیم نرمتر میشود.
- پیچیدگی مدل کاهش مییابد.
- احتمال کمبرازش افزایش پیدا میکند.
gamma بزرگ
اثر هر نمونه به ناحیه نزدیک خودش محدود میشود:
- مرز تصمیم پیچیدهتر میشود.
- مدل جزئیات بیشتری یاد میگیرد.
- احتمال بیشبرازش افزایش پیدا میکند.
بهصورت شهودی، gamma کوچک یعنی شعاع اثر بزرگ و gamma بزرگ یعنی شعاع اثر کوچک. مستندات Scikit-learn همین رابطه را در مثال پارامترهای RBF توضیح میدهد.
تعامل C و gamma
C و gamma باید همزمان تنظیم شوند.
| وضعیت | نتیجه احتمالی |
|---|---|
| C کوچک و gamma کوچک | مدل ساده و احتمال کمبرازش |
| C بزرگ و gamma بزرگ | مرز پیچیده و احتمال بیشبرازش |
| C بزرگ و gamma کوچک | جریمه خطا زیاد، مرز نسبتاً نرم |
| C کوچک و gamma بزرگ | اثر محلی زیاد با تحمل خطا |
بهترین ترکیب به توزیع داده وابسته است و باید با Cross-validation انتخاب شود.
چرا مقیاسبندی برای SVM مهم است؟
SVM بر فاصله، ضرب داخلی و اندازه ویژگیها تکیه دارد.
فرض کنید دو ویژگی داریم:
سن: 18 تا 70
درآمد سالانه: 100,000,000 تا 5,000,000,000
بدون مقیاسبندی، ویژگی درآمد میتواند فقط به دلیل دامنه عددی بزرگتر اثر بیشتری داشته باشد.
روش رایج استفاده از StandardScaler است:
z=x−μσz=\frac{x-\mu}{\sigma}
Scaler باید فقط روی داده آموزش Fit شود. بهترین روش قرار دادن آن داخل Pipeline است.
SVM برای طبقهبندی دودویی
در طبقهبندی دودویی دو کلاس داریم:
مثبت / منفی
فروش / پشتیبانی
عادی / غیرعادی
ریزش / ماندگاری
SVM یک مرز تصمیم میان این دو کلاس یاد میگیرد.
خروجی پیشفرض معمولاً برچسب کلاس یا فاصله نمونه از مرز تصمیم است.
SVM برای طبقهبندی چندکلاسه
SVM در اصل یک روش دودویی است، اما میتوان آن را برای چند کلاس توسعه داد.
راهبردهای رایج:
One-vs-Rest
برای هر کلاس یک مدل در برابر تمام کلاسهای دیگر ساخته میشود.
اگر چهار کلاس داشته باشیم، چهار مدل خواهیم داشت.
One-vs-One
برای هر جفت کلاس یک مدل جداگانه ساخته میشود.
برای K کلاس:
K(K−1)2\frac{K(K-1)}{2}
مدل ساخته میشود.
در Scikit-learn، رفتار دقیق به Estimator انتخابشده بستگی دارد. SVC بهصورت داخلی از راهبرد چندکلاسه مبتنی بر مدلهای جفتی استفاده میکند، درحالیکه LinearSVC پیادهسازی متفاوت و مناسبتری برای بسیاری از دادههای بزرگ و Sparse دارد.
SVC و LinearSVC چه تفاوتی دارند؟
SVC
کلاس SVC از Kernelهای مختلف پشتیبانی میکند:
from sklearn.svm import SVC
برای مرزهای غیرخطی و مجموعه دادههای کوچک یا متوسط مناسب است.
آموزش SVC با افزایش تعداد نمونهها میتواند پرهزینه شود. مستندات Scikit-learn هشدار میدهد که زمان Fit آن حداقل بهصورت درجه دوم نسبت به تعداد نمونهها رشد میکند و برای دهها هزار نمونه یا بیشتر ممکن است عملی نباشد.
LinearSVC
from sklearn.svm import LinearSVC
برای مرز خطی، داده Sparse و مجموعه داده بزرگتر مناسبتر است.
کاربرد متداول:
- طبقهبندی متن
- TF-IDF
- داده با ابعاد زیاد
- تعداد نمونه بیشتر
LinearSVC مستقیماً predict_proba ارائه نمیکند. اگر احتمال کالیبرهشده لازم باشد، باید از روشهایی مانند CalibratedClassifierCV استفاده شود.
پیادهسازی SVM با پایتون
در این مثال از مجموعه داده Breast Cancer موجود در Scikit-learn استفاده میکنیم.
این مثال فقط برای آموزش الگوریتم است و برای تصمیمگیری پزشکی طراحی نشده است.
نصب کتابخانهها
pip install scikit-learn pandas matplotlib
بارگذاری و تقسیم داده
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split


dataset = load_breast_cancer(
    as_frame=True,
)

X = dataset.data
y = dataset.target

X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.2,
        stratify=y,
        random_state=42,
    )
)
ساخت Pipeline
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC


model = Pipeline(
    [
        (
            "scaler",
            StandardScaler(),
        ),
        (
            "svm",
            SVC(
                kernel="rbf",
                C=10.0,
                gamma="scale",
                class_weight="balanced",
                probability=True,
                random_state=42,
            ),
        ),
    ]
)
قرار دادن Scaler داخل Pipeline باعث میشود عملیات Fit فقط با داده آموزش انجام شود و هنگام Cross-validation نیز نشت داده رخ ندهد.
آموزش مدل
model.fit(
    X_train,
    y_train,
)
ارزیابی
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
    roc_auc_score,
)


predictions = model.predict(X_test)

probabilities = model.predict_proba(
    X_test
)[:, 1]

print(
    classification_report(
        y_test,
        predictions,
        target_names=dataset.target_names,
    )
)

print(
    confusion_matrix(
        y_test,
        predictions,
    )
)

print(
    "ROC AUC:",
    roc_auc_score(
        y_test,
        probabilities,
    ),
)
چرا فقط Accuracy کافی نیست؟
اگر کلاسها نامتوازن باشند، Accuracy میتواند گمراهکننده باشد.
معیارهای مهم:
- Precision
- Recall
- F1 Score
- ROC AUC
- PR AUC
- Confusion Matrix
- هزینه False Positive
- هزینه False Negative
معیار مناسب باید بر اساس مسئله کسبوکار انتخاب شود.
تنظیم C و gamma با Grid Search
from sklearn.model_selection import (
    GridSearchCV,
    StratifiedKFold,
)


parameter_grid = {
    "svm__C": [
        0.01,
        0.1,
        1,
        10,
        100,
    ],
    "svm__gamma": [
        0.0001,
        0.001,
        0.01,
        0.1,
        1,
        "scale",
    ],
}

cross_validation = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

search = GridSearchCV(
    estimator=model,
    param_grid=parameter_grid,
    scoring="roc_auc",
    cv=cross_validation,
    n_jobs=-1,
    refit=True,
)

search.fit(
    X_train,
    y_train,
)

print("Best score:", search.best_score_)
print("Best parameters:", search.best_params_)
مقادیر C و gamma معمولاً باید روی مقیاس لگاریتمی جستوجو شوند.
برای فضای بزرگتر میتوان از Randomized Search یا Optuna استفاده کرد.
تنظیم SVM با Optuna
import optuna

from sklearn.model_selection import (
    cross_val_score,
)


def objective(trial):
    c_value = trial.suggest_float(
        "C",
        1e-3,
        1e3,
        log=True,
    )

    gamma_value = trial.suggest_float(
        "gamma",
        1e-6,
        1e0,
        log=True,
    )

    candidate = Pipeline(
        [
            (
                "scaler",
                StandardScaler(),
            ),
            (
                "svm",
                SVC(
                    kernel="rbf",
                    C=c_value,
                    gamma=gamma_value,
                    class_weight="balanced",
                ),
            ),
        ]
    )

    scores = cross_val_score(
        candidate,
        X_train,
        y_train,
        cv=cross_validation,
        scoring="roc_auc",
        n_jobs=-1,
    )

    return scores.mean()


study = optuna.create_study(
    direction="maximize",
)

study.optimize(
    objective,
    n_trials=60,
)

print(study.best_value)
print(study.best_params)
برای آموزش کامل این روش، مقاله بهینهسازی بیزی و Optuna را مطالعه کنید.
SVR چیست؟
Support Vector Regression یا SVR نسخه رگرسیونی SVM است.
در SVR هدف پیدا کردن تابعی است که بیشتر نمونهها در یک لوله با عرض ε اطراف آن قرار بگیرند.
نقاط داخل این محدوده خطای مؤثری ندارند و نقاط خارج آن جریمه میشوند.
پیادهسازی:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVR


regression_model = Pipeline(
    [
        (
            "scaler",
            StandardScaler(),
        ),
        (
            "svr",
            SVR(
                kernel="rbf",
                C=10.0,
                gamma="scale",
                epsilon=0.1,
            ),
        ),
    ]
)
پارامترهای مهم SVR:
C: میزان جریمه خطاgamma: شعاع اثر نمونههاepsilon: عرض محدوده بدون جریمهkernel: نوع Kernel
One-Class SVM چیست؟
One-Class SVM برای تشخیص ناهنجاری یا Novelty Detection استفاده میشود.
مدل عمدتاً با نمونههای عادی آموزش میبیند و تلاش میکند محدودهای برای آنها پیدا کند. نمونههای خارج از این محدوده بهعنوان غیرعادی شناسایی میشوند.
from sklearn.svm import OneClassSVM


anomaly_model = OneClassSVM(
    kernel="rbf",
    gamma="scale",
    nu=0.05,
)

anomaly_model.fit(
    normal_training_data
)

predictions = anomaly_model.predict(
    new_data
)
خروجی معمول:
1  = عادی
-1 = غیرعادی
استفاده از One-Class SVM به معنی اثبات تقلب، خرابی یا مشکل نیست. خروجی فقط نشان میدهد نمونه با الگوهای آموزشی تفاوت دارد.
طبقهبندی متن با SVM و TF-IDF
یکی از کاربردهای مهم SVM، طبقهبندی متن است.
متن ابتدا باید به بردار عددی تبدیل شود. TF-IDF میزان اهمیت هر واژه را بر اساس فراوانی آن در یک سند و کل مجموعه اسناد محاسبه میکند.
مستندات Scikit-learn نمونه رسمی طبقهبندی اسناد را با ویژگیهای Sparse و وزندهی TF-IDF ارائه میکند.
فرض کنید فایل tickets.csv شامل دو ستون باشد:
text,category
"مبلغ از حساب کم شد ولی اعتبار اضافه نشد",billing
"چطور مدل را در کد تغییر بدهم؟",technical
"برای خرید سازمانی فاکتور میخواهم",sales
ساخت مدل طبقهبندی متن فارسی
import pandas as pd

from sklearn.feature_extraction.text import (
    TfidfVectorizer,
)
from sklearn.metrics import (
    classification_report,
)
from sklearn.model_selection import (
    train_test_split,
)
from sklearn.pipeline import Pipeline
from sklearn.svm import LinearSVC


data = pd.read_csv("tickets.csv")

X_train, X_test, y_train, y_test = (
    train_test_split(
        data["text"],
        data["category"],
        test_size=0.2,
        stratify=data["category"],
        random_state=42,
    )
)

text_classifier = Pipeline(
    [
        (
            "tfidf",
            TfidfVectorizer(
                ngram_range=(1, 2),
                min_df=2,
                max_df=0.95,
                sublinear_tf=True,
            ),
        ),
        (
            "classifier",
            LinearSVC(
                C=1.0,
                class_weight="balanced",
            ),
        ),
    ]
)

text_classifier.fit(
    X_train,
    y_train,
)

predictions = text_classifier.predict(
    X_test
)

print(
    classification_report(
        y_test,
        predictions,
    )
)
پیشبینی پیام جدید
messages = [
"برای اتصال به API نمونه کد پایتون میخواهم",
"پرداخت کردم ولی کیف پول شارژ نشده است",
]
categories = text_classifier.predict(
messages
)
for message, category in zip(
messages,
categories,
):
print(category, message)
محدودیت TF-IDF برای متن فارسی
TF-IDF بر واژهها و الگوهای ظاهری متن تکیه دارد. مشکلات احتمالی:
- تفاوت «می شود» و «میشود»
- حروف عربی و فارسی مانند
يوی - حروف
كوک - نیمفاصله
- غلط املایی
- Pinglish
- مترادفها
- وابستگی معنایی
- جملهبندی متفاوت
پیش از Vectorization بهتر است متن فارسی نرمالسازی شود.
نمونه ساده:
import re


def normalize_persian(text):
    text = str(text)

    text = text.replace("ي", "ی")
    text = text.replace("ك", "ک")

    text = re.sub(
        r"\s+",
        " ",
        text,
    )

    return text.strip()
این تابع فقط یک نمونه ساده است. در پروژه واقعی باید اعداد، نیمفاصله، علائم، URLها و اصطلاحات تخصصی نیز بر اساس نیاز محصول مدیریت شوند.
طبقهبندی متن با Embedding و SVM
Embedding متن را به یک بردار عددی متراکم تبدیل میکند که بخشی از معنای آن را نمایش میدهد.
در این معماری:
متن فارسی
↓
مدل Embedding
↓
بردار عددی
↓
Linear SVM
↓
دستهبندی
مزیت احتمالی نسبت به TF-IDF این است که متنهایی با معنای نزدیک، حتی اگر کلمات دقیقاً یکسانی نداشته باشند، میتوانند بردارهای نزدیکتری داشته باشند.
برای آشنایی بیشتر، مقاله Embedding چیست؟ را مطالعه کنید.
دریافت Embedding از API درواره
ابتدا کتابخانهها را نصب کنید:
pip install openai scikit-learn pandas joblib
متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_EMBEDDING_MODEL="YOUR_EMBEDDING_MODEL_ID"
شناسه مدل را از فهرست فعلی مدلهای Embedding در درواره انتخاب کنید.
ساخت Client:
import os

from openai import OpenAI


client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)

EMBEDDING_MODEL = os.environ[
    "DARVAREH_EMBEDDING_MODEL"
]
ساخت Embedding بهصورت گروهی
def create_embeddings(
    texts,
    batch_size=64,
):
    vectors = []

    for start in range(
        0,
        len(texts),
        batch_size,
    ):
        batch = texts[
            start:start + batch_size
        ]

        response = client.embeddings.create(
            model=EMBEDDING_MODEL,
            input=batch,
        )

        ordered_items = sorted(
            response.data,
            key=lambda item: item.index,
        )

        vectors.extend(
            item.embedding
            for item in ordered_items
        )

    return vectors
مرتبسازی بر اساس index کمک میکند ترتیب بردارها با ترتیب متنهای ورودی هماهنگ بماند.
آموزش SVM روی Embeddingهای فارسی
import numpy as np
import pandas as pd

from sklearn.metrics import (
    classification_report,
)
from sklearn.model_selection import (
    train_test_split,
)
from sklearn.preprocessing import (
    LabelEncoder,
    Normalizer,
)
from sklearn.pipeline import Pipeline
from sklearn.svm import LinearSVC


data = pd.read_csv("tickets.csv")

texts = [
    normalize_persian(text)
    for text in data["text"].tolist()
]

embeddings = np.asarray(
    create_embeddings(texts),
    dtype=np.float32,
)

label_encoder = LabelEncoder()

labels = label_encoder.fit_transform(
    data["category"]
)

(
    X_train,
    X_test,
    y_train,
    y_test,
) = train_test_split(
    embeddings,
    labels,
    test_size=0.2,
    stratify=labels,
    random_state=42,
)

embedding_classifier = Pipeline(
    [
        (
            "normalize",
            Normalizer(norm="l2"),
        ),
        (
            "classifier",
            LinearSVC(
                C=1.0,
                class_weight="balanced",
            ),
        ),
    ]
)

embedding_classifier.fit(
    X_train,
    y_train,
)

predictions = embedding_classifier.predict(
    X_test
)

print(
    classification_report(
        y_test,
        predictions,
        target_names=label_encoder.classes_,
    )
)
پیشبینی دسته پیام جدید
def classify_messages(messages):
    normalized_messages = [
        normalize_persian(message)
        for message in messages
    ]

    vectors = np.asarray(
        create_embeddings(
            normalized_messages
        ),
        dtype=np.float32,
    )

    encoded_predictions = (
        embedding_classifier.predict(vectors)
    )

    return label_encoder.inverse_transform(
        encoded_predictions
    )


messages = [
    "چطور API را به برنامه پایتون وصل کنم؟",
    "پرداخت انجام شده ولی موجودی اضافه نشده",
]

categories = classify_messages(messages)

for message, category in zip(
    messages,
    categories,
):
    print({
        "message": message,
        "category": category,
    })
ذخیره مدل آموزشدیده
import joblib


joblib.dump(
    {
        "classifier": embedding_classifier,
        "label_encoder": label_encoder,
        "embedding_model": EMBEDDING_MODEL,
    },
    "ticket_classifier.joblib",
)
بارگذاری:
artifacts = joblib.load(
    "ticket_classifier.joblib"
)

embedding_classifier = artifacts[
    "classifier"
]

label_encoder = artifacts[
    "label_encoder"
]
فایلهای مدل را فقط از منبع مورداعتماد بارگذاری کنید؛ زیرا قالبهایی مانند Pickle و Joblib برای ورودی ناشناس ایمن نیستند.
چرا شناسه مدل Embedding باید ذخیره شود؟
اگر مدل Embedding تغییر کند، ابعاد یا هندسه بردارها نیز ممکن است تغییر کند. در نتیجه طبقهبند آموزشدیده با مدل قبلی نباید بدون ارزیابی روی بردارهای مدل جدید استفاده شود.
همراه هر نسخه طبقهبند این موارد را ذخیره کنید:
- شناسه دقیق مدل Embedding
- نسخه داده آموزشی
- نسخه نرمالساز فارسی
- نسخه Label Encoder
- تاریخ آموزش
- معیارهای ارزیابی
- پارامترهای SVM
- ابعاد بردار
- نسخه کتابخانهها
مقایسه TF-IDF و Embedding برای SVM
| ویژگی | TF-IDF + SVM | Embedding + SVM |
|---|---|---|
| نیاز به API | ندارد | در این مثال دارد |
| درک شباهت معنایی | محدود | معمولاً بهتر |
| سرعت آموزش طبقهبند | بالا | بالا |
| هزینه تولید ویژگی | کم | وابسته به مدل |
| کار با واژههای دقیق | قوی | مناسب |
| ابعاد بردار | معمولاً بسیار زیاد | متراکم و ثابت |
| سازگاری با متن جدید | وابسته به واژگان | معمولاً بهتر |
| استقرار کاملاً محلی | ساده | نیازمند مدل محلی یا API |
| مدیریت نسخه | واژگان و Vectorizer | مدل Embedding و طبقهبند |
بهترین انتخاب باید با یک مجموعه ارزیابی واقعی فارسی تعیین شود.
استفاده از SVM برای مسیریابی درخواستها
طبقهبند SVM میتواند دسته پیام را پیشبینی کند:
sales
technical
billing
feedback
other
سپس نرمافزار میتواند برای هر دسته:
- پرامپت متفاوتی انتخاب کند.
- مدل مناسبتری فراخوانی کند.
- ابزارهای مجاز را محدود کند.
- پیام را به صف مشخصی بفرستد.
- سطح اولویت را تعیین کند.
- در صورت اطمینان پایین، درخواست را ارجاع دهد.
نمونه:
MODEL_BY_CATEGORY = {
    "sales": os.environ["DARVAREH_FAST_MODEL"],
    "technical": os.environ[
        "DARVAREH_QUALITY_MODEL"
    ],
    "billing": os.environ[
        "DARVAREH_FAST_MODEL"
    ],
    "feedback": os.environ[
        "DARVAREH_FAST_MODEL"
    ],
    "other": os.environ[
        "DARVAREH_QUALITY_MODEL"
    ],
}
انتخاب مدل:
def select_model_for_message(message):
    category = classify_messages(
        [message]
    )[0]

    return (
        category,
        MODEL_BY_CATEGORY[category],
    )
ارسال درخواست:
def answer_message(message):
category, model = (
select_model_for_message(message)
)
response = client.chat.completions.create(
model=model,
temperature=0.2,
max_tokens=600,
messages=[
{
"role": "system",
"content": (
"به پیام کاربر به زبان فارسی، "
"دقیق و حرفهای پاسخ بده."
),
},
{
"role": "user",
"content": message,
},
],
)
return {
"category": category,
"model": model,
"answer": (
response.choices[0].message.content
or ""
),
}
کلید API و منطق مسیریابی باید در سمت سرور نگهداری شوند.
اطمینان مدل در LinearSVC
LinearSVC مقدار فاصله از مرز را از طریق decision_function ارائه میکند:
scores = (
    embedding_classifier.decision_function(
        new_vectors
    )
)
این مقادیر احتمال نیستند. برای دریافت احتمال کالیبرهشده میتوان مدل را با CalibratedClassifierCV ترکیب کرد:
from sklearn.calibration import (
    CalibratedClassifierCV,
)


calibrated_classifier = (
    CalibratedClassifierCV(
        estimator=LinearSVC(
            C=1.0,
            class_weight="balanced",
        ),
        method="sigmoid",
        cv=5,
    )
)
پس از آموزش:
probabilities = (
    calibrated_classifier.predict_proba(
        X_test
    )
)
کالیبراسیون باید روی داده مناسب انجام و جداگانه ارزیابی شود.
مدیریت کلاسهای نامتوازن
در داده تیکت ممکن است بعضی دستهها بسیار پرتکرار و بعضی کمیاب باشند.
راهکارها:
- استفاده از
class_weight="balanced" - جمعآوری نمونه بیشتر برای کلاسهای کمیاب
- استفاده از Macro F1
- بررسی Recall هر کلاس
- Stratified Split
- ادغام کلاسهای بسیار مبهم
- تعریف دسته
other - بازبینی خطاهای مدل
- تنظیم Threshold پس از کالیبراسیون
فقط افزایش مصنوعی نمونهها بدون بررسی کیفیت برچسبها ممکن است نتیجه را بدتر کند.
Confusion Matrix برای تحلیل خطا
from sklearn.metrics import (
    ConfusionMatrixDisplay,
)
import matplotlib.pyplot as plt


ConfusionMatrixDisplay.from_predictions(
    y_test,
    predictions,
    display_labels=label_encoder.classes_,
    xticks_rotation=45,
)

plt.tight_layout()
plt.show()
ماتریس اغتشاش نشان میدهد کدام دستهها بیشتر با یکدیگر اشتباه گرفته میشوند.
برای مثال، اگر پیامهای billing و sales مرتب اشتباه شوند، ممکن است:
- تعریف برچسبها مبهم باشد.
- نمونه کافی وجود نداشته باشد.
- بعضی متنها واقعاً چندموضوعی باشند.
- داده برچسبگذاری ناسازگار باشد.
داده چندبرچسبی
ممکن است یک پیام همزمان چند دسته داشته باشد:
technical + billing
sales + technical
در این حالت مسئله Multi-label است، نه Multi-class.
میتوان از روش One-vs-Rest استفاده کرد:
from sklearn.multiclass import (
    OneVsRestClassifier,
)


multi_label_model = OneVsRestClassifier(
    LinearSVC(
        C=1.0,
        class_weight="balanced",
    )
)
برچسبها نیز باید با ساختاری مانند MultiLabelBinarizer تبدیل شوند.
مزایای SVM
- عملکرد مناسب در بسیاری از مسائل طبقهبندی
- مؤثر در فضای با ابعاد زیاد
- مناسب برای متن و داده Sparse
- امکان استفاده از Kernelهای غیرخطی
- تمرکز روی نمونههای نزدیک مرز
- کنترل منظمسازی با پارامتر
C - کاربرد در طبقهبندی، رگرسیون و تشخیص ناهنجاری
- عملکرد مناسب با داده کوچک یا متوسط و ویژگیهای باکیفیت
محدودیتهای SVM
- حساسیت به مقیاس ویژگیها
- هزینه زیاد SVC غیرخطی روی داده بزرگ
- تنظیم دشوار
Cوgamma - تفسیرپذیری محدود در Kernelهای غیرخطی
- عدم ارائه احتمال مستقیم در بعضی پیادهسازیها
- حساسیت به نویز و Outlier در تنظیمات نامناسب
- نیاز به تبدیل متن، تصویر یا صوت به بردار
- کاهش کارایی در داده بسیار بزرگ یا بسیار پرنویز
تفاوت SVM و Logistic Regression
| ویژگی | SVM | Logistic Regression |
|---|---|---|
| هدف اصلی | بیشینهکردن Margin | مدلکردن احتمال کلاس |
| احتمال خروجی | نیازمند کالیبراسیون در برخی مدلها | طبیعیتر |
| Kernel | پشتیبانی میکند | نسخه استاندارد خیر |
| داده Sparse | LinearSVC مناسب | بسیار مناسب |
| تفسیر ضرایب | در مدل خطی ممکن | معمولاً سادهتر |
| مرز غیرخطی | با Kernel | نیازمند ساخت ویژگی |
| مقیاسبندی | مهم | معمولاً مهم |
برای طبقهبندی متن، هر دو مدل باید بهعنوان خط مبنا آزمایش شوند.
تفاوت SVM و درخت تصمیم
| ویژگی | SVM | درخت تصمیم |
|---|---|---|
| مرز تصمیم | خطی یا Kernel-based | تقسیمهای شرطی |
| نیاز به Scaling | دارد | معمولاً ندارد |
| تفسیرپذیری | محدودتر | بیشتر |
| داده با ابعاد زیاد | مناسب | وابسته به مسئله |
| تعامل غیرخطی | با Kernel | بهصورت طبیعی |
| احتمال بیشبرازش | با C و gamma کنترل میشود | با عمق و هرس |
| طبقهبندی متن | Linear SVM بسیار مناسب | معمولاً خط مبنای ضعیفتر |
برای آشنایی بیشتر، مقاله درخت تصمیم و Random Forest را مطالعه کنید.
تفاوت SVM و شبکه عصبی
| ویژگی | SVM | شبکه عصبی |
|---|---|---|
| داده کوچک و متوسط | اغلب مناسب | ممکن است به داده بیشتر نیاز داشته باشد |
| داده خام تصویر و صوت | محدود | بسیار مناسبتر |
| ویژگیسازی | معمولاً لازم | میتواند ویژگی را یاد بگیرد |
| هزینه آموزش | متوسط تا زیاد | معمولاً زیاد |
| مقیاسپذیری | SVC محدود | معماریهای بزرگ مقیاسپذیرتر |
| تنظیمات | C، gamma و Kernel | معماری و پارامترهای متعدد |
در معماریهای مدرن میتوان از مدل عمیق فقط برای تولید Embedding و از SVM برای طبقهبندی نهایی استفاده کرد.
چه زمانی از SVM استفاده کنیم؟
SVM انتخاب مناسبی است اگر:
- مسئله طبقهبندی نظارتشده دارید.
- داده کوچک یا متوسط است.
- تعداد ویژگیها زیاد است.
- Embedding یا TF-IDF در اختیار دارید.
- مرز تصمیم خطی یا قابلمدلسازی با Kernel است.
- یک خط مبنای قوی برای متن میخواهید.
- کیفیت ویژگیها مناسب است.
احتمالاً انتخاب مناسبی نیست اگر:
- میلیونها نمونه دارید و میخواهید از SVC غیرخطی استفاده کنید.
- داده اصلی باید بدون استخراج ویژگی پردازش شود.
- تفسیر کامل قواعد لازم است.
- احتمال کالیبرهشده مستقیماً موردنیاز است.
- داده نویز بسیار زیادی دارد.
- آموزش و پیشبینی باید با منابع بسیار محدود انجام شود.
اشتباهات رایج در استفاده از SVM
نرمالنکردن ویژگیها
تفاوت مقیاس میتواند مرز تصمیم را منحرف کند.
Fit کردن Scaler روی کل داده
این کار باعث Data Leakage میشود. Scaler باید داخل Pipeline قرار گیرد.
استفاده از SVC روی داده بسیار بزرگ
کرنل غیرخطی میتواند زمان و حافظه زیادی مصرف کند. LinearSVC یا روشهای خطی دیگر را بررسی کنید.
انتخاب C و gamma بدون Cross-validation
تنظیمات پیشفرض همیشه برای داده واقعی مناسب نیستند.
فعالکردن probability بدون نیاز
در SVC محاسبه احتمال میتواند آموزش را گرانتر کند. فقط در صورت نیاز آن را فعال کنید.
استفاده از Accuracy روی داده نامتوازن
عملکرد هر کلاس و معیارهایی مانند Macro F1 و PR AUC را بررسی کنید.
ارزیابی روی داده آموزش
امتیاز آموزش میزان تعمیم مدل را نشان نمیدهد.
استفاده از Embedding جدید با طبقهبند قدیمی
با تغییر مدل Embedding باید سازگاری بردارها بررسی و معمولاً طبقهبند دوباره آموزش داده شود.
نادیدهگرفتن کلاس ناشناخته
طبقهبند همیشه یکی از کلاسهای شناختهشده را انتخاب میکند. برای پیامهای خارج از دامنه باید Threshold، دسته other یا سازوکار ارجاع تعریف شود.
پرسشهای متداول
SVM مخفف چیست؟
SVM مخفف Support Vector Machine و به معنای ماشین بردار پشتیبان است.
SVM به زبان ساده چگونه کار میکند؟
SVM مرزی میان کلاسها پیدا میکند که بیشترین فاصله را از نزدیکترین نمونههای دو طرف داشته باشد.
Support Vector چیست؟
نمونهای نزدیک به مرز تصمیم است که در تعیین موقعیت مرز نقش اصلی دارد.
Kernel در SVM چیست؟
Kernel روشی برای محاسبه شباهت نمونهها در فضای ویژگی جدید است و امکان ساخت مرزهای غیرخطی را فراهم میکند.
تفاوت C و gamma چیست؟
C میزان جریمه خطا را کنترل میکند. gamma شعاع اثر نمونهها را در Kernelهایی مانند RBF تعیین میکند.
آیا SVM برای متن فارسی مناسب است؟
بله. Linear SVM همراه با TF-IDF یا Embedding میتواند خط مبنای قدرتمندی برای دستهبندی متن فارسی باشد. کیفیت نتیجه باید روی داده واقعی فارسی سنجیده شود.
آیا SVM برای رگرسیون استفاده میشود؟
بله. نسخه رگرسیونی آن Support Vector Regression یا SVR نام دارد.
آیا SVM احتمال کلاس را برمیگرداند؟
SVC با probability=True میتواند احتمال ارائه کند. LinearSVC احتمال مستقیم ندارد و در صورت نیاز باید کالیبره شود.
آیا SVM برای داده بزرگ مناسب است؟
نسخه خطی میتواند برای دادههای بزرگتر و Sparse مناسب باشد، اما SVC با Kernel غیرخطی با افزایش تعداد نمونهها پرهزینه میشود.
آیا میتوان SVM را به API درواره متصل کرد؟
بله. میتوان متنها را با یک مدل Embedding درواره به بردار تبدیل کرد، سپس SVM را برای طبقهبندی آنها آموزش داد. نتیجه طبقهبندی نیز میتواند مدل یا گردشکار مناسب را انتخاب کند.
جمعبندی
ماشین بردار پشتیبان یا SVM یک الگوریتم یادگیری نظارتشده برای طبقهبندی، رگرسیون و تشخیص ناهنجاری است.
مفاهیم اصلی آن عبارتاند از:
- Hyperplane
- Margin
- Support Vector
- Soft Margin
- پارامتر
C - Kernel Trick
- پارامتر
gamma - Scaling
SVM خطی برای دادههای با ابعاد زیاد، TF-IDF و Embeddingها مناسب است. SVM با Kernel RBF میتواند مرزهای غیرخطی بسازد، اما تنظیم C و gamma و هزینه محاسباتی آن باید جدی گرفته شود.
برای استفاده صحیح از SVM باید:
- داده را به آموزش، اعتبارسنجی و آزمایش تقسیم کنید.
- Scaling را داخل Pipeline قرار دهید.
- معیار مناسب با مسئله انتخاب کنید.
Cوgammaرا با Cross-validation تنظیم کنید.- داده نامتوازن را مدیریت کنید.
- روی داده بزرگ، LinearSVC را بررسی کنید.
- احتمال خروجی را در صورت نیاز کالیبره کنید.
- مدل Embedding و طبقهبند را با هم نسخهبندی کنید.
- برای ورودی خارج از دامنه سازوکار مشخص داشته باشید.
- عملکرد مدل را پس از استقرار پایش کنید.
برای دریافت Embedding، تولید پاسخ و استفاده از مدلهای مختلف در نرمافزار میتوانید از مستندات API درواره شروع کنید.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
API درواره با ساختار OpenAI سازگار است و امکان اتصال یکپارچه برنامهها به مدلهای مختلف را فراهم میکند.
مقالات مرتبط
- یادگیری ماشین چیست؟
- یادگیری نظارتشده چیست؟
- Embedding چیست؟
- Scikit-learn چیست؟
- درخت تصمیم و Random Forest
- بهینهسازی بیزی و Optuna
- ارزیابی مدلهای هوش مصنوعی و Evals
- مسیریابی هوشمند میان مدلها
- راهنمای API سازگار با OpenAI
منابع
- Scikit-learn Support Vector Machines
- Scikit-learn SVC
- Scikit-learn LinearSVC
- Scikit-learn SVR
- Scikit-learn One-Class SVM
- RBF SVM Parameters
- Classification of Text Documents
- Scikit-learn Text Analytics Tutorial
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.