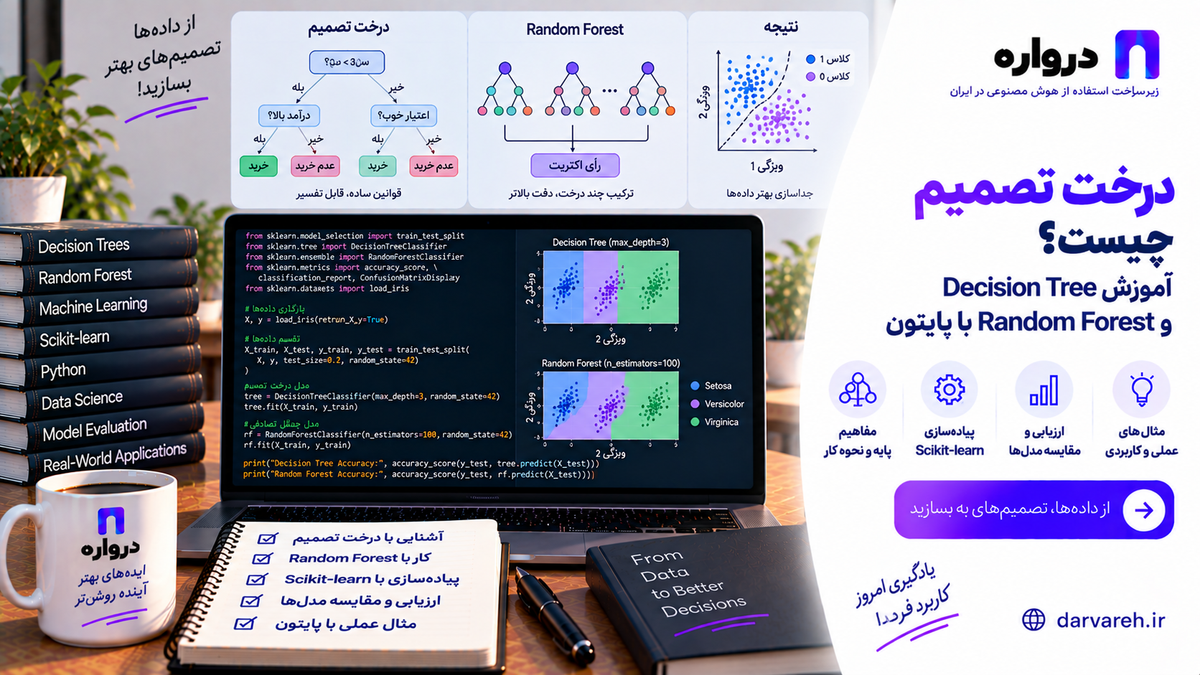
درخت تصمیم چیست؟ آموزش Decision Tree و Random Forest با پایتون
درخت تصمیم یکی از مهمترین الگوریتمهای یادگیری ماشین برای طبقهبندی و رگرسیون است. د
درخت تصمیم یا Decision Tree یکی از پرکاربردترین الگوریتمهای یادگیری ماشین برای طبقهبندی و رگرسیون است. این الگوریتم دادهها را با مجموعهای از پرسشهای شرطی تقسیم میکند تا در نهایت به یک پیشبینی برسد.
برای مثال، یک سامانه پشتیبانی میتواند چنین تصمیمی بگیرد:
آیا پیام درباره خطای فنی است؟
├── خیر: آیا درباره خرید است؟
│   ├── بله: بخش فروش
│   └── خیر: پشتیبانی عمومی
└── بله: آیا سرویس متوقف شده است؟
    ├── بله: اولویت فوری
    └── خیر: اولویت عادی
این ساختار برای انسان قابلفهم است و میتوان مسیر رسیدن مدل به تصمیم را بررسی کرد. اما یک درخت عمیق ممکن است دادههای آموزشی را بیشازحد حفظ کند و روی دادههای جدید عملکرد ضعیفی داشته باشد.
Random Forest یا جنگل تصادفی این مشکل را با ساخت تعداد زیادی درخت و ترکیب خروجی آنها کاهش میدهد.
در این مقاله ابتدا درخت تصمیم را از پایه بررسی میکنیم، سپس معیارهای Gini و Entropy، کنترل بیشبرازش، هرس درخت، Random Forest، اهمیت ویژگیها و پیادهسازی عملی با Scikit-learn را توضیح میدهیم.
درخت تصمیم چیست؟
درخت تصمیم یک مدل یادگیری نظارتشده است که فضای داده را با قواعد شرطی به بخشهای کوچکتر تقسیم میکند.
هر تقسیم با یک سؤال درباره یکی از ویژگیها انجام میشود:
age <= 35?
monthly_usage > 100?
error_count <= 2?
account_type == business?
هدف الگوریتم این است که تقسیمهایی پیدا کند که نمونههای هر بخش تا حد امکان شبیه یکدیگر باشند.
در مسئله طبقهبندی، مدل تلاش میکند هر برگ بیشتر شامل نمونههای یک کلاس باشد. در مسئله رگرسیون، نمونههای هر برگ باید مقادیر هدف نزدیکتری داشته باشند.
Scikit-learn ابزارهای متنباز و استانداردی برای تحلیل پیشبینی، طبقهبندی، رگرسیون و سایر مسائل یادگیری ماشین ارائه میکند.
اجزای درخت تصمیم
گره ریشه
Root Node اولین گره درخت است و تمام دادههای آموزشی در ابتدای کار در آن قرار دارند.
الگوریتم بهترین ویژگی و آستانه را برای اولین تقسیم انتخاب میکند.
مثال:
monthly_usage <= 42?
گره تصمیم
هر گره داخلی یک شرط را بررسی میکند و نمونهها را به شاخههای مختلف میفرستد.
شاخه
شاخه نتیجه یک شرط است. در درخت دودویی هر گره معمولاً دو شاخه دارد:
شرط برقرار است
شرط برقرار نیست
برگ
Leaf Node آخرین بخش مسیر است و پیشبینی مدل در آن قرار دارد.
در طبقهبندی، برگ میتواند کلاس نهایی یا احتمال کلاسها را نگه دارد:
technical_issue: 0.82
billing_issue: 0.12
other: 0.06
در رگرسیون، برگ معمولاً مقدار میانگین یا میانه نمونههای آن بخش را پیشبینی میکند.
عمق درخت
عمق درخت تعداد تقسیمهای مسیر ریشه تا یک برگ است.
درخت عمیقتر میتواند الگوهای پیچیدهتری یاد بگیرد، اما خطر بیشبرازش آن نیز بیشتر است.
درخت تصمیم چگونه آموزش میبیند؟
الگوریتم در هر گره چند تقسیم احتمالی را بررسی میکند:
feature_j <= threshold
سپس میزان خالصترشدن فرزندان را اندازه میگیرد. تقسیمی انتخاب میشود که بیشترین کاهش ناخالصی یا خطا را ایجاد کند.
این فرایند بهصورت بازگشتی ادامه پیدا میکند تا یکی از شرایط توقف برقرار شود:
- رسیدن به حداکثر عمق
- خالصشدن کامل گره
- کمبودن تعداد نمونهها
- کمبودن بهبود تقسیم
- رسیدن به حداقل نمونه برگ
- اعمال هرس
ناخالصی در درخت تصمیم چیست؟
ناخالصی یا Impurity نشان میدهد نمونههای یک گره تا چه اندازه از کلاسهای مختلف تشکیل شدهاند.
اگر تمام نمونهها متعلق به یک کلاس باشند، گره خالص است. اگر کلاسها بهصورت مخلوط حضور داشته باشند، ناخالصی بیشتر است.
معیارهای شناختهشده برای طبقهبندی:
- Gini Impurity
- Entropy
- Log Loss
برای رگرسیون نیز معیارهایی مانند خطای مربعات، خطای مطلق و Poisson Deviance قابلاستفادهاند. مستندات DecisionTreeRegressor در Scikit-learn معیارهایی مانند squared_error، absolute_error و poisson را ارائه میکند.
معیار Gini چیست؟
ناخالصی جینی با فرمول زیر محاسبه میشود:
Gini=1−∑k=1Kpk2Gini=1-\sum_{k=1}^{K}p_k^2
در این رابطه:
Kتعداد کلاسها است.pₖسهم کلاسkدر گره است.
فرض کنید یک گره شامل ۱۰ نمونه باشد:
- ۸ نمونه کلاس مثبت
- ۲ نمونه کلاس منفی
در نتیجه:
Gini=1−(0.82+0.22)=0.32Gini = 1-(0.8^2+0.2^2) = 0.32
اگر همه نمونهها متعلق به یک کلاس باشند:
Gini=0Gini=0
مقدار صفر یعنی گره کاملاً خالص است.
Entropy چیست؟
Entropy میزان بینظمی یا عدمقطعیت را اندازه میگیرد:
Entropy=−∑k=1Kpklog2(pk)Entropy= -\sum_{k=1}^{K} p_k\log_2(p_k)
برای همان مثال:
Entropy=−(0.8log2(0.8)+0.2log2(0.2))Entropy= -\left( 0.8\log_2(0.8) + 0.2\log_2(0.2) \right)
که تقریباً برابر ۰٫۷۲ است.
اگر همه نمونهها متعلق به یک کلاس باشند، Entropy صفر خواهد بود.
Information Gain چیست؟
Information Gain مشخص میکند یک تقسیم تا چه اندازه ناخالصی را کاهش داده است.
InformationGain=Impurity(parent)−WeightedImpurity(children)InformationGain= Impurity(parent) - WeightedImpurity(children)
ناخالصی وزنی فرزندان:
WeightedImpurity=nLnIL+nRnIRWeightedImpurity= \frac{n_L}{n}I_L+ \frac{n_R}{n}I_R
الگوریتم معمولاً تقسیمی را انتخاب میکند که بیشترین کاهش ناخالصی را ایجاد کند.
Gini بهتر است یا Entropy؟
هر دو معیار در بسیاری از مسائل نتایج مشابهی ایجاد میکنند.
| ویژگی | Gini | Entropy |
|---|---|---|
| مبنای محاسبه | مربع احتمال | لگاریتم احتمال |
| هزینه محاسباتی | کمی سادهتر | کمی بیشتر |
| مقدار گره خالص | صفر | صفر |
| کاربرد | CART و بسیاری از مدلها | نظریه اطلاعات |
| برتری قطعی | ندارد | ندارد |
بهتر است انتخاب معیار با Cross-validation انجام شود و فقط بر اساس شهرت یک معیار تصمیم نگیرید.
یک مثال ساده از انتخاب تقسیم
فرض کنید دادههای زیر را داریم:
| مصرف ماهانه | تعداد خطا | ریزش مشتری |
|---|---|---|
| ۱۰ | ۰ | خیر |
| ۱۵ | ۱ | خیر |
| ۳۰ | ۱ | خیر |
| ۵۰ | ۳ | بله |
| ۷۰ | ۴ | بله |
| ۹۰ | ۶ | بله |
یک تقسیم مناسب میتواند چنین باشد:
error_count <= 1?
شاخه اول عمدتاً شامل مشتریان بدون ریزش و شاخه دوم شامل مشتریان دارای ریزش است. بنابراین ناخالصی پس از تقسیم کاهش پیدا میکند.
در داده واقعی، الگوریتم آستانههای مختلف تمام ویژگیهای مجاز را ارزیابی میکند.
درخت تصمیم برای طبقهبندی
Decision Tree Classifier زمانی استفاده میشود که متغیر هدف دستهای باشد.
مثالها:
- پیام فروش یا پشتیبانی
- تراکنش عادی یا مشکوک
- مشتری ماندگار یا در معرض ریزش
- محصول سالم یا معیوب
- درخواست ساده یا پیچیده
- ایمیل عادی یا هرزنامه
خروجی مدل میتواند کلاس یا احتمال کلاسها باشد.
درخت تصمیم برای رگرسیون
Decision Tree Regressor برای پیشبینی مقدار عددی استفاده میشود.
مثالها:
- پیشبینی فروش
- زمان تحویل
- هزینه تعمیر
- مدت پاسخگویی
- میزان مصرف
- ارزش طول عمر مشتری
درخت رگرسیون فضای ویژگیها را به ناحیههایی تقسیم میکند و برای هر برگ یک مقدار ثابت پیشبینی میکند.
درخت بسیار عمیق میتواند جزئیات و نویز داده آموزش را یاد بگیرد و دچار بیشبرازش شود. مستندات Scikit-learn نیز نشان میدهد افزایش بیشازحد max_depth میتواند باعث یادگیری نویز داده شود.
بیشبرازش درخت تصمیم
درخت تصمیم بدون محدودیت میتواند تا جایی رشد کند که هر برگ فقط یک یا چند نمونه داشته باشد.
در این حالت:
- دقت آموزش بسیار بالا میشود.
- قواعد بسیار جزئی ساخته میشوند.
- نویز داده یاد گرفته میشود.
- عملکرد روی داده جدید کاهش پیدا میکند.
نشانههای بیشبرازش:
- اختلاف زیاد امتیاز آموزش و اعتبارسنجی
- عمق بسیار زیاد
- تعداد زیاد برگها
- برگهای دارای یک نمونه
- تغییر شدید مدل با تغییر کوچک داده
مهمترین ابرپارامترهای درخت تصمیم
max_depth
حداکثر عمق درخت را تعیین میکند:
DecisionTreeClassifier(
    max_depth=5,
)
مقدار کوچکتر درخت را سادهتر و قابلتفسیرتر میکند.
min_samples_split
حداقل تعداد نمونه لازم برای تقسیم یک گره:
DecisionTreeClassifier(
    min_samples_split=20,
)
min_samples_leaf
حداقل تعداد نمونهای که باید در هر برگ باقی بماند:
DecisionTreeClassifier(
    min_samples_leaf=10,
)
این پارامتر میتواند از ساخت برگهای بسیار کوچک جلوگیری کند.
max_leaf_nodes
حداکثر تعداد برگها:
DecisionTreeClassifier(
    max_leaf_nodes=30,
)
max_features
تعداد ویژگیهایی که برای پیدا کردن هر تقسیم بررسی میشوند.
class_weight
برای داده نامتوازن میتوان وزن کلاسها را تنظیم کرد:
DecisionTreeClassifier(
    class_weight="balanced",
)
ccp_alpha
پارامتر مربوط به Cost Complexity Pruning:
DecisionTreeClassifier(
    ccp_alpha=0.01,
)
هرچه ccp_alpha بزرگتر باشد، بخشهای بیشتری از درخت حذف میشوند.
هرس درخت تصمیم چیست؟
Pruning یا هرس، شاخههایی را حذف میکند که پیچیدگی زیادی ایجاد میکنند اما بهبود کافی در عملکرد مدل ندارند.
دو رویکرد کلی وجود دارد:
پیشهرس
رشد درخت از ابتدا محدود میشود:
max_depthmin_samples_splitmin_samples_leafmax_leaf_nodes
پسهرس
ابتدا درخت بزرگ ساخته و سپس شاخههای کمارزش حذف میشوند.
Cost Complexity Pruning میان خطای مدل و اندازه درخت تعادل ایجاد میکند:
Rα(T)=R(T)+α∣T∣R_\alpha(T)=R(T)+\alpha|T|
در این رابطه:
R(T)خطای درخت است.|T|تعداد برگها است.αمیزان جریمه پیچیدگی است.
مقدار مناسب ccp_alpha باید با داده اعتبارسنجی انتخاب شود.
آموزش درخت تصمیم با پایتون
در این مثال یک مدل طبقهبندی برای مجموعه داده Breast Cancer میسازیم.
نصب کتابخانهها
pip install scikit-learn pandas matplotlib
بارگذاری داده
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split


dataset = load_breast_cancer(
    as_frame=True,
)

X = dataset.data
y = dataset.target

X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.2,
        stratify=y,
        random_state=42,
    )
)
استفاده از stratify=y نسبت کلاسها را در داده آموزش و آزمایش تا حد امکان حفظ میکند.
ساخت مدل
from sklearn.tree import DecisionTreeClassifier


tree_model = DecisionTreeClassifier(
    criterion="gini",
    max_depth=4,
    min_samples_leaf=5,
    class_weight="balanced",
    random_state=42,
)

tree_model.fit(
    X_train,
    y_train,
)
ارزیابی مدل
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
    roc_auc_score,
)


predictions = tree_model.predict(X_test)

probabilities = tree_model.predict_proba(
    X_test
)[:, 1]

print(
    classification_report(
        y_test,
        predictions,
        target_names=dataset.target_names,
    )
)

print(
    confusion_matrix(
        y_test,
        predictions,
    )
)

print(
    "ROC AUC:",
    roc_auc_score(
        y_test,
        probabilities,
    ),
)
در کاربرد واقعی باید معیار مناسب با هزینه خطا انتخاب شود. برای مثال، اگر ازدستدادن نمونه مثبت مهمتر است، Recall اهمیت بیشتری پیدا میکند.
این مثال فقط جنبه آموزشی دارد و برای تصمیمگیری پزشکی طراحی نشده است.
رسم ساختار درخت
import matplotlib.pyplot as plt

from sklearn.tree import plot_tree


plt.figure(figsize=(22, 12))

plot_tree(
    tree_model,
    feature_names=X.columns,
    class_names=list(
        dataset.target_names
    ),
    filled=True,
    rounded=True,
    proportion=True,
    max_depth=3,
)

plt.tight_layout()
plt.show()
در نمودار میتوان اطلاعاتی مانند ویژگی تقسیم، آستانه، Gini، تعداد نمونه و توزیع کلاسها را مشاهده کرد.
استخراج قواعد درخت
برای تبدیل مدل به متن:
from sklearn.tree import export_text


rules = export_text(
    tree_model,
    feature_names=list(X.columns),
)

print(rules)
نمونه مفهومی خروجی:
|--- worst radius <= 16.80
|   |--- worst concave points <= 0.14
|   |   |--- class: benign
|   |--- worst concave points > 0.14
|   |   |--- class: malignant
|--- worst radius > 16.80
|   |--- class: malignant
قواعد استخراجشده برای تحلیل مفیدند، اما نباید بدون کنترل و نسخهبندی به قوانین قطعی کسبوکار تبدیل شوند.
ارزیابی با Cross-validation
تقسیم واحد آموزش و آزمایش ممکن است تخمین ناپایداری ایجاد کند.
from sklearn.model_selection import (
    StratifiedKFold,
    cross_validate,
)


cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

scores = cross_validate(
    tree_model,
    X,
    y,
    cv=cv,
    scoring=[
        "accuracy",
        "precision",
        "recall",
        "roc_auc",
    ],
    n_jobs=-1,
)

for metric, values in scores.items():
    if metric.startswith("test_"):
        print(
            metric,
            values.mean(),
            values.std(),
        )
گزارش میانگین و انحراف معیار از گزارش یک امتیاز منفرد قابلاعتمادتر است.
تنظیم ابرپارامترهای درخت تصمیم
میتوان از Optuna برای انتخاب پارامترهای مناسب استفاده کرد:
import optuna

from sklearn.model_selection import (
    cross_val_score,
)


def objective(trial):
    model = DecisionTreeClassifier(
        criterion=trial.suggest_categorical(
            "criterion",
            ["gini", "entropy", "log_loss"],
        ),
        max_depth=trial.suggest_int(
            "max_depth",
            2,
            20,
        ),
        min_samples_split=trial.suggest_int(
            "min_samples_split",
            2,
            40,
        ),
        min_samples_leaf=trial.suggest_int(
            "min_samples_leaf",
            1,
            30,
        ),
        max_features=trial.suggest_categorical(
            "max_features",
            [None, "sqrt", "log2"],
        ),
        ccp_alpha=trial.suggest_float(
            "ccp_alpha",
            1e-6,
            1e-1,
            log=True,
        ),
        class_weight="balanced",
        random_state=42,
    )

    scores = cross_val_score(
        model,
        X_train,
        y_train,
        cv=5,
        scoring="roc_auc",
        n_jobs=-1,
    )

    return scores.mean()


study = optuna.create_study(
    direction="maximize",
)

study.optimize(
    objective,
    n_trials=100,
)

print(study.best_value)
print(study.best_params)
برای آموزش کامل Optuna، مقاله بهینهسازی بیزی و تنظیم ابرپارامترها را مطالعه کنید.
Random Forest چیست؟
Random Forest یا جنگل تصادفی یک الگوریتم Ensemble است که تعداد زیادی درخت تصمیم میسازد و خروجی آنها را ترکیب میکند.
در طبقهبندی، معمولاً رأی درختها یا میانگین احتمال کلاسها محاسبه میشود. در رگرسیون، میانگین پیشبینی درختها استفاده میشود.
هدف این است که خطاهای درختهای مختلف یکدیگر را تا حدی خنثی کنند.
Random Forest چگونه کار میکند؟
هر درخت با دو منبع تصادفی ساخته میشود:
نمونهبرداری Bootstrap
برای هر درخت، نمونههایی از داده آموزش با جایگذاری انتخاب میشوند. در نتیجه:
- بعضی نمونهها چند بار انتخاب میشوند.
- بعضی نمونهها برای آن درخت انتخاب نمیشوند.
- هر درخت داده آموزشی کمی متفاوت دارد.
پیادهسازی جنگلهای Scikit-learn هر زیرمدل را روی نمونههای تصادفی با جایگذاری یا Bootstrap آموزش میدهد.
انتخاب تصادفی ویژگیها
در هر تقسیم، فقط زیرمجموعهای تصادفی از ویژگیها بررسی میشود.
این کار باعث میشود درختها بیشازحد شبیه یکدیگر نباشند.
اگر تمام درختها دقیقاً یک خطا را تکرار کنند، ترکیب آنها مزیت زیادی ندارد. Random Forest تلاش میکند هم مدلهای مناسبی بسازد و هم میان آنها تنوع ایجاد کند.
Bagging چیست؟
Bagging مخفف Bootstrap Aggregating است.
مراحل:
- چند مجموعه Bootstrap از داده ساخته میشود.
- روی هر مجموعه یک مدل جداگانه آموزش میبیند.
- خروجی مدلها ترکیب میشود.
Bagging معمولاً واریانس مدلهای ناپایدار مانند درخت تصمیم را کاهش میدهد.
Random Forest علاوه بر Bootstrap، انتخاب تصادفی ویژگیها را نیز اضافه میکند.
آموزش Random Forest با پایتون
from sklearn.ensemble import (
    RandomForestClassifier,
)


forest_model = RandomForestClassifier(
    n_estimators=500,
    max_depth=None,
    min_samples_leaf=2,
    max_features="sqrt",
    bootstrap=True,
    oob_score=True,
    class_weight="balanced",
    n_jobs=-1,
    random_state=42,
)

forest_model.fit(
    X_train,
    y_train,
)
ارزیابی:
forest_predictions = forest_model.predict(
    X_test
)

forest_probabilities = (
    forest_model.predict_proba(X_test)[:, 1]
)

print(
    classification_report(
        y_test,
        forest_predictions,
        target_names=dataset.target_names,
    )
)

print(
    "ROC AUC:",
    roc_auc_score(
        y_test,
        forest_probabilities,
    ),
)

print(
    "OOB score:",
    forest_model.oob_score_,
)
OOB Score چیست؟
در نمونهبرداری Bootstrap، بعضی رکوردها برای آموزش یک درخت انتخاب نمیشوند. این نمونهها Out-of-bag یا OOB نام دارند.
میتوان عملکرد هر نمونه را با استفاده از درختهایی سنجید که آن نمونه را در زمان آموزش ندیدهاند.
OOB Score یک تخمین داخلی از عملکرد مدل ارائه میکند، اما همیشه جایگزین داده آزمایش مستقل یا Cross-validation نیست.
ابرپارامترهای مهم Random Forest
n_estimators
تعداد درختها:
n_estimators=500
درخت بیشتر معمولاً پیشبینی را پایدارتر میکند، اما زمان آموزش، حافظه و زمان پیشبینی افزایش مییابد.
max_features
تعداد ویژگیهای بررسیشده در هر تقسیم:
max_features="sqrt"
مقدار کمتر میتواند تنوع درختها را افزایش دهد.
max_depth
حداکثر عمق هر درخت را کنترل میکند.
min_samples_leaf
از ساخت برگهای بسیار کوچک جلوگیری میکند.
bootstrap
فعال یا غیرفعالبودن نمونهبرداری Bootstrap را تعیین میکند.
max_samples
اگر Bootstrap فعال باشد، سهم یا تعداد نمونههای استفادهشده برای هر درخت را کنترل میکند.
class_weight
برای داده نامتوازن قابلاستفاده است:
class_weight="balanced"
n_jobs
تعداد پردازشهای موازی:
n_jobs=-1
مقدار منفی یک معمولاً از تمام هستههای در دسترس استفاده میکند.
مقایسه درخت تصمیم و Random Forest
| ویژگی | درخت تصمیم | Random Forest |
|---|---|---|
| تعداد درخت | یک | چندین درخت |
| تفسیرپذیری | بالا | کمتر |
| احتمال بیشبرازش | بالا | معمولاً کمتر |
| دقت پیشبینی | خط مبنای مناسب | اغلب بهتر |
| زمان آموزش | کمتر | بیشتر |
| زمان پیشبینی | کمتر | بیشتر |
| حافظه | کمتر | بیشتر |
| پایداری | پایینتر | بالاتر |
| استخراج قواعد | سادهتر | دشوارتر |
اگر توضیح کامل هر تصمیم اهمیت زیادی دارد، یک درخت محدود ممکن است مناسبتر باشد. اگر عملکرد پیشبینی اولویت اصلی است، Random Forest معمولاً گزینه قویتری برای دادههای جدولی محسوب میشود.
Feature Importance چیست؟
اهمیت ویژگی نشان میدهد مدل تا چه اندازه از هر ویژگی برای پیشبینی استفاده کرده است.
در مدل درختی Scikit-learn میتوان اهمیت مبتنی بر کاهش ناخالصی را دریافت کرد:
import pandas as pd


importance = pd.Series(
    forest_model.feature_importances_,
    index=X.columns,
).sort_values(
    ascending=False
)

print(importance.head(10))
اما این اهمیت را نباید با رابطه علّی اشتباه گرفت. مهمبودن یک ویژگی در مدل به این معنی نیست که تغییر آن ویژگی حتماً باعث تغییر نتیجه واقعی میشود.
محدودیت اهمیت مبتنی بر ناخالصی
feature_importances_ معمولاً بر اساس کاهش ناخالصی محاسبه میشود. این معیار میتواند به ویژگیهایی که مقادیر متمایز زیادی دارند یا امکان تقسیمهای بیشتری ایجاد میکنند تمایل نشان دهد.
همچنین اگر دو ویژگی همبستگی زیادی داشته باشند، اهمیت ممکن است میان آنها تقسیم یا به یکی از آنها نسبت داده شود.
برای تحلیل قابلاعتمادتر باید روشهایی مانند Permutation Importance نیز بررسی شوند.
Permutation Importance چیست؟
در Permutation Importance مقادیر یک ویژگی بهصورت تصادفی جابهجا میشوند. اگر عملکرد مدل بهطور محسوسی کاهش یابد، آن ویژگی برای پیشبینی مهم بوده است.
Scikit-learn این معیار را بهصورت اختلاف امتیاز پایه و امتیاز پس از جابهجایی تصادفی ستون ویژگی تعریف میکند.
پیادهسازی:
from sklearn.inspection import (
    permutation_importance,
)


permutation_result = permutation_importance(
    forest_model,
    X_test,
    y_test,
    scoring="roc_auc",
    n_repeats=20,
    random_state=42,
    n_jobs=-1,
)

permutation_scores = pd.Series(
    permutation_result.importances_mean,
    index=X.columns,
).sort_values(
    ascending=False
)

print(permutation_scores.head(10))
بهتر است Permutation Importance روی داده اعتبارسنجی یا آزمایش محاسبه شود، نه فقط داده آموزش.
آیا Random Forest قابلتفسیر است؟
Random Forest نسبت به یک درخت منفرد تفسیرپذیری کمتری دارد، زیرا خروجی صدها درخت ترکیب میشود.
روشهای تحلیل:
- Feature Importance
- Permutation Importance
- Partial Dependence
- Individual Conditional Expectation
- SHAP
- تحلیل نمونههای OOB
- بررسی درختهای منتخب
هیچکدام از این ابزارها بهتنهایی اثبات علّی ارائه نمیکنند.
دادههای دستهای چگونه استفاده میشوند؟
پیادهسازی معمول درختهای Scikit-learn به ورودی عددی نیاز دارد. ویژگیهای دستهای باید پیشپردازش شوند.
روش رایج:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder


preprocessor = ColumnTransformer(
    transformers=[
        (
            "categorical",
            OneHotEncoder(
                handle_unknown="ignore"
            ),
            categorical_columns,
        ),
    ],
    remainder="passthrough",
)
سپس پیشپردازش و مدل داخل Pipeline قرار میگیرند.
استفاده از Pipeline از ناسازگاری مراحل آموزش و پیشبینی و بخشی از خطاهای نشت داده جلوگیری میکند.
مقادیر گمشده چه میشوند؟
روش برخورد با Missing Value به نسخه کتابخانه، نوع مدل و ماهیت داده بستگی دارد.
روشهای رایج:
- حذف رکوردهای ناقص در شرایط محدود
- جایگزینی با میانه برای ویژگی عددی
- جایگزینی با پرتکرارترین مقدار برای ویژگی دستهای
- افزودن شاخص گمشدهبودن
- استفاده از مدلهایی با پشتیبانی بومی از مقادیر گمشده
نمونه:
from sklearn.impute import SimpleImputer


numeric_imputer = SimpleImputer(
    strategy="median",
)
Imputer نیز باید داخل Pipeline قرار گیرد تا فقط روی داده آموزش Fit شود.
داده نامتوازن و درخت تصمیم
فرض کنید فقط یک درصد نمونهها متعلق به کلاس مثبت باشند. Accuracy میتواند گمراهکننده باشد؛ زیرا مدلی که همیشه کلاس منفی را انتخاب کند، دقت ۹۹ درصد خواهد داشت.
معیارهای مناسبتر:
- Precision
- Recall
- F1 Score
- ROC AUC
- PR AUC
- Confusion Matrix
- هزینه واقعی False Positive و False Negative
راهکارها:
class_weight="balanced"- نمونهبرداری مجدد فقط روی داده آموزش
- تنظیم Threshold
- استفاده از معیار ارزیابی مناسب
- Cross-validation لایهبندیشده
- کالیبراسیون احتمال
کالیبراسیون احتمال
احتمال خروجی مدل لزوماً با احتمال واقعی منطبق نیست.
برای مثال، از میان تمام نمونههایی که مدل به آنها احتمال ۰٫۸ داده است، انتظار داریم تقریباً ۸۰ درصد واقعاً مثبت باشند. اگر چنین نباشد، مدل کالیبره نیست.
در کاربردهایی مانند مسیریابی درخواست، قیمتگذاری ریسک یا انتخاب Threshold، کالیبراسیون اهمیت دارد.
ابزارهایی مانند CalibratedClassifierCV میتوانند بررسی شوند:
from sklearn.calibration import (
    CalibratedClassifierCV,
)


calibrated_model = CalibratedClassifierCV(
    forest_model,
    method="isotonic",
    cv=5,
)
داده کالیبراسیون باید از داده آموزش پایه جدا باشد یا از Cross-validation مناسب استفاده شود.
استفاده از درخت تصمیم برای مسیریابی مدلهای هوش مصنوعی
فرض کنید برنامهای دارید که باید هر درخواست را به یکی از دو مسیر بفرستد:
- مدل سریع و اقتصادی
- مدل دقیقتر برای درخواست پیچیده
ویژگیهای ورودی میتوانند شامل موارد زیر باشند:
- طول پیام
- تعداد پرسشها
- وجود فایل
- تعداد صفحات سند
- نیاز به ابزار
- تعداد پیامهای مکالمه
- حساسیت به زمان
- نوع خروجی موردنیاز
- امتیاز پیچیدگی
- امتیاز اطمینان طبقهبندی
هدف مدل:
0 = مسیر سریع
1 = مسیر دقیق
یک درخت محدود میتواند قواعدی مانند این یاد بگیرد:
اگر فایل وجود ندارد و طول پیام کمتر از ۴۰۰ نویسه است:
    مسیر سریع
در غیر این صورت اگر نیاز به ابزار وجود دارد:
    مسیر دقیق
در غیر این صورت:
    بر اساس امتیاز پیچیدگی تصمیم بگیر
مزیت درخت تصمیم در این کاربرد آن است که منطق مسیریابی نسبتاً قابلبررسی است.
ساخت مدل ساده مسیریابی
فرض کنید داده تاریخی در فایل routing_data.csv ذخیره شده است:
message_length
question_count
has_attachment
conversation_turns
requires_tool
complexity_score
best_route
آموزش مدل:
import pandas as pd

from sklearn.model_selection import (
    train_test_split,
)
from sklearn.tree import (
    DecisionTreeClassifier,
)


routing_data = pd.read_csv(
    "routing_data.csv"
)

feature_columns = [
    "message_length",
    "question_count",
    "has_attachment",
    "conversation_turns",
    "requires_tool",
    "complexity_score",
]

X = routing_data[feature_columns]
y = routing_data["best_route"]

X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.2,
        stratify=y,
        random_state=42,
    )
)

router = DecisionTreeClassifier(
    max_depth=5,
    min_samples_leaf=30,
    class_weight="balanced",
    random_state=42,
)

router.fit(
    X_train,
    y_train,
)
برچسب best_route نباید بر اساس حدس ساخته شود. بهتر است از نتیجه Evals، رضایت کاربر، کیفیت پاسخ، هزینه و زمان پاسخ استخراج شود.
اتصال Router به API درواره
متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_FAST_MODEL="YOUR_FAST_MODEL_ID"
export DARVAREH_QUALITY_MODEL="YOUR_QUALITY_MODEL_ID"
ساخت Client:
import os

from openai import OpenAI


client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)

FAST_MODEL = os.environ[
    "DARVAREH_FAST_MODEL"
]

QUALITY_MODEL = os.environ[
    "DARVAREH_QUALITY_MODEL"
]
استخراج ویژگیهای ساده:
def build_features(
    message,
    conversation_turns=1,
    has_attachment=False,
    requires_tool=False,
):
    return pd.DataFrame(
        [
            {
                "message_length": len(message),
                "question_count": (
                    message.count("?")
                    + message.count("؟")
                ),
                "has_attachment": int(
                    has_attachment
                ),
                "conversation_turns": (
                    conversation_turns
                ),
                "requires_tool": int(
                    requires_tool
                ),
                "complexity_score": min(
                    len(message) / 2000,
                    1.0,
                ),
            }
        ]
    )
انتخاب مدل:
def choose_model(message, **context):
    features = build_features(
        message,
        **context,
    )

    route = router.predict(features)[0]

    if route == "quality":
        return QUALITY_MODEL

    return FAST_MODEL
ارسال درخواست:
def answer_user(message, **context):
    model = choose_model(
        message,
        **context,
    )

    response = client.chat.completions.create(
        model=model,
        temperature=0.2,
        max_tokens=800,
        messages=[
            {
                "role": "system",
                "content": (
                    "به زبان فارسی، دقیق و بر اساس "
                    "اطلاعات موجود پاسخ بده."
                ),
            },
            {
                "role": "user",
                "content": message,
            },
        ],
    )

    return {
        "model": model,
        "answer": (
            response.choices[0].message.content
            or ""
        ),
    }
این معماری باید در سمت سرور اجرا شود تا کلید API در مرورگر قرار نگیرد.
آیا تصمیم Router باید قطعی باشد؟
خیر. در محیط واقعی بهتر است موارد زیر نیز لحاظ شوند:
- حداقل Confidence
- Fallback در خطا یا Timeout
- محدودیت بودجه
- ظرفیت لحظهای مدل
- مجازبودن مدل برای نوع داده
- نیاز به ابزار
- نیاز به خروجی ساختاریافته
- SLA قابلیت
- ارزیابی دورهای کیفیت Router
قواعد قطعی مانند مدلهای مجاز، سقف هزینه و الزامات عملیاتی نباید فقط به مدل درخت تصمیم سپرده شوند.
برای طراحی کاملتر، مقاله مسیریابی هوشمند میان مدلهای هوش مصنوعی را مطالعه کنید.
ثبت داده برای بهبود Router
برای هر درخواست این اطلاعات مفید هستند:
- ویژگیهای ورودی
- مسیر انتخابشده
- مدل اجراشده
- زمان پاسخ
- مصرف توکن
- هزینه
- خطا یا Timeout
- امتیاز Eval
- رضایت کاربر
- نیاز به Fallback
- نتیجه نهایی
- نسخه Router
بدون ثبت نسخه مدل و ویژگیها، مقایسه عملکرد Router در طول زمان دشوار میشود.
Drift در مدل درختی
ممکن است توزیع درخواستها، مدلهای در دسترس یا رفتار کاربران تغییر کند.
نشانههای Drift:
- کاهش کیفیت پیشبینی
- افزایش Fallback
- تغییر توزیع ویژگیها
- افزایش هزینه متوسط
- افزایش درخواستهای ارجاعشده
- تغییر سهم مسیر سریع و دقیق
مدل باید بهصورت دورهای ارزیابی شود و آموزش مجدد فقط پس از مقایسه نسخه جدید با نسخه فعال انجام گیرد.
چه زمانی از درخت تصمیم استفاده کنیم؟
درخت تصمیم مناسب است وقتی:
- داده ساختاریافته دارید.
- روابط غیرخطی وجود دارند.
- تفسیر قواعد مهم است.
- به یک مدل سریع نیاز دارید.
- ترکیبی از ویژگیهای مختلف دارید.
- میخواهید خط مبنای قابلفهم بسازید.
Random Forest مناسبتر است وقتی:
- عملکرد پیشبینی مهمتر از نمایش یک درخت است.
- یک درخت منفرد ناپایدار است.
- تعاملهای غیرخطی متعددی وجود دارند.
- داده جدولی متوسط یا بزرگ دارید.
- منابع محاسباتی بیشتری در دسترس است.
چه زمانی درخت تصمیم انتخاب مناسبی نیست؟
ممکن است انتخاب اول نباشد اگر:
- داده اصلی تصویر، صوت یا متن خام است.
- مرز تصمیم بسیار نرم و خطی است.
- تعمیم خارج از دامنه داده اهمیت دارد.
- احتمال کاملاً کالیبرهشده لازم است.
- تعداد ویژگیهای پراکنده بسیار زیاد است.
- مدل با داده بسیار کم باید پایدار بماند.
برای متن خام معمولاً ابتدا باید ویژگی، Embedding یا نمایش مناسب استخراج شود.
تفاوت Random Forest و Gradient Boosting
| ویژگی | Random Forest | Gradient Boosting |
|---|---|---|
| آموزش درختها | عمدتاً مستقل | ترتیبی |
| هدف هر درخت | ایجاد مدل متنوع | اصلاح خطای قبلی |
| موازیسازی | سادهتر | محدودتر |
| حساسیت به تنظیمات | معمولاً کمتر | بیشتر |
| بیشبرازش | نسبتاً مقاوم | نیازمند کنترل دقیق |
| عملکرد روی داده جدولی | قوی | اغلب بسیار قوی |
| نقطه شروع | مناسب | نیازمند تنظیم بیشتر |
Gradient Boosting شامل روشهایی مانند XGBoost، LightGBM و CatBoost است. بهترین انتخاب باید با ارزیابی روی داده واقعی انجام شود.
اشتباهات رایج در استفاده از درخت تصمیم
آموزش درخت بدون محدودیت
درخت بسیار عمیق معمولاً داده آموزش را حفظ میکند.
ارزیابی روی داده آموزش
عملکرد آموزش معیار مناسبی برای تعمیم مدل نیست.
استفاده از Accuracy روی داده نامتوازن
Accuracy بالا میتواند خطاهای مهم کلاس اقلیت را پنهان کند.
پیشپردازش پیش از تقسیم داده
Fit کردن Imputer یا Encoder روی کل داده باعث نشت اطلاعات میشود.
تفسیر Feature Importance بهعنوان علیت
اهمیت پیشبینی با رابطه علت و معلولی یکسان نیست.
اعتماد کامل به feature_importances_
این معیار میتواند دارای سوگیری باشد و باید با Permutation Importance و دانش دامنه مقایسه شود.
انتخاب Threshold پیشفرض
آستانه ۰٫۵ همیشه با هزینه واقعی خطا هماهنگ نیست.
تنظیم ابرپارامتر روی Test Set
Test Set باید فقط برای ارزیابی نهایی استفاده شود.
ثبتنکردن نسخه مدل
در محیط عملی باید نسخه داده، ویژگیها، کد، مدل و معیارها ثبت شوند.
پرسشهای متداول
درخت تصمیم به زبان ساده چیست؟
درخت تصمیم مدلی است که با مجموعهای از پرسشهای شرطی داده را تقسیم میکند و در انتهای هر مسیر یک پیشبینی ارائه میدهد.
درخت تصمیم برای چه مسائلی استفاده میشود؟
برای طبقهبندی و رگرسیون روی دادههای ساختاریافته، مانند تشخیص ریزش مشتری، دستهبندی درخواست و پیشبینی مقدار عددی.
Gini چیست؟
Gini میزان ترکیب کلاسها در یک گره را اندازه میگیرد. مقدار صفر یعنی تمام نمونههای گره متعلق به یک کلاس هستند.
Entropy چیست؟
Entropy میزان بینظمی یا عدمقطعیت کلاسها در یک گره را اندازه میگیرد. تقسیم مناسب Entropy را کاهش میدهد.
چرا درخت تصمیم بیشبرازش میکند؟
زیرا میتواند تا ساخت قواعد بسیار جزئی رشد کند و بهجای الگوی عمومی، نویز داده آموزش را یاد بگیرد.
چگونه بیشبرازش درخت را کاهش دهیم؟
با محدودکردن عمق، افزایش حداقل نمونه برگ، محدودکردن تعداد برگها، هرس و ارزیابی با Cross-validation.
Random Forest چیست؟
Random Forest مجموعهای از درختهای تصمیم است که روی نمونهها و ویژگیهای تصادفی آموزش میبینند و خروجی آنها ترکیب میشود.
آیا Random Forest از درخت تصمیم بهتر است؟
از نظر عملکرد پیشبینی اغلب باثباتتر است، اما تفسیر یک درخت منفرد سادهتر است. انتخاب به هدف پروژه بستگی دارد.
آیا Random Forest به نرمالسازی نیاز دارد؟
مدلهای درختی معمولاً مانند SVM یا KNN به مقیاس ویژگیها حساس نیستند؛ بااینحال پیشپردازش مناسب، مدیریت داده گمشده و کدگذاری متغیرهای دستهای همچنان لازم است.
آیا میتوان از درخت تصمیم برای مسیریابی مدلهای هوش مصنوعی استفاده کرد؟
بله. میتوان با استفاده از ویژگیهای درخواست، مدل سریع یا دقیق را انتخاب کرد. محدودیتهای هزینه، مجوز و Fallback باید در سمت سرور کنترل شوند.
آیا درخت تصمیم به API درواره متصل میشود؟
درخت تصمیم مستقیماً API را فراخوانی نمیکند، اما میتواند مدل یا مسیر مناسب را انتخاب کند و نرمافزار سپس درخواست را از طریق API درواره ارسال کند.
جمعبندی
درخت تصمیم یکی از الگوریتمهای پایه و کاربردی یادگیری ماشین است که داده را با قواعد شرطی به بخشهای کوچکتر تقسیم میکند.
مفاهیم اصلی آن عبارتاند از:
- گره ریشه
- گره تصمیم
- شاخه
- برگ
- Gini
- Entropy
- Information Gain
- عمق و هرس
درخت تصمیم قابلتفسیر و سریع است، اما اگر بدون محدودیت رشد کند میتواند دچار بیشبرازش شود.
Random Forest با ترکیب تعداد زیادی درخت، نمونهبرداری Bootstrap و انتخاب تصادفی ویژگیها معمولاً پیشبینی باثباتتری ایجاد میکند. در مقابل، پیچیدگی و هزینه محاسباتی آن بیشتر و تفسیر تصمیمهایش دشوارتر است.
برای استفاده صحیح از این مدلها باید:
- داده آموزش، اعتبارسنجی و آزمایش را جدا کنید.
- معیار ارزیابی مناسب انتخاب کنید.
- پیچیدگی درخت را محدود کنید.
- از Cross-validation استفاده کنید.
- داده نامتوازن را جدی بگیرید.
- اهمیت ویژگی را با احتیاط تفسیر کنید.
- نتیجه را با مدلهای پایه مقایسه کنید.
- نسخه داده، کد و مدل را ثبت کنید.
- عملکرد مدل را پس از استقرار پایش کنید.
برای ساخت برنامههایی که بر اساس نوع درخواست، مدل هوش مصنوعی مناسب را انتخاب میکنند، میتوانید از مستندات API درواره شروع کنید.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
API درواره با ساختار OpenAI سازگار است و امکان اتصال یکپارچه نرمافزارها به مدلهای مختلف را فراهم میکند.
مقالات مرتبط
- یادگیری ماشین چیست؟
- یادگیری نظارتشده چیست؟
- Scikit-learn چیست؟
- بهینهسازی بیزی و Optuna
- الگوریتم ژنتیک چیست؟
- ارزیابی مدلهای هوش مصنوعی و Evals
- مسیریابی هوشمند میان مدلها
- معماری چندمدلی و چندارائهدهنده
- راهنمای API سازگار با OpenAI
منابع
- Scikit-learn Documentation
- Scikit-learn Decision Trees
- DecisionTreeClassifier
- DecisionTreeRegressor
- RandomForestClassifier
- Permutation Feature Importance
- Scikit-learn Classification Tree Course
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.