رگرسیون لجستیک چیست؟ آموزش Logistic Regression با پایتون
رگرسیون لجستیک یکی از مهمترین الگوریتمهای طبقهبندی در یادگیری ماشین و آمار است.
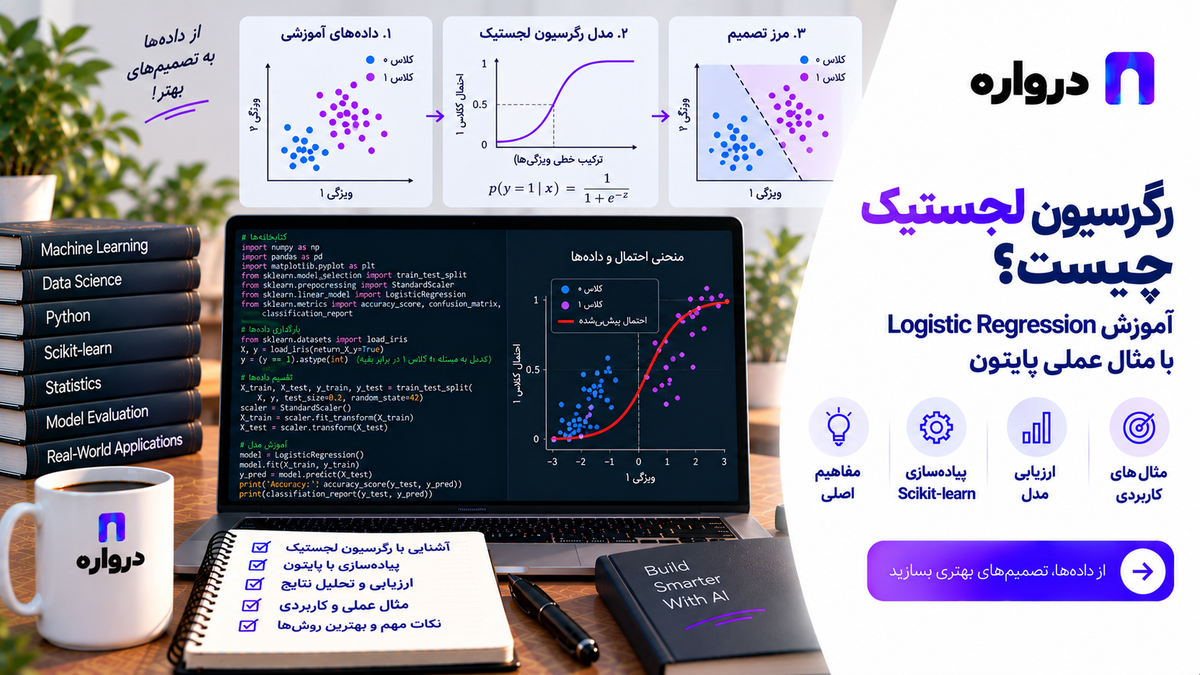
رگرسیون لجستیک یا Logistic Regression یکی از الگوریتمهای پایه و پرکاربرد برای طبقهبندی دادهها است. با وجود کلمه «رگرسیون» در نام این روش، کاربرد اصلی آن پیشبینی یک کلاس یا احتمال تعلق نمونه به یک کلاس است.
برای مثال، رگرسیون لجستیک میتواند احتمال این رویدادها را محاسبه کند:
- آیا مشتری ریزش میکند؟
- آیا پیام مربوط به فروش است؟
- آیا تراکنش به بررسی بیشتر نیاز دارد؟
- آیا کاربر روی پیشنهاد کلیک میکند؟
- آیا درخواست باید به مدل دقیقتر ارسال شود؟
- آیا تیکت به دسته فنی تعلق دارد؟
- آیا پاسخ مدل نیازمند بازبینی است؟
خروجی مدل معمولاً عددی بین صفر و یک است. سپس با استفاده از یک Threshold یا آستانه، احتمال به کلاس تبدیل میشود.
رگرسیون لجستیک به دلیل سرعت، سادگی، پشتیبانی از دادههای Sparse، امکان تفسیر ضرایب و تولید امتیاز احتمال، همچنان یکی از خط مبناهای مهم یادگیری ماشین است.
رگرسیون لجستیک چیست؟
رگرسیون لجستیک یک مدل خطی برای پیشبینی احتمال یک کلاس است.
ابتدا ترکیبی خطی از ویژگیها محاسبه میشود:
z=w1x1+w2x2+⋯+wnxn+bz=w_1x_1+w_2x_2+\dots+w_nx_n+b
یا به شکل برداری:
z=wTx+bz=w^Tx+b
مقدار z میتواند هر عددی از منفی بینهایت تا مثبت بینهایت باشد. برای تبدیل آن به احتمال، از تابع Sigmoid استفاده میشود:
P(y=1∣x)=σ(z)P(y=1|x)=\sigma(z)
مدل سپس بر اساس احتمال خروجی تصمیم میگیرد نمونه به کدام کلاس تعلق دارد.
چرا به آن رگرسیون لجستیک میگویند؟
رگرسیون لجستیک یک رابطه خطی میان ویژگیها و Log Odds رویداد میسازد. بنابراین ساختار آن از خانواده مدلهای رگرسیونی است، اما خروجی نهایی برای طبقهبندی استفاده میشود.
در رگرسیون خطی مستقیماً مقدار عددی پیشبینی میشود:
y^=wTx+b\hat{y}=w^Tx+b
اما در رگرسیون لجستیک، ترکیب خطی از تابع لجستیک عبور میکند:
p^=11+e−(wTx+b)\hat{p}= \frac{1}{1+e^{-(w^Tx+b)}}
به همین دلیل خروجی به بازه صفر تا یک محدود میشود.
تابع Sigmoid چیست؟
تابع سیگموید یا Logistic Function به شکل زیر تعریف میشود:
σ(z)=11+e−z\sigma(z)=\frac{1}{1+e^{-z}}
ویژگیهای مهم:
- خروجی همیشه بین صفر و یک است.
- اگر
z=0باشد، خروجی ۰٫۵ است. - با افزایش
z، احتمال به یک نزدیک میشود. - با کاهش
z، احتمال به صفر نزدیک میشود. - تابع پیوسته و مشتقپذیر است.
چند مقدار نمونه:
| z | Sigmoid |
|---|---|
| ۵- | ۰٫۰۰۷ |
| ۲- | ۰٫۱۱۹ |
| ۰ | ۰٫۵۰۰ |
| ۲ | ۰٫۸۸۱ |
| ۵ | ۰٫۹۹۳ |
پیادهسازی ساده:
import numpy as np


def sigmoid(z):
    return 1.0 / (
        1.0 + np.exp(-z)
    )
برای محاسبات عددی واقعی بهتر است از توابع پایدار کتابخانههای علمی استفاده شود؛ زیرا exp برای اعداد بسیار بزرگ یا کوچک میتواند با مشکل عددی روبهرو شود.
Odds چیست؟
اگر احتمال وقوع یک رویداد p باشد، Odds با رابطه زیر تعریف میشود:
Odds=p1−pOdds=\frac{p}{1-p}
مثال:
اگر احتمال ریزش مشتری ۰٫۸ باشد:
Odds=0.80.2=4Odds=\frac{0.8}{0.2}=4
یعنی نسبت احتمال ریزش به عدم ریزش چهار به یک است.
اگر احتمال ۰٫۵ باشد:
Odds=1Odds=1
Logit چیست؟
Logit لگاریتم Odds است:
Logit(p)=log(p1−p)Logit(p)= \log\left(\frac{p}{1-p}\right)
رگرسیون لجستیک فرض میکند Log Odds با ویژگیها رابطه خطی دارد:
log(p1−p)=wTx+b\log\left( \frac{p}{1-p} \right) = w^Tx+b
این رابطه برای تفسیر ضرایب مدل اهمیت دارد.
تفسیر ضرایب رگرسیون لجستیک
اگر ضریب یک ویژگی w_j باشد، افزایش یک واحد در آن ویژگی، با ثابتبودن سایر ویژگیها، Log Odds را بهاندازه w_j تغییر میدهد.
برای تبدیل ضریب به Odds Ratio:
OddsRatio=ewjOddsRatio=e^{w_j}
اگر:
w_j = 0.7
آنگاه:
e0.7≈2.01e^{0.7}\approx2.01
یعنی با افزایش یک واحد در آن ویژگی، Odds رویداد تقریباً دو برابر میشود؛ البته به شرط ثابتبودن سایر ویژگیها و معتبر بودن مفروضات مدل.
اگر ضریب منفی باشد، افزایش ویژگی Odds کلاس مثبت را کاهش میدهد.
چرا ضرایب باید با احتیاط تفسیر شوند؟
ضریب بزرگتر الزاماً به معنای اهمیت بیشتر نیست؛ زیرا مقیاس ویژگیها متفاوت است.
همچنین:
- ویژگیها ممکن است همبستگی داشته باشند.
- رابطه میتواند غیرخطی باشد.
- داده ممکن است دارای سوگیری باشد.
- ضریب پیشبینی به معنای رابطه علّی نیست.
- One-hot Encoding مرجع خاصی ایجاد میکند.
- منظمسازی مقدار ضرایب را تغییر میدهد.
برای مقایسه ضرایب عددی، معمولاً ویژگیها را مقیاسبندی میکنند.
مرز تصمیم در رگرسیون لجستیک
در حالت دودویی و Threshold برابر ۰٫۵:
P(y=1∣x)≥0.5P(y=1|x)\geq0.5
از آنجا که Sigmoid در z=0 برابر ۰٫۵ است، مرز تصمیم چنین خواهد بود:
wTx+b=0w^Tx+b=0
بنابراین Logistic Regression استاندارد یک مرز خطی میسازد.
برای ایجاد مرز غیرخطی میتوان:
- ویژگیهای چندجملهای ساخت.
- تعامل میان ویژگیها را اضافه کرد.
- از مدلهای غیرخطی استفاده کرد.
- ابتدا داده را به Embedding مناسب تبدیل کرد.
تابع هزینه Log Loss
برای آموزش Logistic Regression معمولاً از Binary Cross-Entropy یا Log Loss استفاده میشود:
L=−1n∑i=1n[yilog(pi)+(1−yi)log(1−pi)]L= -\frac{1}{n} \sum_{i=1}^{n} \left[ y_i\log(p_i) + (1-y_i)\log(1-p_i) \right]
اگر برچسب واقعی یک باشد و مدل احتمال نزدیک صفر بدهد، جریمه بسیار بزرگی دریافت میکند.
اگر برچسب واقعی صفر باشد و مدل احتمال نزدیک یک تولید کند، جریمه نیز زیاد خواهد بود.
Log Loss فقط درست یا غلطبودن کلاس را بررسی نمیکند؛ میزان اطمینان مدل را نیز در نظر میگیرد.
تفاوت Loss و معیار ارزیابی
تابع Loss برای آموزش مدل استفاده میشود، اما معیار ارزیابی بر اساس هدف کسبوکار انتخاب میشود.
معیارهای رایج:
- Accuracy
- Precision
- Recall
- F1 Score
- ROC AUC
- PR AUC
- Log Loss
- Brier Score
- هزینه خطاهای مختلف
مدلی با Accuracy بالاتر الزاماً بهترین احتمال یا بهترین عملکرد عملیاتی را ندارد.
Maximum Likelihood در Logistic Regression
پارامترهای رگرسیون لجستیک معمولاً با بیشینهکردن درستنمایی دادههای مشاهدهشده تخمین زده میشوند.
Likelihood برای طبقهبندی دودویی:
L(w)=∏i=1npiyi(1−pi)1−yiL(w)= \prod_{i=1}^{n} p_i^{y_i} (1-p_i)^{1-y_i}
برای سادهترشدن محاسبات، از Log Likelihood استفاده میشود. کمینهکردن Log Loss با بیشینهکردن Log Likelihood ارتباط مستقیم دارد.
در عمل Solverهای عددی برای پیدا کردن ضرایب مناسب استفاده میشوند.
Regularization چیست؟
Regularization یا منظمسازی با افزودن جریمه به تابع هدف، از بزرگشدن بیشازحد ضرایب جلوگیری میکند.
اهداف:
- کاهش بیشبرازش
- افزایش پایداری مدل
- کنترل پیچیدگی
- مدیریت ویژگیهای زیاد
- کاهش حساسیت به نویز
پیادهسازی LogisticRegression در Scikit-learn بهصورت پیشفرض از منظمسازی استفاده میکند و میتواند ورودیهای Dense و Sparse را پردازش کند.
منظمسازی L2
در L2 مجموع مربع ضرایب جریمه میشود:
PenaltyL2=λ∑jwj2Penalty_{L2}= \lambda \sum_jw_j^2
ویژگیها:
- ضرایب را کوچک میکند.
- معمولاً آنها را دقیقاً صفر نمیکند.
- برای ویژگیهای همبسته رفتار پایدارتری دارد.
- انتخاب پیشفرض مناسبی برای بسیاری از مسائل است.
منظمسازی L1
در L1 مجموع قدرمطلق ضرایب جریمه میشود:
PenaltyL1=λ∑j∣wj∣Penalty_{L1}= \lambda \sum_j|w_j|
ویژگیها:
- میتواند بعضی ضرایب را دقیقاً صفر کند.
- نوعی انتخاب ویژگی انجام میدهد.
- برای دادههای دارای ویژگیهای زیاد مفید است.
- در حضور ویژگیهای بسیار همبسته ممکن است ناپایدار باشد.
Elastic Net
Elastic Net ترکیبی از L1 و L2 است:
Penalty=λ[α∑j∣wj∣+(1−α)∑jwj2]Penalty= \lambda \left[ \alpha\sum_j|w_j| + (1-\alpha)\sum_jw_j^2 \right]
در Scikit-learn برای استفاده از Elastic Net در Logistic Regression معمولاً باید Solver سازگار مانند saga انتخاب شود.
پارامتر C در Scikit-learn
در Scikit-learn، پارامتر C معکوس شدت منظمسازی است.
C کوچک
- منظمسازی قویتر
- ضرایب کوچکتر
- مدل سادهتر
- احتمال کمبرازش بیشتر
C بزرگ
- منظمسازی ضعیفتر
- آزادی بیشتر ضرایب
- تطبیق بیشتر با داده آموزش
- احتمال بیشبرازش بیشتر
این موضوع با پارامتر lambda که مستقیماً شدت جریمه را نشان میدهد رابطه معکوس دارد:
C∝1λC\propto\frac{1}{\lambda}
Solver در Logistic Regression چیست؟
Solver الگوریتم عددی برای پیدا کردن ضرایب مدل است.
گزینههای رایج در Scikit-learn:
lbfgsliblinearnewton-cgnewton-choleskysagsaga
انتخاب Solver به این عوامل بستگی دارد:
- تعداد نمونهها
- تعداد ویژگیها
- Sparse یا Dense بودن داده
- نوع منظمسازی
- دودویی یا چندکلاسهبودن مسئله
نمونههای کاربردی:
LogisticRegression(
    solver="lbfgs",
    penalty="l2",
)
برای L1:
LogisticRegression(
    solver="saga",
    penalty="l1",
)
برای Elastic Net:
LogisticRegression(
    solver="saga",
    penalty="elasticnet",
    l1_ratio=0.5,
)
جدول سازگاری Solver و Penalty ممکن است میان نسخههای کتابخانه تغییر کند؛ بنابراین مستندات نسخه نصبشده را بررسی کنید.
رگرسیون لجستیک دودویی
در Binary Logistic Regression دو کلاس داریم:
0 = عدم وقوع
1 = وقوع
مثال:
- خرید نکرد / خرید کرد
- عادی / نیازمند بررسی
- موفق / ناموفق
- ساده / پیچیده
مدل احتمال کلاس مثبت را محاسبه میکند و سپس Threshold اعمال میشود.
رگرسیون لجستیک چندکلاسه
برای چند کلاس میتوان از Softmax Regression یا راهبردهای چندمدلی استفاده کرد.
در Softmax، احتمال کلاس k چنین محاسبه میشود:
P(y=k∣x)=ewkTx+bk∑j=1KewjTx+bjP(y=k|x)= \frac{ e^{w_k^Tx+b_k} }{ \sum_{j=1}^{K} e^{w_j^Tx+b_j} }
مجموع احتمال کلاسها برابر یک است.
مثال دستهبندی تیکت:
sales
technical
billing
feedback
other
Ordinal Logistic Regression چیست؟
اگر کلاسها ترتیب طبیعی داشته باشند، مسئله Ordinal Classification است:
کم
متوسط
زیاد
یا:
ناراضی
خنثی
راضی
Logistic Regression چندکلاسه معمولی ترتیب کلاسها را در نظر نمیگیرد. برای چنین دادهای باید مدل Ordinal مناسب یا روش طراحیشده برای ترتیب کلاسها بررسی شود.
تفاوت رگرسیون لجستیک و رگرسیون خطی
| ویژگی | رگرسیون لجستیک | رگرسیون خطی |
|---|---|---|
| کاربرد اصلی | طبقهبندی | پیشبینی مقدار عددی |
| خروجی | احتمال و کلاس | عدد پیوسته |
| تابع تبدیل | Sigmoid یا Softmax | معمولاً ندارد |
| تابع هزینه رایج | Log Loss | MSE |
| محدوده خروجی | صفر تا یک برای احتمال | بدون محدودیت |
| مرز تصمیم | دارد | ندارد |
استفاده از رگرسیون خطی برای طبقهبندی دودویی میتواند احتمالهایی کمتر از صفر یا بیشتر از یک تولید کند و مفروضات مناسبی نداشته باشد.
پیادهسازی Logistic Regression با پایتون
در این مثال از مجموعه داده Breast Cancer موجود در Scikit-learn استفاده میکنیم.
این مثال صرفاً آموزشی است و برای تصمیمگیری پزشکی طراحی نشده است.
نصب کتابخانهها
pip install scikit-learn pandas matplotlib
بارگذاری داده
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split


dataset = load_breast_cancer(
    as_frame=True,
)

X = dataset.data
y = dataset.target

X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.2,
        stratify=y,
        random_state=42,
    )
)
ساخت Pipeline
from sklearn.linear_model import (
    LogisticRegression,
)
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import (
    StandardScaler,
)


model = Pipeline(
    [
        (
            "scaler",
            StandardScaler(),
        ),
        (
            "classifier",
            LogisticRegression(
                C=1.0,
                penalty="l2",
                solver="lbfgs",
                class_weight="balanced",
                max_iter=2000,
                random_state=42,
            ),
        ),
    ]
)
آموزش مدل
model.fit(
    X_train,
    y_train,
)
ارزیابی
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
    log_loss,
    roc_auc_score,
)


predictions = model.predict(
    X_test
)

probabilities = model.predict_proba(
    X_test
)[:, 1]

print(
    classification_report(
        y_test,
        predictions,
        target_names=dataset.target_names,
    )
)

print(
    confusion_matrix(
        y_test,
        predictions,
    )
)

print(
    "ROC AUC:",
    roc_auc_score(
        y_test,
        probabilities,
    ),
)

print(
    "Log Loss:",
    log_loss(
        y_test,
        probabilities,
    ),
)
چرا StandardScaler داخل Pipeline است؟
Scaling باید فقط با داده آموزش Fit شود. اگر میانگین و انحراف معیار کل داده پیش از تقسیم محاسبه شوند، اطلاعات داده آزمایش وارد فرایند آموزش میشود.
قرار دادن Scaler داخل Pipeline باعث میشود مراحل پیشپردازش در Cross-validation و پیشبینی بهصورت سازگار اجرا شوند.
تحلیل ضرایب مدل
بعد از آموزش میتوان ضرایب را بررسی کرد:
import pandas as pd


classifier = model.named_steps[
    "classifier"
]

coefficients = pd.Series(
    classifier.coef_[0],
    index=X.columns,
).sort_values()

print("Most negative:")
print(coefficients.head(10))

print("Most positive:")
print(coefficients.tail(10))
به دلیل استفاده از StandardScaler، مقایسه اندازه ضرایب نسبت به حالت بدون مقیاسبندی معنادارتر است.
بااینحال، ضرایب همچنان رابطه علّی را ثابت نمیکنند.
Cross-validation
from sklearn.model_selection import (
    StratifiedKFold,
    cross_validate,
)


cross_validation = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

scores = cross_validate(
    model,
    X,
    y,
    cv=cross_validation,
    scoring=[
        "accuracy",
        "precision",
        "recall",
        "f1",
        "roc_auc",
        "neg_log_loss",
    ],
    n_jobs=-1,
)

for name, values in scores.items():
    if name.startswith("test_"):
        print(
            name,
            values.mean(),
            values.std(),
        )
میانگین و انحراف معیار چند Fold ارزیابی پایدارتری از یک تقسیم منفرد ارائه میدهد.
تنظیم C و Penalty با Optuna
import optuna

from sklearn.model_selection import (
    cross_val_score,
)


def objective(trial):
    penalty = trial.suggest_categorical(
        "penalty",
        ["l1", "l2"],
    )

    c_value = trial.suggest_float(
        "C",
        1e-4,
        1e3,
        log=True,
    )

    candidate = Pipeline(
        [
            (
                "scaler",
                StandardScaler(),
            ),
            (
                "classifier",
                LogisticRegression(
                    C=c_value,
                    penalty=penalty,
                    solver="saga",
                    class_weight="balanced",
                    max_iter=3000,
                    random_state=42,
                ),
            ),
        ]
    )

    values = cross_val_score(
        candidate,
        X_train,
        y_train,
        cv=5,
        scoring="roc_auc",
        n_jobs=-1,
    )

    return values.mean()


study = optuna.create_study(
    direction="maximize",
)

study.optimize(
    objective,
    n_trials=60,
)

print(study.best_value)
print(study.best_params)
برای آشنایی کامل با این روش، مقاله بهینهسازی بیزی و Optuna را مطالعه کنید.
Threshold چیست؟
اگر مدل احتمال ۰٫۷ تولید کند، برای تبدیل آن به کلاس باید یک آستانه تعریف شود.
آستانه پیشفرض معمولاً ۰٫۵ است:
predictions = (
    probabilities >= 0.5
).astype(int)
اما ۰٫۵ همیشه بهترین انتخاب نیست.
اگر ازدستدادن نمونه مثبت هزینه زیادی داشته باشد، میتوان Threshold را کاهش داد تا Recall افزایش پیدا کند.
اگر False Positive پرهزینه باشد، میتوان Threshold را افزایش داد تا Precision بیشتر شود.
انتخاب Threshold بر اساس داده اعتبارسنجی
import numpy as np

from sklearn.metrics import (
    precision_recall_curve,
)


validation_probabilities = (
    model.predict_proba(X_test)[:, 1]
)

precision, recall, thresholds = (
    precision_recall_curve(
        y_test,
        validation_probabilities,
    )
)

f1_scores = (
    2
    * precision[:-1]
    * recall[:-1]
    / (
        precision[:-1]
        + recall[:-1]
        + 1e-12
    )
)

best_index = np.argmax(f1_scores)

best_threshold = thresholds[
    best_index
]

print("Best threshold:", best_threshold)
print("Best F1:", f1_scores[best_index])
در پروژه واقعی Threshold نباید روی Test Set انتخاب شود. برای انتخاب آن باید از داده Validation استفاده شود و Test Set فقط برای ارزیابی نهایی باقی بماند.
انتخاب Threshold بر اساس هزینه
فرض کنید:
- هزینه False Negative برابر ۱۰۰ واحد است.
- هزینه False Positive برابر ۱۰ واحد است.
میتوان Thresholdی را انتخاب کرد که هزینه کل را کمینه کند:
from sklearn.metrics import confusion_matrix


def threshold_cost(
    y_true,
    probabilities,
    threshold,
    false_positive_cost=10,
    false_negative_cost=100,
):
    predictions = (
        probabilities >= threshold
    ).astype(int)

    tn, fp, fn, tp = (
        confusion_matrix(
            y_true,
            predictions,
        ).ravel()
    )

    return (
        fp * false_positive_cost
        + fn * false_negative_cost
    )
این رویکرد از انتخاب Threshold فقط بر اساس Accuracy کاربردیتر است.
کالیبراسیون احتمال چیست؟
یک مدل کالیبره باید میان احتمال پیشبینیشده و فراوانی واقعی رویداد هماهنگی داشته باشد.
اگر مدل برای ۱۰۰ نمونه احتمال ۰٫۸ پیشبینی کند، انتظار داریم تقریباً ۸۰ نمونه واقعاً مثبت باشند.
احتمال خروجی Logistic Regression ممکن است در بسیاری از شرایط مناسب باشد، اما نباید بدون اندازهگیری، کالیبره فرض شود. کیفیت کالیبراسیون به درستی مدل، داده، منظمسازی، نمونهبرداری و Drift بستگی دارد.
Scikit-learn ابزارهایی برای تحلیل و بهبود Probability Calibration ارائه میکند.
رسم Calibration Curve
import matplotlib.pyplot as plt

from sklearn.calibration import (
    CalibrationDisplay,
)


CalibrationDisplay.from_estimator(
    model,
    X_test,
    y_test,
    n_bins=10,
)

plt.grid(True)
plt.show()
اگر منحنی به خط قطری نزدیک باشد، احتمالها بهتر کالیبره شدهاند.
برای مقایسه کالیبراسیون میتوان Brier Score و Log Loss را نیز بررسی کرد.
داده نامتوازن
فرض کنید فقط دو درصد نمونهها مثبت باشند. مدلی که همیشه کلاس منفی را پیشبینی کند، Accuracy برابر ۹۸ درصد خواهد داشت، اما ارزش عملی ندارد.
راهکارها:
class_weight="balanced"- انتخاب معیار مناسب
- تنظیم Threshold
- نمونهبرداری مجدد فقط روی Training Set
- جمعآوری نمونه بیشتر
- ارزیابی PR AUC
- بررسی Recall و Precision کلاس مثبت
- استفاده از هزینه خطاها
نمونه:
LogisticRegression(
    class_weight="balanced",
)
وزندهی کلاس میتواند احتمالهای خروجی را تحتتأثیر قرار دهد؛ بنابراین کالیبراسیون باید دوباره بررسی شود.
Multicollinearity چیست؟
اگر چند ویژگی همبستگی بسیار زیادی داشته باشند، تخمین ضرایب میتواند ناپایدار شود.
نشانهها:
- تغییر زیاد ضرایب با تغییر کوچک داده
- ضرایب با علامت غیرمنتظره
- ضرایب بسیار بزرگ
- تفسیر دشوار اثر هر ویژگی
راهکارها:
- حذف ویژگیهای تکراری
- ترکیب ویژگیها
- استفاده از L2
- استفاده از L1 برای انتخاب ویژگی
- تحلیل همبستگی
- استفاده از روشهای کاهش بعد
- تمرکز بر عملکرد پیشبینی بهجای تفسیر تکضریب
رابطه غیرخطی با Log Odds
Logistic Regression فرض میکند Log Odds با ویژگیها رابطه خطی دارد. این به معنی خطیبودن مستقیم احتمال نیست.
اگر رابطه پیچیده باشد میتوان:
- ویژگی چندجملهای ساخت.
- متغیرها را تبدیل لگاریتمی کرد.
- Interaction اضافه کرد.
- داده را دستهبندی کرد.
- از مدل درختی استفاده کرد.
- از Kernel یا شبکه عصبی استفاده کرد.
نمونه ویژگیهای چندجملهای:
from sklearn.preprocessing import (
    PolynomialFeatures,
)


model = Pipeline(
    [
        (
            "polynomial",
            PolynomialFeatures(
                degree=2,
                include_bias=False,
            ),
        ),
        (
            "scaler",
            StandardScaler(),
        ),
        (
            "classifier",
            LogisticRegression(
                max_iter=2000,
            ),
        ),
    ]
)
افزایش بیرویه درجه میتواند تعداد ویژگیها و خطر بیشبرازش را بهشدت افزایش دهد.
طبقهبندی متن با Logistic Regression و TF-IDF
رگرسیون لجستیک برای طبقهبندی متن، بهخصوص همراه با TF-IDF، یک خط مبنای سریع و قوی است.
Scikit-learn نمونه رسمی طبقهبندی اسناد با ماتریس Sparse مبتنی بر TF-IDF و چند طبقهبند مختلف ارائه میکند.
فرض کنید فایل tickets.csv دو ستون دارد:
text,category
"پرداخت انجام شد ولی کیف پول شارژ نشد",billing
"برای اتصال به API راهنما میخواهم",technical
"برای خرید سازمانی با چه کسی صحبت کنم؟",sales
ساخت طبقهبند متن فارسی
import pandas as pd

from sklearn.feature_extraction.text import (
    TfidfVectorizer,
)
from sklearn.linear_model import (
    LogisticRegression,
)
from sklearn.metrics import (
    classification_report,
)
from sklearn.model_selection import (
    train_test_split,
)
from sklearn.pipeline import Pipeline


data = pd.read_csv("tickets.csv")

X_train, X_test, y_train, y_test = (
    train_test_split(
        data["text"],
        data["category"],
        test_size=0.2,
        stratify=data["category"],
        random_state=42,
    )
)

text_classifier = Pipeline(
    [
        (
            "tfidf",
            TfidfVectorizer(
                ngram_range=(1, 2),
                min_df=2,
                max_df=0.95,
                sublinear_tf=True,
            ),
        ),
        (
            "classifier",
            LogisticRegression(
                C=4.0,
                class_weight="balanced",
                max_iter=2000,
            ),
        ),
    ]
)

text_classifier.fit(
    X_train,
    y_train,
)

predictions = text_classifier.predict(
    X_test
)

print(
    classification_report(
        y_test,
        predictions,
    )
)
پیشبینی پیام جدید
messages = [
    "موجودی حساب بعد از پرداخت اضافه نشده است",
    "چطور مدل را در کد پایتون تغییر بدهم؟",
]

probabilities = (
    text_classifier.predict_proba(
        messages
    )
)

classes = (
    text_classifier.named_steps[
        "classifier"
    ].classes_
)

for message, row in zip(
    messages,
    probabilities,
):
    best_index = row.argmax()

    print({
        "message": message,
        "category": classes[best_index],
        "confidence": float(
            row[best_index]
        ),
    })
این Confidence باید روی داده اعتبارسنجی بررسی و در صورت نیاز کالیبره شود.
طبقهبندی متن با Embedding و Logistic Regression
TF-IDF بیشتر بر واژهها و عبارتهای ظاهری تکیه دارد. Embedding میتواند بخشی از شباهت معنایی متن را در بردار عددی نمایش دهد.
معماری:
پیام فارسی
↓
نرمالسازی
↓
مدل Embedding
↓
بردار عددی
↓
Logistic Regression
↓
احتمال هر دسته
مزیت Logistic Regression در این معماری:
- آموزش سریع
- تولید احتمال کلاسها
- سادگی استقرار
- هزینه کم پیشبینی
- قابلیت تحلیل ضرایب
- مناسب برای Router سبک
دریافت Embedding از API درواره
نصب:
pip install openai scikit-learn pandas numpy joblib
متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_EMBEDDING_MODEL="YOUR_EMBEDDING_MODEL_ID"
شناسه مدل را از فهرست فعلی مدلهای Embedding در درواره انتخاب کنید.
ساخت Client:
import os

from openai import OpenAI


client = OpenAI(
    api_key=os.environ[
        "DARVAREH_API_KEY"
    ],
    base_url="https://api.darvareh.ir/v1",
)

EMBEDDING_MODEL = os.environ[
    "DARVAREH_EMBEDDING_MODEL"
]
نرمالسازی ساده فارسی
import re


def normalize_persian(text):
    text = str(text)

    text = text.replace("ي", "ی")
    text = text.replace("ك", "ک")

    text = re.sub(
        r"\s+",
        " ",
        text,
    )

    return text.strip()
ساخت Embedding گروهی
def create_embeddings(
    texts,
    batch_size=64,
):
    vectors = []

    for start in range(
        0,
        len(texts),
        batch_size,
    ):
        batch = texts[
            start:start + batch_size
        ]

        response = client.embeddings.create(
            model=EMBEDDING_MODEL,
            input=batch,
        )

        ordered_items = sorted(
            response.data,
            key=lambda item: item.index,
        )

        vectors.extend(
            item.embedding
            for item in ordered_items
        )

    return vectors
آموزش طبقهبند روی Embeddingها
import numpy as np
import pandas as pd

from sklearn.linear_model import (
    LogisticRegression,
)
from sklearn.metrics import (
    classification_report,
    log_loss,
)
from sklearn.model_selection import (
    train_test_split,
)
from sklearn.preprocessing import (
    LabelEncoder,
    Normalizer,
)
from sklearn.pipeline import Pipeline


data = pd.read_csv("tickets.csv")

texts = [
    normalize_persian(text)
    for text in data["text"].tolist()
]

embeddings = np.asarray(
    create_embeddings(texts),
    dtype=np.float32,
)

label_encoder = LabelEncoder()

labels = label_encoder.fit_transform(
    data["category"]
)

(
    X_train,
    X_test,
    y_train,
    y_test,
) = train_test_split(
    embeddings,
    labels,
    test_size=0.2,
    stratify=labels,
    random_state=42,
)

embedding_classifier = Pipeline(
    [
        (
            "normalize",
            Normalizer(norm="l2"),
        ),
        (
            "classifier",
            LogisticRegression(
                C=2.0,
                class_weight="balanced",
                max_iter=2000,
            ),
        ),
    ]
)

embedding_classifier.fit(
    X_train,
    y_train,
)

predictions = (
    embedding_classifier.predict(
        X_test
    )
)

probabilities = (
    embedding_classifier.predict_proba(
        X_test
    )
)

print(
    classification_report(
        y_test,
        predictions,
        target_names=label_encoder.classes_,
    )
)

print(
    "Log Loss:",
    log_loss(
        y_test,
        probabilities,
    ),
)
پیشبینی پیام جدید
def classify_messages(messages):
    normalized_messages = [
        normalize_persian(message)
        for message in messages
    ]

    vectors = np.asarray(
        create_embeddings(
            normalized_messages
        ),
        dtype=np.float32,
    )

    probabilities = (
        embedding_classifier.predict_proba(
            vectors
        )
    )

    results = []

    for message, row in zip(
        messages,
        probabilities,
    ):
        best_index = int(row.argmax())

        category = (
            label_encoder.inverse_transform(
                [best_index]
            )[0]
        )

        results.append(
            {
                "message": message,
                "category": category,
                "confidence": float(
                    row[best_index]
                ),
            }
        )

    return results
استفاده:
results = classify_messages(
[
"برای اتصال به API مستندات میخواهم",
"پرداخت موفق بود ولی اعتبار اضافه نشد",
]
)
for result in results:
print(result)
مدیریت پیام خارج از دامنه
Logistic Regression همیشه یکی از کلاسهای شناختهشده را انتخاب میکند؛ حتی اگر پیام هیچ ارتباطی با داده آموزشی نداشته باشد.
میتوان Threshold تعریف کرد:
def classify_with_fallback(
    message,
    threshold=0.65,
):
    result = classify_messages(
        [message]
    )[0]

    if result["confidence"] < threshold:
        result["category"] = "other"
        result["needs_review"] = True
    else:
        result["needs_review"] = False

    return result
Threshold باید بر اساس داده اعتبارسنجی، کالیبراسیون و هزینه خطا انتخاب شود.
برای تشخیص دقیقتر ورودی خارج از دامنه میتوان فاصله Embedding، مدل جداگانه OOD و قوانین دامنه را نیز بررسی کرد.
مسیریابی درخواست میان مدلهای درواره
نتیجه طبقهبندی میتواند برای انتخاب مدل استفاده شود:
FAST_MODEL = os.environ[
    "DARVAREH_FAST_MODEL"
]

QUALITY_MODEL = os.environ[
    "DARVAREH_QUALITY_MODEL"
]


MODEL_BY_CATEGORY = {
    "sales": FAST_MODEL,
    "billing": FAST_MODEL,
    "feedback": FAST_MODEL,
    "technical": QUALITY_MODEL,
    "other": QUALITY_MODEL,
}
انتخاب مدل:
def choose_model(message):
    result = classify_with_fallback(
        message
    )

    model = MODEL_BY_CATEGORY[
        result["category"]
    ]

    return result, model
ارسال درخواست:
def answer_message(message):
routing, model = choose_model(
message
)
response = client.chat.completions.create(
model=model,
temperature=0.2,
max_tokens=700,
messages=[
{
"role": "system",
"content": (
"به زبان فارسی، دقیق و حرفهای "
"پاسخ بده. از بیان اطلاعات "
"تأییدنشده خودداری کن."
),
},
{
"role": "user",
"content": message,
},
],
)
return {
"category": routing["category"],
"confidence": routing[
"confidence"
],
"model": model,
"answer": (
response.choices[0].message.content
or ""
),
}
این منطق باید در سمت سرور اجرا شود. کلید API نباید در کد مرورگر یا اپلیکیشن قابلاستخراج قرار گیرد.
استفاده از احتمال برای Model Routing
بهجای استفاده مستقیم از کلاس میتوان از احتمال برای تصمیمگیری استفاده کرد.
مثال:
اگر احتمال technical بیشتر از ۰٫۸ باشد:
    مدل دقیق
اگر احتمال technical بین ۰٫۵ و ۰٫۸ باشد:
    مدل سریع + اعتبارسنجی
اگر اطمینان کل کمتر از ۰٫۶ باشد:
    Fallback یا بررسی بیشتر
مزیت:
- کنترل دقیقتر هزینه
- امکان تعریف مسیر میانی
- مدیریت عدمقطعیت
- کاهش تصمیمهای اشتباه با اطمینان پایین
اما شرط اصلی، کالیبرهبودن احتمالها است.
ذخیره مدل و اطلاعات نسخه
import joblib


joblib.dump(
    {
        "classifier": embedding_classifier,
        "label_encoder": label_encoder,
        "embedding_model": EMBEDDING_MODEL,
        "normalizer_version": "fa-v1",
        "decision_threshold": 0.65,
    },
    "ticket_logistic_model.joblib",
)
هنگام بارگذاری، فقط از فایل مورداعتماد استفاده کنید؛ زیرا قالبهایی مانند Joblib و Pickle برای فایل ناشناس ایمن نیستند.
چرا مدل Embedding و طبقهبند باید با هم نسخهبندی شوند؟
اگر مدل Embedding تغییر کند:
- ابعاد بردار ممکن است عوض شود.
- هندسه فضای برداری تغییر میکند.
- توزیع ویژگیها تغییر میکند.
- ضرایب طبقهبند قدیمی دیگر معتبر نیستند.
بنابراین تغییر مدل Embedding نیازمند ارزیابی مجدد و معمولاً آموزش دوباره طبقهبند است.
TF-IDF بهتر است یا Embedding؟
| ویژگی | TF-IDF + Logistic Regression | Embedding + Logistic Regression |
|---|---|---|
| درک شباهت معنایی | محدود | معمولاً بهتر |
| هزینه تولید ویژگی | کم | وابسته به مدل |
| استقرار محلی | ساده | نیازمند مدل محلی یا API |
| تعداد ویژگیها | زیاد و Sparse | ثابت و Dense |
| تفسیر واژهها | سادهتر | دشوارتر |
| واژههای دقیق تخصصی | مناسب | وابسته به مدل |
| جملهبندی متفاوت | ضعیفتر | معمولاً بهتر |
| نیاز به نسخهبندی مدل پایه | ندارد | دارد |
هر دو روش باید روی داده فارسی واقعی مقایسه شوند.
Drift در Logistic Regression
پس از استقرار ممکن است توزیع داده تغییر کند.
مثالها:
- کاربران از اصطلاحات جدید استفاده میکنند.
- دستههای پشتیبانی تغییر میکنند.
- محصول قابلیت جدیدی اضافه میکند.
- نوع خطاهای API تغییر میکند.
- مدل Embedding به نسخه دیگری مهاجرت میکند.
شاخصهای پایش:
- Precision و Recall هر کلاس
- Macro F1
- Log Loss
- Calibration Error
- نرخ Fallback
- توزیع Confidence
- توزیع کلاسهای پیشبینیشده
- نرخ اصلاح توسط اپراتور
- هزینه متوسط هر مسیر
مدل باید بر اساس داده جدید و تأییدشده دوباره ارزیابی شود.
تفاوت Logistic Regression و SVM
| ویژگی | Logistic Regression | SVM |
|---|---|---|
| هدف | مدلکردن احتمال | بیشینهکردن Margin |
| احتمال خروجی | مستقیم | در برخی نسخهها نیازمند کالیبراسیون |
| مرز خطی | بله | بله |
| Kernel | نسخه استاندارد ندارد | دارد |
| داده Sparse | مناسب | LinearSVC مناسب |
| تفسیر ضرایب | نسبتاً ساده | در مدل خطی ممکن |
| تنظیم اصلی | C و Penalty | C، gamma و Kernel |
| طبقهبندی متن | خط مبنای قوی | خط مبنای قوی |
برای مطالعه بیشتر به مقاله الگوریتم SVM چیست؟ مراجعه کنید.
تفاوت Logistic Regression و درخت تصمیم
| ویژگی | Logistic Regression | درخت تصمیم |
|---|---|---|
| مرز تصمیم | خطی | شرطی و غیرخطی |
| Scaling | معمولاً مهم | معمولاً لازم نیست |
| تفسیر | ضریب و Odds Ratio | قواعد شاخهای |
| تعامل ویژگیها | باید ساخته شود | طبیعیتر |
| احتمال | مستقیم اما نیازمند بررسی کالیبراسیون | وابسته به توزیع برگها |
| داده Sparse | مناسب | وابسته به مسئله |
| بیشبرازش | با Regularization کنترل میشود | با عمق و هرس |
برای جزئیات بیشتر مقاله درخت تصمیم و Random Forest را مطالعه کنید.
مزایای رگرسیون لجستیک
- آموزش سریع
- پیشبینی سریع
- سادگی پیادهسازی
- خروجی احتمال
- تفسیرپذیری نسبی ضرایب
- پشتیبانی از داده Dense و Sparse
- مناسب برای متن و Embedding
- امکان L1، L2 و Elastic Net
- خط مبنای مناسب برای طبقهبندی
- عملکرد خوب در مرزهای تقریباً خطی
محدودیتهای رگرسیون لجستیک
- مرز تصمیم استاندارد خطی است.
- رابطه با Log Odds باید مناسب باشد.
- به Multicollinearity حساس است.
- تعاملها باید صریحاً ساخته شوند.
- به Outlierها حساسیت دارد.
- Scaling روی آموزش و منظمسازی اثر میگذارد.
- احتمالها همیشه خودکار کالیبره نیستند.
- با کلاسهای کاملاً جداشده ممکن است ضرایب ناپایدار شوند.
- تفسیر ضرایب در داده پیچیده دشوار است.
چه زمانی از Logistic Regression استفاده کنیم؟
انتخاب مناسبی است اگر:
- مسئله طبقهبندی دارید.
- احتمال کلاس اهمیت دارد.
- داده کوچک، متوسط یا Sparse است.
- مرز تقریباً خطی است.
- تفسیر ضرایب مفید است.
- یک خط مبنای سریع نیاز دارید.
- متن را با TF-IDF یا Embedding نمایش دادهاید.
- سرعت پیشبینی اهمیت دارد.
ممکن است انتخاب مناسبی نباشد اگر:
- رابطه بسیار غیرخطی است.
- تعاملهای پیچیده فراواناند.
- داده خام تصویر، صوت یا ویدئو است.
- کلاسها با مرز خطی مناسب جدا نمیشوند.
- داده برچسبگذاریشده کافی ندارید.
- Drift شدید و مداوم وجود دارد.
اشتباهات رایج در Logistic Regression
تصور اینکه مدل مقدار پیوسته پیشبینی میکند
کاربرد اصلی Logistic Regression طبقهبندی و برآورد احتمال است.
نرمالنکردن ویژگیهای دارای مقیاس متفاوت
Scaling بر Solver و Regularization اثر میگذارد.
Fit کردن Scaler روی کل داده
این کار باعث نشت اطلاعات میشود. از Pipeline استفاده کنید.
استفاده از Threshold ثابت ۰٫۵ بدون تحلیل
Threshold باید با معیار و هزینه خطا هماهنگ باشد.
استفاده از Accuracy در داده نامتوازن
Precision، Recall، PR AUC و هزینه خطاها را نیز بررسی کنید.
تفسیر ضریب بهعنوان رابطه علّی
ضریب مدل فقط رابطه آماری مشروط را نشان میدهد.
نادیدهگرفتن کالیبراسیون
احتمال خروجی باید با Calibration Curve، Brier Score یا Log Loss بررسی شود.
ارزیابی روی داده آموزش
برای انتخاب مدل از Validation و برای گزارش نهایی از Test Set استفاده کنید.
تنظیم ابرپارامتر روی Test Set
این کار باعث برآورد خوشبینانه عملکرد میشود.
استفاده از Embedding جدید با طبقهبند قدیمی
مدل Embedding و Logistic Regression باید یک واحد نسخهبندیشده محسوب شوند.
پرسشهای متداول
رگرسیون لجستیک به زبان ساده چیست؟
مدلی است که ترکیب خطی ویژگیها را با تابع Sigmoid به عددی بین صفر و یک تبدیل میکند و از آن برای پیشبینی احتمال یک کلاس استفاده میکند.
چرا نام آن رگرسیون است؟
زیرا رابطهای خطی میان ویژگیها و Log Odds میسازد، هرچند خروجی نهایی برای طبقهبندی استفاده میشود.
تابع Sigmoid چیست؟
تابعی است که هر عدد حقیقی را به مقداری بین صفر و یک تبدیل میکند و در مدل دودویی برای محاسبه احتمال استفاده میشود.
تفاوت Odds و Probability چیست؟
Probability بین صفر و یک است. Odds نسبت احتمال وقوع رویداد به احتمال عدم وقوع آن است.
پارامتر C چه کاری انجام میدهد؟
C معکوس شدت منظمسازی در Scikit-learn است. مقدار کوچکتر یعنی منظمسازی قویتر.
L1 بهتر است یا L2؟
هیچ پاسخ ثابتی وجود ندارد. L1 میتواند ضرایب را صفر و ویژگیها را انتخاب کند. L2 معمولاً پایداری بیشتری دارد. انتخاب باید با Cross-validation انجام شود.
آیا Logistic Regression برای چند کلاس مناسب است؟
بله. میتوان آن را برای مسائل چندکلاسه با روشهای مناسب مانند Softmax به کار برد.
آیا احتمال خروجی Logistic Regression همیشه دقیق است؟
خیر. کالیبراسیون به داده، مفروضات مدل، Regularization، نمونهبرداری و شرایط استقرار وابسته است و باید اندازهگیری شود.
آیا Logistic Regression برای متن فارسی مناسب است؟
بله. ترکیب TF-IDF یا Embedding با Logistic Regression میتواند خط مبنای قوی و سریع برای طبقهبندی متن فارسی باشد.
آیا میتوان Logistic Regression را به API درواره متصل کرد؟
بله. میتوان متن را با مدل Embedding درواره به بردار تبدیل کرد و سپس Logistic Regression را برای پیشبینی دسته و احتمال کلاسها به کار برد.
جمعبندی
رگرسیون لجستیک یکی از مهمترین الگوریتمهای طبقهبندی در یادگیری ماشین است. این مدل ابتدا ترکیبی خطی از ویژگیها میسازد و سپس آن را با تابع Sigmoid یا Softmax به احتمال تبدیل میکند.
مفاهیم کلیدی:
- تابع Sigmoid
- Probability
- Odds
- Logit
- Log Loss
- Regularization
- پارامتر C
- Threshold
- Calibration
- ضرایب مدل
برای استفاده صحیح باید:
- داده را به آموزش، اعتبارسنجی و آزمایش تقسیم کنید.
- پیشپردازش را داخل Pipeline قرار دهید.
- معیار مناسب با مسئله انتخاب کنید.
Cو نوع Penalty را تنظیم کنید.- Threshold را بر اساس هزینه خطا تعیین کنید.
- کالیبراسیون احتمال را اندازهگیری کنید.
- داده نامتوازن را مدیریت کنید.
- ضرایب را با احتیاط تفسیر کنید.
- مدل Embedding و طبقهبند را با هم نسخهبندی کنید.
- Drift و کیفیت مدل را پس از استقرار پایش کنید.
برای ساخت طبقهبندهای فارسی، دریافت Embedding و اتصال نرمافزار خود به مدلهای مختلف میتوانید از مستندات API درواره شروع کنید.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
API درواره با ساختار OpenAI سازگار است و امکان دسترسی یکپارچه به مدلهای مختلف را برای توسعهدهندگان و کسبوکارهای ایرانی فراهم میکند.
مقالات مرتبط
- یادگیری ماشین چیست؟
- یادگیری نظارتشده چیست؟
- Embedding چیست؟
- الگوریتم SVM چیست؟
- درخت تصمیم و Random Forest
- Scikit-learn چیست؟
- بهینهسازی بیزی و Optuna
- ارزیابی مدلهای هوش مصنوعی و Evals
- مسیریابی هوشمند میان مدلها
- راهنمای API سازگار با OpenAI
منابع
- Scikit-learn LogisticRegression
- Scikit-learn Linear Models
- Scikit-learn Probability Calibration
- Scikit-learn Calibration Curves
- Scikit-learn Text Classification
- Scikit-learn Documentation
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.