الگوریتم KNN چیست؟ آموزش K-Nearest Neighbors با پایتون و کاربرد در Embedding
الگوریتم KNN یکی از سادهترین روشهای یادگیری ماشین برای طبقهبندی و رگرسیون است. در این راهنما، K-Nearest Neighbors را با پایتون، تنظیم پارامترها و یک نمونه عملی طبقهبندی متن با Embedding و API درواره میآموزید.
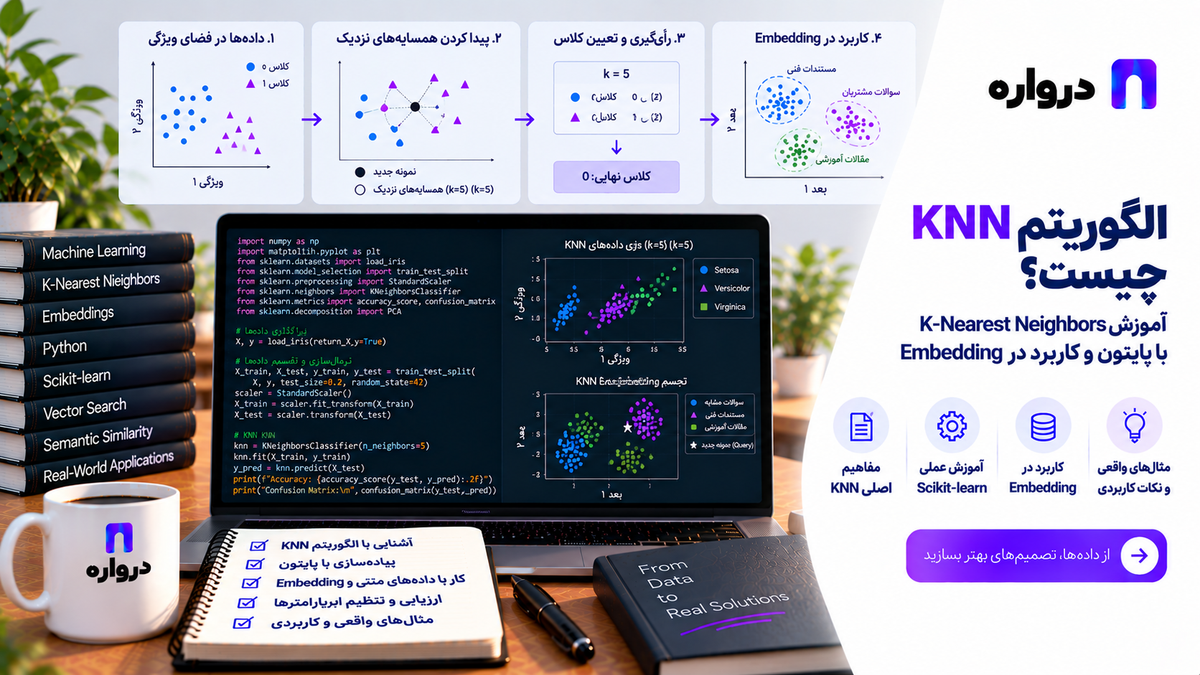
الگوریتم KNN یا K-Nearest Neighbors یکی از شناختهشدهترین الگوریتمهای یادگیری ماشین است. نام فارسی آن را میتوان «الگوریتم نزدیکترین همسایه» یا «K نزدیکترین همسایه» ترجمه کرد.
ایده اصلی KNN بسیار ساده است: اگر بخواهیم وضعیت یک نمونه جدید را تشخیص دهیم، نمونههای مشابه و نزدیک به آن را در دادههای قبلی پیدا میکنیم و بر اساس آنها تصمیم میگیریم.
برای مثال، فرض کنید پیامهای مشتریان یک فروشگاه در سه گروه «پیگیری سفارش»، «مشکل پرداخت» و «درخواست مرجوعی» دستهبندی شدهاند. اگر پیام جدیدی دریافت شود، KNN میتواند چند پیام مشابه را پیدا کند و دسته پیام جدید را با توجه به برچسب آنها پیشبینی کند.
سادگی KNN به این معنا نیست که این الگوریتم فقط برای تمرینهای دانشگاهی کاربرد دارد. مفهوم نزدیکترین همسایه در سیستمهای پیشنهاددهنده، جستوجوی تصویری، تشخیص الگو، بازیابی اسناد و جستوجوی معنایی مبتنی بر Embedding نیز استفاده میشود.
در این مقاله، الگوریتم KNN را بدون استفاده از فرمولهای پیچیده بررسی میکنیم و سپس نمونههای واقعی آن را با پایتون، Scikit-learn و API درواره پیادهسازی میکنیم.
الگوریتم KNN چیست؟
KNN یک الگوریتم یادگیری نظارتشده است که میتواند برای دو مسئله اصلی استفاده شود:
- طبقهبندی یا Classification
- رگرسیون یا Regression
در طبقهبندی، خروجی یک گروه مشخص است. برای مثال، یک تراکنش میتواند «عادی» یا «نیازمند بررسی» باشد.
در رگرسیون، خروجی یک مقدار عددی است. برای مثال، میتوان قیمت تقریبی یک خانه را با توجه به خانههای مشابه تخمین زد.
مستندات رسمی Scikit-learn نیز روشهای مبتنی بر همسایه را به دو گروه طبقهبندی و رگرسیون تقسیم میکند. این روشها بهجای ساختن یک مدل عمومی پیچیده، نمونههای آموزشی را نگه میدارند و هنگام پیشبینی، نزدیکترین نمونهها را جستوجو میکنند.
یک مثال ساده برای درک KNN
فرض کنید اطلاعات چند مشتری قبلی را در اختیار داریم:
| مدت عضویت | تعداد خرید | وضعیت مشتری |
|---|---|---|
| کوتاه | ۱ | تازهوارد |
| کوتاه | ۲ | تازهوارد |
| متوسط | ۷ | فعال |
| طولانی | ۱۲ | وفادار |
| طولانی | ۱۵ | وفادار |
اکنون مشتری جدیدی با مدت عضویت طولانی و ۱۳ خرید وارد سیستم میشود.
الگوریتم KNN مشتریانی را پیدا میکند که از نظر مدت عضویت و تعداد خرید به این مشتری نزدیکتر هستند. اگر بیشتر همسایههای نزدیک در گروه «وفادار» قرار داشته باشند، مشتری جدید نیز در همین گروه طبقهبندی میشود.
در این روش، مدل یک قانون پیچیده برای وفاداری مشتری نمیسازد. تصمیم آن مستقیماً بر اساس شباهت نمونه جدید با دادههای قبلی است.
حرف K در KNN چه معنایی دارد؟
حرف K تعداد همسایههایی را مشخص میکند که در تصمیمگیری شرکت میکنند.
اگر مقدار K برابر با ۳ باشد، الگوریتم سه نمونه نزدیک را بررسی میکند. اگر دو نمونه از این سه همسایه در گروه «فعال» باشند، نمونه جدید معمولاً در گروه فعال قرار میگیرد.
انتخاب K بر رفتار مدل اثر زیادی دارد:
- مقدار بسیار کوچک، مدل را نسبت به نویز و دادههای غیرعادی حساس میکند.
- مقدار بسیار بزرگ، تفاوتهای محلی میان گروهها را از بین میبرد.
- مقدار مناسب باید با اعتبارسنجی روی داده واقعی انتخاب شود.
برای مسائل دودستهای، انتخاب یک عدد فرد میتواند احتمال مساوی شدن رأی همسایهها را کاهش دهد؛ اما این یک قانون قطعی نیست. انتخاب نهایی باید بر اساس نتایج Cross-Validation انجام شود.
مستندات Scikit-learn توضیح میدهد که افزایش تعداد همسایهها میتواند اثر نویز را کاهش دهد، اما ممکن است مرز میان کلاسها را نیز کمرنگتر کند.
الگوریتم KNN چگونه کار میکند؟
فرایند پیشبینی KNN را میتوان در پنج مرحله خلاصه کرد:
۱. دادههای آموزشی و برچسب هر نمونه ذخیره میشوند.
۲. یک نمونه جدید وارد سیستم میشود.
۳. فاصله نمونه جدید با نمونههای قبلی محاسبه میشود.
۴. نزدیکترین همسایهها انتخاب میشوند.
۵. خروجی بر اساس رأی یا مقدار همسایهها تعیین میشود.
در مسئله طبقهبندی، کلاس غالب میان همسایهها انتخاب میشود. در مسئله رگرسیون، خروجی معمولاً از میانگین مقادیر همسایههای نزدیک به دست میآید.
آیا KNN واقعاً آموزش میبیند؟
KNN را معمولاً یک روش Instance-based Learning یا یادگیری مبتنی بر نمونه مینامند.
در بیشتر الگوریتمهای یادگیری ماشین، مرحله آموزش شامل ساخت یک مدل، محاسبه ضرایب یا ایجاد مجموعهای از قوانین است. در KNN، بخش زیادی از کار به زمان پیشبینی منتقل میشود.
به همین دلیل:
- مرحله آموزش معمولاً سریع است.
- دادههای آموزشی باید نگهداری شوند.
- پیشبینی روی مجموعهداده بزرگ ممکن است کند باشد.
- مصرف حافظه میتواند افزایش پیدا کند.
گاهی از KNN با عنوان Lazy Learning نیز یاد میشود؛ زیرا الگوریتم تا زمان دریافت نمونه جدید، محاسبات اصلی پیشبینی را انجام نمیدهد.
معیار فاصله در KNN چیست؟
الگوریتم باید بتواند میزان نزدیکی دو نمونه را محاسبه کند. روش انجام این کار با نوع داده ارتباط دارد.
فاصله اقلیدسی
فاصله اقلیدسی برای دادههای عددی پیوسته رایج است. این معیار، فاصله مستقیم میان دو نقطه را در فضای ویژگیها بررسی میکند.
برای مثال، اگر سن، درآمد و تعداد خرید را بهعنوان ویژگی داشته باشیم، فاصله اقلیدسی میزان تفاوت کلی دو مشتری را محاسبه میکند.
فاصله منهتن
فاصله منهتن تفاوت هر ویژگی را جداگانه محاسبه و با سایر تفاوتها ترکیب میکند. این روش در بعضی دادهها نسبت به مقادیر غیرعادی رفتار متفاوتی از فاصله اقلیدسی دارد.
فاصله مینکوفسکی
مینکوفسکی یک معیار عمومیتر است که میتواند با تنظیم پارامترهای خود رفتاری شبیه فاصله اقلیدسی یا منهتن داشته باشد.
در KNeighborsClassifier، معیار پیشفرض minkowski است. مقدار پیشفرض پارامترهای آن باعث میشود رفتار مدل با فاصله اقلیدسی هماهنگ باشد.
فاصله کسینوسی
فاصله کسینوسی برای بردارهای متنی و Embedding کاربرد زیادی دارد. در این روش، جهت بردارها اهمیت بیشتری از اندازه خام آنها دارد.
این معیار برای کاربردهایی مانند موارد زیر مناسب است:
- پیدا کردن متنهای مشابه
- دستهبندی معنایی پیام
- جستوجوی اسناد
- پیشنهاد محتوای مرتبط
- مقایسه توضیحات محصولات
- یافتن پرسشهای مشابه
Scikit-learn نیز فاصله کسینوسی را در میان معیارهای قابل استفاده برای جستوجوی نزدیکترین همسایه معرفی میکند.
تفاوت KNN و K-Means چیست؟
شباهت نام این دو الگوریتم گاهی باعث اشتباه میشود، اما KNN و K-Means دو روش متفاوت هستند.
| ویژگی | KNN | K-Means |
|---|---|---|
| نوع یادگیری | معمولاً نظارتشده | بدون نظارت |
| نیاز به برچسب | بله، در طبقهبندی و رگرسیون | خیر |
| هدف اصلی | پیشبینی خروجی نمونه جدید | گروهبندی دادههای مشابه |
| مفهوم K | تعداد همسایهها | تعداد خوشهها |
| خروجی | کلاس یا مقدار پیشبینیشده | شناسه خوشه |
اگر دادههای برچسبخورده دارید و میخواهید وضعیت نمونه جدید را پیشبینی کنید، KNN میتواند مناسب باشد. اگر دادهها برچسب ندارند و میخواهید ساختار گروههای پنهان را پیدا کنید، K-Means انتخاب مرتبطتری است.
اهمیت استانداردسازی دادهها در KNN
KNN مستقیماً با فاصله میان دادهها کار میکند. بنابراین مقیاس ویژگیها اهمیت زیادی دارد.
فرض کنید دو ویژگی داریم:
- سن مشتری بین ۱۸ تا ۷۰
- درآمد سالانه بین ۲۰۰ میلیون تا چند میلیارد تومان
چون مقادیر درآمد بسیار بزرگتر از مقادیر سن هستند، ممکن است فاصله میان مشتریان تقریباً فقط تحت تأثیر درآمد قرار گیرد. در نتیجه، اثر سن بهدرستی در تصمیم مدل دیده نمیشود.
برای حل این مشکل میتوان از StandardScaler استفاده کرد. این ابزار ویژگیهای عددی را به مقیاسی قابل مقایسه تبدیل میکند.
مستندات رسمی Scikit-learn هشدار میدهد که اگر پراکندگی یک ویژگی بسیار بزرگتر از ویژگیهای دیگر باشد، همان ویژگی میتواند بر عملکرد بعضی مدلها مسلط شود.
بهتر است استانداردسازی و مدل KNN را داخل یک Pipeline قرار دهیم تا تبدیل دادههای آموزشی و آزمایشی بهصورت هماهنگ انجام شود.
نصب کتابخانههای موردنیاز
برای اجرای مثالها، کتابخانههای زیر را نصب کنید:
pip install numpy pandas scikit-learn openai
در مثال اول از مجموعهداده Wine موجود در Scikit-learn استفاده میکنیم. هدف، تشخیص نوع نمونه بر اساس ویژگیهای عددی آن است.
آموزش KNN با پایتون
کد زیر یک مدل طبقهبندی KNN ایجاد میکند:
from sklearn.datasets import load_wine
from sklearn.metrics import classification_report, confusion_matrix
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler


data = load_wine()

X = data.data
y = data.target

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.25,
    random_state=42,
    stratify=y,
)

pipeline = Pipeline(
    steps=[
        ("scaler", StandardScaler()),
        (
            "knn",
            KNeighborsClassifier(
                n_neighbors=5,
                weights="distance",
            ),
        ),
    ]
)

pipeline.fit(X_train, y_train)

predictions = pipeline.predict(X_test)

print("Confusion matrix:")
print(confusion_matrix(y_test, predictions))

print("\nClassification report:")
print(
    classification_report(
        y_test,
        predictions,
        target_names=data.target_names,
    )
)
در این مثال:
- دادهها به بخش آموزش و آزمایش تقسیم میشوند.
- گزینه
stratify=yنسبت کلاسها را در دو بخش حفظ میکند. StandardScalerویژگیها را استاندارد میکند.- مدل پنج همسایه نزدیک را بررسی میکند.
- همسایههای نزدیکتر وزن بیشتری در تصمیم نهایی دارند.
- عملکرد مدل با گزارش طبقهبندی و ماتریس درهمریختگی بررسی میشود.
چرا از Pipeline استفاده میکنیم؟
Pipeline چند مرحله پردازش را در یک فرایند واحد قرار میدهد.
در مثال ما، ابتدا داده استاندارد میشود و سپس مدل KNN اجرا میشود. اگر استانداردسازی را پیش از تقسیم داده انجام دهیم، اطلاعات بخش آزمایشی ممکن است به فرایند آموزش وارد شود. این اتفاق Data Leakage نام دارد و ارزیابی مدل را غیرواقعی میکند.
Pipeline کمک میکند تبدیلها فقط با داده آموزشی یاد گرفته شوند و سپس بهشکل یکسان روی داده آزمایشی اجرا شوند.
مستندات رسمی Scikit-learn توضیح میدهد که Pipeline امکان اعتبارسنجی و تنظیم همزمان مراحل پردازش و مدل را فراهم میکند.
ارزیابی مدل KNN
استفاده از Accuracy بهتنهایی همیشه کافی نیست. بهتر است معیارهای زیر را نیز بررسی کنید:
Precision
نشان میدهد چند مورد از پیشبینیهای یک کلاس واقعاً متعلق به همان کلاس بودهاند.
Recall
نشان میدهد مدل چه تعداد از نمونههای واقعی یک کلاس را پیدا کرده است.
F1-score
تعادلی میان Precision و Recall ارائه میدهد و برای دادههای نامتوازن مفید است.
Confusion Matrix
نشان میدهد مدل هر کلاس را با کدام کلاسهای دیگر اشتباه گرفته است.
اگر مسئله شما چندکلاسه یا نامتوازن است، بهتر است علاوه بر Accuracy، میانگین Macro F1 را نیز بررسی کنید.
انتخاب بهترین مقدار K با GridSearchCV
نباید مقدار K را فقط بر اساس حدس انتخاب کنیم. میتوان چند مقدار مختلف را با Cross-Validation آزمایش کرد.
from sklearn.model_selection import GridSearchCV
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler


pipeline = Pipeline(
    steps=[
        ("scaler", StandardScaler()),
        ("knn", KNeighborsClassifier()),
    ]
)

parameter_grid = {
    "knn__n_neighbors": [3, 5, 7, 9, 11, 15],
    "knn__weights": ["uniform", "distance"],
    "knn__metric": ["euclidean", "manhattan"],
}

search = GridSearchCV(
    estimator=pipeline,
    param_grid=parameter_grid,
    scoring="f1_macro",
    cv=5,
    n_jobs=-1,
)

search.fit(X_train, y_train)

print("Best parameters:")
print(search.best_params_)

print("Best cross-validation score:")
print(search.best_score_)

best_model = search.best_estimator_
test_predictions = best_model.predict(X_test)
در این کد، موارد زیر بررسی میشوند:
- تعداد متفاوت همسایهها
- رأیدهی برابر یا وزندهی بر اساس فاصله
- دو معیار فاصله رایج
GridSearchCV تمام ترکیبهای تعیینشده را با Cross-Validation ارزیابی میکند و بهترین ترکیب را بر اساس معیار انتخابشده برمیگرداند.
برای مجموعهدادههای بزرگ یا تعداد زیاد پارامترها، RandomizedSearchCV میتواند گزینه سریعتری باشد.
رأیدهی Uniform و Distance چه تفاوتی دارند؟
پارامتر weights مشخص میکند رأی همسایهها چگونه محاسبه شود.
حالت Uniform
همه همسایهها وزن برابر دارند. نزدیکترین و دورترین عضو در میان همسایههای انتخابشده، اثر یکسانی بر نتیجه خواهند داشت.
KNeighborsClassifier(
    n_neighbors=5,
    weights="uniform",
)
حالت Distance
همسایههای نزدیکتر اثر بیشتری بر پیشبینی دارند.
KNeighborsClassifier(
    n_neighbors=5,
    weights="distance",
)
مستندات KNeighborsClassifier نیز این دو روش را پشتیبانی میکند و توضیح میدهد که در حالت distance، نمونههای نزدیکتر تأثیر بیشتری بر خروجی دارند.
در بسیاری از دادههایی که تراکم نقاط یکنواخت نیست، وزندهی بر اساس فاصله میتواند انتخاب مناسبی باشد؛ اما نتیجه باید با داده واقعی ارزیابی شود.
آموزش KNN برای رگرسیون
KNN فقط برای طبقهبندی نیست. با KNeighborsRegressor میتوان یک مقدار عددی را تخمین زد.
مثال زیر قیمت تقریبی یک خانه را بر اساس متراژ و سن بنا پیشبینی میکند:
import numpy as np

from sklearn.neighbors import KNeighborsRegressor
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler


X = np.array(
    [
        [70, 12],
        [80, 8],
        [90, 5],
        [100, 4],
        [110, 3],
        [120, 2],
    ]
)

y = np.array(
    [
        4.2,
        5.1,
        6.4,
        7.3,
        8.4,
        9.2,
    ]
)

model = Pipeline(
    steps=[
        ("scaler", StandardScaler()),
        (
            "knn",
            KNeighborsRegressor(
                n_neighbors=3,
                weights="distance",
            ),
        ),
    ]
)

model.fit(X, y)

predicted_price = model.predict(
    [[95, 6]]
)

print(
    "Predicted price:",
    predicted_price[0],
)
این دادهها فقط برای نمایش نحوه کار الگوریتم هستند و نباید برای قیمتگذاری واقعی ملک استفاده شوند. در یک پروژه واقعی باید عواملی مانند موقعیت، امکانات، طبقه، کیفیت ساخت، وضعیت سند و شرایط بازار نیز وارد مدل شوند.
کاربردهای الگوریتم KNN
KNN در پروژههای متنوعی قابل استفاده است.
طبقهبندی مشتریان
با استفاده از رفتار خرید، تعداد سفارش، مدت عضویت و میزان تعامل میتوان گروه احتمالی یک مشتری را پیشبینی کرد.
تشخیص الگو در تصاویر
هر تصویر را میتوان به مجموعهای از ویژگیها یا یک بردار Embedding تبدیل کرد و تصاویر مشابه را بر اساس فاصله برداری پیدا کرد.
پیشنهاد محصول
اگر محصولات بهصورت بردار نمایش داده شوند، میتوان کالاهای مشابه با محصول موردنظر کاربر را بازیابی کرد.
تشخیص متنهای مشابه
پیام، مقاله، پرسش یا توضیحات محصول میتواند به Embedding تبدیل شود. سپس نزدیکترین متنها به ورودی جدید پیدا میشوند.
دستهبندی تیکت پشتیبانی
پیام جدید مشتری با نمونههای برچسبخورده قبلی مقایسه میشود تا واحد یا موضوع مرتبط پیشنهاد شود.
تشخیص ناهنجاری ساده
اگر یک نمونه فاصله زیادی با همسایههای خود داشته باشد، میتواند برای بررسی بیشتر علامتگذاری شود. بااینحال، برای سامانههای حساس باید از روشهای تخصصیتر تشخیص ناهنجاری و قواعد قطعی نیز استفاده کرد.
Embedding چیست و چه ارتباطی با KNN دارد؟
Embedding متن، تصویر یا داده را به یک بردار عددی تبدیل میکند. هدف این است که نمونههای دارای معنای مشابه، در فضای برداری به یکدیگر نزدیکتر باشند.
برای مثال، دو پیام زیر از واژههای یکسانی استفاده نمیکنند:
- «پرداخت من انجام شد ولی سفارش ثبت نشد»
- «پول از حساب کم شده اما خرید در پنل نیست»
با جستوجوی کلمهای ساده ممکن است شباهت این دو پیام بهخوبی تشخیص داده نشود. یک مدل Embedding مناسب میتواند مفهوم مشترک آنها را در بردارها منعکس کند.
پس از تولید Embedding، میتوان KNN را روی بردارها اجرا کرد و پیامهای نزدیک را پیدا کرد.
برای آشنایی بیشتر با مفهوم بردارهای معنایی، مقاله Embedding چیست و چه کاربردی دارد؟ را مطالعه کنید.
طبقهبندی متن فارسی با Embedding و API درواره
در این مثال، چند پیام نمونه را برچسبگذاری میکنیم. سپس با API درواره برای آنها Embedding میسازیم و یک مدل KNN روی بردارها آموزش میدهیم.
کاربرد نهایی میتواند مسیریابی اولیه پیامهای پشتیبانی باشد.
مرحله اول: تنظیم متغیرهای محیطی
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_EMBEDDING_MODEL="YOUR_EMBEDDING_MODEL_ID"
شناسه مدل را از فهرست فعلی مدلهای درواره انتخاب کنید. قرار دادن شناسه مدل در متغیر محیطی، تغییر مدل را بدون ویرایش بخشهای مختلف کد سادهتر میکند.
مرحله دوم: دریافت Embedding از درواره
import os

import numpy as np
from openai import OpenAI
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import normalize


client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)

EMBEDDING_MODEL = os.environ[
    "DARVAREH_EMBEDDING_MODEL"
]


def create_embeddings(
    texts: list[str],
) -> np.ndarray:
    response = client.embeddings.create(
        model=EMBEDDING_MODEL,
        input=texts,
    )

    ordered_items = sorted(
        response.data,
        key=lambda item: item.index,
    )

    vectors = np.array(
        [
            item.embedding
            for item in ordered_items
        ],
        dtype=np.float32,
    )

    return normalize(vectors)
کتابخانه رسمی OpenAI برای متد embeddings.create ورودی متنی را دریافت و بردار Embedding برمیگرداند. از آنجا که API درواره با ساختار OpenAI سازگار است، میتوان کلاینت را با base_url درواره پیکربندی کرد.
مرتبسازی بر اساس index باعث میشود ترتیب بردارهای خروجی با ترتیب متنهای ورودی هماهنگ بماند.
مرحله سوم: آمادهکردن دادههای نمونه
training_texts = [
"مبلغ از حسابم کم شد ولی سفارش ثبت نشده است.",
"پرداخت موفق بود اما فاکتور در پنل نمایش داده نمیشود.",
"چطور میتوانم هزینه سفارش را آنلاین پرداخت کنم؟",
"سفارش من چه زمانی ارسال میشود؟",
"کد رهگیری مرسوله را از کجا دریافت کنم؟",
"بسته هنوز به دستم نرسیده است.",
"میخواهم کالا را پس بدهم.",
"محصولی که دریافت کردم آسیب دیده و درخواست مرجوعی دارم.",
"شرایط بازگشت کالا چیست؟",
"برای اتصال نرمافزار به API راهنما میخواهم.",
"نمونه کد پایتون برای استفاده از API دارید؟",
"در دریافت پاسخ از API خطا میگیرم.",
]
training_labels = [
"payment",
"payment",
"payment",
"shipping",
"shipping",
"shipping",
"return",
"return",
"return",
"technical",
"technical",
"technical",
]
این مجموعه برای آموزش واقعی بسیار کوچک است. در محیط عملی باید نمونههای متنوعتری از پیامهای واقعی، کوتاه، بلند، محاورهای و دارای غلط تایپی گردآوری شود.
مرحله چهارم: آموزش KNN روی Embeddingها
training_vectors = create_embeddings(
    training_texts
)

classifier = KNeighborsClassifier(
    n_neighbors=3,
    weights="distance",
    metric="cosine",
    algorithm="brute",
)

classifier.fit(
    training_vectors,
    training_labels,
)
در این مثال:
- هر متن به بردار معنایی تبدیل میشود.
- بردارها نرمالسازی میشوند.
- فاصله کسینوسی برای مقایسه متنها استفاده میشود.
- سه پیام مشابه در تصمیمگیری نقش دارند.
- پیام نزدیکتر اثر بیشتری بر خروجی میگذارد.
مرحله پنجم: طبقهبندی پیام جدید
def classify_message(
message: str,
) -> dict:
vector = create_embeddings([message])
predicted_label = classifier.predict(
vector
)[0]
distances, indices = (
classifier.kneighbors(
vector,
n_neighbors=3,
)
)
neighbors = []
for distance, index in zip(
distances[0],
indices[0],
):
neighbors.append(
{
"text": training_texts[index],
"label": training_labels[index],
"distance": round(
float(distance),
4,
),
}
)
return {
"message": message,
"predicted_label": predicted_label,
"neighbors": neighbors,
}
result = classify_message(
"پول از حسابم رفته اما خرید در سفارشها نیست."
)
print(result)
خروجی احتمالی میتواند ساختاری شبیه نمونه زیر داشته باشد:
{
"message": "پول از حسابم رفته اما خرید در سفارشها نیست.",
"predicted_label": "payment",
"neighbors": [
{
"text": "مبلغ از حسابم کم شد ولی سفارش ثبت نشده است.",
"label": "payment",
"distance": 0.08
},
{
"text": "پرداخت موفق بود اما فاکتور در پنل نمایش داده نمیشود.",
"label": "payment",
"distance": 0.12
},
{
"text": "چطور میتوانم هزینه سفارش را آنلاین پرداخت کنم؟",
"label": "payment",
"distance": 0.29
}
]
}
مقادیر فاصله به مدل Embedding و دادههای واقعی وابستهاند و خروجی بالا صرفاً نمایشی است.
استفاده از KNN در کنار مدل زبانی
KNN و مدل زبانی الزاماً جایگزین یکدیگر نیستند. میتوان آنها را در یک معماری ترکیبی به کار برد.
یک جریان عملی میتواند اینگونه باشد:
۱. پیام مشتری دریافت شود.
۲. Embedding پیام با API درواره ساخته شود.
۳. KNN چند پیام یا سند مشابه را پیدا کند.
۴. اگر شباهت کافی بود، دسته اولیه و نمونههای مرتبط استخراج شوند.
۵. یک مدل زبانی پاسخ مناسب را با توجه به اطلاعات بازیابیشده تولید کند.
۶. پاسخ مدل پیش از نمایش اعتبارسنجی شود.
در این معماری، KNN یا موتور جستوجوی برداری مسئول بازیابی نمونههای مشابه است و مدل زبانی مسئول درک زمینه و تولید پاسخ خواهد بود.
نمونه ترکیب KNN با مدل زبانی درواره
پس از پیدا کردن پیامهای مشابه، میتوان آنها را به مدل زبانی ارسال کرد:
def draft_response(
customer_message: str,
similar_messages: list[dict],
) -> str:
examples = "\n".join(
[
(
f"- پیام مشابه: {item['text']}\n"
f" دسته: {item['label']}"
)
for item in similar_messages
]
)
prompt = f"""
پیام مشتری:
{customer_message}
نمونههای مشابه:
{examples}
وظیفه:
یک پاسخ کوتاه، حرفهای و فارسی آماده کن.
اگر اطلاعات کافی نیست، از مشتری اطلاعات تکمیلی بخواه.
هیچ ادعای قطعی درباره وضعیت پرداخت یا سفارش مطرح نکن.
"""
response = client.chat.completions.create(
model=os.environ["DARVAREH_CHAT_MODEL"],
temperature=0.2,
messages=[
{
"role": "system",
"content": (
"شما دستیار پاسخگویی "
"به مشتریان هستید."
),
},
{
"role": "user",
"content": prompt,
},
],
)
content = (
response
.choices[0]
.message
.content
)
if not content:
raise ValueError(
"مدل پاسخ متنی برنگرداند."
)
return content
متغیر مدل را نیز در محیط تنظیم کنید:
export DARVAREH_CHAT_MODEL="YOUR_CHAT_MODEL_ID"
این روش چند مزیت دارد:
- نمونههای واقعی و مرتبط در اختیار مدل قرار میگیرند.
- دستهبندی ساده همیشه به مدل زبانی وابسته نیست.
- مدل تولید متن را میتوان بدون تغییر بخش KNN تعویض کرد.
- پیامها و فاصله همسایهها برای بررسی و ارزیابی قابل ثبت هستند.
بااینحال، برای اطلاعاتی مانند وضعیت واقعی سفارش، موجودی، مانده حساب یا نتیجه پرداخت نباید به شباهت متنی یا حافظه مدل تکیه کرد. این اطلاعات باید از API یا پایگاه داده اصلی کسبوکار دریافت شوند.
تعیین آستانه پذیرش
KNN همیشه یک کلاس را برمیگرداند، حتی اگر نمونه جدید شباهت مناسبی با دادههای آموزشی نداشته باشد. این رفتار در محیط واقعی میتواند مشکلساز شود.
برای مثال، مدل فقط با موضوعات پرداخت، ارسال و مرجوعی آموزش دیده است؛ اما کاربر درباره همکاری تجاری سؤال میکند. KNN همچنان یکی از دستههای موجود را انتخاب خواهد کرد.
راهحل این است که فاصله نزدیکترین همسایه بررسی شود. اگر نزدیکترین نمونه بیش از حد دور باشد، خروجی به گروه unknown یا بررسی انسانی منتقل شود.
def classify_with_threshold(
    message: str,
    max_distance: float = 0.35,
) -> dict:
    vector = create_embeddings([message])

    distances, indices = (
        classifier.kneighbors(
            vector,
            n_neighbors=3,
        )
    )

    nearest_distance = float(
        distances[0][0]
    )

    if nearest_distance > max_distance:
        return {
            "label": "unknown",
            "accepted": False,
            "nearest_distance": (
                nearest_distance
            ),
        }

    label = classifier.predict(
        vector
    )[0]

    return {
        "label": label,
        "accepted": True,
        "nearest_distance": (
            nearest_distance
        ),
    }
عدد آستانه نباید از روی حدس انتخاب شود. باید مجموعهای از پیامهای مرتبط و نامرتبط آماده کنید و آستانه را بر اساس نرخ خطا، پوشش و نیاز کسبوکار تنظیم کنید.
نقاط قوت KNN
سادگی پیادهسازی
منطق KNN قابل فهم است و با چند خط کد میتوان یک نمونه اولیه ساخت.
نیاز نداشتن به آموزش پیچیده
الگوریتم برای شروع به فرایند آموزشی سنگین نیاز ندارد و نمونههای موجود را ذخیره میکند.
پشتیبانی از مرزهای غیرخطی
KNN میتواند الگوهایی را تشخیص دهد که با یک مرز خطی ساده جدا نمیشوند.
کاربرد در طبقهبندی و رگرسیون
با تغییر مدل میتوان از یک ایده مشابه برای خروجیهای گروهی و عددی استفاده کرد.
تفسیرپذیری محلی
میتوان نشان داد کدام همسایهها در تصمیم یک نمونه مشخص مؤثر بودهاند. این ویژگی برای بررسی خطاهای مدل مفید است.
هماهنگی با Embedding
بردارهای متن، تصویر یا محصول را میتوان با روش نزدیکترین همسایه جستوجو کرد.
محدودیتهای KNN
هزینه پیشبینی
KNN هنگام دریافت هر نمونه جدید باید همسایههای آن را جستوجو کند. با افزایش تعداد نمونهها، این عملیات زمانبر میشود.
مصرف حافظه
ازآنجاکه دادههای آموزشی نگهداری میشوند، مجموعهداده بزرگ به حافظه بیشتری نیاز دارد.
حساسیت به مقیاس ویژگیها
اگر ویژگیهای عددی مقیاسهای متفاوتی داشته باشند، نتیجه فاصله میتواند گمراهکننده باشد.
حساسیت به ویژگیهای نامرتبط
ویژگیهایی که اطلاعات مفیدی ندارند میتوانند مفهوم فاصله را ضعیف کنند.
مشکل در ابعاد بالا
در فضای دارای ویژگیهای بسیار زیاد، تفاوت میان نزدیک و دور ممکن است کمتر معنادار شود. این مسئله را معمولاً «نفرین ابعاد» مینامند.
دشواری کار با داده نامتوازن
اگر یک کلاس نمونههای بسیار بیشتری داشته باشد، ممکن است در میان همسایهها بیش از حد ظاهر شود.
نیاز به انتخاب پارامتر مناسب
تعداد همسایهها، معیار فاصله، نوع وزندهی و روش جستوجو باید روی داده واقعی تنظیم شوند.
نفرین ابعاد در KNN چیست؟
با افزایش تعداد ویژگیها، دادهها در فضای بزرگتری پخش میشوند. در چنین فضایی، همسایهای که از نظر محاسباتی نزدیک است، ممکن است از نظر معنایی شباهت کافی نداشته باشد.
راهکارهای متداول عبارتاند از:
- حذف ویژگیهای نامرتبط
- انتخاب ویژگی
- کاهش ابعاد
- افزایش تعداد نمونههای آموزشی
- انتخاب معیار فاصله مناسب
- ارزیابی Embeddingهای مختلف
- استفاده از مدلهای جایگزین در صورت افت کیفیت
در داده متنی، بردارهای Embedding معمولاً صدها یا هزاران مؤلفه دارند. به همین دلیل باید کیفیت جستوجو روی مجموعهای از پرسشهای واقعی ارزیابی شود و صرفاً به نزدیکترین نتیجه اعتماد نشود.
روشهای جستوجوی همسایه در Scikit-learn
پارامتر algorithm میتواند یکی از گزینههای زیر باشد:
| گزینه | توضیح |
|---|---|
auto | انتخاب خودکار روش بر اساس داده |
brute | مقایسه مستقیم با نمونهها |
kd_tree | استفاده از ساختار KD Tree |
ball_tree | استفاده از ساختار Ball Tree |
Scikit-learn از NearestNeighbors بهعنوان رابطی برای جستوجوی مستقیم، KD Tree و Ball Tree استفاده میکند. انتخاب مناسب به تعداد نمونهها، تعداد ویژگیها، ساختار داده و معیار فاصله وابسته است.
برای Embeddingهای متنی با ابعاد زیاد و فاصله کسینوسی، معمولاً روش brute در نمونههای کوچک قابل استفاده است. در مجموعهدادههای بزرگتر باید موتورهای جستوجوی برداری و روشهای Approximate Nearest Neighbor بررسی شوند.
KNN برای دادههای بزرگ
اگر چند صد یا چند هزار نمونه دارید، Scikit-learn میتواند برای نمونه اولیه مناسب باشد. اما اگر تعداد بردارها به صدها هزار یا میلیونها نمونه برسد، جستوجوی مستقیم ممکن است پاسخگویی را کند کند.
در مقیاس بزرگ میتوان ابزارهای زیر را بررسی کرد:
- FAISS
- Qdrant
- Milvus
- Weaviate
- Elasticsearch
- PostgreSQL همراه با pgvector
FAISS یک کتابخانه متنباز برای جستوجوی شباهت و خوشهبندی بردارهای متراکم است و رابط پایتون نیز ارائه میکند. برخی روشهای آن امکان استفاده از GPU را دارند.
انتخاب ابزار به عواملی مانند تعداد بردارها، نیاز به فیلتر متادیتا، سرعت پاسخ، میزان بهروزرسانی داده و زیرساخت پروژه بستگی دارد.
برای آشنایی بیشتر میتوانید مقاله پایگاه داده برداری چیست؟ را مطالعه کنید.
KNN در مقایسه با الگوریتمهای دیگر
| الگوریتم | مزیت اصلی | محدودیت اصلی | کاربرد مناسب |
|---|---|---|---|
| KNN | سادگی و استفاده مستقیم از نمونههای مشابه | پیشبینی کند در داده بزرگ | نمونه اولیه، داده محلی و جستوجوی شباهت |
| رگرسیون لجستیک | سریع و قابل تفسیر | مرز تصمیم نسبتاً ساده | طبقهبندی و مدل پایه |
| SVM | عملکرد مناسب در بسیاری از دادههای پُربعد | تنظیم پارامتر و مقیاسپذیری | طبقهبندی متن و داده متوسط |
| درخت تصمیم | قواعد قابل مشاهده | احتمال بیشبرازش | مسائل دارای قواعد شاخهای |
| جنگل تصادفی | پایداری بیشتر از یک درخت | مدل بزرگتر و تفسیر دشوارتر | دادههای جدولی |
| شبکه عصبی | توانایی یادگیری الگوهای پیچیده | نیاز به داده و محاسبات بیشتر | تصویر، صوت، متن و داده پیچیده |
هیچ الگوریتمی برای همه پروژهها بهترین نیست. KNN را در کنار چند مدل پایه دیگر ارزیابی کنید و انتخاب نهایی را بر اساس کیفیت، سرعت، هزینه و پیچیدگی نگهداری انجام دهید.
چه زمانی از KNN استفاده کنیم؟
KNN میتواند انتخاب مناسبی باشد اگر:
- مجموعهداده کوچک یا متوسط دارید.
- مفهوم شباهت میان نمونهها قابل تعریف است.
- به یک مدل پایه ساده نیاز دارید.
- میخواهید نمونههای مؤثر بر هر تصمیم را مشاهده کنید.
- دادههای جدید بهصورت تدریجی اضافه میشوند.
- هدف شما پیدا کردن متن، تصویر یا محصول مشابه است.
- سرعت پیشبینی در حجم بسیار بالا مسئله اصلی نیست.
چه زمانی KNN انتخاب مناسبی نیست؟
بهتر است روش دیگری را بررسی کنید اگر:
- تعداد نمونهها بسیار زیاد است.
- پاسخ باید با تأخیر بسیار کم ارائه شود.
- تعداد ویژگیها زیاد و کیفیت فاصله پایین است.
- دادههای آموزشی حافظه زیادی مصرف میکنند.
- ویژگیهای نامرتبط فراوان هستند.
- نیاز به یک مدل بسیار فشرده برای اجرا روی دستگاه محدود دارید.
- دادهها بهشدت نامتوازناند و اصلاح آن دشوار است.
اشتباهات رایج در اجرای KNN
استاندارد نکردن ویژگیها
این اشتباه باعث میشود ویژگیهای دارای مقدار بزرگتر، تصمیم مدل را کنترل کنند.
انتخاب K بر اساس حدس
بهتر است مقدار K با Cross-Validation و معیار ارزیابی مناسب انتخاب شود.
استفاده از Accuracy برای داده نامتوازن
در این شرایط باید Precision، Recall، F1 و ماتریس درهمریختگی نیز بررسی شوند.
انجام استانداردسازی پیش از تقسیم داده
این کار میتواند باعث نشت اطلاعات از داده آزمایشی به فرایند آموزش شود. Pipeline از این خطا جلوگیری میکند.
استفاده مستقیم از KNN روی متن خام
KNN با بردارهای عددی کار میکند. متن باید ابتدا با TF-IDF یا Embedding به بردار تبدیل شود.
اعتماد کامل به نزدیکترین نتیجه
حتی یک نمونه نامرتبط نیز نزدیکترین همسایه خود را دارد. برای سامانه عملی باید آستانه پذیرش و حالت unknown تعریف شود.
استفاده از داده آزمایشی برای تنظیم پارامترها
داده آزمایشی باید برای ارزیابی نهایی حفظ شود. تنظیم پارامترها روی بخش اعتبارسنجی یا با Cross-Validation انجام میشود.
ذخیره نکردن نسخه مدل Embedding
اگر مدل Embedding تغییر کند، بردارهای قدیمی و جدید ممکن است قابل مقایسه نباشند. نام و نسخه مدل باید همراه داده ثبت شود و در صورت تغییر مدل، بردارها دوباره تولید شوند.
معماری پیشنهادی برای استفاده از KNN و API درواره
برای یک سامانه طبقهبندی پیام، معماری ساده میتواند شامل مراحل زیر باشد:
۱. دریافت پیام در سرور برنامه
۲. پاکسازی و نرمالسازی متن فارسی
۳. ساخت Embedding با API درواره
۴. جستوجوی نزدیکترین نمونهها
۵. بررسی فاصله و آستانه پذیرش
۶. تعیین دسته یا انتقال به unknown
۷. دریافت اطلاعات قطعی از سامانههای داخلی
۸. تولید پاسخ با مدل زبانی در صورت نیاز
۹. اعتبارسنجی پاسخ
۱۰. ثبت نتیجه و بازخورد کاربر
کلید API نباید در مرورگر، اپلیکیشن موبایل یا کد سمت کاربر قرار گیرد. درخواست باید از سرور برنامه به درواره ارسال شود.
نکات مهم برای محیط Production
Embeddingها را کش کنید
برای متنهای ثابت، هر بار Embedding جدید نسازید. بردار را همراه شناسه متن و نسخه مدل ذخیره کنید.
ورودیها را دستهای ارسال کنید
اگر سرویس و مدل انتخابی از ورودی دستهای پشتیبانی میکنند، چند متن را در یک درخواست ارسال کنید تا تعداد رفتوبرگشتهای شبکه کاهش یابد.
نسخه مدل را ثبت کنید
هر بردار باید به شناسه دقیق مدل Embedding مرتبط باشد.
داده برچسبخورده را نسخهبندی کنید
تغییر برچسب یک نمونه میتواند خروجی تعداد زیادی از پیشبینیها را تغییر دهد. نسخه مجموعهداده و زمان تغییرات را ثبت کنید.
فاصله همسایهها را ذخیره کنید
این اطلاعات برای یافتن خطا، تنظیم آستانه و بررسی تغییر کیفیت مفید است.
بازخورد انسانی جمعآوری کنید
اگر اپراتور دسته پیشنهادی را اصلاح کرد، نتیجه را برای ارزیابی و توسعه مجموعهداده نگه دارید.
دادههای نامرتبط را مدیریت کنید
وجود گزینه unknown یا needs_review از طبقهبندی اجباری ورودیهای جدید جلوگیری میکند.
کیفیت فارسی را جداگانه ارزیابی کنید
پیامهای فارسی رسمی، محاورهای، دارای نیمفاصله، اعداد فارسی، Pinglish و غلط تایپی را در مجموعه آزمایش قرار دهید.
اتصال به API درواره
درواره امکان دسترسی یکپارچه به مدلهای مختلف هوش مصنوعی را از طریق API سازگار با OpenAI فراهم میکند.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
در یک پروژه واقعی بهتر است:
- کلید API فقط در متغیرهای محیطی سرور نگهداری شود.
- شناسه مدل از تنظیمات برنامه خوانده شود.
- برای خطاهای موقت Retry محدود در نظر گرفته شود.
- Timeout مشخص شود.
- میزان مصرف ثبت شود.
- ورودی و خروجی اعتبارسنجی شوند.
- مدل Embedding پیش از استفاده با دادههای فارسی واقعی ارزیابی شود.
برای شروع میتوانید مستندات API درواره را مطالعه کنید.
پرسشهای متداول
الگوریتم KNN چیست؟
KNN یک الگوریتم یادگیری ماشین است که با پیدا کردن نزدیکترین نمونههای آموزشی، کلاس یا مقدار نمونه جدید را پیشبینی میکند.
KNN مخفف چیست؟
KNN مخفف K-Nearest Neighbors و به معنای K نزدیکترین همسایه است.
KNN برای طبقهبندی است یا رگرسیون؟
برای هر دو قابل استفاده است. KNeighborsClassifier برای طبقهبندی و KNeighborsRegressor برای پیشبینی مقدار عددی استفاده میشود.
بهترین مقدار K چند است؟
یک مقدار ثابت برای همه دادهها وجود ندارد. مقدار مناسب باید با Cross-Validation و بر اساس معیار عملکرد پروژه انتخاب شود.
چرا باید دادهها را در KNN استاندارد کنیم؟
زیرا KNN بر اساس فاصله تصمیم میگیرد. اگر مقیاس ویژگیها متفاوت باشد، ویژگی دارای مقادیر بزرگتر ممکن است بیش از حد بر نتیجه اثر بگذارد.
تفاوت KNN و K-Means چیست؟
KNN معمولاً برای پیشبینی بر اساس دادههای برچسبخورده استفاده میشود، اما K-Means یک الگوریتم خوشهبندی بدون نظارت است.
آیا KNN برای متن فارسی مناسب است؟
KNN مستقیماً متن را پردازش نمیکند. ابتدا باید متن فارسی با TF-IDF یا مدل Embedding مناسب به بردار تبدیل شود. سپس میتوان KNN را روی بردارها اجرا کرد.
آیا میتوان KNN را با مدل زبانی ترکیب کرد؟
بله. KNN میتواند پیامها یا اسناد مشابه را پیدا کند و مدل زبانی بر اساس آنها پاسخ تولید کند.
آیا KNN برای میلیونها بردار مناسب است؟
اجرای مستقیم Scikit-learn در چنین مقیاسی معمولاً انتخاب بهینهای نیست. باید موتورهای جستوجوی برداری و روشهای تقریبی مانند FAISS یا پایگاههای داده برداری بررسی شوند.
آیا KNN احتمال خروجی تولید میکند؟
KNeighborsClassifier میتواند با predict_proba سهم رأی کلاسها را ارائه کند، اما این مقدار نباید بدون ارزیابی و کالیبراسیون بهعنوان اطمینان قطعی تفسیر شود.
جمعبندی
الگوریتم KNN یکی از سادهترین روشهای یادگیری ماشین برای طبقهبندی، رگرسیون و جستوجوی شباهت است. این الگوریتم بهجای ساختن یک مدل پیچیده، نزدیکترین نمونههای موجود را پیدا میکند و بر اساس آنها تصمیم میگیرد.
برای استفاده درست از KNN باید به چند موضوع توجه کنید:
۱. ویژگیهای عددی را استاندارد کنید.
۲. مقدار K را با Cross-Validation انتخاب کنید.
۳. معیار فاصله را متناسب با نوع داده تعیین کنید.
۴. برای داده نامتوازن فقط به Accuracy تکیه نکنید.
۵. در طبقهبندی متن، ابتدا TF-IDF یا Embedding بسازید.
۶. برای ورودیهای نامرتبط آستانه پذیرش و دسته unknown تعریف کنید.
۷. در دادههای بزرگ از موتور جستوجوی برداری استفاده کنید.
۸. نسخه مدل Embedding و مجموعهداده را ثبت کنید.
۹. کیفیت مدل را با پیامهای واقعی فارسی بسنجید.
۱۰. اطلاعات قطعی کسبوکار را از پایگاه داده و APIهای اصلی دریافت کنید.
با استفاده از API درواره میتوانید متنهای فارسی را به Embedding تبدیل کنید، نمونههای مشابه را با KNN پیدا کنید و در صورت نیاز، پاسخ نهایی را با یک مدل زبانی تولید کنید. این ترکیب برای ساخت دستهبندی تیکت، جستوجوی معنایی، پیشنهاد محتوا و دستیارهای هوشمند قابل استفاده است.
مقالات مرتبط
- یادگیری ماشین چیست؟
- یادگیری نظارتشده چیست؟
- یادگیری بدون نظارت و K-Means
- الگوریتم SVM چیست؟
- رگرسیون لجستیک چیست؟
- Embedding چیست و چه کاربردی دارد؟
- پایگاه داده برداری چیست؟
- جستوجوی معنایی چیست؟
- آموزش اتصال API هوش مصنوعی به نرمافزار
منابع
- مستندات Nearest Neighbors در Scikit-learn
- مستندات KNeighborsClassifier
- مستندات StandardScaler
- مستندات GridSearchCV
- کتابخانه رسمی OpenAI برای پایتون
- مخزن رسمی FAISS
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.