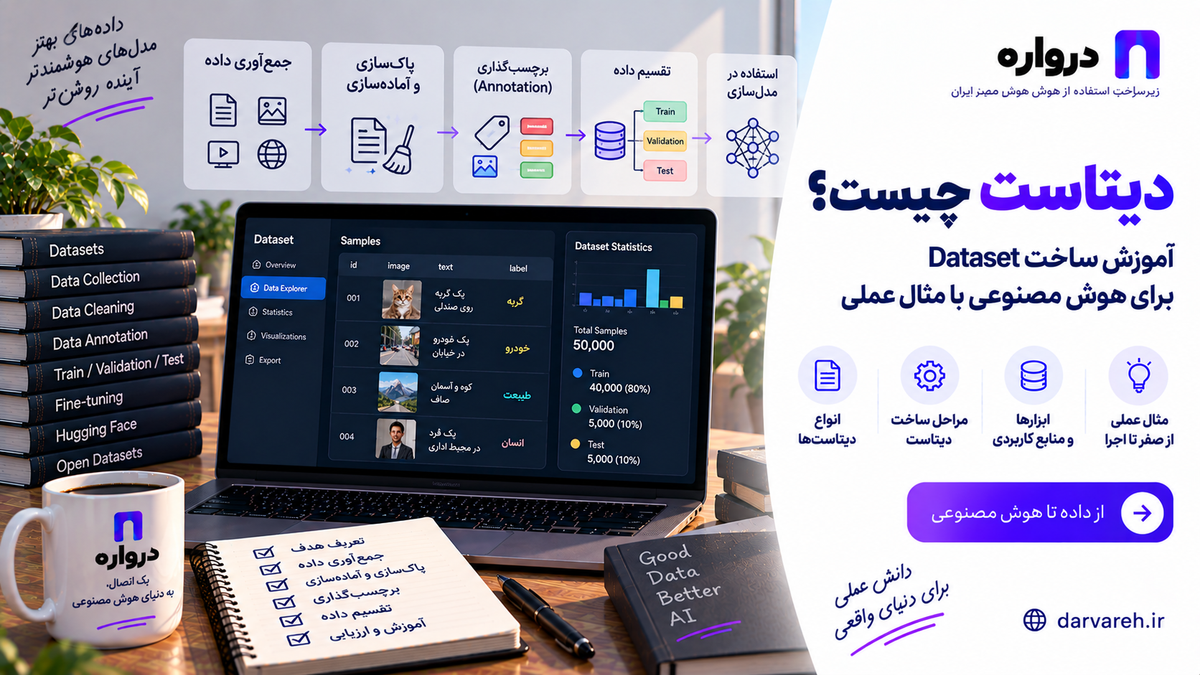
دیتاست چیست؟ آموزش ساخت Dataset برای هوش مصنوعی با مثال عملی
دیتاست چیست و چگونه برای هوش مصنوعی یک مجموعهداده باکیفیت بسازیم؟ در این راهنمای جامع با انواع دیتاست، روش جمعآوری و برچسبگذاری داده، تقسیم Train و Validation و Test، جلوگیری از Data Leakage، کنترل کیفیت و ساخت یک دیتاست واقعی فارسی با Python و API درواره آشنا میشوید.
دیتاست یا مجموعهداده، یکی از مهمترین اجزای هر پروژه هوش مصنوعی و یادگیری ماشین است. مدل بدون داده مناسب نمیتواند الگوهای موردنیاز را یاد بگیرد و حتی قدرتمندترین الگوریتم نیز با دادههای ناقص، اشتباه یا نامرتبط نتیجه قابلاعتمادی تولید نمیکند.
در پروژههای امروزی، دیتاست فقط برای آموزش مدل از صفر استفاده نمیشود. مجموعهداده در بخشهای مختلف یک سیستم هوش مصنوعی کاربرد دارد:
- آموزش مدل یادگیری ماشین
- Fine-tuning مدل زبانی
- ارزیابی و مقایسه مدلها
- آزمایش پرامپتها
- ساخت سیستم RAG
- طبقهبندی پیامهای کاربران
- استخراج اطلاعات از اسناد
- تشخیص اشیا در تصویر
- تبدیل گفتار به متن
- آموزش مدل تولید تصویر
- ارزیابی چتبات و AI Agent
- بررسی کیفیت نسخه جدید مدل
در این مقاله بررسی میکنیم دیتاست چیست، چه انواعی دارد، چگونه ساخته میشود و برای آمادهسازی یک مجموعهداده فارسی باکیفیت باید چه نکاتی را رعایت کرد.
در ادامه، یک پروژه واقعی برای ساخت دیتاست طبقهبندی پیامهای پشتیبانی پیادهسازی میکنیم و نشان میدهیم چگونه میتوان از Python، Pandas، Scikit-learn و API درواره در این فرایند استفاده کرد.
دیتاست چیست؟
دیتاست یا Dataset مجموعهای سازمانیافته از نمونههای داده است که برای تحلیل، آموزش، ارزیابی یا اجرای یک سیستم نرمافزاری استفاده میشود.
هر نمونه میتواند شامل یک یا چند ویژگی و در بعضی پروژهها یک برچسب باشد.
برای مثال، یک دیتاست فروش ممکن است چنین ساختاری داشته باشد:
| شناسه | محصول | قیمت | دستهبندی | فروخته شد؟ |
|---|---|---|---|---|
| ۱ | لپتاپ | ۴۵۰۰۰۰۰۰ | دیجیتال | بله |
| ۲ | صندلی اداری | ۸۰۰۰۰۰۰ | مبلمان | خیر |
| ۳ | هدفون | ۳۵۰۰۰۰۰ | دیجیتال | بله |
در این مثال:
- هر ردیف یک نمونه است.
- هر ستون یک ویژگی یا Feature است.
- ستون «فروخته شد؟» میتواند برچسب یا Label مدل باشد.
یک دیتاست متنی برای طبقهبندی پیامهای مشتریان ممکن است چنین باشد:
| متن پیام | برچسب |
|---|---|
| مبلغ از حسابم کم شد ولی کیف پول شارژ نشد | پرداخت |
| چطور کلید API بسازم؟ | سؤال فنی |
| مدل موردنظر من در فهرست نیست | درخواست محصول |
| پاسخ API خیلی دیر دریافت میشود | مشکل فنی |
در پروژههای هوش مصنوعی، ساختار دیتاست باید متناسب با مسئله، مدل و معیار ارزیابی طراحی شود.
تفاوت Data، Dataset و Database چیست؟
این سه اصطلاح مرتبطاند، اما معنای یکسانی ندارند.
Data یا داده
داده میتواند یک مقدار منفرد یا مجموعهای از اطلاعات خام باشد؛ مانند:
- یک متن
- یک عدد
- یک تصویر
- یک فایل صوتی
- موقعیت جغرافیایی
- زمان ثبت تراکنش
Dataset یا مجموعهداده
دیتاست مجموعهای تعریفشده از نمونههاست که برای یک هدف مشخص آماده شده است؛ برای مثال، آموزش مدل تشخیص احساس متن فارسی.
Database یا پایگاه داده
پایگاه داده سامانهای برای ذخیره، بازیابی و مدیریت اطلاعات است. دیتاست ممکن است از یک یا چند جدول پایگاه داده استخراج شود، اما خود پایگاه داده الزاماً یک دیتاست آماده یادگیری ماشین نیست.
برای تبدیل دادههای عملیاتی به دیتاست معمولاً باید مراحل زیر انجام شوند:
- استخراج داده مرتبط
- پاکسازی
- حذف رکوردهای نامعتبر
- تعریف برچسب
- کنترل کیفیت
- ثبت نسخه
- تقسیم داده برای آموزش و ارزیابی
اجزای اصلی یک دیتاست
نمونه یا Sample
هر واحد مستقل داده یک نمونه محسوب میشود. یک نمونه میتواند یک پیام، تصویر، مکالمه، سند یا تراکنش باشد.
ویژگی یا Feature
ویژگی اطلاعاتی است که مدل برای پیشبینی از آن استفاده میکند.
در دیتاست قیمت مسکن، متراژ، محله، تعداد اتاق و سن ساختمان میتوانند Feature باشند.
برچسب یا Label
برچسب خروجی مطلوب برای هر نمونه است.
در تشخیص احساس، برچسب ممکن است یکی از این مقادیر باشد:
- مثبت
- منفی
- خنثی
Metadata
فراداده اطلاعاتی درباره نمونه است که لزوماً مستقیماً به مدل داده نمیشود، اما برای تحلیل و مدیریت دیتاست مفید است.
نمونههای Metadata:
- زمان جمعآوری
- منبع
- نسخه
- زبان
- شناسه برچسبزن
- وضعیت بازبینی
- میزان اطمینان
- نوع دستگاه
- کانال ورودی
Schema
Schema ساختار رسمی دیتاست را تعریف میکند:
- نام ستونها
- نوع داده هر ستون
- مقادیر مجاز
- فیلدهای اجباری
- محدودیت طول
- رابطه میان ستونها
وجود Schema از ورود دادههای ناسازگار جلوگیری میکند.
انواع دیتاست در هوش مصنوعی
دیتاست جدولی
دادههای جدولی معمولاً در CSV، Excel، Parquet یا پایگاه داده نگهداری میشوند.
کاربردها:
- پیشبینی فروش
- تشخیص ریزش مشتری
- امتیازدهی سرنخ فروش
- پیشبینی تقاضا
- تحلیل تراکنش
- طبقهبندی کاربران
دیتاست متنی
هر نمونه شامل یک متن یا مجموعهای از متنهاست.
کاربردها:
- تحلیل احساس
- طبقهبندی موضوع
- خلاصهسازی
- ترجمه
- استخراج موجودیت
- پاسخگویی به سؤال
- تشخیص هدف کاربر
دیتاست تصویر
نمونهها شامل تصویر و اطلاعات وابسته به آن هستند.
بسته به مسئله، برچسب میتواند یکی از موارد زیر باشد:
- کلاس تصویر
- Bounding Box
- ماسک Segmentation
- نقاط کلیدی
- توضیح متنی تصویر
دیتاست صوت
نمونه ممکن است شامل فایل صوتی، متن پیادهسازیشده، گوینده و اطلاعات زمانی باشد.
کاربردها:
- تبدیل گفتار به متن
- تشخیص گوینده
- طبقهبندی صدا
- تشخیص احساس از صوت
- تولید گفتار
دیتاست ویدیو
دیتاست ویدیو میتواند شامل کلیپ، فریم، صدا، زیرنویس، برچسب حرکت یا توضیح صحنه باشد.
دیتاست سری زمانی
نمونهها ترتیب زمانی دارند و ترتیب آنها بخشی از اطلاعات مسئله است.
کاربردها:
- پیشبینی فروش
- تشخیص ناهنجاری
- پیشبینی مصرف
- تحلیل داده حسگر
- پیشبینی خرابی تجهیزات
دیتاست گراف
داده به شکل Node و Edge نمایش داده میشود.
کاربردها:
- شبکه اجتماعی
- پیشنهاد محصول
- تشخیص تقلب
- تحلیل ارتباطات
- دانشنگار
دیتاست چندوجهی
دیتاست Multimodal بیش از یک نوع داده دارد؛ برای مثال:
- تصویر و توضیح متنی
- ویدیو و زیرنویس
- صوت و متن
- سند اسکنشده و اطلاعات استخراجشده
- پیام کاربر و تصویر پیوستشده
انواع دیتاست برای مدلهای زبانی
با گسترش مدلهای زبانی بزرگ، چند نوع دیتاست تخصصی اهمیت بیشتری پیدا کردهاند.
دیتاست Pretraining
شامل حجم بزرگی از متن برای آموزش عمومی مدل زبانی است. ساخت چنین دیتاستی پیچیده، پرهزینه و نیازمند زیرساخت گسترده است.
دیتاست Instruction Tuning
هر نمونه معمولاً شامل دستور و پاسخ مطلوب است:
{
  "instruction": "پیام مشتری را در یک دسته قرار بده.",
  "input": "مبلغ پرداخت کردم اما کیف پول شارژ نشد.",
  "output": {
    "category": "billing"
  }
}
دیتاست مکالمه
نمونهها به شکل پیامهای دارای نقش ذخیره میشوند:
{
  "messages": [
    {
      "role": "system",
      "content": "شما دستیار پشتیبانی فنی هستید."
    },
    {
      "role": "user",
      "content": "چطور کلید API بسازم؟"
    },
    {
      "role": "assistant",
      "content": "از بخش کلیدهای API در داشبورد یک کلید جدید ایجاد کنید."
    }
  ]
}
دیتاست Preference
در این دیتاست دو یا چند پاسخ برای یک ورودی مقایسه میشوند:
{
  "prompt": "تفاوت API و SDK چیست؟",
  "chosen": "API قرارداد ارتباط با سرویس است؛ SDK مجموعه ابزارهای توسعه است.",
  "rejected": "هر دو یک مفهوم دارند."
}
دیتاست ارزیابی
این مجموعه برای سنجش کیفیت مدل استفاده میشود و نباید وارد داده آموزشی همان مدل یا فرایند تنظیم پرامپت شود.
دیتاست Tool Calling
در این نوع داده، مدل یاد میگیرد در چه شرایطی یک ابزار یا تابع را فراخوانی کند:
{
  "user_message": "موجودی کیف پول من چقدر است؟",
  "expected_tool": "get_wallet_balance",
  "expected_arguments": {}
}
تفاوت دیتاست RAG و دیتاست Fine-tuning
این دو نوع داده نباید با هم اشتباه گرفته شوند.
داده RAG
در RAG، اسناد به بخشهای کوچکتر تقسیم و برای بازیابی آماده میشوند. هدف این است که هنگام پاسخگویی، اطلاعات مرتبط در Context مدل قرار گیرد.
نمونه داده RAG:
- مستندات محصول
- راهنمای داخلی
- قراردادها
- پرسشهای متداول
- اطلاعات بهروز قیمت و خدمات
داده Fine-tuning
در Fine-tuning، نمونهها برای تغییر رفتار مدل یا آموزش یک وظیفه مشخص استفاده میشوند.
نمونه داده Fine-tuning:
- دستور و پاسخ مطلوب
- قالب نگارش سازمان
- نمونه طبقهبندی
- رفتار مورد انتظار در فراخوانی ابزار
- پاسخهای پذیرفتهشده و ردشده
اگر مسئله شما کمبود اطلاعات بهروز است، RAG معمولاً انتخاب مرتبطتری است. اگر مدل اطلاعات را دارد اما قالب، لحن یا رفتار مطلوب را رعایت نمیکند، Fine-tuning ممکن است بررسی شود.
دیتاست آموزش، اعتبارسنجی و آزمون
یکی از مهمترین مراحل آمادهسازی داده، تقسیم آن به مجموعههای مستقل است.
Training Set
داده آموزشی برای یادگیری پارامترهای مدل استفاده میشود.
Validation Set
داده اعتبارسنجی برای انتخاب مدل، تنظیم Hyperparameterها، مقایسه پرامپتها و تصمیمگیری در طول توسعه استفاده میشود.
Test Set
داده آزمون برای ارزیابی نهایی استفاده میشود و نباید در تصمیمهای توسعه مکرراً دیده شود.
یک تقسیم رایج میتواند چنین باشد:
- ۷۰ تا ۸۰ درصد آموزش
- ۱۰ تا ۱۵ درصد اعتبارسنجی
- ۱۰ تا ۲۰ درصد آزمون
این درصدها قانون ثابت نیستند. اندازه دیتاست، تعداد کلاسها، نوع مسئله و شیوه جمعآوری داده بر انتخاب نسبت مناسب اثر دارند.
کتابخانه Scikit-learn تابع train_test_split را برای تقسیم تصادفی داده و امکان استفاده از stratify برای حفظ تقریبی توزیع کلاسها ارائه میکند.
Data Leakage چیست؟
Data Leakage زمانی رخ میدهد که اطلاعاتی از داده ارزیابی یا آینده به فرایند آموزش وارد شود. در این حالت معیارهای ارزیابی بیشازحد خوب به نظر میرسند، اما مدل در محیط واقعی عملکرد ضعیفی دارد.
نمونه اول: رکوردهای تکراری
اگر یک پیام در Train و نسخه تقریباً یکسان آن در Test باشد، مدل ممکن است پاسخ را حفظ کرده باشد.
نمونه دوم: مکالمه مشترک
اگر پیامهای مختلف یک مکالمه میان Train و Test تقسیم شوند، مدل از اطلاعات بسیار مشابه استفاده میکند.
نمونه سوم: داده آینده
در پیشبینی زمانی نباید داده آینده وارد آموزش گذشته شود.
نمونه چهارم: پاکسازی قبل از تقسیم
اگر میانگین، واژگان یا پارامترهای پیشپردازش با کل دیتاست محاسبه شوند، اطلاعات Test وارد Pipeline میشود.
نمونه پنجم: استفاده مکرر از Test
اگر پس از هر تغییر، نتیجه روی Test بررسی و بر اساس آن تصمیمگیری شود، Test عملاً به Validation تبدیل میشود.
روش صحیح تقسیم دیتاست
تقسیم تصادفی همیشه روش مناسبی نیست.
| نوع داده | روش مناسبتر |
|---|---|
| نمونههای مستقل و متوازن | تقسیم تصادفی |
| کلاسهای نامتوازن | تقسیم Stratified |
| چند پیام از یک کاربر | تقسیم بر اساس شناسه کاربر |
| چند بخش از یک سند | تقسیم بر اساس سند |
| سری زمانی | تقسیم بر اساس زمان |
| تصاویر یک محصول | تقسیم بر اساس شناسه محصول |
| مکالمات پشتیبانی | تقسیم بر اساس شناسه مکالمه |
| داده چند شعبه | ارزیابی جداگانه بر اساس شعبه یا منطقه |
اگر چند نمونه از یک منبع مشترک تولید شدهاند، بهتر است همه آنها در یک Split قرار گیرند.
دیتاست خوب چه ویژگیهایی دارد؟
مرتبط با کاربرد واقعی است
داده باید نماینده ورودیهایی باشد که سیستم در محیط واقعی دریافت میکند.
اگر کاربران پیامهای کوتاه و محاورهای فارسی مینویسند، دیتاست رسمی و ادبی نتیجه کاملاً مناسبی ایجاد نمیکند.
برچسبهای دقیق دارد
تعریف هر کلاس باید روشن باشد و برچسبزنها برداشت مشترکی از آن داشته باشند.
تنوع کافی دارد
دیتاست باید شکلهای مختلف بیان، خطاهای تایپی، طولهای متفاوت و موارد مرزی را پوشش دهد.
متوازن و قابل تحلیل است
متوازنبودن لزوماً به معنای برابرکردن مصنوعی همه کلاسها نیست. توزیع داده باید آگاهانه و متناسب با هدف ارزیابی انتخاب شود.
تکرار غیرضروری ندارد
تکرار زیاد ممکن است مدل را نسبت به الگوهای محدود متمایل کند.
قابل بازتولید است
باید بتوان مشخص کرد هر نسخه دیتاست چگونه، چه زمانی و با کدام کد ساخته شده است.
مستندات دارد
بدون توضیح منبع، Schema، برچسبها و محدودیتها، استفاده مجدد از دیتاست دشوار خواهد بود.
چه تعداد نمونه برای ساخت دیتاست لازم است؟
عدد ثابتی وجود ندارد.
نیاز داده به عوامل زیر بستگی دارد:
- پیچیدگی مسئله
- تعداد کلاسها
- تنوع ورودی
- کیفیت برچسب
- نوع مدل
- استفاده از مدل ازپیشآموزشدیده
- معیار کیفیت موردنیاز
- شباهت داده آموزش به محیط واقعی
برای یک طبقهبندی ساده با مدل ازپیشآموزشدیده، تعداد محدودی نمونه باکیفیت ممکن است نقطه شروع خوبی باشد. آموزش یک مدل عمومی از صفر میتواند به حجم بسیار بزرگی از داده نیاز داشته باشد.
راه بهتر برای تصمیمگیری استفاده از Learning Curve است:
- مدل را با بخش کوچکی از داده آموزش دهید.
- کیفیت را ثبت کنید.
- حجم داده را افزایش دهید.
- دوباره ارزیابی کنید.
- بررسی کنید اضافهشدن داده هنوز بهبود معناداری ایجاد میکند یا خیر.
اگر کیفیت با افزایش داده بهتر نمیشود، ممکن است مشکل در برچسبها، مدل، Featureها یا تعریف مسئله باشد.
مراحل ساخت دیتاست برای هوش مصنوعی
مرحله اول: تعریف دقیق مسئله
پیش از جمعآوری داده مشخص کنید مدل قرار است چه تصمیمی بگیرد.
هدف مبهم:
میخواهیم پیامهای مشتری را تحلیل کنیم.
هدف قابلاندازهگیری:
میخواهیم هر پیام جدید را در یکی از پنج دسته فروش، پرداخت، سؤال فنی، بازخورد محصول و سایر قرار دهیم.
مرحله دوم: تعریف واحد نمونه
در پروژه پشتیبانی باید مشخص شود هر نمونه چیست:
- یک پیام
- کل مکالمه
- آخرین پیام همراه با تاریخچه
- خلاصه مکالمه
- یک تیکت کامل
این تصمیم روی مدل، هزینه و روش تقسیم داده اثر دارد.
مرحله سوم: طراحی Schema
برای مثال:
| ستون | نوع | توضیح |
|---|---|---|
sample_id | رشته | شناسه یکتا |
text | رشته | متن پیام |
label | دستهای | برچسب نهایی |
source | رشته | کانال دریافت |
conversation_id | رشته | شناسه مکالمه |
created_at | زمان | زمان ثبت |
review_status | رشته | وضعیت بازبینی |
dataset_version | رشته | نسخه داده |
مرحله چهارم: جمعآوری داده
منابع احتمالی:
- سامانه تیکت
- CRM
- فرم وبسایت
- چت پشتیبانی
- نظرات کاربران
- مرکز تماس
- داده عمومی دارای مجوز مناسب
- داده مصنوعی
- نمونههای طراحیشده توسط متخصص
استفاده از هر منبع باید با شرایط استفاده و مجوز آن سازگار باشد.
مرحله پنجم: پاکسازی
پاکسازی میتواند شامل این موارد باشد:
- حذف رکوردهای خالی
- رفع مشکل Encoding
- یکسانسازی حروف فارسی و عربی
- حذف تکرار
- اصلاح Schema
- شناسایی متنهای بسیار کوتاه
- مدیریت مقادیر گمشده
- حذف داده خارج از دامنه مسئله
مرحله ششم: تعریف راهنمای برچسبگذاری
برای هر برچسب باید تعریف، مثال مثبت، مثال منفی و موارد مرزی نوشته شود.
مرحله هفتم: برچسبگذاری
برچسبگذاری میتواند با این روشها انجام شود:
- متخصص انسانی
- نیروی آموزشدیده
- قانون برنامهنویسیشده
- مدل هوش مصنوعی
- ترکیب مدل و بازبینی انسانی
مرحله هشتم: کنترل کیفیت
بخشی از نمونهها را دوباره بررسی کنید و اختلافها را تحلیل کنید.
مرحله نهم: حذف Leakage و تقسیم داده
ابتدا گروههای مرتبط را مشخص کنید و سپس Train، Validation و Test بسازید.
مرحله دهم: ثبت نسخه و مستندات
نسخه دیتاست، تاریخ، تغییرات و کد تولید باید ثبت شوند.
چگونه راهنمای برچسبگذاری بنویسیم؟
فرض کنید دستههای دیتاست پشتیبانی عبارتاند از:
salesbillingtechnicalproduct_feedbackother
تعریف برچسب billing:
پیامهایی که مسئله اصلی آنها پرداخت، فاکتور، کیف پول، کسر وجه یا بازگشت مبلغ است.
مثال مثبت:
- هزینه از حسابم کم شد ولی اعتبار اضافه نشد.
- فاکتور پرداخت را از کجا دانلود کنم؟
- مبلغ باقیمانده کیف پول چقدر است؟
مثال منفی:
- قیمت استفاده از مدل چقدر است؟
این پیام میتواند در دسته فروش قرار گیرد، زیرا هنوز تراکنشی انجام نشده است.
مورد مرزی:
- برای خرید اعتبار خطای فنی دریافت میکنم.
باید مشخص شود اولویت با فرایند پرداخت است یا خطای فنی.
راهنمای برچسبگذاری باید برای چنین مواردی قانون تصمیمگیری داشته باشد.
سنجش توافق برچسبزنها
در پروژههای حساس بهتر است بخشی از نمونهها توسط حداقل دو نفر مستقل برچسبگذاری شود.
سپس میتوان معیارهایی مانند Cohen’s Kappa را محاسبه کرد:
κ=po−pe1−pe\kappa = \frac{p_o - p_e}{1 - p_e}
در این رابطه:
- pop_o میزان توافق مشاهدهشده است.
- pep_e توافقی است که ممکن است بهصورت تصادفی رخ دهد.
توافق پایین میتواند نشان دهد:
- تعریف کلاسها مبهم است.
- کلاسها همپوشانی دارند.
- راهنمای برچسبگذاری کافی نیست.
- مسئله به ورودی بیشتری نیاز دارد.
- برچسب چندگانه مناسبتر از یک برچسب است.
ابزارهای ساخت و مدیریت دیتاست
Pandas
برای خواندن، پاکسازی، تحلیل و تبدیل دادههای جدولی مناسب است.
Hugging Face Datasets
کتابخانه Hugging Face Datasets امکان بارگذاری فایلهای محلی و راهدور در قالبهایی مانند CSV، JSON، Text و Parquet را فراهم میکند.
Label Studio
ابزار متنباز برای برچسبگذاری متن، تصویر، صوت و انواع دیگر داده است.
CVAT
برای Annotation تصویر و ویدیو کاربرد دارد.
DVC
DVC برای نسخهبندی داده، مدل و آزمایشهای یادگیری ماشین طراحی شده و تجربهای مشابه Git برای داراییهای پروژه ML فراهم میکند.
TensorFlow Data Validation
TFDV میتواند آمار داده را با Schema مقایسه کند و مواردی مانند داده نامعتبر، Training-Serving Skew و Drift را شناسایی کند.
Great Expectations
برای تعریف و اجرای انتظارهای کیفیت داده مناسب است؛ برای مثال:
- ستون نباید خالی باشد.
- مقدار باید در محدوده مشخص قرار گیرد.
- شناسه باید یکتا باشد.
- برچسب باید از فهرست مجاز انتخاب شود.
مثال عملی: ساخت دیتاست فارسی پیامهای پشتیبانی
در این پروژه میخواهیم پیامها را در پنج دسته طبقهبندی کنیم.
ابتدا کتابخانهها را نصب کنید:
pip install pandas scikit-learn pydantic openai
یک فایل با نام support_messages.csv در نظر بگیرید:
sample_id,text,label,conversation_id,source
1,مبلغ پرداخت شد اما کیف پول شارژ نشد,billing,c-101,chat
2,چطور کلید API جدید بسازم,technical,c-102,ticket
3,برای خرید سازمانی تخفیف دارید,sales,c-103,form
4,مدل جدید تولید تصویر اضافه کنید,product_feedback,c-104,chat
5,سلام وقت بخیر,other,c-105,chat
خواندن و بررسی اولیه دیتاست
import pandas as pd


df = pd.read_csv("support_messages.csv")

print(df.head())
print(df.info())
print(df["label"].value_counts(dropna=False))
اعتبارسنجی ستونهای ضروری
REQUIRED_COLUMNS = {
"sample_id",
"text",
"label",
"conversation_id",
"source",
}
missing_columns = REQUIRED_COLUMNS - set(df.columns)
if missing_columns:
raise ValueError(
f"ستونهای ضروری وجود ندارند: {missing_columns}"
)
یکسانسازی متن فارسی
import re
import unicodedata


def normalize_persian_text(text: str) -> str:
    text = unicodedata.normalize("NFKC", str(text))

    replacements = {
        "ي": "ی",
        "ى": "ی",
        "ك": "ک",
        "ۀ": "ه",
    }

    for old, new in replacements.items():
        text = text.replace(old, new)

    text = re.sub(r"\s+", " ", text)
    return text.strip()


df["normalized_text"] = df["text"].map(
    normalize_persian_text
)
در پروژههای زبانی نباید بدون آزمایش همه نشانهها، نیمفاصلهها یا علائم را حذف کرد. ممکن است همین اطلاعات برای وظیفه مفید باشند.
حذف داده خالی
df = df[
    df["normalized_text"].notna()
    & df["normalized_text"].str.len().gt(2)
].copy()
بررسی برچسبهای مجاز
ALLOWED_LABELS = {
    "sales",
    "billing",
    "technical",
    "product_feedback",
    "other",
}

invalid_labels = set(df["label"]) - ALLOWED_LABELS

if invalid_labels:
    raise ValueError(
        f"برچسب نامعتبر پیدا شد: {invalid_labels}"
    )
حذف نمونههای تکراری
duplicate_mask = df.duplicated(
    subset=["normalized_text"],
    keep=False,
)

duplicates = df[duplicate_mask].sort_values(
    "normalized_text"
)

print("Duplicate rows:", len(duplicates))

df = df.drop_duplicates(
    subset=["normalized_text"],
    keep="first",
)
حذف خودکار تمام تکرارها همیشه صحیح نیست. ممکن است دو پیام یکسان در شرایط مختلف برچسب متفاوتی داشته باشند. این اختلاف باید بررسی شود.
پیدا کردن تعارض برچسب
label_conflicts = (
    df.groupby("normalized_text")["label"]
    .nunique()
    .loc[lambda values: values > 1]
)

if not label_conflicts.empty:
    print("Conflicting labels:")
    print(label_conflicts)
تقسیم Train، Validation و Test
برای نمونههای مستقل میتوان از تقسیم Stratified استفاده کرد:
from sklearn.model_selection import train_test_split


train_df, temp_df = train_test_split(
    df,
    test_size=0.30,
    random_state=42,
    stratify=df["label"],
)

validation_df, test_df = train_test_split(
    temp_df,
    test_size=0.50,
    random_state=42,
    stratify=temp_df["label"],
)

print("Train:", len(train_df))
print("Validation:", len(validation_df))
print("Test:", len(test_df))
برای استفاده از stratify باید در هر کلاس تعداد کافی نمونه وجود داشته باشد.
اگر هر مکالمه چند پیام دارد، تقسیم تصادفی ردیفها مناسب نیست. باید تمام پیامهای یک conversation_id در یک مجموعه قرار گیرند.
ذخیره نسخههای دیتاست
from pathlib import Path


output_dir = Path("dataset/v1")
output_dir.mkdir(parents=True, exist_ok=True)

train_df.to_json(
    output_dir / "train.jsonl",
    orient="records",
    lines=True,
    force_ascii=False,
)

validation_df.to_json(
    output_dir / "validation.jsonl",
    orient="records",
    lines=True,
    force_ascii=False,
)

test_df.to_json(
    output_dir / "test.jsonl",
    orient="records",
    lines=True,
    force_ascii=False,
)
قالب JSON Lines برای بسیاری از Pipelineهای یادگیری ماشین و مدلهای زبانی مناسب است، زیرا هر خط یک نمونه مستقل دارد.
آموزش یک مدل پایه برای کنترل دیتاست
قبل از استفاده از مدل پیچیده، بهتر است یک Baseline ساده بسازید. این کار نشان میدهد دیتاست تا چه حد قابل یادگیری است.
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
from sklearn.pipeline import Pipeline


pipeline = Pipeline(
    steps=[
        (
            "tfidf",
            TfidfVectorizer(
                analyzer="char_wb",
                ngram_range=(3, 5),
                min_df=2,
                max_features=50_000,
            ),
        ),
        (
            "classifier",
            LogisticRegression(
                max_iter=1000,
                class_weight="balanced",
            ),
        ),
    ]
)

pipeline.fit(
    train_df["normalized_text"],
    train_df["label"],
)

predictions = pipeline.predict(
    validation_df["normalized_text"]
)

print(
    classification_report(
        validation_df["label"],
        predictions,
        digits=3,
        zero_division=0,
    )
)
Character N-gram میتواند برای متن فارسی، شکلهای مختلف کلمه و بخشی از خطاهای تایپی مفید باشد. بااینحال، انتخاب نهایی باید بر اساس ارزیابی انجام شود.
ذخیره مدل
import joblib


joblib.dump(
    pipeline,
    "support_classifier.joblib",
)
آزمایش روی پیام جدید
model = joblib.load(
"support_classifier.joblib"
)
messages = [
"پول از حسابم کم شده ولی اعتبار ندارم",
"نمونه کد اتصال به API را میخواهم",
]
results = model.predict(messages)
for message, label in zip(messages, results):
print(message, "=>", label)
استفاده از API درواره برای برچسبگذاری کمکی
مدل زبانی میتواند در برچسبگذاری اولیه، پیشنهاد برچسب و شناسایی نمونههای مبهم کمک کند. خروجی مدل نباید بدون کنترل وارد دیتاست مرجع شود.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
متغیرهای محیطی را تنظیم کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
کد پایتون:
import json
import os
from typing import Literal
from openai import OpenAI
from pydantic import BaseModel, Field
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
MODEL_ID = os.environ["DARVAREH_MODEL"]
class SuggestedLabel(BaseModel):
label: Literal[
"sales",
"billing",
"technical",
"product_feedback",
"other",
]
confidence: float = Field(
ge=0.0,
le=1.0,
)
reason: str
needs_human_review: bool
def suggest_label(message: str) -> SuggestedLabel:
prompt = f"""
پیام مشتری را برچسبگذاری کن.
تعریف برچسبها:
- sales: سؤال پیش از خرید، قیمت و فروش سازمانی
- billing: پرداخت، کیف پول، فاکتور و بازگشت وجه
- technical: خطا، اتصال API و سؤال برنامهنویسی
- product_feedback: پیشنهاد قابلیت یا درخواست مدل جدید
- other: پیامهایی که در دستههای بالا قرار نمیگیرند
قواعد:
- فقط یک برچسب انتخاب کن.
- اگر پیام مبهم است، needs_human_review را true کن.
- confidence عددی بین صفر و یک باشد.
- پاسخ فقط JSON معتبر باشد.
ساختار:
{{
"label": "technical",
"confidence": 0.85,
"reason": "دلیل کوتاه",
"needs_human_review": false
}}
پیام:
{message}
"""
response = client.chat.completions.create(
model=MODEL_ID,
temperature=0,
messages=[
{
"role": "system",
"content": (
"شما دستیار برچسبگذاری دیتاست "
"پشتیبانی فارسی هستید."
),
},
{
"role": "user",
"content": prompt,
},
],
)
content = response.choices[0].message.content
if not content:
raise ValueError("مدل پاسخی برنگرداند.")
return SuggestedLabel.model_validate_json(
content
)
result = suggest_label(
"برای اتصال Laravel به API نمونه کد دارید؟"
)
print(result.model_dump_json(indent=2))
نمونه خروجی:
{
"label": "technical",
"confidence": 0.96,
"reason": "پیام درباره اتصال برنامهنویسی Laravel به API است.",
"needs_human_review": false
}
معماری Human-in-the-loop برای برچسبگذاری
بهتر است مدل نقش پیشنهاددهنده داشته باشد:
داده خام
↓
کنترل Schema و پاکسازی
↓
پیشنهاد برچسب توسط مدل
↓
اعمال قواعد اعتبارسنجی
↓
نمونه مطمئن → نمونهبرداری برای کنترل
نمونه مبهم → بازبینی انسانی
↓
دیتاست تأییدشده
↓
نسخهبندی و ارزیابی
نمونههایی که بهتر است برای انسان ارسال شوند:
- Confidence پایین
- پیام چندموضوعی
- کلاس کمنمونه
- اختلاف مدل و قانون
- نمونه خارج از دامنه
- ورودی بسیار کوتاه
- برچسب جدید
- نمونه نزدیک مرز تصمیم
برچسبگذاری دستهای با API
برای کنترل بهتر، بهتر است نمونهها در Batchهای محدود پردازش و هر خروجی جداگانه اعتبارسنجی شود.
import time

import pandas as pd


unlabeled_df = pd.read_csv(
    "unlabeled_messages.csv"
)

results = []

for row in unlabeled_df.itertuples():
    try:
        suggestion = suggest_label(row.text)

        results.append(
            {
                "sample_id": row.sample_id,
                "text": row.text,
                "suggested_label": suggestion.label,
                "confidence": suggestion.confidence,
                "reason": suggestion.reason,
                "needs_human_review": (
                    suggestion.needs_human_review
                ),
                "status": "success",
            }
        )

    except Exception as error:
        results.append(
            {
                "sample_id": row.sample_id,
                "text": row.text,
                "status": "failed",
                "error": str(error),
            }
        )

    time.sleep(0.2)

result_df = pd.DataFrame(results)

result_df.to_json(
    "label_suggestions.jsonl",
    orient="records",
    lines=True,
    force_ascii=False,
)
در محیط واقعی باید Retry، محدودیت نرخ، ثبت هزینه، شناسه درخواست و Checkpoint نیز در نظر گرفته شوند.
اندازهگیری کیفیت برچسبگذاری مدل
برای اعتماد به مدل، ابتدا یک مجموعه مرجع انسانی آماده کنید. سپس پیشنهادهای مدل را با آن مقایسه کنید:
from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix,
)


gold_labels = evaluation_df["human_label"]
model_labels = evaluation_df["model_label"]

print(
    "Accuracy:",
    accuracy_score(
        gold_labels,
        model_labels,
    ),
)

print(
    classification_report(
        gold_labels,
        model_labels,
        digits=3,
        zero_division=0,
    )
)

print(
    confusion_matrix(
        gold_labels,
        model_labels,
    )
)
فقط Accuracy را بررسی نکنید. ممکن است یک کلاس پرتعداد نتیجه کلی را پنهان کند.
معیارهای مهمتر:
- Precision هر کلاس
- Recall هر کلاس
- F1-score
- Confusion Matrix
- نرخ ارجاع به انسان
- کیفیت نمونههای Confidence بالا
- هزینه برچسبگذاری هر نمونه
مدیریت کلاسهای نامتوازن
فرض کنید ۷۰ درصد پیامها فنی و فقط ۲ درصد مربوط به بازخورد محصول هستند. مدلی که همیشه کلاس پرتعداد را انتخاب کند ممکن است Accuracy ظاهراً بالایی داشته باشد.
راهکارهای قابل بررسی:
- جمعآوری داده بیشتر برای کلاس کمنمونه
- استفاده از
class_weight - نمونهگیری آگاهانه
- ارزیابی جداگانه هر کلاس
- تعریف Threshold اختصاصی
- Active Learning
- ترکیب بعضی کلاسهای بسیار مشابه
- تبدیل مسئله تکبرچسبی به چندبرچسبی در صورت نیاز
تغییر مصنوعی توزیع Train نباید باعث شود Test نماینده محیط واقعی نباشد.
Active Learning چیست؟
در Active Learning، مدل بهجای برچسبگذاری تصادفی تمام دادهها، نمونههایی را برای بازبینی انتخاب میکند که بیشترین ارزش آموزشی را دارند.
این نمونهها ممکن است شامل موارد زیر باشند:
- Confidence پایین
- فاصله کم میان دو کلاس
- نمونه متفاوت از دادههای قبلی
- کلاس کمنمونه
- اختلاف میان چند مدل
چرخه Active Learning:
- آموزش مدل اولیه
- پیشبینی داده بدون برچسب
- انتخاب نمونههای نامطمئن
- برچسبگذاری انسانی
- افزودن به Train
- آموزش نسخه جدید
- تکرار فرایند
این روش میتواند هزینه برچسبگذاری را کاهش دهد، اما Test Set باید مستقل باقی بماند.
داده مصنوعی در ساخت دیتاست
مدلهای زبانی میتوانند برای تولید نمونههای متنوع استفاده شوند؛ برای مثال:
- بازنویسی پیام با لحنهای مختلف
- ساخت خطاهای تایپی کنترلشده
- تولید نمونه برای کلاس کمداده
- تولید موارد مرزی
- ساخت داده اولیه برای نمونهسازی
اما داده مصنوعی محدودیت دارد:
- ممکن است الگوهای خود مدل را تکرار کند.
- ممکن است تنوع کاربران واقعی را نداشته باشد.
- ممکن است خطاهای واقعی کسبوکار را پوشش ندهد.
- احتمال تولید برچسب نادرست وجود دارد.
- ارزیابی روی داده مصنوعی میتواند بیشازحد خوشبینانه باشد.
داده مصنوعی بهتر است مکمل داده واقعی باشد، نه جایگزین کامل آن.
Data Augmentation چیست؟
Data Augmentation با ایجاد تغییرهای کنترلشده در نمونهها، تنوع داده را افزایش میدهد.
برای متن
- بازنویسی
- ترجمه رفتوبرگشتی
- تغییر لحن
- افزودن خطای تایپی
- جایگزینی عبارت هممعنی
برای تصویر
- چرخش
- برش
- تغییر روشنایی
- Flip
- تغییر اندازه
- نویز کنترلشده
برای صوت
- تغییر سرعت محدود
- افزودن نویز
- تغییر Pitch
- ترکیب با صدای محیط
تغییر نباید برچسب اصلی نمونه را عوض کند.
کنترل کیفیت خودکار دیتاست
یک اسکریپت اعتبارسنجی ساده میتواند بسیاری از مشکلات را پیش از آموزش پیدا کند:
def validate_dataset(
    frame: pd.DataFrame,
) -> list[str]:
    errors = []

    if frame["sample_id"].duplicated().any():
        errors.append(
            "sample_id تکراری وجود دارد."
        )

    if frame["normalized_text"].isna().any():
        errors.append(
            "متن خالی وجود دارد."
        )

    if not set(frame["label"]).issubset(
        ALLOWED_LABELS
    ):
        errors.append(
            "برچسب خارج از فهرست مجاز وجود دارد."
        )

    if (
        frame["normalized_text"]
        .str.len()
        .lt(3)
        .any()
    ):
        errors.append(
            "نمونه بسیار کوتاه وجود دارد."
        )

    return errors


validation_errors = validate_dataset(df)

if validation_errors:
    raise ValueError(
        "\n".join(validation_errors)
    )
در پروژه عملی این کنترلها را داخل CI اجرا کنید تا نسخه ناسالم دیتاست وارد Pipeline آموزش نشود.
Dataset Card چیست؟
Dataset Card سندی است که مشخصات دیتاست را توضیح میدهد.
موارد پیشنهادی:
- نام دیتاست
- نسخه
- هدف
- زبان
- Schema
- روش جمعآوری
- روش برچسبگذاری
- تعداد نمونهها
- توزیع کلاسها
- روش تقسیم
- معیارهای کیفیت
- محدودیتها
- کاربردهای مناسب
- کاربردهای نامناسب
- تاریخ بهروزرسانی
- مسئول نگهداری
نمونه ساده:
name: Persian Support Intent Dataset
version: 1.0.0
language:
  - fa
task: text-classification
labels:
  - sales
  - billing
  - technical
  - product_feedback
  - other
split_strategy: conversation-level
train_samples: 8000
validation_samples: 1000
test_samples: 1000
اعداد بالا فقط نمونه ساختاری هستند و باید با اطلاعات واقعی جایگزین شوند.
نسخهبندی دیتاست
تغییر کوچک در داده میتواند نتیجه مدل را تغییر دهد. بنابراین عبارت final_dataset_v2_new_revised.csv روش مناسبی برای مدیریت نسخه نیست.
برای هر نسخه ثبت کنید:
- شناسه نسخه
- Hash فایل
- تاریخ ایجاد
- کد تولیدکننده
- منبع داده
- تعداد نمونه
- تعداد هر کلاس
- نمونههای افزودهشده
- نمونههای حذفشده
- دلیل تغییر
- مدلهای آموزشدیده با آن نسخه
یک ساختار ساده:
datasets/
  support-intent/
    v1.0.0/
      train.jsonl
      validation.jsonl
      test.jsonl
      dataset-card.yaml
      statistics.json
      checksums.txt
تشخیص Data Drift
داده کاربران با گذشت زمان تغییر میکند. ممکن است محصولات، اصطلاحات یا رفتار مشتریان جدید شوند.
نمونههای Drift:
- اضافهشدن نام مدل جدید
- تغییر اصطلاحات کاربران
- افزایش پیامهای مربوط به قابلیت تازه
- تغییر کانال ورودی
- تغییر طول متوسط پیام
- تغییر توزیع کلاسها
برای پایش Drift میتوان این موارد را مقایسه کرد:
- توزیع برچسب
- طول متن
- زبان ورودی
- واژگان پرتکرار
- نرخ نمونه خارج از دامنه
- نرخ خطای مدل
- Embedding Distribution
TensorFlow Data Validation نیز امکان مقایسه آمار داده با Schema و شناسایی Drift یا Training-Serving Skew را فراهم میکند.
اشتباهات رایج در ساخت دیتاست
جمعآوری داده قبل از تعریف هدف
اگر خروجی موردانتظار مشخص نباشد، ممکن است حجم زیادی داده غیرقابلاستفاده جمع شود.
برچسبهای مبهم
نام کلاسها کافی نیست. هر کلاس باید تعریف و مثال داشته باشد.
استفاده از داده تکراری
تکرار میان Train و Test نتیجه ارزیابی را غیرواقعی میکند.
تقسیم تصادفی داده وابسته
پیامهای یک مکالمه یا تصاویر یک محصول باید گروهی تقسیم شوند.
استفاده از Test برای تنظیم مدل
Test باید برای ارزیابی نهایی حفظ شود.
اعتماد کامل به برچسب مدل
خروجی مدل زبانی ممکن است اشتباه یا ناپایدار باشد و به کنترل نیاز دارد.
تمرکز فقط بر تعداد نمونهها
هزار نمونه دقیق میتواند از تعداد زیادی نمونه ناسازگار مفیدتر باشد.
نداشتن نسخهبندی
بدون نسخه مشخص نمیتوان نتیجه آزمایش را بازتولید کرد.
پاکسازی بیشازحد متن فارسی
حذف علائم، فاصلهها یا شکلهای محاورهای ممکن است اطلاعات مفید را از بین ببرد.
ارزیابی فقط با Accuracy
در داده نامتوازن باید معیار هر کلاس و Confusion Matrix نیز بررسی شود.
مسیر پیشنهادی برای ساخت اولین دیتاست
مرحله اول: یک کاربرد محدود انتخاب کنید
برای مثال، دستهبندی پنج نوع پیام پشتیبانی.
مرحله دوم: Schema و راهنمای برچسبگذاری بسازید
پیش از برچسبگذاری گسترده، تعریف کلاسها را آزمایش کنید.
مرحله سوم: یک نمونه کوچک واقعی جمعآوری کنید
ابتدا با مجموعه محدود شروع کنید و موارد مبهم را پیدا کنید.
مرحله چهارم: دو برچسبزن را روی بخشی از داده آزمایش کنید
اختلاف آنها نقاط ضعف راهنما را آشکار میکند.
مرحله پنجم: Baseline بسازید
مدل سادهای مانند TF-IDF و Logistic Regression میتواند کیفیت اولیه داده را نشان دهد.
مرحله ششم: خطاها را تحلیل کنید
بررسی کنید مدل کدام کلاسها و عبارتها را اشتباه میگیرد.
مرحله هفتم: داده هدفمند اضافه کنید
بهجای جمعآوری تصادفی، برای خطاهای مهم و کلاسهای ضعیف نمونه جمع کنید.
مرحله هشتم: نسخه پایدار منتشر کنید
Train، Validation، Test و Dataset Card را کنار هم نگهداری کنید.
مرحله نهم: مدلهای مختلف را مقایسه کنید
میتوانید مدلهای مختلف را از طریق API درواره روی Test Set ثابت اجرا و کیفیت، سرعت و هزینه آنها را مقایسه کنید.
استفاده از API درواره برای ارزیابی چند مدل
یکی از مزایای API چندمدلی این است که میتوان یک دیتاست ارزیابی ثابت را روی چند مدل اجرا کرد.
ساختار پیشنهادی:
دیتاست آزمون
  ↓
Runner ارزیابی
  ↓
API درواره
  ↓
مدل A / مدل B / مدل C
  ↓
اعتبارسنجی خروجی
  ↓
محاسبه کیفیت، هزینه و تأخیر
  ↓
گزارش مقایسه
برای هر اجرا ثبت کنید:
- شناسه مدل
- نسخه پرامپت
- نسخه دیتاست
- Temperature
- پاسخ خام
- پاسخ پردازششده
- تعداد خطا
- زمان پاسخ
- میزان مصرف
- نتیجه معیارها
این اطلاعات کمک میکند انتخاب مدل بر اساس داده واقعی محصول انجام شود، نه صرفاً شهرت یا اندازه مدل.
پرسشهای متداول
دیتاست چیست؟
دیتاست مجموعهای سازمانیافته از نمونههای داده است که برای تحلیل، آموزش یا ارزیابی سیستمهای نرمافزاری و هوش مصنوعی استفاده میشود.
Dataset فارسی چیست؟
دیتاست فارسی مجموعهای از متن، صوت، تصویر یا دادههای مرتبط با زبان و کاربران فارسیزبان است که میتواند برای آموزش یا ارزیابی مدل استفاده شود.
دیتاست از کجا دانلود کنیم؟
منابعی مانند Hugging Face Hub، Kaggle، UCI و سامانههای داده باز مجموعهدادههای مختلفی ارائه میکنند. پیش از استفاده، کیفیت، مجوز و تناسب داده با مسئله را بررسی کنید.
آیا میتوان با ChatGPT یا مدل زبانی دیتاست ساخت؟
مدل زبانی میتواند در تولید نمونه، بازنویسی و پیشنهاد برچسب کمک کند، اما داده تولیدشده باید اعتبارسنجی و روی داده واقعی ارزیابی شود.
برای آموزش مدل چند نمونه لازم است؟
عدد ثابتی وجود ندارد. تعداد نمونه به پیچیدگی مسئله، تعداد کلاسها، مدل، تنوع داده و کیفیت موردنیاز بستگی دارد.
Train و Test چه تفاوتی دارند؟
Train برای یادگیری مدل و Test برای سنجش نهایی عملکرد روی داده دیدهنشده استفاده میشود.
Validation Set چه کاربردی دارد؟
Validation برای انتخاب مدل، تنظیم پارامترها، مقایسه پرامپتها و تصمیمهای توسعه استفاده میشود.
Data Leakage چیست؟
Data Leakage ورود اطلاعات مجموعه آزمون یا آینده به فرایند آموزش است که باعث ارزیابی غیرواقعی میشود.
آیا دیتاست باید متوازن باشد؟
نه لزوماً. توزیع Train و Test باید آگاهانه انتخاب شود. Test معمولاً باید کاربرد واقعی را نمایندگی کند.
بهترین فرمت دیتاست چیست؟
به کاربرد بستگی دارد. CSV برای داده جدولی ساده، JSONL برای نمونههای متنی و مکالمهای و Parquet برای دادههای حجیم و تحلیلی مناسب است.
آیا داده RAG همان دیتاست آموزش است؟
خیر. داده RAG برای بازیابی و قراردادن اطلاعات در Context استفاده میشود، درحالیکه دیتاست آموزش برای تغییر پارامترها یا رفتار مدل به کار میرود.
چگونه کیفیت دیتاست را ارزیابی کنیم؟
با بررسی Schema، تکرار، مقدار گمشده، تعارض برچسب، توافق برچسبزنها، توزیع کلاسها، Leakage و عملکرد مدل پایه.
جمعبندی
دیتاست فقط یک فایل CSV یا مجموعهای از نمونهها نیست. یک دیتاست حرفهای باید هدف، Schema، منبع، راهنمای برچسبگذاری، روش تقسیم، کنترل کیفیت و نسخه مشخص داشته باشد.
برای ساخت دیتاست هوش مصنوعی:
- مسئله را دقیق تعریف کنید.
- واحد نمونه را مشخص کنید.
- Schema طراحی کنید.
- داده مرتبط جمعآوری کنید.
- راهنمای برچسبگذاری بنویسید.
- کیفیت برچسبها را بررسی کنید.
- نمونههای وابسته را گروهی تقسیم کنید.
- از Data Leakage جلوگیری کنید.
- یک Baseline ساده بسازید.
- دیتاست را نسخهبندی و مستند کنید.
- خطاهای مدل را به داده جدید تبدیل کنید.
- کیفیت را روی Test Set مستقل بسنجید.
برای برچسبگذاری کمکی، تولید نمونه، استخراج ساختاریافته و مقایسه مدلها میتوانید از مستندات API درواره شروع کنید.
درواره با یک API سازگار با OpenAI، پرداخت ریالی و دسترسی یکپارچه به مدلهای مختلف، امکان آزمایش چند مدل روی دیتاست واقعی و انتخاب گزینه مناسب از نظر کیفیت، سرعت و هزینه را فراهم میکند.
مقالات مرتبط
- داده مصنوعی در هوش مصنوعی چیست؟
- آموزش Fine-tuning مدلهای زبانی با LoRA و QLoRA
- ارزیابی مدل هوش مصنوعی و طراحی Evals
- آموزش Pandas برای تحلیل داده با پایتون
- آموزش Hugging Face و Transformers
- تحلیل داده با هوش مصنوعی
- Embedding چیست و چه کاربردی دارد؟
- راهنمای API سازگار با OpenAI
منابع
- Scikit-learn: train_test_split
- Scikit-learn: Cross-validation
- Hugging Face Datasets
- Hugging Face: Loading Datasets
- TensorFlow Data Validation
- DVC: Data Version Control
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.