یادگیری تقویتی چیست؟ آموزش Reinforcement Learning، الگوریتم Q-Learning و RLHF
یادگیری تقویتی روشی در هوش مصنوعی است که در آن یک عامل با آزمونوخطا، دریافت پاداش و تعامل با محیط یاد میگیرد چه تصمیمی بگیرد. در این راهنمای جامع با مفاهیم Agent، State، Action، Reward، الگوریتم Q-Learning، یادگیری تقویتی عمیق، PPO، RLHF و یک پروژه عملی Python آشنا میشوید.
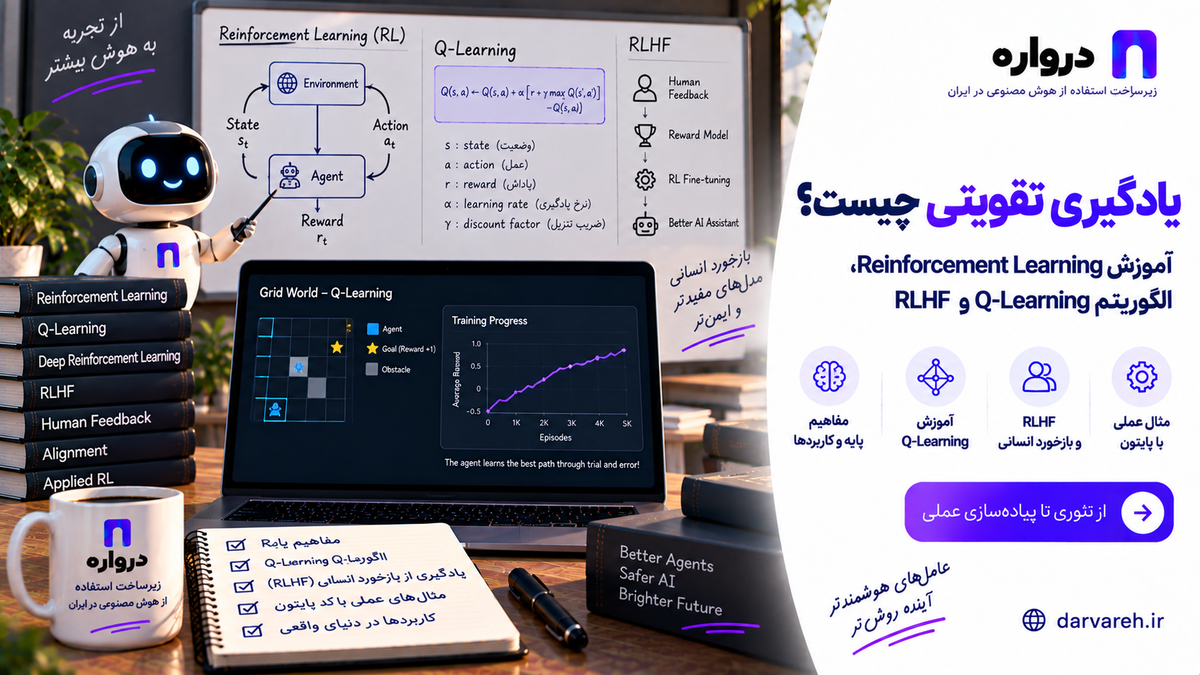
یادگیری تقویتی یا Reinforcement Learning یکی از شاخههای مهم یادگیری ماشین است که در آن یک عامل هوشمند با تعامل با محیط، انجام اقدام و دریافت پاداش یاد میگیرد چگونه تصمیمهای بهتری بگیرد.
برخلاف یادگیری نظارتشده که برای هر ورودی پاسخ صحیح مشخصی دارد، در یادگیری تقویتی معمولاً پاسخ درست هر مرحله مستقیماً در اختیار مدل قرار نمیگیرد. عامل باید با آزمونوخطا کشف کند کدام مجموعه اقدامات در بلندمدت پاداش بیشتری ایجاد میکند.
این روش در حوزههای مختلفی استفاده میشود:
- بازیهای رایانهای
- رباتیک
- کنترل صنعتی
- مدیریت انرژی
- زمانبندی منابع
- مسیریابی
- سیستمهای پیشنهاددهنده
- بهینهسازی تبلیغات
- تصمیمگیری خودکار
- آموزش مدلهای زبانی
- بهبود رفتار AI Agentها
در این مقاله، یادگیری تقویتی را از مفاهیم پایه تا الگوریتم Q-Learning، Deep Q-Network، Policy Gradient، PPO و RLHF بررسی میکنیم. سپس یک عامل واقعی را با Python آموزش میدهیم و نشان میدهیم API مدلهای زبانی چگونه میتواند در ساخت Reward Model و ارزیابی Agent استفاده شود.
یادگیری تقویتی چیست؟
یادگیری تقویتی روشی برای یادگیری تصمیمگیری متوالی است. در این روش یک Agent با Environment تعامل میکند.
چرخه اصلی چنین است:
- عامل وضعیت فعلی محیط را مشاهده میکند.
- یک اقدام انتخاب میکند.
- محیط بر اساس آن اقدام تغییر میکند.
- عامل یک پاداش دریافت میکند.
- عامل از نتیجه تجربه قبلی یاد میگیرد.
- این فرایند تا پایان Episode ادامه پیدا میکند.
هدف عامل فقط دریافت بیشترین پاداش فوری نیست؛ بلکه باید مجموع پاداشهای آینده را نیز در نظر بگیرد.
برای مثال، یک ربات ممکن است برای رسیدن سریعتر به مقصد از مسیری خطرناک عبور کند و پاداش کوتاهمدت بگیرد، اما احتمال سقوط آن افزایش پیدا کند. یک سیاست بهتر باید نتیجه بلندمدت اقدامات را بسنجد.
تفاوت یادگیری تقویتی با یادگیری نظارتشده
| ویژگی | یادگیری نظارتشده | یادگیری تقویتی |
|---|---|---|
| نوع داده | ورودی همراه با پاسخ صحیح | تجربه تعامل با محیط |
| بازخورد | Label مستقیم | Reward یا Penalty |
| نوع مسئله | پیشبینی و طبقهبندی | تصمیمگیری متوالی |
| ترتیب اقدامات | معمولاً مستقل | اقدامات روی آینده اثر دارند |
| جمعآوری داده | دیتاست از قبل آماده | عامل هنگام تعامل تجربه تولید میکند |
| چالش اصلی | تعمیم به داده جدید | اکتشاف، پاداش تأخیری و پایداری |
| نمونه | تشخیص نوع تصویر | کنترل ربات یا انجام بازی |
در یادگیری نظارتشده ممکن است مدل برای هر تصویر برچسب «گربه» یا «سگ» دریافت کند. در یادگیری تقویتی، عامل فقط نتیجه اقدام خود را میبیند و باید رفتار مناسب را کشف کند.
اجزای اصلی یادگیری تقویتی
عامل یا Agent
عامل موجودیتی است که تصمیم میگیرد. عامل میتواند یک الگوریتم، ربات، نرمافزار، مدل زبانی یا سیستم کنترل باشد.
محیط یا Environment
محیط فضایی است که عامل در آن فعالیت میکند. محیط وضعیت را در اختیار عامل قرار میدهد و نتیجه اقدام را محاسبه میکند.
وضعیت یا State
State نمایش اطلاعات فعلی محیط است.
در یک بازی، وضعیت میتواند شامل موقعیت بازیکن، دشمنان، امتیاز و منابع باقیمانده باشد.
در یک سامانه پشتیبانی، وضعیت ممکن است شامل این موارد باشد:
- موضوع درخواست
- وضعیت احراز هویت
- اقدامات قبلی
- نتیجه فراخوانی ابزارها
- میزان اطمینان پاسخ
- مرحله فعلی پرونده
مشاهده یا Observation
در بعضی محیطها عامل به وضعیت کامل دسترسی ندارد و فقط بخشی از آن را مشاهده میکند. این اطلاعات Observation نام دارد.
برای مثال، ربات ممکن است فقط اطلاعات دوربین و حسگرهای خود را ببیند و از وضعیت کامل محیط آگاه نباشد.
اقدام یا Action
Action تصمیمی است که عامل در هر مرحله میگیرد.
فضای اقدام ممکن است گسسته باشد:
- حرکت به چپ
- حرکت به راست
- توقف
یا پیوسته باشد:
- زاویه فرمان
- میزان گاز
- قدرت موتور
پاداش یا Reward
Reward عددی است که مطلوب یا نامطلوببودن نتیجه اقدام را نشان میدهد.
نمونه:
- رسیدن به هدف:
+100 - برخورد با مانع:
-50 - هر مرحله اضافی:
-1 - انجام موفق عملیات:
+20 - فراخوانی ابزار غیرضروری:
-2
سیاست یا Policy
Policy مشخص میکند عامل در هر وضعیت چه اقدامی انجام دهد.
بهصورت ریاضی:
π(a∣s)\pi(a \mid s)
یعنی احتمال انتخاب اقدام aa در وضعیت ss.
سیاست میتواند قطعی باشد یا برای هر اقدام یک احتمال تعریف کند.
Episode
یک Episode توالی کامل تعامل از نقطه شروع تا پایان است.
برای مثال:
- شروع تا پایان یک بازی
- شروع حرکت ربات تا رسیدن به مقصد
- دریافت درخواست مشتری تا حل یا ارجاع پرونده
- آغاز سفارش تا تکمیل فرایند
Return
Return مجموع پاداشهای آینده است:
Gt=Rt+1+γRt+2+γ2Rt+3+…G_t = R_{t+1} + \gamma R_{t+2} + \gamma^2 R_{t+3} + \dots
در این رابطه، γ\gamma ضریب تنزیل است.
ضریب تنزیل یا Discount Factor چیست؟
ضریب تنزیل که با γ\gamma نمایش داده میشود، مشخص میکند عامل تا چه اندازه به پاداشهای آینده اهمیت دهد.
مقدار آن معمولاً میان صفر و یک است.
اگر Gamma نزدیک صفر باشد
عامل بیشتر به پاداش فوری اهمیت میدهد.
اگر Gamma نزدیک یک باشد
عامل پاداشهای بلندمدت را جدیتر در نظر میگیرد.
برای مثال، اگر عامل میان دریافت یک پاداش کوچک در همین لحظه و پاداش بزرگتری در آینده انتخاب کند، مقدار Gamma بر تصمیم آن اثر دارد.
Gamma بسیار بالا همیشه بهتر نیست. افق زمانی مسئله، پایداری محاسبات و نوع محیط باید در انتخاب آن در نظر گرفته شوند.
فرایند تصمیمگیری مارکوف چیست؟
بسیاری از مسائل یادگیری تقویتی با چارچوب Markov Decision Process یا MDP مدلسازی میشوند.
یک MDP معمولاً شامل این اجزاست:
(S,A,P,R,γ)(S, A, P, R, \gamma)
که در آن:
- SS: مجموعه وضعیتها
- AA: مجموعه اقدامها
- PP: احتمال انتقال میان وضعیتها
- RR: تابع پاداش
- γ\gamma: ضریب تنزیل
خاصیت مارکوف به این معناست که اگر State بهدرستی تعریف شده باشد، وضعیت آینده با دانستن وضعیت فعلی و اقدام قابل مدلسازی است و به کل تاریخچه وابسته نیست.
در مسائل واقعی، ساخت State مناسب یکی از دشوارترین بخشهای طراحی سیستم است.
تابع ارزش چیست؟
تابع ارزش نشان میدهد قرارگرفتن در یک وضعیت، با فرض ادامه یک سیاست مشخص، در بلندمدت چقدر ارزش دارد.
State Value
Vπ(s)=Eπ[Gt∣St=s]V^\pi(s) = \mathbb{E}_\pi \left[ G_t \mid S_t=s \right]
این تابع Return موردانتظار از وضعیت ss را تحت سیاست π\pi نشان میدهد.
Action Value
Qπ(s,a)=Eπ[Gt∣St=s,At=a]Q^\pi(s,a) = \mathbb{E}_\pi \left[ G_t \mid S_t=s, A_t=a \right]
تابع Q نشان میدهد انجام اقدام aa در وضعیت ss و ادامه سیاست چقدر ارزش دارد.
معادله بلمن چیست؟
معادله Bellman ارزش یک وضعیت را به پاداش فوری و ارزش وضعیت بعدی مرتبط میکند.
برای تابع Q بهینه میتوان نوشت:
Q∗(s,a)=E[r+γmaxa′Q∗(s′,a′)]Q^*(s,a) = \mathbb{E} \left[ r + \gamma \max_{a'} Q^*(s',a') \right]
مفهوم آن ساده است:
ارزش یک اقدام برابر است با پاداش فعلی بهعلاوه بهترین ارزش قابلدستیابی از وضعیت بعدی.
بسیاری از الگوریتمهای یادگیری تقویتی بر اساس همین رابطه یا شکلهای دیگر آن ساخته شدهاند.
Exploration و Exploitation چیست؟
عامل با یک مسئله اساسی روبهرو است:
- آیا از بهترین اقدام شناختهشده استفاده کند؟
- یا اقدام دیگری را آزمایش کند که شاید نتیجه بهتری داشته باشد؟
Exploitation
استفاده از دانشی که عامل تا این لحظه یاد گرفته است.
Exploration
آزمایش اقدامات جدید برای کشف فرصتهای بهتر.
اگر عامل فقط Exploitation انجام دهد، ممکن است خیلی زود در یک سیاست ضعیف گیر کند. اگر فقط Exploration انجام دهد، از آموختههای خود استفاده نمیکند.
روش Epsilon-Greedy
یکی از روشهای ساده ایجاد تعادل میان اکتشاف و بهرهبرداری، Epsilon-Greedy است.
در هر مرحله:
- با احتمال ϵ\epsilon، یک اقدام تصادفی انتخاب میشود.
- با احتمال 1−ϵ1-\epsilon، بهترین اقدام فعلی انتخاب میشود.
معمولاً Epsilon در ابتدای آموزش مقدار بیشتری دارد و بهتدریج کاهش پیدا میکند.
import random
import numpy as np


def choose_action(
    q_table: np.ndarray,
    state: int,
    epsilon: float,
) -> int:
    if random.random() < epsilon:
        return random.randrange(
            q_table.shape[1]
        )

    return int(
        np.argmax(q_table[state])
    )
Q-Learning چیست؟
Q-Learning یک الگوریتم Model-free و Off-policy برای یادگیری ارزش اقدامهاست.
Model-free یعنی عامل برای یادگیری به مدل صریحی از قوانین انتقال محیط نیاز ندارد. عامل با مشاهده تجربهها مقدارهای Q را بهروزرسانی میکند.
قانون بهروزرسانی Q-Learning:
Q(s,a)←Q(s,a)+α[r+γmaxa′Q(s′,a′)−Q(s,a)]Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r + \gamma \max_{a'} Q(s',a') - Q(s,a) \right]
اجزای این رابطه:
- Q(s,a)Q(s,a): مقدار فعلی
- α\alpha: نرخ یادگیری
- rr: پاداش
- γ\gamma: ضریب تنزیل
- s′s': وضعیت بعدی
- maxQ(s′,a′)\max Q(s',a'): بهترین ارزش تخمینی در وضعیت بعدی
عبارت داخل براکت TD Error نام دارد:
δ=r+γmaxa′Q(s′,a′)−Q(s,a)\delta = r + \gamma \max_{a'} Q(s',a') - Q(s,a)
عامل مقدار قبلی را بهاندازهای متناسب با این خطا اصلاح میکند.
چرا Q-Learning را Off-policy مینامند؟
رفتار عامل هنگام جمعآوری تجربه ممکن است Epsilon-Greedy باشد، اما در هدف بهروزرسانی از بهترین اقدام احتمالی وضعیت بعدی استفاده میشود:
maxa′Q(s′,a′)\max_{a'} Q(s',a')
یعنی سیاست رفتاری و سیاست هدف میتوانند متفاوت باشند.
در مقابل، الگوریتم SARSA مقدار اقدامی را استفاده میکند که سیاست واقعاً در مرحله بعد انتخاب کرده است.
تفاوت Q-Learning و SARSA
| ویژگی | Q-Learning | SARSA |
|---|---|---|
| نوع | Off-policy | On-policy |
| هدف بهروزرسانی | بهترین اقدام احتمالی | اقدام انتخابشده توسط سیاست |
| رفتار | ممکن است خوشبینانهتر باشد | رفتار واقعی سیاست را یاد میگیرد |
| رابطه | max Q(s', a') | Q(s', a') |
| حساسیت به Exploration | کمتر در هدف | Exploration بخشی از هدف است |
رابطه SARSA:
Q(s,a)←Q(s,a)+α[r+γQ(s′,a′)−Q(s,a)]Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r + \gamma Q(s',a') - Q(s,a) \right]
نام SARSA از توالی زیر ساخته شده است:
State,Action,Reward,State,ActionState, Action, Reward, State, Action
مثال عملی: آموزش عامل در FrozenLake
در محیط FrozenLake، عامل باید از نقطه شروع به هدف برسد، بدون اینکه داخل حفرهها بیفتد.
این محیط دارای فضای وضعیت و اقدام گسسته است و برای آموزش Q-Learning جدولی مناسب است. مستندات Gymnasium محیط استاندارد FrozenLake و آموزش Tabular Q-Learning را ارائه میکند.
نصب کتابخانهها
pip install gymnasium numpy
ساخت محیط
import gymnasium as gym


env = gym.make(
    "FrozenLake-v1",
    map_name="4x4",
    is_slippery=True,
)

print(
    "States:",
    env.observation_space.n,
)

print(
    "Actions:",
    env.action_space.n,
)
در نسخه استاندارد ۴×۴:
- فضای مشاهده ۱۶ وضعیت دارد.
- فضای اقدام شامل چهار جهت است.
- لغزندهبودن محیط باعث میشود نتیجه اقدام همیشه قطعی نباشد.
مستندات رسمی Gymnasium فضای اقدام این محیط را Discrete(4) و فضای مشاهده را Discrete(16) تعریف میکند.
پیادهسازی کامل Q-Learning با Python
import random

import gymnasium as gym
import numpy as np


SEED = 42
EPISODES = 20_000
MAX_STEPS = 100

LEARNING_RATE = 0.8
DISCOUNT_FACTOR = 0.95

EPSILON_START = 1.0
EPSILON_MIN = 0.05
EPSILON_DECAY = 0.9997


random.seed(SEED)
np.random.seed(SEED)

env = gym.make(
    "FrozenLake-v1",
    map_name="4x4",
    is_slippery=True,
)

state_count = env.observation_space.n
action_count = env.action_space.n

q_table = np.zeros(
    (state_count, action_count),
    dtype=np.float32,
)

epsilon = EPSILON_START
episode_rewards = []


for episode in range(EPISODES):
    state, info = env.reset(
        seed=SEED + episode
    )

    total_reward = 0.0

    for step in range(MAX_STEPS):
        if random.random() < epsilon:
            action = env.action_space.sample()
        else:
            action = int(
                np.argmax(q_table[state])
            )

        (
            next_state,
            reward,
            terminated,
            truncated,
            info,
        ) = env.step(action)

        done = terminated or truncated

        next_best_q = 0.0

        if not done:
            next_best_q = float(
                np.max(q_table[next_state])
            )

        td_target = (
            reward
            + DISCOUNT_FACTOR * next_best_q
        )

        td_error = (
            td_target
            - q_table[state, action]
        )

        q_table[state, action] += (
            LEARNING_RATE * td_error
        )

        state = next_state
        total_reward += reward

        if done:
            break

    epsilon = max(
        EPSILON_MIN,
        epsilon * EPSILON_DECAY,
    )

    episode_rewards.append(total_reward)


env.close()

print("Q-table:")
print(q_table)

print(
    "Success rate in last 1000 episodes:",
    np.mean(episode_rewards[-1000:]),
)
این کد یک Q-Table با ابعاد تعداد وضعیتها در تعداد اقدامها میسازد. عامل پس از هر تجربه مقدار مربوط به وضعیت و اقدام را اصلاح میکند.
ارزیابی عامل آموزشدیده
برای ارزیابی، Exploration را غیرفعال میکنیم و همیشه بهترین اقدام شناختهشده را انتخاب میکنیم:
import gymnasium as gym
import numpy as np


evaluation_env = gym.make(
    "FrozenLake-v1",
    map_name="4x4",
    is_slippery=True,
)

EVALUATION_EPISODES = 1000
successes = 0


for episode in range(EVALUATION_EPISODES):
    state, info = evaluation_env.reset(
        seed=100_000 + episode
    )

    for step in range(100):
        action = int(
            np.argmax(q_table[state])
        )

        (
            state,
            reward,
            terminated,
            truncated,
            info,
        ) = evaluation_env.step(action)

        if terminated or truncated:
            successes += int(reward > 0)
            break


evaluation_env.close()

success_rate = (
    successes / EVALUATION_EPISODES
)

print(
    f"Success rate: {success_rate:.2%}"
)
در محیطهای تصادفی، یک بار اجرا برای نتیجهگیری کافی نیست. بهتر است آموزش با Seedهای مختلف تکرار و میانگین و پراکندگی نتایج گزارش شود.
راهنمای Stable-Baselines3 نیز تأکید میکند که نتیجه یادگیری تقویتی میتواند با تغییر Seed متفاوت باشد و ارزیابی کمی باید بر اساس چند اجرا انجام شود.
محدودیت Q-Table
Q-Learning جدولی زمانی مناسب است که تعداد وضعیتها و اقدامها محدود باشد.
فرض کنید محیط دارای:
- یک میلیون وضعیت
- هزار اقدام
باشد. Q-Table به یک میلیارد مقدار نیاز خواهد داشت.
در مسائلی مانند پردازش تصویر، وضعیت میتواند شامل میلیونها ترکیب ممکن باشد. ذخیره مقدار جداگانه برای تمام Stateها عملی نیست.
در این شرایط از تقریبزننده تابع مانند شبکه عصبی استفاده میشود.
یادگیری تقویتی عمیق چیست؟
Deep Reinforcement Learning ترکیبی از یادگیری تقویتی و شبکههای عصبی عمیق است.
در این روش، شبکه عصبی میتواند یکی از موارد زیر را تقریب بزند:
- تابع ارزش
- تابع Q
- Policy
- مدل محیط
- Reward Model
این روش برای ورودیهای پیچیده مانند تصویر، صوت یا Stateهای بزرگ مناسبتر است.
DQN چیست؟
Deep Q-Network یا DQN از یک شبکه عصبی برای تخمین مقدار Q استفاده میکند.
ورودی شبکه:
ss
خروجی شبکه:
Q(s,a1),Q(s,a2),…,Q(s,an)Q(s,a_1), Q(s,a_2), \dots, Q(s,a_n)
DQN معمولاً از دو تکنیک مهم استفاده میکند:
Experience Replay
تجربهها در یک Replay Buffer ذخیره میشوند:
(s,a,r,s′,done)(s, a, r, s', done)
سپس Batchهای تصادفی از این حافظه برای آموزش شبکه انتخاب میشوند. این کار وابستگی شدید نمونههای متوالی را کاهش میدهد.
Target Network
یک شبکه جداگانه برای محاسبه هدف استفاده میشود و وزنهای آن با فاصله زمانی از شبکه اصلی بهروزرسانی میشوند. این روش به پایداری آموزش کمک میکند.
پژوهش اولیه DQN نشان داد یک شبکه کانولوشنی میتواند با استفاده از نسخهای از Q-Learning، سیاست کنترل را مستقیماً از پیکسل بازیهای Atari یاد بگیرد.
الگوریتمهای مهم یادگیری تقویتی
Value-based
این روشها ارزش اقدامها یا وضعیتها را یاد میگیرند.
نمونهها:
- Q-Learning
- SARSA
- DQN
- Double DQN
- Dueling DQN
Policy-based
در این روشها Policy مستقیماً بهینه میشود.
نمونهها:
- REINFORCE
- Policy Gradient
Actor-Critic
این معماری دو بخش دارد:
- Actor اقدام را انتخاب میکند.
- Critic ارزش یا کیفیت تصمیم را ارزیابی میکند.
نمونهها:
- A2C
- A3C
- PPO
- DDPG
- TD3
- SAC
Model-based
عامل مدلی از محیط یاد میگیرد یا از مدل محیط برای برنامهریزی استفاده میکند.
Offline Reinforcement Learning
عامل از مجموعه تجربههای از قبل جمعآوریشده یاد میگیرد و هنگام آموزش مستقیماً با محیط تعامل نمیکند.
انتخاب الگوریتم بر اساس فضای اقدام
| نوع مسئله | الگوریتمهای قابل بررسی |
|---|---|
| وضعیت و اقدام کوچک و گسسته | Q-Learning، SARSA |
| مشاهده بزرگ و اقدام گسسته | DQN و انواع آن |
| اقدام پیوسته | SAC، TD3، PPO |
| سیاست تصادفی | Policy Gradient، Actor-Critic |
| داده از قبل جمعآوریشده | Offline RL |
| کنترل نسبتاً عمومی | PPO |
| محیط چندعاملی | Multi-Agent RL |
این جدول نقطه شروع است و تضمین نمیکند یک الگوریتم برای هر محیط از همان نوع بهترین باشد.
مستندات Stable-Baselines3 جدولی از الگوریتمها و پشتیبانی آنها از فضاهای اقدام گسسته، پیوسته و پردازش موازی ارائه میکند.
PPO چیست؟
PPO مخفف Proximal Policy Optimization است. این الگوریتم از خانواده Policy Gradient و Actor-Critic محسوب میشود.
ایده اصلی PPO این است که هنگام بهروزرسانی، Policy جدید بیشازحد از Policy قبلی فاصله نگیرد. تغییر بسیار بزرگ ممکن است رفتار عامل را ناگهان خراب کند.
PPO از یک هدف Clipped استفاده میکند:
LCLIP(θ)=E[min(rt(θ)A^t,clip(rt(θ),1−ϵ,1+ϵ)A^t)]L^{CLIP}(\theta) = \mathbb{E} \left[ \min \left( r_t(\theta)\hat{A}_t, \operatorname{clip} (r_t(\theta),1-\epsilon,1+\epsilon) \hat{A}_t \right) \right]
که در آن:
- rt(θ)r_t(\theta) نسبت احتمال Policy جدید به قدیم است.
- A^t\hat{A}_t تخمین Advantage است.
- ϵ\epsilon محدوده تغییر را کنترل میکند.
مستندات Stable-Baselines3 توضیح میدهد که PPO از Clipping برای جلوگیری از بهروزرسانی بسیار بزرگ Policy استفاده میکند.
آموزش عامل با Stable-Baselines3
نصب:
pip install "stable-baselines3[extra]" gymnasium
نمونه آموزش PPO روی CartPole:
import gymnasium as gym
from stable_baselines3 import PPO
from stable_baselines3.common.evaluation import (
    evaluate_policy,
)
from stable_baselines3.common.monitor import Monitor


train_env = Monitor(
    gym.make("CartPole-v1")
)

model = PPO(
    policy="MlpPolicy",
    env=train_env,
    learning_rate=3e-4,
    n_steps=2048,
    batch_size=64,
    gamma=0.99,
    verbose=1,
    seed=42,
)

model.learn(
    total_timesteps=100_000
)

model.save("ppo_cartpole")

evaluation_env = Monitor(
    gym.make("CartPole-v1")
)

mean_reward, std_reward = evaluate_policy(
    model,
    evaluation_env,
    n_eval_episodes=20,
    deterministic=True,
)

print(
    f"Mean reward: {mean_reward:.2f}"
)

print(
    f"Reward std: {std_reward:.2f}"
)

train_env.close()
evaluation_env.close()
پارامترهای پیشفرض برای تمام محیطها مناسب نیستند. تعداد Step، نرخ یادگیری، ساختار شبکه و Reward باید بر اساس مسئله ارزیابی شوند.
Reward Shaping چیست؟
Reward Shaping به معنای طراحی پاداشهای میانی برای هدایت بهتر عامل است.
فرض کنید ربات فقط هنگام رسیدن به مقصد پاداش +100 دریافت کند. اگر محیط بزرگ باشد، ممکن است مدت زیادی هیچ پاداشی نبیند.
میتوان پاداشهای کمکی تعریف کرد:
- نزدیکشدن به مقصد: پاداش مثبت
- دورشدن: پاداش منفی
- برخورد: جریمه
- هر قدم اضافی: جریمه کوچک
اما Reward Shaping خطرناک است. عامل ممکن است راهی برای بیشینهکردن عدد پاداش پیدا کند که با هدف واقعی سیستم یکسان نباشد.
Reward Hacking چیست؟
Reward Hacking زمانی رخ میدهد که عامل از نقص تابع پاداش استفاده میکند.
برای مثال، اگر به یک ربات نظافتگر بابت تعداد دفعات جمعآوری زباله پاداش دهیم، ممکن است زباله را رها و دوباره جمع کند تا پاداش بیشتری بگیرد.
در سامانه پشتیبانی، اگر فقط «بستهشدن سریع تیکت» پاداش داشته باشد، Agent ممکن است پروندهها را بدون حل واقعی ببندد.
راهکارهای کاهش این مشکل:
- تعریف چند معیار
- استفاده از قیدهای سخت
- بررسی نتیجه واقعی
- ارزیابی انسانی
- تست رفتارهای مرزی
- ثبت اقدامات
- محدودکردن فضای Action
- جداکردن معیار موفقیت از معیار ظاهری
Sparse Reward چیست؟
در محیط Sparse Reward، عامل بهندرت پاداش دریافت میکند.
برای مثال، در یک بازی پیچیده ممکن است فقط پس از تکمیل مأموریت پاداش داده شود. عامل باید زنجیرهای طولانی از اقدامات صحیح را بهطور تصادفی کشف کند.
راهکارهای قابل بررسی:
- Reward Shaping
- Curriculum Learning
- Demonstration
- Imitation Learning
- Hierarchical RL
- Intrinsic Motivation
- تجربههای انسانی
- برنامهریزی مبتنی بر مدل
تفاوت Reinforcement Learning و Imitation Learning
در Imitation Learning، عامل رفتار متخصص را از نمونه اقدامات او یاد میگیرد.
در Reinforcement Learning، عامل رفتار را بر اساس Reward کشف میکند.
این دو روش قابل ترکیباند:
- عامل ابتدا از Demonstration انسانی یاد میگیرد.
- سپس با Reinforcement Learning رفتار خود را بهبود میدهد.
یادگیری تقویتی در مدلهای زبانی
مدل زبانی در مرحله Pretraining معمولاً با پیشبینی توکن بعدی آموزش داده میشود. اما پیشبینی توکن بهتنهایی تضمین نمیکند مدل:
- دستور کاربر را دقیق دنبال کند.
- پاسخ مفید تولید کند.
- قالب موردنظر را رعایت کند.
- پاسخهای ترجیحدادهشده توسط انسان را انتخاب کند.
برای بهبود رفتار مدل از روشهای Post-training استفاده میشود. یکی از این روشها RLHF است.
RLHF چیست؟
RLHF مخفف Reinforcement Learning from Human Feedback و به معنای یادگیری تقویتی از بازخورد انسانی است.
یک Pipeline متداول RLHF شامل مراحل زیر است:
مرحله اول: Supervised Fine-tuning
مدل پایه با نمونههای پاسخ مطلوب Fine-tune میشود.
مرحله دوم: جمعآوری Preference
برای هر Prompt چند پاسخ تولید میشود و ارزیاب انسانی آنها را رتبهبندی میکند.
مرحله سوم: آموزش Reward Model
Reward Model یاد میگیرد کدام پاسخ ترجیح داده میشود.
مرحله چهارم: بهینهسازی Policy
مدل با الگوریتمی مانند PPO برای افزایش امتیاز Reward Model بهینه میشود، درحالیکه معمولاً از فاصلهگرفتن بیشازحد از مدل مرجع جلوگیری میشود.
پژوهش InstructGPT از Demonstrationهای انسانی برای Supervised Fine-tuning، رتبهبندی خروجیها برای ساخت مدل ترجیح و سپس یادگیری تقویتی از بازخورد انسانی استفاده کرد.
آیا تمام مدلهای زبانی با RLHF آموزش میبینند؟
خیر. Post-training مدلهای زبانی میتواند از روشهای مختلف استفاده کند:
- Supervised Fine-tuning
- RLHF
- RLAIF
- PPO
- DPO
- GRPO
- Reward Modeling
- Rejection Sampling
- Constitutional Approaches
- ترکیبی از چند روش
جزئیات دقیق آموزش بسیاری از مدلها نیز عمومی نیست. بنابراین نباید بدون منبع رسمی فرض کرد هر مدل مشخص حتماً از RLHF یا الگوریتم خاصی استفاده کرده است.
RLAIF چیست؟
RLAIF مخفف Reinforcement Learning from AI Feedback است.
در این روش، بخشی از ارزیابی یا تولید Preference توسط یک مدل هوش مصنوعی انجام میشود، نه فقط انسان.
مزیت احتمالی:
- مقیاسپذیری بیشتر
- هزینه کمتر ارزیابی
- امکان اعمال معیارهای ساختاریافته
- سرعت بیشتر تولید Preference
محدودیتها:
- انتقال خطا و سوگیری مدل ارزیاب
- ترجیح پاسخهای شبیه به سبک Judge
- امکان بازیدادن Reward Model
- نیاز به نمونههای مرجع انسانی
- وابستگی نتیجه به Prompt ارزیابی
DPO چیست؟
Direct Preference Optimization روشی برای آموزش مستقیم مدل روی جفت پاسخ ترجیحدادهشده و ردشده است.
در DPO الزاماً یک Reward Model جداگانه و حلقه PPO مشابه Pipeline کلاسیک RLHF ساخته نمیشود. به همین دلیل پیادهسازی آن میتواند سادهتر باشد.
بااینحال، DPO همچنان به دیتاست Preference باکیفیت نیاز دارد و جایگزین عمومی تمام روشهای RL نیست.
استفاده از API درواره برای ساخت سیستم ارزیابی
API مدل زبانی میتواند بهعنوان یکی از اجزای Pipeline آزمایش یا تولید Preference استفاده شود.
برای مثال، دو پاسخ توسط دو مدل تولید میشوند و یک مدل Judge آنها را با معیار مشخص مقایسه میکند.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
نصب کتابخانه:
pip install openai pydantic
تنظیم متغیرها:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_JUDGE_MODEL="YOUR_MODEL_ID"
کد ارزیابی:
import os
from typing import Literal
from openai import OpenAI
from pydantic import BaseModel, Field
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
JUDGE_MODEL = os.environ[
"DARVAREH_JUDGE_MODEL"
]
class ComparisonResult(BaseModel):
winner: Literal["A", "B", "tie"]
score_a: float = Field(ge=0, le=10)
score_b: float = Field(ge=0, le=10)
reason: str
def compare_answers(
question: str,
answer_a: str,
answer_b: str,
) -> ComparisonResult:
prompt = f"""
دو پاسخ را برای سؤال زیر ارزیابی کن.
معیارها:
- صحت
- ارتباط با سؤال
- کاملبودن
- وضوح
- رعایت دستور کاربر
قواعد:
- ترتیب پاسخها نباید بر تصمیم اثر بگذارد.
- اگر تفاوت معناداری نیست، winner را tie قرار بده.
- فقط JSON معتبر برگردان.
- score_a و score_b بین صفر تا ده باشند.
ساختار خروجی:
{{
"winner": "A | B | tie",
"score_a": 0,
"score_b": 0,
"reason": "دلیل کوتاه"
}}
سؤال:
{question}
پاسخ A:
{answer_a}
پاسخ B:
{answer_b}
"""
response = client.chat.completions.create(
model=JUDGE_MODEL,
temperature=0,
messages=[
{
"role": "system",
"content": (
"شما ارزیاب بیطرف پاسخهای "
"مدلهای هوش مصنوعی هستید."
),
},
{
"role": "user",
"content": prompt,
},
],
)
content = response.choices[0].message.content
if not content:
raise ValueError(
"مدل ارزیاب پاسخی برنگرداند."
)
return ComparisonResult.model_validate_json(
content
)
result = compare_answers(
question="Q-Learning چیست؟",
answer_a=(
"Q-Learning الگوریتمی برای یادگیری "
"ارزش اقدامها از طریق تعامل با محیط است."
),
answer_b=(
"Q-Learning یک الگوریتم مرتبسازی است."
),
)
print(
result.model_dump_json(indent=2)
)
این مثال یک سیستم RL کامل نیست. خروجی مدل میتواند برای ساخت داده Preference، ارزیابی اولیه یا یکی از سیگنالهای Reward استفاده شود.
چگونه سوگیری LLM-as-a-Judge را کاهش دهیم؟
مدل Judge ممکن است تحت تأثیر ترتیب، طول یا سبک پاسخ قرار گیرد.
راهکارهای مناسب:
- جابهجاکردن تصادفی پاسخ A و B
- اجرای ارزیابی در هر دو ترتیب
- استفاده از Rubric دقیق
- جداکردن معیارها
- استفاده از چند Judge
- کالیبراسیون با داده انسانی
- عدم نمایش نام مدل تولیدکننده
- اعتبارسنجی ساختار خروجی
- نگهداری Test Set انسانی
- بررسی نرخ توافق مدل و انسان
نمونه ارزیابی دوطرفه:
- بار اول پاسخ اول بهعنوان A ارسال شود.
- بار دوم همان پاسخ بهعنوان B ارسال شود.
- اگر نتیجه با تغییر ترتیب عوض شد، نمونه برای بازبینی علامتگذاری شود.
کاربرد یادگیری تقویتی در AI Agentها
یک AI Agent میتواند کارهای چندمرحلهای انجام دهد:
- انتخاب ابزار
- جستوجوی اطلاعات
- اجرای عملیات
- بررسی نتیجه
- اصلاح برنامه
- توقف یا ارجاع
میتوان این فرایند را به شکل RL مدل کرد:
| مفهوم RL | نمونه در AI Agent |
|---|---|
| State | وضعیت کار، تاریخچه و نتایج ابزارها |
| Action | پاسخ، فراخوانی ابزار، سؤال یا ارجاع |
| Reward | حل موفق، صحت، هزینه و رضایت |
| Episode | یک پرونده کامل |
| Policy | مدل تصمیمگیر Agent |
| Environment | نرمافزارها، کاربر و ابزارهای سازمان |
اما آموزش مستقیم Agent با RL ساده نیست. Reward باید نتیجه واقعی را نشان دهد، فضای اقدام کنترل شود و عملیات غیرقابلبازگشت تحت قواعد قطعی باقی بمانند.
نمونه طراحی Reward برای Agent پشتیبانی
فرض کنید Agent باید درخواست مشتری را حل کند.
یک Reward فرضی:
R=5C+3V−2T−4E−10UR = 5C + 3V - 2T - 4E - 10U
که در آن:
- CC: پرونده واقعاً حل شده است.
- VV: پاسخ با منبع معتبر تأیید شده است.
- TT: تعداد ابزارهای غیرضروری
- EE: ارجاع نادرست
- UU: اقدام غیرمجاز
در عمل، این تعریف به آزمایش دقیق نیاز دارد. اگر فقط سرعت پاسخ پاداش بگیرد، Agent ممکن است پاسخ سریع اما اشتباه تولید کند.
بهتر است موفقیت بر اساس نتیجه تأییدشده سنجیده شود، نه صرفاً اعلام خود Agent.
کاربردهای یادگیری تقویتی
بازی
عامل با تجربه بازی و دریافت امتیاز، سیاست مناسب را یاد میگیرد.
رباتیک
برای کنترل حرکت، گرفتن اشیا، مسیریابی و هماهنگی مفاصل استفاده میشود.
کنترل صنعتی
تنظیم پارامترهای یک فرایند با توجه به وضعیت تجهیزات و هدف بهرهوری.
مدیریت انرژی
تنظیم مصرف، ذخیرهسازی و توزیع انرژی بر اساس تقاضا و هزینه.
پیشنهاد محتوا
تصمیم فعلی روی رفتار و تعامل آینده کاربر اثر دارد؛ بنابراین مسئله میتواند فراتر از پیشبینی کلیک فوری تعریف شود.
تبلیغات
انتخاب تبلیغ با درنظرگرفتن نتیجه بلندمدت، بودجه و تجربه کاربر.
لجستیک
مسیریابی، زمانبندی و تخصیص منابع در محیط متغیر.
مدلهای زبانی
استفاده از Preference یا Reward برای بهبود رفتار و دنبالکردن دستور.
Agentهای نرمافزاری
بهینهسازی انتخاب ابزار، برنامهریزی و حل وظایف چندمرحلهای.
چالشهای یادگیری تقویتی
نیاز به تجربه زیاد
عامل ممکن است برای یادگیری به تعداد بسیار زیادی تعامل نیاز داشته باشد.
هزینه محیط
اجرای ربات واقعی، عملیات صنعتی یا تعامل انسانی میتواند پرهزینه باشد.
پاداش تأخیری
ممکن است نتیجه یک اقدام پس از دهها مرحله مشخص شود.
پاداش پراکنده
عامل ممکن است مدت زیادی هیچ سیگنال مفیدی دریافت نکند.
ناپایداری آموزش
نتیجه میتواند به Seed، Hyperparameter و جزئیات محیط حساس باشد.
Sim-to-Real Gap
رفتار آموختهشده در شبیهساز ممکن است در دنیای واقعی همان عملکرد را نداشته باشد.
توزیع متغیر
رفتار کاربران، محیط یا ابزارها ممکن است با زمان تغییر کند.
Reward Hacking
عامل میتواند تابع پاداش ناقص را به روشی غیرمنتظره بیشینه کند.
ارزیابی دشوار
یک میانگین Reward بالا الزاماً به معنای رفتار مناسب در تمام شرایط نیست.
چگونه یک پروژه RL را درست ارزیابی کنیم؟
محیط آموزش و ارزیابی را جدا کنید
Agent نباید فقط محیطها یا Seedهای آموزش را حفظ کند.
چند Seed اجرا کنید
میانگین، انحراف معیار و بدترین اجرا را گزارش کنید.
Baseline داشته باشید
عامل را با این گزینهها مقایسه کنید:
- سیاست تصادفی
- قانون دستی
- الگوریتم سادهتر
- نسخه قبلی سیستم
Reward و معیار واقعی را جدا کنید
Reward آموزشی ممکن است جانشین هدف واقعی باشد. هر دو را گزارش کنید.
رفتارهای شکست را بررسی کنید
فقط میانگین موفقیت کافی نیست. سناریوهای ناموفق را دستهبندی کنید.
هزینه را محاسبه کنید
تعداد Step، زمان آموزش، مصرف GPU، فراخوانی محیط و هزینه API را ثبت کنید.
سیاست قطعی و تصادفی را جداگانه بسنجید
رفتار Evaluation باید دقیقاً مستند شود.
اشتباهات رایج در یادگیری تقویتی
شروع با الگوریتم پیچیده
ابتدا یک محیط ساده، سیاست تصادفی و Baseline بسازید.
طراحی Reward مبهم
اگر Reward هدف واقعی را نمایش ندهد، Agent رفتار نامطلوب یاد میگیرد.
ارزیابی با یک Seed
نتیجه یک اجرا ممکن است تصادفی باشد.
استفاده از Test برای تنظیم Hyperparameter
یک مجموعه یا سناریوی مستقل برای ارزیابی نهایی نگه دارید.
نادیدهگرفتن مقیاس Observation و Action
در الگوریتمهای مبتنی بر شبکه عصبی، نرمالسازی میتواند اهمیت زیادی داشته باشد.
تغییر همزمان چند عامل
اگر محیط، Reward، مدل و Hyperparameter همزمان تغییر کنند، علت نتیجه قابلتشخیص نیست.
مقایسه ناعادلانه الگوریتمها
بودجه تعامل، زمان آموزش و تعداد اجرای الگوریتمها باید قابلمقایسه باشد.
فرضکردن اینکه RL برای هر مسئله لازم است
بسیاری از مسائل با قانون، یادگیری نظارتشده، بهینهسازی یا Contextual Bandit سادهتر حل میشوند.
چه زمانی از Reinforcement Learning استفاده کنیم؟
یادگیری تقویتی زمانی گزینه قابلبررسی است که:
- تصمیمها متوالی باشند.
- اقدام فعلی بر وضعیت آینده اثر بگذارد.
- هدف را بتوان با Reward یا معیار نتیجه تعریف کرد.
- امکان تعامل یا شبیهسازی وجود داشته باشد.
- سیاست ثابت دستی کافی نباشد.
- هزینه Exploration قابلکنترل باشد.
- مسئله فقط یک پیشبینی مستقل نباشد.
اگر برای هر ورودی یک پاسخ صحیح دارید و اقدامات روی آینده اثر ندارند، یادگیری نظارتشده معمولاً سادهتر است.
مسیر یادگیری Reinforcement Learning
مرحله اول: Python و NumPy
آرایه، تابع، کلاس و محاسبات عددی را یاد بگیرید.
مرحله دوم: احتمال و آمار
امید ریاضی، توزیع احتمال، نمونهگیری و واریانس اهمیت دارند.
مرحله سوم: جبر خطی و حسابان
بردار، ماتریس، گرادیان و بهینهسازی را مطالعه کنید.
مرحله چهارم: یادگیری ماشین
مفاهیم Training، Validation، Overfitting و Gradient Descent را یاد بگیرید.
مرحله پنجم: MDP و Bellman Equation
State، Action، Reward، Policy و Value Function را درک کنید.
مرحله ششم: روشهای جدولی
Multi-Armed Bandit، Dynamic Programming، Monte Carlo، SARSA و Q-Learning.
مرحله هفتم: Deep RL
DQN، Policy Gradient، Actor-Critic و PPO.
مرحله هشتم: پروژه عملی
یک محیط استاندارد را با چند Seed آموزش و ارزیابی کنید.
مرحله نهم: حوزه تخصصی
رباتیک، سیستم پیشنهاددهنده، مدل زبانی، Multi-Agent RL یا Offline RL را انتخاب کنید.
پرسشهای متداول
یادگیری تقویتی چیست؟
یادگیری تقویتی روشی در یادگیری ماشین است که عامل با تعامل با محیط، انجام اقدام و دریافت پاداش، سیاست تصمیمگیری را یاد میگیرد.
Reinforcement Learning چه تفاوتی با Machine Learning دارد؟
Reinforcement Learning یکی از شاخههای Machine Learning است که بر تصمیمگیری متوالی و یادگیری از Reward تمرکز دارد.
Agent در یادگیری تقویتی چیست؟
Agent سیستم تصمیمگیری است که وضعیت را مشاهده و اقدام مناسب را انتخاب میکند.
Reward چیست؟
Reward سیگنالی عددی برای نشاندادن مطلوب یا نامطلوببودن نتیجه اقدام است.
Q-Learning چیست؟
Q-Learning الگوریتمی Model-free و Off-policy است که ارزش انجام هر اقدام در هر وضعیت را یاد میگیرد.
Q-Table چیست؟
جدولی است که برای هر ترکیب State و Action یک مقدار Q نگهداری میکند.
Deep Reinforcement Learning چیست؟
ترکیب یادگیری تقویتی با شبکههای عصبی برای حل مسائل دارای فضای وضعیت یا مشاهده بزرگ است.
PPO چیست؟
PPO الگوریتمی از خانواده Policy Optimization است که با محدودکردن اندازه تغییر Policy به پایداری آموزش کمک میکند.
RLHF چیست؟
RLHF روشی برای بهبود رفتار مدل با استفاده از Preference و بازخورد انسانی است.
آیا RLHF همان Fine-tuning است؟
RLHF یکی از روشهای Post-training است و معمولاً شامل اجزایی فراتر از Supervised Fine-tuning، مانند Preference Data و بهینهسازی بر اساس Reward، میشود.
آیا ChatGPT از یادگیری تقویتی استفاده میکند؟
مقاله InstructGPT استفاده از Supervised Fine-tuning و RLHF را برای مدلهای آن پژوهش توضیح داده است. درباره هر مدل یا نسخه باید به مستندات رسمی همان مدل مراجعه کرد.
آیا برای یادگیری تقویتی به GPU نیاز داریم؟
برای Q-Learning جدولی و محیطهای کوچک معمولاً CPU کافی است. Deep RL با شبکههای بزرگ یا ورودی تصویری ممکن است از GPU سود ببرد.
آیا میتوان با API درواره RLHF انجام داد؟
API مدلهای درواره میتواند در تولید پاسخ، ساخت Preference، ارزیابی و اجرای مدل Judge استفاده شود. آموزش کامل وزنهای یک مدل با PPO به Pipeline آموزشی و دسترسی به مدل قابلآموزش نیاز دارد و صرفاً با فراخوانی Chat API انجام نمیشود.
جمعبندی
یادگیری تقویتی روشی برای آموزش تصمیمگیری متوالی از طریق تعامل، اقدام و دریافت پاداش است.
اجزای اصلی آن عبارتاند از:
- Agent
- Environment
- State یا Observation
- Action
- Reward
- Policy
- Value Function
- Episode
Q-Learning برای محیطهای کوچک و گسسته نقطه شروع مناسبی است. وقتی فضای وضعیت بزرگ باشد، میتوان از شبکههای عصبی و روشهایی مانند DQN، PPO و سایر الگوریتمهای Deep Reinforcement Learning استفاده کرد.
در مدلهای زبانی نیز مفاهیم Preference، Reward Model، RLHF و RLAIF برای بهبود رفتار مدلها به کار میروند. بااینحال، طراحی پاداش، ارزیابی چندمرحلهای و جلوگیری از Reward Hacking همچنان چالشهای مهمی هستند.
اگر میخواهید چند مدل زبانی را برای تولید پاسخ، ساخت داده Preference یا ارزیابی Agentهای خود آزمایش کنید، میتوانید از مستندات API درواره شروع کنید.
درواره با یک API سازگار با OpenAI، پرداخت ریالی و دسترسی یکپارچه به مدلهای مختلف، امکان مقایسه مدلها و ساخت Pipelineهای ارزیابی هوش مصنوعی را برای توسعهدهندگان فراهم میکند.
مقالات مرتبط
- یادگیری ماشین چیست؟
- یادگیری عمیق چیست؟
- شبکه عصبی چیست؟
- مدل استدلالی در هوش مصنوعی چیست؟
- AI Agent چیست؟
- ارزیابی مدلهای هوش مصنوعی و Evals
- دیتاست چیست و چگونه ساخته میشود؟
- Fine-tuning با LoRA و QLoRA
- آموزش PyTorch
- راهنمای API سازگار با OpenAI
منابع
- Gymnasium: FrozenLake
- Gymnasium: Q-Learning Tutorial
- Stable-Baselines3: RL Algorithms
- Stable-Baselines3: Reinforcement Learning Tips
- Stable-Baselines3: PPO
- Playing Atari with Deep Reinforcement Learning
- Training Language Models to Follow Instructions with Human Feedback
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.