یادگیری بدون نظارت چیست؟ آموزش Unsupervised Learning، خوشهبندی و PCA
یادگیری بدون نظارت روشی در یادگیری ماشین است که بدون برچسبهای از پیش تعیینشده، ساختار و الگوهای پنهان داده را کشف میکند. در این راهنمای جامع با خوشهبندی، K-Means، DBSCAN، PCA، تشخیص ناهنجاری و پروژه عملی بخشبندی مشتریان با Python و Scikit-learn آشنا میشوید.
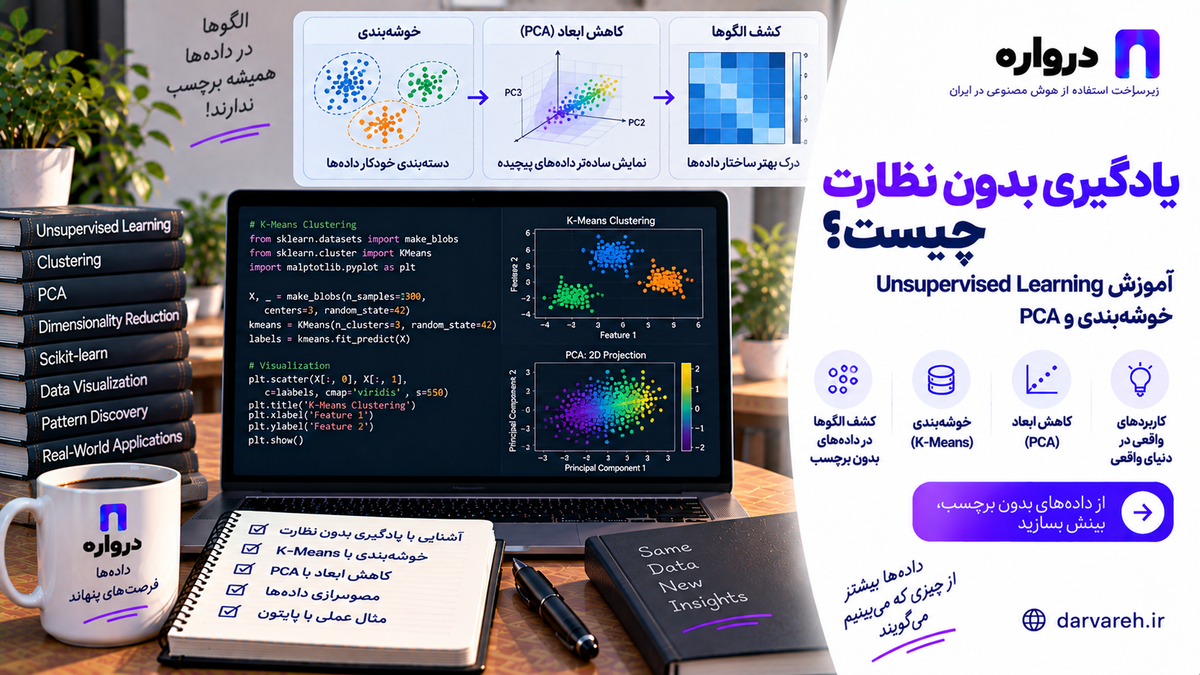
یادگیری بدون نظارت یا Unsupervised Learning یکی از روشهای اصلی یادگیری ماشین است که در آن الگوریتم بدون داشتن پاسخها و برچسبهای از پیش تعیینشده، ساختارهای پنهان داده را کشف میکند.
در یادگیری نظارتشده، هر نمونه همراه با پاسخ صحیح در اختیار مدل قرار میگیرد. برای مثال، پیامهای مشتری از قبل با برچسبهایی مانند فروش، پرداخت یا مشکل فنی مشخص شدهاند.
اما در یادگیری بدون نظارت ممکن است فقط هزاران پیام، تراکنش، تصویر یا رکورد مشتری داشته باشیم و ندانیم چه گروههایی در آنها وجود دارد. الگوریتم تلاش میکند نمونههای مشابه را پیدا کند، ابعاد داده را کاهش دهد یا موارد غیرعادی را شناسایی کند.
کاربردهای متداول این روش عبارتاند از:
- بخشبندی مشتریان
- کشف موضوع اسناد
- گروهبندی محصولات
- شناسایی رفتارهای مشابه
- تشخیص دادههای غیرعادی
- فشردهسازی اطلاعات
- کاهش ابعاد
- تحلیل الگوی خرید
- سازماندهی تصاویر
- کاوش دادههای بدون برچسب
- ساخت نمای بصری از Embeddingها
- تحلیل مکالمات و تیکتهای پشتیبانی
در این مقاله، یادگیری بدون نظارت را از مفاهیم پایه تا K-Means، DBSCAN، خوشهبندی سلسلهمراتبی، PCA و ارزیابی خوشهها بررسی میکنیم. سپس یک پروژه واقعی بخشبندی مشتریان را با Python پیادهسازی میکنیم و نشان میدهیم چگونه میتوان متنهای فارسی را با Embedding و API درواره خوشهبندی کرد.
یادگیری بدون نظارت چیست؟
در Unsupervised Learning، دیتاست شامل ورودیهاست، اما پاسخ صحیح یا Target مشخصی ندارد:
D={x1,x2,…,xn}D = \{x_1,x_2,\dots,x_n\}
الگوریتم باید از روی خود دادهها ساختار معناداری پیدا کند.
این ساختار ممکن است شامل موارد زیر باشد:
- گروههای مشابه
- جهتهای اصلی تغییرات
- الگوهای همرخدادی
- نقاط پرت
- نمایش فشردهتر داده
- توزیع احتمالی نمونهها
خروجی یادگیری بدون نظارت الزاماً یک «پاسخ صحیح قطعی» نیست. نتیجه باید با معیارهای آماری، دانش دامنه و کاربرد کسبوکار تفسیر شود.
چرا به آن یادگیری بدون نظارت میگویند؟
زیرا در زمان آموزش، برچسبی وجود ندارد که مستقیماً به الگوریتم بگوید هر نمونه به کدام دسته تعلق دارد.
برای مثال، اگر اطلاعات خرید مشتریان را به K-Means بدهیم، الگوریتم نمیداند کدام مشتری «وفادار»، «کمفعال» یا «پراشتراک» است. فقط بر اساس شباهت عددی، مشتریان را به چند Cluster تقسیم میکند.
نامگذاری و تفسیر خوشهها پس از تحلیل ویژگیهای اعضای آنها انجام میشود.
تفاوت یادگیری نظارتشده و بدون نظارت
| ویژگی | یادگیری نظارتشده | یادگیری بدون نظارت |
|---|---|---|
| داده آموزشی | دارای Label | بدون Label |
| هدف | پیشبینی خروجی مشخص | کشف ساختار پنهان |
| مسائل اصلی | Classification و Regression | Clustering و کاهش ابعاد |
| ارزیابی | مقایسه با پاسخ صحیح | معیار داخلی و تحلیل انسانی |
| نمونه | تشخیص موضوع پیام | کشف خودکار گروههای پیام |
| خروجی | کلاس یا مقدار | خوشه، نمایش فشرده یا ناهنجاری |
| تفسیر نتیجه | معمولاً روشنتر | نیازمند تحلیل بیشتر |
یادگیری بدون نظارت به این معنا نیست که سیستم بدون طراحی، ارزیابی یا نظارت انسانی قابلاستفاده است. انتخاب Feature، الگوریتم، تعداد Cluster و تفسیر نتیجه همچنان به تصمیم کارشناسی نیاز دارد.
انواع اصلی Unsupervised Learning
خوشهبندی
در Clustering، نمونههای مشابه در گروههای مشترک قرار میگیرند.
الگوریتمهای متداول:
- K-Means
- DBSCAN
- HDBSCAN
- Agglomerative Clustering
- Gaussian Mixture Model
- Spectral Clustering
کاهش ابعاد
در Dimensionality Reduction، داده از فضای دارای تعداد زیادی Feature به فضای کوچکتری منتقل میشود.
الگوریتمهای متداول:
- PCA
- Truncated SVD
- t-SNE
- UMAP
- Autoencoder
تشخیص ناهنجاری
هدف شناسایی نمونههایی است که با الگوی عمومی داده تفاوت دارند.
الگوریتمهای قابل بررسی:
- Isolation Forest
- Local Outlier Factor
- One-Class SVM
- Autoencoder
- روشهای مبتنی بر چگالی
کشف قواعد وابستگی
Association Rule Mining برای کشف همرخدادی آیتمها استفاده میشود.
نمونه:
مشتریانی که محصول A و B را خریدهاند، بیشتر احتمال دارد محصول C را نیز خریداری کنند.
الگوریتمهای شناختهشده:
- Apriori
- FP-Growth
یادگیری نمایش
Representation Learning تلاش میکند نمایش فشرده و معناداری از داده تولید کند. Embeddingها یکی از مهمترین نمونههای آن هستند.
Clustering چیست؟
خوشهبندی فرایند قراردادن نمونههای مشابه در گروههای مشترک است، بهطوریکه:
- نمونههای داخل یک Cluster تا حد امکان شبیه باشند.
- نمونههای Clusterهای متفاوت تا حد امکان تفاوت داشته باشند.
اما شباهت به نحوه نمایش داده و معیار فاصله وابسته است.
برای دو بردار عددی، فاصله اقلیدسی چنین تعریف میشود:
d(x,y)=∑j=1m(xj−yj)2d(x,y) = \sqrt{ \sum_{j=1}^{m} (x_j-y_j)^2 }
در متن و Embedding معمولاً معیارهایی مانند Cosine Similarity نیز استفاده میشوند.
کاربرد خوشهبندی در کسبوکار
بخشبندی مشتریان
مشتریان بر اساس رفتار خرید، تعداد سفارش، مبلغ و میزان فعالیت گروهبندی میشوند.
گروهبندی تیکتهای پشتیبانی
پیامهای مشابه میتوانند موضوعات پرتکرار و مشکلات جدید را آشکار کنند.
سازماندهی اسناد
اسناد بدون برچسب بر اساس شباهت معنایی گروهبندی میشوند.
گروهبندی محصولات
محصولات مشابه برای پیشنهاد، ناوبری یا مدیریت کاتالوگ دستهبندی میشوند.
تحلیل رفتار کاربر
الگوهای استفاده از نرمافزار میتوانند گروههای رفتاری متفاوتی نشان دهند.
الگوریتم K-Means چیست؟
K-Means یکی از معروفترین الگوریتمهای خوشهبندی است. این الگوریتم داده را به KK خوشه تقسیم میکند.
هر Cluster یک مرکز یا Centroid دارد. هدف، کمینهکردن فاصله نمونهها از مرکز خوشه خودشان است:
J=∑i=1K∑x∈Ci∥x−μi∥2J = \sum_{i=1}^{K} \sum_{x \in C_i} \|x-\mu_i\|^2
در این رابطه:
- CiC_i خوشه شماره ii است.
- μi\mu_i مرکز آن خوشه است.
- xx یک نمونه متعلق به خوشه است.
مراحل اجرای K-Means
- تعداد Clusterها یعنی KK انتخاب میشود.
- چند مرکز اولیه تعیین میشود.
- هر نمونه به نزدیکترین مرکز اختصاص پیدا میکند.
- مرکز هر خوشه دوباره محاسبه میشود.
- مراحل تخصیص و محاسبه مرکز تکرار میشوند.
- الگوریتم با رسیدن به شرط توقف پایان مییابد.
مستندات Scikit-learn، K-Means را یکی از سریعترین الگوریتمهای خوشهبندی معرفی میکند، اما توضیح میدهد که الگوریتم ممکن است در یک کمینه محلی قرار گیرد؛ به همین دلیل مقداردهی اولیه و اجرای چندباره اهمیت دارد.
مزایای K-Means
- ساده و قابلدرک
- سرعت مناسب
- مقیاسپذیر برای بسیاری از دیتاستها
- پیادهسازی آسان
- مناسب برای Clusterهای نسبتاً فشرده و کروی
- دارای نسخه MiniBatch برای دادههای بزرگتر
محدودیتهای K-Means
- باید تعداد Clusterها از قبل مشخص شود.
- به مقیاس Featureها حساس است.
- به داده پرت حساس است.
- برای شکلهای پیچیده Cluster مناسب نیست.
- نتیجه به مقداردهی اولیه وابسته است.
- برای Featureهای صرفاً دستهای انتخاب طبیعی نیست.
- هر نمونه را مجبور میکند به یک Cluster تعلق داشته باشد.
چرا Scaling قبل از K-Means مهم است؟
فرض کنید دو Feature داریم:
- تعداد خرید: بین صفر تا ۲۰
- مجموع مبلغ خرید: بین صفر تا ۵۰۰ میلیون
اگر داده را بدون Scaling به K-Means بدهیم، Feature مبلغ بهدلیل مقیاس عددی بزرگتر، فاصله را تحت تأثیر قرار میدهد.
استانداردسازی:
z=x−μσz = \frac{x-\mu}{\sigma}
که در آن:
- μ\mu میانگین Feature است.
- σ\sigma انحراف معیار است.
کلاس StandardScaler در Scikit-learn میانگین را حذف و داده را بر اساس انحراف معیار مقیاسبندی میکند.
چگونه تعداد خوشه مناسب را انتخاب کنیم؟
تعداد Cluster فقط یک پارامتر فنی نیست و باید با کاربرد واقعی سازگار باشد.
روشهای متداول:
- Elbow Method
- Silhouette Score
- Gap Statistic
- Stability Analysis
- معیارهای اطلاعاتی برای مدل احتمالی
- تحلیل کسبوکار
- مقایسه قابلیت تفسیر
روش Elbow
در K-Means میتوان Inertia را برای مقدارهای مختلف KK محاسبه کرد.
Inertia مجموع مجذور فاصله نمونهها از Centroid خوشه خودشان است. با افزایش KK، این مقدار کاهش پیدا میکند.
در Elbow Method نقطهای جستوجو میشود که پس از آن افزایش تعداد Clusterها بهبود کمتری ایجاد میکند.
مشکل این روش آن است که همیشه آرنج مشخصی در نمودار دیده نمیشود.
Silhouette Score چیست؟
Silhouette برای هر نمونه دو مقدار را در نظر میگیرد:
- aa: میانگین فاصله نمونه تا اعضای Cluster خودش
- bb: کمترین میانگین فاصله نمونه تا Cluster دیگر
s=b−amax(a,b)s = \frac{b-a} {\max(a,b)}
مقدار Silhouette بین منفی یک و مثبت یک قرار دارد:
- نزدیک ۱: نمونه با Cluster خود سازگار است.
- نزدیک صفر: نمونه نزدیک مرز دو Cluster است.
- مقدار منفی: احتمالاً نمونه به Cluster نامناسب تخصیص یافته است.
Scikit-learn تابع silhouette_score را برای محاسبه میانگین ضریب Silhouette تمام نمونهها ارائه میکند.
Silhouette بالاتر بهتنهایی تضمین نمیکند Clusterها از نظر کسبوکار مفید باشند.
DBSCAN چیست؟
DBSCAN مخفف Density-Based Spatial Clustering of Applications with Noise است. این الگوریتم مناطق پرتراکم را گسترش میدهد و نقاط کمتراکم را میتواند بهعنوان Noise مشخص کند.
پارامترهای اصلی:
eps
حداکثر فاصله برای همسایهبودن دو نمونه.
min_samples
حداقل تعداد نمونه لازم برای تشکیل ناحیه پرتراکم.
مزایا:
- نیازی به تعیین تعداد Cluster ندارد.
- میتواند شکلهای غیرکروی را پیدا کند.
- نقاط پرت را جدا میکند.
محدودیتها:
- به انتخاب
epsحساس است. - با چگالیهای بسیار متفاوت مشکل دارد.
- در فضای پربعد، فاصله ممکن است معنای خود را از دست بدهد.
- مقیاسکردن Featureها اهمیت زیادی دارد.
خوشهبندی سلسلهمراتبی چیست؟
Hierarchical Clustering یک ساختار درختی از Clusterها ایجاد میکند.
Agglomerative
از هر نمونه بهعنوان یک Cluster شروع میکند و گروههای نزدیک را بهتدریج ادغام میکند.
Divisive
از یک Cluster بزرگ شروع میکند و آن را به گروههای کوچکتر تقسیم میکند.
نتیجه معمولاً با Dendrogram نمایش داده میشود.
روش Linkage مشخص میکند فاصله میان دو Cluster چگونه محاسبه شود:
- Single
- Complete
- Average
- Ward
در AgglomerativeClustering، معیار Linkage تعیین میکند کدام زوج Cluster در هر مرحله ادغام شوند.
Gaussian Mixture Model چیست؟
GMM فرض میکند داده از ترکیب چند توزیع Gaussian تولید شده است.
برخلاف K-Means که هر نمونه را قطعی به یک Cluster اختصاص میدهد، GMM میتواند احتمال تعلق نمونه به هر Cluster را محاسبه کند.
نمونه خروجی:
| مشتری | خوشه ۱ | خوشه ۲ | خوشه ۳ |
|---|---|---|---|
| A | ۰٫۸۵ | ۰٫۱۰ | ۰٫۰۵ |
| B | ۰٫۳۰ | ۰٫۶۰ | ۰٫۱۰ |
این ویژگی برای نمونههای مرزی مفید است.
کاهش ابعاد چیست؟
دادههای واقعی ممکن است صدها یا هزاران Feature داشته باشند.
Dimensionality Reduction داده را به فضای کمبعدتر تبدیل میکند، بهطوریکه تا حد امکان اطلاعات مهم حفظ شود.
کاربردها:
- نمایش دوبعدی یا سهبعدی داده
- کاهش نویز
- کاهش حجم ذخیرهسازی
- افزایش سرعت بعضی الگوریتمها
- کاهش همبستگی Featureها
- آمادهسازی برای Clustering
- تحلیل Embeddingها
PCA چیست؟
PCA مخفف Principal Component Analysis است. این روش محورهای جدیدی پیدا میکند که بیشترین واریانس داده را توضیح میدهند.
مؤلفه اول بیشترین واریانس ممکن را توضیح میدهد. مؤلفه بعدی، بیشترین واریانس باقیمانده را با شرط عمودبودن بر مؤلفه قبلی پوشش میدهد.
Scikit-learn، PCA را روش کاهش ابعاد خطی مبتنی بر تجزیه SVD معرفی میکند که داده را به فضای کمبعدتر نگاشت میکند.
نکته مهم
PCA معمولاً به مقیاس Featureها حساس است. در بسیاری از پروژهها باید قبل از آن Scaling انجام شود.
PCA چه چیزی را حفظ میکند؟
PCA تلاش میکند جهتهایی را حفظ کند که واریانس بیشتری دارند. اما واریانس بیشتر الزاماً به معنای اهمیت بیشتر برای کاربرد کسبوکار نیست.
اگر یک Feature با دامنه بسیار بزرگ وجود داشته باشد، ممکن است نتیجه را غالب کند. اگر الگوی مهم غیرخطی باشد، PCA ممکن است آن را بهخوبی نمایش ندهد.
تفاوت PCA، t-SNE و UMAP
| روش | کاربرد اصلی | ویژگی |
|---|---|---|
| PCA | کاهش ابعاد خطی و پیشپردازش | سریع و قابلتفسیرتر |
| t-SNE | نمایش دوبعدی ساختار محلی | مناسب Visualization |
| UMAP | نمایش و کاهش ابعاد غیرخطی | معمولاً سریعتر از t-SNE در داده بزرگ |
| Truncated SVD | داده Sparse مانند TF-IDF | بدون نیاز به Centering کامل |
از نمودار t-SNE یا UMAP نباید بهتنهایی برای اثبات وجود Cluster واقعی استفاده کرد. تنظیم پارامترها میتواند شکل نمودار را تغییر دهد.
تشخیص ناهنجاری در یادگیری بدون نظارت
در Anomaly Detection، هدف یافتن نمونههای متفاوت از الگوی عمومی است.
نمونه کاربرد:
- خطای دستگاه
- رفتار غیرعادی کاربر
- داده خراب
- افزایش ناگهانی مصرف
- درخواست خارج از الگوی معمول
- مشکل جدید در تیکتهای پشتیبانی
تشخیص ناهنجاری با تشخیص تقلب یکسان نیست. یک نمونه غیرعادی الزاماً متقلب یا نامعتبر نیست و باید بررسی شود.
الگوریتم Isolation Forest
Isolation Forest تلاش میکند نقاط را با تقسیمهای تصادفی از هم جدا کند. نقاط غیرعادی معمولاً با تقسیمهای کمتری جدا میشوند.
این روش برای داده عددی پربعد و مجموعههای نسبتاً بزرگ قابلاستفاده است، اما نسبت آلودگی و کیفیت Featureها بر نتیجه اثر دارند.
پروژه عملی: بخشبندی مشتریان با K-Means
فرض کنید فایل customers.csv دارای ستونهای زیر است:
customer_id,orders_count,total_spend,days_since_last_order,support_tickets
1001,14,9200000,8,1
1002,2,750000,180,3
1003,28,24600000,4,0
1004,6,3100000,45,2
1005,1,420000,260,1
هدف این است که بدون داشتن Label، مشتریان را بر اساس رفتارشان گروهبندی کنیم.
نصب کتابخانهها
pip install pandas scikit-learn matplotlib joblib
خواندن و بررسی داده
import pandas as pd


df = pd.read_csv("customers.csv")

FEATURES = [
    "orders_count",
    "total_spend",
    "days_since_last_order",
    "support_tickets",
]

print(df.head())
print(df[FEATURES].describe())
print(df[FEATURES].isna().sum())
پاکسازی اولیه
df = df.drop_duplicates(
    subset=["customer_id"]
).copy()

df = df.dropna(
    subset=FEATURES
).copy()

for column in FEATURES:
    df = df[
        df[column] >= 0
    ]
در پروژه واقعی، حذف داده گمشده همیشه بهترین راه نیست. ممکن است Imputation یا تعریف مقدار «نامشخص» مناسبتر باشد.
ساخت Pipeline مقیاسگذاری و K-Means
from sklearn.cluster import KMeans
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler


pipeline = Pipeline(
    steps=[
        (
            "scaler",
            StandardScaler(),
        ),
        (
            "kmeans",
            KMeans(
                n_clusters=4,
                init="k-means++",
                n_init=20,
                random_state=42,
            ),
        ),
    ]
)

df["cluster"] = pipeline.fit_predict(
    df[FEATURES]
)
استفاده از Pipeline باعث میشود Scaling و Clustering بهصورت یک زنجیره مشخص ذخیره و اجرا شوند. کلاس Pipeline در Scikit-learn برای اجرای متوالی Transformerها و مدل نهایی طراحی شده است.
انتخاب تعداد Cluster با Silhouette
from sklearn.metrics import silhouette_score
from sklearn.pipeline import make_pipeline


results = []

for k in range(2, 9):
    candidate = make_pipeline(
        StandardScaler(),
        KMeans(
            n_clusters=k,
            n_init=20,
            random_state=42,
        ),
    )

    labels = candidate.fit_predict(
        df[FEATURES]
    )

    score = silhouette_score(
        candidate.named_steps[
            "standardscaler"
        ].transform(df[FEATURES]),
        labels,
    )

    results.append(
        {
            "k": k,
            "silhouette": score,
        }
    )

score_df = pd.DataFrame(results)

print(
    score_df.sort_values(
        "silhouette",
        ascending=False,
    )
)
K دارای بالاترین Silhouette میتواند یک گزینه اولیه باشد، اما انتخاب نهایی باید با تفسیر Clusterها و کاربرد تجاری هماهنگ شود.
محاسبه پروفایل هر Cluster
cluster_profile = (
    df.groupby("cluster")[FEATURES]
    .agg(
        [
            "count",
            "mean",
            "median",
        ]
    )
    .round(2)
)

print(cluster_profile)
نسخه سادهتر:
summary = (
    df.groupby("cluster")
    .agg(
        customers=(
            "customer_id",
            "count",
        ),
        avg_orders=(
            "orders_count",
            "mean",
        ),
        avg_spend=(
            "total_spend",
            "mean",
        ),
        avg_recency=(
            "days_since_last_order",
            "mean",
        ),
        avg_tickets=(
            "support_tickets",
            "mean",
        ),
    )
    .round(2)
)

print(summary)
ممکن است پس از تحلیل، Clusterها چنین تفسیر شوند:
| Cluster | الگوی احتمالی |
|---|---|
| ۰ | مشتریان جدید با خرید محدود |
| ۱ | مشتریان وفادار و پرتراکنش |
| ۲ | مشتریان غیرفعال |
| ۳ | مشتریان دارای تعامل پشتیبانی بالا |
این نامها را نباید قبل از مشاهده داده تعیین کرد. شماره Cluster نیز معنای ذاتی ندارد و در آموزش دوباره ممکن است تغییر کند.
نمایش دوبعدی Clusterها با PCA
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler


scaled_features = StandardScaler().fit_transform(
    df[FEATURES]
)

pca = PCA(
    n_components=2,
    random_state=42,
)

components = pca.fit_transform(
    scaled_features
)

df["pca_1"] = components[:, 0]
df["pca_2"] = components[:, 1]

plt.figure(figsize=(10, 7))

scatter = plt.scatter(
    df["pca_1"],
    df["pca_2"],
    c=df["cluster"],
    cmap="tab10",
    alpha=0.75,
)

plt.xlabel("Principal Component 1")
plt.ylabel("Principal Component 2")
plt.title("Customer Segments")

plt.colorbar(
    scatter,
    label="Cluster",
)

plt.tight_layout()
plt.show()
این نمودار فقط Projection دوبعدی داده است. همپوشانی در نمودار لزوماً به معنای اشتباهبودن خوشهبندی در فضای اصلی نیست.
بررسی واریانس توضیحدادهشده PCA
print(
    "Explained variance ratio:",
    pca.explained_variance_ratio_,
)

print(
    "Total explained variance:",
    pca.explained_variance_ratio_.sum(),
)
اگر دو مؤلفه فقط بخش کوچکی از واریانس را توضیح دهند، نمودار دوبعدی تصویر کاملی از ساختار داده نیست.
ذخیره Pipeline
import joblib


joblib.dump(
    pipeline,
    "customer_segmentation.joblib",
)
بارگذاری:
loaded_pipeline = joblib.load(
    "customer_segmentation.joblib"
)
تخصیص مشتری جدید به Cluster
new_customer = pd.DataFrame(
    [
        {
            "orders_count": 10,
            "total_spend": 8_500_000,
            "days_since_last_order": 12,
            "support_tickets": 1,
        }
    ]
)

cluster = loaded_pipeline.predict(
    new_customer[FEATURES]
)[0]

print(
    "Assigned cluster:",
    int(cluster),
)
این قابلیت مخصوص الگوریتمهایی مانند K-Means است. بعضی روشهای خوشهبندی، مانند شکل معمول DBSCAN، مستقیماً متد predict برای داده جدید ارائه نمیکنند.
چگونه کیفیت Clusterها را ارزیابی کنیم؟
در یادگیری بدون نظارت پاسخ صحیحی وجود ندارد؛ بنابراین ارزیابی دشوارتر است.
معیارهای داخلی
بدون Label واقعی:
- Silhouette Score
- Davies-Bouldin Index
- Calinski-Harabasz Score
- Inertia
معیارهای خارجی
اگر Label مرجع برای ارزیابی وجود داشته باشد:
- Adjusted Rand Index
- Normalized Mutual Information
- Homogeneity
- Completeness
- V-measure
ارزیابی پایداری
الگوریتم را روی نمونههای متفاوت داده یا Seedهای مختلف اجرا کنید و ببینید ساختار Clusterها چقدر ثابت میماند.
ارزیابی کسبوکار
بررسی کنید:
- آیا Clusterها قابلتفسیرند؟
- آیا برای هر Cluster میتوان اقدام متفاوتی تعریف کرد؟
- آیا رفتار آینده گروهها متفاوت است؟
- آیا تقسیمبندی در طول زمان پایدار است؟
- آیا Clusterها فقط یک Feature بدیهی را بازتاب میدهند؟
استفاده از مدل زبانی برای نامگذاری Clusterها
پس از ساخت Clusterها میتوان خلاصه آماری آنها را به مدل زبانی داد تا نام و توضیح اولیه پیشنهاد کند.
این خروجی باید توسط تحلیلگر بررسی شود؛ مدل به داده خام و زمینه کامل کسبوکار دسترسی ندارد.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
نصب:
pip install openai pydantic
تنظیم متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
کد:
import os
from typing import List
from openai import OpenAI
from pydantic import BaseModel
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
MODEL_ID = os.environ["DARVAREH_MODEL"]
class ClusterDescription(BaseModel):
cluster_id: int
suggested_name: str
description: str
recommended_action: str
class ClusterAnalysis(BaseModel):
clusters: List[ClusterDescription]
def analyze_clusters(
summary_json: str,
) -> ClusterAnalysis:
prompt = f"""
خلاصه آماری خوشههای مشتریان را تحلیل کن.
قواعد:
- نام خوشه کوتاه و فارسی باشد.
- فقط بر اساس داده ارائهشده نتیجه بگیر.
- شماره خوشه را تغییر نده.
- برای هر خوشه یک اقدام قابلآزمایش پیشنهاد بده.
- پاسخ فقط JSON معتبر باشد.
ساختار:
{{
"clusters": [
{{
"cluster_id": 0,
"suggested_name": "نام پیشنهادی",
"description": "توضیح",
"recommended_action": "اقدام"
}}
]
}}
داده:
{summary_json}
"""
response = client.chat.completions.create(
model=MODEL_ID,
temperature=0.2,
messages=[
{
"role": "system",
"content": (
"شما تحلیلگر بخشبندی "
"مشتریان هستید."
),
},
{
"role": "user",
"content": prompt,
},
],
)
content = response.choices[0].message.content
if not content:
raise ValueError(
"مدل پاسخی برنگرداند."
)
return ClusterAnalysis.model_validate_json(
content
)
analysis = analyze_clusters(
summary.reset_index().to_json(
orient="records",
force_ascii=False,
)
)
print(
analysis.model_dump_json(
indent=2,
)
)
این روش نقش مدل زبانی را از الگوریتم خوشهبندی جدا نگه میدارد:
- K-Means گروهها را بر اساس داده عددی میسازد.
- مدل زبانی خلاصه خوشهها را تفسیر میکند.
- تحلیلگر نام و اقدام نهایی را تأیید میکند.
خوشهبندی متن فارسی با Embedding
برای گروهبندی تیکتها یا اسناد، ابتدا باید هر متن به یک بردار عددی تبدیل شود.
Embedding متنهایی با معنای مشابه را در فضای برداری به یکدیگر نزدیک میکند. سپس میتوان روی بردارها K-Means یا الگوریتم دیگری اجرا کرد.
معماری:
متنهای فارسی
↓
Embedding API
↓
بردارهای عددی
↓
نرمالسازی
↓
Clustering
↓
نمونههای شاخص هر Cluster
↓
نامگذاری و تحلیل موضوع
دریافت Embedding از API درواره
متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_EMBEDDING_MODEL="YOUR_EMBEDDING_MODEL_ID"
کد:
import os

import numpy as np
from openai import OpenAI


client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)

EMBEDDING_MODEL = os.environ[
    "DARVAREH_EMBEDDING_MODEL"
]


def create_embeddings(
    texts: list[str],
) -> np.ndarray:
    response = client.embeddings.create(
        model=EMBEDDING_MODEL,
        input=texts,
    )

    ordered_items = sorted(
        response.data,
        key=lambda item: item.index,
    )

    vectors = [
        item.embedding
        for item in ordered_items
    ]

    return np.asarray(
        vectors,
        dtype=np.float32,
    )
شناسه مدل را باید از فهرست فعلی مدلهای درواره انتخاب کنید.
خوشهبندی پیامها بر اساس معنا
from sklearn.cluster import KMeans
from sklearn.preprocessing import normalize
messages = [
"مبلغ پرداخت کردم ولی اعتبار اضافه نشد",
"فاکتور پرداخت را از کجا دانلود کنم",
"API من خطای 429 میدهد",
"برای اتصال پایتون نمونه کد دارید",
"مدل جدید تولید تصویر اضافه کنید",
"چطور خرید سازمانی انجام بدهم",
]
embeddings = create_embeddings(
messages
)
normalized_embeddings = normalize(
embeddings,
norm="l2",
)
text_clusterer = KMeans(
n_clusters=3,
n_init=20,
random_state=42,
)
labels = text_clusterer.fit_predict(
normalized_embeddings
)
for message, label in zip(
messages,
labels,
):
print(
f"Cluster {label}: {message}"
)
تعداد Cluster، مدل Embedding و نمونههای واقعی باید جداگانه ارزیابی شوند.
انتخاب نمونه نماینده هر Cluster
برای تحلیل بهتر میتوان متنهایی را پیدا کرد که به Centroid نزدیکترند:
from sklearn.metrics import pairwise_distances


distances = pairwise_distances(
    normalized_embeddings,
    text_clusterer.cluster_centers_,
    metric="euclidean",
)

for cluster_id in range(
    text_clusterer.n_clusters
):
    member_indices = np.where(
        labels == cluster_id
    )[0]

    member_distances = distances[
        member_indices,
        cluster_id,
    ]

    representative_index = (
        member_indices[
            np.argmin(
                member_distances
            )
        ]
    )

    print(
        {
            "cluster": cluster_id,
            "representative": messages[
                representative_index
            ],
        }
    )
نمونه نماینده و چند نمونه نزدیک دیگر میتوانند برای تفسیر موضوع Cluster به مدل زبانی یا تحلیلگر داده شوند.
K-Means یا DBSCAN؛ کدام بهتر است؟
| معیار | K-Means | DBSCAN |
|---|---|---|
| نیاز به تعداد Cluster | بله | خیر |
| تشخیص Noise | محدود | بله |
| شکل Cluster | بیشتر کروی | شکلهای پیچیدهتر |
| داده با چگالی متفاوت | محدود | ممکن است دشوار باشد |
| پیشبینی نمونه جدید | سادهتر | در حالت معمول مستقیم نیست |
| سرعت | معمولاً مناسب | وابسته به داده و تنظیمات |
| حساسیت اصلی | مقدار K و Scaling | eps و min_samples |
هیچکدام همیشه بهتر نیستند. ساختار واقعی داده تعیینکننده است.
چه زمانی از PCA استفاده کنیم؟
PCA زمانی قابلبررسی است که:
- تعداد Featureها زیاد است.
- Featureها همبستگی دارند.
- Visualization دوبعدی نیاز دارید.
- میخواهید نویز یا افزونگی کاهش یابد.
- الگوریتم بعدی با ابعاد کمتر سریعتر میشود.
PCA زمانی ممکن است مناسب نباشد که:
- رابطه اصلی غیرخطی است.
- تفسیر مستقیم Featureها ضروری است.
- Featureها مقیاس نشدهاند.
- مؤلفههای کم، واریانس کافی را حفظ نمیکنند.
- داده بسیار Sparse است و Truncated SVD مناسبتر است.
چالشهای یادگیری بدون نظارت
نبود پاسخ صحیح
نمیتوان نتیجه را مستقیماً با Label واقعی مقایسه کرد.
وابستگی به نمایش داده
Feature Engineering یا مدل Embedding میتواند ساختار Clusterها را کاملاً تغییر دهد.
حساسیت به مقیاس
Featureهای بزرگتر ممکن است فاصله را کنترل کنند.
تفسیر ذهنی
ممکن است برای یک Cluster چند تفسیر ممکن وجود داشته باشد.
ناپایداری
با تغییر Seed، داده یا Hyperparameter ممکن است نتیجه تغییر کند.
وجود Cluster مصنوعی
تقریباً هر الگوریتمی میتواند داده را به گروههایی تقسیم کند؛ اما این گروهها الزاماً معنای واقعی ندارند.
نفرین ابعاد
در فضای بسیار پربعد، مفهوم فاصله میتواند ضعیف شود و بسیاری از نقاط تقریباً فاصله مشابهی داشته باشند.
اشتباهات رایج در Unsupervised Learning
اجرای K-Means بدون Scaling
Feature دارای دامنه بزرگتر ممکن است نتیجه را غالب کند.
انتخاب K فقط با یک معیار
Silhouette یا Elbow باید با تفسیر و کاربرد واقعی ترکیب شوند.
نامگذاری Cluster قبل از تحلیل
نامها باید از پروفایل اعضا به دست آیند، نه انتظار اولیه تحلیلگر.
استفاده از PCA بهعنوان اثبات قطعی
Projection دوبعدی ممکن است بخشی از اطلاعات را حذف کند.
فرضکردن شماره Cluster بهعنوان رتبه
Cluster شماره ۳ الزاماً بهتر یا مهمتر از Cluster شماره ۱ نیست.
ارزیابی روی همان Featureهای نامناسب
معیار داخلی نمیتواند ضعف تعریف Feature را برطرف کند.
نادیدهگرفتن پایداری
اگر نتیجه با تغییر کوچک داده کاملاً عوض شود، استفاده عملی آن دشوار است.
استفاده مستقیم از Cluster بهعنوان حقیقت
خوشهها فرضیهای درباره ساختار داده هستند و باید با رفتار واقعی ارزیابی شوند.
چگونه نتیجه خوشهبندی را عملیاتی کنیم؟
پس از ساخت Clusterها:
- ویژگی هر Cluster را تحلیل کنید.
- نام قابلتفسیر انتخاب کنید.
- یک اقدام مشخص برای هر گروه تعریف کنید.
- اقدام را با آزمایش کنترلشده بسنجید.
- نتیجه کسبوکار را اندازهگیری کنید.
- پایداری Cluster را در طول زمان بررسی کنید.
- مدل را با داده جدید بهروزرسانی کنید.
برای مثال:
| خوشه | اقدام آزمایشی |
|---|---|
| مشتریان وفادار | پیشنهاد سرویس مکمل |
| مشتریان جدید | راهنمای شروع |
| مشتریان غیرفعال | کمپین بازگشت |
| مشتریان پشتیبانیمحور | آموزش و مستندات هدفمند |
خوشهبندی زمانی ارزش ایجاد میکند که به تصمیم قابلاندازهگیری متصل شود.
چه زمانی از یادگیری بدون نظارت استفاده کنیم؟
این روش زمانی مناسب است که:
- داده برچسبدار ندارید.
- میخواهید ساختار اولیه داده را کشف کنید.
- بخشبندی یا گروهبندی نیاز دارید.
- تعداد Featureها زیاد است.
- به دنبال ناهنجاری هستید.
- میخواهید داده را برای تحلیل بصری آماده کنید.
- قصد دارید برای برچسبگذاری انسانی نمونهها را سازماندهی کنید.
اگر هدف پیشبینی یک خروجی مشخص و داده برچسبدار در اختیار دارید، یادگیری نظارتشده معمولاً انتخاب مستقیمتری است.
پرسشهای متداول
یادگیری بدون نظارت چیست؟
روشی در یادگیری ماشین است که بدون داشتن Label، الگوها و ساختارهای پنهان داده را کشف میکند.
مهمترین کاربرد Unsupervised Learning چیست؟
خوشهبندی، کاهش ابعاد، تشخیص ناهنجاری و کشف قواعد وابستگی از کاربردهای اصلی آن هستند.
Clustering چیست؟
فرایند گروهبندی نمونههای مشابه بهگونهای است که اعضای یک Cluster بیشترین شباهت ممکن را داشته باشند.
K-Means چیست؟
الگوریتمی است که داده را به KK خوشه تقسیم و فاصله نمونهها از Centroid خوشه خودشان را کمینه میکند.
چگونه تعداد Cluster را انتخاب کنیم؟
با ترکیب روشهایی مانند Silhouette، Elbow، تحلیل پایداری و تفسیر کسبوکار.
PCA چیست؟
روش کاهش ابعاد خطی است که جهتهای دارای بیشترین واریانس را پیدا میکند.
تفاوت K-Means و DBSCAN چیست؟
K-Means به تعداد Cluster نیاز دارد و بیشتر برای گروههای نسبتاً کروی مناسب است. DBSCAN بر اساس چگالی عمل میکند و میتواند Noise را شناسایی کند.
آیا یادگیری بدون نظارت دقیق است؟
بهدلیل نبود Label، «دقت» به معنای Classification همیشه قابلمحاسبه نیست. نتیجه با معیارهای داخلی، پایداری و ارزش کاربردی ارزیابی میشود.
آیا میتوان متن فارسی را خوشهبندی کرد؟
بله. ابتدا متنها با TF-IDF یا Embedding به بردار تبدیل و سپس خوشهبندی میشوند.
آیا Embedding همان Clustering است؟
خیر. Embedding نمایش برداری داده است؛ Clustering الگوریتمی برای گروهبندی این بردارهاست.
آیا میتوان برای نامگذاری Cluster از مدل زبانی استفاده کرد؟
بله. میتوان نمونهها یا خلاصه آماری هر Cluster را به مدل داد تا نام اولیه پیشنهاد کند، اما نتیجه باید بررسی شود.
آیا Clusterها پس از آموزش ثابت میمانند؟
با تغییر داده، Scaling، Seed یا پارامترها ممکن است Clusterها تغییر کنند. نسخه مدل و روش نامگذاری باید مدیریت شود.
جمعبندی
یادگیری بدون نظارت برای کشف ساختار دادههای بدون برچسب استفاده میشود. مهمترین شاخههای آن عبارتاند از:
- خوشهبندی
- کاهش ابعاد
- تشخیص ناهنجاری
- کشف قواعد وابستگی
- یادگیری نمایش
برای اجرای صحیح یک پروژه Unsupervised Learning:
- هدف کسبوکار را مشخص کنید.
- Featureهای معنادار انتخاب کنید.
- داده را پاکسازی و در صورت نیاز Scale کنید.
- بیش از یک الگوریتم را آزمایش کنید.
- پارامترها را با چند معیار بسنجید.
- پایداری نتیجه را بررسی کنید.
- Clusterها را پس از تحلیل نامگذاری کنید.
- نتیجه را به یک اقدام قابلاندازهگیری متصل کنید.
- تغییر ساختار داده را در طول زمان پایش کنید.
- خروجی الگوریتم را حقیقت قطعی در نظر نگیرید.
برای خوشهبندی متنهای فارسی میتوانید ابتدا با استفاده از مدلهای Embedding، هر متن را به بردار تبدیل کنید و سپس K-Means یا الگوریتم دیگری را روی بردارها اجرا کنید.
برای دسترسی به مدلهای مختلف Embedding و مدلهای زبانی میتوانید از مستندات API درواره شروع کنید.
درواره با یک API سازگار با OpenAI، پرداخت ریالی و دسترسی یکپارچه به مدلهای مختلف، امکان ساخت جستوجوی معنایی، خوشهبندی اسناد و تحلیل دادههای متنی را برای توسعهدهندگان فراهم میکند.
مقالات مرتبط
- یادگیری ماشین چیست؟
- یادگیری نظارتشده چیست؟
- یادگیری تقویتی چیست؟
- دیتاست چیست؟
- Embedding چیست؟
- آموزش Scikit-learn با پایتون
- آموزش Pandas برای تحلیل داده
- جستوجوی معنایی چیست؟
- پایگاه داده برداری چیست؟
- راهنمای API سازگار با OpenAI
منابع
- Scikit-learn: Clustering
- Scikit-learn: KMeans
- Scikit-learn: DBSCAN
- Scikit-learn: Silhouette Score
- Scikit-learn: PCA
- Scikit-learn: Preprocessing Data
- Scikit-learn: Pipeline
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.