الگوریتم ازدحام ذرات چیست؟ آموزش PSO با مثال عملی پایتون
الگوریتم ازدحام ذرات یا PSO یک روش هوشمند برای حل مسائل پیچیده بهینهسازی است که از حرکت گروهی پرندگان و ماهیها الهام میگیرد.
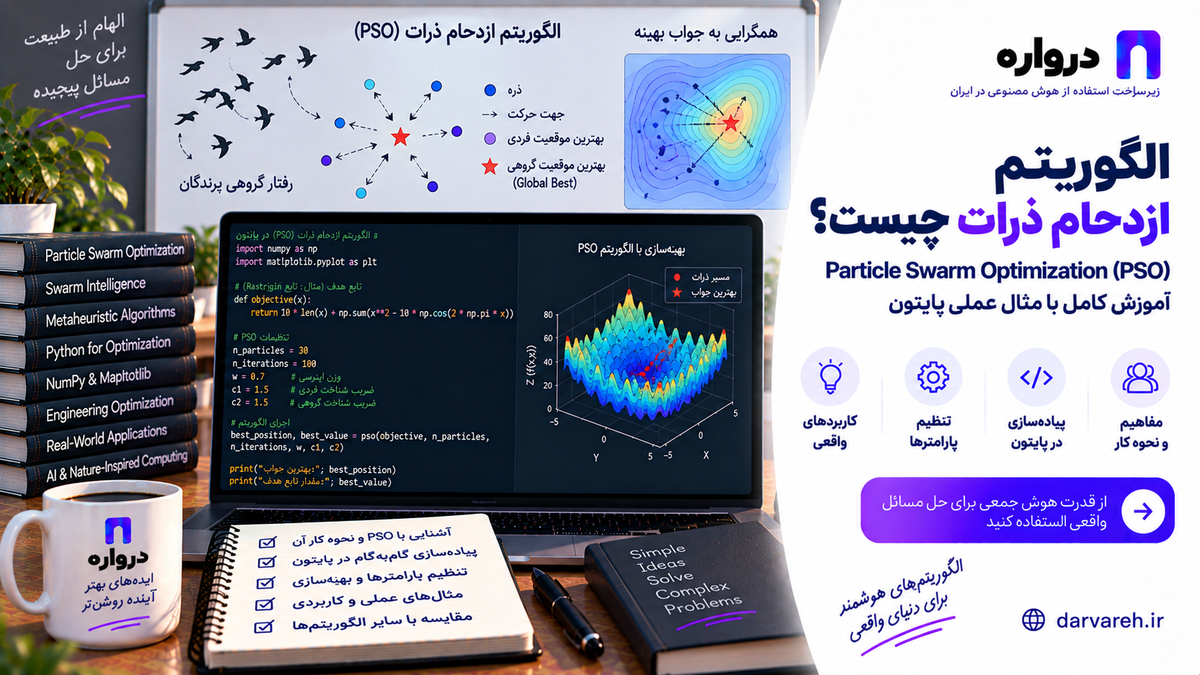
الگوریتم ازدحام ذرات یا Particle Swarm Optimization که بهاختصار PSO نامیده میشود، یکی از الگوریتمهای فراابتکاری و جمعیتمحور برای حل مسائل بهینهسازی است.
ایده اصلی PSO از رفتار گروهی موجوداتی مانند پرندگان و ماهیها الهام گرفته شده است. هر عضو گروه اطلاعاتی درباره موقعیت فعلی خود دارد، تجربههای قبلیاش را به خاطر میسپارد و از بهترین عضو گروه نیز تأثیر میگیرد. با تکرار این فرایند، گروه بهتدریج به ناحیهای نزدیک میشود که احتمال وجود جواب بهتر در آن بیشتر است.
PSO در مسائل مختلفی مانند تنظیم ابرپارامترهای یادگیری ماشین، انتخاب ویژگی، کنترل صنعتی، زمانبندی، تخصیص منابع، طراحی مهندسی و بهینهسازی تنظیمات برنامههای هوش مصنوعی استفاده میشود.
الگوریتم ازدحام ذرات چیست؟
الگوریتم ازدحام ذرات یک روش جستوجوی تصادفی و بدون نیاز به مشتق است. در این الگوریتم، هر جواب احتمالی یک «ذره» نامیده میشود و مجموعه ذرات، «ازدحام» یا Swarm را تشکیل میدهند.
هر ذره دارای دو ویژگی اصلی است:
- موقعیت یا Position
- سرعت یا Velocity
موقعیت ذره نشاندهنده یک جواب احتمالی است. سرعت مشخص میکند ذره در مرحله بعد با چه جهت و شدتی در فضای جستوجو حرکت کند.
هر ذره دو نوع تجربه را دنبال میکند:
- بهترین موقعیتی که خودش تاکنون پیدا کرده است؛ یعنی Personal Best یا
pbest - بهترین موقعیتی که کل گروه پیدا کرده است؛ یعنی Global Best یا
gbest
حرکت هر ذره بر اساس ترکیب سه عامل انجام میشود:
- ادامه حرکت قبلی
- بازگشت به بهترین تجربه شخصی
- حرکت بهسوی بهترین تجربه جمعی
PSO نخستینبار در سال ۱۹۹۵ توسط James Kennedy و Russell Eberhart برای بهینهسازی توابع غیرخطی معرفی شد.
یک مثال ساده برای درک PSO
فرض کنید تعدادی پرنده در یک منطقه بهدنبال غذا هستند. هیچکدام موقعیت دقیق غذا را نمیدانند، اما هر پرنده میتواند:
- موقعیت فعلی خود را بررسی کند.
- بهترین موقعیتی را که قبلاً دیده است به خاطر بسپارد.
- از بهترین موقعیت پیداشده توسط سایر پرندگان مطلع شود.
پرنده فقط بهسمت بهترین پرنده حرکت نمیکند. حرکت قبلی و تجربه شخصی خودش نیز بر تصمیم بعدی اثر میگذارند.
در PSO نیز هر ذره به همین شکل در فضای جوابها حرکت میکند. اگر هدف پیدا کردن کمینه یک تابع باشد، ذرات بهتدریج به نواحی دارای مقدار کمتر نزدیک میشوند.
اصطلاحات اصلی در الگوریتم ازدحام ذرات
ذره یا Particle
هر ذره یک جواب احتمالی برای مسئله است.
اگر بخواهیم دو متغیر x و y را بهینه کنیم، موقعیت یک ذره میتواند چنین باشد:
[3.2, -1.7]
اگر هدف تنظیم پارامترهای یک مدل باشد، ذره میتواند چنین ساختاری داشته باشد:
[learning_rate, dropout, batch_size]
برای مثال:
[0.001, 0.25, 64]
ازدحام یا Swarm
مجموعه تمام ذرات را Swarm مینامند. اگر ۵۰ ذره داشته باشیم، الگوریتم در هر تکرار ۵۰ جواب احتمالی را ارزیابی میکند.
موقعیت یا Position
موقعیت یک ذره همان مقدار فعلی متغیرهای مسئله است:
xᵢ(t)
در این نماد:
iشماره ذره است.tشماره تکرار است.
سرعت یا Velocity
سرعت تعیین میکند موقعیت ذره در مرحله بعد چقدر و در چه جهتی تغییر کند:
vᵢ(t)
سرعت در PSO الزاماً معنای فیزیکی ندارد؛ بلکه برداری برای کنترل حرکت در فضای جوابها است.
بهترین تجربه شخصی یا Personal Best
هر ذره بهترین موقعیتی را که تاکنون تجربه کرده است نگه میدارد:
pbestᵢ
اگر موقعیت جدید ذره بهتر از pbest قبلی باشد، مقدار pbest بهروزرسانی میشود.
بهترین تجربه جمعی یا Global Best
بهترین جواب پیداشده توسط کل ازدحام با gbest نمایش داده میشود.
در نسخه Global-best PSO، همه ذرات از بهترین جواب کل جمعیت تأثیر میگیرند. مستندات PySwarms این ساختار را توپولوژی ستارهای توصیف میکند که در آن هر ذره به بهترین ذره کل گروه جذب میشود.
تابع هدف
تابع هدف یا Objective Function کیفیت هر موقعیت را محاسبه میکند.
برای مثال:
def objective(x):
    return x[0] ** 2 + x[1] ** 2
هدف در این مسئله پیدا کردن مقادیری از x[0] و x[1] است که خروجی تابع را کمینه کنند.
فرمول الگوریتم ازدحام ذرات
سرعت هر ذره با رابطه زیر بهروزرسانی میشود:
vi(t+1)=wvi(t)+c1r1(pbesti−xi(t))+c2r2(gbest−xi(t))v_i(t+1)= w v_i(t) +c_1 r_1 \bigl(pbest_i-x_i(t)\bigr) +c_2 r_2 \bigl(gbest-x_i(t)\bigr)
موقعیت جدید نیز از رابطه زیر به دست میآید:
xi(t+1)=xi(t)+vi(t+1)x_i(t+1)=x_i(t)+v_i(t+1)
پیادهسازیهای مرجع PSO نیز موقعیت را با افزودن سرعت جدید به موقعیت فعلی بهروزرسانی میکنند.
اجزای فرمول عبارتاند از:
| پارامتر | مفهوم |
|---|---|
w | وزن اینرسی |
c1 | ضریب شناختی یا تجربه فردی |
c2 | ضریب اجتماعی یا تجربه جمعی |
r1 و r2 | اعداد تصادفی بین صفر و یک |
pbest | بهترین موقعیت شخصی ذره |
gbest | بهترین موقعیت کل ازدحام |
v | سرعت |
x | موقعیت |
نقش وزن اینرسی در PSO
وزن اینرسی یا w مشخص میکند سرعت قبلی ذره تا چه اندازه در حرکت بعدی اثر داشته باشد.
مقدار بزرگتر w معمولاً حرکت گستردهتر و اکتشاف بیشتر ایجاد میکند. مقدار کوچکتر باعث تمرکز بیشتر ذرات در اطراف جوابهای فعلی میشود.
بهطور مفهومی:
wبزرگتر: Exploration بیشترwکوچکتر: Exploitation بیشتر
در بعضی پیادهسازیها، وزن اینرسی در طول اجرا کاهش پیدا میکند. الگوریتم در نسلهای ابتدایی فضای بزرگتری را بررسی میکند و در مراحل پایانی جستوجو را اطراف جوابهای خوب متمرکز میسازد.
یک رابطه خطی متداول برای کاهش وزن اینرسی چنین است:
w(t)=wmax−tT(wmax−wmin)w(t)=w_{\max}- \frac{t}{T} \left(w_{\max}-w_{\min}\right)
در این رابطه، T تعداد کل تکرارها است.
ضرایب شناختی و اجتماعی
ضریب شناختی c1
این ضریب تعیین میکند ذره تا چه اندازه به بهترین تجربه شخصی خود تمایل داشته باشد.
اگر c1 خیلی بزرگ باشد، هر ذره بیشتر بهصورت مستقل حرکت میکند و ممکن است هماهنگی گروه کاهش پیدا کند.
ضریب اجتماعی c2
این ضریب مشخص میکند ذره تا چه اندازه از بهترین جواب جمعی پیروی کند.
اگر c2 خیلی بزرگ باشد، ذرات ممکن است خیلی سریع دور یک جواب جمع شوند و الگوریتم دچار همگرایی زودرس شود.
تنظیم مناسب c1 و c2 به مسئله بستگی دارد و مقدار واحدی برای همه کاربردها وجود ندارد.
مراحل اجرای الگوریتم PSO
فرایند اجرای الگوریتم ازدحام ذرات به این صورت است:
- موقعیت اولیه ذرات بهصورت تصادفی ساخته میشود.
- برای هر ذره یک سرعت اولیه تعیین میشود.
- تابع هدف برای تمام ذرات محاسبه میشود.
pbestهر ذره مشخص میشود.- بهترین
pbestبهعنوانgbestانتخاب میشود. - سرعت ذرات بهروزرسانی میشود.
- موقعیت ذرات تغییر میکند.
- محدودیتهای فضای جستوجو اعمال میشوند.
- جوابهای جدید ارزیابی میشوند.
pbestوgbestبهروزرسانی میشوند.- مراحل تا رسیدن به شرط توقف تکرار میشوند.
شبهکد الگوریتم:
ساخت موقعیت و سرعت اولیه ذرات
برای هر ذره:
محاسبه تابع هدف
ذخیره موقعیت بهعنوان pbest
انتخاب بهترین ذره بهعنوان gbest
تا زمانی که شرط توقف برقرار نشده است:
برای هر ذره:
محاسبه سرعت جدید
محاسبه موقعیت جدید
اعمال محدودیتها
ارزیابی موقعیت جدید
اگر موقعیت جدید از pbest بهتر بود:
pbest را بهروزرسانی کن
gbest را بهروزرسانی کن
برگرداندن gbest
پیادهسازی PSO از صفر با پایتون
برای درک دقیق الگوریتم، ابتدا نسخه ساده آن را بدون کتابخانه تخصصی پیادهسازی میکنیم.
هدف، کمینهکردن تابع Rastrigin است:
f(x)=10n+∑i=1n(xi2−10cos(2πxi))f(x)=10n+\sum_{i=1}^{n} \left(x_i^2-10\cos(2\pi x_i)\right)
این تابع دارای کمینه سراسری در نقطه صفر است:
x = [0, 0, ..., 0]
f(x) = 0
وجود تعداد زیادی کمینه محلی، این تابع را به گزینه مناسبی برای آزمایش الگوریتمهای بهینهسازی تبدیل میکند.
نصب وابستگیها
pip install numpy
کد کامل الگوریتم
import numpy as np


def rastrigin(positions):
    dimensions = positions.shape[1]

    return (
        10 * dimensions
        + np.sum(
            positions ** 2
            - 10 * np.cos(2 * np.pi * positions),
            axis=1,
        )
    )


class ParticleSwarmOptimizer:
    def __init__(
        self,
        objective,
        dimensions,
        lower_bounds,
        upper_bounds,
        particles=40,
        iterations=200,
        inertia=0.72,
        cognitive=1.49,
        social=1.49,
        seed=42,
    ):
        self.objective = objective
        self.dimensions = dimensions
        self.lower_bounds = np.asarray(
            lower_bounds,
            dtype=float,
        )
        self.upper_bounds = np.asarray(
            upper_bounds,
            dtype=float,
        )

        self.particles = particles
        self.iterations = iterations
        self.inertia = inertia
        self.cognitive = cognitive
        self.social = social

        self.rng = np.random.default_rng(seed)

    def run(self):
        span = self.upper_bounds - self.lower_bounds

        positions = self.rng.uniform(
            self.lower_bounds,
            self.upper_bounds,
            size=(self.particles, self.dimensions),
        )

        velocities = self.rng.uniform(
            -0.1 * span,
            0.1 * span,
            size=(self.particles, self.dimensions),
        )

        scores = self.objective(positions)

        personal_best_positions = positions.copy()
        personal_best_scores = scores.copy()

        best_index = np.argmin(personal_best_scores)
        global_best_position = personal_best_positions[
            best_index
        ].copy()
        global_best_score = personal_best_scores[best_index]

        history = [float(global_best_score)]

        for _ in range(self.iterations):
            random_cognitive = self.rng.random(
                size=(self.particles, self.dimensions)
            )
            random_social = self.rng.random(
                size=(self.particles, self.dimensions)
            )

            cognitive_velocity = (
                self.cognitive
                * random_cognitive
                * (personal_best_positions - positions)
            )

            social_velocity = (
                self.social
                * random_social
                * (global_best_position - positions)
            )

            velocities = (
                self.inertia * velocities
                + cognitive_velocity
                + social_velocity
            )

            max_velocity = 0.2 * span

            velocities = np.clip(
                velocities,
                -max_velocity,
                max_velocity,
            )

            positions = positions + velocities

            positions = np.clip(
                positions,
                self.lower_bounds,
                self.upper_bounds,
            )

            scores = self.objective(positions)

            improved = scores < personal_best_scores

            personal_best_positions[improved] = positions[
                improved
            ]
            personal_best_scores[improved] = scores[improved]

            best_index = np.argmin(personal_best_scores)

            if (
                personal_best_scores[best_index]
                < global_best_score
            ):
                global_best_position = (
                    personal_best_positions[best_index].copy()
                )
                global_best_score = personal_best_scores[
                    best_index
                ]

            history.append(float(global_best_score))

        return {
            "best_position": global_best_position,
            "best_score": float(global_best_score),
            "history": history,
        }
اجرای الگوریتم
optimizer = ParticleSwarmOptimizer(
    objective=rastrigin,
    dimensions=2,
    lower_bounds=[-5.12, -5.12],
    upper_bounds=[5.12, 5.12],
    particles=50,
    iterations=250,
    seed=42,
)

result = optimizer.run()

print("Best position:", result["best_position"])
print("Best score:", result["best_score"])
خروجی باید موقعیتی نزدیک به [0, 0] و امتیازی نزدیک صفر نشان دهد.
به دلیل تصادفیبودن الگوریتم، نتیجه دقیق میتواند در اجراهای مختلف تغییر کند.
نمایش نمودار همگرایی
برای بررسی روند یادگیری میتوان بهترین امتیاز هر تکرار را رسم کرد:
pip install matplotlib
import matplotlib.pyplot as plt


plt.plot(result["history"])
plt.xlabel("Iteration")
plt.ylabel("Global Best Score")
plt.title("PSO Convergence")
plt.yscale("log")
plt.grid(True)
plt.show()
اگر منحنی خیلی زود ثابت شود، ممکن است الگوریتم دچار همگرایی زودرس شده باشد یا به تکرارهای بیشتری نیاز داشته باشد.
آموزش PSO با کتابخانه PySwarms
PySwarms یک ابزار پژوهشی متنباز برای پیادهسازی الگوریتم ازدحام ذرات در پایتون است و رابط سطح بالایی برای PSO ارائه میکند.
نصب:
pip install pyswarms
کد نمونه:
import numpy as np
import pyswarms as ps


def objective(positions):
    return np.sum(positions ** 2, axis=1)


dimensions = 3

bounds = (
    np.full(dimensions, -10.0),
    np.full(dimensions, 10.0),
)

options = {
    "c1": 1.49,
    "c2": 1.49,
    "w": 0.72,
}

optimizer = ps.single.GBestPSO(
    n_particles=40,
    dimensions=dimensions,
    options=options,
    bounds=bounds,
)

best_cost, best_position = optimizer.optimize(
    objective,
    iters=150,
)

print("Best cost:", best_cost)
print("Best position:", best_position)
مستندات PySwarms نمونههایی برای اجرای GBestPSO و LBestPSO روی توابع تکهدفه ارائه میکند.
بااینحال، مخزن اصلی PySwarms اعلام کرده است که دیگر بهصورت فعال نگهداری نمیشود و برای پروژههای جدید باید وضعیت سازگاری و وابستگیهای آن بررسی شود.
اجرای PSO با Scikit-opt
Scikit-opt مجموعهای از الگوریتمهای فراابتکاری مانند PSO، الگوریتم ژنتیک، تبرید شبیهسازیشده، کلونی مورچگان و Differential Evolution را ارائه میکند.
نصب:
pip install scikit-opt
مثال:
from sko.PSO import PSO


def objective(values):
    x, y, z = values

    return (
        x ** 2
        + (y - 0.05) ** 2
        + (z - 0.5) ** 2
    )


pso = PSO(
    func=objective,
    n_dim=3,
    pop=50,
    max_iter=200,
    lb=[-5, -5, -5],
    ub=[5, 5, 5],
    w=0.72,
    c1=1.49,
    c2=1.49,
)

pso.run()

print("Best position:", pso.gbest_x)
print("Best score:", pso.gbest_y)
مستندات Scikit-opt امکان افزودن محدودیتهای غیرخطی به PSO را نیز نشان میدهد.
GBest PSO و LBest PSO چه تفاوتی دارند؟
Global-best PSO
در GBestPSO همه ذرات از بهترین جواب کل ازدحام تأثیر میگیرند.
مزایا:
- همگرایی سریعتر
- ساختار ساده
- مناسب مسائل نسبتاً ساده
معایب:
- احتمال همگرایی زودرس
- کاهش سریع تنوع
- حساسیت بیشتر به جوابهای محلی
Local-best PSO
در LBestPSO هر ذره فقط از بهترین جواب همسایههای خود تأثیر میگیرد.
مزایا:
- حفظ تنوع بیشتر
- جستوجوی گستردهتر
- احتمال کمتر همگرایی زودرس
معایب:
- همگرایی کندتر
- نیاز به انتخاب توپولوژی همسایگی
برای مسائل چندقلهای یا Multimodal، نسخه Local-best گاهی عملکرد پایدارتری دارد.
Binary PSO چیست؟
PSO استاندارد معمولاً برای متغیرهای پیوسته طراحی شده است. اما بعضی مسائل به متغیرهای صفر و یک نیاز دارند.
برای مثال، در انتخاب ویژگی:
1 = ویژگی انتخاب شود
0 = ویژگی حذف شود
یک ذره میتواند چنین باشد:
[1, 0, 1, 1, 0, 0, 1]
در Binary PSO، سرعت مستقیماً به موقعیت افزوده نمیشود. ابتدا سرعت از یک تابع تبدیل مانند Sigmoid عبور میکند و سپس مقدار هر ژن بهصورت احتمالاتی صفر یا یک میشود:
S(v)=11+e−vS(v)=\frac{1}{1+e^{-v}}
سپس:
x={1اگر r<S(v)0در غیر این صورتx= \begin{cases} 1 & \text{اگر } r<S(v) \\ 0 & \text{در غیر این صورت} \end{cases}
کاربرد PSO در یادگیری ماشین
تنظیم ابرپارامترها
PSO میتواند برای انتخاب مقادیر مناسب پارامترهایی مانند موارد زیر استفاده شود:
- Learning Rate
- Dropout
- تعداد نورونها
- تعداد درختها
- عمق درخت
- ضریب منظمسازی
- پارامترهای SVM
- تعداد خوشهها
یک ذره برای مدل XGBoost میتواند چنین باشد:
[
  learning_rate,
  max_depth,
  subsample,
  colsample_bytree
]
تابع هدف نیز میتواند خطای اعتبارسنجی مدل باشد:
Objective = Validation Loss
انتخاب ویژگی
در انتخاب ویژگی، هر ذره مشخص میکند کدام ویژگیها وارد مدل شوند.
تابع هدف باید هم دقت و هم تعداد ویژگیها را در نظر بگیرد:
Objective=Error+λSelectedFeaturesAllFeaturesObjective = Error + \lambda \frac{SelectedFeatures}{AllFeatures}
به این ترتیب الگوریتم فقط بهدنبال دقت بالاتر نیست و مدل سادهتر را نیز ترجیح میدهد.
آموزش شبکه عصبی
امکان استفاده از PSO برای بهینهسازی وزنهای شبکه عصبی وجود دارد، اما برای شبکههای بزرگ معمولاً هزینه محاسباتی بسیار بالایی دارد.
روشهای گرادیانی مانند Adam و SGD برای آموزش متعارف شبکههای عمیق مناسبتر هستند. PSO بیشتر برای مواردی مانند تنظیم ابرپارامترها، طراحی معماری یا مسائل کوچک بدون مشتق بررسی میشود.
خوشهبندی
در خوشهبندی، موقعیت هر ذره میتواند مختصات مراکز خوشهها را نمایش دهد. تابع هدف نیز مجموع فاصله نمونهها از نزدیکترین مرکز است.
این روش میتواند برای بهبود نقطه شروع K-Means استفاده شود.
برای مطالعه مفاهیم خوشهبندی، مقاله یادگیری بدون نظارت، K-Means و PCA را بخوانید.
کاربرد PSO در برنامههای متصل به مدلهای هوش مصنوعی
یک برنامه مبتنی بر مدل زبانی ممکن است چند پارامتر قابلتنظیم داشته باشد:
- Temperature
- Top P
- حداکثر طول خروجی
- تعداد نتایج بازیابیشده در RAG
- حداقل امتیاز شباهت
- وزن جستوجوی معنایی
- وزن جستوجوی لغوی
- آستانه ارسال درخواست به مدل قویتر
هر ذره میتواند یک ترکیب از این پارامترها باشد:
[
  temperature,
  top_p,
  max_tokens,
  retrieval_top_k,
  semantic_weight,
  routing_threshold
]
تابع هدف نیز میتواند ترکیبی از کیفیت، هزینه و زمان پاسخ باشد:
Objective=(1−Quality)+αCost+βLatency+γErrorRateObjective = (1-Quality) +\alpha Cost +\beta Latency +\gamma ErrorRate
از آنجا که PSO معمولاً مسئله کمینهسازی را حل میکند، کاهش مقدار این تابع به معنای بهترشدن تنظیمات خواهد بود.
مثال واقعی: بهینهسازی تنظیمات RAG
فرض کنید یک دستیار سازمانی از جستوجوی ترکیبی استفاده میکند و باید این پارامترها تنظیم شوند:
- تعداد قطعات بازیابیشده: ۲ تا ۱۲
- وزن جستوجوی معنایی: صفر تا یک
- حداقل امتیاز شباهت: ۰٫۳ تا ۰٫۹
- Temperature: صفر تا ۰٫۷
موقعیت یک ذره:
[top_k, semantic_weight, min_score, temperature]
نمونه:
[6.8, 0.72, 0.61, 0.18]
از آنجا که top_k باید عدد صحیح باشد، قبل از استفاده گرد میشود:
top_k = int(round(position[0]))
تابع هدف باید این تنظیمات را روی یک مجموعه ثابت از پرسشها اجرا کند و موارد زیر را بسنجد:
- صحت پاسخ
- کیفیت استناد
- نرخ پاسخ بدون مدرک
- زمان پاسخ
- هزینه مصرف توکن
اتصال PSO به API درواره
API درواره با ساختار OpenAI سازگار است. بنابراین میتوان مدلهای در دسترس را از طریق یک Client مشترک ارزیابی کرد.
نصب کتابخانهها:
pip install openai numpy scikit-opt
تنظیم متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
ساخت Client:
import os

from openai import OpenAI


client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)

MODEL_ID = os.environ["DARVAREH_MODEL"]
تابع تولید پاسخ
def generate_answer(
    question,
    temperature,
    top_p,
    max_tokens,
):
    response = client.chat.completions.create(
        model=MODEL_ID,
        temperature=float(temperature),
        top_p=float(top_p),
        max_tokens=int(round(max_tokens)),
        messages=[
            {
                "role": "system",
                "content": (
                    "به پرسش کاربر به زبان فارسی، دقیق، "
                    "کوتاه و بدون اطلاعات حدسی پاسخ بده."
                ),
            },
            {
                "role": "user",
                "content": question,
            },
        ],
    )

    return response.choices[0].message.content or ""
مجموعه ارزیابی
EVAL_SET = [
{
"question": "API چیست؟",
"required_terms": ["نرمافزار", "درخواست"],
},
{
"question": "توکن در مدل زبانی چیست؟",
"required_terms": ["متن", "پردازش"],
},
{
"question": "Temperature چه اثری دارد؟",
"required_terms": ["تصادفی", "پاسخ"],
},
]
امتیازدهی قطعی ساده
def score_answer(answer, required_terms):
    if not answer.strip():
        return 0.0

    term_score = sum(
        term in answer
        for term in required_terms
    ) / len(required_terms)

    length_score = (
        1.0
        if 80 <= len(answer) <= 700
        else 0.5
    )

    return (
        0.8 * term_score
        + 0.2 * length_score
    )
تابع هدف PSO
کتابخانه Scikit-opt در این مثال هر موقعیت را جداگانه به تابع هدف میدهد:
from functools import lru_cache

from sko.PSO import PSO


@lru_cache(maxsize=500)
def evaluate_cached(
    temperature,
    top_p,
    max_tokens,
):
    scores = []

    for item in EVAL_SET:
        answer = generate_answer(
            question=item["question"],
            temperature=temperature,
            top_p=top_p,
            max_tokens=max_tokens,
        )

        scores.append(
            score_answer(
                answer,
                item["required_terms"],
            )
        )

    mean_score = sum(scores) / len(scores)

    estimated_length_penalty = max_tokens / 10_000

    return (
        1 - mean_score
        + estimated_length_penalty
    )


def objective(position):
    temperature = round(float(position[0]), 2)
    top_p = round(float(position[1]), 2)
    max_tokens = int(round(position[2] / 25) * 25)

    return evaluate_cached(
        temperature,
        top_p,
        max_tokens,
    )
اجرای بهینهسازی
pso = PSO(
    func=objective,
    n_dim=3,
    pop=8,
    max_iter=6,
    lb=[0.0, 0.3, 100],
    ub=[0.8, 1.0, 600],
    w=0.72,
    c1=1.49,
    c2=1.49,
)

pso.run()

print("Best parameters:", pso.gbest_x)
print("Best objective:", pso.gbest_y)
تعداد ذرات و تکرارها در این مثال عمداً کم انتخاب شده است؛ زیرا هر ارزیابی چند درخواست API ایجاد میکند.
در پروژه عملی باید تعداد تقریبی درخواستها را محاسبه کنید:
درخواستهای تقریبی =
تعداد ذرات × تعداد تکرارها × تعداد نمونههای ارزیابی
برای مثال:
۸ × ۶ × ۳ = ۱۴۴ درخواست
نکات مهم برای ارزیابی مدلهای زبانی با PSO
پاسخها را Cache کنید
ممکن است چند ذره به تنظیمات یکسان یا بسیار مشابه برسند. ذخیره نتایج از درخواستهای تکراری جلوگیری میکند.
مجموعه ارزیابی ثابت داشته باشید
اگر پرسشهای ارزیابی در هر مرحله تغییر کنند، مقایسه ذرات معتبر نخواهد بود.
فقط از مدل داور استفاده نکنید
امتیاز مدل داور میتواند ناپایدار یا دارای سوگیری باشد. معیارهای قطعی، ارزیابی انسانی و شاخصهای عملیاتی را نیز وارد تابع هدف کنید.
نوسان خروجی را اندازه بگیرید
یک تنظیم را چند بار اجرا کنید. میانگین و پراکندگی امتیازها از یک اجرای تصادفی قابلاعتمادتر است.
از مجموعه آزمایش جداگانه استفاده کنید
اگر تمام تصمیمها بر اساس یک مجموعه محدود گرفته شوند، تنظیمات به همان نمونهها بیشبرازش پیدا میکنند.
بودجه را محدود کنید
حداکثر تعداد ارزیابی، زمان اجرا و هزینه مجاز را پیش از شروع مشخص کنید.
برای طراحی ارزیابی استاندارد، مقاله ارزیابی مدلهای هوش مصنوعی و Evals را مطالعه کنید.
مدیریت محدودیتها در PSO
مسائل واقعی معمولاً دارای محدودیت هستند. برای مثال:
- هزینه باید کمتر از مقدار مشخصی باشد.
- مجموع تخصیص منابع باید ۱۰۰ درصد شود.
- زمان پاسخ نباید از دو ثانیه بیشتر شود.
- بعضی متغیرها باید عدد صحیح باشند.
محدودکردن موقعیت
سادهترین روش، نگهداشتن موقعیت در بازه مجاز است:
positions = np.clip(
    positions,
    lower_bounds,
    upper_bounds,
)
تابع جریمه
اگر جواب محدودیتی را نقض کند، مقدار جریمه به تابع هدف اضافه میشود:
Objectivefinal=Objective+λPenaltyObjective_{final} = Objective + \lambda Penalty
مثال:
def objective(position):
    quality = calculate_quality(position)
    cost = calculate_cost(position)

    penalty = 0.0

    if cost > 0.03:
        penalty += (cost - 0.03) * 1000

    return (1 - quality) + penalty
اصلاح جواب
در بعضی مسائل میتوان جواب نامعتبر را به نزدیکترین جواب معتبر تبدیل کرد.
برای مثال، اگر درصدهای تخصیص باید مجموعاً ۱۰۰ شوند:
weights = position / position.sum()
شرط توقف در PSO
اجرای الگوریتم میتواند با یکی از شرایط زیر متوقف شود:
- رسیدن به حداکثر تعداد تکرار
- رسیدن تابع هدف به مقدار مشخص
- ثابتماندن
gbestبرای چند تکرار - کوچکشدن تغییر موقعیت ذرات
- پایان بودجه زمانی
- پایان بودجه محاسباتی یا API
- کاهش تنوع ازدحام به کمتر از یک آستانه
در برنامههای متصل به API، محدودیت تعداد ارزیابی و هزینه از مهمترین شرایط توقف است.
همگرایی زودرس در PSO چیست؟
همگرایی زودرس زمانی رخ میدهد که ذرات خیلی سریع اطراف یک جواب نهچندان مناسب جمع شوند و توانایی جستوجوی بخشهای دیگر فضا را از دست بدهند.
نشانهها:
- فاصله ذرات از یکدیگر بسیار کم میشود.
gbestبرای مدت طولانی تغییر نمیکند.- سرعت ذرات به مقادیر بسیار کوچک میرسد.
- اجرای الگوریتم با Seedهای مختلف نتایج بسیار متفاوتی میدهد.
راهکارها:
- افزایش تعداد ذرات
- استفاده از
LBestPSO - کاهش ضریب اجتماعی
- افزایش اکتشاف در مراحل ابتدایی
- استفاده از وزن اینرسی کاهشی
- مقداردهی مجدد بخشی از ذرات
- اجرای چندباره با Seedهای مختلف
- استفاده از مدلهای ترکیبی PSO و الگوریتم ژنتیک
تفاوت PSO با الگوریتم ژنتیک
| ویژگی | PSO | الگوریتم ژنتیک |
|---|---|---|
| واحد اصلی | ذره | کروموزوم |
| سازوکار حرکت | موقعیت و سرعت | انتخاب، ترکیب و جهش |
| حافظه فردی | دارد | معمولاً ندارد |
| Crossover | ندارد | دارد |
| Mutation کلاسیک | ندارد | دارد |
| مناسب متغیر پیوسته | بسیار مناسب | مناسب |
| مناسب ترتیب و ساختار گسسته | نیازمند تغییر | معمولاً مناسبتر |
| تعداد پارامترها | نسبتاً کم | بیشتر |
| سرعت همگرایی | اغلب سریع | وابسته به طراحی |
| خطر همگرایی زودرس | دارد | دارد |
PSO برای مسائل پیوسته معمولاً سادهتر است. الگوریتم ژنتیک در مسائل گسسته، ترتیبی یا دارای ساختار ترکیبی انعطاف بیشتری دارد.
برای مقایسه دقیقتر، مقاله الگوریتم ژنتیک چیست؟ را مطالعه کنید.
تفاوت PSO با Gradient Descent
| ویژگی | PSO | Gradient Descent |
|---|---|---|
| نیاز به مشتق | ندارد | دارد |
| تعداد جوابهای همزمان | چند ذره | معمولاً یک نقطه |
| تابع ناپیوسته | قابلاستفاده | مشکلساز |
| متغیر دستهای | با تبدیل مناسب | معمولاً نامناسب |
| هزینه ارزیابی | بالا | معمولاً کمتر |
| مناسب شبکه عمیق | بیشتر برای تنظیمات | مناسب آموزش وزنها |
| تضمین بهینه سراسری | ندارد | ندارد |
اگر تابع هدف مشتقپذیر باشد و تعداد پارامترها بسیار زیاد باشد، روشهای گرادیانی معمولاً انتخاب مناسبتری هستند.
تفاوت PSO با Random Search
Random Search هر جواب را مستقل از نتایج قبلی انتخاب میکند. PSO از بهترین تجربه فردی و جمعی برای هدایت جستوجو استفاده میکند.
بااینحال، Random Search باید بهعنوان خط مبنا آزمایش شود. اگر PSO نسبت به Random Search بهبود معناداری ایجاد نکند، پیچیدگی بیشتر آن توجیه ندارد.
تفاوت PSO با بهینهسازی بیزی
بهینهسازی بیزی از یک مدل جانشین برای تخمین تابع هدف استفاده میکند و تلاش میکند نقاطی را انتخاب کند که بیشترین اطلاعات یا بهبود مورد انتظار را ایجاد میکنند.
بهینهسازی بیزی معمولاً زمانی مناسبتر است که هر ارزیابی بسیار پرهزینه باشد. PSO ممکن است به ارزیابیهای بیشتری نیاز داشته باشد، اما اجرای موازی آن سادهتر است.
برای تنظیم پرهزینه مدلهای زبانی، مقایسه PSO با روش بیزی ضروری است.
مزایای الگوریتم ازدحام ذرات
- پیادهسازی نسبتاً ساده
- تعداد پارامترهای محدود
- عدم نیاز به محاسبه مشتق
- امکان اجرای موازی ارزیابی ذرات
- مناسب برای توابع غیرخطی
- مناسب برای مسائل Black-box
- قابلیت ترکیب با روشهای دیگر
- مناسب برای فضای پیوسته
- استفاده از تجربه فردی و جمعی
محدودیتهای PSO
- تضمینی برای پیدا کردن بهینه سراسری ندارد.
- ممکن است زودتر از موعد همگرا شود.
- در ابعاد بسیار بالا به ارزیابیهای زیادی نیاز دارد.
- برای متغیرهای دستهای و ترتیبی نیازمند تغییر است.
- نتیجه به پارامترهای
w،c1وc2حساس است. - در توابع پرنویز ممکن است
pbestوgbestگمراهکننده باشند. - هزینه آن برای تابع هدف مبتنی بر API میتواند زیاد باشد.
تنظیم پارامترهای PSO
اعداد زیر فقط نقطه شروع آزمایش هستند و نباید بهعنوان قانون ثابت در نظر گرفته شوند:
| پارامتر | محدوده ابتدایی پیشنهادی |
|---|---|
| تعداد ذرات | ۲۰ تا ۱۰۰ |
وزن اینرسی w | ۰٫۴ تا ۰٫۹ |
ضریب شناختی c1 | ۱ تا ۲٫۵ |
ضریب اجتماعی c2 | ۱ تا ۲٫۵ |
| تعداد تکرار | ۵۰ تا ۵۰۰ |
| سقف سرعت | ۱۰ تا ۳۰ درصد دامنه متغیر |
برای تابع هدف پرهزینه، ابتدا از تعداد ذرات و تکرارهای کوچک استفاده کنید.
ارزیابی صحیح نتیجه PSO
فقط نمایش بهترین جواب یک اجرا کافی نیست. بهتر است موارد زیر گزارش شوند:
- بهترین مقدار تابع هدف
- میانگین نتیجه چند اجرا
- انحراف معیار
- تعداد ارزیابیهای تابع هدف
- زمان کل اجرا
- نمودار همگرایی
- تنوع ذرات
- درصد جوابهای نامعتبر
- مقایسه با Random Search
- مقایسه با الگوریتم ژنتیک یا روش بیزی
استفاده از Seed ثابت برای بازتولید آزمایش مفید است، اما کیفیت الگوریتم باید با چند Seed متفاوت نیز سنجیده شود.
اشتباهات رایج در استفاده از PSO
تعریف نادرست تابع هدف
الگوریتم چیزی را بهینه میکند که اندازهگیری شده است، نه هدفی را که طراح در ذهن دارد.
استفاده از دامنههای بسیار بزرگ
فضای جستوجوی غیرضروری بزرگ، تعداد ارزیابیهای موردنیاز را افزایش میدهد.
تبدیل نادرست متغیرهای صحیح
اگر max_tokens یا top_k باید عدد صحیح باشد، تبدیل و گردکردن آن باید پیش از ارزیابی انجام شود.
بیتوجهی به مقیاس متغیرها
اگر یک متغیر بین صفر و یک و متغیر دیگر بین صفر تا یک میلیون باشد، حرکت ذرات میتواند نامتعادل شود. نرمالسازی متغیرها معمولاً مفید است.
ارزیابی فقط یک اجرا
ماهیت PSO تصادفی است. نتیجه باید در چند اجرای مستقل ارزیابی شود.
استفاده از تعداد ذرات زیاد برای API
اگر Fitness شامل فراخوانی API باشد، جمعیت بزرگ میتواند هزینه و زمان اجرا را بهشدت افزایش دهد.
نادیدهگرفتن نویز
در مدلهای مولد، یک تنظیم یکسان ممکن است خروجیهای متفاوت تولید کند. ارزیابی چندباره یا استفاده از معیار مقاوم ضروری است.
انتخاب PSO بدون خط مبنا
همیشه نتیجه را با یک روش ساده مانند Random Search مقایسه کنید.
چه زمانی از PSO استفاده کنیم؟
PSO زمانی گزینه مناسبی است که:
- تابع هدف مشتق مشخصی ندارد.
- متغیرها عمدتاً پیوسته هستند.
- تابع هدف Black-box است.
- ارزیابیها را میتوان موازی کرد.
- چند کمینه محلی وجود دارد.
- فضای جستوجو متوسط و کنترلشده است.
- یک جواب بسیار خوب کافی است و اثبات بهینگی لازم نیست.
PSO احتمالاً انتخاب مناسبی نیست اگر:
- تابع مشتقپذیر و روش گرادیانی کارآمد است.
- هر ارزیابی بسیار گران است.
- متغیرها عمدتاً رشتهای یا ترتیبی هستند.
- فضای جستوجو ابعاد بسیار زیادی دارد.
- تضمین ریاضی برای جواب بهینه لازم است.
- محدودیتها بسیار پیچیدهاند و جوابهای معتبر کمی وجود دارند.
پرسشهای متداول
PSO مخفف چیست؟
PSO مخفف Particle Swarm Optimization و به معنای الگوریتم بهینهسازی ازدحام ذرات است.
الگوریتم ازدحام ذرات به زبان ساده چیست؟
PSO مجموعهای از جوابهای احتمالی را در فضای جستوجو حرکت میدهد. هر جواب از بهترین تجربه خودش و بهترین تجربه گروه استفاده میکند تا به ناحیههای مناسبتر برسد.
آیا PSO نوعی هوش مصنوعی است؟
PSO یکی از الگوریتمهای هوش ازدحامی و بهینهسازی فراابتکاری است. این الگوریتم میتواند مستقلاً یا در کنار مدلهای یادگیری ماشین و سیستمهای هوش مصنوعی استفاده شود.
آیا PSO به داده آموزشی نیاز دارد؟
خود الگوریتم به داده آموزشی نیاز ندارد، اما به تابع هدف احتیاج دارد. اگر هدف تنظیم یک مدل یادگیری ماشین باشد، داده آموزش، اعتبارسنجی و آزمایش لازم خواهد بود.
آیا PSO بهترین جواب را تضمین میکند؟
خیر. PSO یک روش احتمالاتی است و تضمینی برای پیدا کردن بهینه سراسری ندارد.
بهترین کتابخانه PSO در پایتون چیست؟
PySwarms و Scikit-opt از ابزارهای شناختهشده هستند. PySwarms رابط تخصصی PSO دارد، اما مخزن اصلی آن دیگر بهصورت فعال نگهداری نمیشود. برای پروژه حساس، وضعیت نگهداری، نسخه پایتون و وابستگیها را پیش از انتخاب بررسی کنید.
آیا PSO برای تنظیم مدل زبانی مناسب است؟
برای تنظیم پارامترهای عددی مانند Temperature، Top P، تعداد نتایج بازیابی و آستانههای مسیریابی قابلاستفاده است. بااینحال، هزینه ارزیابی باید کنترل و نتیجه با Random Search و روش بیزی مقایسه شود.
آیا میتوان PSO را به API درواره متصل کرد؟
بله. تابع هدف میتواند تنظیمات هر ذره را به یک درخواست API تبدیل و کیفیت، هزینه و زمان پاسخ را اندازهگیری کند. استفاده از Cache، مجموعه ارزیابی ثابت و محدودیت تعداد درخواست ضروری است.
تفاوت اصلی PSO و الگوریتم ژنتیک چیست؟
PSO ذرات را با موقعیت و سرعت حرکت میدهد، اما الگوریتم ژنتیک با انتخاب، Crossover و Mutation نسل جدیدی از جوابها میسازد.
جمعبندی
الگوریتم ازدحام ذرات یا PSO یک روش جمعیتمحور برای حل مسائل بهینهسازی است که از حرکت هماهنگ موجودات گروهی الهام گرفته شده است.
هر ذره یک جواب احتمالی است و حرکت آن تحتتأثیر سه عامل قرار دارد:
- سرعت قبلی
- بهترین تجربه شخصی
- بهترین تجربه جمعی
PSO به محاسبه مشتق نیاز ندارد و برای مسائل پیوسته، غیرخطی و Black-box مناسب است. این الگوریتم را میتوان برای تنظیم ابرپارامترهای یادگیری ماشین، انتخاب ویژگی، خوشهبندی و بهینهسازی پارامترهای برنامههای مبتنی بر مدلهای هوش مصنوعی استفاده کرد.
برای استفاده صحیح از PSO باید:
- تابع هدف مناسبی تعریف کنید.
- دامنه متغیرها را محدود کنید.
- متغیرها را در صورت نیاز نرمالسازی کنید.
- تعادل اکتشاف و بهرهبرداری را حفظ کنید.
- چند اجرای مستقل انجام دهید.
- نتیجه را با روشهای سادهتر مقایسه کنید.
- هزینه ارزیابی را کنترل کنید.
- جواب نهایی را روی داده آزمایش مستقل بسنجید.
برای ساخت برنامههای هوش مصنوعی و آزمایش مدلهای مختلف میتوانید از مستندات API درواره شروع کنید.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
API درواره با ساختار OpenAI سازگار است و امکان اتصال یکپارچه برنامهها به مدلهای مختلف را فراهم میکند.
مقالات مرتبط
- الگوریتم ژنتیک چیست؟
- یادگیری ماشین چیست؟
- یادگیری بدون نظارت، K-Means و PCA
- یادگیری تقویتی، Q-Learning و RLHF
- ارزیابی مدلهای هوش مصنوعی و Evals
- مسیریابی هوشمند میان مدلهای هوش مصنوعی
- معماری چندمدلی و چندارائهدهنده
- راهنمای API سازگار با OpenAI
منابع
- مقاله اصلی Particle Swarm Optimization در IEEE
- PySwarms Documentation
- PySwarms Basic Optimization
- PySwarms GitHub Repository
- PySwarms در Journal of Open Source Software
- Scikit-opt Documentation
- Scikit-opt GitHub Repository
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.