
رگرسیون خطی چیست؟ آموزش Linear Regression با پایتون و Scikit-learn
رگرسیون خطی یکی از پرکاربردترین الگوریتمهای یادگیری ماشین برای پیشبینی مقادیر عددی است. در این راهنما، Linear Regression را با پایتون، Scikit-learn، دادههای واقعی، معیارهای ارزیابی و یک نمونه ترکیبی با API درواره میآموزید.

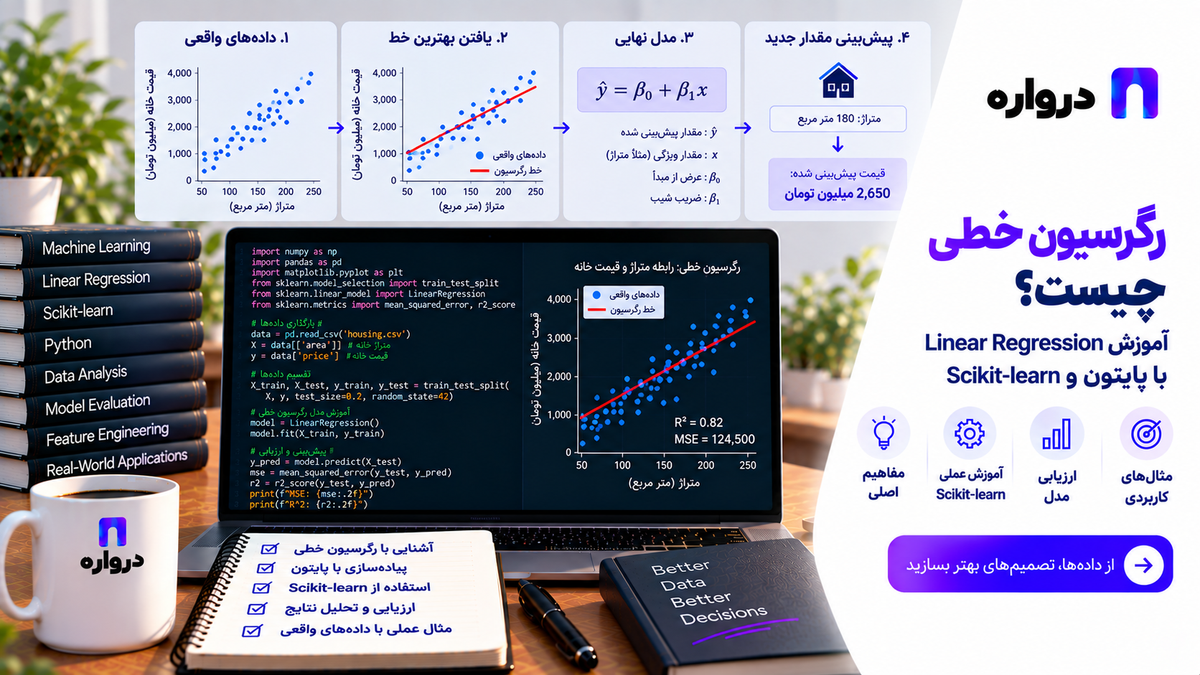
رگرسیون خطی یا Linear Regression یکی از بنیادیترین الگوریتمهای یادگیری ماشین و تحلیل داده است. از این روش برای پیشبینی یک مقدار عددی بر اساس یک یا چند ویژگی استفاده میشود.
برای مثال، با رگرسیون خطی میتوان موارد زیر را تخمین زد:
- میزان فروش ماه آینده
- قیمت تقریبی یک ملک
- مدت زمان انجام یک پروژه
- هزینه مصرف API
- تعداد درخواستهای پشتیبانی
- درآمد احتمالی یک مشتری
- مصرف انرژی ساختمان
- مدت زمان پاسخگویی یک سرویس
رگرسیون خطی فقط یک موضوع دانشگاهی نیست. این الگوریتم به دلیل سرعت بالا، تفسیرپذیری و پیادهسازی ساده، همچنان یکی از مدلهای پایه مهم در پروژههای واقعی داده و هوش مصنوعی محسوب میشود.
در این مقاله، رگرسیون خطی را بدون استفاده از فرمولهای ریاضی پیچیده توضیح میدهیم و چند نمونه عملی آن را با پایتون، Pandas و Scikit-learn پیادهسازی میکنیم.
رگرسیون چیست؟
رگرسیون یکی از روشهای یادگیری نظارتشده است که برای پیشبینی مقدار عددی استفاده میشود.
در یادگیری نظارتشده، مجموعهای از نمونههای قبلی در اختیار مدل قرار میگیرد. هر نمونه شامل ویژگیهای ورودی و خروجی واقعی است. مدل تلاش میکند رابطه میان ورودیها و خروجی را یاد بگیرد و سپس برای داده جدید مقدار احتمالی خروجی را پیشبینی کند.
برای مثال، دادههای یک فروشگاه ممکن است شامل این ستونها باشند:
| هزینه تبلیغات | تعداد بازدید | تعداد مشتری قبلی | فروش |
|---|---|---|---|
| ۲۰ | ۳۰۰۰ | ۱۲۰ | ۸۵ |
| ۳۰ | ۴۵۰۰ | ۱۸۰ | ۱۲۵ |
| ۴۵ | ۷۰۰۰ | ۲۴۰ | ۱۸۰ |
در این جدول، هزینه تبلیغات، تعداد بازدید و تعداد مشتری قبلی ویژگیهای ورودی هستند. فروش، متغیر هدفی است که میخواهیم آن را پیشبینی کنیم.
اگر خروجی موردنظر یک گروه مانند «موفق» یا «ناموفق» باشد، مسئله طبقهبندی است. اگر خروجی یک عدد مانند فروش، قیمت یا زمان باشد، مسئله رگرسیون است.
رگرسیون خطی چیست؟
رگرسیون خطی تلاش میکند رابطه میان ویژگیهای ورودی و مقدار هدف را با یک الگوی خطی نمایش دهد.
به زبان ساده، مدل بررسی میکند که تغییر هر ویژگی معمولاً چه اثری بر خروجی دارد.
فرض کنید بخواهیم فروش را فقط بر اساس هزینه تبلیغات پیشبینی کنیم. اگر با افزایش هزینه تبلیغات، فروش نیز تقریباً با یک روند مشخص افزایش یابد، رگرسیون خطی میتواند خطی پیدا کند که این روند را توضیح دهد.
در دادههای چندمتغیره، مدل همزمان اثر چند ویژگی را بررسی میکند. برای مثال، فروش ممکن است علاوه بر تبلیغات، به فصل، تعداد بازدید، قیمت محصول و تخفیف نیز وابسته باشد.
کلاس LinearRegression در Scikit-learn، رگرسیون خطی با روش حداقل مربعات معمولی را پیادهسازی میکند. هدف آن پیدا کردن ضرایبی است که اختلاف میان مقادیر واقعی و پیشبینیشده را تا حد ممکن کاهش دهند.
تفاوت رگرسیون خطی ساده و چندمتغیره
رگرسیون خطی ساده
در رگرسیون خطی ساده فقط یک ویژگی ورودی وجود دارد.
مثال:
- ورودی: هزینه تبلیغات
- خروجی: فروش
یا:
- ورودی: متراژ خانه
- خروجی: قیمت خانه
رگرسیون خطی چندمتغیره
در رگرسیون خطی چندمتغیره، چند ویژگی برای پیشبینی استفاده میشوند.
مثال پیشبینی قیمت ملک با این ویژگیها:
- متراژ
- سن بنا
- تعداد اتاق
- طبقه
- محله
- آسانسور
- پارکینگ
در پروژههای واقعی، رگرسیون چندمتغیره رایجتر است؛ زیرا خروجی معمولاً تحت تأثیر چند عامل قرار دارد.
رگرسیون خطی چگونه کار میکند؟
فرایند کلی رگرسیون خطی را میتوان در چند مرحله خلاصه کرد:
۱. ویژگیهای ورودی و مقدار هدف مشخص میشوند.
۲. دادهها به بخش آموزش و آزمایش تقسیم میشوند.
۳. مدل رابطه میان ورودیها و خروجی را از داده آموزشی یاد میگیرد.
۴. مدل برای دادههای آزمایشی پیشبینی انجام میدهد.
۵. اختلاف پیشبینیها با مقادیر واقعی اندازهگیری میشود.
۶. اگر کیفیت مناسب نباشد، دادهها، ویژگیها یا نوع مدل اصلاح میشوند.
مدل برای هر ویژگی یک ضریب یاد میگیرد. علامت و اندازه این ضریب نشان میدهد که افزایش آن ویژگی، در شرایط ثابت بودن سایر ویژگیها، معمولاً چه ارتباطی با افزایش یا کاهش خروجی دارد.
ضریب و عرض از مبدأ در رگرسیون خطی
پس از آموزش مدل، دو نوع اطلاعات اصلی در اختیار ما قرار میگیرد:
ضرایب ویژگیها
هر ویژگی یک ضریب دارد. ضریب مثبت نشان میدهد افزایش آن ویژگی با افزایش خروجی ارتباط دارد. ضریب منفی نشاندهنده ارتباط معکوس است.
برای مثال، در یک مدل پیشبینی فروش:
- ضریب مثبت تعداد بازدید میتواند نشان دهد بازدید بیشتر با فروش بیشتر همراه است.
- ضریب منفی قیمت میتواند نشان دهد افزایش قیمت با کاهش فروش ارتباط دارد.
این نتایج فقط ارتباط آماری در داده را نشان میدهند و لزوماً رابطه علت و معلولی را ثابت نمیکنند.
مقدار پایه
مدل یک مقدار پایه نیز یاد میگیرد. این مقدار، نقطه شروع پیشبینی قبل از اعمال اثر ویژگیها است.
در بعضی پروژهها مقدار پایه بهتنهایی تفسیر تجاری مفیدی ندارد؛ بهویژه زمانی که مقدار صفر برای ویژگیها در داده واقعی امکانپذیر نیست.
کاربردهای رگرسیون خطی
رگرسیون خطی در حوزههای متنوعی استفاده میشود.
پیشبینی فروش
میتوان فروش را بر اساس تبلیغات، قیمت، تخفیف، تعداد بازدید و سابقه فروش تخمین زد.
پیشبینی قیمت
قیمت ملک، خودرو، خدمات یا محصول میتواند با توجه به مشخصات آن پیشبینی شود.
برآورد هزینه پروژه
مدت اجرا، تعداد اعضای تیم، پیچیدگی و حجم کار میتوانند برای تخمین هزینه پروژه استفاده شوند.
پیشبینی مصرف API
در یک محصول هوش مصنوعی میتوان هزینه یا تعداد توکن مصرفی را با توجه به تعداد کاربران، تعداد درخواستها، طول ورودی و نوع قابلیت تخمین زد.
تحلیل عوامل مؤثر بر عملکرد
ضرایب مدل میتوانند تصویری اولیه از جهت اثر ویژگیها ارائه دهند.
پیشبینی تقاضا
میزان تقاضا را میتوان بر اساس فصل، قیمت، تبلیغات و رفتار گذشته بررسی کرد.
تفاوت رگرسیون خطی و رگرسیون لجستیک
با وجود شباهت نام، این دو الگوریتم برای اهداف متفاوتی استفاده میشوند.
| ویژگی | رگرسیون خطی | رگرسیون لجستیک |
|---|---|---|
| نوع خروجی | مقدار عددی | کلاس یا احتمال تعلق به کلاس |
| نمونه کاربرد | پیشبینی فروش | تشخیص ریزش مشتری |
| نوع مسئله | رگرسیون | طبقهبندی |
| نمونه خروجی | ۱۲۵ میلیون تومان | مشتری در معرض ریزش است |
اگر هدف پیشبینی یک عدد پیوسته است، رگرسیون خطی مناسبتر است. اگر هدف انتخاب یک گروه یا کلاس است، باید یک الگوریتم طبقهبندی مانند رگرسیون لجستیک بررسی شود.
نصب کتابخانههای موردنیاز
برای اجرای مثالها، کتابخانههای زیر را نصب کنید:
pip install numpy pandas scikit-learn matplotlib joblib openai
اولین مثال رگرسیون خطی با پایتون
در این مثال، فروش را بر اساس هزینه تبلیغات پیشبینی میکنیم.
import pandas as pd

from sklearn.linear_model import LinearRegression


data = pd.DataFrame(
    {
        "advertising": [
            10,
            15,
            20,
            25,
            30,
            35,
            40,
            45,
        ],
        "sales": [
            48,
            61,
            73,
            86,
            98,
            112,
            124,
            139,
        ],
    }
)

X = data[["advertising"]]
y = data["sales"]

model = LinearRegression()
model.fit(X, y)

prediction = model.predict(
    pd.DataFrame(
        {
            "advertising": [50],
        }
    )
)

print(
    "Predicted sales:",
    round(prediction[0], 2),
)

print(
    "Coefficient:",
    model.coef_[0],
)

print(
    "Intercept:",
    model.intercept_,
)
در این کد:
- ستون
advertisingویژگی ورودی است. - ستون
salesمقدار هدف است. - متد
fitمدل را آموزش میدهد. - متد
predictفروش احتمالی را برای بودجه تبلیغاتی جدید محاسبه میکند. - ویژگی
coef_ضریب یادگرفتهشده را برمیگرداند. - ویژگی
intercept_مقدار پایه مدل را نشان میدهد.
این مثال برای آموزش مفهوم است. در پروژه واقعی، نباید مدل را با چند نمونه محدود و بدون مجموعه آزمایشی استفاده کرد.
تقسیم داده به آموزش و آزمایش
برای ارزیابی واقعی، باید بخشی از دادهها را از فرایند آموزش جدا کنیم.
from sklearn.model_selection import train_test_split


X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.25,
        random_state=42,
    )
)

model = LinearRegression()

model.fit(
    X_train,
    y_train,
)

predictions = model.predict(
    X_test
)
داده آموزشی برای یادگیری مدل استفاده میشود. داده آزمایشی فقط برای ارزیابی نهایی به کار میرود.
اگر عملکرد مدل را روی همان دادهای بسنجیم که با آن آموزش دیده است، نتیجه ممکن است بیش از حد خوشبینانه باشد.
معیارهای ارزیابی رگرسیون خطی
برای ارزیابی مدلهای رگرسیون چند معیار پرکاربرد وجود دارد.
میانگین خطای مطلق یا MAE
این معیار میانگین فاصله مطلق میان پیشبینی و مقدار واقعی را نشان میدهد.
اگر هدف بر حسب میلیون تومان باشد، مقدار MAE نیز با همان واحد قابل تفسیر است. به همین دلیل، MAE برای توضیح نتیجه به مدیر یا کارشناس کسبوکار مناسب است.
مقدار کمتر نشاندهنده خطای کمتر است و بهترین حالت آن صفر خواهد بود.
میانگین مربعات خطا یا MSE
در این معیار، خطاهای بزرگ اثر بیشتری بر نتیجه دارند. بنابراین اگر پیشبینیهای بسیار اشتباه برای پروژه مهم باشند، MSE میتواند معیار مفیدی باشد.
ریشه میانگین مربعات خطا یا RMSE
RMSE نیز به خطاهای بزرگ حساس است، اما خروجی آن با واحد متغیر هدف قابل تفسیر خواهد بود.
امتیاز R-squared
این معیار نشان میدهد مدل تا چه اندازه تغییرات مقدار هدف را در مقایسه با یک پیشبینی پایه توضیح میدهد.
امتیاز نزدیک به یک معمولاً بهتر است. امتیاز صفر نشان میدهد مدل نسبت به پیشبینی دائمی مقدار میانگین مزیت خاصی ندارد. این امتیاز حتی میتواند منفی شود؛ یعنی عملکرد مدل از روش پایه نیز ضعیفتر بوده است.
نباید R-squared را بهتنهایی معیار موفقیت در نظر گرفت. خطای واقعی، نیاز کسبوکار و عملکرد مدل روی دادههای جدید نیز اهمیت دارند.
محاسبه معیارهای ارزیابی با Scikit-learn
from sklearn.metrics import (
    mean_absolute_error,
    mean_squared_error,
    r2_score,
    root_mean_squared_error,
)


mae = mean_absolute_error(
    y_test,
    predictions,
)

mse = mean_squared_error(
    y_test,
    predictions,
)

rmse = root_mean_squared_error(
    y_test,
    predictions,
)

r2 = r2_score(
    y_test,
    predictions,
)

print("MAE:", round(mae, 2))
print("MSE:", round(mse, 2))
print("RMSE:", round(rmse, 2))
print("R-squared:", round(r2, 3))
Scikit-learn مجموعهای از معیارهای ارزیابی رگرسیون از جمله MAE، MSE، RMSE و R-squared را ارائه میکند.
مثال رگرسیون خطی چندمتغیره
در پروژه واقعی معمولاً بیش از یک ویژگی داریم. مثال زیر فروش را با توجه به تبلیغات، تعداد بازدید و درصد تخفیف پیشبینی میکند.
import pandas as pd

from sklearn.linear_model import LinearRegression
from sklearn.metrics import (
    mean_absolute_error,
    r2_score,
)
from sklearn.model_selection import (
    train_test_split,
)


data = pd.DataFrame(
    {
        "advertising": [
            10,
            12,
            15,
            18,
            20,
            23,
            27,
            30,
            34,
            38,
            42,
            46,
        ],
        "visits": [
            1200,
            1500,
            1800,
            2100,
            2500,
            2900,
            3300,
            3700,
            4200,
            4800,
            5400,
            6100,
        ],
        "discount": [
            0,
            5,
            5,
            8,
            10,
            10,
            12,
            15,
            15,
            18,
            20,
            20,
        ],
        "sales": [
            38,
            47,
            58,
            69,
            82,
            94,
            108,
            123,
            141,
            160,
            181,
            205,
        ],
    }
)

features = [
    "advertising",
    "visits",
    "discount",
]

X = data[features]
y = data["sales"]

X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.25,
        random_state=42,
    )
)

model = LinearRegression()

model.fit(
    X_train,
    y_train,
)

predictions = model.predict(
    X_test
)

print(
    "MAE:",
    mean_absolute_error(
        y_test,
        predictions,
    ),
)

print(
    "R-squared:",
    r2_score(
        y_test,
        predictions,
    ),
)

coefficients = pd.DataFrame(
    {
        "feature": features,
        "coefficient": model.coef_,
    }
)

print(coefficients)
مجموعهداده این مثال کوچک و آموزشی است. ارزیابی واقعی به داده بیشتر، بررسی زمانی و مقایسه با مدلهای پایه نیاز دارد.
کار با دادههای عددی و دستهای
بسیاری از مجموعهدادهها فقط عددی نیستند. برای مثال، داده فروش میتواند شامل ستونهای زیر باشد:
- مبلغ تبلیغات
- تعداد بازدید
- نوع کمپین
- کانال فروش
- استان
- فصل
رگرسیون خطی نمیتواند متنهایی مانند «اینستاگرام» یا «جستوجوی گوگل» را مستقیماً پردازش کند. ویژگیهای دستهای باید ابتدا به ستونهای عددی تبدیل شوند.
در Scikit-learn میتوان این کار را با OneHotEncoder و ColumnTransformer انجام داد.
import pandas as pd

from sklearn.compose import (
    ColumnTransformer,
)
from sklearn.impute import SimpleImputer
from sklearn.linear_model import (
    LinearRegression,
)
from sklearn.metrics import (
    mean_absolute_error,
    r2_score,
)
from sklearn.model_selection import (
    train_test_split,
)
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import (
    OneHotEncoder,
    StandardScaler,
)


data = pd.read_csv(
    "sales_data.csv"
)

target = "sales"

numeric_features = [
    "advertising",
    "visits",
    "discount",
]

categorical_features = [
    "channel",
    "season",
]

X = data[
    numeric_features
    + categorical_features
]

y = data[target]

numeric_pipeline = Pipeline(
    steps=[
        (
            "imputer",
            SimpleImputer(
                strategy="median"
            ),
        ),
        (
            "scaler",
            StandardScaler(),
        ),
    ]
)

categorical_pipeline = Pipeline(
    steps=[
        (
            "imputer",
            SimpleImputer(
                strategy="most_frequent"
            ),
        ),
        (
            "encoder",
            OneHotEncoder(
                handle_unknown="ignore"
            ),
        ),
    ]
)

preprocessor = ColumnTransformer(
    transformers=[
        (
            "numeric",
            numeric_pipeline,
            numeric_features,
        ),
        (
            "categorical",
            categorical_pipeline,
            categorical_features,
        ),
    ]
)

pipeline = Pipeline(
    steps=[
        (
            "preprocessor",
            preprocessor,
        ),
        (
            "model",
            LinearRegression(),
        ),
    ]
)

X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.2,
        random_state=42,
    )
)

pipeline.fit(
    X_train,
    y_train,
)

predictions = pipeline.predict(
    X_test
)

print(
    "MAE:",
    mean_absolute_error(
        y_test,
        predictions,
    ),
)

print(
    "R-squared:",
    r2_score(
        y_test,
        predictions,
    ),
)
این Pipeline سه کار مهم انجام میدهد:
- مقادیر خالی عددی را با میانه جایگزین میکند.
- مقادیر خالی دستهای را با پرتکرارترین مقدار جایگزین میکند.
- دادههای دستهای را به ستونهای عددی تبدیل میکند.
قرار دادن تمام مراحل در Pipeline احتمال ناهماهنگی میان آموزش و پیشبینی را کاهش میدهد.
آیا استانداردسازی برای رگرسیون خطی ضروری است؟
برای اجرای ساده LinearRegression، استانداردسازی همیشه ضروری نیست. مدل میتواند با ویژگیهای دارای مقیاس متفاوت نیز آموزش ببیند.
بااینحال، استانداردسازی در شرایط زیر مفید است:
- مقایسه تقریبی ضرایب برای شما اهمیت دارد.
- میخواهید از Ridge یا Lasso استفاده کنید.
- مقیاس ویژگیها تفاوت زیادی دارد.
- Pipeline قرار است میان چند مدل مشترک باشد.
- محاسبات عددی مدل ناپایدار شدهاند.
استانداردسازی مقدار پیشبینی نهایی را بهخودیخود بهتر نمیکند، اما میتواند پردازش و مقایسه مدلهای منظمسازیشده را قابلاعتمادتر کند.
تحلیل ضرایب مدل
در رگرسیون خطی، ضرایب میتوانند به تفسیر مدل کمک کنند.
اگر ضریب ویژگی visits مثبت باشد، مدل نشان میدهد با ثابت بودن سایر متغیرها، افزایش بازدید با افزایش فروش همراه بوده است.
اما چند نکته مهم وجود دارد:
- ضریب مثبت، رابطه علت و معلولی را ثابت نمیکند.
- وجود ویژگیهای همبسته میتواند ضرایب را ناپایدار کند.
- مقیاس متفاوت ویژگیها مقایسه مستقیم ضرایب را دشوار میکند.
- وجود تعامل میان ویژگیها ممکن است در مدل ساده دیده نشود.
- داده ناقص یا سوگیریشده میتواند نتیجه تفسیر را تغییر دهد.
ضرایب ابزار تحلیلاند، اما نباید بدون شناخت داده به تصمیم قطعی تبدیل شوند.
تحلیل خطا یا Residual Analysis
Residual یا خطای باقیمانده، اختلاف میان مقدار واقعی و پیشبینی مدل است.
بررسی خطاها میتواند مشکلات مدل را آشکار کند.
results = pd.DataFrame(
    {
        "actual": y_test,
        "predicted": predictions,
    }
)

results["error"] = (
    results["actual"]
    - results["predicted"]
)

print(
    results.sort_values(
        by="error",
        key=abs,
        ascending=False,
    ).head(10)
)
در تحلیل خطا بررسی کنید:
- آیا مدل همیشه مقادیر بزرگ را کمتر پیشبینی میکند؟
- آیا خطا در یک منطقه یا گروه خاص بیشتر است؟
- آیا چند نمونه غیرعادی بیشتر خطا را ایجاد کردهاند؟
- آیا میزان خطا با افزایش مقدار پیشبینی بیشتر میشود؟
- آیا الگوی مشخصی در خطاها وجود دارد؟
اگر خطاها الگوی مشخصی داشته باشند، احتمالاً رابطه داده کاملاً خطی نیست یا ویژگی مهمی از مدل حذف شده است.
نمایش مقدار واقعی و پیشبینیشده
import matplotlib.pyplot as plt


plt.scatter(
    y_test,
    predictions,
    alpha=0.7,
)

minimum = min(
    y_test.min(),
    predictions.min(),
)

maximum = max(
    y_test.max(),
    predictions.max(),
)

plt.plot(
    [minimum, maximum],
    [minimum, maximum],
    linestyle="--",
)

plt.xlabel("Actual")
plt.ylabel("Predicted")
plt.title(
    "Actual vs Predicted"
)

plt.show()
هرچه نقاط به خط مرجع نزدیکتر باشند، پیشبینی مدل به مقدار واقعی نزدیکتر است.
نقاط بسیار دور میتوانند نمونههای غیرعادی، خطای داده یا بخشی از الگوی غیرخطی را نشان دهند.
پیشفرضهای مهم رگرسیون خطی
رگرسیون خطی در شرایطی عملکرد قابلاعتمادتری دارد که چند فرض اصلی تا حد مناسبی برقرار باشند.
رابطه تقریباً خطی
اثر ویژگیها بر خروجی باید با یک روند خطی قابل تقریب باشد. اگر رابطه بسیار منحنی یا پیچیده باشد، مدل خطی ممکن است الگو را بهخوبی یاد نگیرد.
استقلال خطاها
خطاهای نمونهها نباید بهشکل شدید به یکدیگر وابسته باشند. این موضوع در دادههای زمانی اهمیت زیادی دارد.
ثبات تقریبی پراکندگی خطا
بهتر است میزان پراکندگی خطا در بخشهای مختلف دامنه پیشبینی تقریباً پایدار باشد.
نبود همبستگی شدید میان ویژگیها
اگر چند ویژگی تقریباً اطلاعات یکسانی ارائه کنند، ضرایب ممکن است ناپایدار شوند.
نبود نمونههای غیرعادی بسیار اثرگذار
چند نمونه غیرعادی میتوانند خط رگرسیون را بهشدت تغییر دهند.
این موارد به این معنا نیست که با مشاهده هر انحرافی باید مدل را کنار گذاشت. هدف، شناخت محدودیت مدل و ارزیابی آن روی داده واقعی است.
بیشبرازش و کمبرازش در رگرسیون
کمبرازش
اگر رابطه داده پیچیده باشد اما مدل بیش از حد ساده انتخاب شود، مدل نمیتواند الگوی اصلی را یاد بگیرد.
نشانههای رایج:
- خطای زیاد روی داده آموزشی
- خطای زیاد روی داده آزمایشی
- الگوی مشخص در خطاها
بیشبرازش
اگر ویژگیهای زیاد، داده محدود یا تبدیلهای پیچیده داشته باشیم، مدل ممکن است جزئیات تصادفی داده آموزشی را یاد بگیرد.
نشانههای رایج:
- عملکرد بسیار خوب روی داده آموزشی
- عملکرد ضعیف روی داده آزمایشی
- ضرایب بسیار بزرگ و ناپایدار
استفاده از Cross-Validation، کاهش ویژگیهای غیرضروری و روشهای Ridge و Lasso میتواند کمککننده باشد.
Cross-Validation برای ارزیابی مطمئنتر
تقسیم یکباره داده به آموزش و آزمایش ممکن است به انتخاب تصادفی نمونهها حساس باشد. Cross-Validation مدل را روی چند تقسیم متفاوت بررسی میکند.
from sklearn.model_selection import (
    cross_validate,
)


scores = cross_validate(
    pipeline,
    X,
    y,
    cv=5,
    scoring={
        "mae": (
            "neg_mean_absolute_error"
        ),
        "r2": "r2",
    },
    return_train_score=True,
)

test_mae = (
    -scores["test_mae"]
)

print(
    "Average MAE:",
    test_mae.mean(),
)

print(
    "Average R-squared:",
    scores["test_r2"].mean(),
)
اگر نتایج میان Foldهای مختلف تفاوت زیادی داشته باشند، مدل یا داده ممکن است ناپایدار باشند.
برای دادههای زمانی نباید از تقسیم تصادفی معمولی استفاده کرد. در چنین پروژههایی TimeSeriesSplit یا ارزیابی بر اساس ترتیب زمانی مناسبتر است.
Ridge Regression چیست؟
Ridge نسخهای از رگرسیون خطی است که ضرایب بسیار بزرگ را محدود میکند.
این روش زمانی مفید است که:
- ویژگیها با یکدیگر همبستگی دارند.
- تعداد ویژگیها زیاد است.
- مدل روی داده جدید ناپایدار عمل میکند.
- ضرایب بسیار بزرگ شدهاند.
پارامتر alpha شدت محدودسازی را کنترل میکند. مقدار مناسب باید با Cross-Validation انتخاب شود.
مستندات Scikit-learn، Ridge را یک مدل خطی معرفی میکند که با افزودن منظمسازی، اندازه ضرایب را کنترل میکند.
from sklearn.linear_model import Ridge
from sklearn.model_selection import (
    GridSearchCV,
)


ridge_pipeline = Pipeline(
    steps=[
        (
            "preprocessor",
            preprocessor,
        ),
        (
            "model",
            Ridge(),
        ),
    ]
)

parameter_grid = {
    "model__alpha": [
        0.01,
        0.1,
        1,
        10,
        100,
    ],
}

search = GridSearchCV(
    estimator=ridge_pipeline,
    param_grid=parameter_grid,
    scoring=(
        "neg_mean_absolute_error"
    ),
    cv=5,
    n_jobs=-1,
)

search.fit(
    X_train,
    y_train,
)

print(
    "Best parameters:",
    search.best_params_,
)
Lasso Regression چیست؟
Lasso نیز ضرایب را محدود میکند، اما میتواند ضریب بعضی ویژگیها را کاملاً به صفر نزدیک کند. به همین دلیل گاهی برای انتخاب ویژگی نیز استفاده میشود.
Lasso میتواند در پروژههایی با ویژگیهای زیاد مفید باشد؛ اما انتخاب شدت منظمسازی بسیار مهم است. مقدار بیش از حد ممکن است ویژگیهای مفید را نیز حذف کند.
مستندات رسمی Scikit-learn، Lasso را یک مدل خطی با منظمسازی معرفی میکند که میتواند مدلهای دارای تعداد کمتری ضریب فعال ایجاد کند.
from sklearn.linear_model import Lasso
from sklearn.model_selection import (
    GridSearchCV,
)


lasso_pipeline = Pipeline(
    steps=[
        (
            "preprocessor",
            preprocessor,
        ),
        (
            "model",
            Lasso(
                max_iter=10000
            ),
        ),
    ]
)

parameter_grid = {
    "model__alpha": [
        0.001,
        0.01,
        0.1,
        1,
        10,
    ],
}

search = GridSearchCV(
    estimator=lasso_pipeline,
    param_grid=parameter_grid,
    scoring=(
        "neg_mean_absolute_error"
    ),
    cv=5,
    n_jobs=-1,
)

search.fit(
    X_train,
    y_train,
)

print(
    search.best_params_
)
تفاوت Linear Regression، Ridge و Lasso
| مدل | ویژگی اصلی | کاربرد مناسب |
|---|---|---|
| Linear Regression | مدل پایه بدون منظمسازی | داده ساده و ضرایب پایدار |
| Ridge | کاهش اندازه ضرایب | ویژگیهای همبسته و مدل ناپایدار |
| Lasso | محدودسازی و حذف برخی ویژگیها | داده دارای ویژگیهای زیاد |
| Elastic Net | ترکیب رفتار Ridge و Lasso | نیاز به کنترل ضرایب و انتخاب ویژگی |
بهتر است این مدلها روی یک مجموعه اعتبارسنجی مشترک مقایسه شوند.
رگرسیون چندجملهای چیست؟
اگر رابطه میان ورودی و خروجی کاملاً خطی نباشد، میتوان از ویژگیهای چندجملهای استفاده کرد.
در این روش، ویژگیهای جدیدی از ترکیب یا توان ویژگیهای موجود ساخته میشوند و سپس یک مدل خطی روی آنها آموزش میبیند.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import (
    PolynomialFeatures,
)
from sklearn.linear_model import (
    Ridge,
)


polynomial_model = Pipeline(
    steps=[
        (
            "features",
            PolynomialFeatures(
                degree=2,
                include_bias=False,
            ),
        ),
        (
            "model",
            Ridge(
                alpha=1.0
            ),
        ),
    ]
)

polynomial_model.fit(
    X_train[["advertising"]],
    y_train,
)
افزایش بیش از حد درجه ویژگیها میتواند به بیشبرازش منجر شود. بنابراین پیچیدگی مدل باید با Cross-Validation انتخاب شود.
برخورد با دادههای پرت
رگرسیون خطی معمولی به نمونههای پرت حساس است. یک رکورد بسیار غیرعادی ممکن است ضرایب مدل را تغییر دهد.
راهکارهای ممکن:
- بررسی صحت داده
- اصلاح خطاهای ورود اطلاعات
- محدودسازی دادههای غیرواقعی
- تبدیل متغیر هدف
- استفاده از روشهای مقاوم مانند HuberRegressor
- استفاده از RANSACRegressor
- گزارش عملکرد با و بدون دادههای پرت
نباید داده پرت را فقط به دلیل متفاوت بودن حذف کرد. ابتدا باید مشخص شود که آن نمونه خطای داده است یا یک وضعیت واقعی و مهم.
اهمیت مدل پایه
قبل از قبول رگرسیون خطی، باید آن را با یک مدل بسیار ساده مقایسه کنیم.
DummyRegressor میتواند همیشه میانگین یا میانه مقدار هدف را پیشبینی کند.
from sklearn.dummy import (
    DummyRegressor,
)
from sklearn.metrics import (
    mean_absolute_error,
)


baseline = DummyRegressor(
    strategy="median"
)

baseline.fit(
    X_train,
    y_train,
)

baseline_predictions = (
    baseline.predict(
        X_test
    )
)

baseline_mae = mean_absolute_error(
    y_test,
    baseline_predictions,
)

model_mae = mean_absolute_error(
    y_test,
    predictions,
)

print(
    "Baseline MAE:",
    baseline_mae,
)

print(
    "Model MAE:",
    model_mae,
)
اگر مدل رگرسیون تفاوت معناداری با مدل پایه نداشته باشد، احتمالاً ویژگیها اطلاعات کافی ندارند یا فرایند مدلسازی نیازمند اصلاح است.
استفاده از هوش مصنوعی برای آمادهسازی ویژگیهای رگرسیون
مدلهای رگرسیون با داده عددی و ساختاریافته کار میکنند، اما بسیاری از دادههای کسبوکار بهشکل متن آزاد هستند.
برای مثال، یک درخواست پروژه ممکن است چنین باشد:
یک فروشگاه اینترنتی با حدود ده هزار محصول، اتصال به سامانه حسابداری، جستوجوی هوشمند و پنل فروشندگان نیاز داریم.
برای پیشبینی هزینه پروژه، ابتدا باید ویژگیهایی مانند موارد زیر استخراج شوند:
- نوع پروژه
- تعداد محصول
- نیاز به پنل فروشنده
- نیاز به اتصال حسابداری
- نیاز به جستوجوی هوشمند
- سطح پیچیدگی
- زمان مورد انتظار
یک مدل زبانی میتواند متن را به خروجی JSON ساختاریافته تبدیل کند. سپس دادههای استخراجشده وارد مدل رگرسیون شوند.
استخراج ویژگی با API درواره
ابتدا کتابخانهها را نصب کنید:
pip install openai pydantic
متغیرهای محیطی را تنظیم کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
سپس کلاینت را ایجاد کنید:
import json
import os
from typing import Literal
from openai import OpenAI
from pydantic import BaseModel
client = OpenAI(
api_key=os.environ[
"DARVAREH_API_KEY"
],
base_url=(
"https://api.darvareh.ir/v1"
),
)
MODEL_ID = os.environ[
"DARVAREH_MODEL"
]
class ProjectFeatures(BaseModel):
project_type: Literal[
"website",
"mobile_app",
"automation",
"ai_application",
"other",
]
estimated_pages: int
external_integrations: int
has_admin_panel: bool
has_payment: bool
has_ai_features: bool
complexity: Literal[
"low",
"medium",
"high",
]
def extract_project_features(
description: str,
) -> ProjectFeatures:
prompt = f"""
توضیحات پروژه زیر را تحلیل کن.
خروجی را فقط بهصورت JSON معتبر
و مطابق این ساختار برگردان:
{{
"project_type": "website | mobile_app | automation | ai_application | other",
"estimated_pages": 0,
"external_integrations": 0,
"has_admin_panel": false,
"has_payment": false,
"has_ai_features": false,
"complexity": "low | medium | high"
}}
قواعد:
- اگر اطلاعاتی صریح نیست، مقدار محافظهکارانه انتخاب کن.
- هیچ متن یا Markdown خارج از JSON ننویس.
- estimated_pages و external_integrations عدد صحیح باشند.
توضیحات پروژه:
{description}
"""
response = (
client.chat.completions.create(
model=MODEL_ID,
temperature=0,
messages=[
{
"role": "system",
"content": (
"شما اطلاعات "
"ساختاریافته پروژههای "
"نرمافزاری را استخراج "
"میکنید."
),
},
{
"role": "user",
"content": prompt,
},
],
)
)
content = (
response
.choices[0]
.message
.content
)
if not content:
raise ValueError(
"پاسخی از مدل دریافت نشد."
)
return (
ProjectFeatures
.model_validate_json(
content
)
)
اکنون توضیحات پروژه را پردازش میکنیم:
description = """
یک فروشگاه اینترنتی با حدود
ده هزار محصول میخواهیم.
پنل مدیریت، درگاه پرداخت،
اتصال به حسابداری و
جستوجوی هوشمند هم لازم است.
"""
features = extract_project_features(
description
)
print(
features.model_dump_json(
indent=2
)
)
خروجی احتمالی:
{
  "project_type": "website",
  "estimated_pages": 8,
  "external_integrations": 2,
  "has_admin_panel": true,
  "has_payment": true,
  "has_ai_features": true,
  "complexity": "high"
}
این خروجی میتواند پس از اعتبارسنجی وارد Pipeline رگرسیون شود.
اتصال ویژگیهای استخراجشده به مدل رگرسیون
import pandas as pd


input_row = pd.DataFrame(
    [
        features.model_dump()
    ]
)

estimated_cost = (
    trained_pipeline.predict(
        input_row
    )[0]
)

print(
    "Estimated project cost:",
    round(
        estimated_cost,
        2,
    ),
)
در این معماری، مدل زبانی وظیفه استخراج داده از متن را انجام میدهد و مدل رگرسیون مسئول پیشبینی عددی است.
این تفکیک چند مزیت دارد:
- خروجی عددی فقط بر اساس متن آزاد مدل زبانی تولید نمیشود.
- فرایند پیشبینی قابل ارزیابی است.
- ویژگیهای استخراجشده قابل ذخیره و بررسی هستند.
- مدل رگرسیون را میتوان جداگانه بازآموزی کرد.
- مدل زبانی را میتوان بدون تغییر مدل پیشبینی تعویض کرد.
بااینحال، قیمت نهایی پروژه نباید فقط با این مدل تعیین شود. ارزیابی انسانی، شرایط قرارداد، ریسک اجرا و نیازهای دقیق مشتری نیز باید بررسی شوند.
معماری پیشنهادی برای ترکیب درواره و رگرسیون
یک جریان مناسب میتواند شامل مراحل زیر باشد:
۱. کاربر توضیحات متنی را ارسال میکند.
۲. سرور نرمافزار ورودی را اعتبارسنجی میکند.
۳. مدل زبانی از طریق API درواره ویژگیهای ساختاریافته را استخراج میکند.
۴. خروجی JSON با Pydantic اعتبارسنجی میشود.
۵. ویژگیها وارد Pipeline رگرسیون میشوند.
۶. مدل مقدار اولیه را پیشبینی میکند.
۷. محدودیتهای کسبوکار روی نتیجه اعمال میشوند.
۸. نتیجه همراه با بازه عدم قطعیت یا نیاز به بررسی نمایش داده میشود.
۹. مقدار واقعی پس از تکمیل فرایند ثبت میشود.
۱۰. داده جدید در ارزیابی و آموزش نسخه بعدی استفاده میشود.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
کلید API باید فقط در سرور نگهداری شود و نباید در کد مرورگر یا اپلیکیشن موبایل قرار گیرد.
ذخیره مدل آموزشدیده
پس از آموزش، میتوان Pipeline را ذخیره کرد:
import joblib


joblib.dump(
    pipeline,
    "sales_model.joblib",
)
برای استفاده مجدد:
import joblib


model = joblib.load(
    "sales_model.joblib"
)

predictions = model.predict(
    new_data
)
فقط فایلهای مدل مورداعتماد را بارگذاری کنید. همراه مدل، اطلاعات زیر را نیز ثبت کنید:
- نسخه داده
- نسخه کد
- نام ویژگیها
- تاریخ آموزش
- معیارهای ارزیابی
- نسخه کتابخانهها
- محدوده قابل قبول ورودیها
پیادهسازی API پیشبینی با FastAPI
import joblib
import pandas as pd

from fastapi import FastAPI
from pydantic import BaseModel


app = FastAPI()

model = joblib.load(
    "sales_model.joblib"
)


class SalesRequest(BaseModel):
    advertising: float
    visits: int
    discount: float
    channel: str
    season: str


class SalesResponse(BaseModel):
    predicted_sales: float


@app.post(
    "/predict",
    response_model=SalesResponse,
)
def predict_sales(
    request: SalesRequest,
) -> SalesResponse:
    row = pd.DataFrame(
        [
            request.model_dump()
        ]
    )

    prediction = model.predict(
        row
    )[0]

    return SalesResponse(
        predicted_sales=round(
            float(prediction),
            2,
        )
    )
برای اجرای برنامه:
uvicorn app:app --reload
در نسخه Production باید احراز هویت، محدودیت نرخ، ثبت رخداد، بررسی محدوده ورودی، مدیریت خطا و نظارت بر عملکرد مدل نیز اضافه شوند.
پایش مدل رگرسیون در محیط واقعی
عملکرد مدل ممکن است با گذشت زمان کاهش پیدا کند. رفتار کاربران، قیمتها، نرخ ارز، کانالهای فروش و شرایط بازار تغییر میکنند.
موارد زیر را ثبت و پایش کنید:
- میانگین خطای پیشبینی
- خطا در گروههای مختلف
- توزیع ویژگیهای ورودی
- تعداد ورودیهای خارج از محدوده آموزش
- تفاوت پیشبینی با نتیجه واقعی
- تغییر عملکرد نسبت به نسخه قبلی
- زمان پاسخ API
- نرخ خطاهای پردازش
اگر نتیجه واقعی با تأخیر مشخص میشود، باید سازوکاری برای اتصال پیشبینی قبلی به مقدار واقعی آینده وجود داشته باشد.
اشتباهات رایج در رگرسیون خطی
استفاده از داده بسیار کم
مدلی که با تعداد محدودی رکورد آموزش دیده، ممکن است روی داده جدید قابلاعتماد نباشد.
ارزیابی روی داده آموزشی
عملکرد خوب روی داده آموزشی تضمین نمیکند مدل روی نمونههای جدید نیز خوب باشد.
نادیده گرفتن مدل پایه
مدل باید حداقل از پیشبینی میانگین یا میانه بهتر عمل کند.
تبدیل نکردن دادههای دستهای
رشتههای متنی باید با روشی مانند One-Hot Encoding به ویژگی عددی تبدیل شوند.
نادیده گرفتن دادههای پرت
چند نمونه غیرعادی میتوانند ضرایب و پیشبینی را بهشدت تغییر دهند.
تفسیر ضرایب بهعنوان علت
رگرسیون ارتباط آماری را نشان میدهد، اما بهتنهایی علت و معلول را ثابت نمیکند.
نادیده گرفتن زمان
در دادههای زمانی، تقسیم تصادفی میتواند اطلاعات آینده را وارد آموزش کند.
استفاده از R-squared بهتنهایی
خطای واقعی و ارزش تجاری پیشبینی نیز باید بررسی شوند.
استفاده از مدل خارج از دامنه داده
اگر مدل با قیمتهای محدود آموزش دیده باشد، پیشبینی برای مقادیر بسیار خارج از آن محدوده قابلاعتماد نیست.
ثبت نکردن نسخه داده و مدل
بدون نسخهبندی نمیتوان مشخص کرد هر پیشبینی توسط کدام داده و مدل ایجاد شده است.
چه زمانی رگرسیون خطی انتخاب مناسبی است؟
رگرسیون خطی میتواند گزینه خوبی باشد اگر:
- خروجی موردنظر عددی است.
- رابطه ویژگیها با خروجی تقریباً خطی است.
- تفسیرپذیری اهمیت دارد.
- به یک مدل پایه سریع نیاز دارید.
- حجم داده خیلی بزرگ نیست.
- سرعت آموزش و پیشبینی مهم است.
- میخواهید اثر تقریبی ویژگیها را بررسی کنید.
چه زمانی مدل دیگری را بررسی کنیم؟
مدل دیگری میتواند مناسبتر باشد اگر:
- رابطه دادهها بهشدت غیرخطی است.
- تعاملهای پیچیده میان ویژگیها وجود دارد.
- داده پرت فراوان است.
- خروجی یک کلاس یا گروه است.
- داده ساختار زمانی پیچیده دارد.
- عملکرد رگرسیون خطی از مدل پایه بهتر نیست.
- مدلهای درختی یا تقویتی عملکرد بسیار بهتری ارائه میکنند.
مدلهای جایگزین میتوانند شامل موارد زیر باشند:
- Decision Tree Regressor
- Random Forest Regressor
- Gradient Boosting
- XGBoost
- LightGBM
- CatBoost
- Support Vector Regression
- KNN Regressor
- شبکه عصبی
مدل پیچیدهتر الزاماً بهتر نیست. انتخاب نهایی باید بر اساس عملکرد روی داده جدید، سرعت، هزینه و قابلیت نگهداری انجام شود.
پرسشهای متداول
رگرسیون خطی چیست؟
رگرسیون خطی یک الگوریتم یادگیری نظارتشده برای پیشبینی مقدار عددی بر اساس یک یا چند ویژگی است.
رگرسیون خطی در چه مسائلی استفاده میشود؟
در پیشبینی فروش، قیمت، هزینه، زمان، تقاضا، مصرف و سایر خروجیهای عددی استفاده میشود.
تفاوت رگرسیون خطی و لجستیک چیست؟
رگرسیون خطی مقدار عددی پیشبینی میکند، اما رگرسیون لجستیک برای طبقهبندی استفاده میشود.
آیا رگرسیون خطی فقط یک ویژگی دارد؟
خیر. رگرسیون خطی ساده یک ویژگی دارد، اما رگرسیون چندمتغیره میتواند چندین ویژگی را همزمان بررسی کند.
آیا باید دادهها را استاندارد کنیم؟
برای Linear Regression ساده همیشه ضروری نیست، اما برای Ridge، Lasso و مقایسه بهتر ویژگیها معمولاً مفید است.
بهترین معیار ارزیابی رگرسیون چیست؟
یک معیار واحد برای همه پروژهها وجود ندارد. MAE قابلتفسیر است، RMSE به خطاهای بزرگ حساستر است و R-squared میزان توضیح تغییرات را نشان میدهد. بهتر است چند معیار همزمان بررسی شوند.
آیا رگرسیون خطی برای پیشبینی قیمت مناسب است؟
میتواند مدل پایه مناسبی باشد، اما کیفیت آن به داده، ویژگیها و میزان خطیبودن رابطهها وابسته است.
آیا رگرسیون خطی برای دادههای متنی کاربرد دارد؟
متن باید ابتدا به ویژگیهای عددی تبدیل شود. میتوان از TF-IDF، Embedding یا استخراج اطلاعات ساختاریافته با مدل زبانی استفاده کرد.
Ridge و Lasso چه تفاوتی دارند؟
هر دو ضرایب را محدود میکنند. Ridge معمولاً همه ویژگیها را نگه میدارد، اما Lasso میتواند اثر بعضی ویژگیها را به صفر نزدیک کند.
آیا میتوان از API درواره در کنار رگرسیون استفاده کرد؟
بله. مدلهای هوش مصنوعی درواره میتوانند داده ساختاریافته را از متن استخراج کنند و سپس یک مدل رگرسیون مقدار عددی را پیشبینی کند.
جمعبندی
رگرسیون خطی یکی از مهمترین الگوریتمهای پایه در یادگیری ماشین است. این روش برای پیشبینی مقادیر عددی، تحلیل ارتباط ویژگیها و ایجاد یک مدل پایه سریع کاربرد دارد.
برای استفاده صحیح از رگرسیون خطی:
۱. مسئله را بهصورت یک خروجی عددی تعریف کنید.
۲. دادههای آموزشی و آزمایشی را جدا نگه دارید.
۳. دادههای ناقص و دستهای را داخل Pipeline پردازش کنید.
۴. مدل را با MAE، RMSE و R-squared ارزیابی کنید.
۵. عملکرد را با یک مدل پایه مقایسه کنید.
۶. خطاها و نمونههای غیرعادی را بررسی کنید.
۷. ضرایب را بهعنوان ارتباط آماری تفسیر کنید، نه علت قطعی.
۸. برای ضرایب ناپایدار، Ridge و Lasso را آزمایش کنید.
۹. در دادههای زمانی، ترتیب زمان را حفظ کنید.
۱۰. نسخه داده، مدل و معیارهای ارزیابی را ثبت کنید.
در پروژههایی که اطلاعات اولیه بهصورت متن آزاد دریافت میشوند، میتوانید از API درواره برای استخراج ویژگیهای ساختاریافته استفاده کنید و سپس نتیجه را به مدل رگرسیون بسپارید.
برای شروع اتصال نرمافزار خود به مدلهای مختلف هوش مصنوعی، مستندات API درواره را مطالعه کنید.
مقالات مرتبط
- یادگیری ماشین چیست؟
- یادگیری نظارتشده چیست؟
- رگرسیون لجستیک چیست؟
- الگوریتم KNN چیست؟
- درخت تصمیم و جنگل تصادفی
- الگوریتم SVM چیست؟
- Pandas چیست؟
- Scikit-learn چیست؟
- آموزش اتصال API هوش مصنوعی به نرمافزار
منابع
- مستندات LinearRegression در Scikit-learn
- راهنمای مدلهای خطی در Scikit-learn
- مستندات معیارهای ارزیابی رگرسیون
- مستندات Ridge
- مستندات Lasso
- مستندات Pipeline
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



