
بیشبرازش و کمبرازش چیست؟ آموزش Overfitting و Underfitting با پایتون
بیشبرازش زمانی رخ میدهد که مدل داده آموزشی را حفظ کند، اما روی داده جدید ضعیف باشد. در این راهنما تشخیص و رفع Overfitting و Underfitting را با مثال عملی پایتون یاد میگیرید.

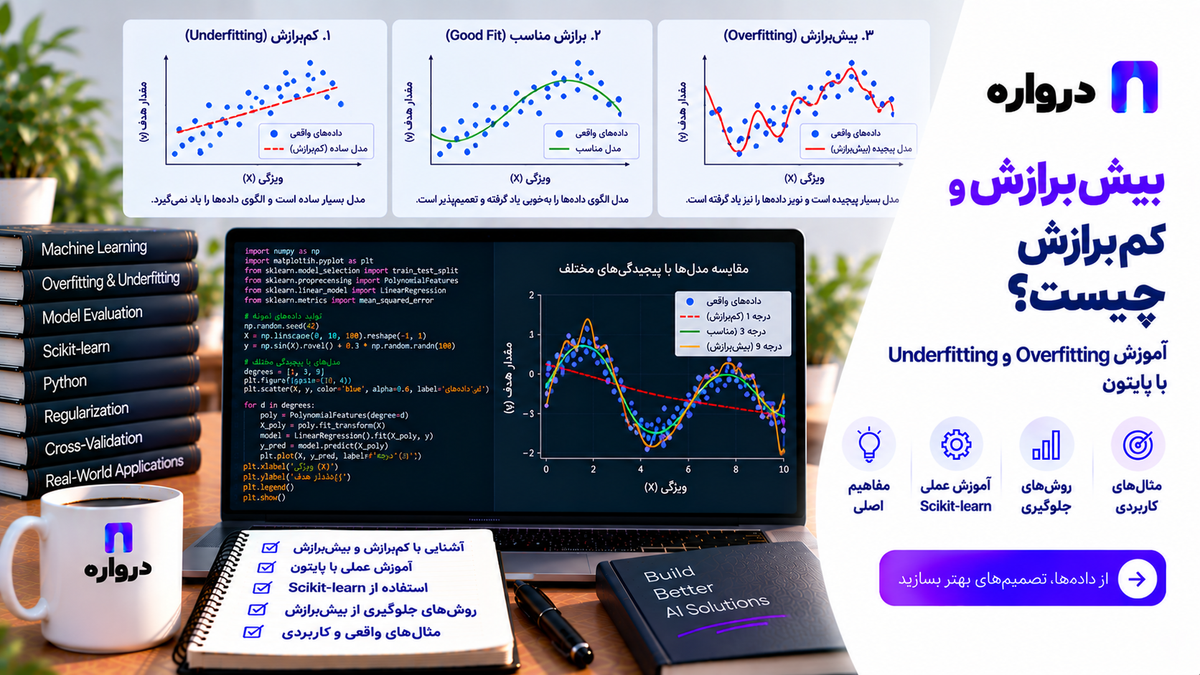
یکی از رایجترین اتفاقها در پروژههای یادگیری ماشین این است که مدل روی دادههای آموزشی عملکرد بسیار خوبی دارد، اما پس از انتشار و مواجهه با دادههای واقعی ضعیف عمل میکند. این وضعیت معمولاً نشانه بیشبرازش یا Overfitting است.
مشکل معکوس نیز وجود دارد. گاهی مدل آنقدر ساده است یا آموزش کافی ندیده که حتی الگوهای موجود در داده آموزشی را هم بهخوبی تشخیص نمیدهد. به این وضعیت کمبرازش یا Underfitting گفته میشود.
هدف آموزش یک مدل فقط کاهش خطا روی دادههای گذشته نیست. مدل باید بتواند الگوهای مفید را یاد بگیرد و روی نمونههایی که قبلاً ندیده است نیز عملکرد مناسبی داشته باشد. این توانایی با عنوان تعمیمپذیری یا Generalization شناخته میشود.
در این مقاله میآموزید:
- Overfitting و Underfitting چه هستند؟
- چگونه آنها را تشخیص دهیم؟
- تفاوت خطای آموزش و اعتبارسنجی چیست؟
- منحنی یادگیری چه اطلاعاتی میدهد؟
- Regularization، Cross-validation و Early Stopping چگونه کمک میکنند؟
- چگونه بیشبرازش را در Scikit-learn تشخیص دهیم؟
- بیشبرازش در شبکههای عصبی و مدلهای زبانی چگونه ظاهر میشود؟
- چگونه از تنظیم بیشازحد پرامپت روی مجموعه ارزیابی جلوگیری کنیم؟
بیشبرازش یا Overfitting چیست؟
بیشبرازش زمانی اتفاق میافتد که مدل علاوه بر الگوهای واقعی، نویزها و ویژگیهای تصادفی داده آموزشی را نیز یاد بگیرد.
چنین مدلی ممکن است روی Training Set امتیاز بسیار بالایی داشته باشد، اما روی Validation Set، Test Set یا داده واقعی عملکرد ضعیفی نشان دهد.
گوگل Overfitting را وضعیتی توصیف میکند که مدل داده آموزشی را بسیار نزدیک به حالت حفظکردن یاد میگیرد و در نتیجه روی نمونههای جدید نمیتواند پیشبینی مناسبی ارائه کند.
برای مثال، فرض کنید مدلی برای دستهبندی پیامهای مشتریان ساختهاید. در داده آموزشی، بیشتر پیامهای مالی شامل کلمه «فاکتور» هستند. اگر مدل فقط همین کلمه را ملاک قرار دهد، ممکن است پیام زیر را مالی تشخیص دهد:
لطفاً قابلیت دانلود فاکتور را به نسخه بعدی محصول اضافه کنید.
اما این پیام در واقع «پیشنهاد محصول» است. مدل بهجای یادگیری مفهوم پیام، یک نشانه سطحی را حفظ کرده است.
کمبرازش یا Underfitting چیست؟
کمبرازش زمانی رخ میدهد که مدل نتواند الگوهای اصلی داده را یاد بگیرد.
مدل کمبرازش معمولاً:
- روی داده آموزشی عملکرد ضعیفی دارد.
- روی داده اعتبارسنجی نیز ضعیف است.
- بیشازحد ساده است.
- ویژگیهای کافی در اختیار ندارد.
- مدت کافی آموزش ندیده است.
- بهشدت محدود شده است.
برای مثال، اگر برای تشخیص موضوع پیام فقط طول متن را در اختیار مدل قرار دهید، مدل احتمالاً نمیتواند تفاوت درخواست فروش، مشکل فنی و سؤال مالی را یاد بگیرد.
در کمبرازش، مشکل اصلی حفظکردن داده نیست؛ بلکه مدل هنوز ظرفیت یا اطلاعات کافی برای یادگیری رابطه موردنظر را ندارد.
تفاوت Overfitting و Underfitting
| وضعیت | عملکرد روی داده آموزش | عملکرد روی داده جدید | مشکل اصلی |
|---|---|---|---|
| کمبرازش | ضعیف | ضعیف | مدل بیشازحد ساده یا آموزش ناکافی |
| برازش مناسب | خوب | خوب | تعادل مناسب میان یادگیری و تعمیم |
| بیشبرازش | بسیار خوب | ضعیفتر | یادگیری نویز و جزئیات غیرقابل تعمیم |
در مستندات Scikit-learn، پایینبودن همزمان امتیاز آموزش و اعتبارسنجی نشانه کمبرازش و بالا بودن امتیاز آموزش همراه با پایینبودن امتیاز اعتبارسنجی نشانه بیشبرازش معرفی شده است.
تعمیمپذیری چیست؟
Generalization یعنی مدل بتواند دانشی را که از داده آموزشی گرفته است روی نمونههای جدید و واقعی به کار ببرد.
مدلی که تعمیمپذیری مناسبی دارد:
- فقط نمونههای آموزشی را حفظ نمیکند.
- روی دادههای جدید عملکرد قابل قبول دارد.
- در برابر تغییرات کوچک ورودی مقاوم است.
- وابستگی شدیدی به چند ویژگی تصادفی ندارد.
- در محیط واقعی افت عملکرد شدیدی نشان نمیدهد.
هدف نهایی یادگیری ماشین دستیابی به بهترین نتیجه روی داده آموزشی نیست؛ بلکه رسیدن به بهترین عملکرد پایدار روی داده دیدهنشده است.
مثال ساده برای درک بیشبرازش
فرض کنید میخواهیم رابطه میان تعداد کلمات یک پیام و زمان لازم برای پاسخگویی را مدلسازی کنیم.
سه مدل میسازیم:
- یک مدل بسیار ساده که تغییرات اصلی را هم تشخیص نمیدهد.
- یک مدل متعادل که روند عمومی داده را یاد میگیرد.
- یک مدل بسیار پیچیده که از تکتک نقاط آموزشی عبور میکند.
مدل سوم احتمالاً روی داده آموزش خطای بسیار کمی دارد، اما تغییر کوچک در ورودی میتواند پیشبینی آن را بهشدت تغییر دهد. این مدل بهجای یادگیری روند عمومی، دادههای موجود را حفظ کرده است.
نشانههای Overfitting چیست؟
فاصله زیاد میان امتیاز آموزش و اعتبارسنجی
مهمترین نشانه این است که مدل روی داده آموزش بسیار بهتر از داده اعتبارسنجی عمل کند.
برای مثال:
| مجموعه داده | F1 |
|---|---|
| آموزش | ۰٫۹۸ |
| اعتبارسنجی | ۰٫۷۴ |
| آزمایش | ۰٫۷۲ |
این فاصله نشان میدهد مدل احتمالاً الگوهایی را یاد گرفته که به دادههای جدید منتقل نمیشوند.
کاهش خطای آموزش و افزایش خطای اعتبارسنجی
در شبکههای عصبی ممکن است Loss آموزشی همچنان کاهش پیدا کند، اما Validation Loss پس از چند دوره شروع به افزایش کند.
این نقطه معمولاً زمان مناسبی برای متوقفکردن آموزش است.
حساسیت شدید به داده ورودی
اگر تغییر کوچک در متن، تصویر یا ویژگیها نتیجه مدل را بهکلی تغییر دهد، احتمال دارد مدل بیشازحد به جزئیات داده آموزشی وابسته شده باشد.
عملکرد متغیر در Foldهای مختلف
اگر امتیازهای Cross-validation اختلاف زیادی داشته باشند، مدل یا مجموعه داده ممکن است ناپایدار باشد.
افت شدید پس از انتشار
عملکرد مناسب در محیط آزمایش و افت شدید در Production میتواند نتیجه Overfitting، Data Leakage یا تغییر توزیع داده باشد.
پیچیدگی غیرضروری مدل
مدلی با پارامترها، عمق یا ویژگیهای زیاد در برابر مجموعه داده کوچک، بیشتر در معرض بیشبرازش قرار دارد.
نشانههای Underfitting چیست؟
کمبرازش معمولاً با این نشانهها همراه است:
- امتیاز آموزش و اعتبارسنجی هر دو پاییناند.
- افزودن داده بیشتر بهتنهایی بهبود زیادی ایجاد نمیکند.
- مدل حتی نمونههای ساده آموزشی را اشتباه تشخیص میدهد.
- ویژگیها اطلاعات کافی درباره هدف ندارند.
- محدودیتهای Regularization بیشازحد شدید هستند.
- تعداد دورههای آموزش کم است.
- مدل توانایی نمایش رابطه واقعی داده را ندارد.
Bias و Variance چه ارتباطی با Overfitting دارند؟
در یادگیری ماشین، دو مفهوم مهم برای تحلیل خطا وجود دارد:
Bias بالا
مدل فرضهای بیشازحد سادهای دارد و نمیتواند رابطه واقعی داده را یاد بگیرد. Bias بالا معمولاً با Underfitting مرتبط است.
Variance بالا
مدل نسبت به تغییرات مجموعه آموزشی بسیار حساس است. اگر داده آموزش کمی تغییر کند، مدل یا پیشبینیهای آن نیز بهشدت تغییر میکنند. Variance بالا معمولاً با Overfitting مرتبط است.
در عمل باید میان سادگی و انعطافپذیری مدل تعادل ایجاد کرد:
- مدل بسیار ساده الگوی اصلی را از دست میدهد.
- مدل بسیار پیچیده نویز داده را یاد میگیرد.
- مدل مناسب الگوهای پایدار را استخراج میکند.
Training، Validation و Test Set
یکی از مهمترین اقدامات برای تشخیص بیشبرازش، جداسازی صحیح دادهها است.
Training Set
برای آموزش پارامترهای مدل استفاده میشود.
Validation Set
برای انتخاب معماری، ویژگیها، آستانه، Hyperparameter و نسخه مدل استفاده میشود.
Test Set
فقط برای ارزیابی نهایی مدل انتخابشده استفاده میشود.
اگر بارها نتیجه Test Set را ببینید و بر اساس آن مدل را تغییر دهید، Test Set عملاً به بخشی از فرایند توسعه تبدیل میشود. در این حالت ممکن است مدل یا تصمیمهای تیم روی Test Set نیز Overfit شوند.
تقسیم داده با Scikit-learn
from sklearn.model_selection import train_test_split

X_train, X_temp, y_train, y_temp = train_test_split(
    X,
    y,
    test_size=0.30,
    random_state=42,
    stratify=y,
)

X_validation, X_test, y_validation, y_test = train_test_split(
    X_temp,
    y_temp,
    test_size=0.50,
    random_state=42,
    stratify=y_temp,
)

print("Training:", len(X_train))
print("Validation:", len(X_validation))
print("Test:", len(X_test))
پارامتر stratify کمک میکند نسبت کلاسها در بخشهای مختلف تقریباً حفظ شود.
برای دادههای زمانی مانند گزارش مصرف، فروش یا رخدادهای سامانه نباید دادهها را بهشکل تصادفی تقسیم کنید. در چنین پروژههایی، داده گذشته باید برای آموزش و داده آینده برای اعتبارسنجی و آزمایش استفاده شود.
Data Leakage؛ مشکلی شبیه بیشبرازش
Data Leakage یا نشت داده زمانی اتفاق میافتد که اطلاعاتی از داده اعتبارسنجی، آزمایش یا آینده به فرایند آموزش وارد شود.
نمونههای رایج:
- نرمالسازی کل داده پیش از تقسیم
- ساخت ویژگی با استفاده از اطلاعات آینده
- وجود نمونههای تکراری در Training و Test
- استخراج واژگان TF-IDF از کل داده
- استفاده از نتیجه نهایی پرونده بهعنوان ویژگی
- حضور پیامهای یک مشتری در هر دو مجموعه
- انتخاب ویژگی بر اساس Test Set
Data Leakage میتواند امتیاز آزمایش را غیرواقعی و بسیار بالا نشان دهد.
برای جلوگیری از نشت، مراحل پیشپردازش را داخل Pipeline قرار دهید:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline

pipeline = Pipeline(
    [
        (
            "tfidf",
            TfidfVectorizer(
                ngram_range=(1, 2),
                min_df=2,
            ),
        ),
        (
            "model",
            LogisticRegression(
                max_iter=1000,
            ),
        ),
    ]
)

pipeline.fit(X_train, y_train)
در این ساختار، واژگان و وزنهای TF-IDF فقط از داده آموزش یاد گرفته میشوند.
Cross-validation چیست و چگونه کمک میکند؟
در Cross-validation داده به چند بخش تقسیم میشود. مدل چند مرتبه آموزش میبیند و هر بار یک بخش متفاوت برای ارزیابی استفاده میشود.
این روش کمک میکند:
- ارزیابی به یک تقسیم تصادفی وابسته نباشد.
- ناپایداری مدل مشخص شود.
- Hyperparameterها منصفانهتر مقایسه شوند.
- خطر انتخاب مدل بر اساس یک Validation Set خاص کاهش یابد.
Scikit-learn استفاده از Cross-validation را برای ارزیابی و انتخاب مدل پشتیبانی میکند.
مثال Cross-validation
from sklearn.model_selection import StratifiedKFold
from sklearn.model_selection import cross_validate

cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

scores = cross_validate(
    pipeline,
    X,
    y,
    cv=cv,
    scoring=[
        "accuracy",
        "f1_macro",
    ],
    return_train_score=True,
)

print(
    "Train F1:",
    scores["train_f1_macro"].mean(),
)

print(
    "Validation F1:",
    scores["test_f1_macro"].mean(),
)
اگر امتیاز آموزش بسیار بالا و امتیاز اعتبارسنجی بهوضوح پایینتر باشد، باید احتمال Overfitting را بررسی کنید.
منحنی یادگیری چیست؟
Learning Curve عملکرد مدل را با افزایش تعداد نمونههای آموزشی نشان میدهد.
این نمودار به دو پرسش مهم پاسخ میدهد:
- آیا افزودن داده بیشتر احتمالاً مفید است؟
- مشکل مدل بیشتر به کمبرازش شباهت دارد یا بیشبرازش؟
الگوی کمبرازش
- امتیاز آموزش پایین است.
- امتیاز اعتبارسنجی نیز پایین است.
- دو منحنی به یک مقدار ضعیف نزدیک میشوند.
در این شرایط، افزودن داده بیشتر معمولاً مشکل اصلی را حل نمیکند. ممکن است به مدل قویتر یا ویژگیهای بهتر نیاز داشته باشید.
الگوی بیشبرازش
- امتیاز آموزش بالا است.
- امتیاز اعتبارسنجی پایینتر است.
- میان دو منحنی فاصله قابل توجهی وجود دارد.
در این وضعیت، افزایش داده میتواند مفید باشد.
مستندات Scikit-learn توضیح میدهد که Learning Curve برای تشخیص سودمندی داده بیشتر و بررسی مسائل مرتبط با Bias و Variance کاربرد دارد.
رسم Learning Curve با پایتون
import matplotlib.pyplot as plt
import numpy as np

from sklearn.model_selection import LearningCurveDisplay
from sklearn.model_selection import StratifiedKFold

cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

LearningCurveDisplay.from_estimator(
    pipeline,
    X,
    y,
    cv=cv,
    scoring="f1_macro",
    train_sizes=np.linspace(0.2, 1.0, 5),
    n_jobs=-1,
)

plt.title("Learning Curve")
plt.tight_layout()
plt.show()
اگر فاصله دو منحنی با افزایش داده کمتر شود، جمعآوری نمونه بیشتر احتمالاً ارزشمند است.
روشهای جلوگیری از بیشبرازش
۱. افزایش داده آموزشی
داده بیشتر و متنوعتر یکی از مؤثرترین راهها برای کاهش وابستگی مدل به نمونههای خاص است.
اما فقط افزایش تعداد کافی نیست. داده باید:
- نماینده محیط واقعی باشد.
- کلاسهای مختلف را پوشش دهد.
- نمونههای مرزی داشته باشد.
- از منابع متنوع جمعآوری شود.
- تکراری یا نزدیک به تکراری نباشد.
- برچسب معتبر داشته باشد.
۲. سادهترکردن مدل
گاهی مدل نسبت به اندازه داده بیشازحد پیچیده است.
راهکارهای ممکن:
- کاهش عمق درخت
- کاهش تعداد پارامترها
- حذف ویژگیهای غیرضروری
- کاهش درجه مدل
- انتخاب معماری کوچکتر
- محدودکردن تعداد لایهها
- کاهش تعداد درختها در صورت مشاهده بیشبرازش
پیچیدهترکردن مدل همیشه به معنی عملکرد بهتر نیست.
۳. استفاده از Regularization
Regularization مدل را از وابستگی بیشازحد به وزنها یا ویژگیهای خاص بازمیدارد.
دو روش رایج عبارتاند از:
- L1 Regularization
- L2 Regularization
L1 میتواند بعضی ضرایب را به صفر نزدیک کند و در انتخاب ویژگی مؤثر باشد. L2 معمولاً وزنهای بسیار بزرگ را محدود میکند و مدل نرمتری میسازد.
گوگل L2 Regularization را روشی برای کاهش پیچیدگی و کمک به جلوگیری از بیشبرازش معرفی میکند.
مثال Regularization در Logistic Regression
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV

parameters = {
    "model__C": [
        0.01,
        0.1,
        1,
        10,
    ],
}

pipeline = Pipeline(
    [
        (
            "tfidf",
            TfidfVectorizer(
                ngram_range=(1, 2),
                min_df=2,
            ),
        ),
        (
            "model",
            LogisticRegression(
                max_iter=1000,
                penalty="l2",
            ),
        ),
    ]
)

search = GridSearchCV(
    pipeline,
    parameters,
    scoring="f1_macro",
    cv=5,
    n_jobs=-1,
)

search.fit(X_train, y_train)

print(search.best_params_)
print(search.best_score_)
در Logistic Regression، مقدار کوچکتر C معمولاً Regularization قویتری اعمال میکند.
۴. Early Stopping
در شبکههای عصبی و مدلهای تکرارشونده، میتوان آموزش را زمانی متوقف کرد که عملکرد Validation دیگر بهتر نمیشود.
best_validation_loss = float("inf")
patience = 3
wait = 0

for epoch in range(max_epochs):
    train_one_epoch(model, train_loader)

    validation_loss = evaluate(
        model,
        validation_loader,
    )

    if validation_loss < best_validation_loss:
        best_validation_loss = validation_loss
        save_model(model)
        wait = 0
    else:
        wait += 1

    if wait >= patience:
        print("Early stopping")
        break
در Early Stopping باید بهترین نسخه مدل ذخیره شود؛ نه صرفاً آخرین نسخه. نمونههای رسمی Scikit-learn نیز نشان میدهند توقف زودهنگام میتواند آموزش را پیش از افزایش خطای اعتبارسنجی متوقف کند.
۵. Dropout
Dropout هنگام آموزش شبکه عصبی، بخشی از واحدها را بهصورت موقت غیرفعال میکند. این کار مانع وابستگی شدید شبکه به مسیرهای خاص میشود.
import torch.nn as nn

model = nn.Sequential(
    nn.Linear(256, 128),
    nn.ReLU(),
    nn.Dropout(0.3),
    nn.Linear(128, 4),
)
مقدار Dropout باید با Validation Set تنظیم شود. مقدار بیشازحد میتواند باعث Underfitting شود.
۶. Data Augmentation
در پروژههای تصویری میتوان نسخههای تغییریافته تصاویر را تولید کرد:
- چرخش محدود
- برش
- تغییر روشنایی
- جابهجایی
- تغییر مقیاس
در پردازش متن باید احتیاط بیشتری داشت؛ زیرا جایگزینی یا حذف واژه ممکن است معنای پیام را تغییر دهد.
برای متن فارسی میتوان از روشهای کنترلشده استفاده کرد:
- افزودن نسخه محاورهای
- تنوع در نیمفاصله
- غلطهای املایی واقعی
- بازنویسی انسانی
- تغییر قالب تاریخ و عدد
- نمونههای کوتاه و بلند
۷. Feature Selection
ویژگیهای زیاد و کمارزش میتوانند احتمال بیشبرازش را افزایش دهند.
روشهای مناسب:
- حذف ویژگیهای تکراری
- حذف ستونهای دارای اطلاعات آینده
- بررسی اهمیت ویژگیها
- استفاده از L1
- کاهش ابعاد
- حذف شناسههایی که الگوی عمومی ندارند
۸. Pruning در درخت تصمیم
درخت بسیار عمیق میتواند نمونههای آموزشی را حفظ کند.
پارامترهای مهم برای کنترل آن:
from sklearn.tree import DecisionTreeClassifier

model = DecisionTreeClassifier(
    max_depth=6,
    min_samples_leaf=10,
    min_samples_split=20,
    random_state=42,
)
محدودکردن عمق درخت و تعیین حداقل نمونه برگ از روشهای رایج جلوگیری از Overfitting در درخت تصمیم هستند.
۹. استفاده از Ensemble
روشهایی مانند Random Forest میتوانند نوسان یک درخت منفرد را کاهش دهند. بااینحال مدلهای Ensemble نیز باید روی داده مستقل ارزیابی شوند و مصون از بیشبرازش نیستند.
۱۰. حذف نمونههای تکراری
وجود نسخههای تکراری یا بسیار مشابه در Training و Test باعث میشود نتیجه مدل بهتر از واقعیت به نظر برسد.
در دادههای متنی بهتر است علاوه بر تطبیق دقیق، شباهت معنایی یا شباهت واژگانی نمونهها نیز بررسی شود.
چگونه Underfitting را برطرف کنیم؟
برای رفع کمبرازش میتوان اقدامات زیر را آزمایش کرد:
- انتخاب مدل منعطفتر
- افزودن ویژگیهای مرتبط
- کاهش شدت Regularization
- افزایش تعداد دورههای آموزش
- اصلاح نرخ یادگیری
- استفاده از نمایش داده بهتر
- رفع خطاهای پیشپردازش
- بررسی کیفیت برچسبها
- افزایش عمق کنترلشده مدل
- استفاده از Embedding مناسبتر برای متن
اگر مدل حتی داده آموزشی را یاد نمیگیرد، افزودن داده بیشتر همیشه اولین راهحل نیست. ابتدا باید مطمئن شوید مدل و ویژگیها توانایی نمایش مسئله را دارند.
مثال عملی کامل با Scikit-learn
در این مثال اثر پیچیدگی مدل را روی داده آموزشی و اعتبارسنجی مقایسه میکنیم:
from sklearn.datasets import make_classification
from sklearn.metrics import f1_score
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

X, y = make_classification(
    n_samples=1500,
    n_features=20,
    n_informative=8,
    n_redundant=4,
    random_state=42,
)

X_train, X_validation, y_train, y_validation = (
    train_test_split(
        X,
        y,
        test_size=0.25,
        random_state=42,
        stratify=y,
    )
)

depths = [
    1,
    2,
    4,
    6,
    10,
    None,
]

for depth in depths:
    model = DecisionTreeClassifier(
        max_depth=depth,
        random_state=42,
    )

    model.fit(X_train, y_train)

    train_prediction = model.predict(X_train)
    validation_prediction = model.predict(X_validation)

    train_f1 = f1_score(
        y_train,
        train_prediction,
    )

    validation_f1 = f1_score(
        y_validation,
        validation_prediction,
    )

    print(
        {
            "max_depth": depth,
            "train_f1": round(train_f1, 3),
            "validation_f1": round(
                validation_f1,
                3,
            ),
        }
    )
تفسیر معمول نتایج:
- عمق بسیار کم: امتیاز آموزش و اعتبارسنجی هر دو پایین؛ نشانه Underfitting
- عمق متوسط: امتیاز هر دو مجموعه مناسب؛ برازش بهتر
- عمق نامحدود: امتیاز آموزش بسیار بالا و فاصله بیشتر با اعتبارسنجی؛ احتمال Overfitting
Overfitting در مدلهای زبانی و برنامههای مبتنی بر API
بیشبرازش فقط هنگام آموزش مدلهای کلاسیک اتفاق نمیافتد. تیمهای توسعه ممکن است هنگام طراحی پرامپت، RAG یا Agent نیز روی مجموعه ارزیابی Overfit شوند.
تنظیم بیشازحد پرامپت
فرض کنید ۳۰ نمونه ارزیابی دارید و پس از مشاهده هر خطا، یک قانون جدید به پرامپت اضافه میکنید. پس از مدتی پرامپت همان ۳۰ نمونه را عالی پاسخ میدهد، اما روی پیامهای جدید پیچیده و شکننده است.
انتخاب مدل بر اساس یک Benchmark کوچک
اگر چند مدل را بارها روی یک مجموعه کوچک مقایسه کنید و فقط بهترین نتیجه را انتخاب کنید، انتخاب شما ممکن است به نویز همان مجموعه وابسته شده باشد.
استفاده از نمونههای Test در Few-shot Prompt
قرار دادن نمونههای مجموعه Test داخل پرامپت باعث نشت داده و نامعتبرشدن ارزیابی میشود.
تنظیم Retrieval روی چند سؤال مشخص
اگر Chunking، Top-K و Reranking فقط بر اساس چند سؤال محدود تنظیم شوند، سامانه RAG ممکن است روی پرسشهای واقعی عملکرد ضعیفی داشته باشد.
ساخت قانون برای تکتک خطاها
افزودن استثناهای زیاد به System Prompt میتواند هزینه توکن، تضاد دستورها و رفتار غیرقابل پیشبینی را افزایش دهد.
روش صحیح ارزیابی مدلهای API درواره
با API یکپارچه درواره میتوانید چند مدل را با کد و مجموعه ارزیابی یکسان مقایسه کنید.
آدرس پایه:
https://api.darvareh.ir/v1متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
نمونه اتصال:
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)

MODEL_ID = os.environ["DARVAREH_MODEL"]
برای جلوگیری از Overfitting در فرایند انتخاب مدل، داده ارزیابی را به سه بخش تقسیم کنید:
- Development Set برای طراحی اولیه پرامپت
- Validation Set برای انتخاب مدل و تنظیمات
- Holdout Set برای ارزیابی نهایی
Holdout Set نباید هنگام طراحی پرامپت مشاهده شود.
نمونه ارزیابی چند پرامپت بدون دستکاری Test Set
prompt_versions = {
"v1": (
"موضوع پیام را فقط در یکی از دستههای "
"sales، technical، billing یا other قرار بده."
),
"v2": (
"پیام مشتری را بر اساس هدف اصلی آن دستهبندی کن. "
"خروجی فقط یکی از sales، technical، billing "
"یا other باشد."
),
}
validation_results = {}
for version, instruction in prompt_versions.items():
predictions = []
for item in validation_data:
result = classify_with_model(
instruction=instruction,
message=item["text"],
)
predictions.append(result)
validation_results[version] = evaluate_predictions(
expected=[
item["label"]
for item in validation_data
],
predicted=predictions,
)
best_version = select_best_version(
validation_results
)
final_result = evaluate_once(
prompt=prompt_versions[best_version],
dataset=holdout_data,
)اصل مهم این است که Holdout Set فقط پس از نهاییشدن انتخابها اجرا شود.
برای شروع اتصال نرمافزار به مدلهای مختلف میتوانید از مستندات API درواره استفاده کنید.
آیا افزودن داده همیشه مشکل را حل میکند؟
خیر. افزودن داده زمانی مفید است که:
- مدل ظرفیت کافی داشته باشد.
- نمونههای جدید متنوع باشند.
- شکاف آموزش و اعتبارسنجی نشاندهنده Variance بالا باشد.
- برچسبها معتبر باشند.
- دادههای جدید نماینده محیط واقعی باشند.
افزودن هزاران نمونه تکراری یا کمکیفیت ممکن است هیچ بهبودی ایجاد نکند.
اگر مدل Underfit باشد، احتمالاً باید معماری، ویژگیها یا فرایند آموزش اصلاح شود.
چه زمانی مدل سادهتر بهتر است؟
مدل سادهتر ممکن است انتخاب بهتری باشد اگر:
- اختلاف کیفیت آن با مدل پیچیده کم باشد.
- داده آموزشی محدود باشد.
- سرعت پاسخ اهمیت داشته باشد.
- توضیحپذیری لازم باشد.
- هزینه پردازش مهم باشد.
- پایداری در Production اولویت داشته باشد.
بهترین مدل لزوماً مدلی نیست که بیشترین امتیاز Validation را با اختلاف ناچیز به دست آورده است. هزینه، تأخیر، ثبات و پیچیدگی نگهداری نیز باید در تصمیم لحاظ شوند.
مانیتورینگ Overfitting پس از انتشار
ارزیابی نباید با استقرار مدل تمام شود. در محیط واقعی موارد زیر را ثبت کنید:
- نسخه مدل
- نسخه داده آموزشی
- نسخه پرامپت
- معیارهای هر کلاس
- نرخ ارجاع به انسان
- میزان اصلاح خروجی توسط کارشناس
- خطاهای پرتکرار
- توزیع ورودیها
- زمان پاسخ
- هزینه هر درخواست
- درصد خروجی نامعتبر
اگر عملکرد Production نسبت به Test Set بسیار ضعیفتر باشد، این احتمالها را بررسی کنید:
- Test Set نماینده کاربران واقعی نیست.
- مدل روی مجموعه ارزیابی Overfit شده است.
- توزیع داده تغییر کرده است.
- ورودیهای Production پیچیدهتر هستند.
- پیشپردازش آموزش و Production متفاوت است.
- داده مرجع یا برچسبها کیفیت کافی ندارند.
اشتباهات رایج
انتخاب مدل بر اساس امتیاز Training
امتیاز Training معیار تعمیمپذیری نیست.
مشاهده مکرر Test Set
هر بار تصمیمگیری بر اساس Test Set، استقلال آن را کاهش میدهد.
افزودن ویژگیهای بیشتر بدون ارزیابی
ویژگی بیشتر میتواند نویز و خطر Overfitting را افزایش دهد.
استفاده از داده تکراری
نمونههای تکراری میان بخشهای داده نتیجه آزمایش را غیرواقعی میکنند.
اعمال پیشپردازش پیش از تقسیم داده
Scaler، Vectorizer و Feature Selector باید فقط روی Training Set آموزش ببینند.
انتخاب مدل بسیار پیچیده برای داده کوچک
مدل باید با اندازه و تنوع داده متناسب باشد.
استفاده از فقط یک تقسیم تصادفی
نتیجه یک تقسیم ممکن است اتفاقی باشد. Cross-validation دید مطمئنتری ارائه میدهد.
نادیدهگرفتن تغییرات زمانی
داده واقعی ممکن است در طول زمان تغییر کند. ارزیابی زمانی برای بعضی پروژهها ضروری است.
Regularization بیشازحد
محدودیت شدید میتواند Overfitting را به Underfitting تبدیل کند.
تنظیم پرامپت روی مثالهای Test
این کار ارزیابی مدل زبانی را نامعتبر میکند.
چکلیست تشخیص و رفع بیشبرازش
پیش از انتشار مدل بررسی کنید:
- Training، Validation و Test کاملاً جدا هستند.
- نمونههای تکراری حذف شدهاند.
- پیشپردازش داخل Pipeline انجام میشود.
- امتیاز Training و Validation مقایسه شده است.
- Cross-validation اجرا شده است.
- پراکندگی نتایج Foldها بررسی شده است.
- Learning Curve رسم شده است.
- مدل سادهتر نیز بهعنوان Baseline آزمایش شده است.
- Regularization تنظیم شده است.
- Early Stopping در صورت نیاز فعال است.
- معیارهای هر کلاس بررسی شدهاند.
- Test Set هنگام توسعه استفاده نشده است.
- داده واقعی پس از انتشار نمونهبرداری و ارزیابی میشود.
- نسخه مدل، داده و پرامپت ثبت میشود.
پرسشهای متداول
Overfitting به فارسی چیست؟
Overfitting معمولاً «بیشبرازش» ترجمه میشود. در این وضعیت مدل داده آموزشی را بیشازحد یاد میگیرد و روی داده جدید عملکرد ضعیفتری دارد.
Underfitting به فارسی چیست؟
Underfitting یا کمبرازش زمانی رخ میدهد که مدل حتی الگوهای اصلی داده آموزشی را نیز بهخوبی یاد نگیرد.
چگونه بفهمیم مدل Overfit شده است؟
اگر عملکرد Training بسیار خوب اما عملکرد Validation یا Test بهوضوح ضعیفتر باشد، احتمال بیشبرازش وجود دارد. Learning Curve و Cross-validation نیز به تشخیص کمک میکنند.
آیا Accuracy بالا نشانه نبود Overfitting است؟
خیر. اگر Accuracy روی داده آموزشی یا یک Test Set آلوده محاسبه شده باشد، ممکن است گمراهکننده باشد.
آیا داده بیشتر همیشه Overfitting را کاهش میدهد؟
داده بیشتر و متنوع معمولاً کمک میکند، اما داده تکراری، نامرتبط یا دارای برچسب اشتباه ممکن است سودی نداشته باشد.
آیا مدلهای بزرگ بیشتر Overfit میشوند؟
مدلهای دارای ظرفیت بالا توانایی بیشتری برای حفظ جزئیات داده دارند، اما میزان Overfitting به اندازه داده، Regularization، روش آموزش و ارزیابی نیز وابسته است.
بهترین روش جلوگیری از Overfitting چیست؟
یک روش واحد وجود ندارد. جداسازی صحیح داده، Cross-validation، مدل متناسب، Regularization، Early Stopping، داده متنوع و ارزیابی مستمر معمولاً در کنار هم استفاده میشوند.
آیا پرامپت هم میتواند Overfit شود؟
بله. اگر پرامپت بارها بر اساس مجموعهای کوچک از مثالها تغییر کند، ممکن است روی همان مثالها عالی و روی ورودیهای واقعی ضعیف باشد.
تفاوت Overfitting و Data Leakage چیست؟
Overfitting یعنی مدل به الگوهای خاص داده آموزش وابسته شده است. Data Leakage یعنی اطلاعاتی که نباید در دسترس مدل باشد وارد فرایند آموزش یا انتخاب شده است. نشت داده میتواند نتیجهای شبیه عملکرد غیرواقعی و بیشبرازش ایجاد کند.
جمعبندی
بیشبرازش زمانی رخ میدهد که مدل داده آموزشی را بسیار خوب یاد بگیرد، اما نتواند همان عملکرد را روی دادههای جدید حفظ کند. کمبرازش نیز زمانی اتفاق میافتد که مدل برای یادگیری الگوهای اصلی داده بیشازحد ساده یا محدود باشد.
برای ساخت مدلی با تعمیمپذیری مناسب:
- دادهها را بهدرستی تفکیک کنید.
- از نشت اطلاعات جلوگیری کنید.
- امتیاز Training و Validation را کنار هم ببینید.
- از Cross-validation و Learning Curve استفاده کنید.
- مدل سادهتر را بهعنوان Baseline نگه دارید.
- Regularization و Early Stopping را تنظیم کنید.
- دادههای متنوع و واقعی جمعآوری کنید.
- Test Set را تا ارزیابی نهایی دستنخورده نگه دارید.
- روی مجموعه ارزیابی کوچک، پرامپت را بیشازحد تنظیم نکنید.
- عملکرد Production را بهصورت مستمر اندازهگیری کنید.
برای مقایسه چند مدل هوش مصنوعی روی مجموعه ارزیابی ثابت، میتوانید از API سازگار با OpenAI درواره استفاده کنید. یکپارچگی API باعث میشود مدل را بدون بازنویسی گسترده کد تغییر دهید و کیفیت، سرعت و هزینه گزینههای مختلف را بسنجید.
مقالات مرتبط
- یادگیری ماشین چیست؟
- آموزش Scikit-learn با پایتون
- ماتریس درهمریختگی و معیارهای ارزیابی مدل
- ارزیابی مدلهای هوش مصنوعی و طراحی Evals
- آموزش Logistic Regression
- آموزش درخت تصمیم و Random Forest
- آموزش شبکه عصبی
- آموزش اتصال API هوش مصنوعی به نرمافزار
منابع
- Scikit-learn: Underfitting vs. Overfitting
- Scikit-learn: Learning and Validation Curves
- Scikit-learn: Cross-validation
- Google Machine Learning: Overfitting
- Google Machine Learning: Regularization
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



