
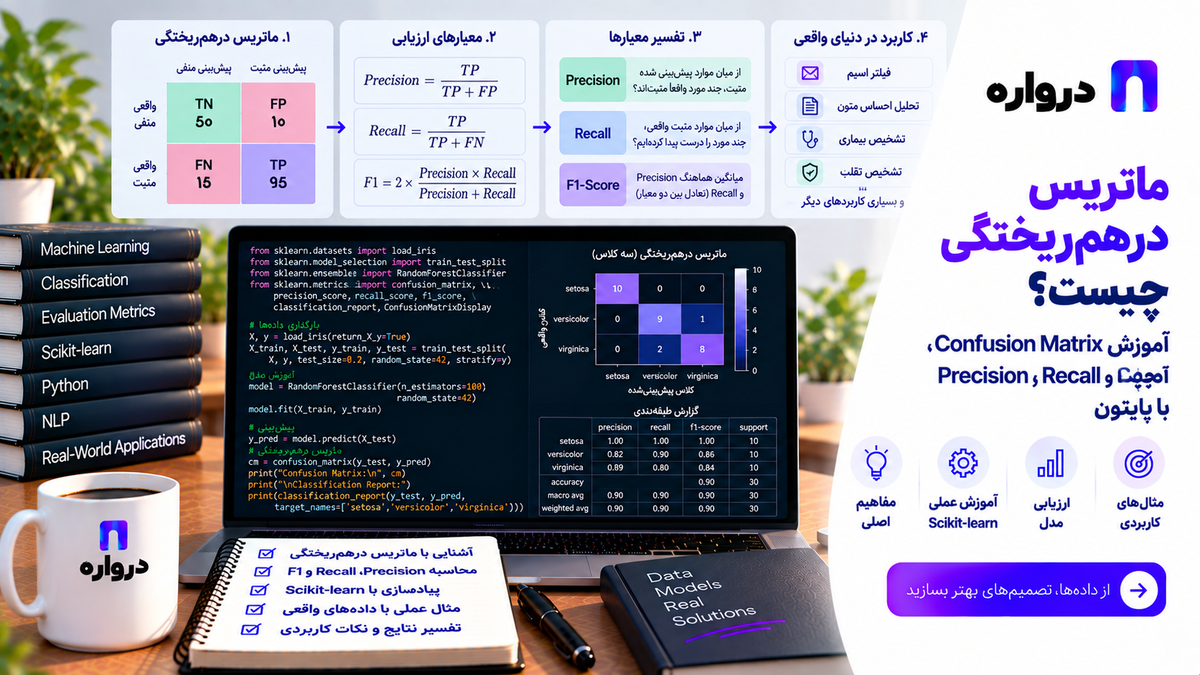
ماتریس درهمریختگی چیست؟ آموزش Confusion Matrix، Precision، Recall و F1 با پایتون
ماتریس درهمریختگی نشان میدهد مدل طبقهبندی دقیقاً در تشخیص کدام کلاسها موفق یا ناموفق بوده است. در این راهنما Confusion Matrix، Precision، Recall و F1 را با مثال واقعی و کد پایتون یاد میگیرید.

فرض کنید مدلی ساختهاید که پیامهای مشتریان را به سه گروه «فروش»، «پشتیبانی فنی» و «مالی» تقسیم میکند. مدل روی داده آزمایش به دقت ۹۲ درصد رسیده است؛ اما آیا همین عدد برای انتشار مدل کافی است؟
ممکن است مدل تقریباً تمام پیامهای فروش را درست تشخیص دهد، ولی نیمی از درخواستهای مالی را اشتباه به واحد پشتیبانی بفرستد. عدد Accuracy بهتنهایی این ضعف را آشکار نمیکند.
اینجاست که ماتریس درهمریختگی یا Confusion Matrix اهمیت پیدا میکند. این ماتریس نشان میدهد پیشبینیهای درست و اشتباه مدل دقیقاً در کدام کلاسها اتفاق افتادهاند.
در این راهنما با مفاهیم زیر آشنا میشوید:
- ماتریس درهمریختگی چیست؟
- TP، TN، FP و FN چه معنایی دارند؟
- تفاوت Accuracy، Precision، Recall و F1 چیست؟
- برای هر پروژه باید کدام معیار را انتخاب کرد؟
- چگونه Confusion Matrix را با پایتون و Scikit-learn رسم کنیم؟
- معیارهای Macro، Micro و Weighted چه تفاوتی دارند؟
- چگونه آستانه تصمیم مدل را تنظیم کنیم؟
- چگونه یک مدل متصل به API هوش مصنوعی درواره را ارزیابی کنیم؟
ماتریس درهمریختگی چیست؟
ماتریس درهمریختگی جدولی است که برچسب واقعی نمونهها را با برچسب پیشبینیشده مدل مقایسه میکند.
هر سطر نماینده کلاس واقعی و هر ستون نماینده کلاس پیشبینیشده است. در پیادهسازی Scikit-learn نیز سطرها به برچسب واقعی و ستونها به خروجی مدل اختصاص دارند. البته بعضی منابع قرارداد محورها را برعکس در نظر میگیرند؛ بنابراین هنگام خواندن هر نمودار باید عنوان محورها را بررسی کنید.
برای یک مسئله دودویی، ساختار ماتریس به این صورت است:
| وضعیت واقعی | پیشبینی منفی | پیشبینی مثبت |
|---|---|---|
| منفی | True Negative | False Positive |
| مثبت | False Negative | True Positive |
چهار خانه این جدول، پایه بیشتر معیارهای ارزیابی طبقهبندی هستند.
TP، TN، FP و FN چه معنایی دارند؟
برای درک بهتر، مدلی را در نظر بگیرید که پیامهای پشتیبانی را از نظر «فوری» یا «عادی» دستهبندی میکند.
True Positive یا TP
پیام واقعاً فوری بوده و مدل نیز آن را فوری تشخیص داده است.
نمونه:
«سرویس شرکت کاملاً قطع شده و هیچ کاربری امکان ورود ندارد.»
مدل این پیام را بهدرستی در صف فوری قرار میدهد.
True Negative یا TN
پیام عادی بوده و مدل نیز آن را عادی تشخیص داده است.
نمونه:
«لطفاً لینک مستندات نصب را ارسال کنید.»
False Positive یا FP
پیام عادی بوده، اما مدل آن را فوری تشخیص داده است.
این خطا باعث شلوغشدن صف فوری و مصرف ظرفیت کارشناسان میشود.
False Negative یا FN
پیام واقعاً فوری بوده، اما مدل آن را عادی تشخیص داده است.
در این مثال، False Negative معمولاً هزینه بیشتری دارد؛ زیرا ممکن است یک اختلال جدی دیرتر بررسی شود.
یک مثال واقعی از ماتریس درهمریختگی
فرض کنید مدل روی ۱۰۰ پیام آزمایش شده و نتیجه زیر به دست آمده است:
| وضعیت واقعی | پیشبینی عادی | پیشبینی فوری |
|---|---|---|
| عادی | ۷۰ | ۱۰ |
| فوری | ۵ | ۱۵ |
تفسیر نتیجه:
- ۷۰ پیام عادی بهدرستی عادی تشخیص داده شدهاند.
- ۱۵ پیام فوری بهدرستی شناسایی شدهاند.
- ۱۰ پیام عادی اشتباهاً فوری تشخیص داده شدهاند.
- ۵ پیام فوری از دست رفته و عادی تشخیص داده شدهاند.
اکنون بهجای یک عدد کلی، دقیقاً میدانیم مدل چه نوع خطاهایی دارد.
چرا Accuracy بهتنهایی کافی نیست؟
Accuracy نشان میدهد چه سهمی از کل پیشبینیها درست بودهاند. این معیار در دادههایی که کلاسها تقریباً متعادلاند مفید است، اما در دادههای نامتوازن میتواند تصویری گمراهکننده ایجاد کند.
فرض کنید از هر ۱۰۰۰ پیام، تنها ۲۰ پیام فوری باشند. مدلی که تمام پیامها را «عادی» اعلام کند، ظاهراً دقت بسیار بالایی دارد؛ ولی حتی یک پیام فوری را هم پیدا نکرده است.
بنابراین در پروژههایی که یک کلاس کمتعداد اما مهم وجود دارد، باید Accuracy را همراه با Precision، Recall، F1 و خود ماتریس درهمریختگی بررسی کرد.
Precision چیست؟
Precision به این پرسش پاسخ میدهد:
از میان تمام مواردی که مدل مثبت اعلام کرده، چند مورد واقعاً مثبت بودهاند؟
در مثال پیامهای فوری، Precision بالا یعنی بیشتر پیامهایی که وارد صف فوری شدهاند واقعاً فوری هستند.
Precision زمانی اهمیت بیشتری دارد که False Positive پرهزینه باشد. برای مثال:
- ارجاع اشتباه تعداد زیادی پیام به کارشناسان ارشد
- علامتگذاری اشتباه دیدگاه سالم بهعنوان اسپم
- ارسال پیشنهاد فروش به کاربری که علاقهای نشان نداده است
- اجرای یک فرایند دستی و پرهزینه بر اساس پیشبینی مدل
اگر مدل Precision پایینی داشته باشد، کاربران یا کارشناسان به هشدارهای آن اعتماد نخواهند کرد.
Recall چیست؟
Recall به این پرسش پاسخ میدهد:
از میان تمام موارد مثبت واقعی، مدل چند مورد را پیدا کرده است؟
در مثال ما، Recall بالا یعنی مدل بخش بزرگی از تمام پیامهای فوری را شناسایی کرده است.
Recall زمانی اولویت دارد که از دست رفتن نمونه مثبت هزینه زیادی داشته باشد. برای مثال:
- نادیدهگرفتن درخواست فوری مشتری
- پیدانکردن سفارشهایی که نیازمند بررسی انسانیاند
- از دست دادن پیامهای مرتبط با لغو سرویس
- تشخیصندادن یک خطای مهم در گزارشهای عملیاتی
افزایش Recall معمولاً میتواند تعداد False Positive را نیز افزایش دهد. به همین دلیل باید میان پوشش بیشتر و هشدار اشتباه تعادل برقرار کرد.
F1 Score چیست؟
F1 معیاری ترکیبی برای سنجش همزمان Precision و Recall است.
این معیار زمانی مناسب است که:
- هر دو نوع خطای False Positive و False Negative مهم باشند.
- دادهها نامتوازن باشند.
- به یک معیار واحد برای مقایسه چند مدل نیاز داشته باشید.
- Accuracy اطلاعات کافی درباره کلاس مهم ارائه نکند.
F1 بالا فقط زمانی به دست میآید که Precision و Recall هر دو وضعیت مناسبی داشته باشند. اگر یکی از آنها بسیار پایین باشد، امتیاز F1 نیز کاهش پیدا میکند.
بااینحال، حتی F1 نیز نباید بدون توجه به مسئله کسبوکار استفاده شود. دو مدل ممکن است F1 مشابهی داشته باشند، ولی یکی Recall بالاتر و دیگری Precision بالاتری ارائه کند.
مقایسه Accuracy، Precision، Recall و F1
| معیار | پرسش اصلی | کاربرد مناسب |
|---|---|---|
| Accuracy | چه تعداد از کل پیشبینیها درستاند؟ | داده نسبتاً متعادل |
| Precision | چند مورد از پیشبینیهای مثبت واقعاً مثبتاند؟ | کاهش هشدارهای اشتباه |
| Recall | چند مورد از مثبتهای واقعی پیدا شدهاند؟ | کاهش موارد ازدسترفته |
| F1 | تعادل Precision و Recall چگونه است؟ | داده نامتوازن و مقایسه مدلها |
| Confusion Matrix | مدل دقیقاً کدام کلاسها را اشتباه میگیرد؟ | تحلیل جزئی خطاها |
آموزش محاسبه Confusion Matrix با پایتون
ابتدا کتابخانههای لازم را نصب کنید:
pip install scikit-learn matplotlibسپس چند برچسب واقعی و پیشبینیشده تعریف کنید:
from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix,
    precision_score,
    recall_score,
    f1_score,
)

y_true = [
    "عادی", "عادی", "فوری", "عادی", "فوری",
    "فوری", "عادی", "عادی", "فوری", "عادی",
]

y_pred = [
    "عادی", "فوری", "فوری", "عادی", "عادی",
    "فوری", "عادی", "عادی", "فوری", "عادی",
]

labels = ["عادی", "فوری"]

matrix = confusion_matrix(
    y_true,
    y_pred,
    labels=labels,
)

print(matrix)

print(
    "Accuracy:",
    accuracy_score(y_true, y_pred),
)

print(
    "Precision:",
    precision_score(
        y_true,
        y_pred,
        pos_label="فوری",
    ),
)

print(
    "Recall:",
    recall_score(
        y_true,
        y_pred,
        pos_label="فوری",
    ),
)

print(
    "F1:",
    f1_score(
        y_true,
        y_pred,
        pos_label="فوری",
    ),
)

print(
    classification_report(
        y_true,
        y_pred,
        labels=labels,
        zero_division=0,
    )
)
تابع classification_report گزارشی شامل Precision، Recall، F1 و تعداد نمونههای هر کلاس تولید میکند.
رسم نمودار ماتریس درهمریختگی
برای نمایش تصویری ماتریس میتوان از ConfusionMatrixDisplay استفاده کرد:
import matplotlib.pyplot as plt

from sklearn.metrics import ConfusionMatrixDisplay

ConfusionMatrixDisplay.from_predictions(
    y_true,
    y_pred,
    labels=["عادی", "فوری"],
    cmap="Blues",
    values_format="d",
)

plt.title("Confusion Matrix")
plt.tight_layout()
plt.show()
هرچه مقدارهای قطر اصلی بیشتر باشند، پیشبینیهای صحیح مدل بیشتر است. خانههای خارج از قطر، نوع و تعداد خطاها را نشان میدهند.
برای جلوگیری از مشکل نمایش حروف فارسی در بعضی محیطها، میتوانید عنوان نمودار را انگلیسی نگه دارید یا فونت فارسی مناسب Matplotlib را تنظیم کنید.
ماتریس نرمالشده چیست؟
در یک مجموعه داده نامتوازن، تعداد خام نمونهها ممکن است مقایسه کلاسها را دشوار کند. ماتریس نرمالشده، نتیجه را بهصورت نسبت نمایش میدهد.
ConfusionMatrixDisplay.from_predictions(
    y_true,
    y_pred,
    labels=["عادی", "فوری"],
    normalize="true",
    cmap="Blues",
    values_format=".2f",
)

plt.title("Normalized Confusion Matrix")
plt.tight_layout()
plt.show()
در Scikit-learn گزینه normalize="true" هر سطر را بر اساس تعداد نمونههای واقعی همان کلاس نرمال میکند. گزینههای دیگری نیز برای نرمالسازی بر اساس پیشبینیها یا کل نمونهها وجود دارند.
پیشنهاد میشود در گزارش پروژه هر دو نسخه را نگه دارید:
- ماتریس خام برای مشاهده تعداد واقعی خطاها
- ماتریس نرمالشده برای مقایسه منصفانه کلاسها
آموزش Confusion Matrix چندکلاسه
بسیاری از پروژهها بیشتر از دو کلاس دارند. برای مثال، یک سامانه پشتیبانی ممکن است پیامها را در دستههای زیر قرار دهد:
- فروش
- فنی
- مالی
- پیشنهاد محصول
- سایر
در این حالت ماتریس پنج سطر و پنج ستون خواهد داشت:
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
)

labels = [
    "sales",
    "technical",
    "billing",
    "feedback",
    "other",
]

y_true = [
    "sales",
    "technical",
    "billing",
    "technical",
    "feedback",
    "billing",
    "other",
    "sales",
]

y_pred = [
    "sales",
    "technical",
    "technical",
    "other",
    "feedback",
    "billing",
    "other",
    "billing",
]

matrix = confusion_matrix(
    y_true,
    y_pred,
    labels=labels,
)

print(matrix)

print(
    classification_report(
        y_true,
        y_pred,
        labels=labels,
        zero_division=0,
    )
)
در ماتریس چندکلاسه، هر خانه خارج از قطر یک الگوی خطای مشخص را نشان میدهد. برای مثال، بزرگبودن خانه مربوط به «مالی واقعی، فنی پیشبینیشده» نشان میدهد مدل این دو مفهوم را با یکدیگر اشتباه میگیرد.
این اطلاعات مستقیماً به بهبود مدل کمک میکنند. احتمالاً باید:
- نمونههای آموزشی مالی بیشتری جمعآوری کنید.
- تعریف دستهها را شفافتر کنید.
- پیامهای مبهم را بازبینی کنید.
- به پرامپت مدل مثالهای مرزی اضافه کنید.
- امکان ارجاع موارد نامطمئن به انسان را فراهم کنید.
Macro، Micro و Weighted Average چه هستند؟
در طبقهبندی چندکلاسه معمولاً چند نوع میانگین در گزارش دیده میشود.
Macro Average
معیار هر کلاس جداگانه محاسبه میشود و سپس همه کلاسها وزن برابر میگیرند.
Macro Average برای زمانی مناسب است که عملکرد روی کلاسهای کمتعداد نیز بهاندازه کلاسهای پرتعداد اهمیت دارد.
اگر مدل روی کلاس بزرگ عملکرد عالی و روی کلاس کوچک عملکرد ضعیفی داشته باشد، Macro Average این ضعف را بهتر آشکار میکند.
Weighted Average
در این روش، سهم هر کلاس متناسب با تعداد نمونههای آن است.
Weighted Average برای ارائه تصویری کلی از عملکرد روی توزیع فعلی داده مفید است، اما ممکن است ضعف مدل روی کلاسهای کوچک را کمتر نشان دهد.
Micro Average
در Micro Average ابتدا نتایج تمام کلاسها با هم تجمیع و سپس معیار محاسبه میشود.
در طبقهبندی چندکلاسه تکبرچسبی، Micro Average اغلب به نتیجهای نزدیک یا معادل Accuracy میرسد. مستندات Scikit-learn نیز توضیح میدهد که در بعضی گزارشهای چندکلاسه، Micro Average به دلیل همارزی با Accuracy نمایش داده نمیشود.
کدام میانگین بهتر است؟
هیچ گزینهای همیشه بهترین نیست:
- برای اهمیت برابر همه کلاسها:
macro - برای توجه به توزیع واقعی داده:
weighted - برای عملکرد کلی روی تمام تصمیمها:
micro - برای بررسی دقیق: معیار هر کلاس را جداگانه بخوانید
آستانه تصمیم مدل چیست؟
بسیاری از مدلها بهجای ارائه مستقیم برچسب، احتمال تعلق نمونه به یک کلاس را تولید میکنند.
برای مثال:
احتمال فوری بودن پیام: 0.63اگر آستانه تصمیم ۰٫۵ باشد، این پیام فوری شناخته میشود. اگر آستانه را به ۰٫۷ افزایش دهید، همین پیام عادی خواهد بود.
تغییر آستانه روی Precision و Recall اثر میگذارد:
- کاهش آستانه معمولاً نمونههای بیشتری را مثبت میکند و میتواند Recall را افزایش دهد.
- افزایش آستانه مدل را محتاطتر میکند و ممکن است Precision را افزایش دهد.
- آستانه پیشفرض لزوماً بهترین انتخاب برای مسئله کسبوکار نیست.
منحنی Precision-Recall برای بررسی عملکرد مدل در آستانههای مختلف استفاده میشود و مخصوصاً در دادههای نامتوازن مفید است.
تنظیم آستانه با پایتون
فرض کنید مدل با predict_proba احتمال کلاس فوری را برمیگرداند:
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
)

urgent_probability = model.predict_proba(X_test)[:, 1]

threshold = 0.65

y_pred = [
    "فوری" if probability >= threshold else "عادی"
    for probability in urgent_probability
]

print(
    confusion_matrix(
        y_test,
        y_pred,
        labels=["عادی", "فوری"],
    )
)

print(
    classification_report(
        y_test,
        y_pred,
        labels=["عادی", "فوری"],
        zero_division=0,
    )
)
چند آستانه را روی مجموعه Validation آزمایش کنید و گزینهای را انتخاب کنید که هزینه واقعی خطاهای کسبوکار را بهتر مدیریت میکند.
آستانه را نباید مستقیماً با مجموعه Test انتخاب کرد. مجموعه Test باید برای ارزیابی نهایی و مستقل باقی بماند.
مثال کامل: ارزیابی دستهبندی پیامهای فارسی
در این مثال یک مدل ساده با TF-IDF و Logistic Regression میسازیم:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (
ConfusionMatrixDisplay,
classification_report,
)
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
messages = [
"قیمت پلن سازمانی چقدر است؟",
"برای خرید اشتراک راهنمایی میخواهم",
"امکان ورود به حساب وجود ندارد",
"API خطای اتصال میدهد",
"فاکتور پرداخت را دریافت نکردهام",
"مبلغ از کیف پول کم شده است",
"پیشنهاد میکنم جستجو سریعتر شود",
"لطفاً حالت تاریک اضافه کنید",
"برای دمو و خرید تماس بگیرید",
"پاسخ API خالی برمیگردد",
"چطور صورتحساب را دانلود کنم؟",
"طراحی پنل کاربری بهتر شده است",
]
labels = [
"sales",
"sales",
"technical",
"technical",
"billing",
"billing",
"feedback",
"feedback",
"sales",
"technical",
"billing",
"feedback",
]
X_train, X_test, y_train, y_test = train_test_split(
messages,
labels,
test_size=0.33,
random_state=42,
stratify=labels,
)
pipeline = Pipeline(
[
(
"tfidf",
TfidfVectorizer(
ngram_range=(1, 2),
min_df=1,
),
),
(
"classifier",
LogisticRegression(
max_iter=1000,
),
),
]
)
pipeline.fit(X_train, y_train)
y_pred = pipeline.predict(X_test)
print(
classification_report(
y_test,
y_pred,
zero_division=0,
)
)
ConfusionMatrixDisplay.from_predictions(
y_test,
y_pred,
labels=[
"sales",
"technical",
"billing",
"feedback",
],
cmap="Blues",
)این داده فقط برای نمایش ساختار کد کوچک نگه داشته شده است. برای یک پروژه واقعی باید صدها یا هزاران نمونه واقعی، متنوع و بازبینیشده در اختیار داشته باشید.
ارزیابی مدل هوش مصنوعی متصل به API درواره
ماتریس درهمریختگی فقط برای مدلهایی که خودتان آموزش دادهاید نیست. میتوان خروجی مدلهای زبانی را نیز در وظایف طبقهبندی ارزیابی کرد.
فرض کنید میخواهید از یک مدل در دسترس از طریق API درواره برای دستهبندی پیام مشتری استفاده کنید. ابتدا یک مجموعه داده ارزیابی بسازید:
evaluation_data = [
{
"text": "برای خرید اعتبار سازمانی راهنمایی میخواهم.",
"expected": "sales",
},
{
"text": "درخواست API با خطای 500 متوقف میشود.",
"expected": "technical",
},
{
"text": "فاکتور آخر در پنل نمایش داده نمیشود.",
"expected": "billing",
},
{
"text": "امکان جستجو میان درخواستها اضافه شود.",
"expected": "feedback",
},
]سپس مدل را از طریق API سازگار با OpenAI درواره فراخوانی کنید:
pip install openai pydantic scikit-learnمتغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
کد ارزیابی:
import os
from typing import Literal
from openai import OpenAI
from pydantic import BaseModel
from sklearn.metrics import (
classification_report,
confusion_matrix,
)
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
MODEL_ID = os.environ["DARVAREH_MODEL"]
class ClassificationResult(BaseModel):
category: Literal[
"sales",
"technical",
"billing",
"feedback",
"other",
]
def classify_message(message: str) -> str:
completion = client.chat.completions.create(
model=MODEL_ID,
temperature=0,
messages=[
{
"role": "system",
"content": (
"پیام مشتری را دستهبندی کن. "
"category فقط یکی از مقادیر sales، "
"technical، billing، feedback یا other باشد. "
"فقط JSON معتبر برگردان."
),
},
{
"role": "user",
"content": message,
},
],
)
content = completion.choices[0].message.content
if not content:
raise ValueError("پاسخ خالی از مدل دریافت شد.")
result = ClassificationResult.model_validate_json(content)
return result.category
evaluation_data = [
{
"text": "برای خرید اعتبار سازمانی راهنمایی میخواهم.",
"expected": "sales",
},
{
"text": "درخواست API با خطای 500 متوقف میشود.",
"expected": "technical",
},
{
"text": "فاکتور آخر در پنل نمایش داده نمیشود.",
"expected": "billing",
},
{
"text": "امکان جستجو میان درخواستها اضافه شود.",
"expected": "feedback",
},
]
y_true = []
y_pred = []
for item in evaluation_data:
prediction = classify_message(item["text"])
y_true.append(item["expected"])
y_pred.append(prediction)
labels = [
"sales",
"technical",
"billing",
"feedback",
"other",
]
print(
confusion_matrix(
y_true,
y_pred,
labels=labels,
)
)
print(
classification_report(
y_true,
y_pred,
labels=labels,
zero_division=0,
)
)شناسه مدل را باید از فهرست فعلی مدلهای درواره انتخاب کنید. ثابتنکردن شناسه مدل در کد باعث میشود بتوانید چند مدل را روی مجموعه ارزیابی یکسان مقایسه کنید.
چگونه چند مدل هوش مصنوعی را مقایسه کنیم؟
برای مقایسه منصفانه مدلها، شرایط آزمایش را ثابت نگه دارید:
- مجموعه داده ارزیابی یکسان باشد.
- برچسبهای مرجع توسط انسان بازبینی شوند.
- متن پرامپت برای همه مدلها یکسان باشد.
- تنظیمات تولید تا حد امکان ثابت بمانند.
- خطاهای JSON و پاسخهای خالی نیز ثبت شوند.
- زمان پاسخ و هزینه در کنار کیفیت اندازهگیری شوند.
- معیار هر کلاس جداگانه گزارش شود.
جدول مقایسه میتواند چنین ساختاری داشته باشد:
| مدل | Macro F1 | Recall فنی | Precision مالی | زمان متوسط | خطای ساختاری |
|---|---|---|---|---|---|
| مدل A | ۰٫۸۷ | ۰٫۹۱ | ۰٫۸۵ | ۱٫۲ ثانیه | ۱٪ |
| مدل B | ۰٫۸۹ | ۰٫۸۶ | ۰٫۹۳ | ۲٫۱ ثانیه | ۰٪ |
| مدل C | ۰٫۸۳ | ۰٫۹۴ | ۰٫۷۹ | ۰٫۸ ثانیه | ۲٪ |
ممکن است مدل A بهترین انتخاب کلی باشد، درحالیکه مدل B برای وظایف مالی و مدل C برای مسیرهای حساس به سرعت مناسبتر باشد.
برای آشنایی بیشتر با این رویکرد، مقاله ارزیابی مدلهای هوش مصنوعی را مطالعه کنید.
ارزیابی روی داده آموزش اشتباه است
یکی از خطاهای رایج این است که مدل روی همان دادهای ارزیابی شود که قبلاً آن را دیده است. نتیجه چنین آزمایشی معمولاً خوشبینانه است.
برای ارزیابی درست از این تقسیمبندی استفاده کنید:
- Training Set برای آموزش مدل
- Validation Set برای انتخاب تنظیمات و آستانه
- Test Set برای ارزیابی نهایی
اگر داده کمی دارید، Cross-validation گزینه مناسبتری است.
from sklearn.model_selection import (
    StratifiedKFold,
    cross_val_predict,
)
from sklearn.metrics import classification_report

cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

out_of_fold_predictions = cross_val_predict(
    pipeline,
    messages,
    labels,
    cv=cv,
)

print(
    classification_report(
        labels,
        out_of_fold_predictions,
        zero_division=0,
    )
)پیشبینیهای Out-of-fold کمک میکنند ماتریس درهمریختگی واقعبینانهتری از داده محدود به دست آورید.
چگونه مجموعه داده ارزیابی باکیفیت بسازیم؟
کیفیت Confusion Matrix مستقیماً به کیفیت برچسبهای واقعی وابسته است. اگر برچسب مرجع اشتباه باشد، معیارها نیز قابل اعتماد نخواهند بود.
یک مجموعه ارزیابی مناسب باید شامل موارد زیر باشد:
- نمونههای پرتکرار واقعی
- نمونههای دشوار و مرزی
- متنهای کوتاه و بلند
- غلطهای املایی و محاوره فارسی
- پیامهای چندمنظوره
- کلاسهای کمتعداد
- نمونههایی که باید به کلاس
otherبروند - ورودیهای نامعتبر یا ناقص
- داده مربوط به دورههای زمانی مختلف
بهتر است بخشی از نمونهها توسط دو نفر مستقل برچسبگذاری شوند. اختلاف میان برچسبگذاران میتواند نشان دهد تعریف کلاسها بهاندازه کافی روشن نیست.
تحلیل خطا مهمتر از عدد نهایی است
پس از ساخت ماتریس، فقط به رنگ خانهها نگاه نکنید. نمونههای خطادار را استخراج و بررسی کنید:
errors = []

for text, expected, predicted in zip(
    X_test,
    y_test,
    y_pred,
):
    if expected != predicted:
        errors.append(
            {
                "text": text,
                "expected": expected,
                "predicted": predicted,
            }
        )

for error in errors:
    print(error)
خطاها را میتوان در چند گروه قرار داد:
- برچسب مرجع اشتباه
- تعریف مبهم کلاس
- داده آموزشی ناکافی
- متن چندموضوعی
- واژه یا عبارت جدید
- پرامپت نامناسب
- خروجی نامعتبر مدل
- تفاوت زبان رسمی و محاورهای
- تغییر رفتار کاربران در طول زمان
این تحلیل مشخص میکند باید داده، مدل، پرامپت یا فرایند محصول را اصلاح کنید.
استفاده از کلاس Unknown یا ارجاع به انسان
مدل نباید مجبور باشد برای تمام ورودیها با اطمینان ظاهری یک کلاس انتخاب کند.
در سامانه واقعی میتوانید:
- کلاس
otherیاunknownتعریف کنید. - خروجیهای کماطمینان را به انسان ارجاع دهید.
- اختلاف میان دو مدل را برای بازبینی ارسال کنید.
- اقدامهای حساس را بدون تأیید سرور اجرا نکنید.
- نمونههای بازبینیشده را به مجموعه ارزیابی اضافه کنید.
این رویکرد معمولاً از تلاش برای دستیابی به پیشبینی کاملاً خودکار و بدون نظارت مطمئنتر است.
مانیتورینگ Confusion Matrix پس از انتشار
عملکرد مدل در محیط آزمایش ممکن است با محیط واقعی متفاوت باشد. پس از انتشار باید نمونهای از خروجیها را بهصورت دورهای بازبینی کنید.
موارد پیشنهادی برای ثبت:
- نسخه مدل
- نسخه پرامپت
- زمان درخواست
- برچسب پیشبینیشده
- برچسب نهایی تأییدشده
- میزان اطمینان
- زمان پاسخ
- خطای ساختاری
- کلاس یا قابلیت محصول
- هزینه درخواست
سپس Confusion Matrix را برای بازههای زمانی مختلف محاسبه کنید. کاهش Recall یک کلاس ممکن است نشانه تغییر نوع ورودی کاربران یا Data Drift باشد.
تفاوت Confusion Matrix با ROC و Precision-Recall Curve
Confusion Matrix عملکرد مدل را در یک آستانه مشخص نشان میدهد.
ROC Curve و Precision-Recall Curve رفتار مدل را در آستانههای مختلف بررسی میکنند.
| ابزار | کاربرد |
|---|---|
| Confusion Matrix | تحلیل خطاها در آستانه فعلی |
| Precision-Recall Curve | بررسی تعادل Precision و Recall |
| ROC Curve | مقایسه نرخ تشخیص صحیح و هشدار اشتباه |
| Classification Report | گزارش معیارها برای هر کلاس |
| PR-AUC | خلاصهکردن عملکرد Precision-Recall در آستانههای مختلف |
در دادههای بسیار نامتوازن، منحنی Precision-Recall معمولاً تصویر کاربردیتری از عملکرد کلاس مثبت ارائه میدهد.
اشتباهات رایج در استفاده از ماتریس درهمریختگی
جابهجا خواندن محورها
همیشه بررسی کنید سطر و ستون چه چیزی را نشان میدهند. قرارداد همه کتابخانهها و مقالات یکسان نیست.
گزارش فقط Accuracy
Accuracy بدون معیارهای هر کلاس میتواند ضعف مدل را پنهان کند.
ارزیابی روی داده آموزش
این کار نتیجهای خوشبینانه و غیرقابل اعتماد تولید میکند.
حذف کلاسهای بدون پیشبینی
اگر مدل هیچ نمونهای را به یک کلاس نسبت نداده باشد، همان کلاس باید در گزارش باقی بماند. حذف آن مشکل مدل را مخفی میکند.
استفاده از Weighted F1 بهتنهایی
کلاس پرتعداد میتواند روی Weighted F1 غلبه کند. Macro F1 و Recall کلاسهای مهم را نیز بررسی کنید.
انتخاب آستانه با داده Test
آستانه باید با Validation Set انتخاب شود. Test Set برای گزارش نهایی باقی میماند.
نادیدهگرفتن هزینه کسبوکار
همه خطاها هزینه یکسان ندارند. پیش از انتخاب معیار اصلی مشخص کنید False Positive یا False Negative چه اثری بر محصول دارد.
مقایسه مدلها روی دادههای متفاوت
هر مدل باید روی مجموعه، برچسبها و قواعد ارزیابی یکسان آزمایش شود.
کوچکبودن مجموعه ارزیابی
عملکرد عالی روی چند نمونه محدود، شواهد کافی برای انتشار مدل نیست.
چکلیست ارزیابی یک مدل طبقهبندی
پیش از انتشار مدل، این موارد را بررسی کنید:
- کلاسها تعریف روشن و غیرهمپوشان دارند.
- داده Test از فرایند آموزش جدا است.
- تعداد نمونه هر کلاس گزارش شده است.
- Confusion Matrix خام ذخیره شده است.
- نسخه نرمالشده نیز بررسی شده است.
- Precision، Recall و F1 هر کلاس مشخصاند.
- Macro F1 در کنار Weighted F1 گزارش شده است.
- نمونههای خطادار بهصورت دستی بررسی شدهاند.
- آستانه تصمیم بر اساس نیاز محصول انتخاب شده است.
- مدل با یک روش پایه ساده مقایسه شده است.
- نسخه مدل و پرامپت ثبت میشود.
- خروجی کماطمینان مسیر بازبینی انسانی دارد.
- عملکرد پس از انتشار مانیتور میشود.
پرسشهای متداول
ماتریس درهمریختگی چه چیزی را نشان میدهد؟
این ماتریس تعداد پیشبینیهای درست و اشتباه مدل را برای هر کلاس نشان میدهد و مشخص میکند مدل کدام دستهها را با یکدیگر اشتباه میگیرد.
نام فارسی Confusion Matrix چیست؟
اصطلاحهای «ماتریس درهمریختگی»، «ماتریس سردرگمی» و گاهی «ماتریس اغتشاش» استفاده میشوند. در متون فنی فارسی، ماتریس درهمریختگی و نام انگلیسی Confusion Matrix رایجتر هستند.
Precision مهمتر است یا Recall؟
به هزینه خطا بستگی دارد. اگر هشدار اشتباه پرهزینه باشد، Precision اهمیت بیشتری دارد. اگر ازدسترفتن موارد مثبت خطر اصلی باشد، Recall در اولویت قرار میگیرد.
آیا F1 بهتر از Accuracy است؟
همیشه خیر. F1 در دادههای نامتوازن و زمانی که هر دو معیار Precision و Recall مهماند مفیدتر است. Accuracy برای داده متعادل و خطاهای همهزینه قابل استفاده است.
آیا Confusion Matrix برای مدلهای چندکلاسه کاربرد دارد؟
بله. برای هر کلاس یک سطر و ستون ایجاد میشود و میتوان الگوهای اشتباه میان تمام کلاسها را مشاهده کرد.
Support در Classification Report چیست؟
Support تعداد نمونههای واقعی هر کلاس در مجموعه ارزیابی است. این عدد کمک میکند بفهمید هر معیار بر اساس چند نمونه محاسبه شده است.
آیا میتوان مدل زبانی را با Confusion Matrix ارزیابی کرد؟
بله. اگر وظیفه مدل خروجی دستهای مانند موضوع پیام، احساس متن یا نوع درخواست باشد، میتوان خروجی آن را با برچسب انسانی مقایسه و Confusion Matrix تولید کرد.
بهترین مقدار F1 چقدر است؟
یک عدد ثابت برای همه پروژهها وجود ندارد. مقدار قابل قبول باید با روش پایه، مدل قبلی، کیفیت داده و نیاز واقعی کسبوکار مقایسه شود.
جمعبندی
ماتریس درهمریختگی یکی از مهمترین ابزارهای ارزیابی مدلهای طبقهبندی است. این ماتریس بهجای ارائه یک عدد کلی، نشان میدهد مدل در کدام کلاسها موفق است و چه نوع خطاهایی تولید میکند.
برای ارزیابی اصولی:
- Accuracy را بهتنهایی معیار تصمیم قرار ندهید.
- Precision، Recall و F1 هر کلاس را بررسی کنید.
- در دادههای نامتوازن به Macro F1 توجه داشته باشید.
- ماتریس خام و نرمالشده را کنار هم ببینید.
- آستانه تصمیم را بر اساس هزینه واقعی خطا تنظیم کنید.
- نمونههای اشتباه را بهصورت دستی تحلیل کنید.
- مدلها و پرامپتها را روی مجموعه ثابت مقایسه کنید.
- ارزیابی را پس از انتشار نیز ادامه دهید.
اگر میخواهید چند مدل هوش مصنوعی را با یک API یکپارچه در نرمافزار خود آزمایش و مقایسه کنید، میتوانید از مستندات API درواره شروع کنید.
API درواره با ساختار سازگار با OpenAI، امکان تغییر مدل با کمترین تغییر در کد و ارزیابی چند مدل روی مجموعه داده یکسان را فراهم میکند.
مقالات مرتبط
- ارزیابی مدلهای هوش مصنوعی و طراحی Evals
- آموزش Logistic Regression
- آموزش Scikit-learn با پایتون
- یادگیری ماشین چیست؟
- آموزش تحلیل داده با پایتون
- راهنمای اتصال API هوش مصنوعی به اپلیکیشن
- خروجی ساختاریافته و JSON Schema در API هوش مصنوعی
منابع
- Scikit-learn: Confusion Matrix
- Scikit-learn: Classification Report
- Scikit-learn: Metrics API
- Scikit-learn: Precision-Recall
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



