
ترنسفورمر چیست؟ آموزش معماری Transformer و مکانیزم Attention
ترنسفورمر معماری اصلی بسیاری از مدلهای هوش مصنوعی مدرن مانند GPT، BERT، Llama و Gemini است. در این راهنمای جامع، معماری Transformer، مکانیزم Attention و Self-Attention، نقش Encoder و Decoder، محاسبات Q، K و V، محدودیت طول کانتکست و کاربرد آن در را همراه با مثال و کد پایتون بررسی میکنیم.

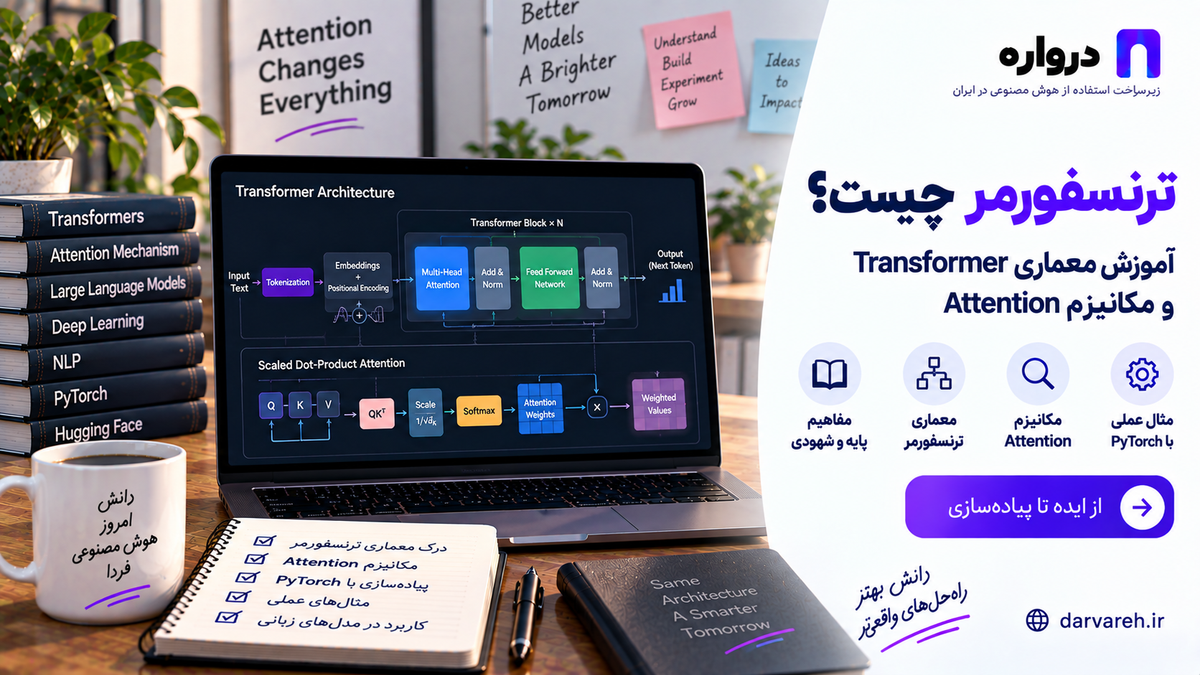
بخش بزرگی از پیشرفتهای سالهای اخیر در هوش مصنوعی به معماری Transformer وابسته است. مدلهایی مانند GPT، BERT، Llama، T5، Gemini و بسیاری از مدلهای تولید متن، تصویر، صوت و ویدئو از Transformer یا معماریهای توسعهیافته بر پایه آن استفاده میکنند.
Transformer در ابتدا برای ترجمه ماشینی معرفی شد، اما بهتدریج به معماری اصلی مدلهای زبانی بزرگ و بسیاری از سامانههای هوش مصنوعی مولد تبدیل شد.
مهمترین ایده Transformer استفاده از مکانیزم Attention است. این مکانیزم به مدل اجازه میدهد هنگام پردازش هر بخش از ورودی، مشخص کند کدام بخشهای دیگر اهمیت بیشتری دارند.
برای مثال، در جمله زیر:
علی کتاب را از رضا گرفت، چون او دیگر به آن نیاز نداشت.
مدل برای تشخیص اینکه «او» و «آن» به چه چیزی اشاره میکنند، باید ارتباط میان واژههای مختلف جمله را بررسی کند. مکانیزم Attention کمک میکند وزن ارتباط میان این کلمات محاسبه شود.
در این مقاله یاد میگیریم:
- Transformer چیست؟
- چرا معماری ترنسفورمر ایجاد شد؟
- Attention و Self-Attention چگونه کار میکنند؟
- ماتریسهای Query، Key و Value چیستند؟
- Multi-Head Attention چه کاربردی دارد؟
- Encoder و Decoder چه تفاوتی دارند؟
- مدلهای BERT، GPT و T5 از کدام معماری استفاده میکنند؟
- چرا طول Context روی هزینه و سرعت API اثر میگذارد؟
- چگونه یک Self-Attention ساده با پایتون پیادهسازی کنیم؟
- شناخت Transformer چگونه به انتخاب مدل مناسب در API درواره کمک میکند؟
Transformer چیست؟
Transformer نوعی معماری شبکه عصبی برای پردازش دنبالهها است. ورودی این معماری میتواند دنبالهای از کلمات، توکنها، قطعههای تصویر، فریمهای ویدئو یا بخشهای دیگری از داده باشد.
معماری Transformer در سال ۲۰۱۷ در مقاله مشهور Attention Is All You Need معرفی شد. نویسندگان این مقاله معماری جدیدی پیشنهاد کردند که برخلاف بسیاری از مدلهای قبلی، برای پردازش دنبالهها به شبکه بازگشتی یا کانولوشن وابسته نبود و بخش اصلی آن بر Attention استوار بود.
ساختار اولیه Transformer برای ترجمه ماشینی طراحی شده بود و دو قسمت اصلی داشت:
- Encoder برای درک ورودی
- Decoder برای تولید خروجی
برای نمونه، هنگام ترجمه یک جمله فارسی به انگلیسی:
جمله فارسی
    ↓
Encoder
    ↓
نمایش معنایی
    ↓
Decoder
    ↓
جمله انگلیسی
مدلهای جدید الزاماً هر دو بخش را ندارند. بعضی مدلها فقط از Encoder و بعضی فقط از Decoder استفاده میکنند.
چرا Transformer ساخته شد؟
پیش از Transformer، مدلهای RNN و LSTM در پردازش زبان و دادههای ترتیبی کاربرد زیادی داشتند.
این مدلها معمولاً کلمات را بهترتیب پردازش میکردند:
کلمه اول → کلمه دوم → کلمه سوم → کلمه چهارم
این ترتیب چند محدودیت ایجاد میکرد.
پردازش ترتیبی
وقتی خروجی هر مرحله به مرحله قبلی وابسته باشد، موازیسازی آموزش دشوارتر میشود. مدل نمیتواند همه موقعیتهای یک جمله را بهآسانی و همزمان پردازش کند.
وابستگیهای دور
در یک متن طولانی ممکن است یک کلمه به عبارتی در چند جمله قبل وابسته باشد. انتقال این اطلاعات در تعداد زیادی مرحله برای معماریهای بازگشتی دشوارتر است.
کاهش سرعت آموزش
پردازش ترتیبی استفاده کامل از توان پردازش موازی GPUها را محدود میکرد.
Transformer با استفاده از Self-Attention توانست ارتباط میان موقعیتهای مختلف یک دنباله را مستقیمتر محاسبه کند. مقاله اصلی نشان داد این معماری در وظایف ترجمه آزمایششده، قابلیت موازیسازی بیشتری نسبت به معماریهای متداول آن زمان داشت.
Attention چیست؟
Attention یا «مکانیزم توجه» روشی است که به مدل اجازه میدهد هنگام پردازش یک عنصر، اهمیت عناصر دیگر را محاسبه کند.
فرض کنید مدل باید معنای واژه «شیر» را در این دو جمله تشخیص دهد:
شیر را داخل لیوان ریخت.
شیر در جنگل حرکت میکرد.
در جمله اول، کلماتی مانند «لیوان» و «ریخت» به مدل کمک میکنند بفهمد منظور نوشیدنی است. در جمله دوم، واژههای «جنگل» و «حرکت» احتمال معنای حیوان را افزایش میدهند.
Attention برای هر کلمه مشخص میکند کدام کلمات دیگر در تعیین نمایش معنایی آن اهمیت بیشتری دارند.
بهصورت ساده:
نمایش جدید هر توکن =
ترکیب وزندار اطلاعات توکنهای مرتبط
این وزنها از پیش بهصورت دستی تعریف نمیشوند. مدل در جریان آموزش یاد میگیرد که برای انجام وظیفه، به چه روابطی توجه کند.
Self-Attention چیست؟
Self-Attention به این معنا است که عناصر یک دنباله به عناصر همان دنباله توجه میکنند.
اگر ورودی شامل ده توکن باشد، هر توکن میتواند ارتباط خود را با سایر توکنها بررسی کند.
برای مثال در جمله:
مریم لپتاپ را خرید چون برای برنامهنویسی به آن نیاز داشت.
هنگام ساخت نمایش کلمه «آن»، مدل ممکن است توجه زیادی به «لپتاپ» داشته باشد. هنگام پردازش «داشت»، کلمات «مریم» و «نیاز» نیز میتوانند مهم باشند.
تفاوت مهم:
- در Self-Attention، Query، Key و Value از یک دنباله ساخته میشوند.
- در Cross-Attention، Query از یک دنباله و Key و Value از دنباله دیگری میآیند.
Cross-Attention در معماری Encoder-Decoder کاربرد دارد. برای مثال، Decoder هنگام تولید ترجمه میتواند به خروجی Encoder مربوط به متن مبدأ توجه کند.
Query، Key و Value چیستند؟
هسته Self-Attention معمولاً با سه نمایش برداری محاسبه میشود:
- Query یا Q
- Key یا K
- Value یا V
برای درک سادهتر، میتوان آنها را به سیستم جستوجو تشبیه کرد:
- Query نشان میدهد در جستوجوی چه اطلاعاتی هستیم.
- Key ویژگیهایی دارد که با Query مقایسه میشوند.
- Value محتوایی است که در صورت مرتبطبودن دریافت میکنیم.
برای هر توکن، بردار اولیه با سه ماتریس آموختنی ضرب میشود:
Q=XWQQ = XW_Q K=XWKK = XW_K V=XWVV = XW_V
در این روابط:
- XX نمایش ورودی توکنها است.
- WQW_Q، WKW_K و WVW_V پارامترهایی هستند که در زمان آموزش یاد گرفته میشوند.
- QQ، KK و VV ماتریسهای حاصلاند.
سپس میزان شباهت Query هر توکن با Key توکنهای دیگر محاسبه میشود.
فرمول Scaled Dot-Product Attention
فرمول رایج Attention به شکل زیر است:
Attention(Q,K,V)=softmax(QKTdk)VAttention(Q,K,V) = softmax\left(\frac{QK^T}{\sqrt{d_k}}\right)V
این فرمول را میتوان در چهار مرحله بررسی کرد.
مرحله اول: محاسبه امتیاز ارتباط
QKTQK^T
Query هر توکن با Key سایر توکنها ضرب داخلی میشود. مقدار بزرگتر معمولاً نشاندهنده ارتباط بیشتر است.
مرحله دوم: مقیاسبندی
QKTdk\frac{QK^T}{\sqrt{d_k}}
در بردارهای با ابعاد بالا، ضرب داخلی ممکن است مقادیر بزرگی تولید کند. تقسیم بر جذر بعد Key به پایدارترشدن محاسبات Softmax کمک میکند.
مرحله سوم: تبدیل امتیازها به وزن
softmax(scores)softmax(scores)
Softmax امتیازها را به مقادیری تبدیل میکند که مجموع آنها برابر یک است.
مرحله چهارم: ترکیب Valueها
weights×Vweights \times V
Valueها بر اساس وزنهای محاسبهشده با یکدیگر ترکیب میشوند. نتیجه، نمایش جدید هر توکن است.
مثال عددی ساده از Attention
فرض کنید بعد از محاسبه و مقیاسبندی، امتیاز ارتباط یک توکن با سه توکن جمله چنین باشد:
[2.0, 1.0, 0.1]
بعد از اعمال Softmax، وزنها تقریباً به این شکل میشوند:
[0.66, 0.24, 0.10]
تفسیر این نتیجه:
- توکن اول ۶۶ درصد اهمیت دارد.
- توکن دوم ۲۴ درصد اهمیت دارد.
- توکن سوم ۱۰ درصد اهمیت دارد.
اگر Valueهای سه توکن را با V1V_1، V2V_2 و V3V_3 نمایش دهیم، خروجی تقریبی برابر است با:
Output=0.66V1+0.24V2+0.10V3Output = 0.66V_1 + 0.24V_2 + 0.10V_3
در مدل واقعی، این عملیات روی بردارهای چندبعدی، چند سر Attention، چند لایه و تعداد زیادی توکن انجام میشود.
پیادهسازی ساده Self-Attention با PyTorch
کد زیر بخش اصلی Scaled Dot-Product Attention را نشان میدهد:
import math

import torch
import torch.nn.functional as F


def scaled_dot_product_attention(
    query: torch.Tensor,
    key: torch.Tensor,
    value: torch.Tensor,
    mask: torch.Tensor | None = None,
) -> tuple[torch.Tensor, torch.Tensor]:
    key_dimension = query.size(-1)

    scores = torch.matmul(
        query,
        key.transpose(-2, -1),
    )

    scores = scores / math.sqrt(key_dimension)

    if mask is not None:
        scores = scores.masked_fill(
            mask == 0,
            float("-inf"),
        )

    attention_weights = F.softmax(
        scores,
        dim=-1,
    )

    output = torch.matmul(
        attention_weights,
        value,
    )

    return output, attention_weights


batch_size = 1
token_count = 4
embedding_dimension = 8

query = torch.randn(
    batch_size,
    token_count,
    embedding_dimension,
)

key = torch.randn(
    batch_size,
    token_count,
    embedding_dimension,
)

value = torch.randn(
    batch_size,
    token_count,
    embedding_dimension,
)

output, weights = scaled_dot_product_attention(
    query,
    key,
    value,
)

print("Output shape:", output.shape)
print("Attention weights shape:", weights.shape)
print(weights)
خروجی از نظر شکل ماتریسی:
Output shape: torch.Size([1, 4, 8])
Attention weights shape: torch.Size([1, 4, 4])
ماتریس Attention دارای ابعاد چهار در چهار است؛ زیرا هرکدام از چهار توکن با چهار توکن ورودی مقایسه شدهاند.
این کد نسخه آموزشی است. کتابخانههای یادگیری عمیق در اجرای واقعی از kernelها و روشهای بهینهتر استفاده میکنند.
Multi-Head Attention چیست؟
یک رابطه معنایی واحد برای درک کامل متن کافی نیست. ممکن است مدل همزمان به چند نوع ارتباط نیاز داشته باشد:
- ارتباط دستوری میان فاعل و فعل
- ارتباط ضمیر و مرجع آن
- ارتباط موضوعی کلمات
- فاصله زمانی رخدادها
- ارتباط میان نامها و ویژگیها
- ترتیب منطقی اجزای جمله
Multi-Head Attention چند عملیات Attention را بهصورت موازی اجرا میکند. هر Head میتواند جنبه متفاوتی از ارتباط میان توکنها را یاد بگیرد.
برای هر Head داریم:
headi=Attention(Qi,Ki,Vi)head_i = Attention(Q_i,K_i,V_i)
سپس خروجی Headها کنار یکدیگر قرار میگیرند:
MultiHead(Q,K,V)=Concat(head1,…,headh)WOMultiHead(Q,K,V) = Concat(head_1,\dots,head_h)W_O
در اینجا WOW_O ماتریس آموختنی دیگری برای ترکیب خروجی Headها است.
داشتن چند Head تضمین نمیکند که هر Head دقیقاً یک نقش زبانی قابلنامگذاری پیدا کند؛ اما به مدل اجازه میدهد روابط مختلف را در زیرفضاهای متفاوت نمایش دهد.
اجزای اصلی معماری Transformer
Transformer فقط شامل Attention نیست. یک بلوک استاندارد معمولاً چند جزء دارد.
Token Embedding
مدل متن خام را مستقیماً پردازش نمیکند. ابتدا متن به توکن تبدیل و هر توکن به یک بردار عددی نگاشت میشود.
برای مثال:
"هوش مصنوعی کاربردهای زیادی دارد"
ممکن است به دنبالهای از شناسهها تبدیل شود:
[2187, 9031, 441, 7820, 119]
سپس هر شناسه از جدول Embedding به یک بردار تبدیل میشود.
Token ID → Embedding Vector
بردارهای Embedding در جریان آموزش تنظیم میشوند تا اطلاعات موردنیاز مدل را نمایش دهند.
Positional Encoding
Self-Attention بهتنهایی ترتیب توکنها را از روی موقعیت آنها تشخیص نمیدهد. بدون اطلاعات موقعیت، این دو عبارت ممکن است بیشازحد مشابه دیده شوند:
سگ مرد را گاز گرفت.
مرد سگ را گاز گرفت.
برای انتقال ترتیب، اطلاعات موقعیت به نمایش توکن اضافه یا در محاسبات Attention وارد میشود.
معماری اصلی Transformer از Positional Encoding سینوسی استفاده میکرد. مدلهای جدید ممکن است روشهای دیگری مانند موقعیت آموختنی یا Rotary Position Embedding را به کار ببرند.
Self-Attention Layer
این لایه روابط میان توکنهای ورودی را محاسبه و نمایش هر توکن را با توجه به Context بهروزرسانی میکند.
Feed-Forward Network
پس از Attention، نمایش هر موقعیت از یک شبکه عصبی پیشخور عبور میکند.
در معماری کلاسیک:
FFN(x)=max(0,xW1+b1)W2+b2FFN(x) = max(0,xW_1+b_1)W_2+b_2
مدلهای جدید ممکن است از تابعهای فعالسازی و ساختارهای متفاوتی مانند GELU، SwiGLU یا انواع Gated MLP استفاده کنند.
Residual Connection
خروجی هر زیرلایه با ورودی آن جمع میشود:
Output=x+SubLayer(x)Output = x + SubLayer(x)
Residual Connection به انتقال اطلاعات و آموزش شبکههای عمیقتر کمک میکند.
Layer Normalization
Layer Normalization برای کنترل توزیع فعالسازیها و پایداری آموزش استفاده میشود.
مدلهای جدید ممکن است از تغییراتی مانند RMSNorm استفاده کنند یا محل Normalization را نسبت به بلوک اصلی تغییر دهند.
معماری Encoder چگونه کار میکند؟
Encoder ورودی را دریافت و برای هر توکن یک نمایش وابسته به Context میسازد.
یک بلوک Encoder کلاسیک شامل بخشهای زیر است:
Input Embedding
      ↓
Positional Information
      ↓
Multi-Head Self-Attention
      ↓
Add & Normalization
      ↓
Feed-Forward Network
      ↓
Add & Normalization
در Encoder، هر توکن معمولاً میتواند به توکنهای قبل و بعد خود توجه کند. به همین دلیل این نوع Attention را دوطرفه مینامند.
برای مثال، هنگام پردازش کلمه وسط جمله، Encoder هم از کلمات قبل و هم کلمات بعد استفاده میکند.
این ویژگی برای وظایفی مناسب است که به درک کامل ورودی نیاز دارند:
- طبقهبندی متن
- تشخیص احساسات
- تشخیص موجودیت نامدار
- استخراج اطلاعات
- جستوجوی معنایی
- پاسخگویی استخراجی
- ساخت Embedding
BERT یکی از شناختهشدهترین مدلهای Encoder-only است. مقاله BERT آن را مدلی برای پیشآموزش نمایشهای عمیق دوطرفه معرفی میکند که با Context سمت چپ و راست آموزش میبیند.
معماری Decoder چگونه کار میکند؟
Decoder برای تولید دنباله خروجی استفاده میشود.
در مدلهای مولد، Decoder توکنها را بهصورت Autoregressive تولید میکند:
توکن اول
  ↓
توکن دوم
  ↓
توکن سوم
  ↓
...
هر توکن بر اساس توکنهای قبلی پیشبینی میشود:
P(xt∣x1,x2,...,xt−1)P(x_t | x_1, x_2, ..., x_{t-1})
تفاوت مهم Decoder با Encoder استفاده از Causal Mask است.
Causal Mask چیست؟
هنگام آموزش مدل تولید متن، پاسخ صحیح در اختیار سیستم قرار دارد؛ اما مدل نباید برای پیشبینی یک توکن، توکنهای بعدی را ببیند.
فرض کنید متن آموزشی چنین باشد:
تهران پایتخت ایران است
هنگام پیشبینی «ایران»، مدل میتواند این بخش را ببیند:
تهران پایتخت
اما نباید از «است» یا خود کلمه «ایران» استفاده کند.
Causal Mask بخش بالایی ماتریس Attention را مسدود میکند:
| توکن جاری | توکن ۱ | توکن ۲ | توکن ۳ | توکن ۴ |
|---|---|---|---|---|
| توکن ۱ | مجاز | مسدود | مسدود | مسدود |
| توکن ۲ | مجاز | مجاز | مسدود | مسدود |
| توکن ۳ | مجاز | مجاز | مجاز | مسدود |
| توکن ۴ | مجاز | مجاز | مجاز | مجاز |
در نتیجه، هر موقعیت فقط به خودش و موقعیتهای قبلی دسترسی دارد.
مدلهایی مانند GPT و Llama از خانواده Decoder-only هستند. این معماری برای کاربردهای زیر مناسب است:
- تولید متن
- گفتوگو
- تکمیل کد
- تولید محتوای ساختاریافته
- پاسخ به پرسش
- کار با ابزارها
- اجرای دستورهای متنی
مستندات Hugging Face نیز Decoder-only را معماری مناسب تولید متن و هوش مصنوعی مکالمهای معرفی میکنند.
معماری Encoder-Decoder چیست؟
مدل Encoder-Decoder هر دو بخش را استفاده میکند.
Encoder ورودی را درک میکند و Decoder با توجه به نمایش ساختهشده، خروجی جدید تولید میکند.
متن ورودی
    ↓
Encoder
    ↓
نمایش معنایی ورودی
    ↓
Cross-Attention
    ↓
Decoder
    ↓
متن خروجی
این معماری با نام Sequence-to-Sequence نیز شناخته میشود.
کاربردهای رایج:
- ترجمه ماشینی
- خلاصهسازی
- اصلاح نگارشی
- تبدیل یک قالب متن به قالب دیگر
- پاسخگویی مولد بر اساس ورودی مشخص
مدلهایی مانند T5، BART و Marian در این گروه قرار میگیرند. در این معماری، Encoder میتواند کل ورودی را ببیند، اما Decoder هنگام تولید هر توکن فقط به خروجیهای قبلی دسترسی دارد و از طریق Cross-Attention اطلاعات Encoder را دریافت میکند.
مقایسه Encoder، Decoder و Encoder-Decoder
| معماری | نوع توجه | کاربرد اصلی | نمونه مدل |
|---|---|---|---|
| Encoder-only | دوطرفه | درک و تحلیل متن | BERT، RoBERTa |
| Decoder-only | علّی و یکطرفه | تولید متن و گفتوگو | GPT، Llama، Gemma |
| Encoder-Decoder | دوطرفه + علّی + Cross-Attention | تبدیل یک دنباله به دنباله دیگر | T5، BART، Marian |
انتخاب معماری باید بر اساس وظیفه انجام شود.
اگر فقط میخواهید پیامها را در چند دسته قرار دهید، یک Encoder کوچک ممکن است از مدل مولد بزرگ سریعتر و اقتصادیتر باشد.
اگر میخواهید پاسخ جدید تولید کنید، Decoder-only انتخاب رایجتری است.
اگر هدف ترجمه یا تبدیل مستقیم یک متن به متن دیگر باشد، Encoder-Decoder میتواند گزینه مناسبی باشد.
مدل GPT چه ارتباطی با Transformer دارد؟
GPT مخفف Generative Pre-trained Transformer است.
اجزای نام آن:
- Generative: برای تولید محتوا طراحی شده است.
- Pre-trained: پیش از استفاده نهایی روی حجم بزرگی از داده آموزش دیده است.
- Transformer: بر معماری ترنسفورمر متکی است.
مدلهای GPT عمدتاً از معماری Decoder-only استفاده میکنند. مدل توکن بعدی را بر اساس توکنهای قبلی پیشبینی میکند.
برای مثال:
هوش مصنوعی میتواند به کسبوکارها در ...
مدل برای توکن بعدی یک توزیع احتمال تولید میکند:
تحلیل      0.31
کاهش       0.20
بهبود      0.18
مدیریت     0.09
...
پارامترهایی مانند Temperature و Top-p بر نحوه انتخاب توکن از این توزیع اثر میگذارند.
برای مطالعه بیشتر میتوانید راهنمای Temperature در مدلهای هوش مصنوعی و مقاله Top-p چیست؟ را مطالعه کنید.
تفاوت BERT و GPT چیست؟
هر دو بر پایه Transformer ساخته شدهاند، اما هدف متفاوتی دارند.
| ویژگی | BERT | GPT |
|---|---|---|
| معماری | Encoder-only | Decoder-only |
| نوع Context | دوطرفه | یکطرفه یا علّی |
| هدف اصلی | درک متن | تولید متن |
| روش آموزشی شناختهشده | پیشبینی بخشهای ماسکشده | پیشبینی توکن بعدی |
| کاربرد رایج | طبقهبندی و استخراج | چت و تولید محتوا |
BERT برای درک رابطه میان کلمات در کل جمله مناسب است. GPT برای ادامهدادن دنباله و تولید خروجی جدید طراحی شده است.
البته مدلهای مدرن ممکن است وظایف متنوعی انجام دهند و مرز کاربردها همیشه مطلق نیست.
تفاوت Attention، Self-Attention و Cross-Attention
| مفهوم | Query از کجا میآید؟ | Key و Value از کجا میآیند؟ | کاربرد |
|---|---|---|---|
| Attention | وابسته به معماری | وابسته به معماری | عنوان عمومی مکانیزم |
| Self-Attention | همان دنباله | همان دنباله | درک رابطه عناصر یک ورودی |
| Masked Self-Attention | همان دنباله | همان دنباله با محدودیت آینده | تولید Autoregressive |
| Cross-Attention | دنباله هدف | دنباله منبع | اتصال Decoder به Encoder یا ورودی دیگر |
برای مثال، در یک مدل متنبهتصویر، نمایش متنی میتواند از طریق Cross-Attention بر بخش تولید تصویر اثر بگذارد.
چرا Transformer فقط برای متن نیست؟
Transformer دنبالهای از بردارها را پردازش میکند. بنابراین ورودی الزاماً کلمه نیست.
تصویر
در Vision Transformer، تصویر به Patchهای کوچک تقسیم میشود. هر Patch مانند یک توکن به بردار تبدیل و وارد Transformer میشود.
مقاله Vision Transformer نشان داد که میتوان تصویر را به دنبالهای از Patchها تبدیل و با معماری Transformer برای طبقهبندی پردازش کرد.
صوت
صدا را میتوان به فریمها یا نمایشهای طیفی تبدیل کرد و آنها را مانند یک دنباله پردازش کرد.
کاربردها:
- تبدیل گفتار به متن
- تشخیص گوینده
- تحلیل صوت
- تولید صدا
ویدئو
ویدئو ترکیبی از اطلاعات مکانی و زمانی است. مدل میتواند Patchهای تصویری را در طول فریمها پردازش کند.
مدلهای چندوجهی
در مدلهای چندوجهی، متن، تصویر، صوت یا ویدئو به نمایشهایی تبدیل میشوند که امکان تعامل میان آنها وجود دارد.
برای نمونه:
تصویر → Visual Tokens
متن → Text Tokens
صوت → Audio Tokens
سپس Attention یا Cross-Attention ارتباط میان این نمایشها را مدیریت میکند.
چرا هزینه Attention با طول ورودی افزایش پیدا میکند؟
در Self-Attention کامل، هر توکن با همه توکنهای دیگر مقایسه میشود.
اگر تعداد توکنها nn باشد، ماتریس امتیاز Attention ابعاد زیر را دارد:
n×nn \times n
برای ۱۰۰۰ توکن:
1000×1000=1,000,0001000 \times 1000 = 1,000,000
برای ۱۰ هزار توکن:
10,000×10,000=100,000,00010,000 \times 10,000 = 100,000,000
بنابراین هزینه محاسباتی و حافظه Attention استاندارد نسبت به طول دنباله معمولاً رفتار درجه دوم دارد:
O(n2)O(n^2)
به همین دلیل افزایش طول Context میتواند هزینه و زمان پردازش را بهطور قابلتوجهی افزایش دهد.
البته مدلها و موتورهای جدید از روشهای مختلفی برای کاهش این هزینه استفاده میکنند:
- FlashAttention
- Sliding Window Attention
- Sparse Attention
- Local Attention
- Chunked Attention
- Linear Attention
- روشهای ترکیبی Attention و State Space
- کشکردن KV
این روشها رفتار و محدودیتهای متفاوتی دارند. صرفاً اعلام یک Context Window بزرگ به این معنا نیست که استفاده از تمام آن همیشه سریع یا اقتصادی است.
KV Cache چیست؟
در مدل Decoder-only، هنگام تولید هر توکن نباید Key و Value مربوط به همه توکنهای قبلی دوباره محاسبه شوند.
KV Cache این مقادیر را برای توکنهای قبلی ذخیره میکند.
بدون KV Cache:
تولید توکن جدید
→ محاسبه دوباره اطلاعات همه توکنهای قبلی
با KV Cache:
تولید توکن جدید
→ استفاده از Key و Value ذخیرهشده
→ محاسبه بخش مربوط به توکن جدید
KV Cache سرعت تولید را افزایش میدهد، اما حافظه مصرف میکند. مقدار حافظه آن به موارد زیر وابسته است:
- تعداد لایهها
- تعداد Headهای Key و Value
- ابعاد Head
- طول Context
- تعداد درخواستهای همزمان
- نوع داده Cache
به همین دلیل، طول Context و همزمانی کاربران دو عامل مهم ظرفیت سروینگ مدل هستند.
برای آشنایی با سروینگ مدلهای زبانی میتوانید مقاله vLLM چیست؟ را مطالعه کنید.
Multi-Query Attention و Grouped-Query Attention چیست؟
در Multi-Head Attention کلاسیک، هر Head مجموعه جداگانهای از Query، Key و Value دارد. در زمان تولید متن، ذخیره Key و Value همه Headها میتواند حافظه زیادی مصرف کند.
Multi-Query Attention
در Multi-Query Attention یا MQA، Headهای Query متعددند، اما Key و Value مشترکاند.
این طراحی میتواند اندازه KV Cache را کاهش دهد.
Grouped-Query Attention
Grouped-Query Attention یا GQA راهحلی میان MHA و MQA است. Headهای Query در چند گروه قرار میگیرند و هر گروه Key و Value مشترک دارد.
هدف این روشها معمولاً ایجاد تعادل میان کیفیت، سرعت و مصرف حافظه است.
در زمان انتخاب مدل برای محیط عملی، معماری Attention میتواند روی تعداد کاربران همزمان و هزینه زیرساخت اثر بگذارد.
FlashAttention چیست؟
FlashAttention یک روش دقیق و آگاه از ساختار حافظه برای محاسبه Attention است. هدف آن کاهش رفتوبرگشت داده میان سطوح حافظه و اجرای کارآمدتر Attention روی سختافزار است.
FlashAttention تعریف ریاضی Attention را با یک تقریب ساده جایگزین نمیکند؛ بلکه همان نتیجه را با الگوریتمی بهینهتر محاسبه میکند، البته جزئیات عددی و پیادهسازی میتواند به نسخه و سختافزار وابسته باشد.
این فناوری به موتورهای استنتاج و آموزش کمک میکند:
- حافظه کمتری برای ماتریسهای میانی مصرف کنند؛
- دنبالههای بلندتر را پردازش کنند؛
- از پهنای باند حافظه بهتر استفاده کنند؛
- سرعت آموزش یا استنتاج را افزایش دهند.
وجود پشتیبانی FlashAttention در یک مدل یا موتور به نوع GPU، نسخه CUDA، کتابخانه و نوع داده وابسته است.
Mixture of Experts چه ارتباطی با Transformer دارد؟
در مدل Mixture of Experts یا MoE، بعضی لایههای Feed-Forward با چند Expert جایگزین میشوند.
یک Router مشخص میکند هر توکن به کدام Expertها ارسال شود:
Token
  ↓
Router
  ├── Expert 1
  ├── Expert 2
  ├── Expert 3
  └── Expert 4
ممکن است مدل پارامترهای کل زیادی داشته باشد، اما برای هر توکن فقط بخشی از آنها فعال شوند.
این روش میتواند ظرفیت مدل را بدون فعالکردن همه پارامترها در هر مرحله افزایش دهد. بااینحال، اجرای MoE چالشهایی مانند مسیریابی، توزیع بار، ارتباط میان GPUها و مصرف حافظه وزنها دارد.
بنابراین دو مدل با تعداد پارامتر کل مشابه ممکن است هزینه استنتاج یکسانی نداشته باشند.
مراحل پردازش یک درخواست در مدل Transformer
فرض کنید کاربر این پیام را ارسال میکند:
سه مزیت استفاده از API هوش مصنوعی را توضیح بده.
پردازش در یک مدل Decoder-only را میتوان بهصورت خلاصه چنین نمایش داد:
مرحله اول: Tokenization
متن به توکنها تبدیل میشود:
["سه", "مزیت", "استفاده", "از", "API", ...]
مرز توکنها الزاماً با مرز کلمات یکسان نیست.
مرحله دوم: Embedding
هر توکن به بردار عددی تبدیل میشود.
مرحله سوم: اطلاعات موقعیت
اطلاعات مربوط به ترتیب توکنها به نمایش مدل اضافه میشود.
مرحله چهارم: عبور از لایههای Transformer
در هر لایه:
- Attention ارتباط توکنها را محاسبه میکند.
- Residual Connection اطلاعات قبلی را حفظ میکند.
- Normalization به پایداری محاسبات کمک میکند.
- شبکه Feed-Forward نمایش هر موقعیت را پردازش میکند.
مرحله پنجم: تولید Logit
مدل برای توکن بعدی یک Logit برای هر توکن واژگان تولید میکند.
مرحله ششم: تبدیل به احتمال
Softmax یا پردازش مرتبط، Logitها را به توزیع احتمال تبدیل میکند.
مرحله هفتم: انتخاب توکن
بر اساس تنظیماتی مانند Temperature، Top-p و Top-k یک توکن انتخاب میشود.
مرحله هشتم: تکرار
توکن انتخابشده به دنباله اضافه و فرایند تا رسیدن به پایان پاسخ تکرار میشود.
نمونه استفاده از مدل Transformer با Hugging Face
برای اجرای یک مدل آماده طبقهبندی متن میتوان از کتابخانه Transformers استفاده کرد.
نصب:
pip install transformers torch
نمونه کد:
from transformers import pipeline


classifier = pipeline(
    task="sentiment-analysis",
    model="<COMPATIBLE_MODEL_ID>",
)

result = classifier(
    "این سرویس سرعت مناسبی دارد و استفاده از آن ساده است."
)

print(result)
در پروژه واقعی باید مدلی انتخاب شود که:
- زبان فارسی را پشتیبانی کند؛
- مجوز مناسب داشته باشد؛
- برای وظیفه موردنظر Fine-tune شده باشد؛
- روی سختافزار شما قابل اجرا باشد؛
- کیفیت آن با داده واقعی آزمایش شده باشد.
استفاده از مدل Transformer از طریق API درواره
برای بسیاری از محصولات، اجرای مستقیم مدل ضروری نیست. میتوان قابلیتهای مدلهای Transformer را از طریق API دریافت کرد.
ابتدا کتابخانه OpenAI را نصب کنید:
pip install openai
متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
کد پایتون:
import os

from openai import OpenAI


client = OpenAI(
    base_url="https://api.darvareh.ir/v1",
    api_key=os.environ["DARVAREH_API_KEY"],
)

response = client.chat.completions.create(
    model=os.environ["DARVAREH_MODEL"],
    temperature=0.2,
    max_tokens=400,
    messages=[
        {
            "role": "system",
            "content": (
                "شما یک دستیار فنی هستید. "
                "پاسخ را دقیق و به زبان فارسی بنویسید."
            ),
        },
        {
            "role": "user",
            "content": (
                "این پیام مشتری را تحلیل کن و "
                "موضوع اصلی و اقدام پیشنهادی را بنویس."
            ),
        },
    ],
)

content = response.choices[0].message.content

if not content:
    raise ValueError("پاسخی از مدل دریافت نشد.")

print(content)
با این روش، توسعهدهنده لازم نیست موارد زیر را مستقیماً مدیریت کند:
- دانلود وزنهای مدل
- تهیه GPU
- نصب CUDA
- سروینگ مدل
- مدیریت KV Cache
- Batching درخواستها
- بهروزرسانی موتور استنتاج
- ظرفیتسنجی زیرساخت
آدرس پایه API درواره:
https://api.darvareh.ir/v1
شناسه مدل باید از فهرست فعلی مدلهای درواره انتخاب شود.
شناخت Transformer چگونه به انتخاب مدل API کمک میکند؟
شناخت معماری فقط موضوعی دانشگاهی نیست. این دانش مستقیماً بر انتخاب مدل، طراحی Prompt، هزینه و سرعت محصول اثر میگذارد.
انتخاب معماری بر اساس وظیفه
برای طبقهبندی ساده، استفاده از یک مدل مولد بزرگ همیشه ضروری نیست. یک مدل Encoder یا مدل کوچکتر میتواند سریعتر و ارزانتر باشد.
برای گفتوگو، تولید محتوا و Tool Calling معمولاً مدل Decoder-only مناسبتر است.
کنترل طول ورودی
با افزایش تعداد توکنهای ورودی، Attention و KV Cache منابع بیشتری مصرف میکنند. ارسال تاریخچه کامل گفتوگو در هر درخواست میتواند هزینه و زمان پاسخ را افزایش دهد.
استفاده از Context مرتبط
بزرگبودن Context Window به معنای ارسال همه اطلاعات موجود نیست. بهتر است با جستوجو، RAG یا انتخاب بخشهای مرتبط، Context مفید ساخته شود.
انتخاب مدل کوچک یا بزرگ
تعداد پارامترها تنها معیار کیفیت نیست. معماری، داده آموزشی، Fine-tuning، طول Context و نوع کاربرد نیز اهمیت دارند.
مقایسه مدلها با داده واقعی
دو مدل Transformer ممکن است در بنچمارک عمومی عملکرد نزدیک داشته باشند، اما کیفیت متفاوتی روی متن فارسی یا داده سازمانی شما نشان دهند.
چه عواملی بر سرعت مدل Transformer اثر میگذارند؟
سرعت پاسخ یک مدل فقط به تعداد پارامترها وابسته نیست.
عوامل مهم:
- تعداد پارامترهای فعال
- نوع معماری Dense یا MoE
- طول ورودی
- طول خروجی
- اندازه KV Cache
- تعداد درخواستهای همزمان
- نوع و تعداد GPU
- روش کوانتیزهسازی
- نوع داده مانند FP16، BF16، FP8 یا INT4
- موتور استنتاج
- پشتیبانی از FlashAttention
- روشهای Tensor Parallel و Data Parallel
- سرعت شبکه میان GPUها
- قابلیت Prompt Caching
به همین دلیل، انتخاب مدل صرفاً بر اساس نام یا اندازه آن تصمیم دقیقی نیست.
محدودیتهای معماری Transformer
Transformer بسیار قدرتمند است، اما محدودیتهایی نیز دارد.
هزینه Attention برای دنباله بلند
ماتریس n×nn \times n در Self-Attention استاندارد با افزایش طول دنباله بزرگ میشود.
حافظه KV Cache
در مدلهای مولد، Context طولانی و کاربران همزمان میتوانند حافظه زیادی مصرف کنند.
تولید مرحلهای خروجی
در Decoderهای Autoregressive، توکنهای خروجی بهترتیب تولید میشوند. این بخش بهاندازه پردازش موازی زمان آموزش قابل موازیسازی نیست.
محدودیت Context
مدل فقط اطلاعات موجود در Context و پارامترهای خود را در اختیار دارد. اگر داده صحیح یا مرتبط ارائه نشود، ممکن است پاسخ ناقص یا نادرست تولید کند.
نبود تضمین صحت
Transformer الگوهای آماری را یاد میگیرد. خروجی روان الزاماً خروجی صحیح نیست.
هزینه آموزش
آموزش مدلهای بزرگ به داده، پردازنده، انرژی و زیرساخت قابلتوجه نیاز دارد.
آیا Attention توضیح کاملی از تصمیم مدل ارائه میدهد؟
وزنهای Attention میتوانند بخشی از رفتار داخلی مدل را نشان دهند، اما نباید همیشه بهعنوان توضیح قطعی تصمیم مدل تفسیر شوند.
چند دلیل:
- مدل تعداد زیادی Head و لایه دارد.
- اطلاعات از Residual Connection عبور میکند.
- شبکههای Feed-Forward نیز در خروجی اثر دارند.
- الگوی Attention در یک لایه الزاماً دلیل نهایی پاسخ نیست.
- یک توکن ممکن است در لایههای مختلف روابط متفاوتی داشته باشد.
بنابراین نمایش Heatmap مربوط به Attention ابزار تحلیل مفیدی است، اما بهتنهایی توضیح کامل تصمیم مدل محسوب نمیشود.
اشتباهات رایج درباره Transformer
Transformer همان مدل زبانی بزرگ است
خیر. Transformer یک معماری است. مدل زبانی بزرگ یک مدل آموزشدیده با تعداد زیاد پارامتر و داده است که ممکن است از Transformer استفاده کند.
هر مدل Transformer مولد است
خیر. مدلهای Encoder-only مانند BERT بیشتر برای درک و تحلیل ورودی استفاده میشوند.
Attention یعنی مدل مانند انسان توجه میکند
Attention یک عملیات ریاضی برای وزندهی ارتباط میان نمایشها است. نباید آن را با توجه انسانی یکسان دانست.
Context بزرگتر همیشه بهتر است
Context بزرگتر میتواند منابع بیشتری مصرف کند و وجود اطلاعات نامرتبط حتی کیفیت پاسخ را کاهش دهد.
تعداد پارامتر بیشتر همیشه نتیجه بهتری میدهد
کیفیت به معماری، داده، آموزش، Fine-tuning و نوع وظیفه نیز وابسته است.
همه مدلهای Transformer هزینه یکسان دارند
مدل Dense، مدل MoE، مدل دارای GQA و مدل با Context متفاوت، رفتار هزینهای و عملکردی متفاوتی دارند.
خروجی Attention صحت پاسخ را تضمین میکند
Attention فقط یکی از اجزای پردازش است و صحت واقعی خروجی باید جداگانه ارزیابی شود.
مسیر پیشنهادی یادگیری Transformer
اگر میخواهید معماری Transformer را بهصورت عملی یاد بگیرید، این مسیر مناسب است:
مرحله اول: آشنایی با بردار و ماتریس
مفاهیم زیر را یاد بگیرید:
- بردار
- ماتریس
- ضرب داخلی
- ضرب ماتریسی
- Softmax
- مشتق و گرادیان
مرحله دوم: یادگیری شبکه عصبی
با این مفاهیم آشنا شوید:
- لایه خطی
- تابع فعالسازی
- تابع هزینه
- Backpropagation
- Optimizer
مرحله سوم: شناخت Embedding
یاد بگیرید چگونه داده گسسته مانند کلمه یا توکن به بردار تبدیل میشود.
مرحله چهارم: پیادهسازی Attention ساده
ابتدا Scaled Dot-Product Attention را با PyTorch بنویسید.
مرحله پنجم: اضافهکردن Multi-Head Attention
ورودی را بین چند Head تقسیم و خروجی آنها را ترکیب کنید.
مرحله ششم: ساخت Transformer کوچک
اجزای زیر را کنار هم قرار دهید:
- Embedding
- Positional Encoding
- Multi-Head Attention
- Feed-Forward
- Residual Connection
- Normalization
مرحله هفتم: استفاده از مدل آماده
با کتابخانه Hugging Face Transformers مدلهای آماده را برای طبقهبندی، تولید متن و Embedding اجرا کنید.
مرحله هشتم: اتصال به API
یک اپلیکیشن واقعی بسازید که از طریق API درواره به یک مدل زبانی متصل شود.
مرحله نهم: ارزیابی
مدلها را روی مجموعه ثابتی از ورودیهای واقعی از نظر کیفیت، هزینه و سرعت مقایسه کنید.
پرسشهای متداول
Transformer در هوش مصنوعی چیست؟
Transformer نوعی معماری شبکه عصبی است که برای پردازش دنبالهها از Attention استفاده میکند. این معماری پایه بسیاری از مدلهای زبانی و چندوجهی مدرن است.
Attention چیست؟
Attention مکانیزمی برای محاسبه اهمیت عناصر مختلف ورودی نسبت به یکدیگر است. مدل با استفاده از این وزنها اطلاعات مرتبط را ترکیب میکند.
Self-Attention چیست؟
در Self-Attention، توکنهای یک دنباله به توکنهای همان دنباله توجه میکنند تا نمایش وابسته به Context ساخته شود.
تفاوت Self-Attention و Cross-Attention چیست؟
در Self-Attention، Query، Key و Value از یک دنباله میآیند. در Cross-Attention، Query از یک دنباله و Key و Value از دنباله دیگری تولید میشوند.
Query، Key و Value چه هستند؟
سه نمایش آموختنی از ورودیاند. Query برای یافتن اطلاعات، Key برای سنجش ارتباط و Value برای انتقال محتوای مرتبط استفاده میشود.
تفاوت Transformer و GPT چیست؟
Transformer معماری عمومی است. GPT خانوادهای از مدلهای مولد مبتنی بر بخش Decoder معماری Transformer است.
تفاوت BERT و GPT چیست؟
BERT معمولاً Encoder-only و مناسب درک متن است. GPT معمولاً Decoder-only و مناسب تولید متن است.
آیا Transformer فقط برای پردازش متن استفاده میشود؟
خیر. Transformer در پردازش تصویر، صوت، ویدئو، کد، دادههای زیستی و مدلهای چندوجهی نیز کاربرد دارد.
چرا Transformer به GPU نیاز دارد؟
عملیات ماتریسی بزرگ و موازی بخش مهمی از محاسبات Transformer را تشکیل میدهند. GPUها برای این نوع محاسبات مناسباند، هرچند مدلهای کوچکتر میتوانند روی CPU یا شتابدهندههای دیگر نیز اجرا شوند.
آیا برای استفاده از Transformer باید مدل را خودمان اجرا کنیم؟
خیر. میتوانید از مدلهای آماده از طریق API استفاده کنید. API درواره امکان دسترسی به مدلهای مختلف را با ساختار سازگار با OpenAI فراهم میکند.
طول Context چه ارتباطی با Transformer دارد؟
Context Window حداکثر تعداد توکنهایی است که مدل در یک درخواست پردازش میکند. افزایش آن میتواند مصرف حافظه، زمان پردازش و هزینه را افزایش دهد.
آیا معماری Transformer جایگزین خواهد شد؟
معماریهای جدید و روشهای ترکیبی در حال توسعهاند، اما Transformer همچنان پایه بخش بزرگی از مدلهای هوش مصنوعی است. احتمالاً در آینده نیز نسخههای بهینهشده، ترکیبی و تخصصی آن استفاده خواهند شد.
جمعبندی
Transformer معماری اصلی بسیاری از مدلهای هوش مصنوعی مدرن است. این معماری با استفاده از Self-Attention میتواند ارتباط میان بخشهای مختلف ورودی را محاسبه و برای هر توکن یک نمایش وابسته به Context ایجاد کند.
اجزای مهم Transformer عبارتاند از:
- Tokenization و Embedding
- اطلاعات موقعیت
- Query، Key و Value
- Scaled Dot-Product Attention
- Multi-Head Attention
- Feed-Forward Network
- Residual Connection
- Normalization
- Encoder یا Decoder
- Causal Mask و KV Cache در مدلهای مولد
مدلهای Encoder-only مانند BERT بیشتر برای درک متن مناسباند. مدلهای Decoder-only مانند GPT و Llama برای تولید متن استفاده میشوند. مدلهای Encoder-Decoder مانند T5 نیز برای تبدیل یک دنباله به دنباله دیگر کاربرد دارند.
شناخت این تفاوتها به توسعهدهندگان کمک میکند مدل مناسبتری انتخاب کنند، طول ورودی را کنترل کنند، هزینه API را کاهش دهند و معماری محصول هوش مصنوعی خود را دقیقتر طراحی کنند.
برای استفاده از مدلهای مختلف بدون مدیریت مستقیم GPU و زیرساخت استنتاج، میتوانید از مستندات API درواره شروع کنید.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
مقالات مرتبط
- مدل زبانی بزرگ یا LLM چیست؟
- یادگیری عمیق چیست؟
- پردازش زبان طبیعی چیست؟
- Embedding چیست؟
- Context Window چیست؟
- Inference چیست؟
- vLLM چیست؟
- API سازگار با OpenAI چیست؟
- محاسبه هزینه API هوش مصنوعی
منابع
- Google Research: Attention Is All You Need
- مقاله Attention Is All You Need در arXiv
- Hugging Face: Transformer Architectures
- Hugging Face: How Transformers Work
- مقاله BERT
- Google Research: Vision Transformer
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



