
CNN چیست؟ آموزش شبکه عصبی کانولوشنی با پایتون و PyTorch
شبکه عصبی کانولوشنی یا CNN یکی از پایههای بینایی ماشین است. در این راهنما ساختار CNN، لایه Convolution، Pooling و آموزش مدل طبقهبندی تصویر با PyTorch را یاد میگیرید.

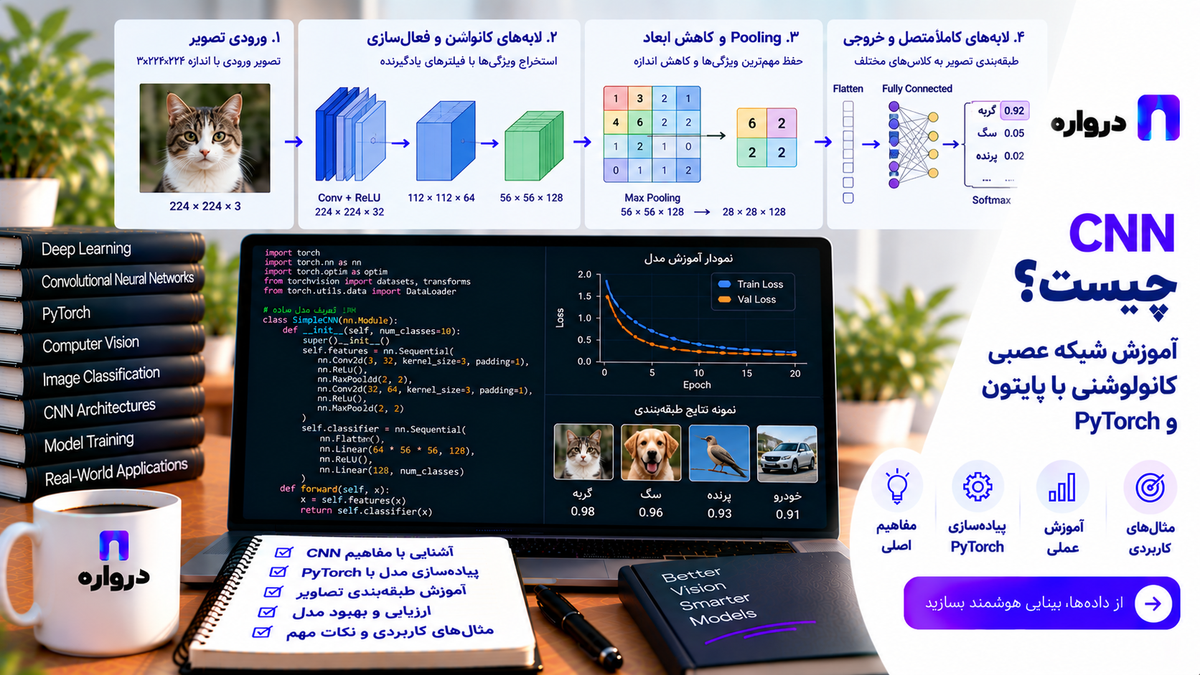
شبکه عصبی کانولوشنی یا Convolutional Neural Network که بهاختصار CNN نامیده میشود، یکی از مهمترین معماریهای یادگیری عمیق برای پردازش تصویر است.
مدلهای CNN میتوانند الگوهای تصویری را مستقیماً از پیکسلها یاد بگیرند. لایههای ابتدایی معمولاً ویژگیهای سادهای مانند لبه و جهت را تشخیص میدهند و لایههای عمیقتر بهتدریج الگوهای پیچیدهتری مانند بافت، شکل، اجزای اشیا و خود اشیا را یاد میگیرند.
شبکههای کانولوشنی در بسیاری از کاربردها استفاده میشوند:
- طبقهبندی تصویر
- تشخیص اشیا
- تشخیص چهره
- تقسیمبندی تصویر
- تحلیل ویدیو
- کنترل کیفیت محصول
- پردازش اسناد تصویری
- شناسایی نوع کالا
- شمارش اشیا
- استخراج ویژگی از تصویر
در این مقاله میآموزید:
- CNN چیست؟
- چرا شبکه معمولی برای تصویر مناسب نیست؟
- Convolution، Kernel و Feature Map چه هستند؟
- Padding، Stride و Pooling چه کاربردی دارند؟
- لایههای CNN چگونه ویژگیها را یاد میگیرند؟
- چگونه یک CNN با PyTorch بسازیم؟
- چگونه مدل را آموزش، ارزیابی و ذخیره کنیم؟
- چگونه از بیشبرازش جلوگیری کنیم؟
- تفاوت CNN، YOLO و Vision Transformer چیست؟
- چه زمانی استفاده از مدل آماده از طریق API درواره مناسبتر است؟
CNN چیست؟
CNN نوعی شبکه عصبی است که برای دادههای دارای ساختار فضایی طراحی شده است.
در تصویر، پیکسلهای نزدیک به یکدیگر معمولاً ارتباط بیشتری دارند. برای مثال، یک لبه از مجموعهای از پیکسلهای مجاور تشکیل شده است و شکل یک شیء نیز از ترکیب چند الگوی محلی ساخته میشود.
شبکه کانولوشنی بهجای اتصال مستقیم تمام پیکسلها به تمام نورونهای لایه بعد، از فیلترهای کوچک استفاده میکند که روی بخشهای مختلف تصویر حرکت میکنند.
این ویژگی باعث میشود CNN:
- روابط محلی را بهتر یاد بگیرد.
- تعداد پارامترهای کمتری نسبت به شبکه کاملاً متصل داشته باشد.
- یک الگو را در موقعیتهای مختلف تصویر شناسایی کند.
- ساختار دوبعدی تصویر را حفظ کند.
- ویژگیها را بهشکل سلسلهمراتبی یاد بگیرد.
راهنمای رسمی TensorFlow نیز CNN را برای آموزش مدل طبقهبندی تصویر روی دادههای CIFAR به کار میبرد.
چرا شبکه عصبی معمولی برای تصویر کافی نیست؟
فرض کنید یک تصویر رنگی با ابعاد نسبتاً متوسط داریم. هر تصویر از تعداد زیادی پیکسل و کانال رنگی تشکیل شده است.
اگر تمام پیکسلها مستقیماً به یک لایه Dense متصل شوند:
- تعداد پارامترها بسیار زیاد میشود.
- ساختار مکانی تصویر از بین میرود.
- مدل به داده و حافظه زیادی نیاز پیدا میکند.
- احتمال بیشبرازش افزایش مییابد.
- جابهجایی کوچک شیء میتواند خروجی را تغییر دهد.
CNN با استفاده از اتصال محلی و اشتراک وزنها این مشکلات را کاهش میدهد.
یک فیلتر واحد میتواند همان الگو را در نقاط مختلف تصویر جستوجو کند. بنابراین لازم نیست برای هر موقعیت وزن جداگانهای یاد گرفته شود.
Convolution چیست؟
Convolution یا کانولوشن عملیاتی است که طی آن یک فیلتر کوچک روی تصویر حرکت میکند و در هر موقعیت یک ویژگی محلی را استخراج میکند.
برای مثال، یک فیلتر میتواند به تشخیص این موارد حساس شود:
- لبه افقی
- لبه عمودی
- تغییر روشنایی
- گوشه
- بافت
- منحنی
در شبکه عصبی، مقدارهای فیلتر از قبل دستی تعیین نمیشوند؛ بلکه مدل آنها را در فرایند آموزش یاد میگیرد.
PyTorch نیز Convolution را فرایندی معرفی میکند که اطلاعات هر بخش تصویر را با همسایههای محلی آن و وزنهای آموختنی ترکیب میکند.
Kernel یا Filter چیست؟
Kernel و Filter در بسیاری از توضیحات CNN به مفهوم نزدیک به هم استفاده میشوند.
Kernel یک ماتریس کوچک از وزنهای قابل آموزش است که روی تصویر حرکت میکند.
برای مثال، لایهای با ۳۲ Filter میتواند ۳۲ نوع الگوی مختلف را از تصویر استخراج کند.
هر Filter ممکن است پس از آموزش به نوع خاصی از ویژگی حساس شود. معمولاً نمیتوان برای همه فیلترهای عمیق یک معنای ساده انسانی تعیین کرد، اما لایههای ابتدایی اغلب الگوهای قابلتصورتری دارند.
Feature Map چیست؟
خروجی اعمال یک Filter روی تصویر، Feature Map نام دارد.
اگر یک لایه ۳۲ Filter داشته باشد، خروجی آن معمولاً شامل ۳۲ Feature Map خواهد بود.
هر Feature Map نشان میدهد الگوی آموختهشده توسط یک Filter در کدام قسمتهای تصویر فعال شده است.
در لایههای بعدی، مدل Feature Mapهای قبلی را ترکیب میکند و الگوهای پیچیدهتر میسازد.
Channel چیست؟
تصویر رنگی معمولاً سه Channel دارد:
- قرمز
- سبز
- آبی
در لایههای عمیق CNN، Channelها دیگر الزاماً رنگ نیستند. هر Channel میتواند یک نوع Feature آموختهشده را نمایش دهد.
برای مثال، خروجی یک لایه ممکن است ۶۴ Channel داشته باشد؛ یعنی آن لایه ۶۴ Feature Map تولید کرده است.
Stride چیست؟
Stride مشخص میکند Kernel در هر مرحله چند پیکسل حرکت کند.
Stride کوچک
- جزئیات بیشتری حفظ میشود.
- خروجی بزرگتر است.
- هزینه محاسباتی بیشتر است.
Stride بزرگ
- ابعاد خروجی سریعتر کاهش پیدا میکند.
- محاسبات کمتر میشود.
- ممکن است بخشی از جزئیات از دست برود.
در بیشتر لایههای ابتدایی Stride کوچکتر استفاده میشود، مگر اینکه هدف کاهش سریع اندازه تصویر باشد.
Padding چیست؟
اگر Kernel فقط در محلهایی قرار گیرد که کاملاً داخل تصویر باشد، ابعاد Feature Map کاهش پیدا میکند و اطلاعات لبههای تصویر کمتر استفاده میشوند.
Padding با افزودن حاشیه به تصویر ورودی کمک میکند:
- ابعاد فضایی کنترل شود.
- اطلاعات ناحیههای کناری بهتر حفظ شود.
- شبکههای عمیقتر ساخته شوند.
در بسیاری از معماریها از Padding بهگونهای استفاده میشود که اندازه ورودی و خروجی لایه کانولوشن یکسان باقی بماند.
Activation Function چیست؟
پس از Convolution معمولاً یک تابع فعالسازی اعمال میشود.
یکی از گزینههای رایج ReLU است:
import torch.nn as nn

activation = nn.ReLU()
تابع فعالسازی به شبکه اجازه میدهد روابط غیرخطی را یاد بگیرد. بدون آن، ترکیب چند لایه قدرت بیان کافی برای الگوهای پیچیده نخواهد داشت.
Pooling چیست؟
Pooling برای کاهش ابعاد Feature Map استفاده میشود.
Max Pooling
بزرگترین مقدار هر ناحیه را نگه میدارد.
pool = nn.MaxPool2d(
    kernel_size=2,
    stride=2,
)
Average Pooling
میانگین مقدارهای هر ناحیه را نگه میدارد.
Pooling میتواند:
- حجم محاسبات را کاهش دهد.
- میدان دید لایههای بعدی را افزایش دهد.
- بخشی از جزئیات کماهمیت را حذف کند.
- مدل را نسبت به جابهجاییهای کوچک مقاومتر کند.
بااینحال Pooling بیشازحد میتواند اطلاعات مفید را از بین ببرد. بعضی معماریهای جدید بهجای Max Pooling از Convolution دارای Stride استفاده میکنند.
ساختار ساده یک CNN
یک CNN ساده برای طبقهبندی تصویر ممکن است شامل این مراحل باشد:
- دریافت تصویر
- لایه Convolution
- Batch Normalization
- تابع ReLU
- Pooling
- تکرار چند Block
- Global Average Pooling
- لایه نهایی طبقهبندی
نمونه مفهومی:
Image
↓
Convolution Block
↓
Convolution Block
↓
Convolution Block
↓
Global Average Pooling
↓
Linear Classifier
↓
Class Scores
شبکه چگونه ویژگیها را یاد میگیرد؟
در شروع آموزش، وزنهای مدل معمولاً تصادفیاند. مدل تصویر را پردازش میکند و خروجی اولیه تولید میشود.
سپس:
- خروجی با Label واقعی مقایسه میشود.
- مقدار خطا محاسبه میشود.
- گرادیانها با Backpropagation محاسبه میشوند.
- Optimizer وزنها را تغییر میدهد.
- این فرایند در Batchها و Epochهای مختلف تکرار میشود.
بهمرور Filterها به الگوهایی حساس میشوند که برای کاهش خطا مفیدند.
اجزای مهم CNN
Convolution Layer
ویژگیهای محلی را استخراج میکند.
Batch Normalization
به پایدارترشدن آموزش کمک میکند و در بسیاری از معماریها پس از Convolution قرار میگیرد.
Activation
قابلیت یادگیری رابطه غیرخطی را فراهم میکند.
Pooling یا Downsampling
ابعاد فضایی را کاهش میدهد.
Dropout
بخشی از فعالسازیها را هنگام آموزش موقتاً غیرفعال میکند و میتواند بیشبرازش را کاهش دهد.
Fully Connected Layer
ویژگیهای نهایی را به خروجی کلاسها تبدیل میکند.
Global Average Pooling
هر Feature Map را خلاصه میکند و میتواند جایگزین Flatten بسیار بزرگ شود.
تفاوت Flatten و Global Average Pooling
Flatten
تمام مقدارهای Feature Mapها را پشت سر هم قرار میدهد.
اگر خروجی مکانی بزرگ باشد، لایه Dense بعدی میتواند پارامترهای بسیار زیادی داشته باشد.
Global Average Pooling
از هر Channel یک مقدار خلاصه تولید میکند.
مزایا:
- تعداد پارامتر کمتر
- کاهش خطر بیشبرازش
- وابستگی کمتر به اندازه فضایی
- معماری سادهتر
معماریهای معروف CNN
LeNet
از معماریهای اولیه برای تشخیص رقمهای دستنویس.
AlexNet
نقش مهمی در رشد استفاده از شبکههای عمیق برای بینایی ماشین داشت.
VGG
ساختاری ساده با تکرار لایههای کانولوشن کوچک دارد، اما از نظر تعداد پارامتر سنگین است.
ResNet
از اتصالهای میانبُر یا Residual Connection استفاده میکند و آموزش شبکههای عمیقتر را آسانتر میسازد.
Inception
چند نوع پردازش را در یک Block ترکیب میکند.
MobileNet
برای مدلهای سبک و اجرای موبایل یا Edge طراحی شده است.
EfficientNet
تعادلی میان عمق، عرض و رزولوشن مدل ایجاد میکند.
ConvNeXt
ایدههای جدیدتر طراحی شبکه را با ساختار کانولوشنی ترکیب میکند.
CNN دوبعدی و سهبعدی
CNN یکبعدی
برای دادههایی مانند سیگنال، صوت و دنباله استفاده میشود.
CNN دوبعدی
رایجترین نوع برای تصویر است و Filter در ارتفاع و عرض حرکت میکند.
CNN سهبعدی
برای دادههای دارای بعد اضافه مانند ویدیو یا حجم سهبعدی استفاده میشود.
TensorFlow آموزش رسمی طبقهبندی ویدیو با 3D CNN را ارائه میکند که در آن Filter در سه جهت حرکت میکند.
تفاوت CNN و شبکه Fully Connected
| ویژگی | CNN | Fully Connected |
|---|---|---|
| حفظ ساختار مکانی | بله | معمولاً خیر |
| اشتراک وزن | بله | خیر |
| تعداد پارامتر برای تصویر | کمتر | بسیار بیشتر |
| تشخیص الگوی محلی | مناسب | محدودتر |
| کاربرد رایج | تصویر و سیگنال | داده جدولی و خروجی نهایی |
تفاوت CNN و YOLO
CNN یک نوع معماری پایه برای استخراج ویژگی از تصویر است.
YOLO یک خانواده مدل کامل برای Object Detection است که از Backbone، بخش ترکیب ویژگی و Head تشخیص تشکیل میشود. اجزای آن میتوانند از عملیات کانولوشنی و ایدههای پیشرفتهتر استفاده کنند.
| موضوع | CNN طبقهبندی | YOLO |
|---|---|---|
| خروجی | کلاس کل تصویر | کلاس و Bounding Box |
| چند شیء | معمولاً مشخص نمیکند | بله |
| موقعیت شیء | خیر | بله |
| کاربرد | طبقهبندی | تشخیص و Tracking |
برای آموزش عملی YOLO میتوانید مقاله YOLO چیست؟ آموزش تشخیص اشیا با پایتون را مطالعه کنید.
تفاوت CNN و Vision Transformer
CNN از Bias ساختاری مناسب تصویر استفاده میکند:
- پردازش محلی
- اشتراک وزن
- یادگیری سلسلهمراتبی ویژگیها
Vision Transformer تصویر را به Patchها تقسیم و ارتباط میان آنها را با Attention بررسی میکند.
CNN
- مناسب دیتاست کوچکتر
- سریع و بهینه روی سختافزارهای مختلف
- ساختار محلی قوی
- مدلهای سبک متنوع
Vision Transformer
- توانایی مدلسازی ارتباطهای دور
- عملکرد قوی با Pre-training وسیع
- مقیاسپذیری مناسب
- نیاز بیشتر به داده یا وزن آماده
معماریهای جدید گاهی ایدههای CNN و Transformer را با هم ترکیب میکنند.
آموزش عملی CNN با PyTorch
در این آموزش از دیتاست CIFAR-10 استفاده میکنیم. این مجموعه شامل تصاویر کوچک از ده کلاس است.
راهنمای رسمی PyTorch نیز برای آموزش یک طبقهبند CNN از CIFAR-10 استفاده میکند.
نصب کتابخانهها
pip install torch torchvision scikit-learn matplotlibواردکردن کتابخانهها
from copy import deepcopy
from pathlib import Path

import torch
import torch.nn as nn
import torch.optim as optim

from sklearn.metrics import classification_report
from sklearn.metrics import confusion_matrix
from torch.utils.data import DataLoader
from torchvision import datasets
from torchvision import transforms
انتخاب دستگاه
device = torch.device(
    "cuda"
    if torch.cuda.is_available()
    else "cpu"
)

print("Device:", device)
اگر GPU سازگار در دسترس باشد، PyTorch میتواند آموزش را روی آن اجرا کند.
آمادهسازی داده
train_transforms = transforms.Compose(
    [
        transforms.RandomCrop(
            32,
            padding=4,
        ),
        transforms.RandomHorizontalFlip(),
        transforms.ToTensor(),
        transforms.Normalize(
            mean=[
                0.4914,
                0.4822,
                0.4465,
            ],
            std=[
                0.2470,
                0.2435,
                0.2616,
            ],
        ),
    ]
)

test_transforms = transforms.Compose(
    [
        transforms.ToTensor(),
        transforms.Normalize(
            mean=[
                0.4914,
                0.4822,
                0.4465,
            ],
            std=[
                0.2470,
                0.2435,
                0.2616,
            ],
        ),
    ]
)
Augmentation فقط روی داده آموزش انجام میشود. داده Validation و Test باید تبدیل ثابت داشته باشد.
دانلود CIFAR-10
data_root = Path("data")

train_dataset = datasets.CIFAR10(
    root=data_root,
    train=True,
    download=True,
    transform=train_transforms,
)

test_dataset = datasets.CIFAR10(
    root=data_root,
    train=False,
    download=True,
    transform=test_transforms,
)
برای پروژه واقعی بهتر است Training Set را به آموزش و Validation تقسیم کنید. Test Set باید تا پایان توسعه دستنخورده باقی بماند.
ساخت DataLoader
train_loader = DataLoader(
    train_dataset,
    batch_size=128,
    shuffle=True,
    num_workers=4,
    pin_memory=True,
)

test_loader = DataLoader(
    test_dataset,
    batch_size=128,
    shuffle=False,
    num_workers=4,
    pin_memory=True,
)
در ویندوز ممکن است لازم باشد کد ساخت DataLoader و اجرای آموزش داخل شرط زیر قرار گیرد:
if __name__ == "__main__":
    pass
ساخت مدل CNN
class ImageCNN(nn.Module):
    def __init__(
        self,
        class_count: int = 10,
    ):
        super().__init__()

        self.features = nn.Sequential(
            nn.Conv2d(
                in_channels=3,
                out_channels=32,
                kernel_size=3,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(32),
            nn.ReLU(inplace=True),

            nn.Conv2d(
                in_channels=32,
                out_channels=32,
                kernel_size=3,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(32),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(2),

            nn.Conv2d(
                in_channels=32,
                out_channels=64,
                kernel_size=3,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(64),
            nn.ReLU(inplace=True),

            nn.Conv2d(
                in_channels=64,
                out_channels=64,
                kernel_size=3,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(64),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(2),

            nn.Conv2d(
                in_channels=64,
                out_channels=128,
                kernel_size=3,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(128),
            nn.ReLU(inplace=True),

            nn.AdaptiveAvgPool2d(
                output_size=1,
            ),
        )

        self.classifier = nn.Sequential(
            nn.Flatten(),
            nn.Dropout(0.30),
            nn.Linear(
                128,
                class_count,
            ),
        )

    def forward(
        self,
        images,
    ):
        features = self.features(
            images
        )

        return self.classifier(
            features
        )
درک ابعاد ورودی و خروجی
ورودی Conv2d معمولاً این ترتیب را دارد:
Batch, Channel, Height, Widthبرای تصویر رنگی:
- Channel برابر ۳ است.
- Height و Width اندازه تصویر هستند.
در لایه اول:
nn.Conv2d(
    in_channels=3,
    out_channels=32,
    kernel_size=3,
    padding=1,
)
مدل سه Channel رنگی را دریافت و ۳۲ Feature Map تولید میکند.
ساخت مدل
model = ImageCNN(
    class_count=10,
).to(device)

print(model)
تعریف Loss و Optimizer
criterion = nn.CrossEntropyLoss()

optimizer = optim.AdamW(
    model.parameters(),
    lr=0.001,
    weight_decay=0.0001,
)
برای طبقهبندی چندکلاسه تکبرچسبی، CrossEntropyLoss انتخاب رایجی است.
نباید پیش از این Loss به خروجی مدل Softmax دستی اضافه کنید؛ زیرا تابع Loss ورودی خام مدل را انتظار دارد.
Scheduler نرخ یادگیری
scheduler = optim.lr_scheduler.ReduceLROnPlateau(
    optimizer,
    mode="min",
    factor=0.5,
    patience=2,
)
اگر Validation Loss برای چند Epoch بهتر نشود، Scheduler نرخ یادگیری را کاهش میدهد.
تابع آموزش یک Epoch
def train_one_epoch(
    model,
    loader,
    criterion,
    optimizer,
    device,
):
    model.train()

    total_loss = 0.0
    correct = 0
    item_count = 0

    for images, labels in loader:
        images = images.to(
            device,
            non_blocking=True,
        )

        labels = labels.to(
            device,
            non_blocking=True,
        )

        optimizer.zero_grad()

        logits = model(images)

        loss = criterion(
            logits,
            labels,
        )

        loss.backward()
        optimizer.step()

        total_loss += (
            loss.item()
            * images.size(0)
        )

        predictions = logits.argmax(
            dim=1
        )

        correct += (
            predictions == labels
        ).sum().item()

        item_count += images.size(0)

    return {
        "loss": total_loss / item_count,
        "accuracy": correct / item_count,
    }
تابع ارزیابی
@torch.no_grad()
def evaluate(
    model,
    loader,
    criterion,
    device,
):
    model.eval()

    total_loss = 0.0
    correct = 0
    item_count = 0

    labels_all = []
    predictions_all = []

    for images, labels in loader:
        images = images.to(
            device,
            non_blocking=True,
        )

        labels = labels.to(
            device,
            non_blocking=True,
        )

        logits = model(images)

        loss = criterion(
            logits,
            labels,
        )

        predictions = logits.argmax(
            dim=1
        )

        total_loss += (
            loss.item()
            * images.size(0)
        )

        correct += (
            predictions == labels
        ).sum().item()

        item_count += images.size(0)

        labels_all.extend(
            labels.cpu().tolist()
        )

        predictions_all.extend(
            predictions.cpu().tolist()
        )

    return {
        "loss": total_loss / item_count,
        "accuracy": correct / item_count,
        "labels": labels_all,
        "predictions": predictions_all,
    }
model.eval() رفتار Batch Normalization و Dropout را به حالت ارزیابی تغییر میدهد.
حلقه کامل آموزش
در پروژه واقعی باید validation_loader جدا از Test داشته باشید:
best_validation_loss = float("inf")
best_state = None

patience = 5
waiting = 0
max_epochs = 30

for epoch in range(max_epochs):
    train_metrics = train_one_epoch(
        model,
        train_loader,
        criterion,
        optimizer,
        device,
    )

    validation_metrics = evaluate(
        model,
        validation_loader,
        criterion,
        device,
    )

    scheduler.step(
        validation_metrics["loss"]
    )

    print(
        {
            "epoch": epoch + 1,
            "train_loss": round(
                train_metrics["loss"],
                4,
            ),
            "train_accuracy": round(
                train_metrics["accuracy"],
                4,
            ),
            "validation_loss": round(
                validation_metrics["loss"],
                4,
            ),
            "validation_accuracy": round(
                validation_metrics[
                    "accuracy"
                ],
                4,
            ),
        }
    )

    if (
        validation_metrics["loss"]
        < best_validation_loss
    ):
        best_validation_loss = (
            validation_metrics["loss"]
        )

        best_state = deepcopy(
            model.state_dict()
        )

        waiting = 0
    else:
        waiting += 1

    if waiting >= patience:
        print("Early stopping")
        break

model.load_state_dict(
    best_state
)
ارزیابی نهایی
test_metrics = evaluate(
    model,
    test_loader,
    criterion,
    device,
)

class_names = test_dataset.classes

print(
    confusion_matrix(
        test_metrics["labels"],
        test_metrics["predictions"],
    )
)

print(
    classification_report(
        test_metrics["labels"],
        test_metrics["predictions"],
        target_names=class_names,
        zero_division=0,
    )
)
علاوه بر Accuracy باید Precision، Recall و F1 هر کلاس بررسی شوند.
ذخیره مدل
checkpoint = {
    "model_state": model.state_dict(),
    "class_names": class_names,
    "architecture": "ImageCNN",
    "input_size": [
        32,
        32,
    ],
}

torch.save(
    checkpoint,
    "image_cnn.pt",
)
بارگذاری مدل
checkpoint = torch.load(
    "image_cnn.pt",
    map_location=device,
)

loaded_model = ImageCNN(
    class_count=len(
        checkpoint["class_names"]
    ),
).to(device)

loaded_model.load_state_dict(
    checkpoint["model_state"]
)

loaded_model.eval()
تعریف معماری باید با زمان ذخیره مدل یکسان باشد.
پیشبینی تصویر جدید
from PIL import Image

image = Image.open(
    "sample.jpg"
).convert("RGB")

input_tensor = (
    test_transforms(image)
    .unsqueeze(0)
    .to(device)
)

with torch.no_grad():
    logits = loaded_model(
        input_tensor
    )

    probabilities = torch.softmax(
        logits,
        dim=1,
    )

predicted_index = probabilities.argmax(
    dim=1
).item()

predicted_class = class_names[
    predicted_index
]

confidence = probabilities[
    0,
    predicted_index,
].item()

print(
    {
        "class": predicted_class,
        "confidence": confidence,
    }
)
Confidence خام مدل همیشه احتمال کالیبرهشده نیست. برای استفاده عملی، Calibration و آستانه عدم اطمینان را بررسی کنید.
جلوگیری از بیشبرازش CNN
CNN بهخصوص روی دیتاست کوچک ممکن است Overfit شود.
نشانه رایج:
- Training Accuracy افزایش مییابد.
- Validation Accuracy ثابت یا ضعیف میشود.
- Training Loss کاهش مییابد.
- Validation Loss شروع به افزایش میکند.
راهکارها:
- Data Augmentation
- Dropout
- Weight Decay
- Early Stopping
- مدل کوچکتر
- داده واقعی بیشتر
- حذف تصاویر تکراری
- Transfer Learning
- کاهش تعداد Epoch
- تقسیم داده بر اساس محصول یا منبع
برای مطالعه بیشتر به مقاله بیشبرازش و کمبرازش چیست؟ مراجعه کنید.
Data Augmentation
Data Augmentation با تغییرهای تصادفی اما واقعی، تنوع داده آموزش را افزایش میدهد.
نمونهها:
- Crop
- Flip
- Rotation محدود
- تغییر روشنایی
- تغییر کنتراست
- Blur محدود
- تغییر مقیاس
آموزش رسمی TensorFlow نیز Data Augmentation را روشی برای افزایش تنوع Training Set با تبدیلهای تصادفی واقعگرایانه معرفی میکند.
تغییرها نباید Label را عوض کنند. برای مثال، Flip افقی روی بعضی متنها یا علائم جهتدار مناسب نیست.
Batch Normalization چه کمکی میکند؟
Batch Normalization میتواند:
- آموزش را پایدارتر کند.
- امکان نرخ یادگیری مناسبتر را فراهم کند.
- حساسیت به مقداردهی اولیه را کاهش دهد.
- همگرایی را سریعتر کند.
در Batch Size بسیار کوچک، آمار Batch ممکن است ناپایدار باشد. در این حالت باید اندازه Batch، نوع Normalization یا استفاده از وزن آماده بررسی شود.
Dropout چه زمانی مفید است؟
Dropout معمولاً در Head طبقهبندی یا بخشهایی از شبکه استفاده میشود.
nn.Dropout(0.30)مقدار بیشازحد Dropout میتواند باعث Underfitting شود. مقدار مناسب باید با Validation انتخاب شود.
تحلیل Feature Mapها
مشاهده Feature Mapها میتواند نشان دهد لایههای مختلف به چه ناحیههایی حساساند.
یک Hook ساده:
activations = {}


def save_activation(
    name,
):
    def hook(
        module,
        inputs,
        output,
    ):
        activations[name] = (
            output.detach().cpu()
        )

    return hook


handle = (
    model.features[0]
    .register_forward_hook(
        save_activation(
            "first_conv"
        )
    )
)

model.eval()

with torch.no_grad():
    model(input_tensor)

feature_maps = activations[
    "first_conv"
]

handle.remove()

print(feature_maps.shape)
تفسیر Feature Mapهای عمیق همیشه ساده نیست، اما این ابزار میتواند برای اشکالزدایی و آموزش مفهومی مفید باشد.
Grad-CAM چیست؟
Grad-CAM روشی برای نمایش ناحیههایی است که بیشترین اثر را بر تصمیم مدل داشتهاند.
کاربردها:
- بررسی تمرکز مدل
- تشخیص وابستگی به پسزمینه
- تحلیل خطا
- نمایش توضیح بصری
- کنترل کیفیت Dataset
اگر مدل بهجای خود محصول به لوگو، واترمارک یا پسزمینه توجه کند، احتمال وجود Bias در داده مطرح میشود.
Grad-CAM اثبات نمیکند مدل واقعاً مانند انسان استدلال کرده است؛ فقط یک ابزار تفسیری است.
آموزش از ابتدا یا Transfer Learning؟
برای بیشتر پروژههای تصویری با داده محدود، استفاده از مدل ازپیشآموزشدیده انتخاب مناسبتری است.
آموزش CNN از ابتدا
مناسب برای:
- یادگیری مفاهیم
- معماری اختصاصی
- داده بسیار زیاد
- دامنه بسیار متفاوت
- پژوهش
Transfer Learning
مناسب برای:
- دیتاست کوچکتر
- توسعه سریع
- هزینه کمتر
- کیفیت اولیه بهتر
- پروژه تجاری
برای آموزش عملی به مقاله Transfer Learning چیست؟ مراجعه کنید.
CNN در Object Detection
در مدلهای Object Detection، CNN میتواند بهعنوان Backbone برای استخراج ویژگی استفاده شود.
سپس بخشهای دیگر مدل:
- ویژگیها را در چند مقیاس ترکیب میکنند.
- موقعیت اشیا را پیشبینی میکنند.
- کلاس هر شیء را تعیین میکنند.
- Boxهای تکراری را حذف میکنند.
مدلهایی مانند YOLO، Faster R-CNN و Mask R-CNN از معماریهای متفاوتی برای این فرایند استفاده میکنند.
CNN در Segmentation
در Segmentation باید برای هر پیکسل یا ناحیه خروجی تولید شود.
معماریهایی مانند U-Net از مسیرهای Encoder و Decoder استفاده میکنند:
- Encoder ویژگی را استخراج میکند.
- Decoder ابعاد مکانی را بازسازی میکند.
- Skip Connection جزئیات لایههای ابتدایی را منتقل میکند.
TensorFlow تفاوت Classification و Segmentation را اینگونه توضیح میدهد که Classification یک کلاس برای کل تصویر میسازد، اما Segmentation کلاس هر پیکسل را تعیین میکند.
CNN در پردازش متن و صوت
CNN فقط برای تصویر نیست.
متن
کانولوشن یکبعدی میتواند الگوهای محلی مانند ترکیب واژهها را استخراج کند.
صوت
CNN میتواند روی Waveform یا Spectrogram اجرا شود.
ویدیو
3D CNN الگوهای مکانی و زمانی را همزمان بررسی میکند.
داده حسگر
Convolution یکبعدی برای دنبالههای زمانی و سیگنالهای چندکاناله کاربرد دارد.
چه زمانی CNN انتخاب مناسبی نیست؟
CNN همیشه بهترین گزینه نیست.
ممکن است گزینه دیگری مناسبتر باشد اگر:
- داده جدولی است.
- ارتباطهای بسیار دور اهمیت اصلی دارند.
- مدل آماده قدرتمندتری وجود دارد.
- داده آموزشی بسیار محدود است.
- مسئله با قوانین ساده حل میشود.
- API آماده هزینه و زمان کمتری دارد.
- خروجی توضیحی و چندمنظوره لازم است.
CNN یا مدل چندوجهی API؟
CNN اختصاصی مناسبتر است اگر:
- کلاسها ثابت و مشخصاند.
- درخواستها بسیار زیادند.
- تأخیر پایین اهمیت دارد.
- اجرای محلی لازم است.
- داده برچسبخورده دارید.
- هزینه هر پیشبینی باید کم باشد.
- کنترل نسخه مدل ضروری است.
مدل چندوجهی مناسبتر است اگر:
- پرسشها درباره تصویر متنوعاند.
- توضیح متنی لازم است.
- داده آموزشی کافی ندارید.
- میخواهید سریع نمونه اولیه بسازید.
- تحلیل معنایی پیچیده نیاز دارید.
- کلاسها از قبل محدود نیستند.
تحلیل تصویر با API درواره
API درواره با ساختار سازگار با OpenAI امکان اتصال نرمافزار به مدلهای مختلف هوش مصنوعی را فراهم میکند.
آدرس پایه:
https://api.darvareh.ir/v1نصب:
pip install openaiمتغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_VISION_MODEL="YOUR_VISION_MODEL_ID"
نمونه کد:
import base64
import mimetypes
import os
from pathlib import Path
from openai import OpenAI
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
MODEL_ID = os.environ[
"DARVAREH_VISION_MODEL"
]
def image_data_url(
image_path: str,
) -> str:
path = Path(image_path)
mime_type = (
mimetypes.guess_type(
path.name
)[0]
or "image/jpeg"
)
encoded = base64.b64encode(
path.read_bytes()
).decode("utf-8")
return (
f"data:{mime_type};base64,"
f"{encoded}"
)
completion = client.chat.completions.create(
model=MODEL_ID,
temperature=0,
messages=[
{
"role": "system",
"content": (
"تصویر را دقیق تحلیل کن. "
"اگر شواهد کافی نیست، "
"عدم اطمینان را اعلام کن."
),
},
{
"role": "user",
"content": [
{
"type": "text",
"text": (
"محتوای اصلی تصویر را "
"توصیف و دستهبندی کن."
),
},
{
"type": "image_url",
"image_url": {
"url": image_data_url(
"sample.jpg"
),
},
},
],
},
],
)
print(
completion.choices[0].message.content
)پشتیبانی از تصویر به مدل انتخابشده بستگی دارد. شناسه مدل و قالب ورودی را در مستندات فعلی بررسی کنید.
برای شروع میتوانید مستندات API درواره را مطالعه کنید.
معماری ترکیبی CNN و API
یک محصول میتواند از هر دو روش استفاده کند:
- CNN کوچک دستهبندی پرتکرار را انجام دهد.
- خروجی کماطمینان شناسایی شود.
- فقط تصویرهای مبهم به مدل چندوجهی ارسال شوند.
- پاسخ مدل با قواعد برنامه اعتبارسنجی شود.
- موارد حساس به کارشناس ارجاع داده شوند.
- نمونههای تأییدشده برای آموزش نسخه بعدی ذخیره شوند.
این معماری میتواند سرعت CNN را با انعطاف مدل چندوجهی ترکیب کند.
استقرار CNN
گزینههای استقرار:
- سرویس Python و FastAPI
- TorchScript
- ONNX Runtime
- TensorRT
- CoreML
- اجرای موبایل
- دستگاه Edge
- پردازش Batch
پیش از انتخاب فرمت باید این موارد را روی سختافزار مقصد اندازهگیری کنید:
- زمان Inference
- مصرف حافظه
- اندازه مدل
- Throughput
- کیفیت خروجی
- زمان بارگذاری مدل
- مصرف CPU یا GPU
مانیتورینگ مدل
بعد از انتشار این موارد را ثبت کنید:
- نسخه مدل
- نسخه Transform
- زمان پیشبینی
- کلاس خروجی
- Confidence
- اندازه تصویر
- نرخ خطا
- نرخ خروجی کماطمینان
- نتیجه بازبینی انسانی
- توزیع کلاسها
- تغییر دوربین یا منبع داده
افت کیفیت ممکن است ناشی از تغییر نور، زاویه، محصول یا فرایند تصویربرداری باشد.
اشتباهات رایج
استفاده از Test Set هنگام توسعه
Test باید برای ارزیابی نهایی باقی بماند.
تفاوت Transform آموزش و Production
Normalization و اندازه ورودی باید با آموزش هماهنگ باشند.
Flatten بسیار بزرگ
این کار تعداد پارامترها و خطر بیشبرازش را افزایش میدهد.
Pooling بیشازحد
ممکن است جزئیات اشیای کوچک از بین برود.
نادیدهگرفتن تصاویر تکراری
وجود نسخههای مشابه در Training و Test نتیجه غیرواقعی ایجاد میکند.
Augmentation نامعتبر
تغییری که Label را عوض میکند نباید استفاده شود.
گزارش فقط Accuracy
معیارهای هر کلاس و Confusion Matrix را نیز بررسی کنید.
استفاده از Softmax داخل مدل پیش از CrossEntropyLoss
CrossEntropyLoss خروجی خام مدل را دریافت میکند.
فراموشکردن model.eval
Dropout و Batch Normalization در حالت آموزش و ارزیابی رفتار متفاوتی دارند.
اعتماد کامل به Confidence
Confidence باید روی داده مستقل ارزیابی و در صورت نیاز کالیبره شود.
چکلیست ساخت CNN
پیش از استقرار بررسی کنید:
- هدف و کلاسها دقیق تعریف شدهاند.
- داده واقعی و متنوع است.
- تصاویر تکراری حذف شدهاند.
- تقسیم داده بر اساس منبع یا محصول انجام شده است.
- Validation و Test مستقل هستند.
- Transformها مستند شدهاند.
- Augmentation با دنیای واقعی سازگار است.
- معماری Baseline ساده ساخته شده است.
- Training و Validation Loss مقایسه میشوند.
- Early Stopping فعال است.
- بهترین Checkpoint ذخیره میشود.
- معیار هر کلاس گزارش شده است.
- مدل ازپیشآموزشدیده نیز آزمایش شده است.
- سرعت روی سختافزار مقصد اندازهگیری شده است.
- خروجی کماطمینان مسیر مشخص دارد.
- مدل پس از انتشار مانیتور میشود.
پرسشهای متداول
CNN چیست؟
CNN نوعی شبکه عصبی است که با استفاده از فیلترهای قابل آموزش، ویژگیهای محلی و سلسلهمراتبی را از تصویر یا داده ساختاریافته استخراج میکند.
CNN مخفف چیست؟
CNN مخفف Convolutional Neural Network به معنی شبکه عصبی کانولوشنی، پیچشی یا همگشتی است.
Convolution در CNN چه کاری انجام میدهد؟
یک Filter کوچک روی بخشهای مختلف ورودی حرکت میکند و الگوهای محلی مانند لبه، بافت و شکل را استخراج میکند.
Pooling چیست؟
Pooling ابعاد Feature Map را کاهش میدهد و حجم محاسبات را کمتر میکند.
تفاوت CNN و شبکه عصبی معمولی چیست؟
CNN ساختار مکانی تصویر را حفظ و وزن Filterها را در موقعیتهای مختلف استفاده میکند. شبکه کاملاً متصل معمولاً تمام ورودیها را بدون این ساختار محلی پردازش میکند.
آیا CNN فقط برای تصویر است؟
خیر. CNNهای یکبعدی برای متن، صوت و سیگنال و CNNهای سهبعدی برای ویدیو و داده حجمی استفاده میشوند.
CNN بهتر است یا Transformer؟
پاسخ به داده، سختافزار و کاربرد بستگی دارد. CNN برای بسیاری از پروژههای تصویری همچنان سریع، کارآمد و مناسب است. Transformerها نیز در مقیاس و Pre-training بزرگ عملکرد قدرتمندی دارند.
آیا باید CNN را از ابتدا آموزش دهیم؟
در بیشتر پروژههای دارای داده محدود، Transfer Learning با مدل ازپیشآموزشدیده گزینه بهتری است.
تفاوت CNN و YOLO چیست؟
CNN یک معماری پایه برای استخراج ویژگی است. YOLO یک سامانه کامل Object Detection برای یافتن کلاس و موقعیت چند شیء است.
آیا میتوان CNN را بدون GPU آموزش داد؟
بله، اما آموزش روی CPU کندتر است. مدل کوچک و دیتاست محدود را میتوان روی CPU آزمایش کرد.
جمعبندی
شبکه عصبی کانولوشنی یکی از مهمترین معماریهای یادگیری عمیق برای پردازش تصویر است. CNN با استفاده از Filterهای قابل آموزش، ویژگیها را بهصورت محلی و سلسلهمراتبی استخراج میکند.
برای اجرای موفق:
- تفاوت Classification، Detection و Segmentation را مشخص کنید.
- داده واقعی و بدون نشت آماده کنید.
- با معماری ساده Baseline بسازید.
- از Convolution، Normalization و Pooling بهشکل کنترلشده استفاده کنید.
- Data Augmentation واقعگرایانه اجرا کنید.
- Training و Validation را همزمان پایش کنید.
- برای دیتاست کوچک Transfer Learning را آزمایش کنید.
- معیار هر کلاس را جداگانه بررسی کنید.
- بهترین Checkpoint را ذخیره کنید.
- سرعت و حافظه را روی سختافزار مقصد اندازهگیری کنید.
- خروجی کماطمینان را مدیریت کنید.
- پیش از آموزش اختصاصی، مدل چندوجهی API را نیز مقایسه کنید.
اگر قصد دارید قابلیت تحلیل تصویر را سریعتر به نرمافزار خود اضافه کنید، میتوانید مدلهای چندوجهی مختلف را از طریق API یکپارچه درواره روی داده واقعی پروژه آزمایش و مقایسه کنید.
مقالات مرتبط
- شبکه عصبی چیست؟
- یادگیری عمیق چیست؟
- بینایی ماشین چیست؟
- آموزش PyTorch با پایتون
- آموزش TensorFlow و Keras
- Transfer Learning چیست؟
- YOLO چیست؟
- بیشبرازش و کمبرازش چیست؟
- ماتریس درهمریختگی و معیارهای ارزیابی
منابع
- TensorFlow: Convolutional Neural Network
- PyTorch: Training a Classifier
- PyTorch: Defining a Neural Network
- TensorFlow: Image Classification
- TensorFlow: Data Augmentation
- TensorFlow: Video Classification with 3D CNN
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



