
YOLO چیست؟ آموزش تشخیص اشیا با پایتون و Ultralytics
YOLO یکی از محبوبترین مدلهای تشخیص اشیا در تصویر و ویدیو است. در این راهنما نصب، اجرای مدل آماده، آموزش دیتاست اختصاصی، ارزیابی و استقرار YOLO را با پایتون یاد میگیرید.

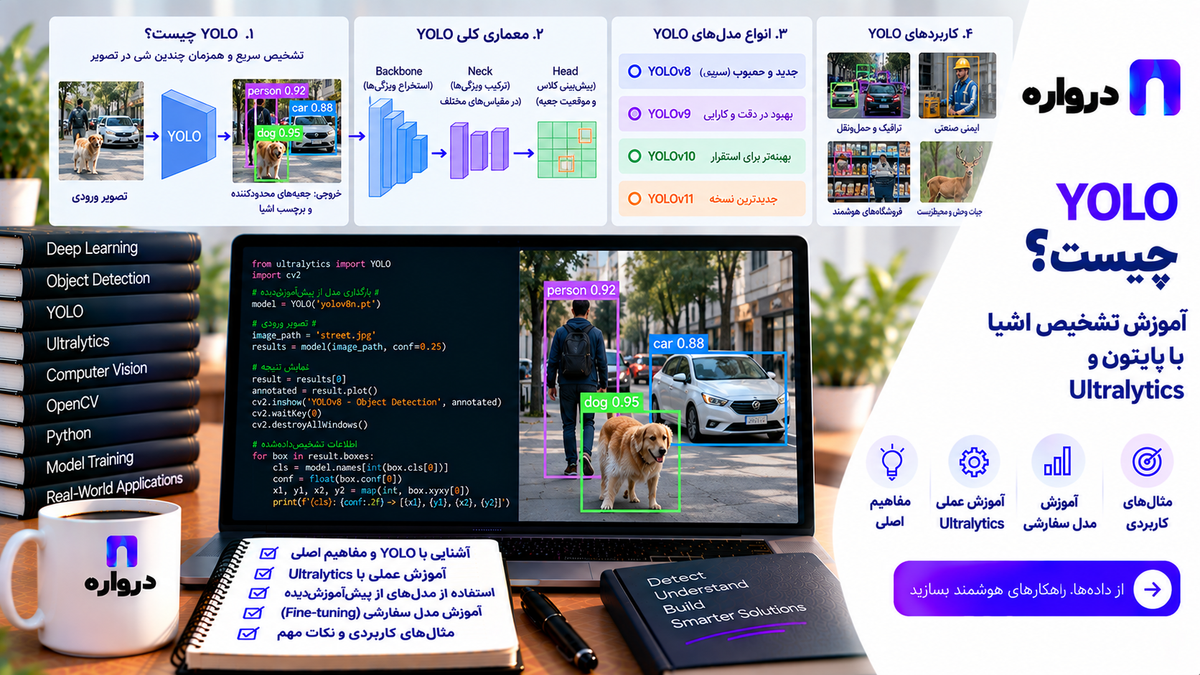
تشخیص اشیا یکی از پرکاربردترین شاخههای بینایی ماشین است. در این مسئله، مدل باید علاوه بر تشخیص نوع اشیا، موقعیت هرکدام را نیز در تصویر مشخص کند.
برای مثال، یک سامانه بینایی ماشین میتواند در یک تصویر موارد زیر را پیدا کند:
- افراد
- خودروها
- محصولات
- بستهها
- قطعات
- علائم
- حیوانات
- تجهیزات
- اشیای معیوب
YOLO یکی از شناختهشدهترین خانوادههای مدل Object Detection است. سرعت بالا و امکان پردازش بلادرنگ باعث شده YOLO در پروژههای تصویری، ویدیویی، صنعتی و نرمافزارهای هوشمند کاربرد گستردهای داشته باشد.
در این مقاله میآموزید:
- YOLO چیست؟
- تفاوت Classification و Object Detection چیست؟
- Bounding Box و Confidence چه هستند؟
- چگونه YOLO را با پایتون نصب کنیم؟
- چگونه اشیا را در تصویر، ویدیو و وبکم تشخیص دهیم؟
- چگونه دیتاست اختصاصی بسازیم؟
- فرمت Annotation مدل YOLO چگونه است؟
- چگونه مدل را آموزش و ارزیابی کنیم؟
- معیارهای Precision، Recall و mAP چه معنایی دارند؟
- چگونه YOLO را به ONNX صادر و به API تبدیل کنیم؟
- چه زمانی مدل چندوجهی از طریق API درواره گزینه مناسبتری است؟
YOLO چیست؟
YOLO مخفف عبارت You Only Look Once است. ایده اصلی این خانواده از مدلها این است که تصویر در یک مرحله پردازش شود و مدل موقعیت و کلاس چند شیء را همزمان تشخیص دهد.
مدلهای YOLO معمولاً از معماری One-stage Detector استفاده میکنند. برخلاف روشهایی که ابتدا ناحیههای پیشنهادی را پیدا و سپس هر ناحیه را جداگانه طبقهبندی میکنند، YOLO مراحل تشخیص را در یک جریان یکپارچه انجام میدهد.
نتیجه این طراحی معمولاً ترکیبی از موارد زیر است:
- سرعت بالا
- امکان پردازش ویدیوی بلادرنگ
- اجرای ساده
- مدلهایی با اندازههای مختلف
- قابلیت آموزش روی دیتاست اختصاصی
- امکان استقرار روی سرور، دسکتاپ، موبایل و Edge
مستندات Ultralytics حالتهای مختلفی مانند آموزش، اعتبارسنجی، پیشبینی، Tracking، Export و Benchmark را برای مدلهای YOLO ارائه میکند.
تفاوت Classification، Detection و Segmentation
این سه مسئله تصویری با یکدیگر متفاوتاند.
Image Classification
مدل یک برچسب برای کل تصویر تولید میکند.
مثال:
این تصویر شامل یک خودرو است.مدل محل خودرو را مشخص نمیکند.
Object Detection
مدل نوع و محل هر شیء را پیدا میکند.
مثال:
خودرو در بخش پایین سمت راست تصویر قرار دارد.خروجی شامل Bounding Box است.
Image Segmentation
مدل بهجای یک مستطیل، پیکسلهای مربوط به هر شیء را مشخص میکند.
Segmentation برای زمانی مناسب است که شکل دقیق شیء اهمیت دارد.
Object Tracking
پس از Detection، اشیا در فریمهای متوالی ویدیو دنبال میشوند و معمولاً یک شناسه پایدار دریافت میکنند.
| وظیفه | خروجی |
|---|---|
| Classification | کلاس کل تصویر |
| Object Detection | کلاس و Bounding Box |
| Segmentation | کلاس و ناحیه پیکسلی |
| Pose Estimation | نقاط کلیدی |
| Tracking | موقعیت و شناسه در طول ویدیو |
Bounding Box چیست؟
Bounding Box مستطیلی است که محل یک شیء را در تصویر نشان میدهد.
هر Bounding Box معمولاً شامل این اطلاعات است:
- مختصات مرکز یا گوشهها
- عرض
- ارتفاع
- کلاس شیء
- امتیاز اطمینان
برای مثال:
{
  "class": "package",
  "confidence": 0.91,
  "box": {
    "x1": 120,
    "y1": 80,
    "x2": 420,
    "y2": 360
  }
}
مختصات میتوانند به پیکسل یا مقدار نرمالشده ذخیره شوند. فرمت دقیق به کتابخانه و مرحله پردازش بستگی دارد.
Confidence چیست؟
Confidence عددی است که نشان میدهد مدل تا چه اندازه به تشخیص خود اطمینان دارد.
اگر آستانه Confidence بسیار پایین باشد:
- اشیای بیشتری پیدا میشوند.
- Recall ممکن است افزایش یابد.
- False Positive نیز بیشتر میشود.
اگر آستانه بسیار بالا باشد:
- خروجیها مطمئنتر میشوند.
- Precision ممکن است افزایش یابد.
- احتمال ازدسترفتن اشیای واقعی بیشتر میشود.
آستانه مناسب باید روی Validation Set و بر اساس نیاز محصول انتخاب شود.
NMS چیست؟
ممکن است مدل برای یک شیء چند Bounding Box نزدیک به هم تولید کند. Non-Maximum Suppression یا NMS برای حذف تشخیصهای تکراری استفاده میشود.
NMS معمولاً:
- Box دارای Confidence بالاتر را نگه میدارد.
- همپوشانی آن را با Boxهای دیگر بررسی میکند.
- Boxهای بسیار مشابه را حذف میکند.
تنظیم NMS روی تعداد خروجیها و تشخیص اشیای نزدیک به یکدیگر اثر دارد.
YOLO در چه پروژههایی کاربرد دارد؟
فروشگاه و انبار
- شمارش محصولات
- تشخیص جای خالی قفسه
- شناسایی نوع کالا
- کنترل چیدمان
- بررسی بستهها
تولید و صنعت
- تشخیص قطعه
- شمارش تجهیزات
- بررسی خط تولید
- شناسایی نقص ظاهری
- کنترل حضور اجزای لازم
حملونقل
- شمارش خودرو
- تشخیص نوع وسیله نقلیه
- تحلیل ترافیک
- پایش فضای پارک
- ردیابی حرکت
کشاورزی
- شمارش محصول
- شناسایی میوه
- پایش رشد
- تشخیص علف هرز
- بررسی ناحیههای مزرعه
رسانه و ویدیو
- جستوجوی اشیا در ویدیو
- استخراج فریمهای مرتبط
- دنبالکردن سوژه
- تحلیل محتوای تصویری
- ساخت Metadata
انتخاب اندازه مدل YOLO
مدلهای Ultralytics معمولاً در چند اندازه عرضه میشوند. نامگذاری دقیق ممکن است میان نسلها تغییر کند، اما الگوی کلی شامل نسخههای کوچک تا بزرگ است.
| اندازه تقریبی | مزیت | کاربرد |
|---|---|---|
| Nano | بسیار سریع و سبک | موبایل، Edge و نمونه اولیه |
| Small | تعادل سرعت و کیفیت | کاربرد بلادرنگ |
| Medium | کیفیت بالاتر | سرور و GPU متوسط |
| Large | دقت بیشتر | پردازش سنگینتر |
| Extra Large | بیشترین ظرفیت | سرور قدرتمند و Batch |
مدل بزرگتر همیشه بهترین انتخاب نیست. باید این موارد را اندازهگیری کنید:
- Precision
- Recall
- mAP
- سرعت Inference
- مصرف حافظه
- اندازه فایل
- تعداد فریم بر ثانیه
- سختافزار مقصد
نصب Ultralytics YOLO
برای نصب:
pip install ultralyticsبررسی نصب:
yolo checksیا در پایتون:
import ultralytics

ultralytics.checks()
برای استفاده از GPU باید نسخه مناسب PyTorch و درایورهای سازگار با کارت گرافیک نصب باشند.
تشخیص اشیا در تصویر با پایتون
from ultralytics import YOLO

model = YOLO(
    "yolo26n.pt"
)

results = model.predict(
    source="image.jpg",
    conf=0.25,
    save=True,
)

print(results)
نام وزن جاری را بر اساس فهرست مدلهای نسخه نصبشده Ultralytics انتخاب کنید. مستندات فعلی Ultralytics نمونههای آموزش و اجرا را با خانواده مدل جاری ارائه میکنند.
تصویر دارای Bounding Box معمولاً در پوشه اجرای Ultralytics ذخیره میشود.
اجرای YOLO از خط فرمان
yolo predict model=yolo26n.pt source=image.jpg conf=0.25 save=Trueساختار کلی CLI:
yolo TASK MODE ARGSحالتهای مهم:
trainvalpredicttrackexportbenchmark
مستندات Ultralytics همین حالتها را برای مراحل مختلف توسعه و استقرار معرفی میکند.
خواندن خروجی مدل
from ultralytics import YOLO

model = YOLO(
    "yolo26n.pt"
)

results = model(
    "image.jpg"
)

for result in results:
    boxes = result.boxes

    for box in boxes:
        class_id = int(
            box.cls[0].item()
        )

        confidence = float(
            box.conf[0].item()
        )

        x1, y1, x2, y2 = (
            box.xyxy[0]
            .cpu()
            .tolist()
        )

        class_name = result.names[
            class_id
        ]

        print(
            {
                "class_id": class_id,
                "class_name": class_name,
                "confidence": confidence,
                "box": {
                    "x1": x1,
                    "y1": y1,
                    "x2": x2,
                    "y2": y2,
                },
            }
        )
در برنامه واقعی بهتر است خروجی به یک Schema مشخص تبدیل شود تا رابط کاربری به ساختار داخلی کتابخانه وابسته نباشد.
تشخیص اشیا در چند تصویر
results = model.predict(
    source=[
        "image-1.jpg",
        "image-2.jpg",
        "image-3.jpg",
    ],
    conf=0.30,
    save=True,
)
برای تعداد زیاد تصاویر، Batch Size و حافظه GPU را بررسی کنید.
تشخیص اشیا در ویدیو
results = model.predict(
    source="video.mp4",
    conf=0.30,
    save=True,
    stream=True,
)

for result in results:
    print(
        len(result.boxes)
    )
استفاده از stream=True کمک میکند تمام نتیجههای ویدیو همزمان در حافظه نگهداری نشوند.
مستندات Predict Mode از ورودیهای مختلف و پردازش بلادرنگ پشتیبانی میکند.
اجرای YOLO روی وبکم
model.predict(
    source=0,
    show=True,
    conf=0.30,
)
عدد صفر معمولاً به اولین وبکم متصل اشاره میکند. در محیط سرور بدون رابط گرافیکی از show=True استفاده نکنید.
Tracking اشیا در ویدیو
results = model.track(
    source="video.mp4",
    conf=0.30,
    persist=True,
    save=True,
)

for result in results:
    if (
        result.boxes is not None
        and result.boxes.id is not None
    ):
        track_ids = (
            result.boxes.id
            .int()
            .cpu()
            .tolist()
        )

        print(track_ids)
Tracking برای شمارش ورود و خروج، دنبالکردن مسیر و جلوگیری از شمارش تکراری یک شیء کاربرد دارد.
Detection و Tracking یکسان نیستند. مدل Detection در هر فریم شیء را پیدا میکند؛ Tracker تلاش میکند تشخیصهای فریمهای مختلف را به یک موجودیت مرتبط کند.
تشخیص فقط چند کلاس مشخص
results = model.predict(
    source="street.jpg",
    classes=[
        0,
        2,
    ],
    conf=0.35,
)
شناسه کلاسها به دیتاست و وزن انتخابشده بستگی دارد. پیش از استفاده نگاشت کلاسها را بررسی کنید:
print(model.names)ساخت دیتاست اختصاصی YOLO
برای آموزش مدل روی اشیای اختصاصی به این موارد نیاز دارید:
- تصاویر واقعی
- Bounding Box برای هر شیء
- نام کلاسها
- تقسیم Training، Validation و Test
- فایل پیکربندی Dataset
ساختار رایج:
package-dataset/
├── images/
│   ├── train/
│   ├── val/
│   └── test/
├── labels/
│   ├── train/
│   ├── val/
│   └── test/
└── data.yaml
برای هر تصویر در پوشه images باید فایل متنی همنامی در پوشه labels وجود داشته باشد.
مثال:
images/train/frame-001.jpg
labels/train/frame-001.txt
فرمت Annotation مدل YOLO
هر خط فایل Label نماینده یک شیء است:
class_id x_center y_center width heightنمونه:
0 0.512 0.461 0.305 0.420
1 0.220 0.710 0.180 0.250
مقادیر موقعیت و اندازه معمولاً نسبت به ابعاد تصویر نرمال شدهاند و باید در محدوده معتبر قرار داشته باشند.
نکات مهم:
- شماره کلاس از صفر شروع میشود.
- هر شیء یک خط دارد.
- مختصات نباید خارج از تصویر باشند.
- Width و Height باید مقدار مثبت داشته باشند.
- فایل خالی میتواند نماینده تصویر بدون شیء باشد.
- تصویر و Label باید دقیقاً همنام باشند.
ابزارهای Annotation
ابزارهای متداول:
- CVAT
- Label Studio
- LabelImg
- Roboflow
- makesense.ai
در انتخاب ابزار این موارد را بررسی کنید:
- خروجی YOLO
- مدیریت تیم برچسبگذاری
- بازبینی Annotation
- کنترل نسخه
- امکان Import و Export
- نصب محلی
- پشتیبانی از ویدیو
- سیاست نگهداری داده
برای داده اختصاصی سازمان، شرایط ذخیرهسازی و دسترسی ابزار را پیش از بارگذاری تصاویر بررسی کنید.
تعریف کلاسها
کلاسها باید:
- تعریف شفاف داشته باشند.
- همپوشانی مبهم نداشته باشند.
- توسط برچسبگذاران یکسان فهمیده شوند.
- نمونه کافی داشته باشند.
- در Production قابل مشاهده باشند.
تعریف ضعیف:
خرابتعریف بهتر:
بستهبندی دارای پارگی یا فرورفتگی قابل مشاهدهبرای موارد نامشخص، راهنمای تصمیم و مسیر بازبینی تعریف کنید.
فایل data.yaml
path: /absolute/path/to/package-dataset

train: images/train
val: images/val
test: images/test

names:
  0: package
  1: damaged_package
  2: label
اگر مسیر نسبی استفاده میکنید، مطمئن شوید اجرای برنامه از مسیر مورد انتظار انجام میشود.
آموزش مدل اختصاصی
from ultralytics import YOLO

model = YOLO(
    "yolo26n.pt"
)

training_result = model.train(
    data="data.yaml",
    epochs=80,
    imgsz=640,
    batch=16,
    device=0,
    project="runs/package-detection",
    name="baseline",
    patience=15,
)
پارامترهای مهم:
data: مسیر فایل Datasetepochs: تعداد دورههاimgsz: اندازه ورودیbatch: اندازه Batchdevice: CPU یا GPUpatience: توقف زودهنگامproject: پوشه اصلی خروجیname: نام اجرای آزمایش
مستندات Train Mode تنظیمات آموزش، Augmentation و سختافزار را توضیح میدهد.
آموزش از خط فرمان
yolo detect train \
  model=yolo26n.pt \
  data=data.yaml \
  epochs=80 \
  imgsz=640 \
  batch=16 \
  device=0 \
  patience=15
در ویندوز میتوانید دستور را در یک خط اجرا کنید.
انتخاب Batch Size
Batch بزرگتر میتواند استفاده از GPU را بهتر کند، اما حافظه بیشتری نیاز دارد.
اگر با خطای کمبود حافظه روبهرو شدید:
- Batch Size را کاهش دهید.
- اندازه تصویر را کمتر کنید.
- مدل کوچکتری انتخاب کنید.
- برنامههای دیگر GPU را ببندید.
- Mixed Precision را بررسی کنید.
- از Gradient Accumulation در صورت پشتیبانی استفاده کنید.
انتخاب اندازه تصویر
اندازه تصویر روی دقت و سرعت اثر میگذارد.
رزولوشن بزرگتر:
- برای اشیای کوچک مفید است.
- حافظه بیشتری مصرف میکند.
- Inference را کندتر میکند.
- زمان آموزش را افزایش میدهد.
اگر اشیا بخش کوچکی از تصویر هستند، فقط افزایش imgsz کافی نیست. روشهای دیگری مانند Crop، Tiling و جمعآوری تصاویر نزدیکتر را نیز بررسی کنید.
آموزش از صفر یا وزن آماده؟
استفاده از وزن آماده
برای بیشتر پروژهها انتخاب مناسبتری است:
model = YOLO(
    "yolo26n.pt"
)
مزایا:
- همگرایی سریعتر
- نیاز کمتر به داده
- عملکرد اولیه بهتر
- هزینه آموزش کمتر
آموزش از معماری بدون وزن
نام فایل پیکربندی به نسل مدل بستگی دارد:
model = YOLO(
    "yolo26n.yaml"
)
آموزش از ابتدا معمولاً به داده بسیار بیشتری نیاز دارد.
برای آشنایی با مفهوم استفاده مجدد از وزنها، مقاله Transfer Learning چیست؟ را مطالعه کنید.
اعتبارسنجی مدل
from ultralytics import YOLO

model = YOLO(
    "runs/package-detection/"
    "baseline/weights/best.pt"
)

metrics = model.val(
    data="data.yaml",
    split="val",
)

print(
    "mAP50:",
    metrics.box.map50,
)

print(
    "mAP50-95:",
    metrics.box.map,
)
Ultralytics حالت Val را برای اندازهگیری معیارهای مدل روی داده اعتبارسنجی فراهم میکند.
در پایان توسعه، مدل را یک بار روی Test Set مستقل ارزیابی کنید.
IoU چیست؟
Intersection over Union یا IoU میزان همپوشانی Bounding Box پیشبینیشده و Box واقعی را اندازهگیری میکند.
IoU بالاتر یعنی Box مدل با Annotation واقعی همپوشانی بیشتری دارد.
IoU در موارد زیر استفاده میشود:
- تعیین درست یا اشتباه بودن Detection
- محاسبه mAP
- حذف Boxهای تکراری در NMS
- ارزیابی کیفیت موقعیتیابی
mAP چیست؟
mAP یکی از معیارهای اصلی Object Detection است.
mAP50
عملکرد مدل را با یک آستانه مشخص IoU ارزیابی میکند.
mAP50-95
عملکرد را روی مجموعهای از آستانههای سختگیرانهتر بررسی میکند و معمولاً معیار جامعتری است.
mAP باید در کنار این موارد گزارش شود:
- Precision
- Recall
- معیار هر کلاس
- سرعت Inference
- اندازه مدل
- Confusion Matrix
- کیفیت بصری خروجی
مدلی با mAP مناسب ممکن است روی یک کلاس مهم عملکرد ضعیفی داشته باشد.
Precision و Recall در Object Detection
Precision بالا
بخش بزرگی از Boxهای پیشبینیشده واقعاً به شیء موردنظر تعلق دارند.
Recall بالا
مدل بخش بزرگی از اشیای واقعی را پیدا کرده است.
اگر هدف شمارش تمام بستهها باشد، Recall اهمیت زیادی دارد. اگر هر هشدار اشتباه باعث توقف خط شود، Precision نیز بسیار مهم خواهد بود.
ارزیابی هر کلاس
مدل را فقط با عدد کلی mAP ارزیابی نکنید.
موارد زیر را برای هر کلاس بررسی کنید:
- تعداد نمونه
- Precision
- Recall
- mAP
- اندازه اشیا
- شرایط نور
- زاویه دوربین
- میزان پوشیدگی
- الگوهای خطا
ممکن است مدل روی package عالی و روی damaged_package ضعیف باشد.
داده نامتوازن
اگر یک کلاس نمونه کمی دارد:
- نمونه واقعی بیشتری جمعآوری کنید.
- توزیع کلاسها را گزارش کنید.
- Augmentation متناسب اجرا کنید.
- خطاهای همان کلاس را جداگانه بررسی کنید.
- Labelهای آن را بازبینی کنید.
- تصاویر تکراری را جایگزین نمونههای متنوع کنید.
تکرار یک تصویر اطلاعات جدیدی به مدل اضافه نمیکند.
تصاویر بدون شیء
اضافهکردن تصاویر Background میتواند به کاهش False Positive کمک کند.
مثال:
- خط تولید بدون محصول
- قفسه خالی
- محیط بدون شیء هدف
- اشیای مشابه اما خارج از کلاس
- نور و پسزمینههای مختلف
برای چنین تصویری Label خالی ایجاد میشود.
تعداد تصاویر منفی نباید آنقدر زیاد باشد که آموزش را به سمت پسزمینه منحرف کند.
تقسیم داده بدون Leakage
تقسیم تصادفی فریمهای یک ویدیو اشتباه رایجی است. فریمهای نزدیک تقریباً یکساناند و اگر میان Training و Test پخش شوند، نتیجه غیرواقعی خواهد بود.
بهتر است تقسیم بر اساس موارد زیر انجام شود:
- ویدیو
- دوربین
- محل
- محصول
- سری تولید
- جلسه تصویربرداری
- تاریخ
Test Set باید شرایطی را شامل شود که مدل هنگام آموزش ندیده است.
Data Augmentation
Augmentationهای احتمالی:
- تغییر روشنایی
- تغییر کنتراست
- Crop
- تغییر مقیاس
- Flip
- جابهجایی
- Blur
- تغییر محدود رنگ
- Mosaic
هر Augmentation باید با شرایط واقعی پروژه سازگار باشد.
برای مثال، Flip افقی ممکن است برای بستهبندی مناسب باشد، اما برای علائم جهتدار یا متن روی تصویر نتیجه غیرواقعی تولید کند.
اشیای کوچک
تشخیص شیء کوچک از چالشهای مهم YOLO است.
راهکارها:
- افزایش رزولوشن ورودی
- نزدیکترکردن دوربین
- استفاده از Tiling
- جمعآوری نمونه بیشتر
- بهبود کیفیت Annotation
- کاهش فضای اضافی اطراف صحنه
- استفاده از مدل بزرگتر
- بررسی نسخه مناسب معماری
برای Tiling، تصویر بزرگ به قطعههای همپوشان تقسیم و نتیجهها در پایان ادغام میشوند.
اشیای همپوشان
وقتی چند شیء نزدیک یا روی یکدیگر قرار دارند:
- NMS ممکن است بعضی Boxها را حذف کند.
- Annotation باید دقیق باشد.
- تصاویر مشابه بیشتری لازم است.
- آستانه IoU باید بررسی شود.
- مدل Segmentation ممکن است مناسبتر باشد.
پیشبینی با مدل آموزشدیده
from ultralytics import YOLO

model = YOLO(
    "runs/package-detection/"
    "baseline/weights/best.pt"
)

results = model.predict(
    source="new-image.jpg",
    conf=0.40,
    iou=0.60,
    save=True,
)آستانهها را روی Validation تنظیم کنید و Test را برای ارزیابی نهایی نگه دارید.
خروجی JSON برای اپلیکیشن
def serialize_result(
    result,
) -> list[dict]:
    detections = []

    if result.boxes is None:
        return detections

    for box in result.boxes:
        class_id = int(
            box.cls[0].item()
        )

        confidence = float(
            box.conf[0].item()
        )

        coordinates = (
            box.xyxy[0]
            .cpu()
            .tolist()
        )

        detections.append(
            {
                "class_id": class_id,
                "class_name": (
                    result.names[
                        class_id
                    ]
                ),
                "confidence": confidence,
                "box": {
                    "x1": coordinates[0],
                    "y1": coordinates[1],
                    "x2": coordinates[2],
                    "y2": coordinates[3],
                },
            }
        )

    return detections
ساخت API تشخیص اشیا با FastAPI
نصب:
pip install fastapi uvicorn python-multipart ultralyticsکد:
from pathlib import Path
from tempfile import NamedTemporaryFile

from fastapi import FastAPI
from fastapi import File
from fastapi import HTTPException
from fastapi import UploadFile
from ultralytics import YOLO

app = FastAPI(
    title="Object Detection API",
)

model = YOLO(
    "best.pt"
)

allowed_content_types = {
    "image/jpeg",
    "image/png",
    "image/webp",
}


@app.post("/detect")
async def detect(
    image: UploadFile = File(...),
):
    if (
        image.content_type
        not in allowed_content_types
    ):
        raise HTTPException(
            status_code=415,
            detail="Unsupported image type",
        )

    content = await image.read()

    if len(content) > 10 * 1024 * 1024:
        raise HTTPException(
            status_code=413,
            detail="Image is too large",
        )

    suffix = Path(
        image.filename or "image.jpg"
    ).suffix

    with NamedTemporaryFile(
        suffix=suffix,
    ) as temporary_file:
        temporary_file.write(content)
        temporary_file.flush()

        results = model.predict(
            source=temporary_file.name,
            conf=0.40,
            verbose=False,
        )

    detections = serialize_result(
        results[0]
    )

    return {
        "detections": detections,
        "count": len(detections),
    }
اجرای سرور:
uvicorn app:app --host 0.0.0.0 --port 8000در نسخه Production موارد زیر را نیز اضافه کنید:
- احراز هویت
- Rate Limit
- محدودیت ابعاد تصویر
- Timeout
- صف پردازش
- گزارش خطا
- مانیتورینگ GPU
- Batch Processing
- حذف Metadata غیرضروری
- ثبت نسخه مدل
Export مدل
مدل آموزشدیده را میتوان برای محیطهای مختلف صادر کرد.
خروجی ONNX
from ultralytics import YOLO

model = YOLO(
    "best.pt"
)

model.export(
    format="onnx",
    imgsz=640,
)
خط فرمان
yolo export model=best.pt format=onnx imgsz=640Ultralytics از فرمتهای مختلفی مانند ONNX، TensorRT و CoreML برای استقرار پشتیبانی میکند. فهرست دقیق فرمتها به نسخه نصبشده وابسته است.
انتخاب فرمت استقرار
| محیط | گزینه قابل بررسی |
|---|---|
| سرور پایتون | PyTorch |
| سرویس چندسکویی | ONNX |
| GPU انویدیا | TensorRT |
| دستگاه اپل | CoreML |
| موبایل و Edge | فرمتهای سبک سازگار |
| مرورگر | مدل سازگار با Runtime وب |
پس از Export باید کیفیت و سرعت مدل صادرشده دوباره ارزیابی شود.
Benchmark مدل
from ultralytics.utils.benchmarks import benchmark

benchmark(
    model="best.pt",
    data="data.yaml",
    imgsz=640,
    device=0,
)
Benchmark به مقایسه سرعت و کیفیت فرمتهای مختلف استقرار کمک میکند.
آزمایش نهایی را روی همان سختافزار Production انجام دهید.
YOLO یا مدل چندوجهی؟
YOLO و مدلهای چندوجهی کاربردهای متفاوتی دارند.
YOLO مناسبتر است اگر:
- کلاسها مشخص و ثابتاند.
- Bounding Box دقیق لازم است.
- پردازش بلادرنگ نیاز دارید.
- حجم درخواست زیاد است.
- مدل باید محلی اجرا شود.
- هزینه هر فریم اهمیت دارد.
- خروجی ساختاریافته ثابت میخواهید.
مدل چندوجهی مناسبتر است اگر:
- سؤالهای متنوع درباره تصویر دارید.
- توضیح متنی لازم است.
- کلاسها از قبل محدود نیستند.
- داده آموزشی کافی ندارید.
- میخواهید سریع نمونه اولیه بسازید.
- تحلیل معنایی و استدلال تصویری اهمیت دارد.
تحلیل تصویر با API درواره
برای آزمایش سریع یک کاربرد تصویری میتوانید از مدل چندوجهی موجود از طریق API درواره استفاده کنید.
آدرس پایه:
https://api.darvareh.ir/v1نصب:
pip install openaiمتغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_VISION_MODEL="YOUR_VISION_MODEL_ID"
نمونه کد:
import base64
import mimetypes
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)

MODEL_ID = os.environ[
    "DARVAREH_VISION_MODEL"
]


def to_data_url(
    image_path: str,
) -> str:
    path = Path(image_path)

    mime_type = (
        mimetypes.guess_type(
            path.name
        )[0]
        or "image/jpeg"
    )

    encoded = base64.b64encode(
        path.read_bytes()
    ).decode("utf-8")

    return (
        f"data:{mime_type};base64,"
        f"{encoded}"
    )


completion = client.chat.completions.create(
    model=MODEL_ID,
    temperature=0,
    messages=[
        {
            "role": "system",
            "content": (
                "تصویر را دقیق بررسی کن. "
                "اگر شواهد کافی نیست، "
                "عدم اطمینان را اعلام کن."
            ),
        },
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": (
                        "اشیای اصلی موجود در "
                        "این تصویر را فهرست کن."
                    ),
                },
                {
                    "type": "image_url",
                    "image_url": {
                        "url": to_data_url(
                            "image.jpg"
                        ),
                    },
                },
            ],
        },
    ],
)

print(
    completion.choices[0].message.content
)
پشتیبانی از تصویر به مدل انتخابشده بستگی دارد. شناسه مدل و ساختار ورودی فعلی را در مستندات بررسی کنید.
برای شروع به مستندات API درواره مراجعه کنید.
معماری ترکیبی YOLO و مدل چندوجهی
یک معماری کاربردی میتواند اینگونه باشد:
- YOLO اشیا را سریع پیدا میکند.
- تصویر یا Crop اشیای کماطمینان انتخاب میشود.
- مدل چندوجهی فقط موارد مبهم را تحلیل میکند.
- قوانین سمت سرور خروجی را اعتبارسنجی میکنند.
- موارد حساس برای بررسی انسانی نگه داشته میشوند.
- نتیجههای تأییدشده به دیتاست آینده اضافه میشوند.
این روش میتواند هزینه API را کاهش دهد و در عین حال برای موارد پیچیده تحلیل دقیقتری ارائه کند.
مانیتورینگ در Production
موارد مهم:
- تعداد تصویر پردازششده
- زمان متوسط Inference
- مصرف GPU
- نرخ خطا
- تعداد Detection هر کلاس
- میانگین Confidence
- نرخ خروجی خالی
- نرخ بررسی انسانی
- Precision نمونهبرداریشده
- تغییر توزیع کلاسها
- نسخه مدل
- نسخه ورودی و Preprocessing
افزایش ناگهانی خروجی خالی ممکن است نتیجه تغییر زاویه دوربین، نور، محصول یا خرابی ورودی باشد.
اشتباهات رایج
استفاده از تصاویر تکراری در Test
این کار نتیجه مدل را غیرواقعی میکند.
Annotation ضعیف
مدل از Labelهای ناقص یا ناسازگار الگوی اشتباه یاد میگیرد.
کلاسهای مبهم
اگر انسانها بر سر تعریف کلاس توافق نداشته باشند، مدل نیز خروجی باثباتی نخواهد داشت.
گزارش فقط mAP کلی
معیار هر کلاس و نمونههای خطادار باید بررسی شوند.
انتخاب مدل بزرگ بدون Benchmark
ممکن است کیفیت اندکی بهتر ولی سرعت بسیار پایینتر باشد.
Augmentation غیرواقعی
تغییرهای مصنوعی نامعتبر میتوانند کیفیت را کاهش دهند.
نادیدهگرفتن تصاویر منفی
مدل باید صحنههای بدون شیء هدف را نیز ببیند.
تنظیم آستانه روی Test Set
Confidence و IoU باید روی Validation تنظیم شوند.
انتظار Bounding Box دقیق از مدل چندوجهی عمومی
برای موقعیتیابی دقیق و بلادرنگ، مدل اختصاصی Detection معمولاً انتخاب مناسبتری است.
نادیدهگرفتن مجوز
مجوز کد، وزن مدل و دیتاست باید پیش از استفاده تجاری بررسی شود.
چکلیست پروژه YOLO
پیش از انتشار بررسی کنید:
- کلاسها تعریف واضح دارند.
- Annotationها بازبینی شدهاند.
- تصاویر تکراری حذف شدهاند.
- فریمهای یک ویدیو میان بخشها پخش نشدهاند.
- Test Set نماینده شرایط واقعی است.
- تصاویر بدون شیء هدف وجود دارند.
- کلاسهای کمنمونه شناسایی شدهاند.
- مدل سبک و سنگین مقایسه شدهاند.
- Precision، Recall و mAP هر کلاس گزارش شدهاند.
- سرعت روی سختافزار مقصد اندازهگیری شده است.
- Confidence روی Validation تنظیم شده است.
- بهترین Checkpoint استفاده میشود.
- خروجی Exportشده دوباره ارزیابی شده است.
- نسخه مدل و Dataset ثبت میشود.
- خروجی کماطمینان مسیر بازبینی دارد.
- عملکرد Production مانیتور میشود.
پرسشهای متداول
YOLO چیست؟
خانوادهای از مدلهای بینایی ماشین برای تشخیص سریع اشیا در تصویر و ویدیو است.
YOLO فقط برای تشخیص اشیا است؟
خیر. ابزارها و مدلهای جدید این اکوسیستم میتوانند وظایفی مانند Segmentation، Pose Estimation، Classification و Tracking را نیز انجام دهند.
آیا YOLO رایگان و متنباز است؟
کد و وزنهای مختلف با مجوزهای مشخص منتشر میشوند. شرایط مجوز ممکن است بر اساس پروژه و نسخه متفاوت باشد و باید پیش از استفاده تجاری بررسی شود.
آیا YOLO بدون GPU اجرا میشود؟
بله، اما سرعت CPU به اندازه مدل، رزولوشن تصویر و سختافزار بستگی دارد. برای پردازش بلادرنگ معمولاً GPU یا شتابدهنده مناسب لازم است.
برای آموزش YOLO چند تصویر لازم است؟
عدد ثابتی وجود ندارد. تعداد کلاسها، تنوع صحنه، اندازه اشیا، کیفیت Annotation و شباهت تصاویر بر مقدار داده موردنیاز اثر دارند.
آیا میتوان YOLO را روی ویدیو اجرا کرد؟
بله. مدل میتواند فریمهای ویدیو، وبکم و جریان زنده را پردازش کند.
تفاوت Detection و Tracking چیست؟
Detection در هر فریم اشیا را پیدا میکند. Tracking تلاش میکند همان اشیا را در فریمهای بعدی با شناسه ثابت دنبال کند.
mAP چیست؟
معیاری برای سنجش کیفیت کلی تشخیص و موقعیتیابی اشیا در کلاسها و آستانههای مختلف است.
YOLO بهتر است یا مدل چندوجهی؟
برای Bounding Box دقیق، کلاسهای ثابت و پردازش سریع، YOLO مناسبتر است. برای سؤالهای متنوع و توضیح معنایی تصویر، مدل چندوجهی کاربرد بیشتری دارد.
آیا میتوان YOLO و API هوش مصنوعی را ترکیب کرد؟
بله. YOLO میتواند تشخیص سریع اولیه را انجام دهد و مدل چندوجهی فقط موارد مبهم یا نیازمند توضیح را تحلیل کند.
جمعبندی
YOLO یکی از محبوبترین گزینهها برای تشخیص اشیا در تصویر و ویدیو است. این مدل میتواند چند شیء را همزمان پیدا کند، کلاس آنها را مشخص کند و Bounding Box ارائه دهد.
برای اجرای موفق پروژه:
- مسئله و کلاسها را دقیق تعریف کنید.
- تصاویر واقعی و متنوع جمعآوری کنید.
- Annotationها را بازبینی کنید.
- داده را بدون نشت تقسیم کنید.
- ابتدا یک مدل سبک و وزن آماده را آزمایش کنید.
- معیار هر کلاس را جداگانه بررسی کنید.
- Confidence و IoU را روی Validation تنظیم کنید.
- مدل را روی سختافزار مقصد Benchmark کنید.
- نسخه Exportشده را دوباره ارزیابی کنید.
- عملکرد Production را پایش کنید.
- برای موارد مبهم، بازبینی انسانی در نظر بگیرید.
- مدل اختصاصی YOLO را با API مدلهای چندوجهی مقایسه کنید.
اگر هنوز داده برچسبخورده کافی ندارید یا میخواهید ایده خود را سریع آزمایش کنید، میتوانید ابتدا مدلهای چندوجهی را از طریق API یکپارچه درواره روی تصاویر واقعی پروژه مقایسه کنید.
مقالات مرتبط
- بینایی ماشین چیست؟
- آموزش OpenCV با پایتون
- Transfer Learning چیست؟
- آموزش PyTorch با پایتون
- شبکه عصبی چیست؟
- یادگیری عمیق چیست؟
- ماتریس درهمریختگی و معیارهای ارزیابی
- داده نامتوازن و SMOTE
- API بینایی و ورودی تصویر
منابع
- Ultralytics: Object Detection
- Ultralytics: Train Mode
- Ultralytics: Predict Mode
- Ultralytics: Validation Mode
- Ultralytics: Export Mode
- Ultralytics: Python Usage
- PyTorch: Object Detection Fine-tuning
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



