
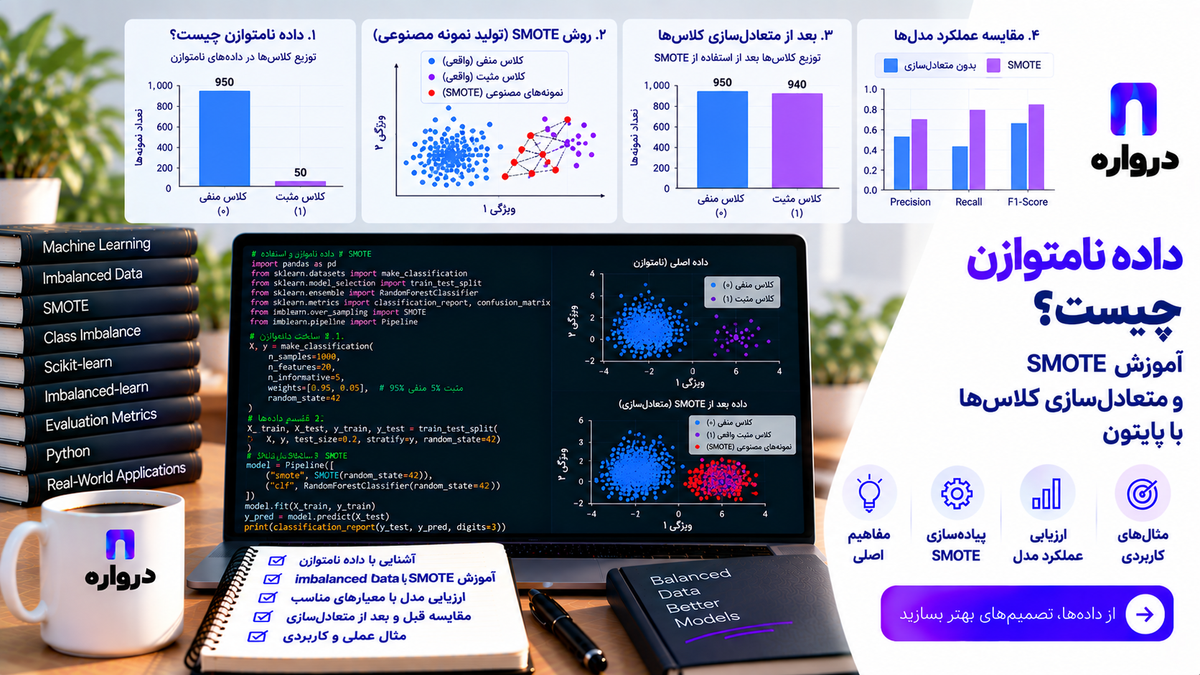
داده نامتوازن چیست؟ آموزش SMOTE و متعادلسازی کلاسها با پایتون
در داده نامتوازن، تعداد نمونههای یک کلاس بسیار کمتر از سایر کلاسها است. در این راهنما SMOTE، Class Weight، Oversampling و معیارهای صحیح ارزیابی را با پایتون یاد میگیرید.

فرض کنید مدلی برای شناسایی پیامهای فوری پشتیبانی ساختهاید. از میان ۱۰ هزار پیام ثبتشده، فقط ۲۰۰ پیام واقعاً فوریاند.
مدلی که تمام پیامها را «عادی» اعلام کند، Accuracy بسیار بالایی به دست میآورد؛ اما حتی یک درخواست فوری را پیدا نمیکند. بنابراین عدد دقت بهتنهایی تصویر کاملاً گمراهکنندهای ارائه میدهد.
این مسئله با عنوان داده نامتوازن، دیتاست نامتوازن یا Imbalanced Dataset شناخته میشود.
داده نامتوازن در بسیاری از پروژههای واقعی دیده میشود:
- تشخیص پیام فوری
- پیشبینی لغو اشتراک
- شناسایی خرابی تجهیزات
- تشخیص محصول معیوب
- دستهبندی تیکتهای کمتکرار
- شناسایی دیدگاههای نیازمند بازبینی
- پیشبینی پاسخندادن مشتری
- تشخیص رخدادهای نادر عملیاتی
در این مقاله میآموزید:
- داده نامتوازن چیست؟
- چرا Accuracy در این دادهها کافی نیست؟
- چه معیارهایی باید استفاده شوند؟
- Class Weight چیست؟
- Oversampling و Undersampling چه تفاوتی دارند؟
- SMOTE چگونه کار میکند؟
- SMOTENC، BorderlineSMOTE و ADASYN چه کاربردی دارند؟
- چگونه از نشت داده هنگام استفاده از SMOTE جلوگیری کنیم؟
- چگونه آستانه تصمیم را تنظیم کنیم؟
- آیا میتوان از مدلهای زبانی برای تولید نمونههای کلاس اقلیت استفاده کرد؟
داده نامتوازن چیست؟
یک مسئله طبقهبندی زمانی نامتوازن است که تعداد نمونههای یک یا چند کلاس بهشکل قابل توجهی کمتر از سایر کلاسها باشد.
برای مثال:
| کلاس | تعداد نمونه | سهم تقریبی |
|---|---|---|
| پیام عادی | ۹۸۰۰ | ۹۸ درصد |
| پیام فوری | ۲۰۰ | ۲ درصد |
کلاس دارای نمونه بیشتر، کلاس اکثریت و کلاس دارای نمونه کمتر، کلاس اقلیت نامیده میشود.
نامتوازنبودن فقط به مسائل دودویی محدود نیست. در طبقهبندی چندکلاسه نیز ممکن است یک یا چند دسته بسیار کمتر از سایر دستهها نمونه داشته باشند. مستندات گوگل نیز Imbalance را برای مسائل دودویی و چندکلاسه مطرح میکند.
آیا هر اختلافی میان کلاسها مشکل است؟
خیر. یک دیتاست لازم نیست دقیقاً بهطور مساوی میان کلاسها تقسیم شده باشد.
برای مثال، نسبت ۵۵ به ۴۵ معمولاً مشکل جدی ایجاد نمیکند. حتی نسبت ۷۰ به ۳۰ نیز بسته به اندازه داده، الگوریتم، کیفیت ویژگیها و هزینه خطا ممکن است قابل مدیریت باشد.
نامتوازنبودن زمانی به مسئله تبدیل میشود که:
- مدل کلاس اقلیت را نادیده بگیرد.
- نمونههای اقلیت برای یادگیری کافی نباشند.
- Accuracy بالا ولی Recall کلاس مهم بسیار پایین باشد.
- Foldهای اعتبارسنجی نمونه کافی از کلاس اقلیت نداشته باشند.
- تصمیم مدل بهشدت به سمت کلاس اکثریت متمایل شود.
- کلاس اقلیت از نظر کسبوکار اهمیت زیادی داشته باشد.
گوگل توضیح میدهد که در نامتوازنبودن شدید، ممکن است تعداد نمونههای کلاس اقلیت برای آموزش مناسب مدل کافی نباشد.
چرا Accuracy در داده نامتوازن گمراهکننده است؟
فرض کنید دیتاست شامل ۹۹۰ پیام عادی و ۱۰ پیام فوری است.
مدلی که بدون بررسی محتوا تمام پیامها را عادی اعلام کند:
- ۹۹۰ پیشبینی درست دارد.
- فقط ۱۰ پیشبینی اشتباه دارد.
- Accuracy آن ظاهراً ۹۹ درصد است.
- Recall پیام فوری آن صفر است.
این مدل از نظر عملی هیچ ارزشی برای تشخیص فوریت ندارد.
بنابراین باید عملکرد کلاس اقلیت را با معیارهای دیگری بررسی کرد.
معیارهای مناسب برای داده نامتوازن
Precision
Precision نشان میدهد از میان مواردی که مدل مثبت اعلام کرده، چه سهمی واقعاً مثبت بودهاند.
اگر Precision پایین باشد، مدل هشدارهای اشتباه زیادی تولید میکند.
Recall
Recall نشان میدهد مدل چه سهمی از نمونههای مثبت واقعی را پیدا کرده است.
اگر هدف ازدستندادن پیامهای فوری باشد، Recall اهمیت زیادی دارد.
F1 Score
F1 تعادلی میان Precision و Recall ایجاد میکند. این معیار برای مقایسه مدلها مفید است، اما باید Precision و Recall را نیز جداگانه بررسی کرد.
Macro F1
در طبقهبندی چندکلاسه، ابتدا F1 هر کلاس جداگانه محاسبه و سپس به همه کلاسها وزن برابر داده میشود.
Macro F1 ضعف مدل روی کلاسهای کوچک را بهتر از Weighted F1 نشان میدهد.
Balanced Accuracy
این معیار عملکرد کلاسها را متعادلتر از Accuracy معمولی در نظر میگیرد.
Average Precision و PR-AUC
منحنی Precision-Recall برای بررسی تعادل Precision و Recall در آستانههای مختلف مفید است.
در دادههای نامتوازن، Precision-Recall Curve معمولاً اطلاعات کاربردیتری درباره کلاس اقلیت نسبت به ROC Curve ارائه میکند.
Confusion Matrix
ماتریس درهمریختگی تعداد موارد زیر را نشان میدهد:
- تشخیص درست کلاس مثبت
- ازدسترفتن کلاس مثبت
- هشدار اشتباه
- تشخیص درست کلاس منفی
برای مطالعه بیشتر میتوانید مقاله ماتریس درهمریختگی و معیارهای Precision، Recall و F1 را ببینید.
قبل از متعادلسازی، یک Baseline بسازید
پیش از استفاده از SMOTE یا روشهای دیگر، یک مدل پایه بسازید.
Baseline کمک میکند بفهمید روش جدید واقعاً کیفیت را بهتر کرده است یا فقط تعداد پیشبینیهای مثبت را افزایش داده است.
from sklearn.dummy import DummyClassifier
from sklearn.metrics import classification_report

baseline = DummyClassifier(
    strategy="most_frequent",
)

baseline.fit(
    X_train,
    y_train,
)

baseline_prediction = baseline.predict(
    X_test,
)

print(
    classification_report(
        y_test,
        baseline_prediction,
        zero_division=0,
    )
)
مدل most_frequent همیشه کلاس پرتکرار را پیشبینی میکند. هر مدل واقعی باید بهشکل معناداری از این Baseline بهتر باشد.
ساخت دیتاست نامتوازن نمونه
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split

X, y = make_classification(
    n_samples=5000,
    n_features=20,
    n_informative=8,
    n_redundant=4,
    n_clusters_per_class=2,
    weights=[0.95, 0.05],
    class_sep=1.0,
    random_state=42,
)

X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.20,
        random_state=42,
        stratify=y,
    )
)
استفاده از stratify=y کمک میکند نسبت کلاسها در Training و Test تقریباً حفظ شود.
ارزیابی مدل معمولی
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
from sklearn.metrics import confusion_matrix

model = LogisticRegression(
    max_iter=1000,
)

model.fit(
    X_train,
    y_train,
)

prediction = model.predict(
    X_test,
)

print(
    confusion_matrix(
        y_test,
        prediction,
    )
)

print(
    classification_report(
        y_test,
        prediction,
        zero_division=0,
    )
)بهجای تمرکز روی Accuracy، این موارد را بررسی کنید:
- Recall کلاس اقلیت
- Precision کلاس اقلیت
- F1 کلاس اقلیت
- Macro F1
- تعداد False Negative
- تعداد False Positive
روشهای مدیریت داده نامتوازن
راهکارهای اصلی را میتوان در چند گروه قرار داد:
- جمعآوری داده بیشتر برای کلاس اقلیت
- اصلاح کیفیت Labelها
- استفاده از Class Weight
- Oversampling
- Undersampling
- ترکیب Oversampling و پاکسازی
- تنظیم آستانه تصمیم
- انتخاب الگوریتم مناسب
- تبدیل مسئله به تشخیص ناهنجاری
- استفاده از داده مصنوعی کنترلشده
هیچ روشی همیشه بهترین نیست. باید گزینهها را روی داده واقعی و با Cross-validation مقایسه کرد.
جمعآوری داده بیشتر
بهترین راهکار در بسیاری از پروژهها جمعآوری نمونه واقعی بیشتر از کلاس اقلیت است.
برای مثال:
- پیامهای فوری قدیمی را بازیابی کنید.
- بازخورد کارشناسان را ثبت کنید.
- نمونههای اشتباه مدل را برای برچسبگذاری ارسال کنید.
- دستههای کمتکرار را هدفمند نمونهبرداری کنید.
- Active Learning را برای انتخاب نمونههای مبهم به کار ببرید.
- تعریف Label را شفافتر کنید.
داده واقعی معمولاً اطلاعاتی دارد که روشهای مصنوعی نمیتوانند کامل بازسازی کنند.
بررسی کیفیت برچسبها
پیش از متعادلسازی مطمئن شوید Labelها معتبرند.
کلاس اقلیت معمولاً نمونه کمتری دارد؛ بنابراین چند برچسب اشتباه میتواند اثر بزرگی روی مدل بگذارد.
موارد مهم:
- تعریف روشن کلاسها
- بازبینی نمونههای مرزی
- اندازهگیری توافق برچسبگذاران
- بررسی داده تکراری
- اصلاح Labelهای قدیمی
- ثبت دلیل برچسب
- تفکیک «نامشخص» از کلاس واقعی
اگر مشکل اصلی کیفیت Label باشد، SMOTE فقط نسخههای مصنوعی بیشتری از همان مشکل ایجاد میکند.
Class Weight چیست؟
با Class Weight میتوان خطای کلاس اقلیت را هنگام آموزش مهمتر در نظر گرفت، بدون اینکه نمونه جدیدی ساخته شود.
بسیاری از الگوریتمهای Scikit-learn از class_weight پشتیبانی میکنند:
weighted_model = LogisticRegression(
    class_weight="balanced",
    max_iter=1000,
)

weighted_model.fit(
    X_train,
    y_train,
)

weighted_prediction = weighted_model.predict(
    X_test,
)

print(
    classification_report(
        y_test,
        weighted_prediction,
        zero_division=0,
    )
)
مزایای Class Weight:
- پیادهسازی ساده
- عدم تولید نمونه مصنوعی
- مناسب بهعنوان اولین آزمایش
- حفظ تمام دادههای اصلی
- قابل استفاده داخل Cross-validation
محدودیتها:
- ممکن است False Positive افزایش پیدا کند.
- همه الگوریتمها از آن پشتیبانی نمیکنند.
- مقدار
balancedلزوماً بهترین وزن کسبوکار نیست. - برای کلاس بسیار کمنمونه، اطلاعات جدیدی ایجاد نمیکند.
بهتر است مدل بدون وزن، مدل با وزن خودکار و چند وزن سفارشی را با معیار یکسان مقایسه کنید.
وزن سفارشی کلاسها
weighted_model = LogisticRegression(
    class_weight={
        0: 1,
        1: 6,
    },
    max_iter=1000,
)
وزن مناسب باید بر اساس این موارد انتخاب شود:
- هزینه False Negative
- هزینه False Positive
- توزیع واقعی کلاسها
- ظرفیت تیم بررسی انسانی
- هدف Precision یا Recall
- نتیجه Cross-validation
نباید فقط بهدلیل نسبت ۱ به ۲۰ داده، وزن کلاس را دقیقاً ۲۰ تعیین کرد. بهترین مقدار باید آزمایش شود.
Oversampling چیست؟
در Oversampling تعداد نمونههای کلاس اقلیت در مجموعه آموزش افزایش پیدا میکند.
روشهای رایج:
- Random Oversampling
- SMOTE
- BorderlineSMOTE
- ADASYN
- تولید نمونه با روشهای دامنهمحور
Oversampling فقط باید روی Training Set انجام شود. Validation و Test باید توزیع واقعی را حفظ کنند.
Random Oversampling
در این روش نمونههای کلاس اقلیت تکرار میشوند.
pip install imbalanced-learnfrom imblearn.over_sampling import RandomOverSampler
sampler = RandomOverSampler(
random_state=42,
)
X_resampled, y_resampled = (
sampler.fit_resample(
X_train,
y_train,
)
)
print(
"Before:",
y_train.value_counts()
if hasattr(y_train, "value_counts")
else None,
)
print(
"After:",
y_resampled
)مزایا:
- ساده
- بدون ساخت ترکیبهای جدید
- قابل استفاده برای انواع مختلف ویژگی
- مناسب بهعنوان Baseline
محدودیت:
- تکرار نمونهها میتواند باعث بیشبرازش شود.
مستندات imbalanced-learn نیز Random Oversampling را روشی برای تکرار نمونههای کلاس اقلیت و کاهش گرایش مرز تصمیم به سمت کلاس اکثریت معرفی میکند.
SMOTE چیست؟
SMOTE مخفف Synthetic Minority Over-sampling Technique است.
این روش بهجای تکرار دقیق نمونههای اقلیت، نمونههای مصنوعی جدیدی میان نمونههای نزدیک کلاس اقلیت ایجاد میکند.
ایده کلی SMOTE:
- یک نمونه از کلاس اقلیت انتخاب میشود.
- همسایههای نزدیک آن در کلاس اقلیت پیدا میشوند.
- یکی از همسایهها انتخاب میشود.
- نمونه مصنوعی در فاصله میان آن دو ساخته میشود.
کلاس SMOTE در کتابخانه imbalanced-learn همین روش Oversampling مصنوعی را پیادهسازی میکند.
اجرای SMOTE
from imblearn.over_sampling import SMOTE

smote = SMOTE(
    sampling_strategy="auto",
    random_state=42,
    k_neighbors=5,
)

X_resampled, y_resampled = (
    smote.fit_resample(
        X_train,
        y_train,
    )
)

model = LogisticRegression(
    max_iter=1000,
)

model.fit(
    X_resampled,
    y_resampled,
)

prediction = model.predict(
    X_test,
)

print(
    classification_report(
        y_test,
        prediction,
        zero_division=0,
    )
)
پارامترهای مهم:
sampling_strategy: مقدار متعادلسازیrandom_state: تکرارپذیریk_neighbors: تعداد همسایههای مورد استفاده
متعادلکردن کامل تا نسبت مساوی همیشه بهترین انتخاب نیست. نسبتهای مختلف را آزمایش کنید.
اشتباه بزرگ: اجرای SMOTE قبل از Train/Test Split
کد زیر اشتباه است:
X_resampled, y_resampled = smote.fit_resample(
    X,
    y,
)

X_train, X_test, y_train, y_test = (
    train_test_split(
        X_resampled,
        y_resampled,
    )
)
در این حالت، SMOTE با مشاهده کل داده نمونه مصنوعی میسازد. اطلاعات Test Set به فرایند Resampling وارد میشود و نتیجه ارزیابی خوشبینانه خواهد بود.
روش صحیح:
- ابتدا داده را تقسیم کنید.
- SMOTE را فقط روی Training اجرا کنید.
- Validation و Test را دستنخورده نگه دارید.
اجرای صحیح SMOTE با Pipeline
برای Cross-validation باید از Pipeline کتابخانه imbalanced-learn استفاده کنید:
from imblearn.over_sampling import SMOTE
from imblearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler

pipeline = Pipeline(
    steps=[
        (
            "scaler",
            StandardScaler(),
        ),
        (
            "smote",
            SMOTE(
                random_state=42,
            ),
        ),
        (
            "classifier",
            LogisticRegression(
                max_iter=1000,
            ),
        ),
    ]
)
این Pipeline در هر Fold:
- Transformer را فقط روی بخش آموزش Fit میکند.
- SMOTE را فقط روی بخش آموزش اجرا میکند.
- مدل را روی داده Resampleشده آموزش میدهد.
- Fold اعتبارسنجی را با توزیع اصلی ارزیابی میکند.
Pipeline کتابخانه imbalanced-learn برای اجرای متوالی تبدیلها، Resampling و مدل نهایی طراحی شده است.
Cross-validation صحیح با SMOTE
from sklearn.model_selection import StratifiedKFold
from sklearn.model_selection import cross_validate

cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

results = cross_validate(
    pipeline,
    X,
    y,
    cv=cv,
    scoring={
        "precision": "precision",
        "recall": "recall",
        "f1": "f1",
        "average_precision": "average_precision",
        "balanced_accuracy": "balanced_accuracy",
    },
    return_train_score=True,
    n_jobs=-1,
)

for metric in [
    "precision",
    "recall",
    "f1",
    "average_precision",
    "balanced_accuracy",
]:
    print(
        metric,
        results[f"test_{metric}"].mean(),
    )
برای داده نامتوازن، StratifiedKFold معمولاً انتخاب مناسبتری است؛ زیرا نسبت کلاسها را در Foldها حفظ میکند.
تنظیم پارامترهای SMOTE
میتوان مقدار Oversampling و تعداد همسایهها را همراه با مدل تنظیم کرد:
from sklearn.model_selection import GridSearchCV

parameters = {
    "smote__sampling_strategy": [
        0.25,
        0.50,
        0.75,
        1.0,
    ],
    "smote__k_neighbors": [
        3,
        5,
        7,
    ],
    "classifier__C": [
        0.1,
        1,
        10,
    ],
}

search = GridSearchCV(
    estimator=pipeline,
    param_grid=parameters,
    scoring="average_precision",
    cv=cv,
    n_jobs=-1,
)

search.fit(
    X_train,
    y_train,
)

print(search.best_params_)
print(search.best_score_)
پس از انتخاب تنظیمات، مدل باید روی Test Set مستقلی ارزیابی شود.
SMOTE چه محدودیتهایی دارد؟
SMOTE راهحل جادویی نیست.
تولید نمونه در ناحیه نامناسب
اگر کلاسها همپوشانی زیادی داشته باشند، نمونه مصنوعی ممکن است نزدیک یا داخل ناحیه کلاس اکثریت ساخته شود.
تقویت نویز
اگر یک نمونه اقلیت اشتباه یا پرت باشد، SMOTE میتواند نمونههای مصنوعی بیشتری اطراف آن ایجاد کند.
مشکل در ویژگی دستهای
SMOTE معمولی برای ویژگیهای عددی پیوسته طراحی شده است. در داده دستهای نمیتوان میان دو مقدار اسمی، مقدار میانی معناداری ساخت.
مشکل در فضای پربعد
در دادههای دارای هزاران ویژگی، مفهوم همسایگی میتواند ضعیف شود.
ایجاد توزیع غیرواقعی
نمونههای ساختهشده الزاماً معادل نمونه واقعی کسبوکار نیستند.
افزایش هزینه آموزش
تعداد نمونه بیشتر میتواند زمان و حافظه بیشتری مصرف کند.
SMOTENC برای داده ترکیبی
اگر دیتاست شامل ویژگی عددی و دستهای است، میتوان از SMOTENC استفاده کرد.
from imblearn.over_sampling import SMOTENC

categorical_columns = [
    0,
    2,
    5,
]

sampler = SMOTENC(
    categorical_features=categorical_columns,
    random_state=42,
)
SMOTENC برای داده دارای ویژگیهای اسمی و پیوسته طراحی شده است.
ترتیب مراحل پیشپردازش و Resampling باید با دقت طراحی شود. One-Hot Encoding پیش از SMOTE معمولی ممکن است نمونههایی با ترکیبهای غیرواقعی ایجاد کند.
BorderlineSMOTE چیست؟
BorderlineSMOTE روی نمونههای اقلیتی تمرکز میکند که نزدیک مرز تصمیم یا در ناحیه دشوار قرار دارند.
from imblearn.over_sampling import BorderlineSMOTE

sampler = BorderlineSMOTE(
    random_state=42,
    k_neighbors=5,
)
این روش تلاش میکند نمونههای مصنوعی را بیشتر در نواحی مرزی بسازد.
BorderlineSMOTE نیز باید با Cross-validation و در مقایسه با Baseline ارزیابی شود.
ADASYN چیست؟
ADASYN مانند SMOTE نمونه مصنوعی میسازد، اما توجه بیشتری به نمونههایی دارد که یادگیری آنها دشوارتر است.
from imblearn.over_sampling import ADASYN

sampler = ADASYN(
    random_state=42,
)
این تمرکز روی نواحی دشوار ممکن است مفید باشد، اما اگر نمونههای دشوار در واقع نویز یا Label اشتباه باشند، نتیجه میتواند ضعیفتر شود.
Undersampling چیست؟
در Undersampling بخشی از نمونههای کلاس اکثریت حذف میشوند.
from imblearn.under_sampling import RandomUnderSampler

sampler = RandomUnderSampler(
    sampling_strategy=0.5,
    random_state=42,
)

X_resampled, y_resampled = (
    sampler.fit_resample(
        X_train,
        y_train,
    )
)
مزایا:
- کاهش زمان آموزش
- کاهش حجم داده
- مفید برای دیتاست بسیار بزرگ
- کاهش غلبه کلاس اکثریت
معایب:
- از دست رفتن اطلاعات
- حذف نمونههای مهم یا مرزی
- کاهش تنوع کلاس اکثریت
Undersampling زمانی مناسبتر است که کلاس اکثریت نمونههای بسیار زیاد و تکراری داشته باشد.
ترکیب Over و Under-sampling
روشهایی مانند SMOTEENN و SMOTETomek ابتدا نمونههای اقلیت را افزایش میدهند و سپس نقاط مبهم یا مرزی را پاکسازی میکنند.
SMOTEENN
from imblearn.combine import SMOTEENN

sampler = SMOTEENN(
    random_state=42,
)
SMOTEENN، SMOTE را با Edited Nearest Neighbours ترکیب میکند.
SMOTETomek
from imblearn.combine import SMOTETomek

sampler = SMOTETomek(
    random_state=42,
)
این روش SMOTE را با پاکسازی Tomek Links ترکیب میکند.
این روشها ممکن است مرز کلاسها را تمیزتر کنند، اما باید اثر حذف نمونهها بررسی شود.
تنظیم آستانه تصمیم
بسیاری از مدلها بهصورت پیشفرض از آستانه ۰٫۵ استفاده میکنند. این مقدار لزوماً با هزینه واقعی خطاها هماهنگ نیست.
positive_probability = (
    model.predict_proba(X_validation)[:, 1]
)

threshold = 0.35

validation_prediction = (
    positive_probability >= threshold
).astype(int)
کاهش آستانه معمولاً:
- Recall را افزایش میدهد.
- تعداد False Negative را کاهش میدهد.
- ممکن است Precision را کاهش دهد.
- تعداد هشدارها را افزایش میدهد.
آستانه باید روی Validation Set انتخاب شود، نه Test Set.
انتخاب آستانه با Precision-Recall Curve
import numpy as np

from sklearn.metrics import precision_recall_curve

probability = pipeline.predict_proba(
    X_validation
)[:, 1]

precision, recall, thresholds = (
    precision_recall_curve(
        y_validation,
        probability,
    )
)

candidate_rows = []

for index, threshold in enumerate(
    thresholds
):
    candidate_rows.append(
        {
            "threshold": threshold,
            "precision": precision[index],
            "recall": recall[index],
        }
    )

acceptable = [
    row
    for row in candidate_rows
    if row["precision"] >= 0.70
]

if acceptable:
    selected = max(
        acceptable,
        key=lambda row: row["recall"],
    )

    print(selected)
در این مثال آستانهای انتخاب میشود که حداقل Precision موردنیاز را حفظ کند و در میان گزینهها Recall بیشتری داشته باشد.
حداقل قابل قبول باید بر اساس فرایند واقعی کسبوکار تعیین شود.
مقایسه روشها بهشکل منصفانه
حداقل این گزینهها را مقایسه کنید:
- مدل پایه بدون تغییر
- Class Weight
- Random Oversampling
- SMOTE
- Undersampling
- روش ترکیبی
- تنظیم آستانه
- الگوریتم جایگزین
نمونه جدول:
| روش | Precision | Recall | F1 | Average Precision | زمان آموزش |
|---|---|---|---|---|---|
| مدل پایه | ۰٫۸۲ | ۰٫۴۶ | ۰٫۵۹ | ۰٫۶۱ | ۱ ثانیه |
| Class Weight | ۰٫۵۹ | ۰٫۷۸ | ۰٫۶۷ | ۰٫۶۵ | ۱ ثانیه |
| SMOTE | ۰٫۶۲ | ۰٫۷۵ | ۰٫۶۸ | ۰٫۶۷ | ۲ ثانیه |
| Undersampling | ۰٫۴۹ | ۰٫۸۱ | ۰٫۶۱ | ۰٫۵۸ | ۰٫۵ ثانیه |
بهترین انتخاب فقط بالاترین Recall نیست. اگر تیم توان بررسی تعداد زیاد هشدار را نداشته باشد، Precision پایین میتواند سیستم را غیرقابل استفاده کند.
حفظ توزیع واقعی در Validation و Test
Validation و Test نباید برای افزایش تعداد کلاس اقلیت مصنوعی متعادل شوند.
هدف ارزیابی این است که مدل در شرایط واقعی آزمایش شود. اگر در Production فقط ۲ درصد پیامها فوریاند، Test Set نیز باید تا حد امکان همین توزیع را بازتاب دهد.
متعادلکردن Test Set میتواند:
- Precision را غیرواقعی نشان دهد.
- تعداد هشدار واقعی را پنهان کند.
- ظرفیت عملیاتی موردنیاز را اشتباه برآورد کند.
- انتخاب آستانه را منحرف کند.
Resampling فقط روی بخش آموزش انجام میشود.
داده نامتوازن چندکلاسه
در مسئله چندکلاسه ممکن است چنین توزیعی داشته باشیم:
| کلاس | نمونه |
|---|---|
| فنی | ۸۰۰۰ |
| فروش | ۳۰۰۰ |
| مالی | ۱۲۰۰ |
| لغو اشتراک | ۱۸۰ |
| پیشنهاد محصول | ۱۰۰ |
در این حالت:
- معیار هر کلاس را جداگانه بررسی کنید.
- Macro F1 را گزارش دهید.
- از StratifiedKFold استفاده کنید.
- برای هر کلاس حداقل نمونه کافی داشته باشید.
- کلاسهای بسیار مبهم را بازتعریف کنید.
sampling_strategyرا برای کلاسهای هدف تنظیم کنید.
smote = SMOTE(
    sampling_strategy={
        "cancel": 800,
        "feedback": 800,
    },
    random_state=42,
)
افزایش تمام کلاسها تا اندازه بزرگترین کلاس همیشه ضروری نیست.
داده نامتوازن در متن فارسی
استفاده مستقیم از SMOTE روی ماتریس TF-IDF به بررسی دقیق نیاز دارد. بردار مصنوعی ممکن است معادل یک متن واقعی و قابل تفسیر نباشد.
گزینههای مناسبتر برای طبقهبندی متن میتوانند شامل این موارد باشند:
- Class Weight
- Random Oversampling متنهای واقعی
- جمعآوری پیامهای واقعی بیشتر
- Augmentation کنترلشده
- Embedding و طبقهبند وزندار
- مدل زبانی Few-shot
- تنظیم آستانه
- تحلیل نمونههای دشوار
اگر SMOTE روی Embedding اجرا میشود، باید نتیجه آن با روشهای سادهتر مقایسه شود.
استفاده از مدل زبانی برای تولید داده اقلیت
یک مدل زبانی میتواند برای ساخت نمونههای پیشنهادی کلاس کمتعداد استفاده شود. برای مثال، میتوان پیامهای متنوع مربوط به «لغو اشتراک» تولید کرد.
اما داده تولیدشده باید:
- توسط انسان بازبینی شود.
- از نمونههای Test جدا باشد.
- صرفاً بازنویسی چند نمونه محدود نباشد.
- تنوع زبانی واقعی داشته باشد.
- شامل سناریوهای ساختگی غیرممکن نباشد.
- با تعریف کلاس هماهنگ باشد.
- بهصورت جداگانه نسخهبندی شود.
تولید نمونه پیشنهادی با API درواره
API درواره با ساختار سازگار با OpenAI امکان استفاده از مدلهای مختلف را با یک اتصال فراهم میکند.
آدرس پایه:
https://api.darvareh.ir/v1نصب کتابخانهها:
pip install openai pydanticمتغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
نمونه کد:
import os
from openai import OpenAI
from pydantic import BaseModel
from pydantic import Field
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
MODEL_ID = os.environ["DARVAREH_MODEL"]
class GeneratedExamples(BaseModel):
examples: list[str] = Field(
min_length=1,
max_length=20,
)
def generate_candidate_examples(
category: str,
count: int = 10,
) -> list[str]:
completion = client.chat.completions.create(
model=MODEL_ID,
temperature=0.7,
messages=[
{
"role": "system",
"content": (
"برای توسعه دیتاست، نمونههای فارسی "
"متنوع و طبیعی تولید کن. خروجی فقط "
"JSON معتبر باشد. اطلاعات شخصی، نام "
"واقعی یا داده حساس تولید نکن."
),
},
{
"role": "user",
"content": (
f"برای دسته «{category}» تعداد "
f"{count} پیام کوتاه و متنوع مشتری "
"تولید کن. پیامها نباید بازنویسی "
"نزدیک یکدیگر باشند."
),
},
],
)
content = completion.choices[0].message.content
if not content:
raise ValueError(
"پاسخ خالی از مدل دریافت شد."
)
result = GeneratedExamples.model_validate_json(
content
)
return result.examplesشناسه مدل را از فهرست فعلی مدلهای درواره انتخاب کنید.
این خروجی نباید بدون بازبینی مستقیماً وارد دیتاست آموزش شود. همچنین نمونه مصنوعی نباید وارد Validation یا Test Set شود.
برای شروع میتوانید مستندات API درواره را مطالعه کنید.
ارزیابی کیفیت داده مصنوعی
برای نمونههای تولیدشده این موارد را بررسی کنید:
- صحت Label
- طبیعیبودن متن
- شباهت زیاد به نمونههای موجود
- تنوع طول و لحن
- پوشش اصطلاحات واقعی کاربران
- وجود تناقض
- ورود ناخواسته اطلاعات حساس
- توزیع واژگان
- اثر واقعی روی Test Set
- عملکرد روی داده کاملاً واقعی
بهبود Training Score بدون بهبود Test Score واقعی، نشانه موفقیت نیست.
چه زمانی از Anomaly Detection استفاده کنیم؟
اگر کلاس مثبت بسیار نادر است و نمونه برچسبخورده کافی ندارید، میتوان مسئله را بهصورت تشخیص ناهنجاری بررسی کرد.
روشهای احتمالی:
- Isolation Forest
- One-Class SVM
- Local Outlier Factor
- Autoencoder
این روشها فرض میکنند نمونههای نادر نسبت به رفتار معمول متفاوتاند. اگر کلاس اقلیت از نظر ویژگیها شباهت زیادی به کلاس عادی داشته باشد، Anomaly Detection نیز ممکن است مناسب نباشد.
پایش مدل پس از انتشار
نسبت کلاسها در Production ممکن است تغییر کند.
موارد قابل مانیتور:
- نرخ پیشبینی کلاس مثبت
- Precision بر اساس نمونههای بازبینیشده
- Recall تخمینی
- تعداد هشدار روزانه
- سهم هر کلاس
- نرخ ارجاع به انسان
- توزیع Probability
- کیفیت داده ورودی
- تغییر Featureها
- اختلاف میان نسخههای مدل
- زمان و هزینه پردازش
اگر نسبت واقعی کلاس مثبت تغییر کند، Precision نیز ممکن است تغییر کند؛ حتی اگر رفتار پایه مدل ثابت مانده باشد.
اشتباهات رایج
تکیه بر Accuracy
Accuracy بالا لزوماً به معنی شناسایی کلاس اقلیت نیست.
اجرای SMOTE پیش از تقسیم داده
این کار باعث Data Leakage میشود.
متعادلکردن Test Set
Test Set باید توزیع واقعی Production را نمایش دهد.
استفاده از SMOTE برای داده دستهای خام
برای داده ترکیبی باید روش مناسب مانند SMOTENC بررسی شود.
متعادلسازی کامل بدون آزمایش
نسبت مساوی همیشه بهترین نتیجه را ایجاد نمیکند.
استفاده از فقط Recall
Recall بالا همراه با Precision بسیار پایین ممکن است سیستم را پر از هشدار اشتباه کند.
نادیدهگرفتن Labelهای اشتباه
Resampling میتواند نویز کلاس اقلیت را تقویت کند.
استفاده از Pipeline اشتباه
Pipeline معمولی Scikit-learn برای Sampler طراحی نشده است. برای SMOTE از Pipeline کتابخانه imbalanced-learn استفاده کنید.
تولید داده مصنوعی برای Test Set
Test Set باید از نمونههای واقعی و مستقل تشکیل شود.
مقایسه روشها روی Foldهای متفاوت
تمام گزینهها باید روی تقسیمهای یکسان ارزیابی شوند.
نادیدهگرفتن هزینه کسبوکار
بهترین آستانه به هزینه False Positive و False Negative وابسته است.
چکلیست پروژه داده نامتوازن
پیش از انتشار مدل بررسی کنید:
- توزیع کلاسها روی داده واقعی مشخص است.
- Accuracy تنها معیار گزارش نیست.
- Baseline ساده ساخته شده است.
- Precision و Recall کلاس اقلیت گزارش میشوند.
- Macro F1 و Average Precision بررسی شدهاند.
- Confusion Matrix تحلیل شده است.
- Labelهای کلاس اقلیت بازبینی شدهاند.
- Training، Validation و Test جدا هستند.
- Resampling فقط روی Training انجام میشود.
- Stratified Cross-validation استفاده شده است.
- Class Weight بهعنوان Baseline آزمایش شده است.
- SMOTE با روشهای سادهتر مقایسه شده است.
- نسبت Sampling تنظیم شده است.
- آستانه تصمیم روی Validation انتخاب شده است.
- Test Set توزیع واقعی را حفظ کرده است.
- ظرفیت بررسی هشدارها در نظر گرفته شده است.
- داده مصنوعی توسط انسان بازبینی شده است.
- عملکرد مدل پس از انتشار مانیتور میشود.
پرسشهای متداول
داده نامتوازن چیست؟
دیتاستی است که تعداد نمونههای یک یا چند کلاس بهطور قابل توجهی کمتر از سایر کلاسها باشد.
SMOTE چیست؟
روشی برای Oversampling است که با استفاده از نمونههای نزدیک کلاس اقلیت، نمونههای عددی مصنوعی جدید تولید میکند.
آیا SMOTE همیشه عملکرد مدل را بهتر میکند؟
خیر. SMOTE میتواند نویز یا همپوشانی کلاسها را افزایش دهد. باید آن را با Baseline، Class Weight و روشهای دیگر مقایسه کرد.
SMOTE را قبل یا بعد از تقسیم داده اجرا کنیم؟
ابتدا داده را تقسیم کنید. SMOTE فقط باید روی Training Set و داخل هر Fold اعتبارسنجی اجرا شود.
آیا Validation و Test را هم متعادل کنیم؟
خیر. این بخشها باید توزیع واقعی داده را حفظ کنند.
Class Weight بهتر است یا SMOTE؟
پاسخ ثابت وجود ندارد. Class Weight سادهتر است و داده مصنوعی نمیسازد. SMOTE ممکن است در بعضی مسائل بهتر باشد. هر دو باید با Cross-validation مقایسه شوند.
آیا SMOTE برای متن مناسب است؟
استفاده آن روی TF-IDF یا Embedding ممکن است، اما نمونه مصنوعی لزوماً معادل متن واقعی نیست. Class Weight، جمعآوری داده و Oversampling نمونههای واقعی نیز باید آزمایش شوند.
SMOTENC چیست؟
نسخهای از SMOTE برای دیتاستهایی است که هم ویژگی عددی و هم ویژگی دستهای دارند.
بهترین معیار برای داده نامتوازن چیست؟
به هدف پروژه بستگی دارد. Precision، Recall، F1، Macro F1 و Average Precision از معیارهای مهماند. بهتر است چند معیار همراه با Confusion Matrix گزارش شوند.
آیا مدل زبانی میتواند داده کلاس اقلیت تولید کند؟
بله، اما خروجی باید بازبینی شود و فقط وارد Training شود. داده تولیدشده جایگزین Test Set واقعی نیست.
جمعبندی
داده نامتوازن یکی از مسائل رایج در پروژههای طبقهبندی است. Accuracy بالا در چنین پروژهای ممکن است ضعف کامل مدل در تشخیص کلاس مهم را پنهان کند.
برای مدیریت اصولی:
- ابتدا توزیع کلاسها و کیفیت Labelها را بررسی کنید.
- یک Baseline ساده بسازید.
- Precision، Recall، F1 و Average Precision را گزارش کنید.
- Class Weight را بهعنوان راهکار اولیه آزمایش کنید.
- Random Oversampling، SMOTE و Undersampling را مقایسه کنید.
- Resampling را فقط روی Training اجرا کنید.
- از Pipeline کتابخانه imbalanced-learn استفاده کنید.
- Validation و Test را با توزیع واقعی نگه دارید.
- آستانه تصمیم را بر اساس هزینه خطا تنظیم کنید.
- داده مصنوعی را جایگزین نمونه واقعی نکنید.
- عملکرد و نرخ هشدار مدل را پس از انتشار پایش کنید.
با API درواره میتوانید مدلهای زبانی مختلف را برای طبقهبندی، استخراج ویژگی و تولید کنترلشده نمونههای پیشنهادی آزمایش کنید و کیفیت، سرعت و هزینه آنها را با یک رابط یکپارچه مقایسه کنید.
مقالات مرتبط
- ماتریس درهمریختگی و معیارهای Precision، Recall و F1
- آموزش Cross-validation و K-Fold
- Feature Engineering و انتخاب ویژگی
- بیشبرازش و کمبرازش چیست؟
- آموزش Scikit-learn با پایتون
- آموزش Logistic Regression
- پردازش زبان طبیعی چیست؟
- ارزیابی مدلهای هوش مصنوعی و طراحی Evals
منابع
- Google Machine Learning: Class-imbalanced Datasets
- Imbalanced-learn: SMOTE
- Imbalanced-learn: Pipeline
- Imbalanced-learn: SMOTENC
- Imbalanced-learn: BorderlineSMOTE
- Imbalanced-learn: Combined Sampling
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



