
Feature Engineering چیست؟ آموزش مهندسی ویژگی و انتخاب ویژگی با پایتون
مهندسی ویژگی فرایند تبدیل داده خام به ورودیهای معنادار برای مدل یادگیری ماشین است. در این راهنما ساخت، استخراج و انتخاب ویژگی را با Pipeline و مثال عملی پایتون یاد میگیرید.

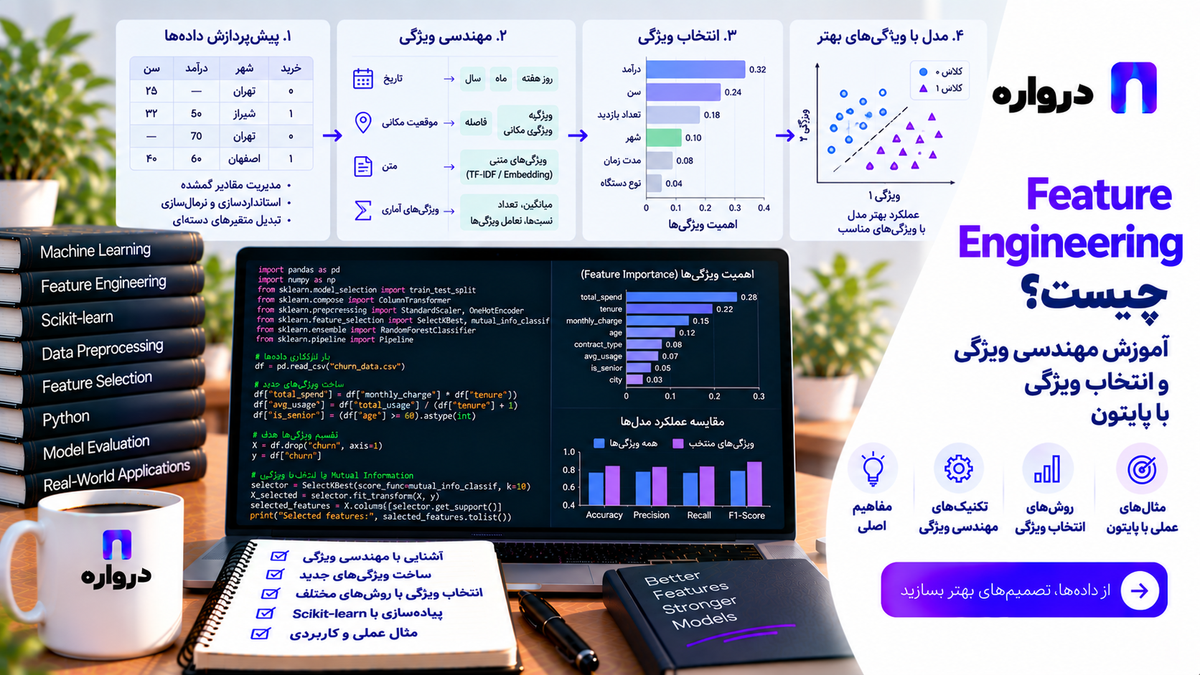
انتخاب الگوریتم قدرتمند بهتنهایی تضمین نمیکند که یک پروژه یادگیری ماشین نتیجه خوبی داشته باشد. اگر داده خام نتواند اطلاعات موردنیاز را بهشکل مناسبی در اختیار مدل قرار دهد، حتی الگوریتمهای پیشرفته نیز عملکرد مطلوبی نخواهند داشت.
مهندسی ویژگی یا Feature Engineering فرایند تبدیل دادههای خام به متغیرهایی است که مدل بتواند از آنها الگوهای مفید یاد بگیرد.
برای مثال، زمان ثبت یک تیکت بهصورت خام ممکن است فقط یک رشته تاریخ باشد:
2026-09-26 22:45:00اما با مهندسی ویژگی میتوان از آن اطلاعات معنادارتری استخراج کرد:
- ساعت ثبت
- روز هفته
- تعطیل یا کاری بودن روز
- ثبت در ساعت اداری یا خارج از ساعت اداری
- فاصله زمانی از آخرین پیام مشتری
در بسیاری از پروژهها، بهبود ویژگیها بیشتر از تغییر الگوریتم باعث افزایش کیفیت مدل میشود.
در این مقاله میآموزید:
- Feature Engineering چیست؟
- تفاوت Feature Engineering، Feature Extraction و Feature Selection چیست؟
- چگونه داده عددی و دستهای را آماده کنیم؟
- برای تاریخ، زمان و متن فارسی چه ویژگیهایی بسازیم؟
- چگونه داده گمشده و مقادیر پرت را مدیریت کنیم؟
- Feature Selection چگونه انجام میشود؟
- چگونه از Data Leakage جلوگیری کنیم؟
- چگونه یک Pipeline کامل با Scikit-learn بسازیم؟
- چگونه از Embedding و API درواره برای استخراج ویژگی معنایی استفاده کنیم؟
ویژگی یا Feature چیست؟
Feature اطلاعاتی است که مدل برای پیشبینی از آن استفاده میکند.
فرض کنید هدف، پیشبینی فوریبودن یک درخواست پشتیبانی باشد. ورودیهای احتمالی مدل میتوانند شامل موارد زیر باشند:
- متن پیام
- نوع اشتراک مشتری
- کانال ارسال پیام
- تعداد تیکتهای باز
- مدتزمان عضویت
- ساعت ثبت درخواست
- تعداد خطاهای اخیر
- مدتزمان گذشته از آخرین پاسخ
- وجود واژههایی مانند «قطع»، «خطا» یا «فوری»
هرکدام از این موارد میتوانند یک ویژگی یا مجموعهای از ویژگیها باشند.
برچسبی که مدل باید پیشبینی کند Feature نیست و معمولاً با نام Target یا Label شناخته میشود.
Feature Engineering چیست؟
مهندسی ویژگی شامل ساخت، تبدیل، ترکیب و نمایش مناسب اطلاعات خام برای استفاده در مدل است.
نمونههای رایج:
- استخراج ساعت و روز هفته از تاریخ
- تبدیل مبلغ خام به بازههای قیمتی
- محاسبه تعداد روزهای عضویت
- محاسبه فاصله میان دو رخداد
- تبدیل دستهها به بردار عددی
- استخراج طول متن
- تبدیل متن به TF-IDF یا Embedding
- ساخت نسبت میان دو متغیر
- ترکیب نوع مشتری و کانال ارتباط
- محدودکردن مقادیر پرت
- تبدیل توزیعهای بسیار نامتقارن
Scikit-learn ابزارهای مختلفی برای تبدیل بردار ویژگی خام به نمایش قابل استفاده برای مدل ارائه میکند.
تفاوت Feature Engineering و Data Preprocessing
این دو مفهوم همپوشانی دارند، اما کاملاً یکسان نیستند.
Data Preprocessing
تمرکز آن بر تمیزکردن و آمادهسازی داده است:
- مدیریت مقدارهای گمشده
- اصلاح نوع داده
- حذف داده تکراری
- استانداردسازی
- کدگذاری دستهها
- هماهنگکردن قالبها
Feature Engineering
تمرکز آن بر ایجاد نمایش معنادارتر از مسئله است:
- ساخت ویژگی جدید
- ترکیب چند ستون
- استخراج الگو از زمان
- محاسبه سابقه و رفتار
- تبدیل متن به ویژگی معنایی
- نمایش بهتر رابطه داده با هدف
در عمل این مراحل معمولاً در یک Pipeline مشترک اجرا میشوند.
تفاوت Feature Engineering، Feature Extraction و Feature Selection
این سه اصطلاح نباید بهجای یکدیگر استفاده شوند.
| مفهوم | هدف | مثال |
|---|---|---|
| Feature Engineering | ساخت یا تبدیل ویژگی معنادار | محاسبه سن حساب از تاریخ عضویت |
| Feature Extraction | تبدیل داده پیچیده به نمایش عددی | تبدیل متن به TF-IDF یا Embedding |
| Feature Selection | نگهداشتن ویژگیهای مفید | حذف ستونهای کماثر یا تکراری |
Scikit-learn، Feature Extraction را تبدیل دادههایی مانند متن یا تصویر به ویژگیهای عددی قابل استفاده برای مدل تعریف میکند.
چرا مهندسی ویژگی مهم است؟
مهندسی ویژگی مناسب میتواند:
- دقت مدل را افزایش دهد.
- الگوهای پنهان را آشکار کند.
- مدل سادهتری را قابل استفاده کند.
- زمان آموزش را کاهش دهد.
- تفسیر نتیجه را آسانتر کند.
- نویز را کاهش دهد.
- بیشبرازش را محدود کند.
- عملکرد مدل در محیط واقعی را پایدارتر کند.
بااینحال، ویژگی نامناسب میتواند نتیجه معکوس داشته باشد و باعث نشت داده، پیچیدگی غیرضروری یا وابستگی مدل به الگوهای موقت شود.
ویژگی خوب چه خصوصیتی دارد؟
یک ویژگی مناسب باید تا حد امکان:
- هنگام پیشبینی در دسترس باشد.
- ارتباط معناداری با هدف داشته باشد.
- روی دادههای جدید قابل محاسبه باشد.
- تعریف ثابت و مستندی داشته باشد.
- از اطلاعات آینده استفاده نکند.
- میان Training و Production یکسان محاسبه شود.
- بیشازحد به شناسههای خاص وابسته نباشد.
- کیفیت قابل اندازهگیری داشته باشد.
- مقدار گمشده آن قابل مدیریت باشد.
مهمترین پرسش برای هر Feature این است:
آیا این اطلاعات دقیقاً در لحظهای که مدل باید پیشبینی کند در دسترس است؟
اگر پاسخ منفی باشد، احتمال Data Leakage وجود دارد.
شناخت انواع داده پیش از ساخت ویژگی
قبل از مهندسی ویژگی باید نوع هر ستون مشخص شود:
داده عددی
مانند:
- مبلغ
- تعداد درخواست
- زمان پاسخ
- مصرف توکن
- تعداد روزهای عضویت
داده دستهای
مانند:
- نوع اشتراک
- استان
- کانال پشتیبانی
- دسته محصول
- وضعیت حساب
داده ترتیبی
مانند:
- سطح رضایت: کم، متوسط، زیاد
- اولویت: پایین، عادی، بالا، فوری
- سطح اشتراک: پایه، حرفهای، سازمانی
داده زمانی
مانند:
- زمان ثبت درخواست
- تاریخ خرید
- زمان آخرین ورود
- تاریخ تمدید
متن
مانند:
- پیام مشتری
- توضیحات محصول
- دیدگاه کاربر
- گزارش خطا
داده چندرسانهای
مانند:
- تصویر
- صوت
- ویدیو
هر نوع داده به روش تبدیل متفاوتی نیاز دارد.
مهندسی ویژگی برای داده عددی
مدیریت مقدارهای گمشده
برخی مدلها نمیتوانند با مقدار خالی کار کنند. روشهای رایج عبارتاند از:
- جایگزینی با میانه
- جایگزینی با میانگین
- جایگزینی با پرتکرارترین مقدار
- مقدار ثابت
- ساخت ستون نشاندهنده گمشدهبودن
from sklearn.impute import SimpleImputer

numeric_imputer = SimpleImputer(
    strategy="median",
    add_indicator=True,
)
استفاده از میانه برای دادههایی که مقدار پرت دارند معمولاً مقاومتر از میانگین است.
ویژگی نشاندهنده مقدار گمشده نیز میتواند مفید باشد؛ زیرا گاهی نبودن اطلاعات خود یک الگوی معنادار است.
Standardization
بعضی الگوریتمها به مقیاس ویژگیها حساساند:
- Logistic Regression
- SVM
- KNN
- شبکههای عصبی
- روشهای مبتنی بر فاصله
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
StandardScaler ویژگیها را در مقیاسی هماهنگتر قرار میدهد. این تبدیل باید فقط روی داده آموزش Fit شود.
Min-Max Scaling
اگر به محدوده مشخصی نیاز دارید:
from sklearn.preprocessing import MinMaxScaler

scaler = MinMaxScaler()
MinMaxScaler به مقادیر پرت حساس است. پیش از استفاده، توزیع داده را بررسی کنید.
Robust Scaling
برای داده دارای مقادیر پرت:
from sklearn.preprocessing import RobustScaler

scaler = RobustScaler()
تبدیل توزیع نامتقارن
مقادیر مالی، تعداد درخواست و مصرف معمولاً توزیع نامتقارن دارند. تبدیل لگاریتمی میتواند اختلاف میان مقادیر بزرگ را کنترل کند:
import numpy as np

df["log_monthly_usage"] = np.log1p(
    df["monthly_usage"]
)
در این تبدیل باید از منفینبودن مقدارها مطمئن شوید.
گوگل برای دادههای عددی روشهایی مانند Scaling خطی، Z-score، Log Scaling و Clipping را معرفی میکند.
Binning
در Binning مقدارهای پیوسته به بازه تبدیل میشوند:
import pandas as pd

df["account_age_group"] = pd.cut(
    df["account_age_days"],
    bins=[
        0,
        30,
        90,
        365,
        float("inf"),
    ],
    labels=[
        "new",
        "growing",
        "established",
        "long_term",
    ],
)
Binning زمانی مفید است که رابطه میان مقدار عددی و هدف خطی نباشد.
نباید تعداد زیادی بازه بسیار کوچک بسازید؛ زیرا مدل ممکن است روی جزئیات تصادفی Overfit شود.
مدیریت مقادیر پرت
Outlier همیشه داده اشتباه نیست. مصرف بسیار زیاد ممکن است متعلق به مشتری سازمانی واقعی باشد.
پیش از حذف مقدار پرت بررسی کنید:
- خطای ثبت است یا مقدار معتبر؟
- هنگام Production نیز ممکن است رخ دهد؟
- چه اثری بر مدل دارد؟
- آیا متعلق به یک بخش مهم از کاربران است؟
- حذف آن باعث تغییر مسئله میشود؟
روشهای ممکن:
- اصلاح داده ثبتشده اشتباه
- محدودکردن به صدکهای مشخص
- تبدیل لگاریتمی
- استفاده از RobustScaler
- ساخت یک Feature برای مقدار بسیار بزرگ
- استفاده از الگوریتم مقاومتر
lower = df["monthly_usage"].quantile(0.01)
upper = df["monthly_usage"].quantile(0.99)

df["monthly_usage_clipped"] = (
    df["monthly_usage"]
    .clip(lower, upper)
)
مرزها باید فقط با Training Set محاسبه شوند.
مهندسی ویژگی برای داده دستهای
مدلهای زیادی نمیتوانند رشتههایی مانند enterprise یا telegram را مستقیماً پردازش کنند.
One-Hot Encoding
برای دستههایی که ترتیب ندارند:
from sklearn.preprocessing import OneHotEncoder

encoder = OneHotEncoder(
    handle_unknown="ignore",
)
handle_unknown="ignore" کمک میکند دسته جدید در Production باعث توقف Pipeline نشود.
گوگل One-hot Encoding و Feature Cross را از روشهای کار با داده دستهای معرفی میکند.
Ordinal Encoding
برای دستههای دارای ترتیب واقعی:
from sklearn.preprocessing import OrdinalEncoder

encoder = OrdinalEncoder(
    categories=[
        [
            "basic",
            "professional",
            "enterprise",
        ]
    ],
    handle_unknown="use_encoded_value",
    unknown_value=-1,
)
Ordinal Encoding برای دسته بدون ترتیب مناسب نیست. تبدیل شهرها به اعداد متوالی ممکن است رابطهای غیرواقعی میان آنها ایجاد کند.
دستههای با Cardinality بالا
ستونهایی مانند شناسه محصول، نام شرکت یا کد صفحه ممکن است هزاران مقدار متفاوت داشته باشند.
روشهای ممکن:
- گروهبندی دستههای کمتکرار
- Hashing
- Frequency Encoding
- Target Encoding کنترلشده
- Embedding
- استخراج ویژگیهای سطح بالاتر
- حذف شناسه خام
Target Encoding باید داخل Cross-validation محاسبه شود. محاسبه آن روی کل داده باعث نشت Target به Feature خواهد شد.
Feature Cross چیست؟
Feature Cross یعنی ترکیب دو یا چند ویژگی برای نمایش یک تعامل.
مثال:
- نوع اشتراک + کانال پشتیبانی
- نوع دستگاه + نسخه سیستمعامل
- دسته محصول + فصل
- کشور + روش پرداخت
- نوع مشتری + ساعت درخواست
df["plan_channel"] = (
    df["plan"].astype(str)
    + "__"
    + df["channel"].astype(str)
)
Feature Cross زمانی مفید است که اثر یک متغیر به متغیر دیگری وابسته باشد.
تعداد ترکیبها را کنترل کنید؛ زیرا ترکیب دستههای پرتنوع میتواند فضای ویژگی بسیار بزرگی ایجاد کند.
مهندسی ویژگی برای تاریخ و زمان
تاریخ خام معمولاً برای مدل کافی نیست.
df["created_at"] = pd.to_datetime(
    df["created_at"],
    utc=True,
)

df["created_hour"] = (
    df["created_at"].dt.hour
)

df["created_weekday"] = (
    df["created_at"].dt.dayofweek
)

df["created_month"] = (
    df["created_at"].dt.month
)

df["is_weekend"] = (
    df["created_weekday"] >= 5
).astype(int)ویژگیهای قابل استخراج:
- ساعت
- روز هفته
- ماه
- فصل
- تعطیل یا کاری
- ساعت اداری
- فاصله تا تمدید
- مدت عضویت
- زمان گذشته از آخرین فعالیت
- تعداد رویداد در یک بازه
محاسبه مدت عضویت
reference_time = pd.Timestamp(
    "2026-09-26",
    tz="UTC",
)

df["account_age_days"] = (
    reference_time
    - df["registered_at"]
).dt.days
در پروژه واقعی بهتر است reference_time همان لحظه پیشبینی باشد، نه یک تاریخ ثابت داخل کد.
جلوگیری از نشت زمانی
این ویژگی ظاهراً مفید است:
تعداد تیکتهای حلشده مشتری در ماه جاریاما اگر مدل هنگام ثبت تیکت پیشبینی میکند، نباید رخدادهایی را که بعد از همان لحظه اتفاق افتادهاند ببیند.
برای هر Feature زمانی باید Cutoff مشخص باشد:
- چه زمانی پیشبینی انجام میشود؟
- تا آن لحظه چه دادهای در دسترس است؟
- آیا Aggregation فقط از گذشته استفاده میکند؟
- آیا رکوردهای آینده به محاسبه وارد شدهاند؟
ویژگیهای تجمیعی
اطلاعات رفتاری معمولاً از تجمیع رویدادها ساخته میشود:
- تعداد درخواست در هفت روز گذشته
- میانگین مصرف در ۳۰ روز گذشته
- تعداد خطاهای اخیر
- فاصله از آخرین خرید
- تعداد ورود ناموفق
- میانگین زمان پاسخ قبلی
- تعداد ویژگیهای استفادهشده
customer_features = (
    events
    .groupby("customer_id")
    .agg(
        ticket_count=(
            "ticket_id",
            "count",
        ),
        average_response_time=(
            "response_minutes",
            "mean",
        ),
        last_activity=(
            "created_at",
            "max",
        ),
    )
    .reset_index()
)
این محاسبات باید نسبت به زمان پیشبینی انجام شوند. استفاده از تمام تاریخچه، شامل آینده، نتیجه ارزیابی را غیرواقعی میکند.
مهندسی ویژگی برای متن فارسی
متن را میتوان به روشهای مختلف به ویژگی عددی تبدیل کرد.
ویژگیهای ساده متنی
- تعداد کاراکتر
- تعداد کلمه
- تعداد عدد
- تعداد علامت سؤال
- وجود URL
- وجود کد خطا
- نسبت حروف فارسی
- وجود واژههای مرتبط با فوریت
df["message_length"] = (
    df["message"].str.len()
)

df["word_count"] = (
    df["message"]
    .str.split()
    .str.len()
)

df["question_mark_count"] = (
    df["message"]
    .str.count(r"\?")
)

df["contains_error_code"] = (
    df["message"]
    .str.contains(
        r"\b[45]\d{2}\b",
        regex=True,
        na=False,
    )
    .astype(int)
)
این ویژگیها نباید جای فهم معنایی متن را بگیرند، اما میتوانند مکمل مناسبی باشند.
نرمالسازی فارسی
در متن فارسی باید موارد زیر را بررسی کنید:
- یکسانسازی «ی» و «ک»
- مدیریت نیمفاصله
- حذف فاصلههای اضافی
- تفاوت اعداد فارسی و انگلیسی
- علائم نگارشی
- شکلهای مختلف URL
- غلطهای املایی پرتکرار
- متن محاورهای
نباید تمام علائم و اعداد را بدون بررسی حذف کنید. کد خطا، نسخه نرمافزار و مبلغ ممکن است اطلاعات مهمی باشند.
TF-IDF
from sklearn.feature_extraction.text import TfidfVectorizer

vectorizer = TfidfVectorizer(
    ngram_range=(1, 2),
    min_df=2,
    max_df=0.95,
    sublinear_tf=True,
)
TfidfVectorizer متن خام را به ماتریس ویژگی TF-IDF تبدیل میکند.
Word و Character N-gram
Character N-gram برای متن فارسی، غلط املایی و شکلهای نوشتاری متفاوت میتواند مفید باشد:
character_vectorizer = TfidfVectorizer(
    analyzer="char_wb",
    ngram_range=(3, 5),
    min_df=2,
)میتوان ویژگیهای کلمه و کاراکتر را با FeatureUnion ترکیب کرد.
Embedding بهعنوان ویژگی
Embedding متن را به یک بردار عددی معنایی تبدیل میکند. پیامهایی با مفهوم مشابه میتوانند بردارهای نزدیکتری داشته باشند، حتی اگر واژههای یکسانی نداشته باشند.
کاربردها:
- طبقهبندی متن
- جستوجوی معنایی
- خوشهبندی پیامها
- پیشنهاد محتوای مشابه
- تشخیص موضوع
- بازیابی اسناد برای RAG
برای آشنایی مفصلتر میتوانید مقاله Embedding چیست؟ را مطالعه کنید.
ساخت Embedding با API درواره
API درواره با ساختار سازگار با OpenAI امکان دسترسی یکپارچه به مدلهای مختلف را فراهم میکند.
آدرس پایه:
https://api.darvareh.ir/v1نصب کتابخانه:
pip install openai numpy scikit-learnمتغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_EMBEDDING_MODEL="YOUR_EMBEDDING_MODEL_ID"
کد نمونه:
import os

import numpy as np
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)

EMBEDDING_MODEL = os.environ[
    "DARVAREH_EMBEDDING_MODEL"
]


def create_embeddings(
    texts: list[str],
) -> np.ndarray:
    response = client.embeddings.create(
        model=EMBEDDING_MODEL,
        input=texts,
    )

    vectors = [
        item.embedding
        for item in response.data
    ]

    return np.asarray(
        vectors,
        dtype=np.float32,
    )
شناسه مدل را باید از فهرست فعلی مدلهای درواره انتخاب کنید.
پس از ساخت بردارها میتوان یک مدل طبقهبندی آموزش داد:
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn.model_selection import StratifiedKFold

X_embeddings = create_embeddings(
    messages
)

classifier = LogisticRegression(
    max_iter=1000,
)

cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

scores = cross_val_score(
    classifier,
    X_embeddings,
    labels,
    cv=cv,
    scoring="f1_macro",
)

print("Macro F1:", scores.mean())
برای جلوگیری از هزینه تکراری، Embedding هر متن را همراه با شناسه مدل و نسخه ورودی ذخیره کنید.
برای شروع اتصال میتوانید مستندات API درواره را ببینید.
استفاده از مدل زبانی برای استخراج ویژگی ساختاریافته
مدل زبانی میتواند اطلاعات ساختاریافتهای از متن استخراج کند:
- موضوع پیام
- لحن
- محصول اشارهشده
- نیاز به پاسخ انسانی
- وجود کد خطا
- نوع اقدام درخواستی
- خلاصه کوتاه
این اطلاعات سپس میتوانند بهعنوان Feature وارد مدل یا قواعد کسبوکار شوند.
import os
from typing import Literal
from openai import OpenAI
from pydantic import BaseModel
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
MODEL_ID = os.environ["DARVAREH_MODEL"]
class MessageFeatures(BaseModel):
topic: Literal[
"sales",
"technical",
"billing",
"feedback",
"other",
]
tone: Literal[
"neutral",
"negative",
"positive",
]
contains_error_code: bool
requires_human_review: bool
def extract_message_features(
message: str,
) -> MessageFeatures:
completion = client.chat.completions.create(
model=MODEL_ID,
temperature=0,
messages=[
{
"role": "system",
"content": (
"از پیام مشتری ویژگیهای خواستهشده "
"را استخراج کن و فقط JSON معتبر برگردان."
),
},
{
"role": "user",
"content": message,
},
],
)
content = completion.choices[0].message.content
if not content:
raise ValueError(
"مدل پاسخ خالی برگرداند."
)
return MessageFeatures.model_validate_json(
content
)خروجی مدل زبانی را نباید حقیقت قطعی در نظر گرفت. دقت Featureهای استخراجشده باید روی مجموعه برچسبگذاریشده ارزیابی شود.
همچنین نسخه مدل، پرامپت و Schema باید ثبت شوند؛ زیرا تغییر هرکدام میتواند توزیع ویژگیها را تغییر دهد.
ساخت Pipeline برای داده ترکیبی
فرض کنید دیتاست پشتیبانی شامل این ستونها است:
message: متن پیامplan: نوع اشتراکchannel: کانال ارتباطیopen_tickets: تعداد تیکت بازaccount_age_days: مدت عضویت
یک Pipeline کامل:
from sklearn.compose import ColumnTransformer
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder
from sklearn.preprocessing import StandardScaler

numeric_features = [
    "open_tickets",
    "account_age_days",
]

categorical_features = [
    "plan",
    "channel",
]

text_feature = "message"

numeric_pipeline = Pipeline(
    [
        (
            "imputer",
            SimpleImputer(
                strategy="median",
                add_indicator=True,
            ),
        ),
        (
            "scaler",
            StandardScaler(),
        ),
    ]
)

categorical_pipeline = Pipeline(
    [
        (
            "imputer",
            SimpleImputer(
                strategy="most_frequent",
            ),
        ),
        (
            "encoder",
            OneHotEncoder(
                handle_unknown="ignore",
            ),
        ),
    ]
)

preprocessor = ColumnTransformer(
    transformers=[
        (
            "numeric",
            numeric_pipeline,
            numeric_features,
        ),
        (
            "categorical",
            categorical_pipeline,
            categorical_features,
        ),
        (
            "text",
            TfidfVectorizer(
                ngram_range=(1, 2),
                min_df=2,
            ),
            text_feature,
        ),
    ]
)

model = Pipeline(
    [
        (
            "preprocessor",
            preprocessor,
        ),
        (
            "classifier",
            LogisticRegression(
                max_iter=1000,
            ),
        ),
    ]
)
ColumnTransformer اجازه میدهد برای هر گروه از ستونها تبدیل متفاوتی اعمال شود و Pipeline همه مراحل را همراه با مدل نگه میدارد.
Scikit-learn استفاده از Pipeline را برای اجرای متوالی Transformerها و مدل نهایی پشتیبانی میکند.
آموزش و ارزیابی Pipeline
from sklearn.model_selection import StratifiedKFold
from sklearn.model_selection import cross_validate

cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

results = cross_validate(
    model,
    X,
    y,
    cv=cv,
    scoring=[
        "accuracy",
        "f1_macro",
    ],
    return_train_score=True,
    n_jobs=-1,
)

print(
    "Train F1:",
    results["train_f1_macro"].mean(),
)

print(
    "Validation F1:",
    results["test_f1_macro"].mean(),
)
قرارگرفتن تمام تبدیلها داخل Pipeline از استفاده ناخواسته اطلاعات Fold اعتبارسنجی جلوگیری میکند.
Feature Selection چیست؟
Feature Selection یعنی انتخاب زیرمجموعهای از ویژگیها که بیشترین اطلاعات مفید را برای مدل دارند.
مزایای احتمالی:
- کاهش بیشبرازش
- کاهش زمان آموزش
- کاهش حافظه
- سادهترشدن مدل
- افزایش توضیحپذیری
- حذف نویز
- کاهش هزینه جمعآوری داده
اما حذف ویژگی باید با Cross-validation ارزیابی شود. ویژگیای که بهتنهایی ضعیف است ممکن است در ترکیب با ویژگی دیگر مفید باشد.
انواع روشهای انتخاب ویژگی
روشهای Filter
ویژگیها پیش از آموزش مدل و با معیار آماری رتبهبندی میشوند.
نمونهها:
- Variance Threshold
- آزمونهای آماری
- Mutual Information
- همبستگی
مزایا:
- سریع
- مستقل از مدل
- مناسب داده دارای ویژگی زیاد
محدودیت:
- تعامل پیچیده میان ویژگیها را کمتر در نظر میگیرد.
روشهای Wrapper
زیرمجموعههای مختلف ویژگی با آموزش مکرر مدل مقایسه میشوند.
نمونه:
- Recursive Feature Elimination
- Sequential Feature Selection
مزایا:
- هماهنگ با مدل انتخابشده
معایب:
- هزینه محاسباتی بیشتر
- خطر بیشبرازش روی Validation
- نامناسب برای تعداد بسیار زیاد ویژگی
روشهای Embedded
انتخاب ویژگی بخشی از آموزش مدل است.
نمونهها:
- L1 Regularization
- Decision Tree
- Random Forest
- Gradient Boosting
انتخاب ویژگی با SelectKBest
from sklearn.feature_selection import SelectKBest
from sklearn.feature_selection import mutual_info_classif

selection_model = Pipeline(
    [
        (
            "preprocessor",
            preprocessor,
        ),
        (
            "selector",
            SelectKBest(
                score_func=mutual_info_classif,
                k=50,
            ),
        ),
        (
            "classifier",
            LogisticRegression(
                max_iter=1000,
            ),
        ),
    ]
)
مقدار k باید با Cross-validation انتخاب شود.
Scikit-learn انتخاب تکمتغیره را روشی برای انتخاب ویژگیهای بهتر بر اساس آزمونهای آماری معرفی میکند.
حذف ویژگی کمتغییر
ویژگیای که تقریباً در تمام ردیفها مقدار یکسان دارد ممکن است اطلاعات کمی ارائه دهد:
from sklearn.feature_selection import VarianceThreshold

selector = VarianceThreshold(
    threshold=0.01,
)
این روش باید با توجه به نوع داده استفاده شود. یک Feature کمتکرار ممکن است برای تشخیص یک کلاس مهم ارزشمند باشد.
Recursive Feature Elimination
from sklearn.feature_selection import RFE
from sklearn.linear_model import LogisticRegression

estimator = LogisticRegression(
    max_iter=1000,
)

selector = RFE(
    estimator=estimator,
    n_features_to_select=20,
    step=5,
)
RFE مدل را چند بار آموزش میدهد و بهتدریج ویژگیهای کماهمیتتر را حذف میکند.
برای دادههای بسیار بزرگ یا هزاران ویژگی متنی ممکن است هزینه آن زیاد باشد.
انتخاب ویژگی با L1
from sklearn.linear_model import LogisticRegression
from sklearn.feature_selection import SelectFromModel

selector = SelectFromModel(
    LogisticRegression(
        penalty="l1",
        solver="liblinear",
        max_iter=1000,
    )
)
L1 میتواند بخشی از ضرایب را به صفر نزدیک کند و مدل کمتراکمتری بسازد.
اهمیت ویژگی در مدلهای درختی
from sklearn.ensemble import RandomForestClassifier
from sklearn.feature_selection import SelectFromModel

selector = SelectFromModel(
    RandomForestClassifier(
        n_estimators=300,
        random_state=42,
    ),
    threshold="median",
)
اهمیت داخلی درختها همیشه تفسیر کاملی از اثر واقعی ویژگی ارائه نمیکند. ویژگیهای همبسته میتوانند اهمیت را میان خود تقسیم کنند.
برای تحلیل مطمئنتر میتوان از Permutation Importance روی داده اعتبارسنجی استفاده کرد.
Data Leakage در انتخاب ویژگی
این روش اشتباه است:
selector.fit(X, y)
X_selected = selector.transform(X)

scores = cross_val_score(
    model,
    X_selected,
    y,
    cv=5,
)
در اینجا Feature Selection پیش از Cross-validation روی کل داده انجام شده و اطلاعات تمام Labelها وارد انتخاب شده است.
روش درست:
pipeline = Pipeline(
    [
        (
            "selector",
            selector,
        ),
        (
            "model",
            model,
        ),
    ]
)

scores = cross_val_score(
    pipeline,
    X,
    y,
    cv=5,
)
Scikit-learn تأکید میکند انتخاب ویژگی نیز مانند سایر مراحل پیشپردازش باید فقط با داده آموزش انجام شود؛ استفاده از Test Set نتیجهای خوشبینانه ایجاد میکند.
ویژگیهای خطرناک که باید بررسی شوند
شناسه یکتا
ستونهایی مانند شماره تیکت معمولاً الگوی قابل تعمیمی ندارند.
اطلاعات آینده
وضعیت نهایی پرونده یا زمان حل نباید برای پیشبینی اولیه استفاده شود.
ویژگی ساختهشده از Target
اگر Feature مستقیماً یا غیرمستقیم Label را بازتاب دهد، نتیجه غیرواقعی خواهد بود.
داده پس از رخداد
برای پیشبینی لغو اشتراک، اطلاعات ثبتشده پس از لغو نباید وارد مدل شود.
متغیرهای واسطهای
گاهی یک ستون نتیجه تصمیم انسانی قبلی است و Target را آشکار میکند.
داده ناسازگار با Production
اگر Feature فقط در محیط آزمایش قابل محاسبه باشد، مدل قابل استقرار نیست.
Feature Store چیست؟
Feature Store سامانهای برای تعریف، محاسبه، نگهداری و ارائه Featureها است.
مزایای آن:
- یکسانبودن محاسبه در Training و Production
- استفاده مجدد از ویژگیها
- مدیریت نسخه
- ثبت منبع داده
- کنترل تازگی
- کاهش Training-serving Skew
- مستندسازی مالک و تعریف Feature
برای پروژه کوچک، جدولهای نسخهبندیشده و Pipeline مشخص میتوانند کافی باشند. با افزایش تعداد مدلها و منابع داده، Feature Store ارزش بیشتری پیدا میکند.
Training-serving Skew چیست؟
Training-serving Skew زمانی رخ میدهد که Featureها در آموزش و Production به روش متفاوتی محاسبه شوند.
مثال:
- در آموزش، مقدار خالی با میانه جایگزین شده است.
- در Production، مقدار خالی صفر میشود.
- در آموزش، زمان بر اساس UTC است.
- در Production، زمان محلی استفاده میشود.
- در آموزش، متن فارسی نرمال شده است.
- در Production، متن خام وارد مدل میشود.
استفاده از Pipeline مشترک و تست خروجی Featureها این خطر را کاهش میدهد.
پایش Featureها پس از انتشار
پس از استقرار فقط کیفیت خروجی مدل را بررسی نکنید. توزیع Featureها نیز باید مانیتور شود.
موارد مهم:
- درصد مقدار گمشده
- مقدارهای جدید دستهای
- تغییر میانگین و پراکندگی
- افزایش مقادیر خارج از محدوده
- تغییر طول متن
- تغییر سهم کانالها
- کاهش تازگی داده
- تغییر توزیع Embedding
- شکست فرایند محاسبه Feature
- تغییر Schema
تغییر شدید توزیع ممکن است نشانه Data Drift یا خرابی Pipeline باشد.
اشتباهات رایج در Feature Engineering
ساخت ویژگی پیش از تعریف زمان پیشبینی
ابتدا باید لحظه تصمیم مدل مشخص شود.
استفاده از اطلاعات آینده
این خطا یکی از رایجترین دلایل امتیاز غیرواقعی است.
Fit کردن Transformer روی کل داده
تمام Transformerها باید داخل Pipeline و فقط روی Training Fit شوند.
One-Hot کردن شناسههای پرتعداد
این کار میتواند هزاران ستون کمارزش ایجاد کند.
حذف بیدلیل مقادیر پرت
مقادیر پرت ممکن است نماینده کاربران واقعی و مهم باشند.
Featureهای بسیار زیاد بدون ارزیابی
افزایش تعداد ویژگی لزوماً کیفیت را بهتر نمیکند.
استفاده از Target Encoding بدون Cross-validation
این کار باعث نشت Label میشود.
حذف علائم و اعداد از متن
کد خطا، مبلغ و نسخه میتوانند اطلاعات اصلی پیام باشند.
محاسبه متفاوت در Production
کد Feature Engineering باید تا حد امکان میان آموزش و سرویس عملیاتی مشترک باشد.
انتخاب ویژگی با Test Set
Test Set فقط برای ارزیابی نهایی است.
اعتماد کامل به Feature استخراجشده توسط مدل زبانی
خروجی مدل باید اعتبارسنجی، نسخهبندی و مانیتور شود.
چکلیست مهندسی ویژگی
پیش از آموزش مدل بررسی کنید:
- هدف و لحظه پیشبینی دقیقاً مشخص شده است.
- نوع هر ستون تعیین شده است.
- Feature فقط از اطلاعات در دسترس همان لحظه استفاده میکند.
- دادههای تکراری و ناسازگار بررسی شدهاند.
- مقدارهای گمشده مدیریت میشوند.
- دسته جدید در Production باعث خطا نمیشود.
- Featureهای زمانی فقط از گذشته ساخته میشوند.
- پیشپردازش داخل Pipeline است.
- Feature Selection داخل Cross-validation انجام میشود.
- Training و Production منطق مشترک دارند.
- نسخه و تعریف Featureها ثبت میشود.
- تأثیر هر ویژگی با Ablation Test بررسی شده است.
- هزینه محاسبه Feature در نظر گرفته شده است.
- توزیع Featureها پس از انتشار مانیتور میشود.
- Test Set در ساخت ویژگی دخالت نداشته است.
پرسشهای متداول
Feature Engineering چیست؟
فرایند تبدیل داده خام به ویژگیهای معنادار و قابل استفاده برای مدل یادگیری ماشین است.
تفاوت Feature و Label چیست؟
Feature ورودی مدل است. Label یا Target مقداری است که مدل باید آن را پیشبینی کند.
تفاوت Feature Engineering و Feature Selection چیست؟
در Feature Engineering ویژگی جدید ساخته یا تبدیل میشود. در Feature Selection بخشی از ویژگیهای موجود انتخاب میشوند.
آیا مهندسی ویژگی فقط برای مدلهای کلاسیک است؟
خیر. شبکههای عصبی، مدلهای زبانی، سیستمهای RAG و Agentها نیز به آمادهسازی ورودی، استخراج اطلاعات و طراحی نمایش مناسب داده نیاز دارند.
آیا Scaling برای همه مدلها لازم است؟
خیر. مدلهایی مانند درخت تصمیم معمولاً به Scaling حساس نیستند، اما SVM، KNN، Logistic Regression و شبکههای عصبی اغلب از مقیاسبندی مناسب سود میبرند.
برای داده دستهای از چه روشی استفاده کنیم؟
برای دستههای کمتعداد و بدون ترتیب، One-Hot Encoding انتخاب رایجی است. برای داده دارای ترتیب واقعی میتوان از Ordinal Encoding استفاده کرد. دستههای بسیار پرتعداد به روش متفاوتی نیاز دارند.
TF-IDF بهتر است یا Embedding؟
TF-IDF ساده، سریع و برای بسیاری از مسائل طبقهبندی متن مؤثر است. Embedding اطلاعات معنایی بیشتری ثبت میکند. انتخاب نهایی باید با داده واقعی و Cross-validation انجام شود.
آیا Embedding یک Feature است؟
بله. هر بعد بردار Embedding بخشی از نمایش عددی متن، تصویر یا داده دیگر است و میتواند بهعنوان ورودی مدل استفاده شود.
چگونه بهترین Featureها را پیدا کنیم؟
دانش دامنه، تحلیل داده، Cross-validation، Feature Importance، Selection و Ablation Test را با هم استفاده کنید.
Ablation Test چیست؟
در این آزمایش یک Feature یا گروه Feature حذف میشود و تغییر عملکرد مدل اندازهگیری میشود. این روش اثر واقعی گروههای ویژگی را بهتر نشان میدهد.
جمعبندی
Feature Engineering پلی میان داده خام و مدل یادگیری ماشین است. کیفیت این مرحله میتواند بیش از پیچیدهترکردن الگوریتم بر نتیجه پروژه اثر بگذارد.
برای اجرای اصولی:
- ابتدا زمان و هدف پیشبینی را مشخص کنید.
- نوع داده هر ستون را بشناسید.
- مقدارهای گمشده و پرت را آگاهانه مدیریت کنید.
- داده عددی را متناسب با الگوریتم مقیاسبندی کنید.
- دستهها را بدون ایجاد ترتیب مصنوعی کدگذاری کنید.
- از تاریخ و زمان ویژگیهای قابل تعمیم بسازید.
- متن فارسی را با حفظ اطلاعات مهم نرمال کنید.
- TF-IDF و Embedding را روی داده واقعی مقایسه کنید.
- Feature Selection را داخل Pipeline انجام دهید.
- از ورود اطلاعات آینده و Test Set جلوگیری کنید.
- محاسبات Training و Production را هماهنگ نگه دارید.
- کیفیت و توزیع Featureها را پس از انتشار پایش کنید.
با استفاده از API درواره میتوانید مدلهای Embedding و زبانی مختلف را با یک اتصال یکپارچه آزمایش کنید و از آنها برای استخراج ویژگی معنایی، طبقهبندی متن و ساخت قابلیتهای هوش مصنوعی در نرمافزار خود استفاده کنید.
مقالات مرتبط
- Embedding چیست و چه کاربردی دارد؟
- آموزش Cross-validation و K-Fold
- بیشبرازش و کمبرازش چیست؟
- آموزش Scikit-learn با پایتون
- آموزش Pandas برای تحلیل داده
- ماتریس درهمریختگی و معیارهای ارزیابی
- آموزش پردازش زبان طبیعی
- آموزش اتصال API هوش مصنوعی به نرمافزار
منابع
- Scikit-learn: Preprocessing Data
- Scikit-learn: Feature Extraction
- Scikit-learn: Feature Selection
- Scikit-learn: Pipeline
- Scikit-learn: Common Pitfalls
- Google Machine Learning: Numerical Data
- Google Machine Learning: Categorical Data
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



