
Cross-validation چیست؟ آموزش کامل K-Fold و اعتبارسنجی متقابل با پایتون
Cross-validation روشی برای ارزیابی مطمئنتر مدل روی چند تقسیم متفاوت داده است. در این راهنما K-Fold، StratifiedKFold، GroupKFold و TimeSeriesSplit را با مثال عملی پایتون یاد میگیرید.

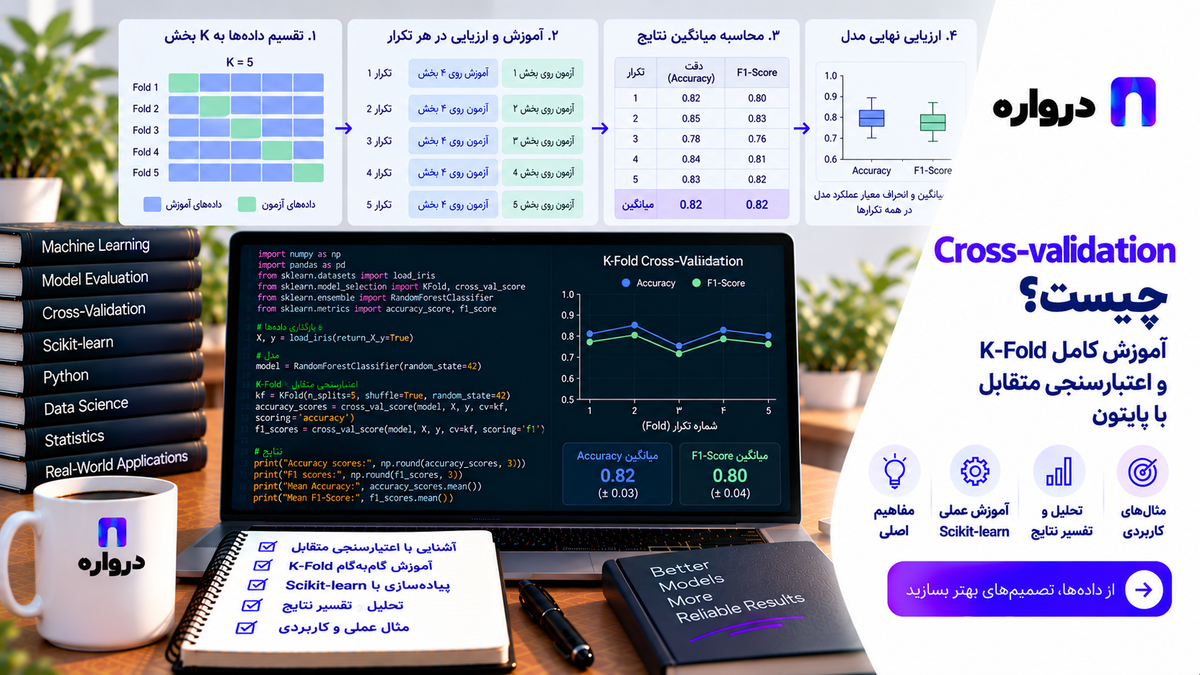
فرض کنید دو مدل یادگیری ماشین ساختهاید و مدل اول روی مجموعه آزمایش دقت بیشتری دارد. آیا میتوان نتیجه گرفت مدل اول واقعاً بهتر است؟
نه لزوماً. ممکن است تقسیم تصادفی داده بهگونهای انجام شده باشد که نمونههای سادهتر وارد مجموعه آزمایش مدل اول شده باشند. با تغییر random_state احتمال دارد رتبه دو مدل عوض شود.
اعتبارسنجی متقابل یا Cross-validation روشی برای کاهش این وابستگی است. بهجای ارزیابی مدل روی یک تقسیم ثابت، آن را چند مرتبه روی بخشهای متفاوت داده آموزش میدهیم و ارزیابی میکنیم.
در این مقاله میآموزید:
- Cross-validation چیست؟
- K-Fold چگونه کار میکند؟
- عدد K را چگونه انتخاب کنیم؟
- تفاوت KFold و StratifiedKFold چیست؟
- چه زمانی باید از GroupKFold استفاده کنیم؟
- TimeSeriesSplit برای چه دادههایی مناسب است؟
- Nested Cross-validation چیست؟
- چگونه از Data Leakage جلوگیری کنیم؟
- چطور چند مدل را با Scikit-learn مقایسه کنیم؟
- چگونه این روش را برای ارزیابی مدلهای هوش مصنوعی و API درواره به کار ببریم؟
اعتبارسنجی متقابل چیست؟
Cross-validation روشی برای برآورد عملکرد مدل روی دادههای دیدهنشده است.
در یک تقسیم ساده یا Holdout، داده را معمولاً به مجموعه آموزش و آزمایش تقسیم میکنیم. مدل فقط یک بار آموزش میبیند و نتیجه آن روی یک بخش مشخص اندازهگیری میشود.
مشکل این روش آن است که نتیجه میتواند به همان تقسیم خاص وابسته باشد.
در اعتبارسنجی متقابل:
- داده به چند بخش تقسیم میشود.
- مدل روی تعدادی از بخشها آموزش میبیند.
- روی بخش باقیمانده ارزیابی میشود.
- این فرایند با بخشهای متفاوت تکرار میشود.
- میانگین و پراکندگی امتیازها گزارش میشود.
Cross-validation به ما کمک میکند بفهمیم مدل در تقسیمهای مختلف چقدر پایدار است. مستندات Scikit-learn نیز این روش را برای ارزیابی عملکرد و انتخاب مدل معرفی میکند.
چرا یک Train/Test Split کافی نیست؟
تقسیم ساده داده سریع و قابل فهم است، اما محدودیتهایی دارد:
- نتیجه به انتخاب تصادفی نمونهها وابسته است.
- ممکن است کلاسهای دشوار در یک بخش بیشتر باشند.
- بخشی از داده فقط برای آزمایش کنار گذاشته میشود.
- در دیتاست کوچک، کاهش داده آموزشی محسوس است.
- مقایسه مدلها ممکن است ناپایدار باشد.
- یک امتیاز منفرد میزان پراکندگی عملکرد را نشان نمیدهد.
فرض کنید یک مدل دستهبندی پیام مشتری روی یک تقسیم به F1 برابر ۰٫۹۰ برسد. همان مدل با تقسیم دیگر ممکن است F1 برابر ۰٫۸۱ داشته باشد. گزارش فقط نتیجه اول تصویری بیشازحد خوشبینانه ایجاد میکند.
Cross-validation عملکرد را روی چند تقسیم بررسی میکند و تصویر مطمئنتری ارائه میدهد.
K-Fold Cross-validation چگونه کار میکند؟
K-Fold یکی از رایجترین انواع اعتبارسنجی متقابل است.
در این روش داده به K بخش یا Fold تقسیم میشود. مدل K مرتبه آموزش داده میشود. در هر مرحله:
- یک Fold برای اعتبارسنجی استفاده میشود.
- سایر Foldها برای آموزش استفاده میشوند.
- Fold اعتبارسنجی در مرحله بعد تغییر میکند.
در پایان، هر نمونه یک بار در بخش اعتبارسنجی قرار گرفته است.
برای مثال، در ۵-Fold Cross-validation:
| مرحله | Foldهای آموزش | Fold اعتبارسنجی |
|---|---|---|
| ۱ | ۲، ۳، ۴ و ۵ | ۱ |
| ۲ | ۱، ۳، ۴ و ۵ | ۲ |
| ۳ | ۱، ۲، ۴ و ۵ | ۳ |
| ۴ | ۱، ۲، ۳ و ۵ | ۴ |
| ۵ | ۱، ۲، ۳ و ۴ | ۵ |
پس از پنج مرحله، پنج امتیاز داریم. میانگین آنها عملکرد مورد انتظار مدل و پراکندگی آنها میزان ثبات مدل را نشان میدهد.
عدد K را چگونه انتخاب کنیم؟
مقادیر ۵ و ۱۰ از انتخابهای رایج هستند، اما هیچ مقدار ثابتی برای همه پروژهها وجود ندارد.
K کوچک
مزایا:
- آموزش سریعتر
- هزینه پردازشی کمتر
- مناسب برای دیتاستهای بزرگتر
محدودیت:
- برآورد عملکرد ممکن است به تقسیمبندی حساستر باشد.
K بزرگ
مزایا:
- سهم بیشتری از داده در هر مرحله برای آموزش استفاده میشود.
- برای دیتاست کوچک میتواند مفید باشد.
محدودیتها:
- زمان آموزش افزایش پیدا میکند.
- Foldهای اعتبارسنجی کوچکتر میشوند.
- اجرای مدلهای سنگین گرانتر خواهد بود.
پیشنهاد عملی
- برای شروع از ۵ Fold استفاده کنید.
- اگر داده محدود و هزینه آموزش قابل مدیریت است، ۱۰ Fold را آزمایش کنید.
- در طبقهبندی مطمئن شوید هر Fold از هر کلاس نمونه کافی دارد.
- در داده گروهی، تعداد گروهها باید برای تعداد Fold انتخابشده کافی باشد.
- در داده زمانی، بهجای KFold معمولی از تقسیم زمانی استفاده کنید.
اولین مثال K-Fold با پایتون
ابتدا کتابخانههای لازم را نصب کنید:
pip install scikit-learn pandas numpyیک مثال ساده:
from sklearn.datasets import load_iris
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score

X, y = load_iris(
    return_X_y=True,
)

model = LogisticRegression(
    max_iter=1000,
)

cv = KFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

scores = cross_val_score(
    model,
    X,
    y,
    cv=cv,
    scoring="accuracy",
)

print("Fold scores:", scores)
print("Mean accuracy:", scores.mean())
print("Standard deviation:", scores.std())
پارامترهای مهم:
n_splits: تعداد Foldهاshuffle: برزدن داده پیش از تقسیمrandom_state: تکرارپذیرکردن تقسیمscoring: معیار ارزیابی
گزارش میانگین بدون پراکندگی کافی نیست. دو مدل ممکن است میانگین مشابه داشته باشند، اما یکی در Foldهای مختلف بسیار ناپایدار باشد.
تفاوت KFold و StratifiedKFold چیست؟
KFold معمولی فقط نمونهها را تقسیم میکند و تضمینی برای حفظ نسبت کلاسها ندارد.
فرض کنید ۹۰ درصد داده مربوط به کلاس «عادی» و ۱۰ درصد مربوط به کلاس «فوری» باشد. ممکن است یک Fold تعداد بسیار کمی پیام فوری داشته باشد. در دیتاست کوچک حتی احتمال دارد یک کلاس در بعضی Foldها وجود نداشته باشد.
StratifiedKFold نسبت تقریبی کلاسها را در Foldهای مختلف حفظ میکند. مستندات رسمی Scikit-learn نیز این ابزار را نوعی K-Fold معرفی میکند که درصد نمونههای هر کلاس را در تقسیمها حفظ میکند.
مثال StratifiedKFold
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold
from sklearn.model_selection import cross_validate

X, y = make_classification(
    n_samples=1000,
    n_features=20,
    n_informative=8,
    weights=[0.90, 0.10],
    random_state=42,
)

model = LogisticRegression(
    max_iter=1000,
)

cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

results = cross_validate(
    model,
    X,
    y,
    cv=cv,
    scoring=[
        "accuracy",
        "precision",
        "recall",
        "f1",
    ],
    return_train_score=True,
)

print(
    "Validation F1:",
    results["test_f1"].mean(),
)

print(
    "Validation Recall:",
    results["test_recall"].mean(),
)
برای بیشتر مسائل طبقهبندی، StratifiedKFold انتخاب پیشفرض مناسبتری از KFold است.
انتخاب معیار ارزیابی
Cross-validation فقط نحوه تقسیم داده را تعیین میکند. همچنان باید معیار مناسبی انتخاب کنید.
برای طبقهبندی
معیارهای متداول:
- Accuracy
- Precision
- Recall
- F1
- Macro F1
- Weighted F1
- ROC-AUC
- Average Precision
در داده نامتوازن، Accuracy ممکن است گمراهکننده باشد. برای طبقهبندی چندکلاسه، f1_macro معمولاً گزینه مفیدی است؛ زیرا به همه کلاسها وزن برابر میدهد.
برای رگرسیون
معیارهای متداول:
- Mean Absolute Error
- Root Mean Squared Error
- R²
- Median Absolute Error
در Scikit-learn بعضی معیارهای خطا با پیشوند neg_ ارائه میشوند؛ زیرا سیستم امتیازدهی این کتابخانه امتیاز بزرگتر را بهتر در نظر میگیرد.
from sklearn.model_selection import cross_val_score

scores = cross_val_score(
    regression_model,
    X,
    y,
    cv=5,
    scoring="neg_mean_absolute_error",
)

mae_scores = -scores

print("Mean MAE:", mae_scores.mean())
ارزیابی همزمان چند معیار
تابع cross_validate امکان محاسبه چند معیار و ثبت زمان آموزش را فراهم میکند:
from sklearn.model_selection import cross_validate

results = cross_validate(
    model,
    X,
    y,
    cv=cv,
    scoring={
        "macro_f1": "f1_macro",
        "accuracy": "accuracy",
        "balanced_accuracy": "balanced_accuracy",
    },
    return_train_score=True,
    return_estimator=True,
    n_jobs=-1,
)

print(
    "Macro F1:",
    results["test_macro_f1"].mean(),
)

print(
    "Accuracy:",
    results["test_accuracy"].mean(),
)

print(
    "Training time:",
    results["fit_time"].mean(),
)
مقایسه امتیاز Training و Validation میتواند در تشخیص بیشبرازش و کمبرازش نیز کمک کند.
Repeated K-Fold چیست؟
در K-Fold معمولی فقط یک مجموعه تقسیم تولید میشود. در Repeated K-Fold، فرایند K-Fold چند بار با تقسیمهای تصادفی متفاوت تکرار میشود.
این روش برای دیتاستهای کوچک میتواند برآورد باثباتتری تولید کند، اما هزینه محاسباتی بالاتری دارد.
from sklearn.model_selection import RepeatedStratifiedKFold
from sklearn.model_selection import cross_val_score

cv = RepeatedStratifiedKFold(
    n_splits=5,
    n_repeats=3,
    random_state=42,
)

scores = cross_val_score(
    model,
    X,
    y,
    cv=cv,
    scoring="f1",
    n_jobs=-1,
)

print("Mean F1:", scores.mean())
print("F1 variation:", scores.std())RepeatedStratifiedKFold، Stratified K-Fold را با تصادفیسازی متفاوت چند بار تکرار میکند.
Leave-One-Out Cross-validation چیست؟
در Leave-One-Out یا LOOCV، در هر مرحله فقط یک نمونه برای اعتبارسنجی کنار گذاشته میشود و مدل روی تمام نمونههای دیگر آموزش میبیند.
اگر دیتاست ۵۰۰ نمونه داشته باشد، مدل ۵۰۰ مرتبه آموزش داده میشود.
مزایا:
- تقریباً تمام داده برای آموزش هر مرحله استفاده میشود.
- برای دیتاست بسیار کوچک قابل بررسی است.
معایب:
- هزینه محاسباتی زیاد
- نوسان بالای برآورد در بعضی مسائل
- نامناسب برای مدلهای سنگین
- ارزیابی هر مرحله فقط بر یک نمونه انجام میشود
در بیشتر پروژههای عملی، K-Fold با ۵ یا ۱۰ Fold انتخاب کارآمدتری است.
GroupKFold چیست؟
گاهی چند ردیف به یک موجودیت مشترک تعلق دارند. برای مثال:
- چند پیام از یک مشتری
- چند تصویر از یک محصول
- چند درخواست از یک سازمان
- چند رکورد از یک دستگاه
- چند بخش از یک سند
- چند فریم از یک ویدیو
اگر نمونههای یک مشتری هم در Training و هم در Validation قرار بگیرند، مدل ممکن است ویژگیهای همان مشتری را یاد بگیرد و نتیجه بیشازحد خوشبینانه شود.
GroupKFold تضمین میکند گروههای یکسان میان آموزش و اعتبارسنجی تقسیم نشوند. هر گروه در کل فرایند دقیقاً یک بار در بخش ارزیابی قرار میگیرد.
مثال GroupKFold
import numpy as np

from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GroupKFold
from sklearn.model_selection import cross_validate

X = np.array(
    [
        [0.2, 1.1],
        [0.3, 1.0],
        [1.5, 0.4],
        [1.6, 0.5],
        [0.8, 1.4],
        [0.9, 1.3],
        [1.9, 0.2],
        [2.0, 0.3],
    ]
)

y = np.array(
    [0, 0, 1, 1, 0, 0, 1, 1]
)

customer_ids = np.array(
    [
        "customer-1",
        "customer-1",
        "customer-2",
        "customer-2",
        "customer-3",
        "customer-3",
        "customer-4",
        "customer-4",
    ]
)

cv = GroupKFold(
    n_splits=4,
)

model = LogisticRegression()

results = cross_validate(
    model,
    X,
    y,
    groups=customer_ids,
    cv=cv,
    scoring="accuracy",
)

print(results["test_score"])
اگر هدف پیشبینی برای مشتریان جدید است، تقسیم بر اساس مشتری ضروری است. تقسیم تصادفی ردیفها سؤال متفاوتی را ارزیابی میکند: عملکرد مدل برای پیام جدید از مشتریانی که قبلاً بخشی از داده آنها را دیده است.
StratifiedGroupKFold چیست؟
گاهی همزمان دو نیاز داریم:
- نمونههای یک گروه نباید میان Training و Validation پخش شوند.
- نسبت کلاسها تا حد امکان در Foldها حفظ شود.
در این شرایط میتوان از StratifiedGroupKFold استفاده کرد:
from sklearn.model_selection import StratifiedGroupKFold

cv = StratifiedGroupKFold(
    n_splits=5,
    shuffle=True,
    random_state=42,
)

results = cross_validate(
    model,
    X,
    y,
    groups=customer_ids,
    cv=cv,
    scoring="f1_macro",
)
این روش تلاش میکند Stratification را در کنار جدا نگهداشتن گروهها اجرا کند.
اگر تعداد گروهها یا نمونههای یک کلاس کم باشد، حفظ کامل نسبت کلاسها ممکن نیست. بنابراین توزیع هر Fold را پس از تقسیم بررسی کنید.
Cross-validation برای دادههای زمانی
استفاده از KFold تصادفی برای دادههای زمانی میتواند اطلاعات آینده را وارد آموزش گذشته کند.
نمونههای داده زمانی:
- فروش روزانه
- مصرف API
- قیمتها
- تعداد درخواستهای پشتیبانی
- گزارش خطا
- رفتار کاربران
- تقاضای محصول
در یک ارزیابی معتبر، مدل باید روی گذشته آموزش ببیند و آینده را پیشبینی کند.
TimeSeriesSplit برای دادههای مرتبشده زمانی طراحی شده است. مستندات Scikit-learn تأکید میکند روشهای عادی Cross-validation برای چنین دادههایی ممکن است باعث آموزش روی آینده و ارزیابی روی گذشته شوند.
مثال TimeSeriesSplit
from sklearn.model_selection import TimeSeriesSplit
from sklearn.model_selection import cross_validate
from sklearn.ensemble import RandomForestRegressor

model = RandomForestRegressor(
    n_estimators=200,
    random_state=42,
)

cv = TimeSeriesSplit(
    n_splits=5,
)

results = cross_validate(
    model,
    X,
    y,
    cv=cv,
    scoring="neg_mean_absolute_error",
)

mae_scores = -results["test_score"]

print("Fold MAE:", mae_scores)
print("Mean MAE:", mae_scores.mean())
در مسائل زمانی باید موارد زیر را نیز بررسی کنید:
- فاصله زمانی میان آموزش و ارزیابی
- فصلها و مناسبتها
- تغییر قیمت یا سیاست محصول
- تأخیر در دسترسشدن ویژگیها
- پنجره ثابت یا در حال گسترش
- Data Drift
- استفاده ناخواسته از اطلاعات آینده
TimeSeriesSplit همیشه کافی نیست
حتی با TimeSeriesSplit ممکن است نشت زمانی رخ دهد.
فرض کنید میخواهید تعداد درخواستهای فردا را پیشبینی کنید، اما یکی از ویژگیها «مجموع درخواستهای هفته جاری» است و هنگام پیشبینی هنوز هفته تمام نشده است. چنین ویژگیای ممکن است بخشی از آینده را در خود داشته باشد.
برای هر ویژگی این سؤال را بپرسید:
آیا این مقدار دقیقاً در لحظه پیشبینی در دسترس خواهد بود؟
اگر پاسخ منفی است، آن ویژگی نباید در آموزش استفاده شود.
Cross-validation و Data Leakage
یکی از بزرگترین اشتباهات این است که پیشپردازش پیش از Cross-validation روی کل داده اجرا شود.
مثال اشتباه:
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()

X_scaled = scaler.fit_transform(X)

scores = cross_val_score(
    model,
    X_scaled,
    y,
    cv=5,
)
در این کد، میانگین و پراکندگی کل داده، از جمله Fold اعتبارسنجی، وارد پیشپردازش شدهاند.
راه درست استفاده از Pipeline است:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression

pipeline = Pipeline(
    [
        (
            "scaler",
            StandardScaler(),
        ),
        (
            "model",
            LogisticRegression(
                max_iter=1000,
            ),
        ),
    ]
)

scores = cross_val_score(
    pipeline,
    X,
    y,
    cv=5,
    scoring="f1_macro",
)
Pipeline مراحل را درون هر Fold بهطور مستقل آموزش میدهد. Scikit-learn نیز Pipeline را ابزاری برای کنار هم قراردادن مراحلی معرفی میکند که باید بهصورت مشترک Cross-validate شوند.
پیشپردازش متن فارسی بدون نشت داده
برای دستهبندی پیامهای فارسی، Vectorizer باید فقط روی بخش Training هر Fold آموزش ببیند:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold
from sklearn.model_selection import cross_validate
from sklearn.pipeline import Pipeline
messages = [
"قیمت اشتراک سازمانی چقدر است",
"برای خرید اعتبار راهنمایی میخواهم",
"پاسخ API خالی برمیگردد",
"سرویس خطای اتصال میدهد",
"فاکتور پرداخت صادر نشده است",
"چطور صورتحساب را دانلود کنم",
"قابلیت جستجو را اضافه کنید",
"رابط کاربری میتواند سادهتر باشد",
]
labels = [
"sales",
"sales",
"technical",
"technical",
"billing",
"billing",
"feedback",
"feedback",
]
pipeline = Pipeline(
[
(
"tfidf",
TfidfVectorizer(
ngram_range=(1, 2),
min_df=1,
),
),
(
"classifier",
LogisticRegression(
max_iter=1000,
),
),
]
)
cv = StratifiedKFold(
n_splits=2,
shuffle=True,
random_state=42,
)
results = cross_validate(
pipeline,
messages,
labels,
cv=cv,
scoring="f1_macro",
return_train_score=True,
)
print(
"Train F1:",
results["train_score"],
)
print(
"Validation F1:",
results["test_score"],
)این مجموعه کوچک فقط برای نمایش کد است. ارزیابی واقعی به داده بیشتر، تنوع زبانی، نمونههای مرزی و برچسبگذاری معتبر نیاز دارد.
Cross-validation برای تنظیم Hyperparameter
میتوان از GridSearchCV برای بررسی ترکیبهای مختلف تنظیمات استفاده کرد:
from sklearn.model_selection import GridSearchCV

parameters = {
    "tfidf__ngram_range": [
        (1, 1),
        (1, 2),
    ],
    "tfidf__min_df": [
        1,
        2,
    ],
    "classifier__C": [
        0.1,
        1,
        10,
    ],
}

search = GridSearchCV(
    estimator=pipeline,
    param_grid=parameters,
    scoring="f1_macro",
    cv=cv,
    n_jobs=-1,
    refit=True,
)

search.fit(
    messages,
    labels,
)

print(search.best_params_)
print(search.best_score_)
best_score_ نتیجه Cross-validation داخلی است و نباید بهعنوان نتیجه نهایی Production گزارش شود. پس از انتخاب تنظیمات، مدل باید روی Test Set مستقلی ارزیابی شود.
Nested Cross-validation چیست؟
اگر از همان Cross-validation هم برای انتخاب Hyperparameter و هم برای گزارش عملکرد استفاده کنید، نتیجه میتواند خوشبینانه باشد.
Nested Cross-validation از دو حلقه استفاده میکند:
- حلقه داخلی برای انتخاب Hyperparameter
- حلقه خارجی برای برآورد عملکرد مدل انتخابشده
مثال Nested Cross-validation
from sklearn.model_selection import GridSearchCV
from sklearn.model_selection import StratifiedKFold
from sklearn.model_selection import cross_val_score

inner_cv = StratifiedKFold(
    n_splits=4,
    shuffle=True,
    random_state=10,
)

outer_cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=20,
)

search = GridSearchCV(
    pipeline,
    parameters,
    cv=inner_cv,
    scoring="f1_macro",
    n_jobs=-1,
)

nested_scores = cross_val_score(
    search,
    messages,
    labels,
    cv=outer_cv,
    scoring="f1_macro",
    n_jobs=-1,
)

print("Nested CV scores:", nested_scores)
print("Mean:", nested_scores.mean())
print("Variation:", nested_scores.std())
Nested Cross-validation بیشتر برای دیتاستهای محدود، مقایسه علمی مدلها و زمانی مناسب است که انتخاب Hyperparameter بخش مهمی از فرایند باشد.
برای پروژههای بزرگتر ممکن است یک Validation Set و Test Set مستقل از نظر محاسباتی عملیتر باشند.
آیا بعد از Cross-validation هنوز Test Set لازم است؟
در بسیاری از پروژهها بله.
Cross-validation معمولاً برای موارد زیر استفاده میشود:
- مقایسه الگوریتمها
- انتخاب ویژگی
- انتخاب Hyperparameter
- تنظیم Pipeline
- بررسی پایداری
پس از پایان این تصمیمها، یک Test Set دستنخورده برای ارزیابی نهایی استفاده میشود.
اگر بارها نتیجه Test Set را ببینید و مدل را تغییر دهید، Test Set دیگر مستقل نیست و ممکن است فرایند توسعه روی آن Overfit شود.
گوگل نیز توصیه میکند Training، Validation و Test بهدرستی جدا شوند و نمونههای تکراری Training از مجموعههای Validation و Test حذف شوند.
آموزش مدل نهایی پس از Cross-validation
پس از انتخاب الگوریتم و Hyperparameter:
- ارزیابی و تنظیمات را نهایی کنید.
- Test Set را فقط یک بار برای گزارش نهایی اجرا کنید.
- در صورت تأیید نتیجه، مدل نهایی را با داده توسعه موجود آموزش دهید.
- Pipeline کامل را ذخیره کنید.
- نسخه داده، کد و تنظیمات را ثبت کنید.
- عملکرد Production را پایش کنید.
best_pipeline = search.best_estimator_

best_pipeline.fit(
    X_development,
    y_development,
)

final_prediction = best_pipeline.predict(
    X_test,
)
Out-of-Fold Prediction چیست؟
در Cross-validation هر نمونه زمانی پیشبینی میشود که در Fold آموزش حضور ندارد. مجموعه این پیشبینیها با عنوان Out-of-Fold Predictions شناخته میشود.
این پیشبینیها برای موارد زیر مفیدند:
- ساخت Confusion Matrix
- تحلیل نمونههای خطادار
- تنظیم آستانه
- ساخت مدلهای Stacking
- مقایسه منصفانه خروجیها
from sklearn.model_selection import cross_val_predict
from sklearn.metrics import classification_report
from sklearn.metrics import confusion_matrix

oof_predictions = cross_val_predict(
    pipeline,
    messages,
    labels,
    cv=cv,
    method="predict",
)

print(
    confusion_matrix(
        labels,
        oof_predictions,
    )
)

print(
    classification_report(
        labels,
        oof_predictions,
        zero_division=0,
    )
)
Out-of-Fold Predictions جای Test Set نهایی را نمیگیرند، اما برای تحلیل خطای داده توسعه بسیار مفید هستند.
مقایسه چند مدل با تقسیمهای یکسان
برای مقایسه منصفانه، همه مدلها باید روی Foldهای یکسان ارزیابی شوند:
from sklearn.linear_model import LogisticRegression
from sklearn.naive_bayes import MultinomialNB
from sklearn.svm import LinearSVC

models = {
    "logistic_regression": LogisticRegression(
        max_iter=1000,
    ),
    "naive_bayes": MultinomialNB(),
    "linear_svm": LinearSVC(),
}

for name, classifier in models.items():
    candidate = Pipeline(
        [
            (
                "tfidf",
                TfidfVectorizer(
                    ngram_range=(1, 2),
                ),
            ),
            (
                "model",
                classifier,
            ),
        ]
    )

    scores = cross_val_score(
        candidate,
        messages,
        labels,
        cv=cv,
        scoring="f1_macro",
    )

    print(
        name,
        scores.mean(),
        scores.std(),
    )
فقط میانگین بالاتر را انتخاب نکنید. موارد زیر را نیز بسنجید:
- پراکندگی امتیازها
- زمان آموزش
- زمان پیشبینی
- مصرف حافظه
- توضیحپذیری
- کیفیت کلاسهای مهم
- سادگی استقرار
- هزینه نگهداری
Cross-validation برای مدلهای هوش مصنوعی مولد
در مدلهای مولد، مفهوم Cross-validation دقیقاً مشابه مدلهای کلاسیک نیست؛ زیرا معمولاً مدل پایه را داخل پروژه آموزش نمیدهید. بااینحال میتوان همان منطق را برای ارزیابی مدل، پرامپت و گردش کار استفاده کرد.
برای مثال، یک مجموعه شامل پیامهای واقعی مشتریان و خروجی مطلوب تهیه کنید و آن را به چند Fold تقسیم کنید.
در هر مرحله:
- نمونههای آموزشی یا Few-shot از Foldهای آموزش انتخاب شوند.
- پرامپت فقط با همان Foldها تنظیم شود.
- مدل روی Fold کنارگذاشتهشده ارزیابی شود.
- نتیجه تمام Foldها با هم ترکیب شود.
- یک Holdout Set مستقل برای ارزیابی نهایی باقی بماند.
این روش به کاهش تنظیم بیشازحد پرامپت روی چند مثال ثابت کمک میکند.
اتصال ارزیابی مدل به API درواره
API درواره با ساختار سازگار با OpenAI امکان آزمایش مدلهای مختلف را با یک رابط مشترک فراهم میکند.
آدرس پایه:
https://api.darvareh.ir/v1نصب کتابخانه:
pip install openai pydantic scikit-learnتنظیم متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
اتصال اولیه:
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)

MODEL_ID = os.environ["DARVAREH_MODEL"]
مثال ارزیابی دستهبندی با مدل زبانی
from typing import Literal
from pydantic import BaseModel
class ClassificationResult(BaseModel):
category: Literal[
"sales",
"technical",
"billing",
"feedback",
"other",
]
def classify_message(
message: str,
examples: list[dict],
) -> str:
examples_text = "\n".join(
(
f'پیام: {item["text"]}\n'
f'دسته: {item["label"]}'
)
for item in examples
)
completion = client.chat.completions.create(
model=MODEL_ID,
temperature=0,
messages=[
{
"role": "system",
"content": (
"موضوع اصلی پیام مشتری را تشخیص بده. "
"فقط JSON معتبر با کلید category برگردان."
),
},
{
"role": "user",
"content": (
f"نمونهها:\n{examples_text}\n\n"
f"پیام جدید:\n{message}"
),
},
],
)
content = completion.choices[0].message.content
if not content:
raise ValueError(
"مدل پاسخ معتبری برنگرداند."
)
result = ClassificationResult.model_validate_json(
content
)
return result.categoryدر پیادهسازی Cross-validation باید مثالهای Few-shot فقط از Fold آموزش انتخاب شوند. استفاده از نمونه ارزیابی داخل پرامپت Data Leakage محسوب میشود.
ارزیابی چند مدل درواره
میتوانید شناسه مدل را به تابع بدهید و چند مدل را روی Foldهای یکسان مقایسه کنید:
model_ids = [
    "MODEL_ID_A",
    "MODEL_ID_B",
    "MODEL_ID_C",
]

results = {}

for model_id in model_ids:
    fold_scores = evaluate_model_with_folds(
        model_id=model_id,
        dataset=evaluation_data,
        n_splits=5,
    )

    results[model_id] = {
        "mean_score": sum(fold_scores)
        / len(fold_scores),
        "fold_scores": fold_scores,
    }

print(results)شناسهها را باید از فهرست فعلی مدلهای درواره انتخاب کنید.
در مقایسه مدلهای API علاوه بر کیفیت، این معیارها را ثبت کنید:
- هزینه ورودی و خروجی
- زمان پاسخ
- نرخ Timeout
- پاسخ خالی
- JSON نامعتبر
- ثبات پاسخ
- تعداد Retry
- کیفیت زبان فارسی
- مصرف توکن
- عملکرد روی کلاسهای کمتعداد
برای شروع میتوانید مستندات API درواره را مطالعه کنید.
Cross-validation برای RAG
در سامانه RAG میتوان پرسشها را به Foldهای مختلف تقسیم کرد، اما باید مراقب ارتباط اسناد و پرسشها بود.
اگر چند سؤال تقریباً یکسان درباره یک سند دارید، بهتر است آنها در یک گروه قرار گیرند. در غیر این صورت، یک سؤال بسیار مشابه ممکن است در Training و Validation حضور داشته باشد.
موارد قابل ارزیابی:
- Recall بازیابی
- دقت Reranker
- صحت استناد
- کاملبودن پاسخ
- عدم استفاده از اطلاعات خارج از منبع
- زمان پاسخ
- هزینه کل درخواست
- نرخ پاسخ «اطلاعات کافی نیست»
برای ارزیابی تعمیم به اسناد جدید میتوانید اسناد را گروهبندی کنید و از GroupKFold بر اساس شناسه سند استفاده کنید.
Cross-validation برای Agentهای هوش مصنوعی
در Agentها نتیجه فقط متن نهایی نیست. باید مسیر اجرا نیز ارزیابی شود:
- انتخاب ابزار درست
- تعداد فراخوانی ابزار
- پارامترهای ارسالشده
- رعایت قواعد گردش کار
- موفقیت نهایی وظیفه
- درخواست تأیید در مرحله لازم
- جلوگیری از اجرای اقدام نامعتبر
- هزینه و زمان کل
میتوان سناریوها را بر اساس نوع فرایند، مشتری یا ابزار گروهبندی کرد تا نمونههای بسیار مشابه در Foldهای متفاوت قرار نگیرند.
چه زمانی Cross-validation مناسب نیست؟
Cross-validation همیشه بهترین انتخاب نیست.
ممکن است از آن صرفنظر کنید اگر:
- دیتاست بسیار بزرگ و نماینده باشد.
- آموزش هر مدل بسیار گران باشد.
- تقسیم زمانی تنها ارزیابی معتبر باشد.
- داده دائماً در حال تغییر باشد.
- اجرای مدل از طریق API هزینه زیادی ایجاد کند.
- یک مجموعه Holdout بزرگ و مستقل دارید.
- هدف آزمایش نهایی Production است.
در چنین شرایطی میتوان از یک Validation Set ثابت، ارزیابی زمانی، نمونهبرداری کنترلشده یا تعداد Fold کمتر استفاده کرد.
اشتباهات رایج در Cross-validation
استفاده از KFold معمولی برای داده نامتوازن
برای طبقهبندی معمولاً StratifiedKFold مناسبتر است.
برزدن داده زمانی
Shuffle در دادههای زمانی میتواند اطلاعات آینده را وارد آموزش کند.
نادیدهگرفتن گروهها
پیامهای یک مشتری یا بخشهای یک سند نباید بدون بررسی میان Foldها پخش شوند.
پیشپردازش کل داده قبل از Cross-validation
Scaler، Vectorizer، Imputer و Feature Selector باید داخل Pipeline باشند.
تنظیم مدل و گزارش نتیجه روی همان Foldها
برای برآورد دقیقتر میتوان از Test Set مستقل یا Nested Cross-validation استفاده کرد.
مقایسه مدلها روی تقسیمهای متفاوت
مدلها باید روی Foldهای یکسان مقایسه شوند.
گزارش فقط میانگین
پراکندگی و امتیاز هر Fold نیز باید بررسی شوند.
استفاده از معیار نامناسب
Accuracy برای داده نامتوازن میتواند نتیجه گمراهکننده ایجاد کند.
نمونههای تکراری میان Foldها
نمونه تکراری یا بسیار مشابه باعث نشت داده و نتیجه غیرواقعی میشود.
تعداد Fold نامناسب
اگر هر کلاس یا گروه نمونه کمی دارد، تعداد زیاد Fold ممکن است ارزیابی را ناپایدار کند.
استفاده مکرر از Test Set
Test Set نباید برای انتخاب تنظیمات استفاده شود.
راهنمای انتخاب روش مناسب
| نوع داده | روش پیشنهادی |
|---|---|
| طبقهبندی متعادل | KFold یا StratifiedKFold |
| طبقهبندی نامتوازن | StratifiedKFold |
| رگرسیون معمولی | KFold |
| چند رکورد برای هر مشتری | GroupKFold |
| داده گروهی و نامتوازن | StratifiedGroupKFold |
| داده مرتبشده زمانی | TimeSeriesSplit |
| دیتاست کوچک و نتیجه حساس | Repeated K-Fold |
| تنظیم گسترده Hyperparameter | Nested Cross-validation |
| مدل بسیار سنگین | Holdout یا Fold کمتر |
| RAG با چند سؤال از هر سند | GroupKFold بر اساس سند |
چکلیست اجرای Cross-validation
قبل از اعتماد به نتیجه، این موارد را بررسی کنید:
- واحد واقعی استقلال نمونهها مشخص شده است.
- نوع تقسیم با ساختار داده هماهنگ است.
- داده زمانی Shuffle نشده است.
- نسبت کلاسها در Foldها بررسی شده است.
- گروه مشترک در Training و Validation وجود ندارد.
- پیشپردازش داخل Pipeline انجام میشود.
- نمونههای تکراری حذف شدهاند.
- معیار اصلی پیش از آزمایش انتخاب شده است.
- میانگین و پراکندگی گزارش میشوند.
- همه مدلها روی Foldهای یکسان ارزیابی میشوند.
- Test Set مستقل باقی مانده است.
- نسخه داده و تنظیمات Split ثبت شده است.
- هزینه و زمان Cross-validation اندازهگیری شدهاند.
- خطاهای هر Fold جداگانه تحلیل شدهاند.
پرسشهای متداول
Cross-validation چیست؟
روشی برای ارزیابی مدل روی چند تقسیم متفاوت داده است تا عملکرد آن با اطمینان بیشتری روی نمونههای دیدهنشده برآورد شود.
K-Fold چیست؟
در K-Fold داده به K بخش تقسیم میشود. مدل K مرتبه آموزش میبیند و هر بار یک بخش متفاوت برای اعتبارسنجی استفاده میشود.
KFold بهتر است یا StratifiedKFold؟
برای بیشتر مسائل طبقهبندی، StratifiedKFold مناسبتر است؛ زیرا نسبت کلاسها را در Foldها حفظ میکند. برای رگرسیون معمولاً KFold استفاده میشود.
مقدار مناسب K چقدر است؟
۵ و ۱۰ انتخابهای رایجاند. مقدار مناسب به اندازه داده، تعداد نمونه هر کلاس و هزینه آموزش بستگی دارد.
آیا Cross-validation جای Test Set را میگیرد؟
معمولاً خیر. Cross-validation برای توسعه و انتخاب مدل استفاده میشود و Test Set مستقل برای ارزیابی نهایی باقی میماند.
آیا باید قبل از Cross-validation داده را نرمالسازی کنیم؟
نرمالسازی لازم است، اما Scaler باید داخل Pipeline قرار گیرد تا در هر Fold فقط روی داده آموزش Fit شود.
برای داده زمانی از چه روشی استفاده کنیم؟
از TimeSeriesSplit یا یک روش Walk-forward متناسب با زمان استفاده کنید. KFold تصادفی ممکن است باعث نشت اطلاعات آینده شود.
GroupKFold چه کاربردی دارد؟
زمانی استفاده میشود که چند نمونه به یک مشتری، کاربر، سند، دستگاه یا موجودیت مشترک تعلق داشته باشند و نباید میان Training و Validation پخش شوند.
آیا Cross-validation از Overfitting جلوگیری میکند؟
Cross-validation به تشخیص و کاهش انتخاب بیشازحد خوشبینانه کمک میکند، اما بهتنهایی مانع Overfitting مدل نمیشود. داده مناسب، Regularization و ارزیابی مستقل همچنان ضروریاند.
آیا میتوان مدلهای زبانی را با Cross-validation ارزیابی کرد؟
بله. میتوان نمونههای Few-shot، پرامپتها یا سناریوهای ارزیابی را به Foldهای جدا تقسیم و مدلها را روی بخشهای دیدهنشده مقایسه کرد.
جمعبندی
Cross-validation یکی از مهمترین ابزارهای ارزیابی و انتخاب مدل در یادگیری ماشین است. این روش با اجرای مدل روی چند تقسیم متفاوت، وابستگی نتیجه به یک Train/Test Split تصادفی را کاهش میدهد.
برای استفاده صحیح:
- نوع Cross-validation را بر اساس ساختار داده انتخاب کنید.
- برای طبقهبندی از StratifiedKFold شروع کنید.
- رکوردهای یک مشتری یا سند را با GroupKFold جدا نگه دارید.
- برای داده زمانی از TimeSeriesSplit استفاده کنید.
- تمام پیشپردازشها را داخل Pipeline قرار دهید.
- مدلها را روی Foldهای یکسان مقایسه کنید.
- میانگین و پراکندگی امتیازها را گزارش دهید.
- Test Set مستقل را برای ارزیابی نهایی حفظ کنید.
- در تنظیمات پیچیده از Nested Cross-validation استفاده کنید.
- هزینه، سرعت و ثبات مدل را در کنار کیفیت بسنجید.
با استفاده از API یکپارچه درواره میتوانید چند مدل هوش مصنوعی را روی مجموعه ارزیابی و Foldهای یکسان آزمایش کنید و بدون ایجاد اتصال جداگانه برای هر ارائهدهنده، کیفیت، سرعت و هزینه مدلها را مقایسه کنید.
مقالات مرتبط
- بیشبرازش و کمبرازش چیست؟
- ماتریس درهمریختگی و معیارهای ارزیابی
- آموزش Scikit-learn با پایتون
- یادگیری ماشین چیست؟
- ارزیابی مدلهای هوش مصنوعی و طراحی Evals
- آموزش Logistic Regression
- راهنمای خروجی ساختاریافته در API هوش مصنوعی
- آموزش اتصال API هوش مصنوعی به نرمافزار
منابع
- Scikit-learn: Cross-validation
- Scikit-learn: StratifiedKFold
- Scikit-learn: GroupKFold
- Scikit-learn: TimeSeriesSplit
- Scikit-learn: Pipeline
- Google Machine Learning: Dividing Datasets
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



