
Transfer Learning چیست؟ آموزش یادگیری انتقالی و Fine-tuning با PyTorch
یادگیری انتقالی امکان استفاده از دانش یک مدل ازپیشآموزشدیده برای مسئلهای جدید را فراهم میکند. در این راهنما Transfer Learning و Fine-tuning را با مثال عملی PyTorch یاد میگیرید.

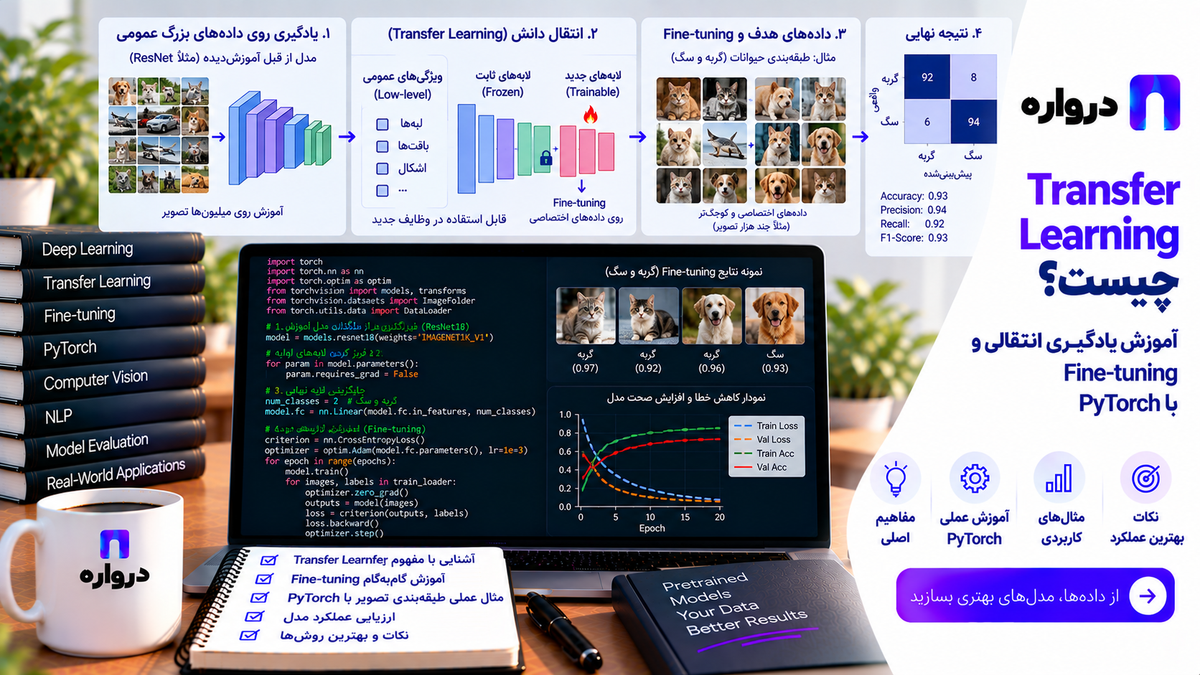
آموزش یک شبکه عصبی از ابتدا معمولاً به حجم زیادی داده برچسبخورده، سختافزار قدرتمند و زمان طولانی نیاز دارد. بااینحال بسیاری از پروژهها میتوانند از دانشی استفاده کنند که یک مدل قبلاً روی مجموعه بزرگی از دادهها یاد گرفته است.
این روش یادگیری انتقالی یا Transfer Learning نام دارد.
در یادگیری انتقالی، مدلی را که قبلاً برای یک مسئله گسترده آموزش دیده است برمیداریم و آن را برای وظیفه جدید خود به کار میگیریم.
برای مثال، یک مدل بینایی که قبلاً شکلها، بافتها، لبهها و اشیای مختلف را از میلیونها تصویر یاد گرفته است، میتواند نقطه شروع مناسبی برای ساخت این مدلها باشد:
- دستهبندی تصاویر محصول
- تشخیص بستهبندی معیوب
- شناسایی نوع کالا
- طبقهبندی قطعات صنعتی
- تشخیص سبک تصویر
- دستهبندی اسناد اسکنشده
- تشخیص نوع پوشش گیاهی
- طبقهبندی فریمهای ویدیو
در این مقاله میآموزید:
- Transfer Learning چیست؟
- مدل ازپیشآموزشدیده چیست؟
- تفاوت Feature Extraction و Fine-tuning چیست؟
- چه زمانی باید لایهها را Freeze کنیم؟
- چگونه یک مدل Transfer Learning با PyTorch بسازیم؟
- چگونه از بیشبرازش جلوگیری کنیم؟
- یادگیری انتقالی در متن، صوت و ویدیو چگونه استفاده میشود؟
- تفاوت Transfer Learning، Fine-tuning، RAG و استفاده از API چیست؟
- چه زمانی استفاده از مدل چندوجهی درواره از آموزش مدل اختصاصی مناسبتر است؟
Transfer Learning چیست؟
Transfer Learning روشی است که در آن دانش آموختهشده توسط یک مدل برای حل مسئلهای جدید استفاده میشود.
فرض کنید یک شبکه عصبی قبلاً روی مجموعه بسیار بزرگی از تصاویر آموزش دیده است. لایههای ابتدایی این شبکه معمولاً الگوهای عمومی مانند موارد زیر را یاد میگیرند:
- لبهها
- رنگها
- بافتها
- شکلهای ساده
- بخشهای مختلف اشیا
- ترکیبهای بصری پیچیدهتر
برای ساخت یک طبقهبند اختصاصی لازم نیست مدل تمام این مفاهیم را دوباره از ابتدا یاد بگیرد. میتوان بخش اصلی شبکه را حفظ کرد و فقط خروجی آن را با کلاسهای جدید تطبیق داد.
راهنمای رسمی TensorFlow، یادگیری انتقالی را استفاده از ویژگیهای آموختهشده در یک مسئله برای مسئلهای جدید توصیف میکند.
مدل ازپیشآموزشدیده چیست؟
مدل ازپیشآموزشدیده یا Pre-trained Model مدلی است که قبلاً روی یک مجموعه داده بزرگ آموزش دیده و وزنهای آن منتشر شده است.
نمونههای رایج در بینایی ماشین:
- ResNet
- EfficientNet
- MobileNet
- ConvNeXt
- Vision Transformer
- Swin Transformer
- Mask R-CNN
در پردازش متن نیز مدلهایی مانند BERT و مدلهای زبانی بزرگ، نمونههایی از مدلهای ازپیشآموزشدیده هستند.
در صوت و ویدیو نیز میتوان از شبکههایی استفاده کرد که قبلاً الگوهای عمومی صدا، گفتار، حرکت یا فریمهای تصویری را یاد گرفتهاند.
چرا Transfer Learning اهمیت دارد؟
نیاز کمتر به داده
مدل قبلاً ویژگیهای عمومی را یاد گرفته است. بنابراین برای مسئله جدید معمولاً به داده کمتری نسبت به آموزش از ابتدا نیاز دارید.
زمان آموزش کمتر
بخش قابل توجهی از وزنهای مدل از قبل آماده است. در بعضی پروژهها فقط لایه خروجی آموزش داده میشود.
هزینه پردازشی کمتر
آموزش کامل مدلهای عمیق میتواند هزینهبر باشد. یادگیری انتقالی مقدار پردازش موردنیاز را کاهش میدهد.
عملکرد بهتر روی دیتاست کوچک
وقتی داده محدود است، آموزش از ابتدا ممکن است به بیشبرازش منجر شود. استفاده از نمایش آموختهشده مدل بزرگ میتواند تعمیمپذیری را بهتر کند.
ساخت سریع نمونه اولیه
تیم میتواند در زمان کوتاهتری امکانپذیری یک ایده را بررسی کند.
TensorFlow توضیح میدهد که آموزش مدلهای طبقهبندی تصویر از ابتدا معمولاً به داده و توان پردازشی زیادی نیاز دارد و Transfer Learning با استفاده مجدد از مدل آموزشدیده این مسیر را کوتاهتر میکند.
یک مثال ساده از یادگیری انتقالی
فرض کنید میخواهیم تصاویر بستهبندی را در دو کلاس قرار دهیم:
acceptabledamaged
اگر فقط چند هزار تصویر اختصاصی داشته باشیم، آموزش یک شبکه بزرگ از ابتدا احتمالاً به نتیجه پایدار نمیرسد.
راه بهتر:
- یک مدل ResNet ازپیشآموزشدیده انتخاب کنیم.
- لایههای اصلی آن را Freeze کنیم.
- لایه خروجی را با یک طبقهبند دوکلاسه جایگزین کنیم.
- ابتدا فقط طبقهبند جدید را آموزش دهیم.
- در صورت نیاز، تعدادی از لایههای انتهایی را آزاد و Fine-tune کنیم.
- مدل را روی Test Set واقعی ارزیابی کنیم.
تفاوت Feature Extraction و Fine-tuning
دو روش اصلی استفاده از مدل ازپیشآموزشدیده وجود دارد.
Feature Extraction
در این روش بدنه اصلی مدل ثابت میماند و فقط لایه جدید آموزش داده میشود.
مراحل:
- بارگذاری وزنهای آماده
- Freeze کردن Backbone
- جایگزینی Head
- آموزش Head جدید
مزایا:
- آموزش سریعتر
- مصرف حافظه کمتر
- خطر کمتر بیشبرازش
- مناسب برای دیتاست کوچک
- نقطه شروع خوب برای پروژه
محدودیت:
- مدل اصلی با ویژگیهای تخصصی دامنه جدید تطبیق کامل پیدا نمیکند.
Fine-tuning
در این روش بخشی یا تمام لایههای مدل ازپیشآموزشدیده با داده جدید دوباره آموزش میبینند.
مزایا:
- سازگاری بیشتر با دامنه اختصاصی
- احتمال دستیابی به کیفیت بالاتر
- مناسب برای تفاوت بیشتر میان داده اصلی و هدف
محدودیتها:
- هزینه محاسباتی بیشتر
- نیاز به تنظیم دقیق نرخ یادگیری
- خطر بیشبرازش
- احتمال تخریب دانش قبلی مدل
- نیاز به داده بیشتر
تفاوت Transfer Learning و Fine-tuning
Fine-tuning یکی از روشهای اجرای Transfer Learning است.
Transfer Learning مفهوم کلی انتقال دانش است، اما Fine-tuning به بهروزرسانی وزنهای مدل ازپیشآموزشدیده با داده جدید اشاره دارد.
هر Fine-tuning نوعی Transfer Learning است، اما هر Transfer Learning الزاماً شامل آموزش دوباره تمام لایهها نیست.
چه زمانی Feature Extraction مناسبتر است؟
Feature Extraction معمولاً انتخاب بهتری است اگر:
- دیتاست کوچک باشد.
- مسئله جدید به داده اولیه مدل شباهت داشته باشد.
- سختافزار محدود باشد.
- به نمونه اولیه سریع نیاز داشته باشید.
- خطر بیشبرازش بالا باشد.
- مدل پایه ویژگیهای عمومی مناسبی داشته باشد.
برای مثال، اگر مدل پایه روی تصاویر عمومی آموزش دیده و مسئله شما طبقهبندی تصاویر محصول است، ویژگیهای آن احتمالاً مفید خواهند بود.
چه زمانی Fine-tuning لازم است؟
Fine-tuning را بررسی کنید اگر:
- دامنه جدید با داده اولیه تفاوت قابل توجهی دارد.
- داده برچسبخورده کافی دارید.
- Feature Extraction به سقف کیفیت رسیده است.
- تصاویر بسیار تخصصی هستند.
- تفاوت کلاسها ظریف است.
- منابع پردازشی مناسب در اختیار دارید.
بهتر است Fine-tuning از لایههای انتهایی آغاز شود، نه اینکه از همان ابتدا تمام شبکه آزاد شود.
انتخاب مدل پایه
مدل پایه را فقط بر اساس دقت یک Benchmark انتخاب نکنید.
معیارهای مهم:
- شباهت داده اولیه به مسئله جدید
- اندازه مدل
- سرعت Inference
- حافظه موردنیاز
- رزولوشن ورودی
- مجوز استفاده
- پشتیبانی کتابخانه
- امکان اجرا روی سرور یا موبایل
- کیفیت روی داده واقعی
- تأخیر مورد قبول محصول
مدل کوچک یا بزرگ؟
مدل بزرگتر ممکن است کیفیت بیشتری داشته باشد، اما:
- کندتر است.
- حافظه بیشتری مصرف میکند.
- هزینه استقرار بیشتری دارد.
- روی دیتاست کوچک ممکن است Overfit شود.
- برای دستگاه Edge مناسب نیست.
برای کاربرد تعاملی یا موبایل، MobileNet یا EfficientNet کوچک میتواند بهتر از یک مدل بسیار بزرگ باشد.
آمادهسازی محیط PyTorch
ابتدا کتابخانههای لازم را نصب کنید:
pip install torch torchvision scikit-learn matplotlib pillowساختار پیشنهادی دیتاست:
dataset/
├── train/
│   ├── acceptable/
│   │   ├── image-001.jpg
│   │   └── image-002.jpg
│   └── damaged/
│       ├── image-003.jpg
│       └── image-004.jpg
├── validation/
│   ├── acceptable/
│   └── damaged/
└── test/
    ├── acceptable/
    └── damaged/
هر پوشه نماینده یک کلاس است.
جداسازی صحیح دادهها
پیش از آموزش، داده را به سه بخش تقسیم کنید:
- Training برای آموزش
- Validation برای انتخاب تنظیمات و Early Stopping
- Test برای ارزیابی نهایی
نکته مهم این است که تصاویر بسیار مشابه نباید میان این بخشها پخش شوند.
برای مثال، اگر از یک محصول چند تصویر با زاویههای نزدیک دارید، بهتر است تمام تصاویر همان محصول فقط در یکی از بخشها باشند. در غیر این صورت مدل ممکن است خود محصول را حفظ کند و نتیجه Test غیرواقعی شود.
Data Augmentation
Data Augmentation تنوع Training Set را افزایش میدهد.
from torchvision import transforms

train_transforms = transforms.Compose(
    [
        transforms.RandomResizedCrop(
            224,
        ),
        transforms.RandomHorizontalFlip(),
        transforms.ColorJitter(
            brightness=0.15,
            contrast=0.15,
        ),
        transforms.ToTensor(),
        transforms.Normalize(
            mean=[
                0.485,
                0.456,
                0.406,
            ],
            std=[
                0.229,
                0.224,
                0.225,
            ],
        ),
    ]
)

validation_transforms = transforms.Compose(
    [
        transforms.Resize(256),
        transforms.CenterCrop(224),
        transforms.ToTensor(),
        transforms.Normalize(
            mean=[
                0.485,
                0.456,
                0.406,
            ],
            std=[
                0.229,
                0.224,
                0.225,
            ],
        ),
    ]
)
Augmentation فقط برای Training استفاده میشود. Validation و Test باید تبدیلهای ثابت و قابل تکرار داشته باشند.
نوع Augmentation باید با مسئله سازگار باشد. برای مثال، برعکسکردن عمودی تصویر در بعضی محصولات میتواند نمونهای غیرواقعی بسازد.
استفاده از Transform رسمی وزنها
TorchVision همراه هر نسخه از وزنهای آماده، پیشپردازش پیشنهادی را نیز ارائه میکند:
from torchvision import models

weights = models.ResNet18_Weights.DEFAULT

validation_transforms = weights.transforms()
استفاده از Transform هماهنگ با وزنهای مدل اهمیت دارد؛ زیرا اندازه، Scaling و Normalization ورودی باید با شرایط آموزش اولیه سازگار باشند.
بارگذاری دیتاست
from pathlib import Path

from torch.utils.data import DataLoader
from torchvision.datasets import ImageFolder

dataset_root = Path("dataset")

train_dataset = ImageFolder(
    dataset_root / "train",
    transform=train_transforms,
)

validation_dataset = ImageFolder(
    dataset_root / "validation",
    transform=validation_transforms,
)

test_dataset = ImageFolder(
    dataset_root / "test",
    transform=validation_transforms,
)

train_loader = DataLoader(
    train_dataset,
    batch_size=32,
    shuffle=True,
    num_workers=4,
    pin_memory=True,
)

validation_loader = DataLoader(
    validation_dataset,
    batch_size=32,
    shuffle=False,
    num_workers=4,
    pin_memory=True,
)

test_loader = DataLoader(
    test_dataset,
    batch_size=32,
    shuffle=False,
    num_workers=4,
    pin_memory=True,
)

print(train_dataset.class_to_idx)
مقدار class_to_idx نگاشت نام پوشه به شماره کلاس را نشان میدهد. این نگاشت باید همراه مدل ذخیره شود.
ساخت مدل Feature Extraction
import torch.nn as nn
from torchvision import models

weights = models.ResNet18_Weights.DEFAULT

model = models.resnet18(
    weights=weights,
)

for parameter in model.parameters():
    parameter.requires_grad = False

input_features = model.fc.in_features

model.fc = nn.Linear(
    input_features,
    len(train_dataset.classes),
)
در این کد:
- وزنهای آماده ResNet18 بارگذاری میشوند.
- تمام پارامترهای مدل Freeze میشوند.
- لایه نهایی با تعداد کلاسهای جدید جایگزین میشود.
- فقط لایه جدید قابل آموزش است.
آموزش رسمی PyTorch نیز دو سناریوی Fine-tuning شبکه و استفاده از آن بهعنوان استخراجکننده ثابت ویژگی را توضیح میدهد.
انتخاب CPU یا GPU
import torch

device = torch.device(
    "cuda"
    if torch.cuda.is_available()
    else "cpu"
)

model = model.to(device)

print("Device:", device)
تعریف Loss و Optimizer
import torch.optim as optim

criterion = nn.CrossEntropyLoss()

optimizer = optim.AdamW(
    model.fc.parameters(),
    lr=0.001,
    weight_decay=0.0001,
)
چون Backbone فریز شده است، فقط پارامترهای model.fc به Optimizer داده میشوند.
حلقه آموزش
def train_one_epoch(
    model,
    data_loader,
    criterion,
    optimizer,
    device,
):
    model.train()

    total_loss = 0.0
    correct = 0
    sample_count = 0

    for images, labels in data_loader:
        images = images.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        logits = model(images)
        loss = criterion(
            logits,
            labels,
        )

        loss.backward()
        optimizer.step()

        total_loss += (
            loss.item()
            * images.size(0)
        )

        predictions = logits.argmax(
            dim=1
        )

        correct += (
            predictions == labels
        ).sum().item()

        sample_count += images.size(0)

    return {
        "loss": total_loss / sample_count,
        "accuracy": correct / sample_count,
    }
حلقه اعتبارسنجی
@torch.no_grad()
def evaluate(
    model,
    data_loader,
    criterion,
    device,
):
    model.eval()

    total_loss = 0.0
    correct = 0
    sample_count = 0

    all_labels = []
    all_predictions = []

    for images, labels in data_loader:
        images = images.to(device)
        labels = labels.to(device)

        logits = model(images)

        loss = criterion(
            logits,
            labels,
        )

        predictions = logits.argmax(
            dim=1
        )

        total_loss += (
            loss.item()
            * images.size(0)
        )

        correct += (
            predictions == labels
        ).sum().item()

        sample_count += images.size(0)

        all_labels.extend(
            labels.cpu().tolist()
        )

        all_predictions.extend(
            predictions.cpu().tolist()
        )

    return {
        "loss": total_loss / sample_count,
        "accuracy": correct / sample_count,
        "labels": all_labels,
        "predictions": all_predictions,
    }
استفاده از model.eval() اهمیت زیادی دارد؛ زیرا رفتار لایههایی مانند Dropout و Batch Normalization را به حالت ارزیابی تغییر میدهد.
آموزش همراه با Early Stopping
from copy import deepcopy

best_validation_loss = float("inf")
best_state = None

patience = 4
waiting_epochs = 0
max_epochs = 20

for epoch in range(max_epochs):
    train_metrics = train_one_epoch(
        model,
        train_loader,
        criterion,
        optimizer,
        device,
    )

    validation_metrics = evaluate(
        model,
        validation_loader,
        criterion,
        device,
    )

    print(
        {
            "epoch": epoch + 1,
            "train_loss": round(
                train_metrics["loss"],
                4,
            ),
            "train_accuracy": round(
                train_metrics["accuracy"],
                4,
            ),
            "validation_loss": round(
                validation_metrics["loss"],
                4,
            ),
            "validation_accuracy": round(
                validation_metrics["accuracy"],
                4,
            ),
        }
    )

    if (
        validation_metrics["loss"]
        < best_validation_loss
    ):
        best_validation_loss = (
            validation_metrics["loss"]
        )

        best_state = deepcopy(
            model.state_dict()
        )

        waiting_epochs = 0
    else:
        waiting_epochs += 1

    if waiting_epochs >= patience:
        print("Early stopping")
        break

model.load_state_dict(
    best_state
)
بهترین نسخه باید بر اساس Validation ذخیره شود؛ نه آخرین Epoch.
ارزیابی روی Test Set
from sklearn.metrics import classification_report
from sklearn.metrics import confusion_matrix

test_metrics = evaluate(
    model,
    test_loader,
    criterion,
    device,
)

class_names = test_dataset.classes

print(
    confusion_matrix(
        test_metrics["labels"],
        test_metrics["predictions"],
    )
)

print(
    classification_report(
        test_metrics["labels"],
        test_metrics["predictions"],
        target_names=class_names,
        zero_division=0,
    )
)
Accuracy بهتنهایی کافی نیست. معیارهای هر کلاس و Confusion Matrix را نیز بررسی کنید.
ذخیره مدل
import torch

checkpoint = {
    "model_state": model.state_dict(),
    "classes": train_dataset.classes,
    "class_to_idx": train_dataset.class_to_idx,
    "architecture": "resnet18",
    "weights": "ResNet18_Weights.DEFAULT",
}

torch.save(
    checkpoint,
    "package_classifier.pt",
)
علاوه بر وزنها بهتر است این اطلاعات ثبت شوند:
- معماری
- نسخه کتابخانه
- Transform ورودی
- اندازه تصویر
- کلاسها
- نسخه داده
- معیارهای Test
- تاریخ آموزش
- شناسه اجرای آزمایش
پیشبینی یک تصویر جدید
from PIL import Image

image = Image.open(
    "sample.jpg"
).convert("RGB")

input_tensor = (
    validation_transforms(image)
    .unsqueeze(0)
    .to(device)
)

model.eval()

with torch.no_grad():
    logits = model(input_tensor)
    probability = torch.softmax(
        logits,
        dim=1,
    )

predicted_index = probability.argmax(
    dim=1
).item()

predicted_class = class_names[
    predicted_index
]

confidence = probability[
    0,
    predicted_index,
].item()

print(
    {
        "class": predicted_class,
        "confidence": confidence,
    }
)
مقدار Softmax را نباید بدون ارزیابی Calibration بهعنوان احتمال کاملاً قابل اعتماد در نظر گرفت.
Fine-tuning لایههای انتهایی
پس از آموزش Head میتوان آخرین Block را آزاد کرد:
for parameter in model.layer4.parameters():
    parameter.requires_grad = True

for parameter in model.fc.parameters():
    parameter.requires_grad = True
برای Fine-tuning معمولاً نرخ یادگیری پایینتری استفاده میشود:
optimizer = optim.AdamW(
    [
        {
            "params": model.layer4.parameters(),
            "lr": 0.00001,
        },
        {
            "params": model.fc.parameters(),
            "lr": 0.0001,
        },
    ],
    weight_decay=0.0001,
)
استفاده از نرخ یادگیری کمتر برای Backbone کمک میکند دانش قبلی مدل با تغییرهای ناگهانی تخریب نشود.
Fine-tuning تدریجی
یک راهکار عملی:
مرحله اول
- Freeze کردن تمام Backbone
- آموزش Head جدید
- انتخاب تنظیمات اولیه
مرحله دوم
- آزادکردن آخرین Block
- کاهش نرخ یادگیری
- ادامه آموزش با Early Stopping
مرحله سوم
- در صورت وجود داده کافی، آزادکردن Blockهای بیشتر
- کاهش بیشتر نرخ یادگیری
- ارزیابی مجدد روی Validation
لازم نیست تمام شبکه را آزاد کنید. هر مرحله باید با نسخه قبلی مقایسه شود.
Batch Normalization در Fine-tuning
Batch Normalization هنگام Fine-tuning نیازمند توجه است.
اگر Batch Size کوچک باشد، بهروزرسانی آمار Batch Normalization میتواند ناپایدار شود. بسته به معماری و دیتاست ممکن است بخواهید:
- لایههای BatchNorm را در حالت ارزیابی نگه دارید.
- فقط پارامترهای انتخابشده را آموزش دهید.
- Batch Size را افزایش دهید.
- نتایج هر روش را روی Validation مقایسه کنید.
یک نسخه عمومی برای همه مسائل وجود ندارد.
چه تعداد تصویر لازم است؟
پاسخ به عوامل مختلف بستگی دارد:
- تعداد کلاسها
- تنوع درون هر کلاس
- شباهت کلاسها
- کیفیت Labelها
- شباهت دامنه به داده Pre-training
- قدرت مدل پایه
- نوع Augmentation
- معیار کیفیت موردنیاز
بهجای تکیه بر یک عدد ثابت:
- یک Baseline بسازید.
- Learning Curve را بررسی کنید.
- خطاهای مدل را تحلیل کنید.
- داده کلاسهای ضعیف را افزایش دهید.
- تنوع واقعی را بیشتر کنید.
انتخاب Augmentation مناسب
Augmentation باید تغییرهایی بسازد که در Production نیز ممکناند.
برای تصویر محصول:
- تغییر محدود روشنایی
- تغییر کوچک زاویه
- Crop کنترلشده
- تغییر مقیاس
- Blur محدود
Augmentation نامناسب:
- چرخش غیرواقعی
- حذف بخش اصلی محصول
- تغییر رنگی که Label را عوض کند
- Flip برای اشیای دارای جهت
- Distortion شدید
برای هر Transform نمونههای خروجی را بهصورت بصری بازبینی کنید.
مدیریت داده نامتوازن
اگر کلاس damaged نمونه کمتری دارد، فقط Accuracy را گزارش نکنید.
راهکارها:
- جمعآوری نمونه واقعی بیشتر
- Weighted Loss
- Weighted Sampler
- Augmentation بیشتر برای کلاس اقلیت
- تنظیم آستانه
- بررسی Precision و Recall هر کلاس
class_weights = torch.tensor(
    [
        1.0,
        3.0,
    ],
    device=device,
)

criterion = nn.CrossEntropyLoss(
    weight=class_weights,
)
وزن مناسب باید روی Validation انتخاب شود.
جلوگیری از بیشبرازش
در Transfer Learning نیز Overfitting ممکن است رخ دهد.
راهکارها:
- Data Augmentation
- Weight Decay
- Early Stopping
- فریزکردن لایههای بیشتر
- مدل پایه کوچکتر
- جمعآوری داده متنوعتر
- حذف تصاویر تکراری
- کاهش تعداد Epoch
- ارزیابی Group-based
- Dropout در Head جدید
برای مطالعه بیشتر به مقاله بیشبرازش و کمبرازش چیست؟ مراجعه کنید.
Data Leakage در تصاویر
نشت داده در پروژه تصویری میتواند به شکلهای مختلف رخ دهد:
- نسخه Resizeشده یک تصویر در Training و Test
- چند فریم نزدیک یک ویدیو در بخشهای متفاوت
- چند تصویر از یک محصول واحد در Training و Test
- نام فایل مرتبط با Label
- واترمارک متفاوت کلاسها
- پسزمینه ثابت برای یک کلاس
- تصاویر تولیدشده از منبع یکسان در دو بخش
تقسیم تصادفی فایلها همیشه کافی نیست. گاهی باید بر اساس محصول، کاربر، ویدیو، فروشگاه یا جلسه تصویربرداری تقسیم انجام شود.
Domain Shift چیست؟
Domain Shift زمانی رخ میدهد که داده Production با Training تفاوت داشته باشد.
مثالها:
- دوربین متفاوت
- نور متفاوت
- پسزمینه جدید
- رزولوشن پایینتر
- زاویه تصویربرداری جدید
- محصول نسل جدید
- فشردهسازی تصویر
- تغییر فصل یا محیط
Test Set باید تا حد امکان شرایط واقعی Production را بازتاب دهد.
اگر تصاویر عملیاتی با داده Pre-training تفاوت زیادی دارند، Fine-tuning گستردهتر یا Pre-training دامنهای ممکن است لازم باشد.
Negative Transfer چیست؟
گاهی انتقال دانش نتیجه را ضعیفتر میکند. این وضعیت Negative Transfer نام دارد.
دلایل احتمالی:
- مدل پایه روی دامنه بسیار متفاوت آموزش دیده است.
- ویژگیهای قبلی برای مسئله جدید مناسب نیستند.
- Fine-tuning با نرخ یادگیری نامناسب انجام شده است.
- داده جدید نویزی است.
- Layerهای زیادی Freeze شدهاند.
- Preprocessing با وزنها هماهنگ نیست.
برای تشخیص Negative Transfer، نتیجه را با یک Baseline ساده یا مدل آموزشدیده از ابتدا مقایسه کنید.
یادگیری انتقالی در پردازش متن
در NLP، یک مدل زبانی ازپیشآموزشدیده میتواند برای وظایف زیر تطبیق داده شود:
- طبقهبندی متن
- تشخیص موضوع
- تحلیل دیدگاه
- استخراج موجودیت
- پاسخگویی
- خلاصهسازی
- بازیابی معنایی
روشهای رایج:
- استفاده مستقیم از Embedding
- آموزش یک Head طبقهبندی
- Fine-tuning کامل
- Parameter-Efficient Fine-tuning
- LoRA و QLoRA
- Instruction Tuning
برای مطالعه بیشتر میتوانید مقاله Fine-tuning مدل زبانی با LoRA و QLoRA را ببینید.
یادگیری انتقالی در صوت
یک مدل صوتی ازپیشآموزشدیده میتواند برای موارد زیر استفاده شود:
- طبقهبندی رویداد صوتی
- تشخیص گفتار
- شناسایی نوع صدا
- تشخیص فرمان صوتی
- دستهبندی صدای محیط
آموزش TensorFlow برای YAMNet نمونهای از استفاده از Embeddingهای یک شبکه صوتی ازپیشآموزشدیده برای طبقهبندی جدید است.
یادگیری انتقالی در ویدیو
در ویدیو میتوان از مدلهای آموزشدیده برای استخراج ویژگی حرکت و تصویر استفاده کرد.
کاربردها:
- طبقهبندی فعالیت
- تشخیص نوع محتوا
- تحلیل حرکت
- دستهبندی کلیپ
- تشخیص رویداد
TensorFlow آموزش مستقلی برای Transfer Learning در طبقهبندی ویدیو با MoViNet ارائه میکند.
Transfer Learning یا آموزش از ابتدا؟
| معیار | Transfer Learning | آموزش از ابتدا |
|---|---|---|
| داده موردنیاز | کمتر | بیشتر |
| زمان آموزش | کمتر | بیشتر |
| هزینه محاسباتی | معمولاً کمتر | بیشتر |
| کنترل معماری | محدودتر | کامل |
| مناسب دیتاست کوچک | بله | معمولاً دشوار |
| وابستگی به مدل پایه | دارد | ندارد |
| دانش دامنه قبلی | قابل استفاده | باید آموخته شود |
آموزش از ابتدا زمانی منطقیتر است که:
- داده بسیار بزرگ و اختصاصی دارید.
- دامنه کاملاً متفاوت است.
- معماری خاصی لازم دارید.
- استفاده از وزن موجود محدودیت مجوز دارد.
- کنترل کامل فرایند آموزش ضروری است.
Transfer Learning یا استفاده مستقیم از API؟
همیشه لازم نیست مدلی را آموزش دهید.
مدلهای چندوجهی آماده میتوانند تصویر را دریافت و درباره آن پاسخ تولید کنند. برای ساخت نمونه اولیه، بررسی امکانپذیری یا کاربردهای متنوع، استفاده از API میتواند سریعتر باشد.
Transfer Learning مناسب است اگر:
- خروجی محدود و ثابت دارید.
- تعداد درخواست بسیار زیاد است.
- تأخیر پایین لازم است.
- مدل باید محلی اجرا شود.
- داده برچسبخورده کافی دارید.
- کنترل نسخه مدل مهم است.
API مدل چندوجهی مناسب است اگر:
- میخواهید سریع شروع کنید.
- وظایف متنوعاند.
- داده آموزشی کافی ندارید.
- علاوه بر کلاس، توضیح متنی میخواهید.
- مدل باید دستورهای مختلف را اجرا کند.
- هنوز در مرحله اعتبارسنجی ایده هستید.
آزمایش مدل تصویری با API درواره
API درواره با ساختار سازگار با OpenAI امکان اتصال نرمافزار به مدلهای مختلف هوش مصنوعی را فراهم میکند.
آدرس پایه:
https://api.darvareh.ir/v1نصب کتابخانه:
pip install openaiمتغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_VISION_MODEL="YOUR_VISION_MODEL_ID"
نمونه ارسال تصویر:
import base64
import mimetypes
import os
from pathlib import Path
from openai import OpenAI
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
MODEL_ID = os.environ[
"DARVAREH_VISION_MODEL"
]
def image_to_data_url(
image_path: str,
) -> str:
path = Path(image_path)
mime_type = (
mimetypes.guess_type(path.name)[0]
or "image/jpeg"
)
encoded = base64.b64encode(
path.read_bytes()
).decode("utf-8")
return (
f"data:{mime_type};base64,"
f"{encoded}"
)
response = client.chat.completions.create(
model=MODEL_ID,
temperature=0,
messages=[
{
"role": "system",
"content": (
"تصویر بستهبندی را بررسی کن. "
"نتیجه را کوتاه و دقیق بنویس. "
"اگر شواهد کافی نیست، عدم اطمینان "
"را اعلام کن."
),
},
{
"role": "user",
"content": [
{
"type": "text",
"text": (
"آیا بستهبندی قابل قبول است "
"یا آسیب ظاهری دارد؟"
),
},
{
"type": "image_url",
"image_url": {
"url": image_to_data_url(
"sample.jpg"
),
},
},
],
},
],
)
print(
response.choices[0].message.content
)پشتیبانی از ورودی تصویر به مدل انتخابشده بستگی دارد. شناسه مدل و ساختار فعلی درخواست را پیش از استفاده عملی در مستندات بررسی کنید.
برای شروع میتوانید به مستندات API درواره مراجعه کنید.
معماری ترکیبی API و مدل اختصاصی
در بعضی محصولات میتوان از معماری ترکیبی استفاده کرد:
- مدل اختصاصی کوچک درخواستهای پرتکرار را پردازش میکند.
- نمونههای کماطمینان به مدل چندوجهی API ارسال میشوند.
- خروجیهای حساس برای بازبینی انسانی نگه داشته میشوند.
- نمونههای بازبینیشده به دیتاست آموزش آینده اضافه میشوند.
- کیفیت هر مسیر جداگانه مانیتور میشود.
این معماری میتواند تعادل مناسبی میان هزینه، سرعت و کیفیت ایجاد کند.
Transfer Learning، RAG یا Fine-tuning؟
این روشها مسائل متفاوتی را حل میکنند.
| روش | مسئله اصلی |
|---|---|
| Transfer Learning | انتقال دانش مدل به وظیفه جدید |
| Fine-tuning | تغییر رفتار یا توانایی مدل با آموزش بیشتر |
| RAG | دسترسی مدل به اطلاعات اختصاصی و بهروز |
| Prompt Engineering | هدایت مدل بدون تغییر وزن |
| API آماده | استفاده مستقیم از قابلیت مدل |
| Embedding | نمایش معنایی متن، تصویر یا داده |
اگر هدف شما پاسخگویی بر اساس مستندات شرکت است، معمولاً RAG از Fine-tuning مناسبتر است.
اگر هدف طبقهبندی ثابت تصاویر اختصاصی با تأخیر کم است، Transfer Learning میتواند گزینه مناسبی باشد.
اگر هدف ساخت سریع یک قابلیت عمومی تحلیل تصویر است، ابتدا API یک مدل چندوجهی را آزمایش کنید.
ارزیابی مدل Transfer Learning
معیارها به نوع مسئله وابستهاند.
برای طبقهبندی:
- Accuracy
- Precision
- Recall
- F1
- Macro F1
- Confusion Matrix
- PR-AUC برای داده نامتوازن
- زمان Inference
- حافظه مصرفی
علاوه بر میانگین کلی، کیفیت هر کلاس را جداگانه بررسی کنید.
برای پروژه بستهبندی، هزینه این دو خطا ممکن است متفاوت باشد:
- بستهبندی سالم اشتباهاً معیوب اعلام شود.
- بستهبندی معیوب اشتباهاً سالم اعلام شود.
معیار اصلی باید با هزینه واقعی این خطاها هماهنگ باشد.
Calibration و کلاس نامشخص
مدل نباید مجبور باشد هر تصویر را با قطعیت به یکی از کلاسها اختصاص دهد.
برای Production بهتر است:
- آستانه اطمینان تعریف شود.
- خروجی کماطمینان به بازبینی انسانی برود.
- کلاس
unknownدر نظر گرفته شود. - تصاویر خارج از دامنه شناسایی شوند.
- Probability مدل Calibration شود.
یک تصویر تار، ناقص یا مربوط به محصول ناشناخته نباید صرفاً به نزدیکترین کلاس مجبور شود.
مانیتورینگ پس از استقرار
موارد پیشنهادی برای ثبت:
- نسخه مدل
- نسخه وزن پایه
- نسخه Transform
- زمان پیشبینی
- کلاس خروجی
- امتیاز اطمینان
- نتیجه بازبینی انسانی
- دستگاه و رزولوشن تصویر
- نرخ کلاس نامشخص
- نرخ خطا
- توزیع کلاسها
- تعداد اصلاح خروجی
افت کیفیت ممکن است ناشی از تغییر دوربین، نور، محصول یا فرایند تصویربرداری باشد.
اشتباهات رایج
آموزش تمام شبکه از ابتدای کار
برای دیتاست کوچک بهتر است ابتدا Head جدید آموزش داده شود.
استفاده از نرخ یادگیری یکسان
Backbone ازپیشآموزشدیده معمولاً به نرخ یادگیری پایینتری نیاز دارد.
استفاده از Transform اشتباه
Normalization باید با وزنهای انتخابشده هماهنگ باشد.
پخش تصاویر مشابه میان Training و Test
این کار نتیجهای غیرواقعی تولید میکند.
Augmentation غیرواقعی
تغییرهایی که در Production رخ نمیدهند میتوانند مدل را منحرف کنند.
گزارش فقط Accuracy
معیار هر کلاس و Confusion Matrix نیز باید بررسی شود.
نادیدهگرفتن مجوز وزنها و دادهها
شرایط استفاده تجاری مدل، وزن و دیتاست باید بررسی شود.
استفاده از آخرین Epoch
بهترین Checkpoint بر اساس Validation باید ذخیره شود.
Fine-tuning بدون Baseline
نتیجه باید با Feature Extraction و مدل سادهتر مقایسه شود.
اعتماد به Confidence خام
امتیاز Softmax همیشه احتمال قابل اعتماد نیست.
نداشتن کلاس Unknown
مدل ممکن است تصویر خارج از دامنه را با اطمینان ظاهری طبقهبندی کند.
چکلیست اجرای Transfer Learning
پیش از انتشار مدل بررسی کنید:
- مسئله و کلاسها دقیق تعریف شدهاند.
- مدل پایه متناسب با دامنه انتخاب شده است.
- مجوز استفاده از وزنها بررسی شده است.
- تصاویر تکراری حذف شدهاند.
- تقسیم داده بر اساس موجودیت واقعی انجام شده است.
- Transform با وزن مدل هماهنگ است.
- Augmentation فقط روی Training اعمال میشود.
- ابتدا Feature Extraction آزمایش شده است.
- Fine-tuning با نرخ یادگیری کمتر انجام میشود.
- Early Stopping فعال است.
- بهترین Checkpoint ذخیره میشود.
- معیار هر کلاس گزارش شده است.
- مدل با Baseline مقایسه شده است.
- خروجی کماطمینان مسیر مشخص دارد.
- زمان و حافظه Inference اندازهگیری شدهاند.
- مدل روی داده واقعی Production آزمایش شده است.
- تغییر توزیع داده پس از انتشار پایش میشود.
پرسشهای متداول
Transfer Learning چیست؟
روشی است که در آن دانش یک مدل ازپیشآموزشدیده برای حل مسئلهای جدید استفاده میشود.
تفاوت Transfer Learning و Fine-tuning چیست؟
Transfer Learning مفهوم کلی انتقال دانش است. Fine-tuning یکی از روشهای آن است که طی آن بخشی یا تمام وزنهای مدل با داده جدید بهروزرسانی میشوند.
Freeze کردن لایهها یعنی چه؟
یعنی پارامترهای آن لایهها هنگام آموزش تغییر نکنند و فقط بخشهای انتخابشده مدل آموزش ببینند.
آیا برای Transfer Learning به GPU نیاز داریم؟
الزامی نیست، اما GPU آموزش و Fine-tuning را سریعتر میکند. برای مدل کوچک و دیتاست محدود میتوان از CPU نیز استفاده کرد.
آیا Transfer Learning فقط برای تصویر است؟
خیر. در متن، صوت، ویدیو و بسیاری از حوزههای دیگر نیز کاربرد دارد.
آیا میتوان با داده کم Transfer Learning انجام داد؟
بله، یکی از مزایای اصلی این روش استفاده بهتر از دیتاست محدود است. بااینحال داده باید متنوع، معتبر و نماینده شرایط واقعی باشد.
Feature Extraction بهتر است یا Fine-tuning؟
برای شروع و دیتاست کوچک، Feature Extraction مناسبتر است. اگر کیفیت کافی نبود و داده بیشتری داشتید، Fine-tuning لایههای انتهایی را آزمایش کنید.
آیا Fine-tuning همیشه کیفیت را افزایش میدهد؟
خیر. نرخ یادگیری نامناسب، داده کم، Label اشتباه یا تفاوت شدید دامنه میتواند کیفیت را کاهش دهد.
Transfer Learning بهتر است یا API آماده؟
برای نمونه اولیه و وظایف متنوع، API آماده سریعتر است. برای خروجی ثابت، حجم زیاد، اجرای محلی و تأخیر پایین، مدل اختصاصی Transfer Learning میتواند مناسبتر باشد.
آیا RAG نوعی Transfer Learning است؟
خیر. RAG اطلاعات مرتبط را هنگام درخواست در اختیار مدل قرار میدهد و معمولاً وزنهای مدل را تغییر نمیدهد.
جمعبندی
Transfer Learning امکان استفاده مجدد از دانش مدلهای ازپیشآموزشدیده را فراهم میکند و هزینه ساخت مدل اختصاصی را کاهش میدهد.
برای اجرای موفق:
- مسئله و معیار موفقیت را مشخص کنید.
- مدل پایه متناسب با دامنه انتخاب کنید.
- داده را بدون نشت به Training، Validation و Test تقسیم کنید.
- از Transform هماهنگ با وزنهای مدل استفاده کنید.
- ابتدا Backbone را Freeze و Head جدید را آموزش دهید.
- در صورت نیاز لایههای انتهایی را تدریجی Fine-tune کنید.
- برای Backbone نرخ یادگیری پایینتری در نظر بگیرید.
- از Early Stopping و بهترین Checkpoint استفاده کنید.
- کیفیت هر کلاس و Confusion Matrix را بررسی کنید.
- مدل را روی شرایط واقعی Production آزمایش کنید.
- خروجیهای کماطمینان را به مسیر بازبینی بفرستید.
- پیش از آموزش اختصاصی، امکان استفاده از API آماده را نیز مقایسه کنید.
اگر میخواهید پیش از سرمایهگذاری روی آموزش مدل اختصاصی، چند مدل چندوجهی را روی تصاویر واقعی خود آزمایش کنید، API درواره امکان دسترسی یکپارچه به مدلهای مختلف را با ساختار سازگار با OpenAI فراهم میکند.
مقالات مرتبط
- Fine-tuning مدل زبانی با LoRA و QLoRA
- آموزش PyTorch با پایتون
- آموزش TensorFlow و Keras
- شبکه عصبی چیست؟
- یادگیری عمیق چیست؟
- بینایی ماشین چیست؟
- بیشبرازش و کمبرازش چیست؟
- داده نامتوازن و SMOTE
- آموزش اتصال API هوش مصنوعی به نرمافزار
منابع
- PyTorch: Transfer Learning for Computer Vision
- PyTorch: TorchVision Object Detection Fine-tuning
- TensorFlow: Transfer Learning and Fine-tuning
- Keras: Transfer Learning Guide
- TensorFlow: Transfer Learning for Audio
- TensorFlow: Transfer Learning for Video
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



