
RNN و LSTM چیست؟ آموزش شبکه عصبی بازگشتی و GRU با PyTorch
RNN، LSTM و GRU چگونه دادههای ترتیبی را پردازش میکنند؟ در این راهنمای جامع، معماری شبکههای بازگشتی، تفاوت مدلها و ساخت یک طبقهبند متن فارسی با PyTorch را بهصورت عملی یاد میگیرید.

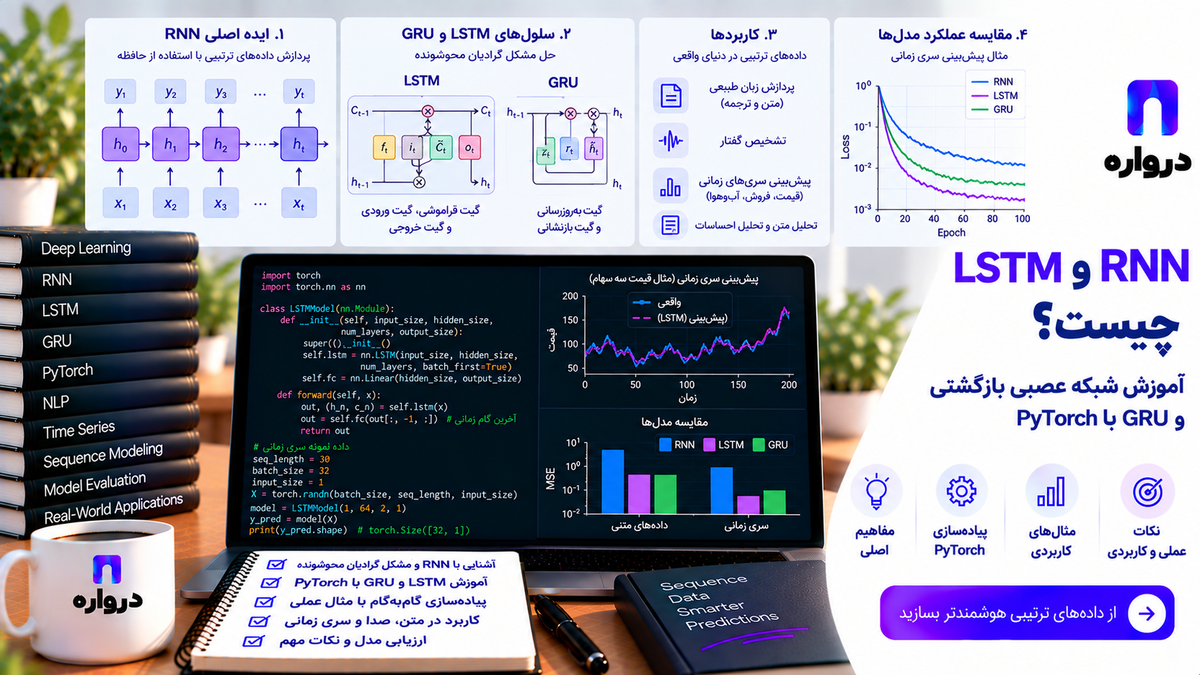
شبکه عصبی بازگشتی یا RNN نوعی شبکه عصبی است که برای پردازش دادههای ترتیبی طراحی شده است؛ دادههایی که در آنها ترتیب عناصر اهمیت دارد.
در یک جمله، ترتیب کلمات روی معنا اثر میگذارد. در دادههای زمانی، مقدار فعلی ممکن است به رویدادهای قبلی وابسته باشد. در فایل صوتی نیز هر بخش از سیگنال با بخشهای قبل و بعد از خود ارتباط دارد.
شبکههای عصبی معمولی هر ورودی را مستقل پردازش میکنند، اما RNN نوعی وضعیت یا حافظه داخلی دارد که اطلاعات مراحل قبلی را به مرحله بعد منتقل میکند.
مدلهای LSTM و GRU نیز نسخههای پیشرفتهتر RNN هستند که برای یادگیری وابستگیهای طولانیتر و کاهش مشکلات آموزشی شبکههای بازگشتی توسعه یافتهاند.
در این مقاله ابتدا RNN، LSTM و GRU را بررسی میکنیم و سپس یک طبقهبند متن فارسی را با PyTorch میسازیم. در پایان نیز مشخص میکنیم چه زمانی استفاده از این مدلها مناسب است و چه زمانی Transformer یا API مدلهای زبانی انتخاب بهتری خواهد بود.
داده ترتیبی چیست؟
داده ترتیبی یا Sequential Data دادهای است که جایگاه و ترتیب عناصر آن اهمیت دارد.
نمونههای رایج عبارتاند از:
- جمله و متن
- مکالمه
- سیگنال صوتی
- داده حسگرها
- اطلاعات آبوهوا
- لاگ رویدادهای نرمافزار
- دنباله کلیکهای کاربر
- داده مصرف انرژی
- تراکنشهای زمانی
- فریمهای ویدیو
برای مثال، جملههای زیر از کلمات تقریباً مشابه ساخته شدهاند، اما ترتیب متفاوت آنها معنای متفاوتی ایجاد میکند:
کاربر سفارش را لغو کرد.
سفارش کاربر را لغو کرد.
مدلی که کلمات را کاملاً مستقل ببیند، در درک چنین تفاوتی با مشکل روبهرو میشود. مدل ترتیبی تلاش میکند رابطه عناصر را در طول دنباله حفظ کند.
شبکه عصبی بازگشتی RNN چیست؟
RNN مخفف Recurrent Neural Network و به معنای شبکه عصبی بازگشتی است.
در یک شبکه پیشخور معمولی، اطلاعات فقط از ورودی به خروجی حرکت میکنند. در RNN، خروجی یا وضعیت داخلی هر مرحله در پردازش مرحله بعد نیز استفاده میشود.
برای مثال، هنگام پردازش جمله زیر:
کیفیت محصول خوب بود اما بستهبندی آسیب دیده بودمدل کلمات را بهترتیب میخواند. پس از پردازش هر کلمه، یک وضعیت داخلی بهروزرسانی میشود. این وضعیت خلاصهای از اطلاعات دیدهشده تا آن نقطه را نگه میدارد.
مستندات رسمی PyTorch نیز RNN را شبکهای معرفی میکند که یک وضعیت داخلی را حفظ میکند و میتواند اطلاعات را هنگام حرکت روی دنباله به مراحل بعد منتقل کند.
حافظه RNN چگونه کار میکند؟
فرض کنید مدل کلمهبهکلمه یک دیدگاه مشتری را پردازش میکند.
در هر مرحله، دو نوع اطلاعات در اختیار شبکه قرار میگیرد:
- نمایش عددی کلمه فعلی
- وضعیت داخلی باقیمانده از کلمات قبلی
شبکه این اطلاعات را ترکیب میکند و وضعیت جدیدی میسازد. وضعیت جدید به مرحله بعد منتقل میشود.
این فرایند به RNN اجازه میدهد هنگام رسیدن به کلمه «آسیب» همچنان اطلاعاتی درباره کلمات قبلی مانند «بستهبندی» داشته باشد.
حافظه RNN مانند حافظه یک پایگاه داده نیست و متن قبلی را کلمهبهکلمه ذخیره نمیکند. این حافظه یک نمایش عددی فشرده از اطلاعات قبلی است.
انواع ورودی و خروجی در RNN
RNN را میتوان برای الگوهای مختلف ورودی و خروجی استفاده کرد.
یک ورودی به یک خروجی
این حالت به شبکه عصبی معمولی شبیه است و استفاده از RNN معمولاً ضرورت ندارد.
نمونه:
- تصویر به برچسب
چند ورودی به یک خروجی
مدل یک دنباله را دریافت و یک نتیجه تولید میکند.
نمونهها:
- متن به احساس مثبت یا منفی
- دنباله رویدادها به احتمال ریزش مشتری
- داده حسگر به نوع وضعیت دستگاه
یک ورودی به چند خروجی
یک ورودی به دنبالهای از خروجیها تبدیل میشود.
نمونهها:
- تصویر به توضیح متنی
- موضوع به دنباله کلمات
چند ورودی به چند خروجی هماندازه
به ازای هر عنصر ورودی، یک خروجی تولید میشود.
نمونهها:
- تعیین نقش دستوری هر کلمه
- برچسبگذاری موجودیتهای نامدار
- طبقهبندی هر فریم صوتی
چند ورودی به چند خروجی با طول متفاوت
ورودی و خروجی میتوانند طول متفاوتی داشته باشند.
نمونهها:
- ترجمه ماشینی
- خلاصهسازی
- پاسخگویی ترتیبی
در معماریهای کلاسیک، این مسئله معمولاً با ساختار Encoder-Decoder یا Seq2Seq پیادهسازی میشود.
مشکل اصلی RNN ساده چیست؟
RNN ساده در یادگیری وابستگیهای کوتاه عملکرد قابلقبولی دارد، اما در دنبالههای طولانی با مشکل روبهرو میشود.
برای مثال، در جملهای طولانی ممکن است معنای کلمه انتهایی به عبارتی در ابتدای جمله وابسته باشد. اطلاعات ابتدای دنباله باید از مراحل زیادی عبور کند تا به انتها برسد.
در جریان آموزش، گرادیانها نیز از همین مسیر عبور میکنند. این وضعیت میتواند دو مشکل ایجاد کند:
- Vanishing Gradient: گرادیان بهتدریج بسیار کوچک میشود.
- Exploding Gradient: گرادیان بهشدت بزرگ و آموزش ناپایدار میشود.
در حالت اول، مدل نمیتواند وابستگیهای دور را بهخوبی یاد بگیرد. در حالت دوم، وزنها ممکن است تغییرات شدید و کنترلنشده داشته باشند.
LSTM و GRU برای کاهش این محدودیتها طراحی شدهاند.
LSTM چیست؟
LSTM مخفف Long Short-Term Memory و نوعی شبکه عصبی بازگشتی دارای سازوکار حافظه کنترلشده است.
LSTM علاوه بر وضعیت مخفی، یک وضعیت حافظه جداگانه نیز نگه میدارد. چند دروازه یادگرفتنی تعیین میکنند:
- چه اطلاعاتی فراموش شود؛
- چه اطلاعات جدیدی وارد حافظه شود؛
- چه بخشی از حافظه در خروجی فعلی اثر بگذارد.
بهجای اینکه تمام اطلاعات قبلی در هر مرحله بازنویسی شوند، LSTM میتواند بخشهای مهم حافظه را برای مدت بیشتری حفظ کند.
لایه torch.nn.LSTM در PyTorch برای اجرای LSTM چندلایه روی دنباله ورودی طراحی شده است.
دروازههای LSTM چگونه کار میکنند؟
دروازه فراموشی
این بخش تصمیم میگیرد کدام اطلاعات قبلی دیگر ضروری نیستند.
برای مثال، در تحلیل چند دیدگاه مستقل، اطلاعات دیدگاه قبلی نباید وارد دیدگاه بعدی شود.
دروازه ورودی
دروازه ورودی مشخص میکند چه اطلاعات جدیدی به حافظه اضافه شوند.
اگر مدل در جمله به عبارت «اصلاً راضی نبودم» برسد، این بخش میتواند اطلاعات مرتبط با نارضایتی را وارد حافظه کند.
حافظه سلولی
حافظه سلولی مسیر اصلی انتقال اطلاعات در طول دنباله است. دروازهها محتوای این حافظه را کنترل میکنند.
دروازه خروجی
این دروازه تعیین میکند چه بخشی از حافظه فعلی در وضعیت مخفی و خروجی مرحله حاضر منعکس شود.
این اجزا در جریان آموزش بهصورت خودکار یاد میگیرند چه اطلاعاتی را حفظ، حذف یا منتقل کنند.
GRU چیست؟
GRU مخفف Gated Recurrent Unit است. این مدل مانند LSTM از دروازهها استفاده میکند، اما معماری سادهتری دارد.
GRU معمولاً دو سازوکار اصلی دارد:
- دروازه بهروزرسانی
- دروازه بازنشانی
برخلاف LSTM، وضعیت حافظه و وضعیت مخفی در GRU کاملاً جدا نیستند. این سادگی باعث میشود GRU معمولاً پارامترهای کمتری داشته باشد و سریعتر آموزش ببیند.
PyTorch نیز لایه torch.nn.GRU را برای اجرای GRU چندلایه روی دادههای ترتیبی ارائه میکند.
تفاوت RNN، LSTM و GRU
| ویژگی | RNN ساده | LSTM | GRU |
|---|---|---|---|
| حافظه کوتاهمدت | دارد | دارد | دارد |
| یادگیری وابستگی طولانی | ضعیفتر | مناسبتر | مناسبتر |
| تعداد دروازهها | ندارد | بیشتر | کمتر |
| تعداد پارامترها | کمتر | بیشتر | معمولاً کمتر از LSTM |
| سرعت آموزش | بالا | کمتر | معمولاً بیشتر از LSTM |
| خطر محوشدن گرادیان | بیشتر | کمتر | کمتر |
| پیچیدگی معماری | کم | زیادتر | متوسط |
| انتخاب اولیه مناسب | دنباله بسیار کوتاه | وابستگی پیچیده | تعادل سرعت و کیفیت |
هیچکدام در تمام مسائل بهتر نیستند. انتخاب باید با ارزیابی روی داده واقعی انجام شود.
اگر حجم داده محدود و سرعت مهم باشد، GRU نقطه شروع مناسبی است. اگر وابستگیهای طولانی و پیچیده اهمیت بیشتری داشته باشند، LSTM ارزش آزمایش دارد.
تفاوت LSTM یکطرفه و دوطرفه
LSTM معمولی دنباله را از ابتدا به انتها پردازش میکند. مدل Bidirectional LSTM یا BiLSTM همان دنباله را در دو جهت بررسی میکند:
- از ابتدا به انتها
- از انتها به ابتدا
در طبقهبندی متن، این روش میتواند مفید باشد؛ زیرا معنای یک کلمه ممکن است به کلمات قبل و بعد آن وابسته باشد.
برای مثال، در جمله زیر کلمه «خوب» بهتنهایی کافی نیست:
فکر میکردم کیفیت خوب باشد، اما اصلاً خوب نبود.مدل دوطرفه میتواند زمینه هر دو سمت کلمه را بررسی کند.
BiLSTM برای پردازش آفلاین متن مناسب است، اما در سامانهای که داده بهصورت زنده وارد میشود و آینده هنوز در دسترس نیست، استفاده از جهت معکوس همیشه امکانپذیر نیست.
لایه Embedding چه نقشی دارد؟
مدل عصبی نمیتواند کلمات خام را مستقیماً پردازش کند. هر کلمه ابتدا به یک شناسه عددی و سپس به یک بردار تبدیل میشود.
لایه Embedding یک جدول قابلآموزش است که برای هر شناسه کلمه، یک بردار میسازد.
کلمات دارای کاربرد مشابه ممکن است در جریان آموزش نمایشهای نزدیکتری پیدا کنند. این لایه بخشی از مدل است و همراه LSTM آموزش میبیند.
خط پردازش متن میتواند به شکل زیر باشد:
متن فارسی
↓
نرمالسازی
↓
توکنسازی
↓
تبدیل کلمات به شناسه
↓
Embedding
↓
LSTM یا GRU
↓
لایه طبقهبندی
↓
برچسب خروجیآموزش عملی طبقهبندی متن فارسی با LSTM
در این مثال، یک مدل BiLSTM برای طبقهبندی دیدگاههای فارسی میسازیم.
هر دیدگاه در یکی از دو کلاس قرار میگیرد:
0: منفی1: مثبت
همین معماری را میتوان برای دستهبندی تیکت پشتیبانی، تشخیص موضوع پیام، تحلیل بازخورد مشتری یا برچسبگذاری درخواستها توسعه داد.
ساختار داده آموزشی
دو فایل CSV بسازید:
data/
├── train.csv
└── valid.csv
ساختار هر فایل:
text,label
"کیفیت محصول عالی بود و سریع ارسال شد",1
"بستهبندی آسیب دیده بود و راضی نیستم",0
"پشتیبانی خیلی خوب پاسخ داد",1
"سفارش با چند روز تأخیر رسید",0تقسیم داده باید پیش از ساخت واژگان انجام شود. واژگان را فقط از داده آموزش بسازید تا اطلاعات مجموعه اعتبارسنجی وارد فرایند آموزش نشود.
نصب کتابخانهها
pip install torch scikit-learnنرمالسازی متن فارسی
متن فارسی ممکن است شکلهای متفاوتی از حروف، فاصله و نیمفاصله داشته باشد. در یک پروژه واقعی میتوان از کتابخانههایی مانند Hazm نیز استفاده کرد، اما در این مثال یک نرمالساز ساده میسازیم.
import re


def normalize_persian_text(text: str) -> str:
    replacements = {
        "ي": "ی",
        "ى": "ی",
        "ك": "ک",
        "ة": "ه",
        "ۀ": "ه",
        "\u200c": " ",
    }

    for source, target in replacements.items():
        text = text.replace(source, target)

    text = text.strip().lower()
    text = re.sub(r"[^\w\s\u0600-\u06FF]", " ", text)
    text = re.sub(r"\s+", " ", text)

    return text


def tokenize(text: str) -> list[str]:
    normalized = normalize_persian_text(text)
    return normalized.split()
حذف تمام نشانهها همیشه بهترین تصمیم نیست. در تحلیل احساس، علامت تعجب، شکلک و کشیدهنویسی ممکن است اطلاعات مفیدی داشته باشند. پیشپردازش را بر اساس داده و هدف پروژه تنظیم کنید.
خواندن داده و ساخت واژگان
دو توکن ویژه تعریف میکنیم:
<PAD>برای هماندازهکردن دنبالهها<UNK>برای کلمات ناشناخته
import csv
from collections import Counter
from pathlib import Path


PAD_TOKEN = "<PAD>"
UNK_TOKEN = "<UNK>"
PAD_INDEX = 0
UNK_INDEX = 1


def read_csv_rows(path: str | Path) -> list[dict]:
    with open(path, "r", encoding="utf-8-sig") as file:
        return list(csv.DictReader(file))


train_rows = read_csv_rows("data/train.csv")
valid_rows = read_csv_rows("data/valid.csv")


def build_vocabulary(
    rows: list[dict],
    min_frequency: int = 2,
) -> dict[str, int]:
    counter = Counter()

    for row in rows:
        counter.update(tokenize(row["text"]))

    vocabulary = {
        PAD_TOKEN: PAD_INDEX,
        UNK_TOKEN: UNK_INDEX,
    }

    for token, frequency in counter.items():
        if frequency >= min_frequency:
            vocabulary[token] = len(vocabulary)

    return vocabulary


vocabulary = build_vocabulary(
    train_rows,
    min_frequency=2,
)

print(f"Vocabulary size: {len(vocabulary)}")
کلمات بسیار کمتکرار میتوانند اندازه واژگان را زیاد کنند، بدون اینکه اطلاعات کافی برای یادگیری نمایش مناسب داشته باشند. مقدار min_frequency را بر اساس اندازه دیتاست تنظیم کنید.
ساخت Dataset
import torch
from torch.utils.data import Dataset


def encode_text(
    text: str,
    vocabulary: dict[str, int],
) -> torch.Tensor:
    token_ids = [
        vocabulary.get(token, UNK_INDEX)
        for token in tokenize(text)
    ]

    if not token_ids:
        token_ids = [UNK_INDEX]

    return torch.tensor(
        token_ids,
        dtype=torch.long,
    )


class PersianSentimentDataset(Dataset):
    def __init__(
        self,
        rows: list[dict],
        vocabulary: dict[str, int],
    ):
        self.rows = rows
        self.vocabulary = vocabulary

    def __len__(self) -> int:
        return len(self.rows)

    def __getitem__(
        self,
        index: int,
    ) -> tuple[torch.Tensor, torch.Tensor]:
        row = self.rows[index]

        tokens = encode_text(
            row["text"],
            self.vocabulary,
        )

        label = torch.tensor(
            int(row["label"]),
            dtype=torch.long,
        )

        return tokens, label
مدیریت متنهای دارای طول متفاوت
جملهها طول یکسانی ندارند. برای قرارگرفتن چند جمله در یک Batch، باید جملههای کوتاهتر با توکن Padding کامل شوند.
طول واقعی هر جمله را نیز نگه میداریم تا LSTM بخشهای Padding را پردازش نکند.
from torch.nn.utils.rnn import pad_sequence


def collate_batch(batch):
    sequences, labels = zip(*batch)

    lengths = torch.tensor(
        [len(sequence) for sequence in sequences],
        dtype=torch.long,
    )

    padded_sequences = pad_sequence(
        sequences,
        batch_first=True,
        padding_value=PAD_INDEX,
    )

    labels = torch.stack(labels)

    return padded_sequences, lengths, labels
ساخت DataLoader
from torch.utils.data import DataLoader


BATCH_SIZE = 32

train_dataset = PersianSentimentDataset(
    train_rows,
    vocabulary,
)

valid_dataset = PersianSentimentDataset(
    valid_rows,
    vocabulary,
)

train_loader = DataLoader(
    train_dataset,
    batch_size=BATCH_SIZE,
    shuffle=True,
    collate_fn=collate_batch,
)

valid_loader = DataLoader(
    valid_dataset,
    batch_size=BATCH_SIZE,
    shuffle=False,
    collate_fn=collate_batch,
)
ساخت مدل BiLSTM با PyTorch
from torch import nn
from torch.nn.utils.rnn import pack_padded_sequence


class PersianBiLSTMClassifier(nn.Module):
    def __init__(
        self,
        vocabulary_size: int,
        embedding_size: int = 128,
        hidden_size: int = 128,
        number_of_layers: int = 2,
        number_of_classes: int = 2,
        dropout: float = 0.3,
    ):
        super().__init__()

        self.embedding = nn.Embedding(
            num_embeddings=vocabulary_size,
            embedding_dim=embedding_size,
            padding_idx=PAD_INDEX,
        )

        self.lstm = nn.LSTM(
            input_size=embedding_size,
            hidden_size=hidden_size,
            num_layers=number_of_layers,
            batch_first=True,
            bidirectional=True,
            dropout=dropout if number_of_layers > 1 else 0.0,
        )

        self.dropout = nn.Dropout(dropout)

        self.classifier = nn.Linear(
            hidden_size * 2,
            number_of_classes,
        )

    def forward(
        self,
        token_ids: torch.Tensor,
        lengths: torch.Tensor,
    ) -> torch.Tensor:
        embedded = self.embedding(token_ids)

        packed = pack_padded_sequence(
            embedded,
            lengths.cpu(),
            batch_first=True,
            enforce_sorted=False,
        )

        _, (hidden_state, _) = self.lstm(packed)

        forward_state = hidden_state[-2]
        backward_state = hidden_state[-1]

        final_state = torch.cat(
            [forward_state, backward_state],
            dim=1,
        )

        final_state = self.dropout(final_state)

        return self.classifier(final_state)
به دلیل دوطرفهبودن LSTM، آخرین وضعیت جهت جلو و جهت عقب با یکدیگر ترکیب میشوند.
در مستندات رسمی PyTorch، ورودی LSTM بهصورت Tensor سهبعدی پردازش میشود و با فعالکردن batch_first ترتیب ابعاد ورودی به شکل Batch، طول دنباله و ویژگی خواهد بود.
راهاندازی مدل و Optimizer
device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

model = PersianBiLSTMClassifier(
    vocabulary_size=len(vocabulary),
    embedding_size=128,
    hidden_size=128,
    number_of_layers=2,
    number_of_classes=2,
    dropout=0.3,
).to(device)

criterion = nn.CrossEntropyLoss()

optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=0.001,
    weight_decay=0.0001,
)

print(device)
در خروجی مدل از Softmax استفاده نکردهایم؛ زیرا CrossEntropyLoss تبدیل موردنیاز را داخل خود انجام میدهد.
حلقه آموزش مدل
def train_one_epoch(
    model,
    data_loader,
    optimizer,
    criterion,
    device,
):
    model.train()

    total_loss = 0.0
    total_correct = 0
    total_samples = 0

    for token_ids, lengths, labels in data_loader:
        token_ids = token_ids.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        logits = model(token_ids, lengths)
        loss = criterion(logits, labels)

        loss.backward()

        nn.utils.clip_grad_norm_(
            model.parameters(),
            max_norm=1.0,
        )

        optimizer.step()

        total_loss += loss.item() * labels.size(0)

        predictions = logits.argmax(dim=1)
        total_correct += (
            predictions == labels
        ).sum().item()

        total_samples += labels.size(0)

    return {
        "loss": total_loss / total_samples,
        "accuracy": total_correct / total_samples,
    }
تابع clip_grad_norm_ از بزرگشدن کنترلنشده گرادیانها جلوگیری میکند. این تکنیک در آموزش شبکههای بازگشتی اهمیت ویژهای دارد.
ارزیابی روی مجموعه اعتبارسنجی
def evaluate(
    model,
    data_loader,
    criterion,
    device,
):
    model.eval()

    total_loss = 0.0
    total_correct = 0
    total_samples = 0

    with torch.inference_mode():
        for token_ids, lengths, labels in data_loader:
            token_ids = token_ids.to(device)
            labels = labels.to(device)

            logits = model(token_ids, lengths)
            loss = criterion(logits, labels)

            total_loss += loss.item() * labels.size(0)

            predictions = logits.argmax(dim=1)

            total_correct += (
                predictions == labels
            ).sum().item()

            total_samples += labels.size(0)

    return {
        "loss": total_loss / total_samples,
        "accuracy": total_correct / total_samples,
    }
آموزش کامل همراه با Early Stopping
EPOCHS = 20
PATIENCE = 4

best_validation_loss = float("inf")
epochs_without_improvement = 0

for epoch in range(EPOCHS):
    train_metrics = train_one_epoch(
        model,
        train_loader,
        optimizer,
        criterion,
        device,
    )

    validation_metrics = evaluate(
        model,
        valid_loader,
        criterion,
        device,
    )

    print(
        f"Epoch {epoch + 1:02d} | "
        f"Train Loss: {train_metrics['loss']:.4f} | "
        f"Train Accuracy: {train_metrics['accuracy']:.4f} | "
        f"Valid Loss: {validation_metrics['loss']:.4f} | "
        f"Valid Accuracy: {validation_metrics['accuracy']:.4f}"
    )

    if validation_metrics["loss"] < best_validation_loss:
        best_validation_loss = validation_metrics["loss"]
        epochs_without_improvement = 0

        torch.save(
            {
                "model_state": model.state_dict(),
                "vocabulary": vocabulary,
            },
            "persian-bilstm-sentiment.pt",
        )
    else:
        epochs_without_improvement += 1

        if epochs_without_improvement >= PATIENCE:
            print("Early stopping")
            break
Early Stopping آموزش را زمانی متوقف میکند که عملکرد مجموعه اعتبارسنجی برای چند دوره بهتر نشده باشد. این کار خطر بیشبرازش و مصرف غیرضروری منابع را کاهش میدهد.
پیشبینی احساس متن جدید
LABELS = {
    0: "منفی",
    1: "مثبت",
}


def predict_sentiment(
    text: str,
    model: nn.Module,
    vocabulary: dict[str, int],
    device: torch.device,
) -> dict:
    model.eval()

    encoded = encode_text(text, vocabulary)
    length = torch.tensor([len(encoded)])

    token_ids = encoded.unsqueeze(0).to(device)

    with torch.inference_mode():
        logits = model(token_ids, length)
        probabilities = torch.softmax(logits, dim=1)

    predicted_index = probabilities.argmax(dim=1).item()
    confidence = probabilities[0, predicted_index].item()

    return {
        "label": LABELS[predicted_index],
        "confidence": round(confidence, 4),
    }


result = predict_sentiment(
    "کیفیت محصول خوب بود ولی ارسال خیلی دیر انجام شد",
    model,
    vocabulary,
    device,
)

print(result)
خروجی احتمالی:
{
    "label": "منفی",
    "confidence": 0.7814
}
Confidence مدل را نباید بدون ارزیابی Calibration بهعنوان احتمال کاملاً قابلاعتماد تفسیر کرد. ممکن است مدل نسبت به پیشبینی اشتباه خود نیز اطمینان زیادی نشان دهد.
محاسبه Precision، Recall و F1
Accuracy برای دیتاست نامتوازن کافی نیست. اگر بیشتر دیدگاهها مثبت باشند، مدلی که همیشه کلاس مثبت را انتخاب کند ممکن است Accuracy ظاهراً مناسبی داشته باشد.
from sklearn.metrics import classification_report


def classification_metrics(
    model,
    data_loader,
    device,
):
    model.eval()

    all_labels = []
    all_predictions = []

    with torch.inference_mode():
        for token_ids, lengths, labels in data_loader:
            token_ids = token_ids.to(device)

            logits = model(token_ids, lengths)
            predictions = logits.argmax(dim=1).cpu()

            all_labels.extend(labels.tolist())
            all_predictions.extend(predictions.tolist())

    print(
        classification_report(
            all_labels,
            all_predictions,
            target_names=["منفی", "مثبت"],
            digits=4,
        )
    )


classification_metrics(
    model,
    valid_loader,
    device,
)
برای ارزیابی واقعی، مجموعه Test جداگانهای نگه دارید و تنها پس از نهاییشدن مدل از آن استفاده کنید.
جایگزینکردن LSTM با GRU
برای آزمایش GRU، بخش بازگشتی مدل را میتوان تغییر داد:
self.gru = nn.GRU(
    input_size=embedding_size,
    hidden_size=hidden_size,
    num_layers=number_of_layers,
    batch_first=True,
    bidirectional=True,
    dropout=dropout if number_of_layers > 1 else 0.0,
)
خروجی GRU شامل وضعیت سلولی جداگانه نیست:
_, hidden_state = self.gru(packed)

forward_state = hidden_state[-2]
backward_state = hidden_state[-1]
باقی معماری میتواند تقریباً یکسان باقی بماند. هر دو مدل را با تقسیم داده، Seed و معیارهای یکسان مقایسه کنید.
Stateful RNN چیست؟
در حالت معمول، وضعیت مخفی برای هر Batch از نو آغاز میشود. در مدل Stateful، وضعیت پایانی یک Batch میتواند به Batch بعد منتقل شود.
این روش در بعضی دادههای پیوسته مانند جریان حسگر یا قطعات متوالی یک فایل صوتی کاربرد دارد، اما نیازمند دقت زیادی است.
اگر نمونههای دو Batch به یک دنباله واقعی تعلق ندارند، انتقال وضعیت باعث نشت اطلاعات میان نمونهها میشود.
در پردازش دیدگاههای مستقل مشتریان، معمولاً نباید وضعیت یک دیدگاه به دیدگاه بعد منتقل شود.
Padding و Packing چه تفاوتی دارند؟
Padding
جملههای کوتاهتر با توکن خالی پر میشوند تا تمام نمونههای Batch طول یکسان داشته باشند.
Packing
با pack_padded_sequence به LSTM اعلام میکنیم کدام بخش هر دنباله واقعی است. در نتیجه مدل زمان کمتری برای پردازش توکنهای Padding صرف میکند و وضعیت نهایی تحت تأثیر آنها قرار نمیگیرد.
برای استفاده صحیح باید طول واقعی دنبالهها حفظ شود. اگر دادهها مرتب نشدهاند، پارامتر enforce_sorted=False را تنظیم کنید.
Bidirectional، چندلایه و Dropout
LSTM چندلایه
با افزایش num_layers، خروجی یک لایه وارد لایه بازگشتی بعدی میشود. مدل عمیقتر ظرفیت بیشتری دارد، اما هزینه آموزش و خطر بیشبرازش نیز افزایش پیدا میکند.
Dropout
Dropout بخشی از فعالسازیها را در زمان آموزش غیرفعال میکند. در nn.LSTM، Dropout داخلی میان لایههای بازگشتی اعمال میشود و برای مدل تکلایه اثری ندارد.
LSTM دوطرفه
با bidirectional=True دو مسیر مستقل برای خواندن دنباله در جهت جلو و عقب ساخته میشود. در نتیجه اندازه نمایش نهایی معمولاً دو برابر میشود.
کاربردهای RNN، LSTM و GRU
تحلیل احساس
طبقهبندی نظر مشتری، پیام شبکه اجتماعی یا پاسخ نظرسنجی به مثبت، منفی یا خنثی.
طبقهبندی تیکت پشتیبانی
تشخیص موضوع درخواستهایی مانند امور مالی، مشکل فنی، فروش، ارسال یا لغو سفارش.
پیشبینی سری زمانی
تحلیل دادههایی که در طول زمان ثبت میشوند؛ مانند مصرف منابع، بار سرور، داده حسگر و تقاضا.
در داده زمانی باید از تقسیم تصادفی نامناسب پرهیز کرد. داده آینده نباید وارد آموزش مدل گذشته شود.
پردازش گفتار
شبکههای بازگشتی در معماریهای کلاسیک تشخیص گفتار، تشخیص رویداد صوتی و پردازش سیگنال کاربرد داشتهاند.
برچسبگذاری دنباله
مدل میتواند برای هر کلمه یا گام زمانی یک برچسب تولید کند؛ مانند تشخیص نام شخص، سازمان یا مکان در متن.
تشخیص ناهنجاری ترتیبی
الگوهای رویداد یا رفتار میتوانند در طول زمان تحلیل شوند تا دنبالههای غیرعادی شناسایی شوند.
پیشبینی رفتار کاربر
دنباله مشاهده صفحات، جستوجوها یا خریدها میتواند برای پیشنهاد اقدام یا محتوای بعدی استفاده شود.
معماری Seq2Seq چیست؟
معماری Sequence-to-Sequence معمولاً از دو بخش تشکیل میشود:
- Encoder برای خواندن دنباله ورودی
- Decoder برای تولید دنباله خروجی
در ترجمه ماشینی کلاسیک، Encoder جمله مبدأ را میخواند و Decoder جمله مقصد را تولید میکند.
آموزش رسمی PyTorch نیز Seq2Seq را ساختاری متشکل از دو RNN معرفی میکند که یکی دنباله ورودی را رمزگذاری و دیگری خروجی را تولید میکند.
در نسخههای اولیه، تمام جمله ورودی در یک بردار ثابت فشرده میشد. این محدودیت برای جملههای طولانی مشکل ایجاد میکرد. سازوکار Attention به Decoder اجازه داد هنگام تولید هر خروجی روی بخش متفاوتی از ورودی تمرکز کند.
همین مسیر در نهایت به معماری Transformer منتهی شد که وابستگی خود به پردازش کاملاً ترتیبی را کاهش داد.
تفاوت RNN و Transformer
| معیار | RNN، LSTM و GRU | Transformer |
|---|---|---|
| پردازش دنباله | عمدتاً مرحلهبهمرحله | بخشهای زیادی بهصورت موازی |
| وابستگی طولانی | در LSTM و GRU بهتر از RNN | معمولاً قویتر |
| سرعت آموزش روی GPU | محدودتر | معمولاً بهتر |
| مصرف حافظه در دنباله بلند | گاهی مناسبتر | ممکن است زیاد باشد |
| جریان زنده | مناسب | نیازمند طراحی مناسب |
| دیتاست کوچک | گاهی عملکرد مناسب | مدل از پیشآموزشدیده معمولاً بهتر |
| مدلهای زبانی بزرگ | کمتر استفاده میشود | معماری غالب |
| مدل سبک لبه | در بعضی پروژهها مناسب | به مدل و بهینهسازی وابسته |
Transformer جایگزین مطلق RNN نیست. در مسائل جریان پیوسته، مدلهای کوچک، سختافزار محدود یا سریهای زمانی خاص، LSTM و GRU همچنان گزینههای قابلبررسی هستند.
چه زمانی LSTM همچنان انتخاب مناسبی است؟
LSTM میتواند مناسب باشد اگر:
- داده ذاتاً ترتیبی است.
- حجم دیتاست بسیار بزرگ نیست.
- مدل باید نسبتاً کوچک باشد.
- داده بهصورت جریان وارد میشود.
- وابستگی به مدلهای از پیشآموزشدیده مطلوب نیست.
- هزینه استقرار باید محدود بماند.
- مسئله دامنهای مشخص و خروجی محدود دارد.
- تأخیر و حافظه دستگاه اهمیت دارند.
چه زمانی Transformer انتخاب بهتری است؟
Transformer یا مدلهای مبتنی بر آن معمولاً زمانی مناسبترند که:
- متنهای طولانی پردازش میشوند.
- درک معنایی پیچیده اهمیت دارد.
- داده آموزش برچسبخورده محدود است.
- مدل از پیشآموزشدیده مرتبط وجود دارد.
- چند وظیفه باید با یک مدل انجام شوند.
- پردازش زبان فارسی عمومی موردنیاز است.
- استخراج ساختاریافته، خلاصهسازی یا تولید متن مطرح است.
- توان پردازشی مناسب در دسترس است.
چه زمانی بهجای آموزش مدل از API استفاده کنیم؟
آموزش LSTM اختصاصی به جمعآوری، پاکسازی و برچسبگذاری داده نیاز دارد. برای بعضی کاربردها، استفاده از یک مدل آماده از طریق API مسیر سریعتری است.
API میتواند مناسب باشد اگر:
- هنوز دیتاست برچسبخورده ندارید.
- میخواهید نمونه اولیه را سریع آزمایش کنید.
- دستهبندیها مرتب تغییر میکنند.
- پیامها پیچیده یا چندموضوعی هستند.
- استخراج دلیل، خلاصه و اقدام پیشنهادی نیز لازم است.
- کیفیت معنایی مهمتر از کمینهکردن هزینه هر درخواست است.
- حجم مصرف اولیه نامشخص است.
LSTM آموزشدیده میتواند برای یک طبقهبندی ثابت، پرتکرار و کمهزینه مناسب باشد. مدل زبانی API انعطاف بیشتری دارد و میتواند همزمان چند خروجی تولید کند.
طبقهبندی پیام فارسی با API درواره
درواره یک API سازگار با OpenAI برای دسترسی یکپارچه به مدلهای مختلف فراهم میکند.
ابتدا کتابخانه را نصب کنید:
pip install openai pydanticمتغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
نمونه طبقهبندی پیام مشتری:
import json
import os
from typing import Literal
from openai import OpenAI
from pydantic import BaseModel
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
class MessageClassification(BaseModel):
category: Literal[
"sales",
"technical",
"billing",
"delivery",
"complaint",
"other",
]
sentiment: Literal[
"positive",
"neutral",
"negative",
]
summary: str
suggested_action: str
def classify_message(
message: str,
) -> MessageClassification:
response = client.chat.completions.create(
model=os.environ["DARVAREH_MODEL"],
temperature=0,
messages=[
{
"role": "system",
"content": (
"پیامهای فارسی مشتریان را تحلیل کن. "
"پاسخ باید فقط JSON معتبر و بدون Markdown باشد."
),
},
{
"role": "user",
"content": f"""
پیام مشتری:
{message}
ساختار خروجی:
{{
"category": "sales | technical | billing | delivery | complaint | other",
"sentiment": "positive | neutral | negative",
"summary": "خلاصه کوتاه فارسی",
"suggested_action": "اقدام پیشنهادی کوتاه"
}}
""",
},
],
)
content = response.choices[0].message.content
if not content:
raise ValueError("پاسخی از مدل دریافت نشد.")
return MessageClassification.model_validate_json(
content
)
result = classify_message(
"سلام، سفارش من سه روز است ارسال نشده و "
"پشتیبانی هم جواب مشخصی نمیدهد."
)
print(result.model_dump_json(indent=2))خروجی نمونه:
{
"category": "delivery",
"sentiment": "negative",
"summary": "مشتری از تأخیر در ارسال و پاسخگویی نامشخص پشتیبانی ناراضی است.",
"suggested_action": "وضعیت سفارش بررسی و زمان دقیق ارسال به مشتری اعلام شود."
}شناسه مدل را از فهرست فعلی مدلهای درواره انتخاب کنید. امکانات خروجی ساختاریافته ممکن است با توجه به مدل متفاوت باشند؛ بنابراین پاسخ را همیشه در سمت سرور اعتبارسنجی کنید.
برای شروع میتوانید مستندات API درواره را مطالعه کنید.
معماری ترکیبی LSTM و مدل زبانی
در بعضی محصولات، بهترین راه استفاده ترکیبی از یک مدل سبک داخلی و مدل زبانی API است.
برای مثال:
- LSTM پیامهای ساده و پرتکرار را طبقهبندی میکند.
- اگر اطمینان مدل بالا باشد، پیام به مسیر مشخص هدایت میشود.
- پیامهای مبهم یا چندموضوعی به مدل زبانی ارسال میشوند.
- مدل زبانی خلاصه، دستهبندی و اقدام پیشنهادی تولید میکند.
- قوانین قطعی سمت سرور خروجی را کنترل میکنند.
- نمونههای بررسیشده برای بهبود مدل داخلی ذخیره میشوند.
این معماری میتواند هزینه را کنترل و در عین حال کیفیت موارد پیچیده را حفظ کند.
مقدار Confidence بهتنهایی برای تصمیمهای مهم کافی نیست. آستانه ارجاع باید با داده اعتبارسنجی و بر اساس هزینه خطا تنظیم شود.
اشتباهات رایج در پروژههای LSTM
تقسیم تصادفی اشتباه داده زمانی
در پیشبینی سری زمانی، دادههای آینده نباید وارد مجموعه آموزش گذشته شوند. تقسیم باید بر اساس زمان انجام شود.
ساخت واژگان از کل دیتاست
اگر واژگان با داده Test ساخته شود، اطلاعات مجموعه ارزیابی وارد خط آموزش خواهد شد.
نادیدهگرفتن طول واقعی دنباله
پردازش Padding مانند کلمه واقعی میتواند نمایش نهایی را خراب و محاسبات غیرضروری ایجاد کند.
استفاده از متن بسیار بلند بدون محدودیت
متنهای بسیار بلند زمان آموزش و مصرف حافظه را افزایش میدهند. توزیع طول متنها را بررسی و راهبرد برش یا قطعهبندی تعریف کنید.
ارزیابی فقط با Accuracy
در داده نامتوازن باید Precision، Recall، F1 و ماتریس درهمریختگی نیز بررسی شوند.
استفاده از وضعیت مخفی نمونه قبلی
برای نمونههای مستقل، وضعیت قبلی باید بازنشانی شود. انتقال نادرست وضعیت نوعی نشت اطلاعات ایجاد میکند.
استفاده بیدلیل از مدل بسیار بزرگ
برای طبقهبندی ساده، افزایش تعداد لایه و Hidden Size ممکن است فقط بیشبرازش و هزینه را بیشتر کند.
نادیدهگرفتن مدل پایه
قبل از LSTM، یک مدل ساده مانند TF-IDF همراه با Logistic Regression را آزمایش کنید. مدل پیچیده باید نسبت به Baseline بهبود قابلاندازهگیری ایجاد کند.
استفاده مستقیم از خروجی مدل در عملیات مهم
اگر خروجی باعث بازپرداخت، تغییر سفارش یا اقدام حساس میشود، قوانین قطعی و مرحله تأیید باید در نرمافزار وجود داشته باشند.
بهینهسازی LSTM برای محیط عملیاتی
محدودکردن طول ورودی
حداکثر طول ورودی را بر اساس توزیع واقعی داده تعیین کنید. انتخاب عدد دلخواه ممکن است اطلاعات مهم را حذف یا منابع زیادی مصرف کند.
استفاده از Batch
پردازش گروهی درخواستها بهرهوری سختافزار را افزایش میدهد، اما برای سرویس بلادرنگ باید میان Throughput و زمان انتظار تعادل برقرار شود.
Quantization
کوانتیزهسازی میتواند اندازه مدل و هزینه اجرای CPU را کاهش دهد. کیفیت مدل را پیش و پس از تبدیل مقایسه کنید.
ثبت نسخه مدل و واژگان
وزن مدل بدون واژگان و پیشپردازش همان نسخه قابلاستفاده نیست. موارد زیر را کنار مدل ثبت کنید:
- Vocabulary
- تنظیمات نرمالسازی
- فهرست برچسبها
- نسخه داده
- حداکثر طول ورودی
- تنظیمات معماری
- معیارهای ارزیابی
- نسخه کتابخانهها
پایش تغییر داده
زبان مشتریان، نام محصولات و نوع درخواستها در طول زمان تغییر میکند. افت توزیع Confidence، افزایش کلاس ناشناخته و کاهش کیفیت نمونههای بررسیشده را پایش کنید.
پرسشهای متداول
RNN مخفف چیست؟
RNN مخفف Recurrent Neural Network و به معنای شبکه عصبی بازگشتی است.
LSTM چیست؟
LSTM نوعی RNN است که با استفاده از حافظه سلولی و دروازههای کنترلکننده، وابستگیهای طولانیتر را بهتر از RNN ساده یاد میگیرد.
GRU چیست؟
GRU یک شبکه بازگشتی دروازهدار با معماری سادهتر از LSTM است. این مدل معمولاً پارامتر کمتر و آموزش سریعتری دارد.
تفاوت LSTM و GRU چیست؟
LSTM وضعیت حافظه جداگانه و دروازههای بیشتری دارد. GRU ساختار سادهتری دارد و وضعیتها را بیشتر با یکدیگر ترکیب میکند. مدل بهتر باید روی دیتاست واقعی مشخص شود.
آیا LSTM برای زبان فارسی مناسب است؟
بله، اما کیفیت آن به حجم داده، نرمالسازی، توکنسازی، واژگان و تعریف دقیق مسئله وابسته است. مدلهای Transformer از پیشآموزشدیده در بسیاری از وظایف متنی پیچیده عملکرد بهتری دارند.
آیا RNN منسوخ شده است؟
خیر. استفاده از RNN در مدلهای زبانی بزرگ کاهش یافته، اما LSTM و GRU همچنان در سری زمانی، داده جریان، پردازش لبه و مدلهای تخصصی کوچک کاربرد دارند.
Bidirectional LSTM چیست؟
BiLSTM دنباله را در دو جهت پردازش میکند و اطلاعات قبل و بعد هر بخش را در نمایش خود در نظر میگیرد.
چرا از pack_padded_sequence استفاده میکنیم؟
این تابع به LSTM کمک میکند بخشهای Padding را نادیده بگیرد و فقط قسمت واقعی هر دنباله را پردازش کند.
آیا میتوان LSTM را بدون GPU آموزش داد؟
بله. مدلهای کوچک و دیتاستهای محدود روی CPU قابلآموزشاند، اما GPU آموزش مدلهای بزرگتر را سریعتر میکند.
برای طبقهبندی پیام مشتری LSTM بهتر است یا مدل زبانی؟
اگر دستهها ثابت، حجم درخواست زیاد و دیتاست برچسبخورده مناسب باشد، LSTM میتواند سریع و اقتصادی باشد. اگر پیامها پیچیدهاند یا همزمان به خلاصه، استدلال و استخراج اطلاعات نیاز دارید، مدل زبانی API انعطاف بیشتری دارد.
جمعبندی
RNN برای پردازش دادههایی طراحی شده است که ترتیب عناصر در آنها اهمیت دارد. این شبکه اطلاعات قبلی را در یک وضعیت داخلی نگه میدارد و هنگام پردازش مراحل بعدی از آن استفاده میکند.
RNN ساده در یادگیری وابستگیهای طولانی محدودیت دارد. LSTM با حافظه سلولی و دروازههای کنترلی این مشکل را کاهش میدهد. GRU نیز هدفی مشابه دارد، اما ساختار سادهتری ارائه میکند.
برای ساخت یک سامانه واقعی باید تنها به معماری مدل توجه نکنید. کیفیت داده، جداسازی صحیح مجموعهها، مدیریت Padding، ارزیابی چندمعیاره، کنترل گرادیان، ثبت نسخه مدل و پایش تغییر داده نیز ضروری هستند.
در پروژههای متنی جدید، Transformer و مدلهای زبانی آماده اغلب گزینههای قدرتمندی هستند. بااینحال، LSTM و GRU برای مسائل محدود، مدلهای سبک، سریهای زمانی و پردازش ترتیبی همچنان ارزش زیادی دارند.
اگر نمیخواهید از ابتدا مدل آموزش دهید، میتوانید با API درواره مدلهای مختلف را روی داده واقعی خود آزمایش کنید و کیفیت، سرعت و هزینه هر مدل را بسنجید.
مقالات مرتبط
- شبکه عصبی چیست؟
- Transformer و Attention چیست؟
- پردازش زبان طبیعی NLP چیست؟
- PyTorch چیست؟
- Embedding چیست؟
- ماتریس درهمریختگی، Precision و Recall
- آموزش اتصال API هوش مصنوعی به نرمافزار
- API سازگار با OpenAI چیست؟
منابع
- PyTorch LSTM Documentation
- PyTorch GRU Documentation
- PyTorch Sequence Models and LSTM Tutorial
- PyTorch Seq2Seq and Attention Tutorial
- Keras LSTM Documentation
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



