
مقداردهی اولیه وزنهای شبکه عصبی چیست؟ آموزش Xavier و He باPyTorch
مقداردهی اولیه وزنهای شبکه عصبی چیست و چرا بر آموزش اثر میگذارد؟ در این راهنما، روشهای Xavier و He یا Kaiming، ارتباط آنها با تابع فعالسازی و شیوه مقایسه عملی مقداردهی پیشفرض PyTorch را با کد کامل میآموزید.

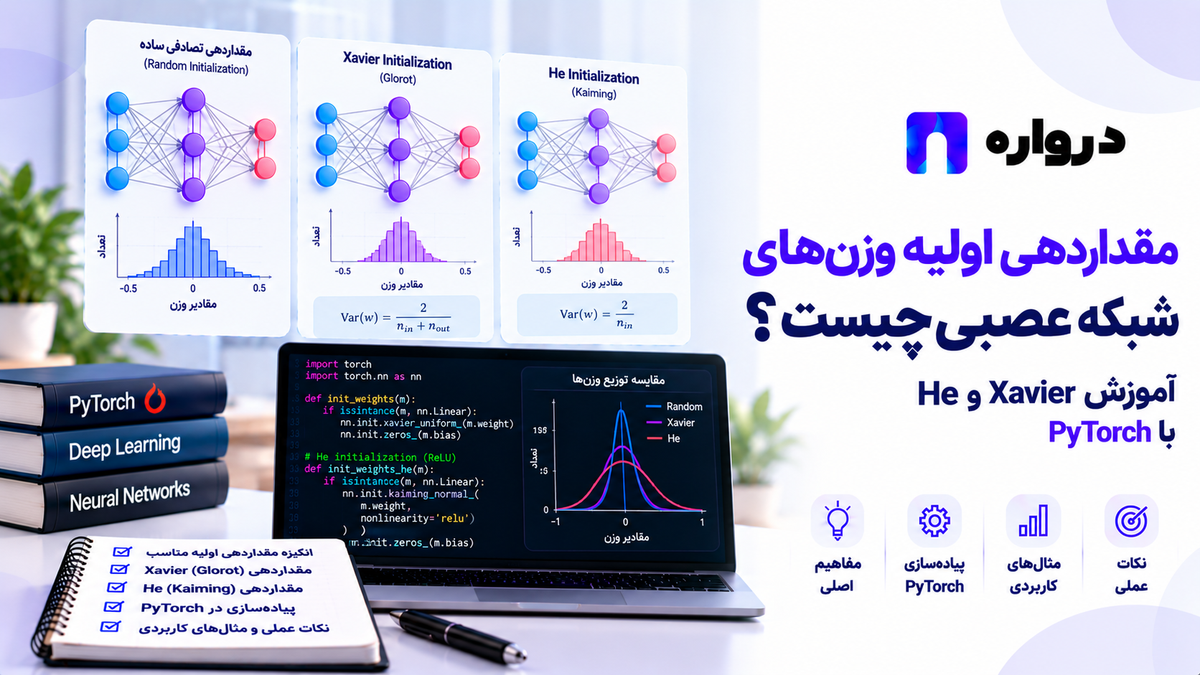
پیش از آنکه شبکه عصبی اولین داده آموزشی را ببیند، وزنهای لایههایش باید مقداری اولیه داشته باشند. این مرحله را مقداردهی اولیه وزنها یا Weight Initialization مینامند.
این انتخاب ممکن است جزئی به نظر برسد، اما نقطه شروع آموزش را تعیین میکند. اگر وزنهای یک شبکه عمیق بسیار کوچک یا بسیار بزرگ باشند، اطلاعات و گرادیانها ممکن است هنگام عبور از لایهها مقیاس نامناسبی پیدا کنند. در نتیجه، آموزش میتواند کند یا ناپایدار شود.
دو خانواده شناختهشده برای مقداردهی اولیه عبارتاند از:
- Xavier یا Glorot Initialization
- He یا Kaiming Initialization
Xavierبا پژوهش Xavier Glorot و Yoshua Bengio درباره دشواری آموزش شبکههای عمیق پیوند دارد. روش He نیز در پژوهشی درباره شبکههای دارای فعالسازهای یکسوساز، از جمله ReLU، مطرح شد. هر دو پژوهش به رفتار سیگنال و گرادیان در شبکههای چندلایه توجه دارند. proceedings.mlr.press
در این مقاله، روشها را بدون فرمولنویسی پیچیده توضیح میدهیم و سپس با PyTorch مقداردهی پیشفرض، Xavier و He را در یک آزمایش قابلتکرار مقایسه میکنیم.
وزن اولیه چه نقشی در آموزش دارد؟
یک لایه عصبی ورودی را با وزنهای خود ترکیب میکند و خروجی را به لایه بعد میدهد. در مرحله آموزش، مقدار این وزنها بر اساس گرادیانها تغییر میکند.
بنابراین وزنهای اولیه بر چند چیز اثر میگذارند:
- خروجی اولیه هر لایه.
- اندازه سیگنالی که به لایههای بعد میرسد.
- رفتار فعالسازهایی مانند ReLU وTanh.
- گرادیانهایی که هنگام پسانتشار به لایههای قبلی میرسند.
- سرعت و پایداری مراحل آغازین آموزش.
مقداردهی اولیه مناسب موفقیت مدل را تضمین نمیکند. معماری، داده، نرخ یادگیری و تابع خطا نیز مهماند. بااینحال، نقطه شروع نامناسب میتواند آموزش یک معماری خوب را دشوار کند.
آیا نمیتوان همه وزنها را صفر گذاشت؟
برای وزنهای لایههای پنهان یک شبکه معمولی، صفرکردن همه مقادیر معمولاً انتخاب مناسبی نیست.
اگر نورونهای یک لایه وزنهای یکسان داشته باشند، میتوانند خروجی و گرادیان یکسانی بگیرند و به شیوه مشابهی تغییر کنند. در چنین حالتی، وجود چند نورون لزوماً به یادگیری ویژگیهای متفاوت منجر نمیشود. به این وضعیت، مشکل تقارن میگویند.
این موضوع را با مقداردهی بایاسها اشتباه نگیرید. صفرگذاشتن بایاس اولیه در بسیاری از لایهها رایج است؛ مشکل اصلیِ مثال بالا، یکسانکردن وزن همه نورونهای مشابه است.
همچنین «همه وزنها را تصادفی کن» بهتنهایی دستور کافی نیست. مقیاس مقادیر تصادفی اهمیت دارد.
وزنهای خیلی کوچک یا خیلی بزرگ چه مشکلی ایجاد میکنند؟
اگر سیگنال در هر لایه ضعیفتر شود، ممکن است در لایههای بعد یا هنگام بازگشت گرادیان به لایههای ابتدایی، مقادیر بسیار کوچکی به دست آید. در مقابل، بزرگشدن پیدرپی مقادیر نیز میتواند آموزش را ناپایدار کند.
رفتار دقیق به معماری، فعالساز و سایر اجزای شبکه وابسته است. مقاله Glorot و Bengio نقش فعالسازها و تغییر اندازه فعالسازیها و گرادیانها در لایههای مختلف را از عوامل مهم دشواری آموزش شبکههای عمیق بررسی میکند. proceedings.mlr.press
بنابراین هدف مقداردهی اولیه، انتخاب چند عدد «کوچک» بهصورت دلخواه نیست؛ هدف این است که مقیاس وزنها با شکل لایه و رفتار شبکه هماهنگ باشد.
Fan In و Fan Outچیست؟
بسیاری از روشهای مقداردهی اولیه به اندازه ورودی و خروجی لایه توجه میکنند:
- Fan In: شمار ورودیهایی که به یک واحد یا فیلتر میرسند.
- Fan Out: شمار خروجیهایی که از واحد یا فیلتر ساخته میشوند.
برای یک لایه خطی با ۶۴ ویژگی ورودی و ۱۲۸ خروجی، این دو مقدار بهترتیب به ابعاد ورودی و خروجی لایه مربوطاند.
در لایههای کانولوشنی، تعداد کانالها و اندازه فیلتر نیز در محاسبه دخالت دارند. مزیت استفاده از توابع رسمی PyTorch این است که لازم نیست برای لایههای استاندارد این محاسبات را خودتان انجام دهید.
مستندات PyTorch توضیح میدهد که توابع Xavier و Kaiming از این ویژگیهای وزن برای تعیین توزیع اولیه استفاده میکنند. PyTorch main documentation
مقداردهی اولیه Xavier یا Glorot چیست؟
Xavier Initialization، که با نام Glorot Initialization نیز شناخته میشود، روشی برای تعیین مقیاس وزنهای آغازین با توجه به اندازه ورودی و خروجی لایه است.
این روش دو پیادهسازی رایج در PyTorch دارد:
nn.init.xavier_uniform_(layer.weight)و:
nn.init.xavier_normal_(layer.weight)تفاوت این دو در نوع توزیعی است که مقادیر اولیه از آن گرفته میشوند: یکی یکنواخت و دیگری نرمال. هر دو در خانواده Xavier قرار میگیرند. مستندات PyTorch آنها را به پژوهش Glorot و Bengio ارجاع میدهد. PyTorch main documentation
Xavierبرای چه زمانی مناسب است؟
Xavierیک گزینه قابلآزمایش برای شبکههای پیشخور و بهویژه لایههایی است که قصد دارید مقیاس ورودی و خروجی آنها را با توجه به هر دو سمت لایه مدیریت کنید.
اما یک قانون مطلق از نوع «هر جا Tanh بود Xavier و هر جا ReLU بود He» وجود ندارد. معماریهای مدرن ممکن است شامل مسیرهای باقیمانده، نرمالسازی، گیتها و طراحیهای خاص خود باشند. مقداردهی پیشنهادی یک معماری شناختهشده را نباید بدون بررسی با قاعدهای عمومی جایگزین کرد.
gain در Xavier چیست؟
در PyTorch میتوان مقیاس مقداردهی Xavier را با پارامتر gain تنظیم کرد:
gain = nn.init.calculate_gain(
    "tanh"
)

nn.init.xavier_uniform_(
    layer.weight,
    gain=gain,
)
تابع calculate_gain در PyTorch مقدار پیشنهادی برای بعضی غیرخطیها را برمیگرداند. مستندات رسمی، نمونه استفاده از gain را برای Xavier نیز نشان میدهد. PyTorch main documentation
باید دقت کنید gain مربوط به فعالسازی بعد از همان لایه است. برای مثال، اگر لایه خروجی امتیاز خام کلاسها را تولید میکند، نباید بیدلیل تنظیم فعالساز لایههای پنهان را به آن تعمیم دهید.
مقداردهی اولیه He یا Kaiming چیست؟
He Initialization که در PyTorch با نام Kaiming Initialization دیده میشود، برای شبکههای دارای فعالسازهای یکسوساز مانند ReLU مطرح شده است.
دو تابع رایج آن:
nn.init.kaiming_uniform_(
    layer.weight,
    nonlinearity="relu",
)
و:
nn.init.kaiming_normal_(
    layer.weight,
    nonlinearity="relu",
)
در مقاله He و همکاران، مقداردهی اولیه متناسب با رفتار فعالسازهای یکسوساز بررسی شده است. در مستندات PyTorch نیز kaiming_normal_ به همان پژوهش ارجاع داده میشود و استفاده از آن برای relu یا leaky_relu توصیه شده است. arxiv.org
Kaiming با Xavierچه تفاوتی دارد؟
تفاوت فقط نام توزیع یا تصادفیبودن مقادیر نیست. این روشها برای تعیین مقیاس وزنها از ملاحظات متفاوتی استفاده میکنند.
برای یک شبکه پنهان با ReLU، Kaiming معمولاً گزینهای منطقی برای شروع آزمایش است؛ زیرا با رفتار این فعالساز طراحی شده است. بااینحال، مقاله اصلی He در آزمایشهای خود نیز برتری یکسان و قطعی در همه معیارها و همه معماریها گزارش نمیکند. نتیجه نهایی را باید روی مسئله خود بسنجید. arxiv.org
fan_in و fan_out درKaiming
در توابع Kaiming میتوانید پارامتر mode را تنظیم کنید:
nn.init.kaiming_normal_(
    layer.weight,
    mode="fan_in",
    nonlinearity="relu",
)
یا:
nn.init.kaiming_normal_(
    layer.weight,
    mode="fan_out",
    nonlinearity="relu",
)
در مستنداتPyTorch، fan_in با حفظ مقیاس در مسیر روبهجلو و fan_out با توجه به مسیر بازگشت گرادیان توضیح داده میشود. انتخاب پیشفرض fan_in برای بسیاری از مثالهای ساده شروع مناسبی است؛ انتخاب نهایی به طراحی شبکه وابسته خواهد بود. PyTorch main documentation
اگر وزن را با قرارداد متفاوتی از لایههای معمول nn.Linear در ضرب ماتریسی استفاده میکنید، به هشدار مستندات PyTorch درباره جهت ماتریس وزن توجه کنید. PyTorch main documentation
مقداردهی اولیه برایLeaky ReLU
اگر از LeakyReLU استفاده میکنید، پارامتر شیب بخش منفی را با مقداردهی اولیه هماهنگ کنید:
negative_slope = 0.1

layer = nn.Linear(
    64,
    128,
)

activation = nn.LeakyReLU(
    negative_slope=negative_slope
)

nn.init.kaiming_normal_(
    layer.weight,
    a=negative_slope,
    nonlinearity="leaky_relu",
)
در این مثال، مقدار a در مقداردهی اولیه با شیب LeakyReLU یکسان است. رابط رسمی PyTorch هر دو پارامتر را برای kaiming_normal_ تعریف میکند. PyTorch main documentation
مقایسه Xavier، He و مقداردهی پیشفرض
| روش | ایده اصلی | نمونه کاربرد برای آزمایش | تابع PyTorch |
|---|---|---|---|
| مقداردهی پیشفرض لایه | رفتار تعریفشده توسط پیادهسازی همان لایه | Baseline پیش از سفارشیسازی | ساخت عادی nn.Linear یا nn.Conv2d |
| Xavier / Glorot | توجه به ابعاد ورودی و خروجی لایه | لایههای پیشخور متناسب با طراحی شبکه | xavier_uniform_ یا xavier_normal_ |
| He / Kaiming | مقداردهی متناسب با فعالسازهای یکسوساز | لایههای پنهان با ReLU یا Leaky ReLU | kaiming_uniform_ یا kaiming_normal_ |
| Orthogonal | ساخت وزن با ساختار متعامد یا نیمهمتعامد | برخی معماریها و آزمایشهای تخصصی | orthogonal_ |
وجود یک تابع در این جدول به معنی مناسببودن آن برای هر لایه نیست. برای مثال، رفتار لایه خروجی و لایه پنهانِ دارای ReLU لزوماً یکسان نیست. مستندات PyTorch توابع بالا را معرفی میکند، اما انتخاب پیکربندی مناسب به معماری و آزمایش شما وابسته است. PyTorch main documentation
آیا مقداردهی پیشفرض PyTorch بد است؟
خیر. لایههای PyTorch هنگام ساختهشدن بدون مقداردهی اولیه رها نمیشوند. آنها سازوکار مقداردهی پیشفرض خود را دارند.
به همین دلیل، در یک آزمایش واقعی ابتدا مقداردهی پیشفرض را بهعنوان Baseline نگه دارید. تغییر آن به Xavier یا Kaiming باید با دلیل و سنجش همراه باشد.
همچنین در مدلهای از پیش آموزشدیده، مقداردهی دوباره وزنها میتواند دانش آموختهشده مدل را پاک کند. هنگام Fine-tuning، فقط لایههایی را که واقعاً قصد دارید از ابتدا مقداردهی شوند، مشخص کنید.
مقداردهی اولیه در PyTorch با model.apply
PyTorch اجازه میدهد تابعی را روی زیرماژولهای یک مدل اجرا کنید. برای مثال، اگر بخواهید تمام لایههای خطی یک مدل ساده را بهصورت Xavierمقداردهی کنید:
import torch
from torch import nn


def initialize_xavier(module):
    if isinstance(
        module,
        nn.Linear,
    ):
        nn.init.xavier_uniform_(
            module.weight
        )

        if module.bias is not None:
            nn.init.zeros_(
                module.bias
            )


model.apply(
    initialize_xavier
)
توابع torch.nn.init برای مقداردهی پارامترها طراحی شدهاند و طبق مستندات PyTorch، این عملیات در حالت بدون ثبت گرادیان اجرا میشود. PyTorch main documentation
این تابع نمونه، تمام لایههای خطی از جمله لایه خروجی را به یک شیوه مقداردهی میکند. در مدلهای واقعی بهتر است برای هر بخش، فعالساز بعد از آن و نقش لایه را نیز در نظر بگیرید.
آموزش عملی: مقایسه سه روش روی طبقهبندی رقمها
در این مثال، از مجموعهداده Digits در scikit-learn استفاده میکنیم. هر نمونه تصویری کوچک از یک رقم دستنویس است که به برداری با ۶۴ ویژگی تبدیل میشود.
سه روش را مقایسه میکنیم:
- مقداردهی پیشفرضPyTorch
- Xavierبرای لایههای پنهان و خروجی
- Kaiming برای لایههای پنهان دارای ReLU و Xavierبرای خروجی
برای آنکه اختلافها قابلتفسیرتر شوند، معماری، داده، بهینهساز، تعداد Epoch و ترتیب Batchها را ثابت نگه میداریم.
نصب کتابخانهها
pip install torch scikit-learn matplotlibآمادهسازی داده
ابتدا داده Test را کنار میگذاریم. سپس داده باقیمانده را به Train و Validation تقسیم میکنیم. مقیاسساز فقط روی Train برازش میشود.
import numpy as np
import torch

from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

from torch.utils.data import (
    DataLoader,
    TensorDataset,
)


SEED = 42
BATCH_SIZE = 64
EPOCHS = 30

np.random.seed(SEED)
torch.manual_seed(SEED)

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

digits = load_digits()

X = digits.data.astype(np.float32)
y = digits.target.astype(np.int64)

X_train_val, X_test, y_train_val, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.20,
        stratify=y,
        random_state=SEED,
    )
)

X_train, X_val, y_train, y_val = (
    train_test_split(
        X_train_val,
        y_train_val,
        test_size=0.20,
        stratify=y_train_val,
        random_state=SEED,
    )
)

scaler = StandardScaler()

X_train = scaler.fit_transform(
    X_train
).astype(np.float32)

X_val = scaler.transform(
    X_val
).astype(np.float32)

X_test = scaler.transform(
    X_test
).astype(np.float32)


def to_dataset(features, labels):
    return TensorDataset(
        torch.from_numpy(features),
        torch.from_numpy(labels),
    )


train_dataset = to_dataset(
    X_train,
    y_train,
)

val_dataset = to_dataset(
    X_val,
    y_val,
)

test_dataset = to_dataset(
    X_test,
    y_test,
)

print(
    "Train / Validation / Test:",
    len(train_dataset),
    len(val_dataset),
    len(test_dataset),
)

print("Device:", device)
جداکردن Validation و Test اهمیت دارد: روش مقداردهی و تنظیمات آموزشی را روی Validation بررسی میکنیم و Test را برای ارزیابی نهایی نگه میداریم.
ساخت شبکه عصبی
از چند لایه خطی و ReLU استفاده میکنیم تا نقش مقداردهی در لایههای پنهان روشنتر باشد:
from torch import nn


class DigitMLP(nn.Module):
    def __init__(self):
        super().__init__()

        self.hidden_layers = nn.Sequential(
            nn.Linear(64, 128),
            nn.ReLU(),

            nn.Linear(128, 128),
            nn.ReLU(),

            nn.Linear(128, 128),
            nn.ReLU(),

            nn.Linear(128, 64),
            nn.ReLU(),
        )

        self.output_layer = nn.Linear(
            64,
            10,
        )

    def forward(self, images):
        features = self.hidden_layers(
            images
        )

        return self.output_layer(
            features
        )
خروجی آخر، امتیاز خام ۱۰ کلاس را تولید میکند. برای آموزش از CrossEntropyLoss استفاده خواهیم کرد.
تعریف روشهای مقداردهی اولیه
این تابع از نام روش استفاده میکند و فقط در صورت انتخاب Xavier یا Kaiming، وزنهای پیشفرض را تغییر میدهد:
def initialize_model(
model,
method,
):
if method == "default":
return model
for module in model.hidden_layers:
if not isinstance(
module,
nn.Linear,
):
continue
if method == "xavier":
nn.init.xavier_uniform_(
module.weight
)
elif method == "kaiming":
nn.init.kaiming_normal_(
module.weight,
mode="fan_in",
nonlinearity="relu",
)
else:
raise ValueError(
f"Unknown method: {method}"
)
if module.bias is not None:
nn.init.zeros_(
module.bias
)
# خروجی امتیاز خام میدهد و ReLU ندارد.
nn.init.xavier_uniform_(
model.output_layer.weight,
gain=1.0,
)
if (
model.output_layer.bias
is not None
):
nn.init.zeros_(
model.output_layer.bias
)
return modelدر روش Kaiming، فقط لایههای پنهانی که پس از آنها ReLU قرار دارد با تنظیم nonlinearity="relu" مقداردهی میشوند. لایه خروجی با Xavier و gain=1.0 مقداردهی شده است. این یک انتخاب مشخص برای آزمایش ماست، نه قانون جهانی برای همه مدلها.
تابع ارزیابی
def evaluate(
    model,
    data_loader,
    device,
):
    model.eval()

    criterion = nn.CrossEntropyLoss(
        reduction="sum"
    )

    total_loss = 0.0
    total_correct = 0
    total_samples = 0

    with torch.inference_mode():
        for images, labels in data_loader:
            images = images.to(device)
            labels = labels.to(device)

            logits = model(images)

            total_loss += criterion(
                logits,
                labels,
            ).item()

            total_correct += (
                logits.argmax(dim=1)
                == labels
            ).sum().item()

            total_samples += (
                labels.size(0)
            )

    return {
        "loss": (
            total_loss / total_samples
        ),
        "accuracy": (
            total_correct
            / total_samples
        ),
    }
تابع آموزش با شرایط یکسان
پیش از ساخت هر مدل، بذر تصادفی یکسانی تنظیم میکنیم. این کار باعث میشود ساخت مدلها از شرایط تصادفی قابلکنترلتری آغاز شود. در کنار آن، برای ترتیب Batchها نیز از بذر ثابت استفاده میکنیم.
نکته: حتی با بذر یکسان، مقداردهی Xavier و Kaiming وزنهای عددی یکسانی تولید نمیکنند؛ هدف، کنترل بخشی از عوامل تصادفی است، نه یکسانکردن خودِ وزنها.
from copy import deepcopy


def run_experiment(
    method,
    train_dataset,
    val_dataset,
    device,
):
    torch.manual_seed(SEED)

    model = DigitMLP()

    model = initialize_model(
        model,
        method,
    ).to(device)

    optimizer = torch.optim.AdamW(
        model.parameters(),
        lr=0.001,
        weight_decay=0.001,
    )

    criterion = nn.CrossEntropyLoss()

    generator = torch.Generator()
    generator.manual_seed(SEED)

    train_loader = DataLoader(
        train_dataset,
        batch_size=BATCH_SIZE,
        shuffle=True,
        generator=generator,
    )

    val_loader = DataLoader(
        val_dataset,
        batch_size=BATCH_SIZE,
        shuffle=False,
    )

    history = []

    best_val_loss = float("inf")
    best_epoch = None
    best_weights = None

    for epoch in range(
        1,
        EPOCHS + 1,
    ):
        model.train()

        total_train_loss = 0.0
        total_train_samples = 0

        for images, labels in train_loader:
            images = images.to(device)
            labels = labels.to(device)

            optimizer.zero_grad()

            logits = model(images)

            loss = criterion(
                logits,
                labels,
            )

            loss.backward()
            optimizer.step()

            batch_size = (
                labels.size(0)
            )

            total_train_loss += (
                loss.item()
                * batch_size
            )

            total_train_samples += (
                batch_size
            )

        train_loss = (
            total_train_loss
            / total_train_samples
        )

        val_metrics = evaluate(
            model,
            val_loader,
            device,
        )

        history.append(
            {
                "epoch": epoch,
                "train_loss": (
                    train_loss
                ),
                "val_loss": (
                    val_metrics["loss"]
                ),
                "val_accuracy": (
                    val_metrics[
                        "accuracy"
                    ]
                ),
            }
        )

        if (
            val_metrics["loss"]
            < best_val_loss
        ):
            best_val_loss = (
                val_metrics["loss"]
            )

            best_epoch = epoch

            best_weights = deepcopy(
                model.state_dict()
            )

    model.load_state_dict(
        best_weights
    )

    return {
        "model": model,
        "history": history,
        "best_epoch": best_epoch,
        "best_val_loss": (
            best_val_loss
        ),
}وزنهای بهترین Epoch را با deepcopy نگه میداریم تا مراحل بعدی آموزش آنها را تغییر ندهند.
اجرای سه آزمایش
experiments = {}

for method in (
    "default",
    "xavier",
    "kaiming",
):
    experiments[method] = (
        run_experiment(
            method=method,
            train_dataset=train_dataset,
            val_dataset=val_dataset,
            device=device,
        )
    )

    result = experiments[
        method
    ]

    print(
        f"{method:8s} | "
        f"Best epoch: "
        f"{result['best_epoch']:02d} | "
        f"Validation loss: "
        f"{result['best_val_loss']:.4f}"
    )
این مقاله نتیجه اجرای کد را جعل نمیکند. خروجی واقعی به محیط اجرا، نسخه کتابخانهها و تنظیمات وابسته است.
رسم منحنیهای آموزش
import matplotlib.pyplot as plt


figure, axes = plt.subplots(
    1,
    2,
    figsize=(12, 4),
)

for method, result in experiments.items():
    history = result["history"]

    epochs = [
        row["epoch"]
        for row in history
    ]

    train_losses = [
        row["train_loss"]
        for row in history
    ]

    val_losses = [
        row["val_loss"]
        for row in history
    ]

    val_accuracies = [
        row["val_accuracy"]
        for row in history
    ]

    axes[0].plot(
        epochs,
        train_losses,
        label=f"{method} train",
    )

    axes[0].plot(
        epochs,
        val_losses,
        linestyle="--",
        label=f"{method} validation",
    )

    axes[1].plot(
        epochs,
        val_accuracies,
        label=method,
    )

axes[0].set_xlabel(
    "Epoch"
)

axes[0].set_ylabel(
    "Loss"
)

axes[0].set_title(
    "Training and validation loss"
)

axes[0].legend()

axes[1].set_xlabel(
    "Epoch"
)

axes[1].set_ylabel(
    "Validation accuracy"
)

axes[1].set_title(
    "Validation accuracy"
)

axes[1].legend()

plt.tight_layout()
plt.show()بهجای نگاهکردن فقط به آخرین عدد، این پرسشها را بررسی کنید:
- آیا یکی از روشها در Epochهای ابتدایی سریعتر پیشرفت کرده است؟
- آیا تفاوت تا پایان آموزش باقی مانده است؟
- آیا Train Loss بهتر شده، اما Validation بهبود نیافته است؟
- آیا مقداردهی پیشفرض به همان خوبی روشهای سفارشی عمل کرده است؟
- آیا روش انتخابشده روی چند اجرای مستقل نیز عملکرد مشابه دارد؟
انتخاب روش و ارزیابی نهایی
روش را با کمترینValidation Loss انتخاب میکنیم. سپس فقط مدل منتخب را روی Test ارزیابی میکنیم:
selected_method = min(
    experiments,
    key=lambda method: (
        experiments[method][
            "best_val_loss"
        ]
    ),
)

test_loader = DataLoader(
    test_dataset,
    batch_size=BATCH_SIZE,
    shuffle=False,
)

selected_model = experiments[
    selected_method
]["model"]

test_metrics = evaluate(
    selected_model,
    test_loader,
    device,
)

print(
    "Selected method:",
    selected_method,
)

print(
    "Test loss:",
    round(
        test_metrics["loss"],
        4,
    ),
)

print(
    "Test accuracy:",
    round(
        test_metrics["accuracy"],
        4,
    ),
)
اگر پس از دیدن Test روش مقداردهی، معماری یا نرخ یادگیری را تغییر دهید و دوباره از همان Test برای انتخاب استفاده کنید، ارزیابی نهایی دیگر مستقل نخواهد بود.
بررسی فعالسازی لایهها پیش از آموزش
علاوه بر Loss، میتوان رفتار خروجی لایههای پنهان را پیش از اولین گام آموزش مشاهده کرد.
برای نمونه، کد زیر خروجی هر ReLU را در یک Batch ثبت میکند:
def inspect_relu_activations(
    model,
    features,
):
    model.eval()

    records = []
    handles = []

    def make_hook(layer_name):
        def hook(
            module,
            inputs,
            output,
        ):
            values = (
                output.detach()
            )

            records.append(
                {
                    "layer": layer_name,
                    "mean": (
                        values.mean().item()
                    ),
                    "std": (
                        values.std().item()
                    ),
                    "zero_fraction": (
                        (values == 0)
                        .float()
                        .mean()
                        .item()
                    ),
                }
            )

        return hook

    for name, module in (
        model.named_modules()
    ):
        if isinstance(
            module,
            nn.ReLU,
        ):
            handles.append(
                module.register_forward_hook(
                    make_hook(name)
                )
            )

    with torch.inference_mode():
        model(
            features
        )

    for handle in handles:
        handle.remove()

    return records
اجرای آن روی یک مدل تازه باKaiming:
torch.manual_seed(SEED)

inspection_model = (
    initialize_model(
        DigitMLP(),
        "kaiming",
    )
).to(device)

sample_features = (
    torch.from_numpy(
        X_train[:128]
    ).to(device)
)

activation_report = (
    inspect_relu_activations(
        inspection_model,
        sample_features,
    )
)

for item in activation_report:
    print(item)
این اعداد بهتنهایی ثابت نمیکنند که مدل خوب یا بد آموزش خواهد دید. اما اگر مقیاس فعالسازیها در لایههای متوالی بهشدت تغییر میکند یا بخش بزرگی از خروجیها الگوی غیرمنتظرهای دارند، نقطهای برای بررسی بیشتر به دست میآورید.
نکته: صفرشدن بخشی از خروجی ReLU طبیعی است. هر مقدار غیرصفر برای zero_fraction نشانه خرابی مدل نیست.
بررسی گرادیانها پس از اولین گام پسانتشار
میتوان پس از محاسبه Loss و پیش از optimizer.step()، اندازه گرادیان لایهها را نیز ثبت کرد:
def print_gradient_norms(model):
    for name, parameter in (
        model.named_parameters()
    ):
        if (
            parameter.grad is None
        ):
            continue

        print(
            name,
            parameter.grad
            .norm()
            .item(),
        )
نمونه استفاده:
model.train()

features, labels = next(
    iter(train_loader)
)

features = features.to(device)
labels = labels.to(device)

optimizer.zero_grad()

logits = model(features)

loss = criterion(
    logits,
    labels,
)

loss.backward()

print_gradient_norms(model)

optimizer.step()
این قطعهکد فرض میکند model، train_loader، criterion و optimizer از پیش برای همان اجرای آموزشی تعریف شدهاند.
یک مقدار بزرگ یا کوچک در یک Batch، بهتنهایی تشخیص قطعی نیست. رفتار را در چند Batch و چند مرحله آموزش بررسی کنید.
مقداردهی اولیه در شبکه کانولوشنی
در شبکههای تصویری، لایههای Conv2d نیز وزن دارند و میتوان برای آنها از توابع Kaiming استفاده کرد:
def initialize_cnn_with_kaiming(
    module,
):
    if isinstance(
        module,
        nn.Conv2d,
    ):
        nn.init.kaiming_normal_(
            module.weight,
            mode="fan_in",
            nonlinearity="relu",
        )

        if module.bias is not None:
            nn.init.zeros_(
                module.bias
            )
سپس:
cnn_model.apply(
    initialize_cnn_with_kaiming
)
این مثال فرض میکند پس از لایههای کانولوشنی موردنظر، ReLU استفاده میشود. اگر فعالساز یا طراحی بلوکها متفاوت است، تابع را متناسب با همان معماری تنظیم کنید.
مقداردهی اولیه لایههای خروجی
یک اشتباه رایج این است که بدون بررسی، روش لایههای پنهان را برای لایه خروجی هم تکرار کنیم.
در مدل طبقهبندی مثال ما:
- لایههای پنهان با ReLU دنبال میشوند.
- لایه خروجی ۱۰ امتیاز خام کلاسها را میسازد.
- پس از لایه خروجی ReLU نداریم.
به همین دلیل در روش Kaiming، لایههای پنهان را با تنظیم مخصوص ReLU مقداردهی کردیم، ولی برای لایه خروجی از Xavier با gain=1.0 استفاده کردیم.
این تصمیم باید با خروجی و تابع خطای همان مدل بررسی شود. برای مدلهای دارای معماری شناختهشده، ابتدا دستورالعمل پیادهسازی اصلی آن معماری را مبنا قرار دهید.
آیا نوع توزیع مهمتر است یا مقیاس وزن؟
هر دو میتوانند اثرگذار باشند، ولی هنگام فهم مسئله بهتر است ابتدا بررسی کنید مقیاس مقادیر اولیه با لایه و فعالساز سازگار است یا خیر.
برای مثال:
- Xavier Uniform و Xavier Normal هر دو از منطق مقیاسبندی Xavierاستفاده میکنند.
- Kaiming Uniform و Kaiming Normal هر دو از خانواده Kaimingهستند.
- تفاوت Uniform و Normal را نیز میتوان در آزمایش کنترلشده بررسی کرد.
اگر چند عامل را همزمان تغییر دهید، تشخیص علت تفاوت نتیجه سخت میشود. برای بررسی دقیق، ابتدا خانواده روش را ثابت نگه دارید و سپس نوع توزیع را جداگانه آزمایش کنید.
مقداردهی اولیه و تابع فعالسازی
انتخاب اولیه وزنها با رفتار تابع فعالسازی ارتباط دارد:
| تابع فعالسازی یا بخش مدل | نقطه شروع برای بررسی |
|---|---|
| لایه پنهان با ReLU | Kaiming با nonlinearity="relu" |
| لایه پنهان با Leaky ReLU | Kaiming با شیب منطبق با فعالساز |
| لایه پنهان با Tanh | Xavier با gain متناسب با Tanh |
| لایه خروجی خطی | بررسی مقداردهی متناسب با معماری و تابع خطا |
| مدل از پیش آموزشدیده | حفظ وزنهای بارگذاریشده مگر برای لایههای جدید |
اینها نقطه شروع آزمایش هستند. پژوهشهای اصلی Xavier و He مسائل و معماریهای معینی را بررسی کردهاند؛ تعمیم یک نتیجه به تمام مدلهای جدید بدون ارزیابی درست نیست. proceedings.mlr.press
آیا Batch Normalization مشکل مقداردهی اولیه را حل میکند؟
Batch Normalizationمیتواند رفتار مقادیر میانی شبکه را تغییر دهد و در بسیاری از معماریها به آموزش کمک کند. بااینحال، وجود آن به معنی بیاهمیتشدن کامل وزنهای اولیه نیست.
مقداردهی اولیه هنوز نقطه شروع محاسبات را مشخص میکند. افزون بر این، برخی معماریها، اندازه Batchها و ترتیب لایهها رفتار خاص خود را دارند.
راه عملی این است که بهجای فرض قطعی، نتیجه مقداردهی پیشفرض و روش سفارشی را روی Validation مقایسه کنید.
آیا برای Transformer از Xavier یا He استفاده کنیم؟
نمیتوان برای کل Transformer یک تابع مقداردهی یکسان پیشنهاد کرد. Transformer شامل بخشهایی مانند تعبیهسازی، نگاشتهای خطی توجه، بلوکهای پیشخور، نرمالسازی و گاهی معماریهای خاص مدلهای از پیش آموزشدیده است.
اگر مدل از پیش آموزشدیده را Fine-tune میکنید، وزنهای بارگذاریشده را دوباره مقداردهی نکنید. اگر مدل را از ابتدا میسازید، از طرح مقداردهی توصیهشده برای همان معماری و پیادهسازی آن شروع کنید و سپس تغییرات را ارزیابی کنید.
مقداردهی اولیه و تکرارپذیری آزمایش
تنظیم بذر تصادفی کمک میکند اثر بعضی عوامل تصادفی را در یک محیط مشخص کنترل کنید:
import random

import numpy as np
import torch


SEED = 42

random.seed(SEED)
np.random.seed(SEED)
torch.manual_seed(SEED)
اما بذر یکسان، تضمین تکرارپذیری کامل در همه دستگاهها و نسخههای PyTorch نیست. مستندات رسمی PyTorch صراحتاً میگوید نتایج ممکن است میان نسخهها، پلتفرمها و حتی اجرای CPU و GPU کاملاً یکسان نباشند. PyTorch main documentation
برای نتیجهگیری علمیتر:
- چند بذر تصادفی آزمایش کنید.
- میانگین و پراکندگی معیار Validation را گزارش دهید.
- نسخه کتابخانهها و دستگاه اجرا را ثبت کنید.
- بهترین نتیجه یک اجرا را بهعنوان رفتار همیشگی روش معرفی نکنید.
اشتباهات رایج در مقداردهی اولیه وزنها
صفرکردن همه وزنهای لایههای پنهان
این کار میتواند نورونهای مشابه را در وضعیت متقارن نگه دارد و یادگیری ویژگیهای متنوع را محدود کند.
استفاده از Kaiming مخصوص ReLU برای هر فعالساز
پارامتر nonlinearity باید با رفتار لایه هماهنگ باشد. مستندات PyTorch استفاده از توابع Kaiming را بهویژه برای relu و leaky_relu توصیه میکند. PyTorch main documentation
اعمال بیفکر یک تابع به تمام لایهها
لایه پنهان، لایه خروجی، Embedding و بخشهای ویژه معماری الزاماً نباید یکسان مقداردهی شوند.
مقداردهی دوباره مدل از پیش آموزشدیده
این کار وزنهای یادگرفتهشده را تغییر میدهد و میتواند هدف Fine-tuning را از بین ببرد.
نادیدهگرفتن Baseline پیشفرضPyTorch
ممکن است مقداردهی موجود عملکرد خوبی داشته باشد. آن را پیش از جایگزینی اندازه بگیرید.
مقایسه روشها همراه با تغییر نرخ یادگیری
اگر هم مقداردهی اولیه و هم نرخ یادگیری را همزمان تغییر دهید، علت تفاوت نتیجه روشن نخواهد بود.
قضاوت فقط با اولینBatch
یک Batch ممکن است نماینده کل داده نباشد. منحنی چند Epoch و معیار Validation اطلاعات معتبرتری میدهد.
نتیجهگیری از یک بذر
تفاوت کوچک میان دو روش ممکن است با یک مقداردهی تصادفی دیگر تغییر کند.
چگونه یک روش مقداردهی اولیه انتخاب کنیم؟
برای یک مدل تازه، مسیر زیر عملی است:
- معماری را بررسی کنید: فعالساز هر بخش چیست و کدام لایهها وزن قابلآموزش دارند؟
- پیشفرض را اجرا کنید: یک Baseline با مقداردهی موجود در PyTorch بسازید.
- روش مرتبط را آزمایش کنید: برای لایههای پنهان دارای ReLU، Kaiming را بررسی کنید؛ برای بخشهای دیگر، انتخاب را با طراحی آنها هماهنگ کنید.
- بقیه شرایط را ثابت نگه دارید: تقسیم داده، بهینهساز، نرخ یادگیری و تعداد گامها را کنترل کنید.
- منحنیها را ببینید: سرعت پیشرفت اولیه و عملکرد Validation را جداگانه بررسی کنید.
- آزمایش را تکرار کنید: بهویژه اگر اختلاف نتیجه کوچک است.
- مدل نهایی را مستقل ارزیابی کنید: Testرا پس از انتخاب تنظیمات به کار ببرید.
پرسشهای متداول
Weight Initializationچیست؟
فرایند تعیین مقادیر اولیه پارامترهای قابلیادگیری شبکه عصبی پیش از شروع آموزش است.
Xavier Initializationچیست؟
روشی برای مقداردهی اولیه است که اندازه ورودی و خروجی لایه را در تعیین مقیاس وزنها در نظر میگیرد و با نام Glorot نیز شناخته میشود.
He Initializationچیست؟
روشی برای مقداردهی اولیه وزنها است که با نام Kaiming نیز شناخته میشود و برای شبکههای دارای فعالسازهای یکسوساز مانند ReLU مطرح شده است.
Xavier بهتر است یا Kaiming؟
هیچ پاسخ همگانی وجود ندارد. فعالساز، معماری و نتیجه Validation تعیینکنندهاند. برای لایههای پنهان دارای ReLU، Kaiming یک گزینه مناسب برای شروع مقایسه است.
آیا kaiming_normal_ و kaiming_uniform_ یکساناند؟
هر دو به خانواده Kaiming تعلق دارند، اما مقادیر اولیه را از توزیعهای متفاوت میگیرند.
آیا همه بایاسها باید صفر باشند؟
صفرکردن بایاس در بسیاری از مثالهای ساده رایج است، ولی برای همه معماریها قانون قطعی نیست. تنظیم پیشنهادی پیادهسازی همان مدل را بررسی کنید.
آیا مقداردهی اولیه خوب نیاز به تنظیم نرخ یادگیری را حذف میکند؟
خیر. وزن اولیه و نرخ یادگیری دو بخش متفاوت از فرایند آموزشاند.
آیا میتوان وزن مدل آموزشدیده را دوباره مقداردهی کرد؟
از نظر فنی بله، اما این کار وزنهای یادگرفتهشده را تغییر میدهد. هنگام Fine-tuning معمولاً فقط لایههای جدید را از ابتدا مقداردهی میکنند.
چرا با یک بذر ثابت هنوز نتیجه من کمی متفاوت است؟
تکرارپذیری کامل در همه نسخهها و سختافزارها تضمین نمیشود. علاوه بر بذر، الگوریتمهای اجرا و محیط محاسباتی نیز میتوانند اثر داشته باشند. PyTorch main documentation
جمعبندی
مقداردهی اولیه وزنها نقطه شروع یادگیری شبکه عصبی را تعیین میکند. Xavier یا Glorot با توجه به ابعاد ورودی و خروجی لایه، مقیاس وزنها را تنظیم میکند. He یا Kaiming برای شبکههای دارای فعالسازهای یکسوساز مانند ReLU مطرح شده است.
انتخاب روش مناسب به فعالساز، نقش لایه و معماری وابسته است. مقداردهی پیشفرض PyTorch را بهعنوان Baseline نگه دارید، تغییرات را کنترلشده آزمایش کنید و نتیجه را با داده Validation و بیش از یک اجرای تصادفی بررسی کنید.
برای مدل از پیش آموزشدیده نیز پیش از اجرای هر تابع مقداردهی اولیه مشخص کنید دقیقاً کدام لایهها تازه ساخته شدهاند؛ مقداردهی دوباره کل مدل میتواند وزنهای ارزشمند آن را از بین ببرد.
از آموزش مدل تا استفاده از هوش مصنوعی در محصول
اگر علاوه بر آموزش مدل اختصاصی، قصد دارید قابلیتهای هوش مصنوعی آماده را به نرمافزار خود متصل کنید، مدلها و خدمات API درواره را بررسی کنید. درواره دسترسی یکپارچه به مدلهای هوش مصنوعی را برای توسعهدهندگان ارائه میکند؛ انتخاب مدل و سرویس مناسب را بر اساس نیاز محصول و شرایط فعلی آن انجام دهید. hub.darvareh.ir
برای بررسی خدمات و شروع کار، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- تابع فعالسازی ReLU، Sigmoid و GELU چیست؟
- Batch Normalizationچیست؟
- گرادیان کاهشی در یادگیری ماشین
- Adam چیست؟ مقایسه AdamW و SGD با PyTorch
- Early Stoppingچیست؟
- بیشبرازش و کمبرازش در یادگیری ماشین
- PyTorchچیست؟
- یادگیری انتقالی و Fine-tuning باPyTorch
- آموزش استفاده از API هوش مصنوعی
منابع
- Glorot و Bengio: Understanding the Difficulty of Training Deep Feedforward Neural Networks
- He و همکاران: Delving Deep into Rectifiers
- مستندات رسمی PyTorch: توابع
torch.nn.init - مستندات رسمی PyTorch: تکرارپذیری آزمایشها
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و صفحه سلب مسئولیت درواره را نیز مطالعه کنید.



