
تابع فعالسازی چیست؟ راهنمای ReLU، Sigmoid، Tanh، GELU و Softmax باPyTorch
تابع فعالسازی در شبکه عصبی چیست و چرا اهمیت دارد؟ در این راهنما ReLU، Sigmoid، Tanh، Leaky ReLU، GELU، SiLU و Softmax را مقایسه میکنید و اثر انتخاب آنها را با PyTorch میسنجید.

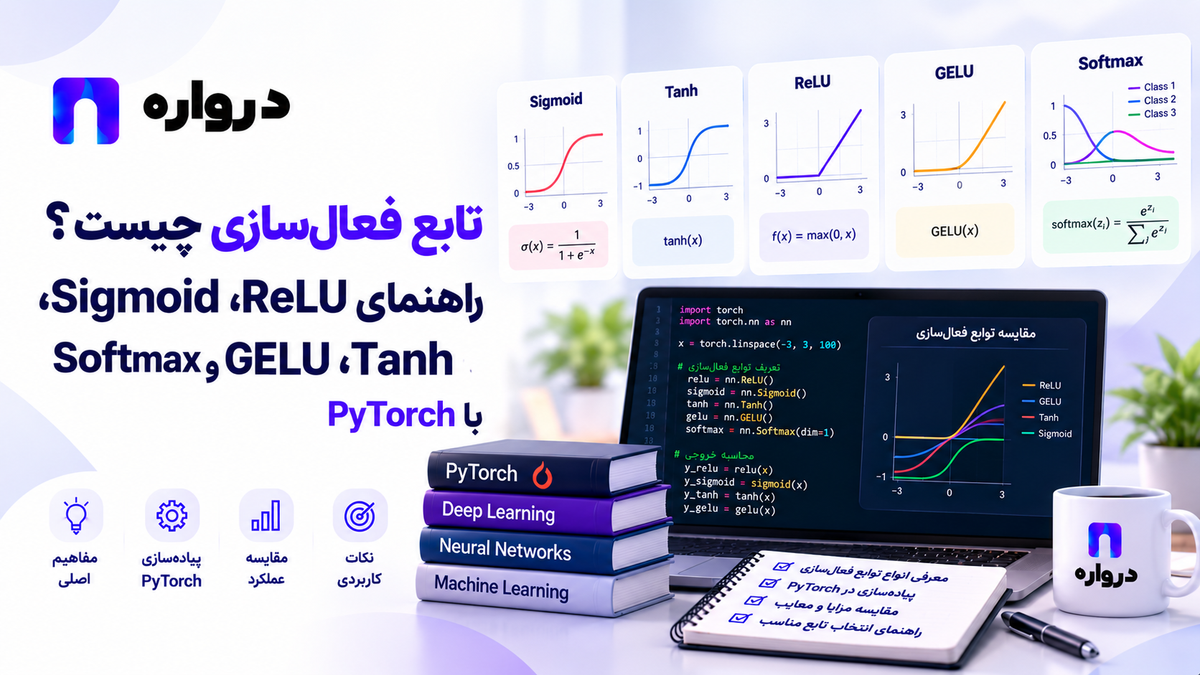
تابع فعالسازی یا Activation Function عملیاتی است که روی خروجی یک واحد یا لایه شبکه عصبی اعمال میشود. مهمترین نقش آن در لایههای میانی، ایجاد رفتار غیرخطی است؛ قابلیتی که به شبکه اجازه میدهد الگوهایی پیچیدهتر از یک مرز تصمیم خطی را یاد بگیرد.
فرض کنید شبکهای چند لایه کاملاً متصل دارد، اما میان لایهها هیچ تابع فعالسازی غیرخطی قرار نگرفته است. زیاد شدن تعداد این لایهها بهتنهایی برای یادگیری رابطه غیرخطی کافی نیست؛ مجموعه تبدیلهای خطی پشت سر هم را همچنان میتوان در قالب یک تبدیل خطی بیان کرد.
از سوی دیگر، انتخاب تابع فعالسازی فقط به «غیرخطی کردن» شبکه محدود نیست. این انتخاب میتواند بر جریان گرادیان هنگام آموزش، سرعت اجرا، شکل خروجی و هماهنگی مدل با تابع خطا اثر بگذارد.
در این مقاله، تابعهای پرکاربرد را بدون فرمول ریاضی بررسی میکنیم، کاربرد هرکدام را توضیح میدهیم و سپس در یک آزمایش عملی با PyTorch چند تابع را روی داده یکسان مقایسه میکنیم. مستندات رسمی PyTorch نیز ReLU، Tanh، Sigmoid و خانوادهای از تابعهای فعالسازی دیگر را بهعنوان اجزای ساخت مدل معرفی میکند. PyTorch Tutorials 2.14.0+cu130 documentation
تابع فعالسازی چیست؟
هر لایه شبکه عصبی ورودی خود را پردازش و مقداری به لایه بعد ارسال میکند. تابع فعالسازی مشخص میکند این مقدار پیش از ادامه مسیر چگونه تغییر کند.
یک مسیر ساده چنین است:
داده ورودی
↓
لایه قابلآموزش
↓
تابع فعالسازی
↓
لایه قابلآموزش بعدی
↓
خروجی مدلدر PyTorch، نمونهای از این ترکیب چنین نوشته میشود:
from torch import nnnetwork = nn.Sequential( nn.Linear(2, 32), nn.ReLU(), nn.Linear(32, 1),)در این مثال، nn.Linear تبدیل قابلآموزش را انجام میدهد و nn.ReLU خروجی لایه اول را پیش از رسیدن به لایه بعد تغییر میدهد. nn.Sequential نیز ماژولها را به همان ترتیبی که تعریف شدهاند اجرا میکند. PyTorch Tutorials 2.14.0+cu130 documentation
چرا شبکه عصبی به غیرخطی بودن نیاز دارد؟
بسیاری از رابطههای واقعی را نمیتوان با یک خط یا سطح تصمیم ساده توضیح داد.
برای مثال، در یک داده دوبعدی ممکن است نمونههای یک کلاس به شکل هلالی دور نمونههای کلاس دیگر قرار گرفته باشند. یک طبقهبند با مرز خطی، برای جداسازی آنها محدودیت دارد. شبکهای با لایههای پنهان و فعالساز غیرخطی میتواند مرز منعطفتری بسازد.
این توانایی برای دادههای پیچیدهتر نیز اهمیت دارد:
- در تصویر، ترکیب لبهها و بافتها میتواند به تشخیص شیء کمک کند.
- در صوت، الگوهای کوتاه و بلند ممکن است همراه هم معنا پیدا کنند.
- در متن، رابطه میان واژهها به جایگاه و بافت آنها وابسته است.
- در داده جدولی، اثر یک ویژگی ممکن است به مقدار ویژگی دیگر بستگی داشته باشد.
غیرخطی بودن، تضمین عملکرد بهتر نیست. مدل همچنان به داده مرتبط، آموزش مناسب و ارزیابی مستقل نیاز دارد.
تابع فعالسازی چه اثری بر آموزش دارد؟
هنگام آموزش، شبکه با استفاده از پسانتشار مشخص میکند تغییر هر پارامتر چگونه بر خطا اثر میگذارد. گرادیانها از لایههای پایانی به لایههای ابتدایی منتقل میشوند.
رفتار تابع فعالسازی میتواند این مسیر را آسانتر یا دشوارتر کند. اگر تغییرات ورودی در بخش بزرگی از تابع به تغییر بسیار کوچکی در خروجی منجر شود، گرادیان عبوری نیز ممکن است کوچک شود. در شبکه عمیق، این مسئله میتواند آموزش لایههای ابتدایی را دشوار کند.
پژوهش Glorot و Bengio درباره دشواری آموزش شبکههای عمیق، نقش رفتار فعالسازها و مقیاس مقدارها را در جریان آموزش بررسی کرده است. proceedings.mlr.press
گرادیان محوشونده چیست؟
گرادیان محوشونده وضعیتی است که در آن اثر تغییرات پارامترهای لایههای ابتدایی بر خطا بسیار کوچک میشود. در نتیجه، این لایهها ممکن است بسیار کند یاد بگیرند.
این مشکل فقط به انتخاب تابع فعالسازی مربوط نیست. عمق شبکه، مقداردهی اولیه وزنها، معماری و تنظیمات آموزش نیز نقش دارند.
گرادیان انفجاری چیست؟
در جهت دیگر، ممکن است مقدار گرادیانها بیشازحد بزرگ شود و آموزش را ناپایدار کند. انتخاب فعالساز بخشی از طراحی مدل است، اما برای بررسی چنین مشکلی باید کل معماری و روند آموزش را دید.
دستهبندی تابعهای فعالسازی
برای استفاده عملی، میتوان تابعها را در دو جایگاه بررسی کرد:
- تابعهای لایه پنهان: برای ساخت بازنمایی غیرخطی در بخش میانی شبکه؛ مانند ReLU، Leaky ReLU، GELU، SiLU وTanh.
- تابعهای مرتبط با خروجی: برای تبدیل خروجی خام به شکل مناسب نمایش یا تصمیم؛ مانند Sigmoid برای برخی خروجیهای دودویی و Softmax برای نمایش خروجی چندکلاسه.
این دستهبندی به معنی آن نیست که Sigmoid یا Tanh هرگز در لایه پنهان استفاده نمیشوند. انتخاب دقیق به معماری و مسئله وابسته است. نکته مهمتر این است که تابع خروجی باید با تابع خطا هماهنگ باشد.
تابع ReLU چیست؟
ReLU یکی از رایجترین فعالسازهای لایه پنهان است. رفتار آن ساده است:
- ورودی مثبت را عبور میدهد.
- ورودی منفی را به صفر تبدیل میکند.
نمونه درPyTorch:
from torch import nnactivation = nn.ReLU()مزایایReLU
- پیادهسازی و محاسبه آن ساده است.
- برای بسیاری از شبکههای چندلایه نقطه شروع مناسبی است.
- در بخش مثبت ورودی، تغییر خروجی با تغییر ورودی متوقف نمیشود.
- در معماریهای مختلف، از MLP تا برخی CNNها، کاربرد دارد.
محدودیتReLU
برای ورودیهای منفی، خروجی ReLU صفر است. اگر یک واحد در شرایطی قرار بگیرد که برای نمونههای زیادی فقط خروجی صفر تولید کند، ممکن است سهم آن در یادگیری کاهش یابد. این پدیده معمولاً با نام Dying ReLU مطرح میشود.
دیدن چند خروجی صفر بهتنهایی به معنی خراب بودن مدل نیست. ReLU طبق تعریف خود بخشی از ورودیها را صفر میکند. مسئله زمانی مطرح است که رفتار واحدها یا کیفیت آموزش، مشکل عملی ایجاد کند.
مقداردهی اولیه وReLU
روش مقداردهی اولیه وزنها میتواند بر جریان مقدارها و گرادیانها اثر بگذارد. پژوهش He و همکاران روشی را برای مقداردهی اولیه متناسب با فعالسازهای خانواده ReLU مطرح کرد. PyTorch نیز تابعهای مقداردهی اولیه مرتبط را در torch.nn.init ارائه میکند. arxiv.org
تابع Leaky ReLU چیست؟
Leaky ReLU شبیه ReLU است، با این تفاوت که برای ورودی منفی خروجی را بهطور کامل صفر نمیکند. بخش منفی، مسیر کوچکی برای تغییر خروجی دارد.
درPyTorch:
from torch import nnactivation = nn.LeakyReLU( negative_slope=0.01)پارامتر negative_slope میزان این مسیر را تعیین میکند.
Leaky ReLU زمانی ارزش آزمایش دارد که بخواهید رفتار ReLU را با یک گزینه نزدیک مقایسه کنید، بهویژه اگر نشانهای از مشکل واحدهای غیرفعال در شبکه دیدهاید. بااینحال، نمیتوان گفت Leaky ReLU در هر مسئله از ReLUبهتر است.
تابع PReLU چیست؟
PReLU یا Parametric ReLU به خانواده فعالسازهای یکسوساز تعلق دارد. در این روش، رفتار بخش منفی با پارامتری تعیین میشود که میتواند در آموزش یاد گرفته شود.
نمونه:
from torch import nnactivation = nn.PReLU()تفاوت اصلی با Leaky ReLU این است که مقدار مربوط به بخش منفی در PReLU میتواند قابلآموزش باشد. این انعطاف، پارامتر بیشتری نیز به مدل اضافه میکند.
پژوهش He و همکاران PReLU را همراه با روش مقداردهی اولیه مناسب برای شبکههای عمیق بررسی کرده است. مستندات PyTorch نیز پیادهسازی آن را ارائه میدهد. arxiv.org
تابع Sigmoid چیست؟
Sigmoid یک مقدار خام را به بازه بین صفر و یک تبدیل میکند. به همین دلیل برای نمایش نمره خروجی طبقهبندی دودویی کاربرد دارد.
برای نمونه:
import torchlogits = torch.tensor( [-2.0, 0.0, 2.0])scores = torch.sigmoid( logits)print(scores)برای ورودی خام بزرگتر، نمره خروجی نیز به یک نزدیکتر میشود. اما چند نکته مهم وجود دارد:
- نمره بین صفر و یک، بدون ارزیابی کافی به معنی «احتمال قطعی درست بودن» نیست.
- آستانه تصمیم لزوماً باید
0.5باشد؟ خیر؛ آستانه را با توجه به هدف و خطاهای مسئله میتوان روی داده اعتبارسنجی انتخاب کرد. - در بخشهای بسیار مثبت یا بسیار منفی، خروجی Sigmoid به کرانهای خود نزدیک میشود و تغییرات آن کوچکتر میشود.
آیا Sigmoid را در لایه پنهان استفاده کنیم؟
امکان آن وجود دارد، اما برای بسیاری از شبکههای چندلایه مدرن، معمولاً نخست گزینههایی مانند ReLU یا GELU بررسی میشوند. استفاده گسترده از Sigmoid در لایههای پنهان میتواند به دشواری جریان گرادیان منجر شود. این یک قاعده مطلق برای همه معماریها نیست؛ برای مثال برخی سازوکارهای دروازهای از Sigmoid استفاده میکنند.
تابع Tanh چیست؟
Tanh خروجی را در بازه منفی یک تا مثبت یک قرار میدهد. برخلاف Sigmoid، خروجی آن میتواند منفی نیز باشد و حول صفر قرار بگیرد.
درPyTorch:
from torch import nn

activation = nn.Tanh()
Tanh در برخی شبکههای ترتیبی و مدلهایی که خروجی محدود و دارای مقادیر مثبت و منفی میخواهند دیده میشود. مانند Sigmoid،در بخشهای دور از مرکز، تغییر خروجی آن کوچک میشود و این رفتار باید هنگام طراحی شبکه عمیق در نظر گرفته شود.
| ویژگی | Sigmoid | Tanh |
|---|---|---|
| محدوده خروجی | صفر تا یک | منفی یک تا مثبت یک |
| امکان خروجی منفی | ندارد | دارد |
| کاربرد رایج در این مقاله | نمایش نمره دودویی | آزمایش در لایه پنهان |
| رفتار در ورودیهای بسیار بزرگ | نزدیک شدن به کران | نزدیک شدن به کران |
تابع GELU چیست؟
GELU یا Gaussian Error Linear Unit فعالسازی هموار است که در برخی معماریهای یادگیری عمیق، از جمله مدلهای مبتنی بر Transformer، استفاده میشود.
برخلاف ReLU که بخش منفی را ناگهان صفر میکند، رفتار GELU در اطراف صفر هموارتر است. مقاله معرفی GELU آن را بهعنوان یک فعالساز برای شبکه عصبی پیشنهاد میکند و PyTorch پیادهسازی آماده آن را دارد. arxiv.org
from torch import nn

activation = nn.GELU()
GELUممکن است در برخی معماریها انتخاب مناسبی باشد، اما جایگزینی ReLU با GELU تضمین بهبود نیست. کیفیت، زمان پاسخ و مصرف منابع را در مسئله خودتان اندازه بگیرید.
تابع SiLU یا Swish چیست؟
SiLU یکی دیگر از فعالسازهای هموار است. در بسیاری از متنهای فنی، رابطه نزدیکی میان SiLU و شکل رایج تابع Swish مطرح میشود. پژوهش «Searching for Activation Functions» رفتار Swish را در چند معماری بررسی کرده است؛ این نتایج را نباید به همه مجموعهدادهها و مدلها تعمیم داد. arxiv.org
درPyTorch:
from torch import nn

activation = nn.SiLU()
SiLU نیز مانند GELUمیتواند بهعنوان گزینهای برای لایههای پنهان آزمایش شود. انتخاب آن در محصول واقعی باید بر اساس نتیجه سنجش انجام شود.
تابع Softmax چیست؟
Softmax مجموعهای از خروجیهای خام را به نمرههایی تبدیل میکند که برای کلاسهای یک مسئله چندکلاسه قابلمقایسهاند و مجموع آنها برای هر نمونه یک میشود.
فرض کنید مدل باید یک تصویر را دقیقاً در یکی از سه کلاس «کفش»، «کیف» یا «لباس» قرار دهد. لایه آخر میتواند برای هر کلاس یک خروجی خام تولید کند. Softmax آن خروجیها را برای نمایش به نمره تبدیل میکند.
import torch

logits = torch.tensor(
    [[1.2, 2.4, 0.3]]
)

scores = torch.softmax(
    logits,
    dim=1,
)

print(scores)
print(scores.sum(dim=1))
مستندات PyTorch تصریح میکند که dim مشخص میکند Softmax در امتداد کدام بُعد اعمال شود. در مثال بالا، هر ستون نماینده یک کلاس است و تبدیل روی بُعد کلاسها انجام میشود. PyTorch Tutorials 2.14.0+cu130 documentation
Softmax چه تفاوتی با Sigmoidدارد؟
| مسئله | نمایش رایج خروجی |
|---|---|
| دودویی با یک خروجی خام | Sigmoid هنگام نمایش نمره |
| چندکلاسه با کلاسهای انحصاری | Softmax هنگام نمایش نمره کلاسها |
| چندبرچسبی با برچسبهای مستقل | Sigmoid جداگانه برای هر برچسب |
چندکلاسه و چندبرچسبی یکسان نیستند. یک تصویر در مسئله چندکلاسه ممکن است دقیقاً یکی از کلاسهای «کیف» یا «کفش» باشد. اما یک پیام پشتیبانی در مسئله چندبرچسبی میتواند همزمان برچسبهای «ارسال» و «بازپرداخت» داشته باشد.
Logitچیست و چرا در انتخاب تابع خروجی مهم است؟
Logit در این بحث به مقدار خام خروجی مدل، پیش از تبدیل نمایشی با Sigmoid یا Softmax، گفته میشود.
برای نمونه:
from torch import nn

model = nn.Sequential(
    nn.Linear(8, 16),
    nn.ReLU(),
    nn.Linear(16, 3),
)
این مدل برای هر نمونه سه خروجی خام تولید میکند. اگر مسئله، طبقهبندی سهکلاسه باشد، معمولاً همین خروجیها مستقیماً به CrossEntropyLoss داده میشوند. پس از آموزش، برای نمایش نمره کلاسها میتوان Softmax را اعمال کرد.
مستندات CrossEntropyLoss ورودی مدل را logits خام معرفی میکند و توضیح میدهد که این تابع، تبدیلهای لازم برای محاسبه خطا را در خود انجام میدهد. PyTorch 2.14 documentation
یک خطای رایج: افزودن Softmax پیش ازCrossEntropyLoss
کد زیر برای مسیر رایج آموزش چندکلاسه، الگوی موردنظر CrossEntropyLoss نیست:
# برای مسیر رایج آموزش با CrossEntropyLoss مناسب نیست.
model = nn.Sequential(
    nn.Linear(8, 3),
    nn.Softmax(dim=1),
)

criterion = nn.CrossEntropyLoss()بهجای آن، خروجی خام را به تابع خطا بدهید:
model = nn.Linear(8, 3)

criterion = nn.CrossEntropyLoss()

logits = model(features)
loss = criterion(logits, labels)
برای گزارش نتیجه به کاربر:
scores = torch.softmax(
    logits,
    dim=1,
)
Sigmoidرا چه زمانی در مدل قرار ندهیم؟
در مسئله طبقهبندی دودویی PyTorch، استفاده از BCEWithLogitsLoss رایج است. این تابع، بخش مربوط به Sigmoid و محاسبه خطای دودویی را به شکل ترکیبی انجام میدهد. طبق مستندات PyTorch، این ترکیب از نظر عددی پایدارتر از اجرای Sigmoid و سپس BCELoss است. PyTorch main documentation
مسیر آموزش:
from torch import nn

model = nn.Linear(8, 1)
criterion = nn.BCEWithLogitsLoss()

logits = model(features)
loss = criterion(logits, targets)
مسیر نمایش نمره:
scores = torch.sigmoid(
    logits
)
قاعده عملی: پیش از افزودن تابع فعالسازی به لایه خروجی، ببینید تابع خطایی که انتخاب کردهاید چه نوع ورودی میخواهد.
مقایسه تابعهای فعالسازی پرکاربرد
| تابع | محدوده و رفتار خروجی | کاربرد رایج | نکته اصلی |
|---|---|---|---|
| ReLU | منفیها را صفر میکند؛ مثبتها عبور میکنند | لایه پنهان | نقطه شروع ساده و رایج |
| Leaky ReLU | بخش منفی مسیر کوچکی دارد | لایه پنهان | جایگزین نزدیک برای ReLU |
| PReLU | رفتار بخش منفی قابلآموزش است | لایه پنهان | پارامتر اضافه میکند |
| Sigmoid | بین صفر و یک | نمایش خروجی دودویی، سازوکارهای دروازهای | در کرانها تغییر خروجی کم میشود |
| Tanh | بین منفی یک و مثبت یک | برخی لایههای پنهان و خروجیهای محدود | حول صفر قرار دارد |
| GELU | هموار با رفتار غیرخطی | برخی مدلهای عمیق و Transformer | نیازمند سنجش در معماری موردنظر |
| SiLU | هموار | برخی لایههای پنهان | گزینه آزمایشی در کنار ReLU و GELU |
| Softmax | نمره چند کلاس با مجموع یک | نمایش خروجی چندکلاسه | بُعد کلاسها باید درست انتخاب شود |
این جدول، فهرست رتبهبندی کیفیت نیست. نتیجه واقعی به مسئله، معماری، مقداردهی اولیه، داده و تنظیمات آموزش وابسته است.
آموزش عملی: مقایسه ReLU، Tanh و GELU باPyTorch
در این آزمایش، سه MLP با ساختار یکسان میسازیم. تنها تفاوت آنها تابع فعالسازی لایههای پنهان است. داده از make_moons ساخته میشود؛ یعنی یک مسئله دوبعدی با مرز تصمیم غیرخطی.
برای مقایسه منصفانهتر:
- تقسیم داده در همه اجراها یکسان است.
- مقیاسبندی فقط از داده آموزش یاد گرفته میشود.
- تعداد لایهها، بهینهساز و سقف دورهها یکسان است.
- انتخاب مدل با مجموعه اعتبارسنجی انجام میشود.
- مجموعه آزمون برای گزارش نهایی نگه داشته میشود.
این آزمایش آموزشی برتری عمومی یکی از تابعها را اثبات نمیکند.
نصب بستهها
python -m pip install torch scikit-learn numpy matplotlibساخت داده و تقسیم آن
import numpy as np
import torch
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
SEED = 42
X, y = make_moons(
n_samples=3000,
noise=0.27,
random_state=SEED,
)
X = X.astype(np.float32)
y = y.astype(np.float32)
# مجموعه آزمون برای پایان آزمایش کنار میرود.
X_dev, X_test, y_dev, y_test = (
train_test_split(
X,
y,
test_size=0.20,
stratify=y,
random_state=SEED,
)
)
X_train, X_val, y_train, y_val = (
train_test_split(
X_dev,
y_dev,
test_size=0.25,
stratify=y_dev,
random_state=SEED,
)
)
scaler = StandardScaler()
X_train = scaler.fit_transform(
X_train
).astype(np.float32)
X_val = scaler.transform(
X_val
).astype(np.float32)
X_test = scaler.transform(
X_test
).astype(np.float32)مقیاسساز فقط روی X_train تنظیم میشود. تنظیم آن روی کل داده، اطلاعات اعتبارسنجی و آزمون را وارد آمادهسازی مدل میکند. scikit-learn این وضعیت را از خطاهای رایج ناشی از نشت داده معرفی میکند. scikit-learn.org
تعریف مدل با فعالساز قابلتعویض
from torch import nn


def build_model(
    activation_class,
):
    return nn.Sequential(
        nn.Linear(2, 32),
        activation_class(),

        nn.Linear(32, 32),
        activation_class(),

        nn.Linear(32, 1),
    )
لایه آخر تابع فعالسازی ندارد، زیرا قرار است خروجی خام آن به BCEWithLogitsLoss داده شود.
آمادهسازی دستههای آموزش
from torch.utils.data import ( DataLoader, TensorDataset,)train_dataset = TensorDataset( torch.from_numpy(X_train), torch.from_numpy(y_train).unsqueeze(1),)train_loader = DataLoader( train_dataset, batch_size=64, shuffle=True,)device = torch.device( "cuda" if torch.cuda.is_available() else "cpu")X_val_tensor = torch.from_numpy( X_val).to(device)y_val_tensor = torch.from_numpy( y_val).unsqueeze(1).to(device)تابع آموزش و انتخاب بهترین دوره
import copyfrom torch import nndef train_model( activation_class, max_epochs=120, patience=15,): # شروع یکسان برای کنترل بخشی از # تفاوتهای ناشی از تصادفی بودن. torch.manual_seed(SEED) model = build_model( activation_class ).to(device) criterion = nn.BCEWithLogitsLoss() optimizer = torch.optim.AdamW( model.parameters(), lr=0.001, weight_decay=0.0001, ) train_history = [] val_history = [] best_val_loss = float("inf") best_state = None waiting = 0 for epoch in range(max_epochs): model.train()در کد بالا، loss.backward() گرادیانها را محاسبه و optimizer.step() پارامترها را بهروزرسانی میکند. هنگام اعتبارسنجی، مدل در حالت eval قرار میگیرد و با torch.inference_mode() محاسبه گرادیان غیرفعال میشود. روند کلی با آموزش رسمی PyTorch هماهنگ است. PyTorch Tutorials 2.14.0+cu130 documentation
آموزش سه مدل
activations = { "ReLU": nn.ReLU, "Tanh": nn.Tanh, "GELU": nn.GELU,}results = {}for name, activation_class in ( activations.items()): result = train_model( activation_class ) results[name] = result print( f"{name:5s} | " f"Validation loss: " f"{result['best_val_loss']:.4f} | " f"Epochs: " f"{result['epochs']}" )اعداد خروجی از پیش مشخص نیستند و باید از اجرای واقعی برنامه به دست بیایند. علاوه بر تابع فعالسازی، مقداردهی اولیه، تنظیم بهینهساز و انتخاب داده بر نتیجه اثر دارند. بنابراین از یک اجرای کوچک نباید نتیجهای مانند «GELU همیشه بهتر است» گرفت.
رسم روند آموزش
import matplotlib.pyplot as plt


plt.figure(figsize=(9, 5))

for name, result in results.items():
    plt.plot(
        result["val_history"],
        label=f"{name} validation",
    )

plt.xlabel("Epoch")
plt.ylabel("Validation loss")
plt.legend()
plt.tight_layout()
plt.show()
در این نمودار به موارد زیر نگاه کنید:
- آیا یک مدل زودتر به خطای اعتبارسنجی پایین میرسد؟
- آیا نتیجه آن در دورههای مختلف پایدار است؟
- آیا اختلافها به اندازهای هستند که ارزش بررسی بیشتر داشته باشند؟
- آیا با اجرای دوباره و بذرهای متفاوت نیز الگوی مشابهی دیده میشود؟
سرعت رسیدن به یک مقدارLoss تنها معیار انتخاب نیست. کیفیت پیشبینی، زمان پاسخ و هزینه اجرا نیز اهمیت دارند.
انتخاب مدل و ارزیابی نهایی
در این مثال، مدل را بر اساس کمترین Loss اعتبارسنجی انتخاب میکنیم و سپس فقط مدل انتخابشده را روی آزمون مستقل میسنجیم:
from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix,
    roc_auc_score,
)


best_name = min(
    results,
    key=lambda name: (
        results[name]["best_val_loss"]
    ),
)

best_model = results[
    best_name
]["model"]

best_model.eval()

X_test_tensor = torch.from_numpy(
    X_test
).to(device)

with torch.inference_mode():
    test_logits = best_model(
        X_test_tensor
    )

    test_scores = torch.sigmoid(
        test_logits
    ).squeeze(1).cpu().numpy()

test_predictions = (
    test_scores >= 0.5
).astype(int)

true_labels = y_test.astype(int)

print(
    "Selected activation:",
    best_name,
)

print(
    "Test accuracy:",
    accuracy_score(
        true_labels,
        test_predictions,
    ),
)

print(
    "Test ROC AUC:",
    roc_auc_score(
        true_labels,
        test_scores,
    ),
)

print(
    confusion_matrix(
        true_labels,
        test_predictions,
    )
)

print(
    classification_report(
        true_labels,
        test_predictions,
        digits=4,
    )
)
اگر قرار است آستانهای غیر از 0.5 استفاده شود، آن را روی مجموعه اعتبارسنجی و بر اساس هزینه خطاها انتخاب کنید؛ آستانه را با نگاه کردن به نتیجه آزمون تنظیم نکنید.
چگونه نتیجه آزمایش را درست تفسیر کنیم؟
اگر یکی از سه تابع در اجرای بالا Loss کمتری ثبت کند، تنها میتوان گفت در این داده، این معماری، این تنظیمات و این اجرا بهتر ظاهر شده است.
برای نتیجهگیری محکمتر:
- آزمایش را با چند بذر تصادفی تکرار کنید.
- میانگین و پراکندگی نتیجه را گزارش کنید.
- زمان آموزش و پیشبینی را اندازه بگیرید.
- نتیجه را روی داده مرتبط با کاربرد واقعی بسنجید.
- تابع فعالسازی را همراه با مقداردهی اولیه مناسب بررسی کنید.
- مجموعه آزمون را برای تصمیمگیریهای مکرر مصرف نکنید.
برای شبکه عمیقتر، یک تغییر فعالساز ممکن است با تغییر مناسب مقداردهی اولیه یا نرخ یادگیری نتیجه متفاوتی بدهد. بنابراین مقایسه دقیق به طراحی آزمایش نیاز دارد.
تابع فعالسازی مناسب را چگونه انتخاب کنیم؟
میتوانید از این راهنمای اولیه استفاده کنید:
برای لایههای پنهان یک MLP یاCNN
ReLU نقطه شروع قابلفهمی است. سپس، اگر هدف و منابع اجازه میدهد، Leaky ReLU، GELU یا SiLUرا در شرایط قابلمقایسه آزمایش کنید.
برای معماری از پیشآموزشدیده
معماری مدل را بدون دلیل و آزمایش تغییر ندهید. اگر مدل از پیشآموزشدیده با GELU ساخته شده است، جایگزین کردن آن با ReLU صرفاً یک تغییر ظاهری نیست و رفتار مدل را عوض میکند.
برای طبقهبندی دودویی
اگر از BCEWithLogitsLoss استفاده میکنید، خروجی خام مدل را به تابع خطا بدهید. برای نمایش نمره، بعداً Sigmoid را اعمال کنید.
برای طبقهبندی چندکلاسه انحصاری
اگر از CrossEntropyLoss استفاده میکنید، خروجی خام هر کلاس را به تابع خطا بدهید. برای نمایش نمره کلاسها، بعداً Softmax را اعمال کنید.
برای طبقهبندی چندبرچسبی
هر برچسب میتواند مستقل از برچسبهای دیگر باشد. معمولاً برای هر برچسب یک خروجی خام در نظر گرفته میشود و تبدیل Sigmoid برای نمایش نمره هر خروجی جداگانه انجام میشود. تعریف برچسبها، شکل هدفها و تابع خطا باید با این ساختار هماهنگ باشند.
برای رگرسیون
تابع فعالسازی خروجی به محدوده مقدار هدف بستگی دارد. اگر مقدار هدف میتواند هر مقدار مناسبی در یک بازه گسترده داشته باشد، ممکن است خروجی خطی مناسب باشد. اگر خروجی از نظر مسئله محدود است، فعالساز باید با همان محدودیت هماهنگ شود. تصمیم را با توجه به داده و تابع خطا بگیرید.
آیا ReLU همیشه از Sigmoid بهتر است؟
خیر؛ این پرسش بدون مشخص کردن جایگاه تابع پاسخ دقیقی ندارد. در بسیاری از شبکههای چندلایه، ReLU برای لایههای پنهان نقطه شروع مناسبی است. Sigmoid نیز برای تبدیل خروجی خام یک طبقهبند دودویی به نمره یا در برخی سازوکارهای دروازهای کاربرد دارد.
مقایسه این دو در جایگاههای متفاوت، مانند مقایسه «لایه پنهان» با «نمایش خروجی» است. بهتر است نخست وظیفه هر بخش مدل را مشخص کنید.
آیا Softmax احتمال واقعی تولید میکند؟
Softmaxنمرههای خروجی مدل را به مقادیر قابلمقایسهای تبدیل میکند که مجموعشان یک است. اما این ویژگی بهتنهایی ثابت نمیکند نمره 0.9 در محیط واقعی همیشه به معنی درست بودن حدود ۹۰ درصد چنین پیشبینیهایی است.
اگر تصمیم محصول به میزان اطمینان وابسته است، باید کالیبراسیون نمرهها و عملکرد مدل روی داده مرتبط را جداگانه بررسی کنید. تغییر توزیع داده پس از استقرار نیز میتواند تفسیر نمرهها را تغییر دهد.
اشتباهات رایج در استفاده از تابع فعالسازی
قرار دادن Softmax پیش از CrossEntropyLoss
این تابع خطا برای مسیر رایج طبقهبندی چندکلاسه، logits خام مدل را دریافت میکند. Softmax را هنگام نمایش خروجی اعمال کنید.
قرار دادن Sigmoid پیش از BCEWithLogitsLoss
این تابع Sigmoid را در محاسبه خطا لحاظ میکند. خروجی خام مدل را به آن بدهید.
استفاده از Softmax روی بُعد اشتباه
در آرایهای که شکل آن «تعداد نمونه، تعداد کلاس» است، معمولاً بُعد کلاسها dim=1 است. انتخاب بُعد اشتباه نتیجه متفاوتی تولید میکند.
استفاده از فعالساز یکسان برای همه خروجیها
نوع خروجی رگرسیون، طبقهبندی دودویی، چندکلاسه و چندبرچسبی یکسان نیست. لایه آخر و تابع خطا را برای مسئله تعریف کنید.
تغییر تابع فعالسازی بدون بررسی مقداردهی اولیه
رفتار ReLU، Tanh و دیگر تابعها متفاوت است. پژوهشها و مستندات PyTorch روشهای مقداردهی اولیه متناسب با بعضی از این تابعها را مطرح میکنند. proceedings.mlr.press
نتیجهگیری از یک اجرای تصادفی
تفاوت کوچک میان دو تابع در یک اجرا ممکن است با بذر تصادفی یا تقسیم داده تغییر کند. برای ادعای برتری، آزمایش تکرارشونده لازم است.
توجه فقط بهAccuracy
در داده نامتوازن، Accuracy میتواند ضعف مدل روی کلاس کمتعداد را پنهان کند. معیارهای هر کلاس، ماتریس خطا و هزینه خطاهای عملی را بررسی کنید.
بزرگتر کردن شبکه به امید حل همه مشکلات
اگر برچسبها مبهماند، داده نماینده محیط واقعی نیست یا پیشپردازش آموزش و استقرار فرق دارد، تغییر ReLU به GELU مسئله اصلی را حل نمیکند.
رابطه تابع فعالسازی با مدلهای زبانی بزرگ چیست؟
مدلهای زبانی بزرگ از لایههای متعددی تشکیل میشوند و تابع فعالسازی یکی از اجزای محاسبات در معماری آنهاست. اما کیفیت یک مدل زبانی را نمیتوان تنها با نام تابع فعالسازی آن توضیح داد.
عواملی مانند معماری کلی، داده و روش آموزش، تعداد پارامترها، طراحی توکنایزر و روش ارزیابی نیز نقش دارند. به همین دلیل، هنگام انتخاب مدل زبانی برای محصول، بهتر است عملکرد آن را روی وظیفه واقعی خود بسنجید؛ مثلاً کیفیت پاسخ فارسی، استخراج داده، زمان پاسخ و هزینه استفاده.
اگر قصد دارید مدلهای آماده را بدون آموزش شبکه از صفر در نرمافزار آزمایش کنید، APIدرواره امکان اتصال به مدلهای موجود را از یک مسیر یکپارچه فراهم میکند. شناسه و قابلیت هر مدل را پیش از پیادهسازی در فهرست فعلی مدلها بررسی کنید. برای مسیر برنامهنویسی نیز راهنمای استفاده از API هوش مصنوعی در اپلیکیشن در دسترس است.
پرسشهای متداول
تابع فعالسازی چیست؟
تابع فعالسازی خروجی یک واحد یا لایه شبکه عصبی را تغییر میدهد. در لایههای پنهان، نقش مهم آن ایجاد رفتار غیرخطی است.
اگر تابع فعالسازی نگذاریم چه میشود؟
اگر لایهها فقط تبدیل خطی انجام دهند، قرار دادن چند لایه پشت سر هم بهتنهایی توان ساخت یک رابطه غیرخطی را ایجاد نمیکند.
بهترین تابع فعالسازی برای لایه پنهان چیست؟
پاسخ ثابت وجود ندارد. ReLU نقطه شروع رایجی است. GELU، SiLU، Leaky ReLU و گزینههای دیگر باید با معماری و داده موردنظر آزمایش شوند.
تفاوت ReLU و Leaky ReLU چیست؟
ReLU ورودی منفی را صفر میکند. Leaky ReLUبرای بخش منفی مسیر کوچکی باقی میگذارد.
تفاوت Sigmoid و Softmax چیست؟
Sigmoid هر مقدار را جداگانه به بازه صفر تا یک میبرد. Softmaxمجموعه خروجیهای مربوط به کلاسهای انحصاری را با هم تبدیل میکند تا نمرههای آنها قابلمقایسه و مجموعشان یک شود.
برای طبقهبندی دودویی Sigmoid را به لایه آخر اضافه کنیم؟
اگر آموزش را با BCEWithLogitsLoss انجام میدهید، خیر؛ تابع خطا خروجی خام را میخواهد. برای نمایش نمره پس از پیشبینی از Sigmoid استفاده کنید.
برای CrossEntropyLoss به Softmax نیاز داریم؟
برای ورودی دادن به مسیر رایج CrossEntropyLoss، خیر. logits خام را بدهید. برای نمایش نمره کلاسها میتوانید پس از آن Softmax را اجرا کنید.
GELU از ReLUبهتر است؟
نمیتوان حکم کلی داد. GELU در برخی معماریها کاربرد دارد، اما برتری آن باید برای مدل، داده و معیار موردنظر آزمایش شود.
Dying ReLUبه چه معناست؟
به وضعیتی اشاره دارد که بعضی واحدهای دارای ReLU برای ورودیهای بسیاری خروجی صفر میدهند و نقششان در یادگیری کاهش مییابد. هر خروجی صفر، نشانه وجود این مشکل نیست.
آیا تابع فعالسازی روی سرعت مدل اثر دارد؟
بله، هزینه محاسباتی تابعها میتواند متفاوت باشد. اثر عملی این تفاوت به معماری، سختافزار، اندازه دسته و محیط اجرا بستگی دارد و باید اندازهگیری شود.
آیا میتوان در لایههای مختلف تابعهای متفاوت داشت؟
بله. انتخاب تابع برای لایههای پنهان و خروجی معمولاً با هدفهای متفاوتی انجام میشود. حتی در بخشهای مختلف یک معماری نیز ممکن است فعالسازهای متفاوتی استفاده شوند.
جمعبندی
تابع فعالسازی یکی از اجزای اصلی شبکه عصبی است. در لایههای پنهان، به مدل کمک میکند رابطههای غیرخطی یاد بگیرد؛ در بخش خروجی نیز میتواند مقدار خام مدل را برای نمایش یا تصمیم به شکل مناسب تبدیل کند.
ReLU نقطه شروع رایجی برای لایه پنهان است. Leaky ReLU و PReLU رفتار بخش منفی آن را تغییر میدهند. GELU و SiLU گزینههای هموارتری برای برخی معماریها هستند. Sigmoid و Softmax نیز در تفسیر خروجی طبقهبندی نقش مهمی دارند.
مهمترین قاعده عملی این است: تابع فعالسازی خروجی را جدا از تابع خطا انتخاب نکنید. درPyTorch، BCEWithLogitsLoss و CrossEntropyLoss معمولاً logits خام میخواهند. سپس میتوان برای نمایش نمرهها، بهترتیب از Sigmoid یا Softmax استفاده کرد.
در نهایت، انتخاب میان ReLU، GELU و دیگر گزینهها باید با آزمایش کنترلشده روی داده مرتبط، معیار مناسب و مجموعه آزمون مستقل انجام شود.
مقالات مرتبط
- شبکه عصبی مصنوعی چیست؟ راهنمای یادگیری عمیق
- PyTorchچیست؟ آموزش یادگیری عمیق با پایتون
- گرادیان کاهشی چیست؟
- بیشبرازش و کمبرازش در یادگیری ماشین
- شبکه عصبی کانولوشنی CNN چیست؟
- معماری Transformer و Attention چیست؟
- آموزش API هوش مصنوعی در برنامهنویسی
منابع
- مستندات PyTorch: ساخت شبکه عصبی وReLU
- مستندات PyTorch: تابعهای فعالسازی
- مستنداتPyTorch: CrossEntropyLoss
- مستندات PyTorch: مقداردهی اولیه وزنها
- پژوهش Glorot و Bengio درباره دشواری آموزش شبکههای عمیق
- پژوهش He و همکاران درباره فعالسازهای یکسوساز
- مقاله معرفیGELU
- پژوهش معرفیSwish
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. رفتار مدل، عملکرد تابعهای فعالسازی و سازگاری کد با نسخه کتابخانهها باید پیش از استفاده عملی در محیط موردنظر بررسی شود. صفحه سلب مسئولیت درواره را نیز مطالعه کنید.



