
Batch Normalization چیست؟ آموزش BatchNorm در شبکه عصبی با PyTorch
Batch Normalization چیست و چگونه بر آموزش شبکه عصبی اثر میگذارد؟ در این راهنما، تفاوت رفتار آن در آموزش و پیشبینی، کاربرد در CNN، محدودیت Batch کوچک و مقایسه با LayerNorm را میآموزید و یک آزمایش عملی با PyTorchاجرا میکنید.

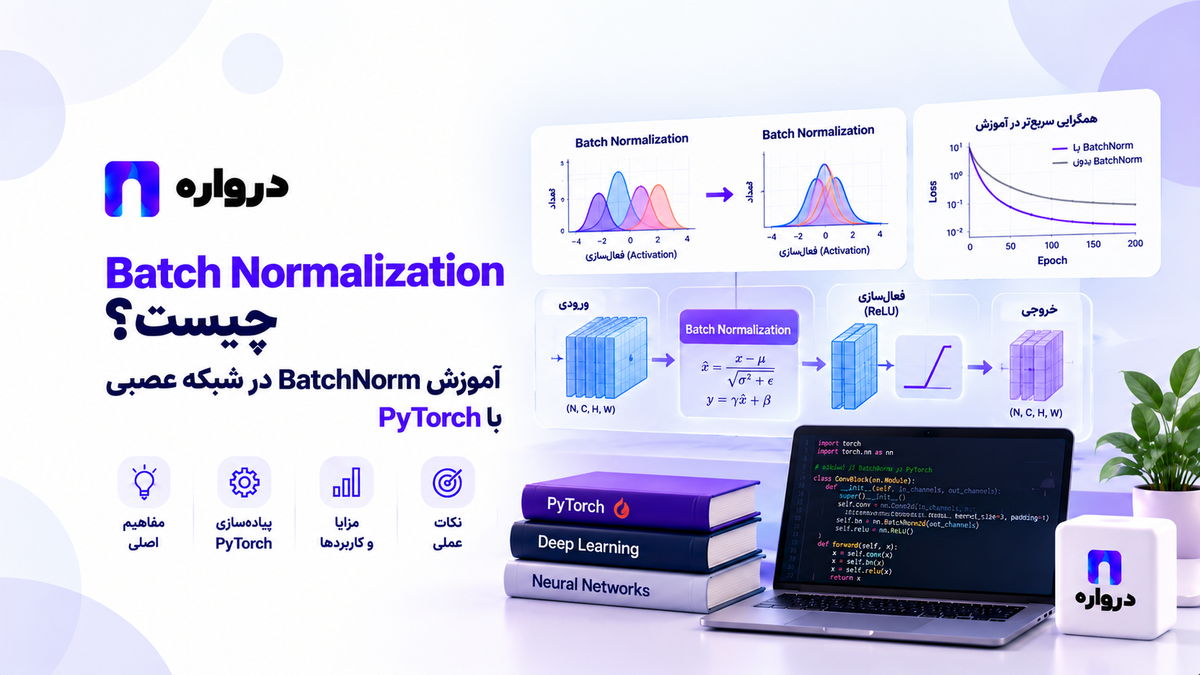
Batch Normalization یا بهاختصار BatchNorm روشی برای نرمالسازی مقادیر میانی شبکه عصبی هنگام آموزش است. این روش از آمار یک دسته از نمونهها استفاده میکند و سپس به مدل اجازه میدهد نتیجه نرمالسازی را با پارامترهای قابلآموزش تنظیم کند.
BatchNormدر بسیاری از معماریهای تصویری استفاده شده است، اما کاربرد درست آن فقط به افزودن یک لایه به کد محدود نمیشود. این لایه در حالت آموزش و ارزیابی رفتار متفاوتی دارد. اگر هنگام اعتبارسنجی یا استفاده عملی، حالت مدل را درست تنظیم نکنید، نتیجه میتواند تغییر کند یا آمار ذخیرهشده مدل ناخواسته بهروزرسانی شود.
در این مقاله، ابتدا سازوکار BatchNorm را به زبان ساده توضیح میدهیم. سپس آن را با نرمالسازی داده ورودی، Dropout، LayerNorm و GroupNorm مقایسه میکنیم و با PyTorch دو شبکه کانولوشنی را روی یک داده یکسان آموزش میدهیم: یکی با BatchNorm و دیگری بدون آن.
Batch Normalizationچیست؟
هنگام عبور داده از شبکه عصبی، هر لایه مقادیری به لایه بعد میدهد. اندازه و پراکندگی این مقادیر در جریان آموزش تغییر میکند، زیرا وزنهای لایههای قبلی نیز تغییر میکنند.
BatchNormمقادیر مربوط به هر ویژگی یا کانال را بر اساس آمار یک مینیبتچ نرمالسازی میکند. سپس دو پارامتر قابلآموزش به لایه امکان میدهند مقیاس و جابهجایی مناسب را یاد بگیرد. بنابراین هدف BatchNorm این نیست که خروجی تمام لایهها برای همیشه به یک شکل ثابت و بدون انعطاف محدود شود.
مقاله اصلی Batch Normalization را Sergey Ioffe و Christian Szegedy در سال ۲۰۱۵ منتشر کردند. آنها در آزمایشهای گزارششده نشان دادند این روش میتواند آموزش برخی شبکهها را سریعتر کند. این نتیجه مربوط به شرایط آزمایش مقاله است و به معنی بهبود تضمینی برای هر معماری و داده نیست. proceedings.mlr.press
مسیر رایج در یک بخش از شبکه تصویری چنین است:
ورودی لایه
↓
لایه کانولوشنی
↓
Batch Normalization
↓
تابع فعالسازی
↓
لایه بعدبرای آشنایی با اجزای دیگر این مسیر، راهنماهای شبکه عصبی کانولوشنی و تابع فعالسازی را ببینید.
مینیبتچ چیست؟
مدل معمولاً تمام داده آموزشی را در یک گام پردازش نمیکند. داده به گروههای کوچکتری به نام Batch یا «دسته» تقسیم میشود.
برای مثال، اگر مجموعه آموزش ۶۴۰ تصویر داشته باشد و اندازه Batch برابر ۶۴ باشد، هر دسته شامل ۶۴ تصویر است. مدل برای هر دسته پیشبینی انجام میدهد، خطا را محاسبه میکند و پارامترهای خود را تغییر میدهد.
BatchNorm هنگام آموزش از مقادیر موجود در همین دسته برای محاسبه آمار موردنیاز خود استفاده میکند. بنابراین ترکیب و اندازه Batchمیتواند بر رفتار آن اثر بگذارد.
BatchNormدقیقاً چه چیزی را نرمالسازی میکند؟
پاسخ به نوع لایه بستگی دارد. در یک شبکه کاملاً متصل، معمولاً خروجی هر ویژگی میان نمونههای Batch بررسی میشود. در یک شبکه کانولوشنی، آمار برای هر کانال با در نظر گرفتن نمونهها و موقعیتهای مکانی مربوط محاسبه میشود.
PyTorchچند ماژول جدا برای شکلهای مختلف ورودی دارد:
| ماژول | شکل رایج داده | کاربرد نمونه |
|---|---|---|
BatchNorm1d | نمونه و ویژگی؛ یا داده سهبعدی ترتیبی | MLP و برخی دادههای ترتیبی |
BatchNorm2d | نمونه، کانال، ارتفاع و عرض | تصویر در CNN |
BatchNorm3d | نمونه، کانال و سه بُعد فضایی یا زمانی | برخی دادههای حجمی |
برای یک تصویر رنگی در PyTorch، ترتیب رایج ابعاد ورودی به BatchNorm2d عبارت است از تعداد نمونه، تعداد کانال، ارتفاع، عرض. تعداد کانالهایی که به BatchNorm2d میدهید باید با خروجی لایه قبل هماهنگ باشد. مستندات رسمی PyTorch شکل ورودی و شیوه محاسبه آمار این ماژولها را مشخص میکند. PyTorch main documentation
آیا BatchNorm همان نرمالسازی داده ورودی است؟
خیر. این دو در بخشهای متفاوتی از گردش کار قرار دارند.
نرمالسازی داده ورودی پیش از ورود داده به مدل انجام میشود. برای مثال، ممکن است مقدار پیکسلها را به محدوده مناسب ببرید یا ویژگیهای جدولی را با آماری که فقط از داده آموزش به دست آمده مقیاسبندی کنید.
BatchNorm بخشی از خود شبکه است و معمولاً روی خروجی میانی یک لایه عمل میکند.
| ویژگی | نرمالسازی ورودی | BatchNorm |
|---|---|---|
| محل اجرا | پیش از مدل | داخل مدل |
| داده مورد استفاده برای تنظیم | داده آموزش | مقادیر میانی Batchهای آموزش |
| پارامترهای قابلآموزش | معمولاً ندارد | در حالت پیشفرض دارد |
| نقش در پیشبینی | همان تبدیل ذخیرهشده اعمال میشود | معمولاً از آمار ذخیرهشده هنگام آموزش استفاده میکند |
وجود BatchNorm دلیل خوبی برای حذف آمادهسازی درست داده ورودی نیست. برای داده جدولی، شیوه برخورد با ویژگیهای عددی، مقادیر گمشده و متغیرهای دستهای همچنان باید مشخص باشد.
پارامترهای قابلآموزش BatchNorm چه هستند؟
پس از نرمالسازی، BatchNorm در حالت پیشفرض دو نوع تنظیم قابلآموزش برای ویژگیها یا کانالها دارد:
- تنظیم مقیاس خروجی
- تنظیم جابهجایی خروجی
این پارامترها به مدل امکان میدهند نمایش مناسب مسئله را یاد بگیرد. به بیان ساده، BatchNorm خروجی لایه را نرمال میکند، اما شبکه همچنان میتواند شکل مفیدی از آن خروجی را تنظیم کند.
در PyTorch، گزینه affine=True این رفتار پیشفرض را فعال نگه میدارد. مستندات BatchNorm1d و BatchNorm2d همچنین نشان میدهد که لایه در حالت پیشفرض آمار در حال بهروزرسانی را نیز نگه میدارد. PyTorch main documentation
چرا BatchNorm به آمار ذخیرهشده نیاز دارد؟
هنگام آموزش، BatchNorm میتواند از آمار Batch جاری استفاده کند. اما هنگام پیشبینی ممکن است فقط یک نمونه به مدل داده شود. در این حالت، تکیه کردن بر آمار همان درخواست میتواند رفتار مدل را به اندازه و ترکیب دسته درخواستها وابسته کند.
به همین دلیل، با تنظیمات پیشفرض PyTorch، BatchNorm در طول آموزش برآوردهایی از آمار را نگه میدارد و هنگام اجرای مدل در حالت eval() از آنها استفاده میکند.
این موضوع یکی از تفاوتهای مهم میان حالت آموزش و ارزیابی است. PyTorch main documentation
آمار Batch و آمار ذخیرهشده یکساناند؟
لزومی ندارد. آمار Batch جاری از همان دادهای به دست میآید که در آن گام از شبکه عبور میکند. آمار ذخیرهشده بهتدریج در طول آموزش بهروزرسانی میشود.
در نتیجه، طبیعی است که خروجی یک مدل دارای BatchNorm در حالت train() و eval() برای ورودی یکسان دقیقاً برابر نباشد. این اختلاف بهخودیخود نشانه خرابی کد نیست.
اگر track_running_stats=False بگذاریم چه میشود؟
در این حالت، PyTorch آمار در حال بهروزرسانی را مانند حالت پیشفرض نگه نمیدارد و BatchNorm حتی هنگام ارزیابی نیز از آمار Batch ورودی استفاده میکند. بنابراین رفتار پیشبینی میتواند به نمونههای دیگری که همراه ورودی در همان Batch قرار گرفتهاند وابسته باشد. این تنظیم را باید آگاهانه و متناسب با کاربرد انتخاب کرد. PyTorch main documentation
تفاوت model.train() و model.eval() چیست؟
این دو دستور صرفاً برچسبگذاری ظاهری نیستند. بعضی لایهها بر اساس حالت مدل رفتار خود را تغییر میدهند.
model.train()مدل را برای مرحله آموزش تنظیم میکند. BatchNorm از آمار Batch استفاده میکند و، با تنظیمات پیشفرض، آمار ذخیرهشدهاش را بهروزرسانی میکند.
model.eval()مدل را برای اعتبارسنجی یا پیشبینی تنظیم میکند. BatchNorm با تنظیمات پیشفرض از آمار ذخیرهشده استفاده میکند و آن را با داده اعتبارسنجی بهروزرسانی نمیکند.
مستندات PyTorch تأکید میکند که برای مدلهای دارای BatchNorm و Dropout باید حالت آموزش و ارزیابی را بهدرستی تغییر دهید. PyTorch 2.14 documentation
آیا torch.inference_mode() جای model.eval() را میگیرد؟
خیر. این دو کار متفاوتی انجام میدهند:
model.eval()رفتار لایههایی مانند BatchNorm و Dropout را برای ارزیابی تغییر میدهد.torch.inference_mode()محاسبههایی را که برای گرادیانگیری لازماند در مرحله پیشبینی غیرفعال میکند.
برای پیشبینی معمولاً هر دو را به کار میبریم:
model.eval()with torch.inference_mode(): prediction = model(features)اگر فقط inference_mode() را اجرا کنید ولی مدل در حالت آموزش مانده باشد، BatchNorm همچنان میتواند رفتار مخصوص آموزش را داشته باشد. PyTorch 2.14 documentation
پارامتر momentum در BatchNorm چیست؟
درBatchNorm، momentum به نحوه بهروزرسانی آمار ذخیرهشده مربوط است. مستندات PyTorch تصریح میکند که معنای این پارامتر با momentum در بعضی بهینهسازها یکسان نیست.
مقدار پیشفرض آن در BatchNorm1d و BatchNorm2d برابر 0.1 است. تغییر این مقدار میتواند بر سرعت واکنش آمار ذخیرهشده به Batchهای جدید اثر بگذارد؛ بنابراین بهتر است بدون مشاهده مشکل مشخص و ارزیابی نتیجه، آن را صرفاً برای «بهبود سرعت آموزش» تغییر ندهید. PyTorch main documentation
پارامتر eps چه کاری انجام میدهد؟
eps مقدار کوچکی است که در محاسبه نرمالسازی برای پایداری عددی استفاده میشود. این پارامتر کمک میکند محاسبه در شرایطی که پراکندگی مقادیر بسیار کم است پایدار بماند.
مقدار پیشفرض آن در مستندات PyTorch مشخص شده است. در بسیاری از پروژهها نیازی به تغییر دستی آن نیست، مگر اینکه شواهد مشخصی از مشکل عددی یا نیاز ویژه معماری وجود داشته باشد. PyTorch main documentation
آیا BatchNorm همیشه آموزش را بهتر میکند؟
خیر. مقاله اصلی بهبودهای چشمگیری را در معماریها و آزمایشهای خود گزارش کرد، اما این نتیجه نباید به همه مسئلهها تعمیم داده شود. BatchNorm هزینه محاسباتی و وضعیت داخلی بیشتری به شبکه اضافه میکند و به اندازه Batch نیز حساس است. proceedings.mlr.press
برای تصمیم درست، مدلهای «با BatchNorm» و «بدون BatchNorm» را در شرایط قابلمقایسه بسنجید:
- کیفیت روی داده اعتبارسنجی و آزمون
- تعداد گام لازم برای رسیدن به کیفیت موردنظر
- زمان واقعی آموزش
- زمان پاسخ هنگام پیشبینی
- پایداری نتیجه در چند اجرای تکراری
- رفتار مدل با Batch کوچک
کم شدن تعداد گام آموزش الزاماً به معنی کم شدن زمان واقعی آموزش نیست. هر گام ممکن است هزینه متفاوتی داشته باشد.
آیا BatchNorm با «کاهش جابهجایی توزیع داخلی» کار میکند؟
عنوان مقاله اولیه Batch Normalization به Internal Covariate Shift اشاره دارد و این مفهوم در بسیاری از توضیحهای آموزشی تکرار شده است. اما توضیح سازوکار اثر BatchNorm در پژوهشهای بعدی بررسی و نقد شده است.
برای نمونه، پژوهش Santurkar و همکاران استدلال میکند که موفقیت BatchNorm را نمیتوان صرفاً با پایدار نگه داشتن توزیع ورودی لایهها توضیح داد و اثر آن بر هموارتر شدن مسئله بهینهسازی را برجسته میکند. بنابراین دقیقتر است بگوییمBatchNorm در بسیاری از آزمایشها به آموزش کمک کرده است، اما سازوکار اثر آن را نباید به یک توضیح ساده و قطعی فروکاست. proceedings.mlr.press
BatchNormرا کجای شبکه قرار دهیم؟
یک الگوی رایج در شبکه کانولوشنی چنین است:
from torch import nnblock = nn.Sequential( nn.Conv2d( in_channels=1, out_channels=16, kernel_size=3, padding=1, ), nn.BatchNorm2d(16), nn.ReLU(),)در اینجا لایه کانولوشنی ۱۶ کانال خروجی میسازد؛ بنابراین BatchNorm2d نیز با 16 تعریف شده است.
این ترتیب رایج است، اما قانون جهانی برای همه معماریها نیست. در مدلهای از پیشطراحیشده، جای لایههای نرمالسازی را باید با توجه به معماری همان مدل حفظ یا با آزمایش کنترلشده تغییر داد.
آیا بایاس لایه قبل ضروری است؟
در برخی بلوکها، وقتی بلافاصله پس از لایه خطی یا کانولوشنی از BatchNorm با تنظیمات پیشفرض استفاده میشود، بایاس لایه قبلی ممکن است زائد باشد. به همین دلیل در بعضی پیادهسازیها bias=False میبینید:
block = nn.Sequential( nn.Conv2d( 1, 16, kernel_size=3, padding=1, bias=False, ), nn.BatchNorm2d(16), nn.ReLU(),)این یک انتخاب طراحی است؛ آن را بدون بررسی ترتیب لایهها و رفتار مدل به همه معماریها تعمیم ندهید.
تفاوت BatchNorm با LayerNorm چیست؟
Layer Normalization یا LayerNorm آمار نرمالسازی را از بخشهای مشخصی از خود هر نمونه محاسبه میکند. در نتیجه، به همان شکل BatchNorm به آمار نمونههای دیگر در Batch وابسته نیست.
مستندات PyTorch میگوید LayerNorm در هر دو حالت آموزش و ارزیابی از آمار محاسبهشده برای ورودی استفاده میکند. مقاله اصلی Layer Normalization نیز این روش را با محاسبه آمار در سطح یک نمونه توضیح میدهد. PyTorch 2.14 documentation
| معیار | BatchNorm | LayerNorm |
|---|---|---|
| منبع آمار هنگام آموزش | Batch و ابعاد مرتبط | ابعاد تعیینشده در هر نمونه |
| وابستگی به ترکیب Batch | دارد | به شکل BatchNorm ندارد |
| رفتار پیشفرض هنگام ارزیابی | استفاده از آمار ذخیرهشده | استفاده از آمار ورودی همان نمونه |
| کاربرد شناختهشده | بسیاری از CNNها | بسیاری از معماریهای ترتیبی و Transformer |
| حساسیت به Batch بسیار کوچک | میتواند مهم باشد | معمولاً کمتر |
این جدول به معنی «LayerNorm جدیدتر است، پس همیشه بهتر است» نیست. نوع معماری و نتیجه آزمایش تعیینکنندهاند.
تفاوت BatchNorm با GroupNorm چیست؟
Group Normalization یا GroupNorm کانالها را به گروههایی تقسیم میکند و نرمالسازی را در هر نمونه و گروه انجام میدهد. این روش برای شرایطی که Batch آموزشی بسیار کوچک است، ارزش بررسی دارد.
پژوهش Wu و He، GroupNorm را بهعنوان جایگزینی برای BatchNorm معرفی و نشان داد که در آزمایشهای گزارششده با Batch کوچک، میتواند عملکرد مناسبتری داشته باشد. نتیجه آن پژوهش نیز تضمین برتری GroupNorm در هر شبکه نیست. openaccess.thecvf.com
نمونهPyTorch:
from torch import nn

normalization = nn.GroupNorm(
    num_groups=4,
    num_channels=16,
)
تعداد کانالها باید با خروجی لایه قبل هماهنگ باشد و انتخاب تعداد گروهها نیز باید با تعداد کانالها سازگار باشد.
BatchNorm چه تفاوتی با Dropoutدارد؟
BatchNorm و Dropoutهر دو ممکن است در یک شبکه وجود داشته باشند، اما یک کار انجام نمیدهند.
Dropout در هنگام آموزش بخشی از خروجی واحدها را بهصورت تصادفی غیرفعال میکند و در حالت ارزیابی رفتار متفاوتی دارد. BatchNorm مقادیر میانی را با استفاده از آمار مناسب حالت آموزش یا ارزیابی نرمالسازی میکند.
| ویژگی | BatchNorm | Dropout |
|---|---|---|
| عمل اصلی | نرمالسازی مقادیر میانی | غیرفعالسازی تصادفی بخشی از خروجیها در آموزش |
| رفتار متفاوت در Train و Eval | بله | بله |
| نگهداری آمار در حال بهروزرسانی در حالت پیشفرض | بله | خیر |
| جایگزین مستقیم دیگری است؟ | خیر | خیر |
استفاده همزمان از آنها ممکن است، اما ترتیب و مقدار تنظیمات باید با ارزیابی مشخص شود. مستندات PyTorch درباره رفتار متفاوت این لایهها در حالت آموزش و ارزیابی توضیح میدهد. PyTorch Tutorials 2.14.0+cu130 documentation
آموزش عملی: مقایسه CNN با BatchNorm و بدون آن
در این مثال از مجموعهداده کوچک Digits در scikit-learn استفاده میکنیم. تصاویر آن ۸ در ۸ پیکسل هستند. به این ترتیب، بدون دانلود یک دیتاست تصویری بزرگ میتوانیم دو CNN کوچک را آموزش دهیم.
دو مدل از نظر ساختار اصلی یکساناند:
- مدل اول پس از لایههای کانولوشنی BatchNorm دارد.
- مدل دوم BatchNorm ندارد.
هدف آزمایش، یادگیری روش مقایسه است. هیچ عدد یا برتری از پیش برای یکی از مدلها اعلام نمیکنیم.
نصب ابزارها
python -m pip install torch scikit-learn numpy matplotlibساخت و تقسیم داده
import numpy as np
import torch
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
SEED = 42
np.random.seed(SEED)
torch.manual_seed(SEED)
digits = load_digits()
# تصاویر 8 در 8 هستند.
# یک بُعد کانال به هر تصویر اضافه میکنیم.
X = digits.images.astype(
np.float32
)
X = X[:, None, :, :]
# مقدار پیکسلها در این دیتاست
# در بازه صفر تا 16 قرار دارد.
X = X / 16.0
y = digits.target.astype(
np.int64
)
X_dev, X_test, y_dev, y_test = (
train_test_split(
X,
y,
test_size=0.20,
stratify=y,
random_state=SEED,
)
)
X_train, X_val, y_train, y_val = (
train_test_split(
X_dev,
y_dev,
test_size=0.25,
stratify=y_dev,
random_state=SEED,
)
)
print("Train:", len(X_train))
print("Validation:", len(X_val))
print("Test:", len(X_test))تقسیم بالا مجموعه آزمون را برای مرحله آخر کنار میگذارد. داده اعتبارسنجی برای انتخاب نسخه بهتر مدل استفاده میشود.
ساختDataLoader
from torch.utils.data import (
    DataLoader,
    TensorDataset,
)


train_dataset = TensorDataset(
    torch.from_numpy(X_train),
    torch.from_numpy(y_train),
)

device = torch.device(
    "cuda" if torch.cuda.is_available()
    else "cpu"
)

X_val_tensor = torch.from_numpy(
    X_val
).to(device)

y_val_tensor = torch.from_numpy(
    y_val
).to(device)
دقت کنید که برای این آزمایش آموزشی، دادهها از پیش در حافظه قرار دارند. در پروژههای بزرگتر، روش بارگذاری داده باید متناسب با حجم و محل نگهداری آن طراحی شود.
ساخت معماری قابلمقایسه
from torch import nn


class SmallCNN(nn.Module):
    def __init__(
        self,
        use_batch_norm: bool,
    ):
        super().__init__()

        first_norm = (
            nn.BatchNorm2d(16)
            if use_batch_norm
            else nn.Identity()
        )

        second_norm = (
            nn.BatchNorm2d(32)
            if use_batch_norm
            else nn.Identity()
        )

        self.features = nn.Sequential(
            nn.Conv2d(
                1,
                16,
                kernel_size=3,
                padding=1,
            ),
            first_norm,
            nn.ReLU(),

            nn.MaxPool2d(2),

            nn.Conv2d(
                16,
                32,
                kernel_size=3,
                padding=1,
            ),
            second_norm,
            nn.ReLU(),

            nn.MaxPool2d(2),
        )

        self.classifier = nn.Linear(
            32 * 2 * 2,
            10,
        )

    def forward(
        self,
        images,
    ):
        features = self.features(
            images
        )

        features = torch.flatten(
            features,
            start_dim=1,
        )

        return self.classifier(
            features
        )
ابعاد تصویر پس از نخستین MaxPool2d از ۸ به ۴ و پس از دومی از ۴ به ۲ کاهش مییابد. به همین دلیل ورودی لایه نهایی با 32 * 2 * 2 تعریف شده است.
در مدل بدونBatchNorm، nn.Identity() ورودی را بدون تغییر عبور میدهد. این کار به ما کمک میکند جای لایهها در دو نسخه یکسان بماند.
آموزش هر دو مدل
import copy
def train_one_model(
use_batch_norm: bool,
max_epochs: int = 35,
patience: int = 7,
):
torch.manual_seed(SEED)
model = SmallCNN(
use_batch_norm=use_batch_norm
).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(
model.parameters(),
lr=0.001,
weight_decay=0.0001,
)
loader_generator = (
torch.Generator()
)
loader_generator.manual_seed(
SEED
)
train_loader = DataLoader(
train_dataset,
batch_size=64,
shuffle=True,
generator=loader_generator,
)
train_history = []
val_history = []
best_val_loss = float("inf")
best_state = None
epochs_without_improvement = 0
for epoch in range(max_epochs):
model.train()
total_loss = 0.0
total_samples = 0
for images, labels in train_loader:
images = images.to(device)
labels = labels.to(device)
optimizer.zero_grad()
logits = model(
images
)
loss = criterion(
logits,
labels,
)
loss.backward()
optimizer.step()
batch_size = images.size(0)
total_loss += (
loss.item()
* batch_size
)
total_samples += batch_size
train_loss = (
total_loss
/ total_samples
)
# پیش از اعتبارسنجی،
# حالت مدل تغییر میکند.
model.eval()
with torch.inference_mode():
val_logits = model(
X_val_tensor
)
val_loss = criterion(
val_logits,
y_val_tensor,
).item()
train_history.append(
train_loss
)
val_history.append(
val_loss
)
if val_loss < (
best_val_loss - 1e-5
):
best_val_loss = val_loss
best_state = copy.deepcopy(
model.state_dict()
)
epochs_without_improvement = 0
else:
epochs_without_improvement += 1
if (
epochs_without_improvement
>= patience
):
break
model.load_state_dict(
best_state
)
model.eval()
return {
"model": model,
"train_history": train_history,
"val_history": val_history,
"best_val_loss": best_val_loss,
"epochs": len(train_history),
}
results = {
"with_batch_norm": train_one_model(
use_batch_norm=True
),
"without_batch_norm": train_one_model(
use_batch_norm=False
),
}
for name, result in results.items():
print(
name,
"Validation loss:",
round(
result["best_val_loss"],
4,
),
"Epochs:",
result["epochs"],
)در این آزمایش، هر مدل با یک بذر مشخص و ترتیب دستههای آموزشی کنترلشده آغاز میشود. بااینحال، افزودن BatchNorm پارامترها و رفتار محاسباتی مدل را تغییر میدهد؛ بنابراین این دو اجرا از همه نظر یکسان نیستند. برای نتیجهگیری محکمتر باید آزمایش را با چند بذر تکرار کرد.
نکته مهم کد: best_state تنها وزنهای قابلآموزش نیست؛ وضعیت ذخیرهشده موردنیاز مدل، از جمله آمار مربوط به BatchNorm، نیز در وضعیت مدل قرار میگیرد. هنگام استفاده بعدی باید همان وضعیت انتخابشده بازیابی شود. PyTorch آمار BatchNorm را بخشی از وضعیت ماژول نگه میدارد. PyTorch main documentation
نمایش روند آموزش و اعتبارسنجی
import matplotlib.pyplot as plt


plt.figure(figsize=(9, 5))

for name, result in results.items():
    plt.plot(
        result["val_history"],
        label=name,
    )

plt.xlabel("Epoch")
plt.ylabel("Validation loss")
plt.legend()
plt.tight_layout()
plt.show()
هنگام خواندن نمودار، فقط پایینترین نقطه را نبینید. به موارد زیر هم توجه کنید:
- آیا کاهش خطا در چند اجرا تکرار میشود؟
- آیا یکی از مدلها نوسان شدید دارد؟
- آیا تفاوت کیفیت با تفاوت زمان آموزش تناسب دارد؟
- آیا خطای آموزش کاهش مییابد ولی اعتبارسنجی بدتر میشود؟
- آیا نتیجه برای اندازه Batchهای دیگر نیز پابرجاست؟
ارزیابی نهایی روی داده آزمون
مدلی را که با معیار اعتبارسنجی انتخاب شده است، روی آزمون مستقل بررسی میکنیم:
from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix,
)


selected_name = min(
    results,
    key=lambda name: (
        results[name]["best_val_loss"]
    ),
)

selected_model = results[
    selected_name
]["model"]

X_test_tensor = torch.from_numpy(
    X_test
).to(device)

selected_model.eval()

with torch.inference_mode():
    test_logits = selected_model(
        X_test_tensor
    )

    predictions = (
        test_logits.argmax(dim=1)
        .cpu()
        .numpy()
    )

print(
    "Selected model:",
    selected_name,
)

print(
    "Test accuracy:",
    accuracy_score(
        y_test,
        predictions,
    ),
)

print(
    confusion_matrix(
        y_test,
        predictions,
    )
)

print(
    classification_report(
        y_test,
        predictions,
        digits=4,
    )
)
اعداد خروجی باید از اجرای واقعی کد به دست بیایند. این مثال ادعای بهبود ثابت و تضمینی BatchNorm روی دیتاست Digits ندارد.
آیا باید هر دو مدل را روی Test ببینیم؟
برای تحلیل پژوهشی میتوان نتیجه هر دو را گزارش کرد، اما اگر بارها بر اساس نتیجه Test مدل، معماری یا تنظیمات را تغییر دهید، Test دیگر یک سنجش مستقل از تصمیمهای شما نخواهد بود. در گردش کار بالا، انتخاب با Validation انجام میشود و Test برای ارزیابی نهایی مدل انتخابشده نگه داشته میشود.
مشاهده تفاوت حالت Train و Eval درBatchNorm
کد کوتاه زیر نشان میدهد running_mean هنگام آموزش تغییر میکند، اما هنگام ارزیابی ثابت میماند:
import torch

from torch import nn


layer = nn.BatchNorm1d(4)

batch = torch.randn(
    8,
    4,
)

before_training = (
    layer.running_mean.clone()
)

layer.train()

_ = layer(batch)

after_training = (
    layer.running_mean.clone()
)

layer.eval()

with torch.inference_mode():
    _ = layer(batch)

after_evaluation = (
    layer.running_mean.clone()
)

print(
    "Before training:",
    before_training,
)

print(
    "After training:",
    after_training,
)

print(
    "After evaluation:",
    after_evaluation,
)
در این مثال باید مشاهده کنید که آمار پس از اجرای حالت آموزش میتواند تغییر کند و اجرای حالت ارزیابی آن را دوباره بهروزرسانی نمیکند. مقدار دقیق اعداد به Batch تصادفی بستگی دارد.
Batchکوچک چه مشکلی ایجاد میکند؟
BatchNorm برای محاسبه آمار آموزش به مقادیر موجود در Batchمتکی است. وقتی تعداد مقادیر مؤثر برای هر ویژگی بسیار کم باشد، تخمین آمار میتواند ناپایدار یا حتی در بعضی شکلهای ورودی ناممکن شود.
این مسئله بهویژه در مدلهایی رخ میدهد که به دلیل اندازه تصویر یا محدودیت حافظه، تنها تعداد اندکی نمونه در هر گام پردازش میکنند.
چند نکته عملی:
- Batchکوچک همیشه به معنی خطا نیست؛ شکل خروجی لایه نیز اهمیت دارد.
- برای
BatchNorm1dروی یک بردار ویژگی، Batch تکنمونهای در حالت آموزش میتواند مسئلهساز شود. - در
BatchNorm2dعلاوه بر تعداد نمونه، ابعاد مکانی ویژگیها نیز در تعداد مقدارهای در دسترس برای هر کانال نقش دارند. - اگر Batch مؤثر بسیار کوچک است، GroupNorm یا LayerNorm را در آزمایش قرار دهید.
- افزایش اندازه Batch فقط برای سازگار شدن با BatchNorm، اگر هزینه حافظه یا کیفیت را خراب کند، الزاماً تصمیم خوبی نیست.
پژوهش Group Normalization این محدودیت را در آموزش با Batch کوچک بررسی و روش جایگزینی ارائه میکند. openaccess.thecvf.com
چرا اجرای مدل با Batch تکنمونهای در حالت Eval ممکن است؟
در تنظیم پیشفرض، مدل آموزشدیده دارای BatchNorm هنگام eval() از آمار ذخیرهشده استفاده میکند. بنابراین لازم نیست برای هر درخواست پیشبینی، یک Batch بزرگ از کاربران جدید جمعآوری کنید.
البته اگر track_running_stats=False انتخاب کرده باشید، این توضیح پیشفرض دیگر به همان شکل برقرار نیست؛ زیرا مدل در حالت ارزیابی نیز از آمار Batch جاری استفاده خواهد کرد. PyTorch main documentation
آیا BatchNorm مانع بیشبرازش میشود؟
BatchNormممکن است در بعضی شرایط بر رفتار آموزش و تعمیم مدل اثر بگذارد، اما جایگزین ارزیابی و کنترل بیشبرازش نیست. مدلی که BatchNorm دارد همچنان میتواند داده آموزش را خوب یاد بگیرد و روی داده جدید عملکرد ضعیفی داشته باشد.
برای بررسی بیشبرازش باید نتیجه آموزش و اعتبارسنجی را مقایسه کنید و در صورت نیاز، ظرفیت مدل، کیفیت داده، وزندهی، روش آموزش و تناسب داده آزمون با کاربرد واقعی را بازبینی کنید. مقاله بیشبرازش و کمبرازش این موضوع را جداگانه بررسی میکند.
BatchNormدر مدلهای از پیشآموزشدیده
در یادگیری انتقالی، ممکن است شبکهای را دریافت کنید که BatchNorm آن از پیش آموزش دیده است. تصمیم درباره ادامه بهروزرسانی این لایهها به مقدار داده جدید، شباهت داده جدید به داده اصلی و روش تنظیم مدل بستگی دارد.
یک نکته فنی مهم این است که ثابت کردن گرادیان پارامترها بهتنهایی لزوماً مانع تغییر آمار ذخیرهشده BatchNorm نمیشود. اگر کل مدل را در حالت train() اجرا کنید، لایههای BatchNorm با رفتار حالت آموزش کار میکنند. بنابراین در فاینتیونینگ باید وضعیت لایهها را آگاهانه مدیریت کنید و نتیجه را روی Validation بسنجید. مستندات PyTorch بر تفاوت حالت لایهها در آموزش و ارزیابی تأکید دارد. PyTorch 2.14 documentation
اشتباهات رایج هنگام استفاده ازBatchNorm
فراموش کردن model.eval() در پیشبینی
در این حالت مدل ممکن است همچنان با رفتار آموزش اجرا شود. نتیجه میتواند به ترکیب Batch وابسته شود و آمار ذخیرهشده نیز ناخواسته تغییر کند.
اجرای اعتبارسنجی در حالتTrain
اگر داده Validation از مدلی در حالت آموزش عبور کند، ارزیابی شما ممکن است آمار BatchNorm را بهروزرسانی کند. اعتبارسنجی را پس از model.eval() انجام دهید.
تصور اینکه inference_mode() حالت لایه را عوض میکند
inference_mode() جای eval() را نمیگیرد. هر دو نقش متفاوتی دارند.
انتخاب تعداد کانال اشتباه
اگر خروجی کانولوشن ۳۲ کانال دارد، لایه بعدی باید متناسب با همان تعداد کانال تعریف شود:
nn.Conv2d(16, 32, kernel_size=3)nn.BatchNorm2d(32)استفاده از BatchNorm2d برای داده با ترتیب ابعاد اشتباه
ورودی رایج آن در PyTorch به ترتیب «Batch، کانال، ارتفاع، عرض» است. اگر داده شما ترتیب دیگری دارد، پیش از ورود به لایه باید ابعاد را درست آماده کنید.
مقایسه مدلها با داده یا تنظیمات متفاوت
اگر همزمان BatchNorm، نرخ یادگیری، اندازه شبکه و تقسیم داده را تغییر دهید، دیگر نمیدانید اختلاف نتیجه به کدام تغییر مربوط است.
فرض اینکه BatchNorm جای مقیاسبندی ورودی را میگیرد
BatchNormروی مقادیر داخل شبکه عمل میکند. آمادهسازی داده ورودی همچنان یک تصمیم جداگانه است.
آموزش با Batch بسیار کوچک بدون بررسی رفتار
وقتی Batch کوچک است، دقت و پایداری آمار را بررسی کنید. در صورت نیاز، GroupNorm، LayerNorm یا معماری دیگری را مقایسه کنید.
تغییر momentum با تصور اینکه همان momentum بهینهساز است
momentum مربوط به BatchNorm نحوه بهروزرسانی آمار ذخیرهشده را کنترل میکند. معنای آن را با تنظیم بهینهساز اشتباه نگیرید.
چه زمانی BatchNorm، LayerNorm یا GroupNorm را آزمایش کنیم؟
| شرایط | گزینههای مناسب برای آزمایش | دلیل |
|---|---|---|
| CNN تصویری با Batch آموزشی مناسب | BatchNorm و خط مبنای بدون آن | کاربرد شناختهشده در معماریهای تصویری |
| CNN با Batch بسیار کوچک | GroupNorm در کنار BatchNorm | وابستگی کمتر GroupNorm به اندازه Batch |
| مدل ترتیبی یا Transformer | LayerNorm یا نرمالسازی تعریفشده در همان معماری | آمار در سطح نمونه و سازگاری با معماری |
| مدل از پیشآموزشدیده | حفظ ساختار اصلی و سنجش روش فاینتیونینگ | تغییر نرمالسازی، رفتار مدل را تغییر میدهد |
| MLP کوچک روی داده جدولی | مدل ساده بدون نرمالسازی داخلی و گزینههای دارای آن | نیاز به سنجش تجربی؛ پیچیدگی بیشتر همیشه مفید نیست |
این جدول نسخه قطعی طراحی مدل نیست. معماری، داده و نتیجه آزمون معتبر باید تصمیم را تعیین کنند.
ارتباط BatchNorm با استفاده از مدلهای آماده
شناخت BatchNorm برای کسی که شبکه را با PyTorch آموزش میدهد مهم است؛ زیرا میتواند بر کیفیت آموزش و رفتار مدل در پیشبینی اثر بگذارد. اما هر محصولی نیاز ندارد شبکه را از ابتدا آموزش دهد.
برای نمونه، اگر هدف شما افزودن تحلیل متن فارسی، خلاصهسازی، جستوجوی معنایی یا تولید پاسخ به نرمافزار است، میتوانید ابتدا مدلهای آماده مناسب را روی داده واقعی خود آزمایش کنید. در این حالت، معیار تصمیم شما بیشتر کیفیت خروجی، زمان پاسخ، هزینه و تناسب مدل با وظیفه است. اگر بهمرور به آموزش مدل اختصاصی رسیدید، جزئیاتی مانند BatchNorm و شیوه تنظیم مدل اهمیت عملی بیشتری پیدا میکنند.
درواره از طریق یک API یکپارچه امکان بررسی و استفاده از مدلهای موجود را فراهم میکند. قابلیت و شناسه هر مدل را باید پیش از پیادهسازی در مستندات و فهرست فعلی مدلهای درواره بررسی کنید؛ BatchNorm در این مقاله یک مفهوم معماری است و به معنی ارائه یک سرویس مستقل با این نام نیست.
پرسشهای متداول
Batch Normalizationچیست؟
Batch Normalizationروشی برای نرمالسازی مقادیر میانی شبکه عصبی با استفاده از آمار دستههای آموزشی است. در حالت پیشفرض، آمار ذخیرهشده آن هنگام ارزیابی استفاده میشود.
BatchNormچه تفاوتی با نرمالسازی ورودی دارد؟
نرمالسازی ورودی پیش از مدل روی داده خام یا ویژگیها انجام میشود. BatchNorm لایهای داخل شبکه است و روی نمایشهای میانی کار میکند.
آیا BatchNorm همیشه سرعت آموزش را افزایش میدهد؟
خیر. اثر آن به معماری، داده، Batch و محیط اجرا بستگی دارد. تعداد گام آموزش، زمان واقعی هر گام و کیفیت نهایی را جداگانه اندازه بگیرید.
چرا خروجی مدل در حالت Train و Eval فرق میکند؟
BatchNorm با تنظیمات پیشفرض در آموزش از آمار Batch جاری و در ارزیابی از آمار ذخیرهشده استفاده میکند. لایههای دیگری مانند Dropoutنیز رفتارشان میان این دو حالت متفاوت است.
آیا model.eval() آموزش مدل را برای همیشه متوقف میکند؟
خیر. این دستور حالت اجرای ماژول را تغییر میدهد. برای ادامه آموزش میتوان model.train() را اجرا کرد. خود eval() جای کنترل گرادیان با torch.inference_mode() یا ابزارهای مشابه را نمیگیرد.
آیا برای پیشبینی یک تصویر به Batch بزرگ نیاز داریم؟
در حالت پیشفرض و پس از آموزش مناسب، BatchNorm در وضعیت eval() از آمار ذخیرهشده استفاده میکند و پیشبینی تکنمونهای امکانپذیر است.
BatchNorm و Dropoutیکی هستند؟
خیر. BatchNorm مقادیر میانی را نرمالسازی میکند؛ Dropout در آموزش بخشی از خروجیها را بهصورت تصادفی غیرفعال میکند.
BatchNorm بهتر است یا LayerNorm؟
پاسخ کلی وجود ندارد. BatchNorm در بسیاری از CNNها به کار رفته است. LayerNorm در معماریهای دیگری، از جمله بسیاری از مدلهای ترتیبی، کاربرد دارد. انتخاب را با توجه به معماری و آزمون انجام دهید.
برای Batch کوچک چه کنیم؟
ابتدا شکل داده و رفتار واقعی BatchNorm را بررسی کنید. سپس GroupNorm یا LayerNorm را بهعنوان گزینه آزمایشی در نظر بگیرید و کیفیت و هزینه آنها را مقایسه کنید.
آیا BatchNorm جای تابع فعالسازی را میگیرد؟
خیر. BatchNorm و تابع فعالسازی نقش متفاوتی دارند و در بسیاری از شبکهها هر دو در یک بلوک وجود دارند.
آیا BatchNorm مانع بیشبرازش میشود؟
بهتنهایی خیر. کیفیت تعمیم مدل باید با داده اعتبارسنجی و آزمون مستقل سنجیده شود.
جمعبندی
Batch Normalization لایهای برای نرمالسازی مقادیر میانی شبکه است که در حالت پیشفرض هنگام آموزش از آمار Batchاستفاده میکند و آمار لازم برای ارزیابی را نیز نگه میدارد. همین تفاوت باعث میشود اجرای درست model.train() و model.eval() ضروری باشد.
BatchNorm در بسیاری از معماریهای تصویری مفید بوده است، اما نتیجه آن برای هر داده و شبکه تضمینشده نیست. Batch کوچک، هزینه محاسباتی، روش فاینتیونینگ و تفاوت رفتار آموزش و پیشبینی باید بررسی شوند. برای بعضی شرایط، LayerNorm یا GroupNormارزش مقایسه دارند.
برای ساخت محصول با هوش مصنوعی: اگر مسئله شما نیازمند آموزش شبکه اختصاصی نیست، ابتدا مدلهای آماده مرتبط را روی نمونههای واقعی محصولتان بسنجید. مدلها و مستندات API درواره را بررسی کنید، یک نمونه اولیه بسازید و کیفیت، زمان پاسخ و هزینه را پیش از تصمیم درباره آموزش مدل اختصاصی مقایسه کنید.
مقالات مرتبط
- شبکه عصبی مصنوعی و یادگیری عمیق چیست؟
- تابع فعالسازی در شبکه عصبی چیست؟
- شبکه عصبی کانولوشنی CNN چیست؟
- PyTorchچیست؟ آموزش یادگیری عمیق با پایتون
- بیشبرازش و کمبرازش در یادگیری ماشین
- یادگیری انتقالی و Fine-tuning باPyTorch
- آموزش استفاده از API هوش مصنوعی در اپلیکیشن
منابع
- مقاله اصلی Batch Normalization درICML
- پژوهش بررسی سازوکار بهینهسازی BatchNorm درNeurIPS
- مستندات رسمی PyTorch برایBatchNorm1d
- مستندات رسمی PyTorch برایBatchNorm2d
- مقاله اصلیLayer Normalization
- مقاله Group Normalization درECCV
- مستندات PyTorch درباره حالت آموزش و ارزیابی
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. رفتار لایهها، عملکرد مدل و سازگاری نمونه کد با نسخه کتابخانهها باید پیش از استفاده عملی در محیط موردنظر بررسی شود. صفحه سلب مسئولیت درواره را نیز مطالعه کنید.



