
Early Stopping چیست؟ آموزش توقف زودهنگام و ذخیره بهترین مدل با PyTorch
Early Stopping چیست و چگونه زمان مناسب توقف آموزش شبکه عصبی را پیدا میکند؟ در این آموزش، مفهوم Patience و Min Delta، ذخیره بهترین مدل، تفاوت توقف زودهنگام با کاهش نرخ یادگیری و پیادهسازی کامل آن در PyTorch را یاد میگیرید.

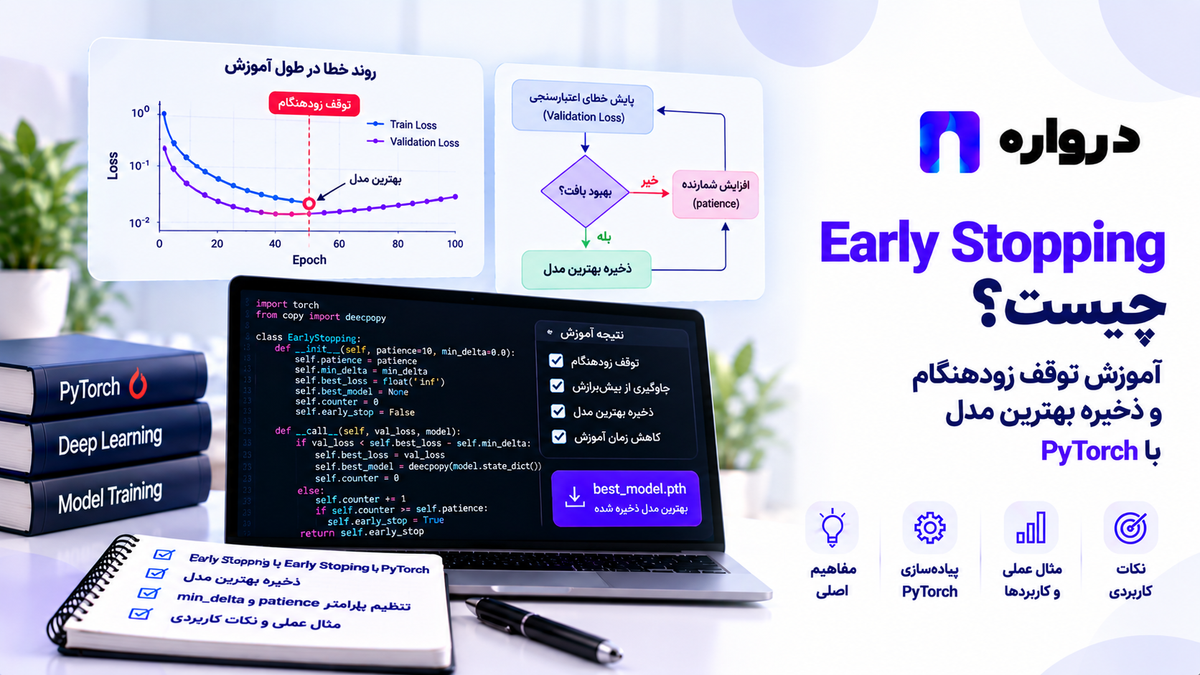
وقتی یک شبکه عصبی را آموزش میدهید، معمولاً نمیدانید چند Epoch برای آن مناسب است. اگر آموزش را خیلی زود متوقف کنید، مدل ممکن است هنوز الگوهای اصلی داده را یاد نگرفته باشد. اگر مدت زیادی ادامه دهید، ممکن است مدل به داده آموزش بیشازحد وابسته شود یا فقط زمان و منابع بیشتری مصرف کند.
Early Stopping یا توقف زودهنگام روشی برای تصمیمگیری درباره زمان پایان آموزش است. در این روش، عملکرد مدل را پس از هر Epoch روی داده اعتبارسنجی بررسی میکنیم. اگر معیار انتخابشده برای مدتی مشخص بهبود معناداری نداشته باشد، آموزش متوقف میشود.
برای مثال، اگر معیار ما خطای اعتبارسنجی باشد:
- مدل یک Epoch آموزش میبیند.
- خطای آن روی داده Validation محاسبه میشود.
- اگر خطا بهتر شده باشد، وضعیت بهترین مدل نگه داشته میشود.
- اگر بهبود کافی رخ ندهد، شمارنده انتظار افزایش مییابد.
- پس از رسیدن شمارنده به حد تعیینشده، آموزش پایان مییابد.
- وزنهای بهترین Epoch بازیابی میشوند.
مستندات رسمی Keras نیز Early Stopping را توقف آموزش پس از متوقفشدن بهبود یک معیار پایششده، با تنظیماتی مانند patience و min_delta، تعریف میکند. در این مقاله همان منطق را بهصورت شفاف در حلقه آموزش PyTorch پیادهسازی میکنیم. keras.io
چرا تعیین تعداد ثابت Epoch همیشه کافی نیست؟
فرض کنید برای هر مسئله مقدار epochs=100 انتخاب میکنید. سه وضعیت ممکن است رخ دهد:
- مدل در Epoch دهم به نتیجه مناسب برسد و ادامه آموزش سود کمی داشته باشد.
- مدل تا Epoch صدم همچنان در حال بهترشدن باشد.
- مدل ابتدا بهتر شود، اما بعد عملکردش روی داده جدید افت کند.
بنابراین تعداد Epoch یک عدد جادویی و مستقل از داده نیست. معماری مدل، اندازه و کیفیت داده، نرخ یادگیری، Batch Size و حتی بذر تصادفی میتوانند بر روند آموزش اثر بگذارند.
Early Stoppingبهجای اتکا به یک تعداد ثابت بهعنوان زمان پایان قطعی، از عملکرد مدل روی داده اعتبارسنجی برای تصمیمگیری کمک میگیرد.
تفاوت خطای Train وValidation
در طول آموزش، دو نوع خطا را زیاد میبینیم:
- Train Loss: خطای مدل روی دادهای که برای تغییر وزنها استفاده میشود.
- Validation Loss: خطای مدل روی دادهای که در بهروزرسانی وزنها شرکت نمیکند.
ممکن است Train Loss همچنان کاهش یابد، اما Validation Loss دیگر بهتر نشود یا حتی افزایش یابد. در این شرایط، بهبود مدل روی داده آموزش الزاماً به معنی بهترشدن عملکرد آن روی نمونههای جدید نیست.
راهنمای ارزیابی scikit-learn توضیح میدهد که سنجش مدل فقط روی نمونههایی که در آموزش دیده، میتواند ارزیابی گمراهکنندهای ایجاد کند. برای انتخاب تنظیمات، داده اعتبارسنجی و برای ارزیابی نهایی، داده Test جداگانه لازم است. scikit-learn 1.9.1 documentation
Early Stoppingچگونه به جلوگیری از بیشبرازش کمک میکند؟
بیشبرازش زمانی رخ میدهد که مدل الگوهای داده آموزش را بسیار خوب یاد بگیرد، اما روی داده جدید عملکرد ضعیفتری داشته باشد.
توقف زودهنگام میتواند مدت زمانی را که مدل پس از پایان بهبود اعتبارسنجی همچنان آموزش میبیند، محدود کند. نمونه رسمی scikit-learn نیز توقف بر اساس امتیاز Validation را روشی برای یافتن تعداد تکرار کافی و کاهش احتمال بیشبرازش توصیف میکند. scikit-learn 1.9.1 documentation
بااینحال، Early Stopping درمان همه علتهای بیشبرازش نیست. اگر تقسیم داده اشتباه باشد، داده اعتبارسنجی نماینده شرایط واقعی نباشد یا مدل روی دادهای آلوده آموزش ببیند، صرف توقف بهموقع مشکل را حل نمیکند.
Patienceچیست؟
patience مشخص میکند چند بار ارزیابی بدون بهبود کافی را تحمل کنیم و بعد آموزش را متوقف کنیم.
اگر بعد از هر Epoch اعتبارسنجی انجام میدهید و patience=8 است، مدل پس از هشت Epoch متوالی بدون بهبود کافی متوقف میشود.
Patience بهخصوص زمانی مفید است که معیار Validation نوسان دارد. بدون آن، یک Epochضعیف ممکن است باعث توقف عجولانه شود.
انتخاب آن به رفتار مسئله بستگی دارد:
- مقدار بسیار کوچک: خطر توقف پیش از ادامه بهبود.
- مقدار بسیار بزرگ: آموزش طولانیتر پس از توقف پیشرفت.
- مقدار متناسب با نوسان Validation: فرصت بیشتر برای عبور از افتهای کوتاهمدت.
Min Deltaچیست؟
min_delta تعیین میکند کمترین مقدار بهبود قابلقبول چقدر باشد.
فرض کنید Validation Loss از 0.4200 به 0.4199 برسد. از نظر عددی بهتر شده است؛ اما ممکن است این تغییر آنقدر کوچک باشد که نخواهید شمارنده انتظار را از صفر آغاز کنید.
اگر min_delta=0.001 باشد، چنین تغییری برای ادامهدادن صبر میتواند ناکافی شمرده شود. در مستنداتKeras، min_delta حداقل تغییر مطلق برای محسوبشدن بهعنوان بهبود معرفی شده است. keras.io
یک ظرافت پیادهسازی وجود دارد: میتوان کوچکترین Loss مشاهدهشده را برای ذخیره بهترین مدل نگه داشت، اما شمارنده Patience را فقط هنگام عبور از آستانه min_delta صفر کرد. در کد این مقاله همین دو وظیفه را جدا میکنیم.
کدام معیار را برای توقف پایش کنیم؟
انتخاب معیار باید با هدف مدل هماهنگ باشد:
| مسئله | معیار احتمالی برای پایش | جهت بهبود |
|---|---|---|
| طبقهبندی عمومی | Validation Loss | کاهش |
| طبقهبندی با تأکید بر دقت کلی | Validation Accuracy | افزایش |
| تشخیص موارد نادر | معیار مناسب مسئله، مانند Recall یا PR-AUC | افزایش |
| پیشبینی مقدار عددی | Validation MAE یا Validation Loss | کاهش |
| بازسازی تصویر | Validation Reconstruction Loss | کاهش |
| مدل زبانی | Validation Loss | کاهش |
Validation Loss معمولاً نقطه شروع خوبی است، زیرا تغییرات پیشبینی مدل را حتی زمانی که Accuracyثابت مانده، میتواند نشان دهد. ولی اگر هدف عملی شما یک معیار دیگر است، باید تصمیم نهایی را با همان معیار نیز بررسی کنید.
برای داده نامتوازن، صرفاً توقف بر اساس Accuracy ممکن است انتخاب مناسبی نباشد؛ زیرا Accuracy بالا میتواند عملکرد ضعیف روی کلاس مهمتر را پنهان کند.
آیا باید بهترین وزنها را بازیابی کنیم؟
بله، اگر هدف استفاده از مدلی است که بهترین نتیجه اعتبارسنجی را در طول آموزش داشته است.
مدلی که در لحظه توقف در حافظه قرار دارد، معمولاً مربوط به آخرینEpoch است. اما تصمیم توقف پس از چند Epoch بدون بهبود گرفته شده؛ بنابراین وزنهای آخرین Epoch ممکن است از وزنهای بهترین Epoch ضعیفتر باشند.
در Keras گزینه restore_best_weights این رفتار را کنترل میکند. در PyTorch میتوانیم هنگام بهبود Validation، وزنها را کپی یا روی دیسک ذخیره کنیم و در پایان دوباره بارگذاری کنیم. keras.io
پیادهسازی Early Stopping باPyTorch
در ادامه یک مسئله طبقهبندی دودویی میسازیم: تشخیص کلاس نقاط در داده مصنوعی make_moons. این داده دو شکل درهمرفته دارد و برای نمایش رفتار یک مدل غیرخطی مناسب است.
هدف این مثال، آموزش روش درست تقسیم داده، پایش Validation و بازیابی بهترین مدل است؛ نتیجه آن را نباید بهعنوان پیشبینی عملکرد یک شبکه عصبی در پروژه واقعی در نظر گرفت.
نصب کتابخانهها
pip install torch scikit-learn matplotlibساخت داده Train، Validation وTest
ابتدا Test را جدا میکنیم، سپس بخشی از داده باقیمانده را برای Validation کنار میگذاریم. مقیاسبندی نیز فقط روی Train برازش میشود.
import numpy as np
import torch

from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

from torch.utils.data import (
    DataLoader,
    TensorDataset,
)


SEED = 42
BATCH_SIZE = 64

np.random.seed(SEED)
torch.manual_seed(SEED)

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

X, y = make_moons(
    n_samples=1500,
    noise=0.30,
    random_state=SEED,
)

X = X.astype(np.float32)
y = y.astype(np.float32)

X_train_val, X_test, y_train_val, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.20,
        stratify=y,
        random_state=SEED,
    )
)

X_train, X_val, y_train, y_val = (
    train_test_split(
        X_train_val,
        y_train_val,
        test_size=0.20,
        stratify=y_train_val,
        random_state=SEED,
    )
)

scaler = StandardScaler()

X_train = scaler.fit_transform(
    X_train
).astype(np.float32)

X_val = scaler.transform(
    X_val
).astype(np.float32)

X_test = scaler.transform(
    X_test
).astype(np.float32)


def to_dataset(features, labels):
    return TensorDataset(
        torch.from_numpy(features),
        torch.from_numpy(labels).unsqueeze(1),
    )


train_dataset = to_dataset(
    X_train,
    y_train,
)

val_dataset = to_dataset(
    X_val,
    y_val,
)

test_dataset = to_dataset(
    X_test,
    y_test,
)

train_loader = DataLoader(
    train_dataset,
    batch_size=BATCH_SIZE,
    shuffle=True,
)

val_loader = DataLoader(
    val_dataset,
    batch_size=BATCH_SIZE,
    shuffle=False,
)

test_loader = DataLoader(
    test_dataset,
    batch_size=BATCH_SIZE,
    shuffle=False,
)

print(
    "Train / Validation / Test:",
    len(train_dataset),
    len(val_dataset),
    len(test_dataset),
)

print("Device:", device)
اگر مقیاسبندی را روی کل داده انجام دهید و سپس تقسیم کنید، اطلاعات Validation و Test وارد مرحله آمادهسازی داده آموزش میشود. راهنمای scikit-learn توصیه میکند برای جلوگیری از نشت داده، جداسازی دادههای ارزیابی را پیش از برازش مراحل پیشپردازش انجام دهید. scikit-learn 1.10.dev0 documentation
ساخت شبکه عصبی
مدل دو ویژگی ورودی را میگیرد و یک امتیاز خام برای طبقهبندی دودویی تولید میکند:
from torch import nn


class MoonClassifier(nn.Module):
    def __init__(self):
        super().__init__()

        self.network = nn.Sequential(
            nn.Linear(2, 64),
            nn.ReLU(),

            nn.Linear(64, 64),
            nn.ReLU(),

            nn.Linear(64, 1),
        )

    def forward(self, features):
        return self.network(features)


model = MoonClassifier().to(device)

criterion = nn.BCEWithLogitsLoss()

optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=0.001,
    weight_decay=0.001,
)
از BCEWithLogitsLoss استفاده میکنیم؛ بنابراین در خروجی مدل Sigmoid قرار ندادهایم. هنگام محاسبه کلاس پیشبینیشده، برای این مدل میتوان بررسی کرد که امتیاز خام خروجی بزرگتر از صفر هست یا خیر.
تابع ارزیابی روی Validation وTest
تابع زیر میانگین Loss و Accuracy را برمیگرداند:
def evaluate( model, data_loader, criterion, device,): model.eval() total_loss = 0.0 total_correct = 0 total_samples = 0 with torch.inference_mode(): for features, labels in data_loader: features = features.to(device) labels = labels.to(device) logits = model(features) loss = criterion(logits, labels) batch_size = labels.size(0) total_loss += ( loss.item() * batch_size ) predictions = ( logits > 0 ).float() total_correct += ( predictions == labels ).sum().item() total_samples += batch_sizeفراخوانی model.eval() برای ارزیابی درست مدلهایی که لایههایی مانند Dropout یا Batch Normalization دارند نیز مهم است. آموزش رسمی PyTorch هنگام بارگذاری مدل برای استنتاج بر قرار دادن مدل در حالت ارزیابی تأکید میکند. PyTorch Tutorials 2.14.0+cu130 documentation
ساخت کلاسEarly Stopping
این پیادهسازی دو مقدار را جداگانه نگه میدارد:
best_score: کمترین Validation Loss دیدهشده برای ذخیره بهترین وزنها.patience_reference: مقداری که با آن بهبود معنادار بر اساسmin_deltaسنجیده میشود.
به این ترتیب، یک بهبود عددی کوچک میتواند به ذخیره وزنهای بهتر منجر شود، بیآنکه لزوماً شمارنده Patience را از ابتدا شروع کند.
from copy import deepcopyclass EarlyStopping: def __init__( self, patience=10, min_delta=0.001, ): if patience < 1: raise ValueError( "patience must be at least 1" ) if min_delta < 0: raise ValueError( "min_delta cannot be negative" ) self.patience = patience self.min_delta = min_delta self.best_score = float("inf") self.patience_reference = float("inf") self.best_epoch = None self.best_weights = None self.bad_epochs = 0 self.should_stop = False def update( self, validation_loss, model, epoch,چرا از deepcopy استفاده کردهایم؟ مستندات PyTorch هشدار میدهد که انتساب مستقیم model.state_dict() به یک متغیر، کپی مستقل بهترین وزنها را تضمین نمیکند و تغییرات بعدی مدل میتواند نتیجه موردنظر را از بین ببرد. PyTorch Tutorials 2.14.0+cu130 documentation
حلقه کامل آموزش
حالا مدل را حداکثر ۱۵۰ Epoch آموزش میدهیم. این عدد فقط سقف آموزش است؛ توقف زودهنگام ممکن است زودتر رخ دهد.
MAX_EPOCHS = 150

early_stopping = EarlyStopping(
    patience=12,
    min_delta=0.001,
)

history = []

for epoch in range(
    1,
    MAX_EPOCHS + 1,
):
    model.train()

    train_loss_sum = 0.0
    train_correct = 0
    train_samples = 0

    for features, labels in train_loader:
        features = features.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        logits = model(features)

        loss = criterion(
            logits,
            labels,
        )

        loss.backward()
        optimizer.step()

        batch_size = labels.size(0)

        train_loss_sum += (
            loss.item() * batch_size
        )

        train_correct += (
            (logits > 0).float() == labels
        ).sum().item()

        train_samples += batch_size

    train_loss = (
        train_loss_sum / train_samples
    )

    train_accuracy = (
        train_correct / train_samples
    )

    val_metrics = evaluate(
        model,
        val_loader,
        criterion,
        device,
    )

    early_stopping.update(
        validation_loss=(
            val_metrics["loss"]
        ),
        model=model,
        epoch=epoch,
    )

    history.append(
        {
            "epoch": epoch,
            "train_loss": train_loss,
            "train_accuracy": (
                train_accuracy
            ),
            "val_loss": (
                val_metrics["loss"]
            ),
            "val_accuracy": (
                val_metrics["accuracy"]
            ),
        }
    )

    print(
        f"Epoch {epoch:03d} | "
        f"Train loss: {train_loss:.4f} | "
        f"Validation loss: "
        f"{val_metrics['loss']:.4f} | "
        f"Wait: "
        f"{early_stopping.bad_epochs}"
    )

    if early_stopping.should_stop:
        print(
            "Early stopping triggered"
        )
        break

early_stopping.restore_best(model)

print(
    "Best epoch:",
    early_stopping.best_epoch,
)

print(
    "Best validation loss:",
    round(
        early_stopping.best_score,
        4,
    ),
)
ممکن است در اجرای شما آموزش در Epoch متفاوتی متوقف شود. در این مقاله کد اجرا نشده و عددی بهعنوان نتیجه تجربی گزارش نمیشود.
ترتیب عملیات در هر Epoch چرا مهم است؟
ابتدا مدل را در حالت آموزش قرار میدهیم و وزنها را بهروزرسانی میکنیم. سپس با evaluate عملکرد آن را روی Validation میسنجیم و تصمیم Early Stopping را میگیریم.
مجموعه Test در این مرحله هیچ نقشی ندارد.
رسم نمودار Train Loss وValidation Loss
نمودارها نشان میدهند آیا توقف با رفتار داده همخوانی دارد:
import matplotlib.pyplot as pltepochs = [ row["epoch"] for row in history]train_losses = [ row["train_loss"] for row in history]val_losses = [ row["val_loss"] for row in history]plt.figure(figsize=(10, 5))plt.plot( epochs, train_losses, label="Train loss",)plt.plot( epochs, val_losses, label="Validation loss",)plt.axvline( early_stopping.best_epoch, color="red", linestyle="--",اگر Validation Loss نوسان زیادی دارد، ممکن است لازم باشد patience را افزایش دهید، اندازه مجموعه اعتبارسنجی را بازنگری کنید یا ناپایداری آموزش را بررسی کنید.
ارزیابی نهایی رویTest
اکنون که بهترین وزنها بازیابی شدهاند، میتوانیم یکبار عملکرد نهایی را روی مجموعه Test بسنجیم:
test_metrics = evaluate( model, test_loader, criterion, device,)print( "Test loss:", round( test_metrics["loss"], 4, ),)print( "Test accuracy:", round( test_metrics["accuracy"], 4, ),)اگر نتیجه Test را ببینید و سپس patience، معماری یا نرخ یادگیری را بارها با هدف بهترکردن همان نتیجه تغییر دهید، Test دیگر ارزیابی مستقل نهایی نخواهد بود. راهنمای scikit-learn این خطر را برای تنظیم مدل بر اساس Test توضیح میدهد. scikit-learn 1.9.1 documentation
ذخیره بهترین مدل روی دیسک
در مثال بالا بهترین وزنها در حافظه نگه داشته میشوند. پس از پایان آموزش میتوانید مدل بازیابیشده را ذخیره کنید:
torch.save(
    model.state_dict(),
    "best_moons_model.pth",
)
بارگذاری مجدد برای استنتاج:
loaded_model = MoonClassifier().to(device)

state = torch.load(
    "best_moons_model.pth",
    map_location=device,
    weights_only=True,
)

loaded_model.load_state_dict(state)
loaded_model.eval()
PyTorchذخیره state_dict را روشی انعطافپذیر برای نگهداری وزنهای مدل معرفی میکند. برای استفاده از مدل بعد از بارگذاری نیز باید آن را در حالت eval قرار دهید. PyTorch Tutorials 2.14.0+cu130 documentation
آیا این فایل برای ادامه آموزش کافی است؟
برای استنتاج، وزنهای مدل معمولاً کافیاند. اما برای ادامه دقیق فرایند آموزش، فقط وزنها کافی نیستند: وضعیت بهینهساز، Epoch، وضعیت زمانبند نرخ یادگیری و اطلاعات لازم برای ادامه تصمیم Early Stopping نیز اهمیت دارند.
مستندات رسمی PyTorch توصیه میکند برای Checkpoint مناسب ادامه آموزش، علاوه بر وضعیت مدل، وضعیت بهینهساز و اطلاعات مرتبط آموزش نیز نگه داشته شود. PyTorch Tutorials 2.14.0+cu130 documentation
نمونه ساختار یک Checkpoint برای ادامه آموزش:
torch.save(
    {
        "epoch": epoch,
        "model_state_dict": (
            model.state_dict()
        ),
        "optimizer_state_dict": (
            optimizer.state_dict()
        ),
        "early_stopping_best_score": (
            early_stopping.best_score
        ),
        "early_stopping_reference": (
            early_stopping.patience_reference
        ),
        "early_stopping_bad_epochs": (
            early_stopping.bad_epochs
        ),
        "early_stopping_best_epoch": (
            early_stopping.best_epoch
        ),
    },
    "training_checkpoint.pth",
)
این مثال فقط ساختار دادههای لازم را نشان میدهد. اگر میخواهید پس از قطعشدن برنامه با همان منطق توقف ادامه دهید، باید بهترین وزنهای ذخیرهشده، وضعیت شمارنده، نسخه پیشپردازش و در صورت استفاده، وضعیت زمانبند را نیز بهدرستی مدیریت کنید. Checkpoint مربوط به «آخرین وضعیت آموزش» و فایل مربوط به «بهترین مدل برای استنتاج» میتوانند دو فایل جدا باشند.
تفاوت Early Stopping وModel Checkpoint
این دو مفهوم با هم مرتبطاند، اما نقش یکسانی ندارند:
| مفهوم | پرسشی که پاسخ میدهد |
|---|---|
| Early Stopping | چه زمانی آموزش را متوقف کنیم؟ |
| Best Model Checkpoint | وزنهای کدام Epoch را نگه داریم؟ |
| Resume Checkpoint | چگونه آموزش قطعشده را از وضعیت قبلی ادامه دهیم؟ |
در یک پروژه عملی معمولاً Early Stopping را با ذخیره بهترین مدل ترکیب میکنند. اگر آموزش طولانی یا حساس به قطعشدن است، Checkpoint مربوط به ادامه آموزش را هم اضافه میکنند.
تفاوت Early Stopping و کاهش نرخ یادگیری
Early Stopping آموزش را پایان میدهد. در مقابل، یک Learning Rate Scheduler میتواند نرخ یادگیری را تغییر دهد و به مدل فرصت دهد با گامهای کوچکتر به آموزش ادامه دهد.
برای مثال، ReduceLROnPlateau در PyTorch پس از توقف بهبود یک معیار، نرخ یادگیری را کاهش میدهد. در نمونه استفاده رسمی، مقدار Validation Loss به scheduler.step(val_loss) داده میشود. PyTorch 2.14 documentation
ترکیب این دو میتواند چنین باشد:
- Validation Loss برای چند Epochبهبود کافی ندارد.
- زمانبند نرخ یادگیری را کاهش میدهد.
- چند Epoch دیگر به مدل فرصت داده میشود.
- اگر باز هم بهبود کافی رخ ندهد، Early Stopping آموزش را قطع میکند.
نمونه افزودن زمانبند به کد بالا:
scheduler = (
    torch.optim.lr_scheduler.ReduceLROnPlateau(
        optimizer,
        mode="min",
        factor=0.5,
        patience=3,
        min_lr=1e-5,
    )
)
پس از محاسبه val_metrics در هرEpoch:
scheduler.step(
    val_metrics["loss"]
)

early_stopping.update(
    validation_loss=(
        val_metrics["loss"]
    ),
    model=model,
    epoch=epoch,
)
در این نمونه، Patience زمانبند را کمتر از Patience توقف زودهنگام گذاشتهایم تا مدل پس از کاهش نرخ یادگیری فرصت ادامه آموزش داشته باشد. این صرفاً یک پیکربندی اولیه برای آزمایش است. معیارهای «بهبود» در این دو ابزار نیز باید آگاهانه تنظیم شوند؛ انتظار نداشته باشید فقط با یکسانبودن عدد Patience، دقیقاً در یک زمان واکنش نشان دهند.
Early Stopping در Keras
اگر با Keras کار میکنید، این قابلیت بهصورت Callback آماده است:
import keras


early_stopping = (
    keras.callbacks.EarlyStopping(
        monitor="val_loss",
        mode="min",
        patience=10,
        min_delta=0.001,
        restore_best_weights=True,
    )
)

history = model.fit(
    X_train,
    y_train,
    validation_data=(
        X_val,
        y_val,
    ),
    epochs=150,
    callbacks=[
        early_stopping
    ],
)
این قطعهکد فرض میکند مدل Keras از قبل ساخته و compile شده است. Keras همچنین گزینه start_from_epoch را برای تأخیر در شروع پایش معرفی میکند؛ این گزینه میتواند وقتی در Epochهای ابتدایی انتظار بهبود پایدار ندارید، مفید باشد. keras.io
آیا همیشه باید Validation Loss را پایش کرد؟
خیر. معیار توقف باید با هدف مدل و هزینه خطاها هماهنگ باشد.
برای مثال:
- اگر در تشخیص یک رویداد نادر، ازدستدادن نمونه مثبت پرهزینه است، Recall را نیز بررسی کنید.
- اگر تعداد هشدارهای اشتباه مهم است، Precision یا معیار مناسبتر مسئله را بررسی کنید.
- اگر مسئله پیشبینی عددی است، MAE ممکن است برای کاربران محصول قابلفهمتر از یک Loss آموزشی باشد.
- اگر خروجی مدل باید از نظر انسانی بررسی شود، ارزیابی کیفی نمونهها را کنار معیار عددی قرار دهید.
بااینحال، معیارهای بعضی مسائل روی مجموعه Validation کوچک نوسان زیادی دارند. در چنین شرایطی، تغییر معیار توقف بدون توجه به اندازه نمونهها ممکن است به تصمیمهای ناپایدار منجر شود.
انتخاب Patience و Min Delta در عمل
برای شروع، به رفتار منحنی Validation نگاه کنید و سپس تنظیمات را تعیین کنید.
اگر Validation Loss آرام و پیوسته کاهش مییابد
یک patience متوسط ممکن است کافی باشد. min_delta را آنقدر بزرگ نگذارید که پیشرفتهای واقعی، بیاثر شمرده شوند.
اگر Validation Loss شدیداً نوسان دارد
ممکن است به patience بیشتر نیاز داشته باشید. همچنین بررسی کنید:
- مجموعه Validation خیلی کوچک نباشد.
- نرخ یادگیری بیشازحد زیاد نباشد.
- روش تقسیم داده با مسئله واقعی هماهنگ باشد.
- معیار انتخابشده ذاتاً نوسان زیادی نداشته باشد.
اگر آموزش بسیار پرهزینه است
علاوه بر Early Stopping، برای Checkpoint و بازیابی پس از قطعشدن آموزش برنامهریزی کنید. توقف زودهنگام زمان اضافه را کاهش میدهد، اما جایگزین نگهداری وضعیت آموزش نیست.
اگر داده در طول زمان تغییر میکند
برای داده زمانی، تقسیم تصادفی ممکن است تصویر غیرواقعی از آینده بسازد. در چنین مسئلهای مجموعه Validation باید از نظر زمانی و عملیاتی نماینده شرایطی باشد که مدل بعداً با آن روبهرو میشود.
اشتباهات رایج درEarly Stopping
پایش فقطTrain Loss
پایینآمدن Train Loss لزوماً نشانه بهترشدن عملکرد مدل روی داده جدید نیست. برای تصمیم توقف، معمولاً باید یک معیار مستقل از بهروزرسانی وزنها را پایش کنید.
بازیابینکردن بهترین وزنها
اگر پس از توقف از وزنهای آخرین Epoch استفاده کنید، ممکن است بهترین مدل مشاهدهشده در طول آموزش را کنار گذاشته باشید.
نگهداشتن state_dict بدون کپی
برای ذخیره بهترین وزنها در حافظه از کپی مستقل استفاده کنید یا همان لحظه آنها را روی دیسک بنویسید. PyTorch درباره اتکا به انتساب مستقیم model.state_dict() هشدار میدهد. PyTorch Tutorials 2.14.0+cu130 documentation
تعیین Patience بسیار کوچک
یک یا دو Epoch ضعیف ممکن است فقط نوسان طبیعی معیار باشد. توقف سریع میتواند فرصت ادامه بهبود را از مدل بگیرد.
تعیین Min Delta بدون توجه به مقیاس معیار
0.001 برای همه Lossها و معیارها معنای یکسانی ندارد. مقدار آن را متناسب با مقیاس و نوسان معیار انتخاب کنید.
استفاده از داده Test برای توقف
اگر در هر Epoch روی Test تصمیم میگیرید، دیگر Test یک مجموعه مستقل برای ارزیابی نهایی نیست.
فرض اینکه توقف زودهنگام مشکل داده را حل میکند
برچسبهای اشتباه، نشت داده، تغییر توزیع نمونهها و Validation نامناسب با Early Stopping برطرف نمیشوند.
ترکیب زمانبند و توقف با فرصت ناکافی
اگر زمانبند تازه نرخ یادگیری را کم کرده اما Early Stopping بلافاصله آموزش را متوقف کند، مدل فرصتی برای استفاده از نرخ جدید نداشته است.
چگونه پیادهسازی را برای پروژه واقعی بهتر کنیم؟
معیار توقف را از قبل مشخص کنید
قبل از مشاهده نتیجه Test تعیین کنید چه معیاری برای انتخاب مدل اهمیت دارد. این کار تصمیمگیری را قابلردیابیتر میکند.
بهترین Epoch و تنظیمات را ثبت کنید
همراه مدل، اطلاعات زیر را نگه دارید:
- بهترینEpoch
- مقدار معیارValidation
- مقدار
patienceوmin_delta - معماری و نسخه مدل
- نسخه داده و روش تقسیم آن
- تنظیمات پیشپردازش
- بهینهساز و نرخ یادگیری
- بذر تصادفی
- نسخه کتابخانهها
از چند اجرا استفاده کنید
اگر تفاوت دو تنظیم کوچک است، آزمایش را با بذرهای متفاوت تکرار کنید. یک تقسیم تصادفی یا یک اجرای آموزشی ممکن است برای نتیجهگیری کافی نباشد.
عملکرد را روی گروههای مهم جداگانه بررسی کنید
بهترین Validation Loss کلی ممکن است عملکرد ضعیف روی یک گروه مهم از داده را پنهان کند. در پروژه واقعی، معیارها را بر اساس گروههای مرتبط با کاربرد نیز بررسی کنید.
داده اعتبارسنجی را نماینده شرایط واقعی انتخاب کنید
اگر قرار است مدل روی داده ماه آینده یا یک دستگاه جدید اجرا شود، Validation باید تا حد امکان همان شرایط را شبیهسازی کند. انتخاب تصادفی نمونهها همیشه این هدف را برآورده نمیکند.
پرسشهای متداول
Early Stoppingچیست؟
روشی برای توقف آموزش مدل است که بر اساس متوقفشدن بهبود یک معیار، معمولاً روی داده اعتبارسنجی، تصمیم میگیرد.
آیا Early Stopping همان جلوگیری از Overfitting است؟
میتواند به کاهش بیشبرازش کمک کند، اما همه علتهای آن را برطرف نمیکند. کیفیت داده، اندازه مدل و روش ارزیابی نیز اهمیت دارند.
Patience در Early Stoppingچیست؟
تعداد دفعات ارزیابی بدون بهبود کافی است که پیش از توقف آموزش تحمل میکنیم.
Min Deltaچیست؟
حداقل تغییر لازم در معیار پایششده است تا آن تغییر، بهبود کافی محسوب شود.
آیا باید آخرین Epoch را ذخیره کنیم یا بهترین Epoch را؟
اگر هدف استفاده از بهترین مدل بر اساس Validation است، وزنهای بهترین Epoch را ذخیره و پس از پایان آموزش بازیابی کنید. برای ادامه آموزش قطعشده، وضعیت آخرین Epoch را نیز در Checkpoint جداگانه نگه دارید.
آیا Early Stopping برای همه مدلها مناسب است؟
برای بسیاری از فرایندهای آموزش تکراری مفید است، اما معیار پایش، شیوه تقسیم داده و تعداد دفعات ارزیابی باید با مسئله هماهنگ باشند.
آیا میتوان Early Stopping را با AdamW استفاده کرد؟
بله. Early Stopping درباره زمان پایان آموزش تصمیم میگیرد و AdamW وزنها را در هر گام آموزش بهروزرسانی میکند.
آیا میتوان Early Stopping را با Dropout ترکیب کرد؟
بله. Dropout روی رفتار شبکه هنگام آموزش اثر دارد و Early Stopping روند عملکرد Validation را برای تصمیم توقف بررسی میکند.
چرا مدل قبل از پایان تعداد Epoch تعیینشده متوقف شد؟
چون تعداد Epoch در این روش سقف آموزش است. اگر معیار Validation به مدت patience بهبود کافی نداشته باشد، آموزش زودتر پایان مییابد.
چرا بهترین Epoch با Epoch توقف یکسان نیست؟
توقف زمانی اتفاق میافتد که مدتی از آخرین بهبود کافی گذشته باشد. بنابراین بهترین وزنها معمولاً متعلق به یکی از Epochهای قبلیاند.
جمعبندی
Early Stoppingکمک میکند پایان آموزش را بر اساس رفتار مدل روی داده اعتبارسنجی تعیین کنید. دو تنظیم اصلی آن Patience، یعنی مدت صبر بدون بهبود کافی، و Min Delta، یعنی حداقل بهبود موردانتظار، هستند.
برای پیادهسازی درست، Train، Validation و Test را جدا نگه دارید؛ پس از هر Epoch معیار Validation را محاسبه کنید؛ بهترین وزنها را مستقل ذخیره کنید؛ و پس از توقف، همان وزنها را برای ارزیابی نهایی بازیابی کنید. اگر از زمانبند کاهش نرخ یادگیری نیز استفاده میکنید، به مدل فرصت دهید پس از کاهش نرخ یادگیری بهبود احتمالی خود را نشان دهد.
در پروژه واقعی، نتیجه توقف زودهنگام فقط به کد وابسته نیست. کیفیت تقسیم داده، معیار انتخاب مدل و شباهت Validation به شرایط استفاده واقعی تعیین میکند این تصمیم چقدر قابلاعتماد باشد.
از آموزش مدل تا استفاده در محصول با درواره
اگر در کنار آموزش مدل اختصاصی، میخواهید قابلیتهای آماده هوش مصنوعی را هم به محصول خود اضافه کنید، میتوانید مدلها و خدمات API درواره را بررسی کنید. درواره دسترسی یکپارچه به مدلهای هوش مصنوعی را برای توسعهدهندگان ارائه میکند؛ برای انتخاب عملی، مدلهای موجود و شرایط هر سرویس را در سایت بررسی کنید. hub.darvareh.ir
برای بررسی خدمات و شروع اتصال محصولتان، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- بیشبرازش و کمبرازش در یادگیری ماشین
- Dropout چیست؟ آموزش کاهش بیشبرازش با PyTorch
- Adam چیست؟ مقایسه AdamW و SGD با PyTorch
- گرادیان کاهشی در یادگیری ماشین
- PyTorchچیست؟
- یادگیری انتقالی و Fine-tuning باPyTorch
- آموزش استفاده از API هوش مصنوعی
منابع
- Keras: مستندات رسمی EarlyStopping
- PyTorch:راهنمای رسمی ذخیره و بارگذاری مدل
- PyTorch: مستندات رسمی ReduceLROnPlateau
- scikit-learn: نمونه رسمی Early Stopping
- scikit-learn:راهنمای ارزیابی و اعتبارسنجی مدل
- scikit-learn:خطاهای رایج و نشت داده
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و صفحه سلب مسئولیت درواره را نیز مطالعه کنید.



