
Dropout چیست؟ آموزش کاهش بیشبرازش شبکه عصبی با PyTorch
Dropout چیست و چگونه به کاهش بیشبرازش شبکه عصبی کمک میکند؟ در این راهنما، رفتار آن در آموزش و پیشبینی، انتخاب نرخ مناسب، تفاوت با BatchNorm و آزمایش عملی چند نرخ Dropout با PyTorchرا میآموزید.

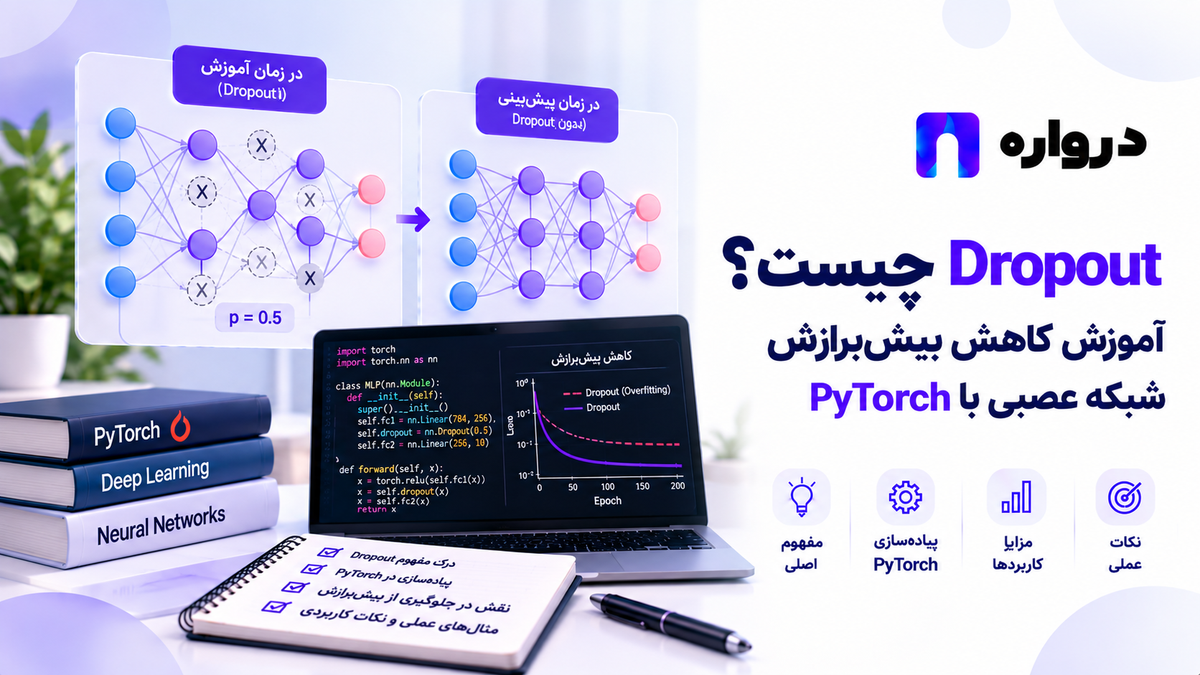
Dropout روشی برای تنظیم آموزش شبکه عصبی است که هنگام هر عبور رو به جلو در حالت آموزش، بخشی از خروجی واحدها را بهصورت تصادفی صفر میکند. هدف این است که شبکه بیشازحد به حضور همیشگی چند واحد یا یک مسیر مشخص متکی نشود.
فرض کنید یک شبکه بزرگ، داده آموزشی را بسیار خوب یاد گرفته است، اما روی نمونههای تازه خطاهای زیادی دارد. این وضعیت میتواند نشانه بیشبرازش باشد. Dropout یکی از روشهایی است که ارزش آزمایش برای بهبود تعمیم مدل را دارد؛ البته نه برای هر مدل و نه با هر نرخی.
مقاله اصلی Dropout این ایده را با غیرفعال کردن تصادفی واحدها و ارتباطهایشان هنگام آموزش توضیح میدهد و نتایج آن را در چند مسئله یادگیری نظارتشده بررسی میکند. این نتایج دلیل استفاده گسترده از روش هستند، اما به معنی بهبود تضمینی روی داده و معماری شما نیستند. jmlr.org
در این راهنما، سازوکار Dropout، تفاوت آن با Batch Normalization و Weight Decay، انتخاب نرخ مناسب و خطاهای رایج پیادهسازی را بررسی میکنیم. سپس با PyTorch سه مدل یکسان را با نرخهای متفاوت آموزش میدهیم و نتیجه را بهدرستی ارزیابی میکنیم.
Dropoutچیست؟
در PyTorch، لایه Dropout هنگام آموزش، بعضی مقدارهای ورودی خود را بهطور تصادفی صفر میکند. احتمال صفر شدن هر مقدار با پارامتر p تعیین میشود.
برای مثال:
from torch import nndropout = nn.Dropout(p=0.2)در اینجا p=0.2 یعنی هر مقدار در عبورهای رو به جلو هنگام آموزش، با احتمال ۲۰ درصد صفر میشود. این عبارت به معنی آن نیست که «۲۰ درصد نورونهای مدل برای همیشه حذف میشوند»؛ انتخاب تصادفی در عبورهای بعدی دوباره انجام میشود.
مستندات PyTorch توضیح میدهد که مقدارهای صفرشده برای هر عبور رو به جلو بهطور مستقل انتخاب میشوند و این لایه در حالت ارزیابی مانند یک تبدیل بدون تغییر عمل میکند. PyTorch main documentation
یک شبکه ساده با Dropout میتواند چنین باشد:
from torch import nnmodel = nn.Sequential( nn.Linear(64, 128), nn.ReLU(), nn.Dropout(p=0.2), nn.Linear(128, 64), nn.ReLU(), nn.Dropout(p=0.2), nn.Linear(64, 10),)در این مثال، Dropout روی خروجی لایههای پنهان اعمال میشود. لایه نهایی همچنان برای هر یک از ۱۰ کلاس، یک خروجی خام تولید میکند.
چرا Dropout به کاهش بیشبرازش کمک میکند؟
وقتی شبکه ظرفیت زیادی نسبت به داده موجود دارد، ممکن است به الگوهای تصادفی یا جزئیات خاص مجموعه آموزش وابسته شود. Dropout هنگام آموزش هر بار بخشی از مسیرهای انتقال اطلاعات را موقتاً غیرفعال میکند.
در نتیجه، واحدهای فعال شبکه ناچارند بدون اتکا به حضور همیشگی همان واحدهای دیگر نیز کار کنند. مقاله اصلی این رفتار را در ارتباط با کاهش وابستگی بیشازحد میان واحدها توضیح میدهد. jmlr.org
بااینحال، این یک توضیح شهودی برای اثر روش است؛ نتیجه نهایی باید روی داده اعتبارسنجی و آزمون مستقل سنجیده شود. اگر مدل شما از ابتدا کمبرازش دارد، افزودن Dropout یا زیاد کردن نرخ آن ممکن است یادگیری را دشوارتر کند.
Dropoutدر آموزش و پیشبینی چه تفاوتی دارد؟
این تفاوت از مهمترین نکات پیادهسازی است.
هنگام آموزش
وقتی مدل در حالت train() است، Dropout فعال میشود. برای هر عبور رو به جلو، بخشی از مقدارها بهطور تصادفی صفر میشوند:
model.train()هنگام ارزیابی و پیشبینی
وقتی مدل در حالت eval() است، Dropout معمولی PyTorch دیگر مقدارها را بهطور تصادفی صفر نمیکند:
model.eval()با تنظیمات پیشفرض PyTorch، مقدارهای باقیمانده هنگام آموزش به شکلی مقیاسبندی میشوند که در مرحله ارزیابی نیازی به مقیاسبندی جداگانه خروجی Dropout نباشد. به این روش معمولاً Inverted Dropout گفته میشود. مستندات PyTorch رفتار آموزش و ارزیابی را صریحاً شرح میدهد. PyTorch main documentation
آیا torch.inference_mode() جای model.eval() را میگیرد؟
خیر. این دو دستور کار متفاوتی دارند:
model.eval()رفتار لایههایی مانند Dropout و BatchNorm را برای ارزیابی تنظیم میکند.torch.inference_mode()محاسبات لازم برای گرادیانگیری را در مرحله پیشبینی غیرفعال میکند.
برای پیشبینی معمولی هر دو را استفاده کنید:
model.eval()

with torch.inference_mode():
    logits = model(features)
مستندات PyTorch هشدار میدهد که اگر مدل دارای Dropout یا BatchNorm باشد، مسئولیت تغییر حالت آموزش و ارزیابی با برنامهنویس است. PyTorch 2.14 documentation
یک مثال کوچک برای دیدن رفتارDropout
کد زیر تفاوت حالت آموزش و ارزیابی را بدون نیاز به آموزش مدل نشان میدهد:
import torch

from torch import nn


torch.manual_seed(42)

layer = nn.Dropout(
    p=0.5
)

values = torch.ones(
    4,
    8,
)

layer.train()

first_train_output = layer(
    values
)

second_train_output = layer(
    values
)

layer.eval()

evaluation_output = layer(
    values
)

print("Train, first call:")
print(first_train_output)

print("Train, second call:")
print(second_train_output)

print("Evaluation:")
print(evaluation_output)
در دو فراخوانی حالت آموزش، الگوی صفر شدن مقدارها معمولاً یکسان نیست. مقدارهای باقیمانده نیز طبق رفتار PyTorch مقیاسبندی میشوند. در حالت ارزیابی، این لایه ورودی را بدون تغییر ناشی از Dropout عبور میدهد.
توجه: چون فرایند تصادفی است، نباید برای هر عبور انتظار داشت دقیقاً نیمی از خانههای این آرایه کوچک صفر شوند؛ p=0.5 احتمال صفر شدن هر مقدار است.
پارامتر p در Dropout دقیقاً چیست؟
پارامتر p احتمال حذف موقت هر مقدار هنگام آموزش است؛ احتمال نگه داشتن آن نیست.
مقدار p | تفسیر |
|---|---|
0.0 | هیچ مقداری با Dropout حذف نمیشود |
0.1 | احتمال حذف هر مقدار ۱۰ درصد است |
0.2 | احتمال حذف هر مقدار ۲۰ درصد است |
0.5 | احتمال حذف هر مقدار ۵۰ درصد است |
مقدار پیشفرض nn.Dropout در مستندات PyTorch برابر 0.5 است. پیشفرض بودن به معنی مناسب بودن برای هر شبکه نیست. نرخ را با داده اعتبارسنجی انتخاب کنید. PyTorch main documentation
آیا Dropout بیشتر همیشه بهتر است؟
خیر. نرخ بسیار بالا ممکن است مقدار زیادی از اطلاعات مسیر آموزش را در هر گام حذف کند و مدل را به کمبرازش برساند. نرخ بسیار پایین نیز ممکن است اثر قابلمشاهدهای بر مشکل بیشبرازش نداشته باشد.
یک روند عملی، مقایسه چند نرخ محدود مانند صفر، 0.1، 0.2 و در صورت نیاز مقادیر دیگر، روی تقسیم داده و معماری یکسان است. مقدار نهایی را بر اساس معیار کاربرد واقعی انتخاب کنید.
Dropoutچه تفاوتی با حذف دائمی نورون دارد؟
Dropoutهنگام آموزش بهطور موقت و تصادفی بخشی از مقدارها را صفر میکند. وزنهای لایه و ساختار شبکه همچنان وجود دارند. هنگام ارزیابی معمولی، کل ساختار مدل بدون صفرسازی تصادفی Dropout استفاده میشود.
در مقابل، Pruning یا هرس مدل به حذف یا محدود کردن بخشهایی از ساختار یا وزنها برای ساخت مدل کوچکتر اشاره میکند. Dropout بهخودیخود فایل مدل یا تعداد پارامترهای آن را به همان روش کوچک نمیکند.
تفاوت Dropout وBatch Normalization
Dropout و BatchNormهر دو در حالت آموزش و ارزیابی رفتار متفاوت دارند، اما هدف و سازوکار آنها یکسان نیست.
| ویژگی | Dropout | BatchNorm |
|---|---|---|
| عمل اصلی | صفر کردن تصادفی بخشی از مقدارها در آموزش | نرمالسازی مقادیر میانی |
| وابستگی به آمار Batch | ندارد | در حالت آموزش پیشفرض دارد |
رفتار معمول در eval() | عبور بدون صفرسازی تصادفی | استفاده از آمار ذخیرهشده |
| نقش رایج | روشی برای تنظیم آموزش و مقابله با بیشبرازش | کمک به رفتار آموزش در برخی معماریها |
| جایگزین مستقیم دیگری است؟ | خیر | خیر |
میتوان هر دو را در یک مدل داشت، اما افزودن بیبرنامه آنها لزوماً مفید نیست. ترتیب لایهها، نرخ Dropout و اثر آن بر کیفیت را باید آزمایش کرد. برای جزئیات، مقاله Batch Normalizationچیست؟ را ببینید.
تفاوت Dropout وWeight Decay
Weight Decay و Dropout هر دو میتوانند در تنظیم آموزش به کار روند، اما از مسیرهای متفاوتی عمل میکنند:
- Dropoutدر عبورهای رو به جلو، بعضی مقدارها را موقتاً صفر میکند.
- Weight Decayبر روند تنظیم وزنهای قابلآموزش اثر میگذارد.
این دو را میتوان جداگانه یا همراه هم آزمایش کرد. اگر همزمان هر دو را به مقدار زیاد اعمال کنید، ممکن است مدل توان یادگیری کافی نداشته باشد. نتیجه را با داده اعتبارسنجی بسنجید و از تغییر همزمان چند تنظیم بدون ثبت آزمایش پرهیز کنید.
تفاوت Dropout وEarly Stopping
توقف زودهنگام یا Early Stopping آموزش را زمانی متوقف میکند که معیار اعتبارسنجی پس از مدتی بهتر نشود. Dropout در طول گامهای آموزش، مسیرهای فعال شبکه را بهصورت تصادفی تغییر میدهد.
| روش | در کدام بخش عمل میکند؟ |
|---|---|
| Dropout | داخل عبور رو به جلو هنگام آموزش |
| Early Stopping | تصمیم درباره زمان پایان آموزش |
| Weight Decay | فرایند بهروزرسانی پارامترها |
| کوچکتر کردن مدل | ظرفیت معماری |
هیچکدام جایگزین داده معتبر و تقسیم درست Train، Validation و Test نمیشوند.
Dropout معمولی و Dropout2dچه تفاوتی دارند؟
nn.Dropout مقدارهای ورودی خود را بهطور تصادفی صفر میکند. برای خروجی یک لایه کاملاً متصل، این رفتار قابلفهم است.
در داده تصویری، مقدارهای نزدیک به هم در یک نقشه ویژگی ممکن است ارتباط زیادی داشته باشند. nn.Dropout2d بهجای صفر کردن پراکنده مقدارها، کل یک کانال یا نقشه ویژگی را برای یک نمونه در یک عبور صفر میکند. مستندات PyTorch این رفتار و دلیل استفاده از آن در برخی شبکههای کانولوشنی را توضیح میدهد. PyTorch main documentation
نمونه:
from torch import nn

block = nn.Sequential(
    nn.Conv2d(
        16,
        32,
        kernel_size=3,
        padding=1,
    ),
    nn.ReLU(),
    nn.Dropout2d(p=0.1),
)
این انتخاب برای هر CNN ضروری نیست. جای لایه و نرخ مناسب آن را با آزمایش تعیین کنید.
شکل ورودی Dropout2d
برای جلوگیری از ابهام، در مثالهای تصویری ورودی را با شکل تعداد نمونه، کانال، ارتفاع، عرض آماده کنید. مستندات PyTorch درباره رفتار تاریخی این ماژول برای بعضی ورودیهای سهبعدی نیز هشدار میدهد؛ بنابراین اگر داده شما بُعد Batch ندارد، فرض نکنید رفتار آن دقیقاً مانند ورودی چهاربعدی است. PyTorch main documentation
AlphaDropoutچیست؟
AlphaDropout گونهای از Dropout است که برای معماریهای مبتنی بر فعالساز SELU طراحی شده تا ویژگی خودنرمالساز آن معماری بهتر حفظ شود.
برای یک شبکه معمولی دارای ReLU، نباید صرفاً به دلیل اسم مشابه، AlphaDropout را جای Dropout قرار داد. انتخاب آن به طراحی کل معماری مربوط است. مستندات رسمی PyTorch این پیوند با SELU را توضیح میدهد. PyTorch 2.14 documentation
آیا Dropout فقط برای شبکههای کاملاً متصل است؟
خیر. شکلهای مختلفی از Dropout در مدلهای تصویری، ترتیبی و معماریهای دیگر به کار رفتهاند. اما نوع Dropout، محل اعمال و نرخ آن ممکن است متفاوت باشد.
برای نمونه، در یک MLP ممکن است پس از تابع فعالسازی لایه پنهان از nn.Dropout استفاده شود. در بعضی CNNها، nn.Dropout2d برای نقشههای ویژگی آزمایش میشود. در مدلهای ترتیبی نیز تنظیم dropout در یک لایه آماده ممکن است معنای ویژهای داشته باشد؛ بنابراین پیش از استفاده باید مستندات همان لایه را خواند.
آیا Dropout در مدلهای از پیشآموزشدیده هم مفید است؟
گاهی میتواند بخشی از معماری موجود یا روش تنظیم مدل باشد، اما افزودن خودسرانه Dropout به مدل از پیشآموزشدیده تضمین بهبود نیست. شما رفتار مدلی را تغییر میدهید که با معماری و داده مشخصی آموزش دیده است.
در فاینتیونینگ، این پرسشها را بررسی کنید:
- آیا مدل از قبل Dropout دارد؟
- نرخ آن در معماری موجود چقدر است؟
- داده جدید نسبت به داده پیشآموزش چه تفاوتی دارد؟
- کدام بخشهای مدل قابلآموزش هستند؟
- آیا اضافه یا تغییر کردن Dropout، معیار Validation را بهبود میدهد؟
- آیا نتیجه در چند اجرای مستقل پایدار است؟
آموزش عملی: مقایسه چند نرخ Dropout باPyTorch
در این آزمایش از مجموعهداده Digits در scikit-learn استفاده میکنیم. هر نمونه یک تصویر ۸ در ۸ پیکسلی از یک رقم است. هدف، طبقهبندی تصویر در یکی از ۱۰ کلاس است.
سه شبکه با معماری مشابه میسازیم:
- بدونDropout
- با
p=0.2 - با
p=0.5
تمام مدلها روی یک تقسیم داده آموزش میبینند. بهترین گزینه با Validation انتخاب میشود و تنها پس از انتخاب، روی Test گزارش میشود. دیتاست Digits در مستندات scikit-learn بهعنوان مجموعهای از تصاویر رقم ۸ در ۸ معرفی شده است. scikit-learn 1.3.2 documentation
هدف این آزمایش، یادگیری روش سنجش است؛ قرار نیست یکی از نرخها از پیش برنده اعلام شود.
نصب ابزارها
python -m pip install torch scikit-learn numpy matplotlibمرحله اول: آمادهسازی داده
import numpy as np
import torch
from sklearn.datasets import load_digits
from sklearn.model_selection import (
train_test_split,
)
SEED = 42
np.random.seed(SEED)
torch.manual_seed(SEED)
digits = load_digits()
# هر تصویر 8 در 8 پیکسل دارد.
X = digits.images.astype(
np.float32
)
# مقادیر پیکسل در Digits از صفر تا 16 است.
X = X / 16.0
# تبدیل هر تصویر به 64 ویژگی برای MLP.
X = X.reshape(
len(X),
64,
)
y = digits.target.astype(
np.int64
)
# مجموعه Test کنار گذاشته میشود.
X_dev, X_test, y_dev, y_test = (
train_test_split(
X,
y,
test_size=0.20,
stratify=y,
random_state=SEED,
)
)
# داده باقیمانده برای Train و Validation.
X_train, X_val, y_train, y_val = (
train_test_split(
X_dev,
y_dev,
test_size=0.25,
stratify=y_dev,
random_state=SEED,
)
)
print("Train:", len(X_train))
print("Validation:", len(X_val))
print("Test:", len(X_test))در این مثال، تقسیم تقریبی کل داده ۶۰ درصد آموزش، ۲۰ درصد اعتبارسنجی و ۲۰ درصد آزمون است. چون مجموعه نسبتاً کوچک است، نتیجه یک تقسیم منفرد ممکن است با تقسیم دیگر تغییر کند؛ برای مقایسه پژوهشی دقیقتر، آزمایش تکراری لازم است.
مرحله دوم: ساختDataLoader
from torch.utils.data import (
    DataLoader,
    TensorDataset,
)


train_dataset = TensorDataset(
    torch.from_numpy(X_train),
    torch.from_numpy(y_train),
)

device = torch.device(
    "cuda" if torch.cuda.is_available()
    else "cpu"
)

X_val_tensor = torch.from_numpy(
    X_val
).to(device)

y_val_tensor = torch.from_numpy(
    y_val
).to(device)
مرحله سوم: تعریف مدل با نرخ Dropout قابلتغییر
from torch import nn


class DigitMLP(nn.Module):
    def __init__(
        self,
        dropout_rate: float,
    ):
        super().__init__()

        self.network = nn.Sequential(
            nn.Linear(64, 128),
            nn.ReLU(),
            nn.Dropout(
                p=dropout_rate
            ),

            nn.Linear(128, 64),
            nn.ReLU(),
            nn.Dropout(
                p=dropout_rate
            ),

            nn.Linear(64, 10),
        )

    def forward(
        self,
        features,
    ):
        return self.network(
            features
        )
وقتی dropout_rate=0.0 باشد، ساختار کلی مدل حفظ میشود، اما هیچ مقداری از سوی Dropout حذف نمیشود. خروجی لایه آخر logitsخام است. برای آموزش طبقهبندی چندکلاسه با CrossEntropyLoss، نیازی نیست پیش از تابع خطا Softmax را به مدل اضافه کنیم.
مرحله چهارم: تعریف تابع آموزش
import copy
def train_one_model(
dropout_rate: float,
max_epochs: int = 120,
patience: int = 15,
):
# شروع کنترلشده برای هر آزمایش.
torch.manual_seed(SEED)
model = DigitMLP(
dropout_rate=dropout_rate
).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(
model.parameters(),
lr=0.001,
weight_decay=0.0001,
)
loader_generator = (
torch.Generator()
)
loader_generator.manual_seed(
SEED
)
train_loader = DataLoader(
train_dataset,
batch_size=64,
shuffle=True,
generator=loader_generator,
)
train_losses = []
val_losses = []
best_val_loss = float("inf")
best_state = None
waiting = 0
for epoch in range(max_epochs):
# Dropout در این حالت فعال است.
model.train()
total_loss = 0.0
total_samples = 0
for features, labels in train_loader:
features = features.to(device)
labels = labels.to(device)
optimizer.zero_grad()
logits = model(
features
)
loss = criterion(
logits,
labels,
)
loss.backward()
optimizer.step()
batch_size = (
features.size(0)
)
total_loss += (
loss.item()
* batch_size
)
total_samples += batch_size
train_loss = (
total_loss
/ total_samples
)
# Dropout برای اعتبارسنجی معمول
# غیرفعال میشود.
model.eval()
with torch.inference_mode():
val_logits = model(
X_val_tensor
)
val_loss = criterion(
val_logits,
y_val_tensor,
).item()
train_losses.append(
train_loss
)
val_losses.append(
val_loss
)
if val_loss < (
best_val_loss - 1e-5
):
best_val_loss = (
val_loss
)
best_state = copy.deepcopy(
model.state_dict()
)
waiting = 0
else:
waiting += 1
if waiting >= patience:
break
model.load_state_dict(
best_state
)
model.eval()
return {
"model": model,
"dropout_rate": dropout_rate,
"train_losses": train_losses,
"val_losses": val_losses,
"best_val_loss": best_val_loss,
"epochs": len(train_losses),
}در این حلقه، مدل هنگام آموزش در حالت train() و هنگام اعتبارسنجی در حالت eval() است. اگر این تغییر را انجام ندهید، نتیجه Validation تحت تأثیر صفرسازی تصادفی Dropout قرار میگیرد. PyTorch نیز هنگام توضیح بارگذاری و پیشبینی مدل، بر فراخوانی eval() برای لایههایی مانند Dropout تأکید میکند. PyTorch Tutorials 2.14.0+cu130 documentation
مرحله پنجم: آموزش نرخهای مختلف
dropout_rates = [ 0.0, 0.2, 0.5,]results = {}for rate in dropout_rates: result = train_one_model( dropout_rate=rate ) results[rate] = result print( f"Dropout p={rate:.1f} | " f"Best validation loss: " f"{result['best_val_loss']:.4f} | " f"Epochs: " f"{result['epochs']}" )عددهای چاپشده باید با اجرای واقعی کد به دست آیند. هیچ نرخ ثابتی را نمیتوان بدون دیدن نتیجه برای این داده یا مسئلههای دیگر «بهترین» نامید.
مرحله ششم: رسم نمودار اعتبارسنجی
import matplotlib.pyplot as pltplt.figure(figsize=(9, 5))for rate, result in results.items(): plt.plot( result["val_losses"], label=f"Dropout p={rate}", )plt.xlabel("Epoch")plt.ylabel("Validation loss")plt.legend()plt.tight_layout()plt.show()هنگام مقایسه نمودار، به این پرسشها پاسخ دهید:
- کدام مدل کمترین خطای اعتبارسنجی را داشته است؟
- آیا تفاوت نتیجه چشمگیر است یا بسیار کوچک؟
- آیا یک مدل با دورههای آموزش بیشتری بهتر شده است؟
- آیا منحنی یکی از مدلها نوسان بیشتری دارد؟
- آیا نتیجه در چند اجرای مستقل تکرار میشود؟
خطای Train مدل دارای Dropout و مدل بدون آن همیشه مقایسه مستقیم و سادهای ندارد. در مرحله آموزش، یکی از مدلها با مقدارهای تصادفی صفرشده پیشبینی میکند و دیگری خیر. برای انتخاب، معیار اعتبارسنجی در حالت eval() تصویر منسجمتری فراهم میکند.
مرحله هفتم: انتخاب مدل و آزمون نهایی
ابتدا بهترین نرخ را با Validation انتخاب میکنیم. سپس فقط نتیجه مدل انتخابشده را روی Test گزارش میکنیم:
from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix,
)


best_rate = min(
    results,
    key=lambda rate: (
        results[rate]["best_val_loss"]
    ),
)

best_model = results[
    best_rate
]["model"]

best_model.eval()

X_test_tensor = torch.from_numpy(
    X_test
).to(device)

with torch.inference_mode():
    test_logits = best_model(
        X_test_tensor
    )

    test_predictions = (
        test_logits.argmax(dim=1)
        .cpu()
        .numpy()
    )

print(
    "Selected dropout rate:",
    best_rate,
)

print(
    "Test accuracy:",
    accuracy_score(
        y_test,
        test_predictions,
    ),
)

print(
    confusion_matrix(
        y_test,
        test_predictions,
    )
)

print(
    classification_report(
        y_test,
        test_predictions,
        digits=4,
    )
)
اگر پس از دیدن نتیجه Test دوباره نرخ Dropout، معماری یا آستانههای تصمیم را تغییر دهید، Test دیگر مجموعهای کاملاً مستقل از تصمیمهای شما نخواهد بود. برای گزارش معتبر، انتخاب تنظیمات را روی Validation انجام دهید.
آیا آزمایش بالا برتری Dropout را ثابت میکند؟
خیر. این آزمایش یک نمونه آموزشی روی دیتاست کوچک است. نتیجه آن ممکن است با تغییر موارد زیر عوض شود:
- مقدار و تنوع داده آموزش
- تعداد لایهها و واحدها
- نرخ یادگیری
- Weight Decay
- بذر تصادفی
- تقسیم Train وValidation
- تعداد دورهها
- شیوه انتخاب بهترین مدل
اگر تفاوت دو نرخ کوچک است، اجرای مجدد با چند بذر و گزارش میانگین و پراکندگی نتایج ضروری است. همچنین باید زمان آموزش و هزینه پیشبینی را متناسب با محصول بسنجید.
Dropoutرا کجای مدل قرار دهیم؟
در MLP، یک انتخاب رایج قرار دادن Dropout پس از تابع فعالسازی لایه پنهان است:
block = nn.Sequential(
    nn.Linear(64, 128),
    nn.ReLU(),
    nn.Dropout(p=0.2),
)
اما این تنها چینش ممکن نیست. در CNN و Transformer، نوع و محل Dropout میتواند با معماری فرق کند. اگر از مدل از پیشآموزشدیده استفاده میکنید، ساختار اصلی آن را پیش از تغییر بررسی کنید.
چند اصل عملی:
- ابتدا مدلی بدونDropout بهعنوان خط مبنا داشته باشید.
- Dropoutرا در یک یا چند جای مشخص اضافه کنید.
- نرخ را روی Validation انتخاب کنید.
- اگر مدل دچار کمبرازش است، افزودن Dropout بیشتر احتمالاً راهحل مناسبی نیست.
- کیفیت نهایی را روی داده مستقل از تصمیمهای تنظیم مدل بسنجید.
چرا Dropout در لایه خروجی معمولاً انتخاب اولیه نیست؟
لایه خروجی اطلاعاتی را تولید میکند که تابع خطا از آن برای اصلاح مدل استفاده میکند. صفر کردن تصادفی خروجی کلاسها در یک طبقهبند معمولی، مسئله آموزشی را تغییر میدهد.
به همین دلیل، در مثال این مقاله Dropout را روی لایههای پنهان قرار دادیم و خروجی خام لایه آخر را بدون Dropout به CrossEntropyLoss دادیم. این یک الگوی رایج برای شروع است؛ در معماریهای تخصصی ممکن است روشهای متفاوتی وجود داشته باشد.
آیا Dropout باعث کوچکتر شدن مدل و کاهش هزینه پیشبینی میشود؟
Dropout معمولی در PyTorchهنگام eval() صفرسازی تصادفی انجام نمیدهد. تعداد وزنهای ذخیرهشده شبکه نیز با افزودن nn.Dropout کاهش نمییابد.
بنابراین Dropout را نباید با روشهای فشردهسازی مدل، هرس وزنها یا استفاده از معماری کوچکتر یکسان دانست. اگر هدف شما کاهش زمان پاسخ یا اندازه فایل مدل است، باید همان معیارها را مستقیماً اندازه بگیرید و روشهای مناسب آن هدف را جداگانه بررسی کنید.
Monte Carlo Dropoutچیست؟
در پیشبینی معمولی، Dropout خاموش است. در روشی پژوهشی به نام Monte Carlo Dropout، Dropoutبهطور کنترلشده در چند اجرای پیشبینی فعال میماند تا بتوان تغییرپذیری خروجیها را بررسی کرد.
پژوهش Gal و Ghahramani چارچوبی برای تفسیر این روش بهعنوان یک تقریب احتمالاتی ارائه کرده است. اما پراکندگی چند پیشبینی بهتنهایی تضمین نمیکند که عدمقطعیت مدل در کاربرد واقعی درست برآورد شده باشد؛ روش باید روی داده مرتبط ارزیابی شود. proceedings.mlr.press
از سوی دیگر، فعال نگه داشتن کل مدل در حالت train() برای این کار میتواند روی لایههایی مانند BatchNorm نیز اثر بگذارد. پس Monte Carlo Dropout را نباید با «فراموش کردن model.eval()» اشتباه گرفت. این روش به پیادهسازی و ارزیابی جداگانه نیاز دارد.
اشتباهات رایج هنگام استفاده ازDropout
استفاده از p=0.5 فقط چون مقدار پیشفرض است
مقدار پیشفرض، نتیجه آزمایش روی داده شما نیست. نرخ مناسب را با معیار Validation و هدف محصول تعیین کنید.
فعال ماندن Dropout در اعتبارسنجی معمول
پیش از Validation یا پیشبینی استاندارد، model.eval() را اجرا کنید. در غیر این صورت، نتیجه میتواند میان فراخوانیها تغییر کند.
تصور اینکه torch.inference_mode() Dropoutرا خاموش میکند
این دستور رفتار لایه Dropout را به حالت ارزیابی تغییر نمیدهد. eval() نقش جداگانهای دارد.
انتظار بهبود هنگام کمبرازش
اگر مدل حتی روی Train عملکرد کافی ندارد، افزایش Dropout ممکن است مسئله را بدتر کند. نخست علت کمبرازش را بررسی کنید.
افزودن همزمان چند روش تنظیم بدون خط مبنا
اگر Dropout، Weight Decay، معماری و مقدار داده را همزمان تغییر دهید، تشخیص علت بهبود یا افت دشوار میشود.
استفاده از Dropout2d بدون توجه به شکل ورودی
برای داده تصویری، شکل ورودی و نسخه PyTorch اهمیت دارند. مستندات Dropout2d درباره بعضی ورودیهای سهبعدی هشدار میدهد. PyTorch main documentation
نتیجهگیری از یک اجرای تصادفی
تصادفی بودن آموزش و خود Dropout میتواند نتیجه را تغییر دهد. برای مقایسه دقیقتر، آزمایش را با چند بذر تکرار کنید.
انتخاب بهترین نرخ رویTest
اگر Test برای انتخاب نرخ استفاده شود، گزارش نهایی میتواند خوشبینانه باشد. انتخاب روی Validation و ارزیابی نهایی روی Test انجام میشود.
چه زمانی Dropout ارزش آزمایش دارد؟
Dropoutبهویژه زمانی ارزش بررسی دارد که:
- مدل روی Train خوب و روی Validation ضعیفتر است؛
- شبکه نسبت به مقدار داده ظرفیت زیادی دارد؛
- خط مبنای بدون Dropout ساخته شده است؛
- امکان مقایسه منصفانه چند نرخ وجود دارد؛
- زمان و منابع لازم برای ارزیابی تکرارشونده فراهم است.
در مقابل، اگر داده کمکیفیت است، برچسبها مبهماند یا Train و Validation از دو توزیع متفاوت میآیند، Dropout بهتنهایی مشکل اصلی را حل نمیکند. برای شناخت الگوهای بیشبرازش، مقاله بیشبرازش و کمبرازش در یادگیری ماشین را بخوانید.
پرسشهای متداول
Dropoutدر شبکه عصبی چیست؟
Dropoutروشی است که هنگام آموزش، بخشی از مقدارهای میانی شبکه را بهطور تصادفی صفر میکند. این روش میتواند در بعضی شرایط به کاهش بیشبرازش کمک کند.
آیا Dropout هنگام پیشبینی هم فعال است؟
در حالت معمول PyTorch، خیر. وقتی مدل را با model.eval() اجرا میکنید، nn.Dropout صفرسازی تصادفی انجام نمیدهد.
p=0.2 یعنی چه؟
یعنی هر مقدار ورودی لایه Dropout هنگام یک عبور رو به جلو در حالت آموزش، با احتمال ۲۰ درصد صفر میشود.
آیا p=0.5 بهترین نرخ است؟
خیر. این مقدار پیشفرض nn.Dropout است، اما نرخ مناسب باید برای مدل و داده شما روی Validation سنجیده شود.
تفاوت Dropout و Dropout2d چیست؟
Dropoutمعمولی مقدارها را صفر میکند؛ Dropout2d برای ورودی تصویری میتواند کل کانال یا نقشه ویژگی را صفر کند.
آیا Dropout جای BatchNorm را میگیرد؟
خیر. Dropout و BatchNorm سازوکار و نقش متفاوتی دارند. هرکدام را بر اساس نیاز معماری و نتیجه آزمایش انتخاب کنید.
آیا Dropout باعث کاهش پارامترهای مدل میشود؟
خیر. حذف در Dropout معمولی موقتی و مربوط به عبورهای آموزش است. تعداد پارامترهای ذخیرهشده شبکه بهخودیخود کم نمیشود.
چرا Loss آموزش مدل دارای Dropout گاهی بیشتر است؟
زیرا Dropout در حالت آموزش بخشی از مقدارها را صفر میکند و وظیفه مدل را در آن گام دشوارتر میسازد. برای مقایسه مدلها، معیار اعتبارسنجی را در حالت eval() بررسی کنید.
آیا Dropout از بیشبرازش جلوگیری میکند؟
ممکن است به کاهش آن کمک کند، اما تضمین نمیدهد. کیفیت داده، ظرفیت مدل، روش ارزیابی و دیگر تنظیمات نیز اثر دارند.
تفاوت Dropout و Early Stopping چیست؟
Dropout در طول گامهای آموزش بر خروجیهای میانی اثر میگذارد. Early Stoppingتصمیم میگیرد آموزش چه زمانی متوقف شود.
Monte Carlo Dropoutچه کاربردی دارد؟
در این روش پژوهشی، چند پیشبینی با Dropout فعال تولید میشود تا تغییرپذیری خروجی بررسی شود. اعتبار این تغییرپذیری بهعنوان برآورد عدمقطعیت باید جداگانه سنجیده شود.
جمعبندی
Dropoutهنگام آموزش، بخشی از مقدارهای میانی شبکه را بهصورت تصادفی صفر میکند. این روش میتواند وابستگی بیشازحد مدل به مسیرهای مشخص را کاهش دهد و در بعضی شرایط به تعمیم بهتر کمک کند.
نرخ Dropout، نوع لایه و محل قرارگیری آن پاسخ ثابت ندارند. ابتدا مدلی بدون Dropout بسازید، سپس چند تنظیم محدود را با داده اعتبارسنجی مقایسه کنید و عملکرد نهایی مدل انتخابشده را روی Test مستقل گزارش دهید.
در PyTorch، مهمترین نکته اجرایی تفاوت حالتهاست: هنگام آموزش model.train() و هنگام اعتبارسنجی یا پیشبینی معمول model.eval() را اجرا کنید.
استفاده از هوش مصنوعی در محصول با درواره
آموزش شبکه اختصاصی با PyTorch زمانی ارزشمند است که مسئله، داده و معیار ارزیابی مشخصی دارید. اگر هدف شما افزودن قابلیتهایی مانند تحلیل متن، جستوجوی معنایی، تولید محتوا یا پاسخگویی هوشمند به یک محصول است، میتوانید ابتدا مدلهای آماده را روی نمونههای واقعی کارتان ارزیابی کنید و بعد درباره آموزش مدل اختصاصی تصمیم بگیرید.
برای شروع، به darvareh.ir بروید، مدل مناسب کاربردتان را بررسی کنید و کیفیت، زمان پاسخ و هزینه را روی داده واقعی محصول خود بسنجید.
مقالات مرتبط
- بیشبرازش و کمبرازش در یادگیری ماشین
- Batch Normalizationچیست؟
- تابع فعالسازی در شبکه عصبی چیست؟
- شبکه عصبی CNN چیست؟
- PyTorchچیست؟ آموزش یادگیری عمیق
- یادگیری انتقالی و فاینتیونینگ باPyTorch
- آموزش استفاده از API هوش مصنوعی در اپلیکیشن
منابع
- مقاله اصلی Dropout درJournal of Machine Learning Research
- مستندات رسمی PyTorch برای
nn.Dropout - مستندات رسمی PyTorch برای
nn.Dropout2d - مستندات PyTorch درباره حالت آموزش، ارزیابی و گرادیان
- مستندات PyTorch برای ذخیره و بارگذاری مدل
- پژوهش Monte Carlo Dropout درICML
- مستندات مجموعهداده Digits درscikit-learn
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. عملکرد Dropout، سازگاری کد با نسخه کتابخانهها و کیفیت مدل باید پیش از استفاده عملی در محیط موردنظر بررسی شود. صفحه سلب مسئولیت درواره را نیز مطالعه کنید.



