
Adam چیست؟ مقایسه بهینهسازهای Adam، AdamW و SGD با PyTorch
Adam، AdamW و SGD چگونه وزنهای شبکه عصبی را بهروزرسانی میکنند؟ در این آموزش، تفاوت بهینهسازها، نقش نرخ یادگیری و Weight Decay را میآموزید و هر سه روش را با کد PyTorchروی یک مسئله طبقهبندی مقایسه میکنید.

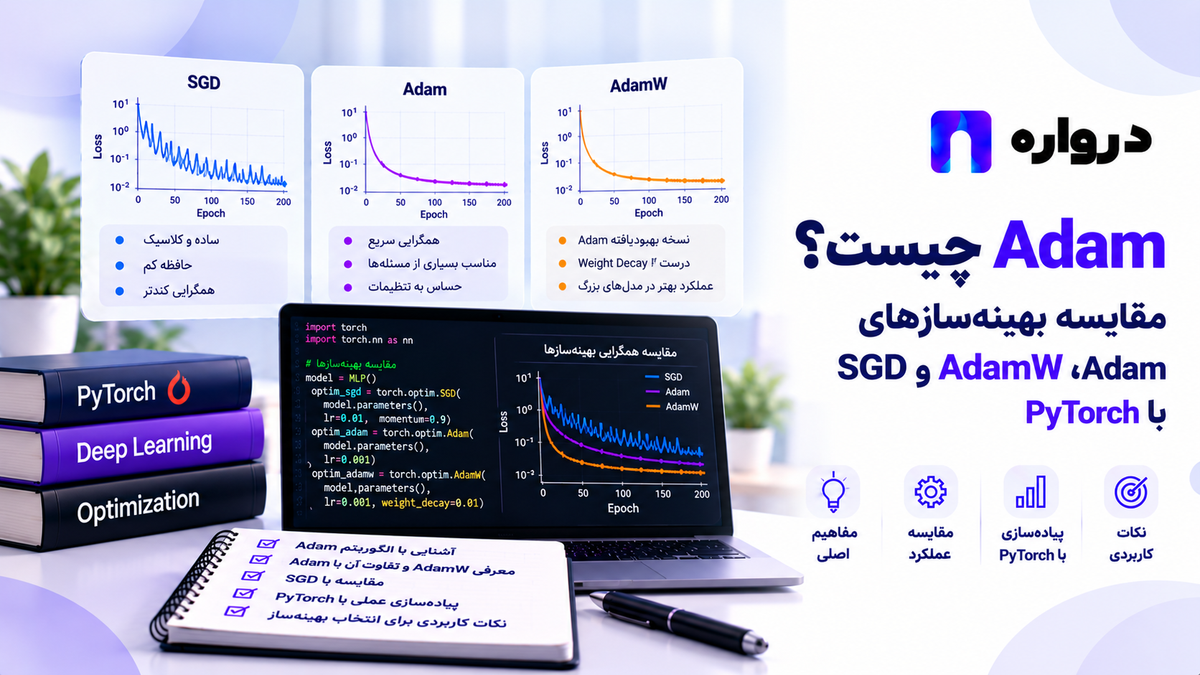
آموزش شبکه عصبی فقط محاسبه خطا و گرادیان نیست. پس از آنکه مدل دریافت هر وزن چه اثری بر خطا دارد، باید تصمیم بگیرد وزنها را چگونه تغییر دهد. این تصمیم را بهینهساز یا Optimizer اجرا میکند.
سه انتخاب پرکاربرد در PyTorch عبارتاند از:
- SGD: بهروزرسانی وزنها بر اساس گرادیان، با امکان افزودن مومنتوم.
- Adam: استفاده از میانگینهای متحرک گرادیان و اندازه آن برای تنظیم گام هر پارامتر.
- AdamW: سازوکار Adam همراه با اعمال مستقل Weight Decay بر وزنها.
نام Adam کوتاهشدهٔ Adaptive Moment Estimation است. مقاله اصلی این روش توضیح میدهد که Adam از برآورد میانگین گرادیان و میانگین توان دوم آن برای تعیین اندازه بهروزرسانی پارامترها استفاده میکند. arxiv.org
در این مقاله ابتدا رفتار این سه بهینهساز را به زبان ساده بررسی میکنیم. سپس با PyTorch، یک مدل واحد را تحت شرایط قابلمقایسه آموزش میدهیم تا بتوانید بر اساس نتیجه اعتبارسنجی، بهینهساز مناسب مسئله خود را انتخاب کنید.
بهینهساز در شبکه عصبی چه کاری انجام میدهد؟
فرض کنید یک شبکه عصبی قرار است تصویر یک رقم دستنویس را به یکی از کلاسهای صفر تا ۹ نسبت دهد. مدل در ابتدای آموزش معمولاً پیشبینیهای دقیقی ندارد.
در هر مرحله آموزش:
- یک دسته داده وارد مدل میشود.
- مدل پیشبینی میکند.
- تابع خطا فاصله پیشبینی و پاسخ درست را اندازه میگیرد.
- پسانتشار، گرادیان پارامترها را محاسبه میکند.
- بهینهساز با استفاده از گرادیانها، پارامترهای مدل را تغییر میدهد.
در PyTorch این چرخه معمولاً با سه فراخوانی مشخص در حلقه آموزش دیده میشود:
optimizer.zero_grad()
loss.backward()
optimizer.step()
فراخوانی اول گرادیانهای باقیمانده از مرحله قبل را پاک میکند؛ فراخوانی دوم گرادیانهای مرحله فعلی را میسازد؛ و فراخوانی سوم پارامترها را بهروزرسانی میکند. PyTorch Tutorials 2.14.0+cu130 documentation
گرادیان چه چیزی به ما میگوید؟
گرادیان نشان میدهد تغییر کوچک هر پارامتر، خطا را در چه جهتی تغییر میدهد. بهینهساز از این اطلاعات برای پیدا کردن پارامترهای بهتر استفاده میکند.
اما گرادیان بهتنهایی همه تصمیمهای آموزش را تعیین نمیکند. برای مثال:
- گام بهروزرسانی چقدر بزرگ باشد؟
- آیا جهت چند گام گذشته نیز در تصمیم فعلی اثر بگذارد؟
- آیا همه پارامترها با مقیاس یکسان تغییر کنند؟
- آیا وزنهای بزرگتر بهتدریج کوچک شوند؟
SGD، Adam و AdamWبه این پرسشها پاسخهای متفاوتی میدهند.
نرخ یادگیری یا Learning Rate چیست؟
Learning Rate اندازه کلی گامهای بهروزرسانی را کنترل میکند. اگر این مقدار بیشازحد بزرگ باشد، آموزش ممکن است نوسان کند یا به نتیجه مناسب نرسد. اگر بسیار کوچک باشد، پیشرفت آموزش ممکن است کند شود.
نرخ یادگیری حتی در بهینهسازهای تطبیقی مانند Adam اهمیت دارد. «تطبیقی» بودن به این معنا نیست که میتوان هر نرخ یادگیری دلخواهی انتخاب کرد. Adam مقیاس بهروزرسانی پارامترها را تنظیم میکند، اما مقدار lr همچنان بر اندازه کلی گامها اثر دارد.
در مستندات PyTorch، نرخ یادگیری یکی از ورودیهای اصلی سازندهٔ هر سه بهینهساز SGD، Adam و AdamW است. PyTorch main documentation
SGDچیست؟
Stochastic Gradient Descent یا SGD یکی از روشهای پایه برای بهینهسازی شبکه عصبی است. در کاربرد رایج، گرادیان با استفاده از یک مینیبچ محاسبه میشود و بهینهساز پارامترها را در جهت کاهش خطا تغییر میدهد.
نمونه استفاده درPyTorch:
optimizer = torch.optim.SGD( model.parameters(), lr=0.05,)SGDچند مزیت عملی دارد:
- رفتار آن نسبتاً ساده است.
- برای ساختن یک مبنای مقایسه مناسب است.
- تنظیمات و وضعیت داخلی کمتری نسبت به Adam دارد.
- میتوان آن را با مومنتوم و زمانبندی نرخ یادگیری ترکیب کرد.
در عوض، نرخ یادگیری مناسب SGD ممکن است با نرخ یادگیری مناسب Adam تفاوت زیادی داشته باشد. بنابراین مقایسه این دو با مقدار lr یکسان، لزوماً منصفانه نیست.
مومنتوم در SGD چیست؟
مومنتوم باعث میشود جهت حرکت گامهای قبلی نیز در بهروزرسانی فعلی اثر بگذارد. به زبان ساده، بهینهساز فقط به گرادیان همین مینیبچ نگاه نمیکند؛ بخشی از روند حرکت قبلی را هم نگه میدارد.
optimizer = torch.optim.SGD(
    model.parameters(),
    lr=0.05,
    momentum=0.9,
)
مستندات رسمی PyTorch پشتیبانی SGD از momentum را در رابط این بهینهساز نشان میدهد. PyTorch main documentation
مومنتوم میتواند حرکت در جهتی نسبتاً پایدار را آسانتر کند، اما همچنان باید نرخ یادگیری و مقدار مومنتوم را برای داده و مدل خود بررسی کنید.
Adamچگونه کار میکند؟
Adamبرای هر پارامتر دو نوع اطلاعات از گرادیانهای گذشته نگه میدارد:
- میانگین متحرک گرادیانها، برای دنبالکردن جهت تغییرات.
- میانگین متحرک توان دوم گرادیانها، برای توجه به مقیاس تغییرات.
Adam همچنین اثر شروع این میانگینها از صفر را در گامهای ابتدایی اصلاح میکند. نتیجه این است که اندازه مؤثر بهروزرسانی میتواند برای پارامترهای مختلف متفاوت باشد. این توصیف مستقیماً از الگوریتم منتشرشده در مقاله اصلی Adamمیآید. arxiv.org
درPyTorch:
optimizer = torch.optim.Adam(
    model.parameters(),
    lr=0.001,
)
Adamاغلب نقطه شروع مناسبی برای آزمایش یک معماری تازه است، زیرا تنظیم اولیه آن نسبتاً ساده است. بااینحال، از روی نام بهینهساز نمیتوان نتیجه گرفت که روی هر دیتاست، بهترین دقت نهایی یا بهترین تعمیم را خواهد داشت. عملکرد را باید روی دادهای که در آموزش استفاده نشده است سنجید.
پارامترهای betas و eps درAdam
در PyTorch میتوان رفتار Adam را با پارامترهای دیگری نیز تنظیم کرد:
optimizer = torch.optim.Adam(
    model.parameters(),
    lr=0.001,
    betas=(0.9, 0.999),
    eps=1e-8,
)betasمیزان اثر اطلاعات گرادیانهای گذشته را در دو میانگین متحرک تعیین میکند.epsیک مقدار کوچک برای پایداری محاسباتی در بهروزرسانی است.
این مقادیر با پیشفرضهای ثبتشده در مستندات PyTorch هماهنگاند. بهتر است پیش از تغییرشان، ابتدا نرخ یادگیری، کیفیت داده و رفتار منحنیهای آموزش را بررسی کنید. PyTorch main documentation
AdamW چیست و چه تفاوتی با Adamدارد؟
AdamW سازوکار بهروزرسانی تطبیقی Adamرا نگه میدارد، اما Weight Decayرا جدا از محاسبه مومنتوم و میانگین توان دوم گرادیان اعمال میکند. مستندات PyTorch نیز همین ویژگی را در تعریف AdamW ذکر میکند. PyTorch main documentation
نمونه استفاده:
optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=0.001,
    weight_decay=0.01,
)
مقاله اصلی AdamW توضیح میدهد که در بهینهسازهای تطبیقی مانند Adam، افزودن جریمه L2 به گرادیان و اعمال Weight Decay مستقل رفتار یکسانی ندارند. پیشنهاد مقاله، جداکردن Weight Decay از گام بهینهسازی مبتنی بر گرادیان است. arxiv.org
یک نکته مهم درباره پیشفرضهایPyTorch
در مستندات فعلی PyTorch، مقدار پیشفرض weight_decay برای torch.optim.Adam برابر صفر و برای torch.optim.AdamW برابر ۰٫۰۱ ثبت شده است. بنابراین اگر فقط نام کلاس را عوض کنید و هیچ مقدار دیگری ندهید، هم روش اعمال Weight Decay و هم مقدار آن در آزمایش تغییر میکند. PyTorch main documentation
برای آزمایش قابلتفسیر، مقدار weight_decay را صریح بنویسید.
Weight Decayچه اثری دارد؟
Weight Decayهنگام آموزش تمایل دارد اندازه وزنها را کاهش دهد. این سازوکار میتواند به کنترل پیچیدگی مدل کمک کند، اما مقدار مناسب آن به داده، معماری و سایر تنظیمات بستگی دارد.
چند نکته عملی:
weight_decay=0یعنی این سازوکار در بهینهساز غیرفعال است.- مقدار خیلی زیاد ممکن است یادگیری را محدود کند.
- اثر Weight Decay را باید با عملکرد مجموعه اعتبارسنجی بررسی کرد.
- برای مقایسه Adam و AdamW، باید دقیق مشخص کنید Weight Decay در هر کدام چگونه و با چه مقداری اعمال شده است.
Weight Decay تنها ابزار مقابله با بیشبرازش نیست. اندازه مدل، کیفیت داده، افزایش داده، Dropoutو توقف آموزش نیز میتوانند مهم باشند.
مقایسه Adam، AdamW وSGD
| ویژگی | SGD با مومنتوم | Adam | AdamW |
|---|---|---|---|
| استفاده از گرادیان فعلی | بله | بله | بله |
| نگهداری اطلاعات گامهای قبلی | با مومنتوم | بله | بله |
| تنظیم تطبیقی مقیاس بهروزرسانی هر پارامتر | خیر | بله | بله |
| Weight Decay مستقل از میانگینهای گرادیان | خیر | در حالت پیشفرض خیر | بله |
| حساسیت به انتخاب نرخ یادگیری | دارد | دارد | دارد |
| مناسب برای شروع آزمایش | بله | بله | بله |
| برتری قطعی برای همه مسائل | خیر | خیر | خیر |
این جدول رفتار الگوریتمها را مقایسه میکند، نه دقت تضمینشده آنها را. تنظیمات مناسب را باید برای مسئله واقعی آزمایش کرد. تعریف رسمی هر بهینهساز در مستندات PyTorch و تفاوت Weight Decay در مقاله AdamW آمده است. PyTorch main documentation
آیا Adam همیشه سریعتر از SGD است؟
پاسخ به این بستگی دارد که «سریعتر» را چگونه اندازه بگیریم:
- تعداد گام لازم برای رسیدن به یک خطای مشخص؟
- زمان واقعی آموزش؟
- تعداد Epoch لازم برای رسیدن به دقت مطلوب؟
- دقت نهایی مجموعه اعتبارسنجی؟
- هزینه حافظه؟
ممکن است یک روش در چند Epoch ابتدایی خطای آموزش را سریعتر کاهش دهد، اما روش دیگری پس از تنظیم مناسب نرخ یادگیری، عملکرد اعتبارسنجی بهتری داشته باشد. حتی مقاله اصلی Adam نیز نتایج تجربی خود را برای مدلها و مجموعهدادههای مشخص گزارش میکند؛ از آن نتایج نمیتوان یک برتری همگانی نتیجه گرفت. arxiv.org
برای تصمیم واقعی، هم کیفیت مدل و هم هزینه رسیدن به آن کیفیت را اندازه بگیرید.
آموزش عملی: مقایسه سه بهینهساز باPyTorch
در این آزمایش، از مجموعهداده Digits کتابخانه scikit-learn استفاده میکنیم. این مجموعه شامل ۱۷۹۷ تصویر ۸ در ۸ پیکسلی از رقمهای دستنویس است. هدف، طبقهبندی هر تصویر در یکی از ۱۰ کلاس است. scikit-learn 1.3.2 documentation
برای اینکه نتیجه قابلفهم باشد:
- مدل هر سه آزمایش یکسان است.
- تقسیم داده ثابت است.
- وزنهای اولیه مدل یکساناند.
- پیشپردازش فقط روی داده آموزش برازش میشود.
- انتخاب بهینهساز با داده اعتبارسنجی انجام میشود.
- داده Test تا پایان انتخاب تنظیمات کنار گذاشته میشود.
این یک نمونه آموزشی است. یک اجرای کوچک برای اثبات برتری عمومی هیچ بهینهسازی کافی نیست.
نصب کتابخانهها
pip install torch scikit-learn matplotlibاگر به نسخه ویژه CUDA نیاز دارید، دستور نصب مناسب دستگاه خود را از صفحه رسمی نصب PyTorch انتخاب کنید.
آمادهسازی داده
در کد زیر، ابتدا Test را جدا میکنیم. سپس داده باقیمانده را به Train و Validation تقسیم میکنیم. تقسیمبندی با stratify انجام میشود تا نسبت کلاسها تا حد امکان در مجموعهها حفظ شود؛ این گزینه در رابط رسمی train_test_split وجود دارد. scikit-learn 1.9.1 documentation
import numpy as np
import torch

from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from torch.utils.data import DataLoader, TensorDataset


SEED = 42
BATCH_SIZE = 64

torch.manual_seed(SEED)
np.random.seed(SEED)

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

digits = load_digits()

X = digits.data.astype(np.float32)
y = digits.target.astype(np.int64)

X_train_val, X_test, y_train_val, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.20,
        stratify=y,
        random_state=SEED,
    )
)

X_train, X_val, y_train, y_val = (
    train_test_split(
        X_train_val,
        y_train_val,
        test_size=0.20,
        stratify=y_train_val,
        random_state=SEED,
    )
)

scaler = StandardScaler()

X_train = scaler.fit_transform(
    X_train
).astype(np.float32)

X_val = scaler.transform(
    X_val
).astype(np.float32)

X_test = scaler.transform(
    X_test
).astype(np.float32)


def make_dataset(features, labels):
    return TensorDataset(
        torch.from_numpy(features),
        torch.from_numpy(labels),
    )


train_dataset = make_dataset(X_train, y_train)
val_dataset = make_dataset(X_val, y_val)
test_dataset = make_dataset(X_test, y_test)

print(
    "Train / Validation / Test:",
    len(train_dataset),
    len(val_dataset),
    len(test_dataset),
)
print("Device:", device)
StandardScaler فقط با X_train برازش میشود. سپس همان تبدیل روی Validation و Test اعمال میشود. اگر مقیاسساز را پیش از جداسازی دادهها روی کل مجموعه برازش دهید، اطلاعات مجموعههای ارزیابی وارد فرایند آموزش میشود.
ساخت مدل طبقهبندی
برای مقایسه، یک شبکه کوچک چندلایه میسازیم. ورودی آن ۶۴ ویژگی پیکسلی و خروجی آن ۱۰ امتیاز مربوط به کلاسها است.
from torch import nn


class DigitClassifier(nn.Module):
    def __init__(self):
        super().__init__()

        self.network = nn.Sequential(
            nn.Linear(64, 128),
            nn.ReLU(),
            nn.Linear(128, 64),
            nn.ReLU(),
            nn.Linear(64, 10),
        )

    def forward(self, images):
        return self.network(images)
خروجی مدل را پیش از CrossEntropyLoss از Softmax عبور نمیدهیم. تابع CrossEntropyLoss امتیازهای خام کلاسها را میپذیرد و محاسبات لازم را درون خود انجام میدهد.
تعریف بهینهسازها
در این آزمایش، SGD را با مومنتوم، Adam را بدون Weight Decay، و AdamW را با Weight Decay مشخص اجرا میکنیم:
def make_optimizer(name, parameters):
    if name == "sgd":
        return torch.optim.SGD(
            parameters,
            lr=0.05,
            momentum=0.9,
            weight_decay=0.0,
        )

    if name == "adam":
        return torch.optim.Adam(
            parameters,
            lr=0.001,
            weight_decay=0.0,
        )

    if name == "adamw":
        return torch.optim.AdamW(
            parameters,
            lr=0.001,
            weight_decay=0.01,
        )

    raise ValueError(
        f"Unknown optimizer: {name}"
    )
دقت کنید که این آزمایش فقط «تفاوت الگوریتم Adam و AdamW» را جداگانه اندازه نمیگیرد: در تنظیمات بالا، AdamW علاوه بر روش متفاوت اعمال Weight Decay، مقدار غیرصفر آن را نیز دارد. این سه پیکربندی، سه انتخاب عملی برای آموزش هستند.
اگر بخواهید اثر خودِ روش اعمال Weight Decay را بررسی کنید، Adam و AdamW را با مقدار یکسان و غیرصفر weight_decay، همراه با نرخهای یادگیری تنظیمشده، در آزمایشی جداگانه مقایسه کنید.
تابع ارزیابی
در ارزیابی، مدل باید در حالت eval باشد و نیازی به ثبت گرادیان نداریم:
def evaluate(model, data_loader, device):
    model.eval()

    criterion = nn.CrossEntropyLoss(
        reduction="sum"
    )

    total_loss = 0.0
    total_correct = 0
    total_samples = 0

    with torch.inference_mode():
        for features, labels in data_loader:
            features = features.to(device)
            labels = labels.to(device)

            logits = model(features)

            total_loss += criterion(
                logits,
                labels,
            ).item()

            predictions = logits.argmax(dim=1)

            total_correct += (
                predictions == labels
            ).sum().item()

            total_samples += labels.size(0)

    return {
        "loss": total_loss / total_samples,
        "accuracy": total_correct / total_samples,
    }
هم خطا و هم دقت را نگه میداریم؛ زیرا ممکن است دو مدل دقت یکسانی داشته باشند ولی خطای پیشبینی آنها متفاوت باشد.
آموزش با وزن اولیه یکسان
برای آنکه اثر مقداردهی اولیه را کمتر با اثر انتخاب بهینهساز اشتباه بگیریم، ابتدا یک مدل میسازیم و سپس از وزنهای اولیه آن برای هر سه آزمایش کپی میگیریم.
همچنین برای ترتیب مینیبچها در هر آزمایش از یک بذر ثابت استفاده میکنیم.
from copy import deepcopy


initial_model = DigitClassifier()

initial_weights = deepcopy(
    initial_model.state_dict()
)


def train_experiment(
    optimizer_name,
    train_dataset,
    val_dataset,
    initial_weights,
    device,
    epochs=30,
):
    model = DigitClassifier().to(device)

    model.load_state_dict(
        initial_weights
    )

    optimizer = make_optimizer(
        optimizer_name,
        model.parameters(),
    )

    criterion = nn.CrossEntropyLoss()

    generator = torch.Generator()
    generator.manual_seed(SEED)

    train_loader = DataLoader(
        train_dataset,
        batch_size=BATCH_SIZE,
        shuffle=True,
        generator=generator,
    )

    val_loader = DataLoader(
        val_dataset,
        batch_size=BATCH_SIZE,
        shuffle=False,
    )

    history = []
    best_val_loss = float("inf")
    best_weights = None
    best_epoch = None

    for epoch in range(epochs):
        model.train()

        train_loss_sum = 0.0
        train_correct = 0
        train_samples = 0

        for features, labels in train_loader:
            features = features.to(device)
            labels = labels.to(device)

            optimizer.zero_grad()

            logits = model(features)
            loss = criterion(logits, labels)

            loss.backward()
            optimizer.step()

            batch_size = labels.size(0)

            train_loss_sum += (
                loss.item() * batch_size
            )

            train_correct += (
                logits.argmax(dim=1) == labels
            ).sum().item()

            train_samples += batch_size

        val_metrics = evaluate(
            model,
            val_loader,
            device,
        )

        epoch_result = {
            "epoch": epoch + 1,
            "train_loss": (
                train_loss_sum / train_samples
            ),
            "train_accuracy": (
                train_correct / train_samples
            ),
            "val_loss": val_metrics["loss"],
            "val_accuracy": (
                val_metrics["accuracy"]
            ),
        }

        history.append(epoch_result)

        if val_metrics["loss"] < best_val_loss:
            best_val_loss = val_metrics["loss"]
            best_epoch = epoch + 1

            best_weights = deepcopy(
                model.state_dict()
            )

    model.load_state_dict(best_weights)

    return {
        "model": model,
        "history": history,
        "best_epoch": best_epoch,
        "best_val_loss": best_val_loss,
    }
در این کد، مدل منتخب هر آزمایش مربوط به Epoch با کمترین خطای Validation است. به این ترتیب مجبور نیستیم فرض کنیم آخرین Epoch بهترین مدل را ساخته است.
اجرای سه آزمایش
experiments = {}

for optimizer_name in (
    "sgd",
    "adam",
    "adamw",
):
    experiments[optimizer_name] = (
        train_experiment(
            optimizer_name=optimizer_name,
            train_dataset=train_dataset,
            val_dataset=val_dataset,
            initial_weights=initial_weights,
            device=device,
            epochs=30,
        )
    )

    result = experiments[optimizer_name]

    print(
        f"{optimizer_name:5s} | "
        f"best epoch: "
        f"{result['best_epoch']:02d} | "
        f"validation loss: "
        f"{result['best_val_loss']:.4f}"
    )
از آنجا که آموزش کد در همین مقاله اجرا نشده است، هیچ عدد دقتی را بهعنوان «نتیجه آزمایش» اعلام نمیکنیم. خروجی واقعی به محیط اجرا، نسخه کتابخانهها و تنظیمات وابسته است.
رسم منحنی آموزش و اعتبارسنجی
مشاهده یک عدد نهایی کافی نیست. منحنیها نشان میدهند هر بهینهساز در طول آموزش چگونه رفتار کرده است.
import matplotlib.pyplot as plt


figure, axes = plt.subplots(
    1,
    2,
    figsize=(12, 4),
)

for name, result in experiments.items():
    history = result["history"]

    epochs = [
        row["epoch"]
        for row in history
    ]

    train_losses = [
        row["train_loss"]
        for row in history
    ]

    val_losses = [
        row["val_loss"]
        for row in history
    ]

    val_accuracies = [
        row["val_accuracy"]
        for row in history
    ]

    axes[0].plot(
        epochs,
        train_losses,
        label=f"{name} train",
    )

    axes[0].plot(
        epochs,
        val_losses,
        linestyle="--",
        label=f"{name} validation",
    )

    axes[1].plot(
        epochs,
        val_accuracies,
        label=name,
    )

axes[0].set_title("Training and validation loss")
axes[0].set_xlabel("Epoch")
axes[0].set_ylabel("Loss")
axes[0].legend()

axes[1].set_title("Validation accuracy")
axes[1].set_xlabel("Epoch")
axes[1].set_ylabel("Accuracy")
axes[1].legend()

plt.tight_layout()
plt.show()
هنگام بررسی نمودارها به این موارد توجه کنید:
- کدام روش در Epochهای ابتدایی سریعتر پیشرفت میکند؟
- آیا خطای آموزش کاهش مییابد، ولی خطای Validation بالا میرود؟
- آیا تفاوت دقتها پایدار است یا فقط در یک Epoch دیده میشود؟
- آیا یکی از روشها هنوز در حال بهبود است و به زمان آموزش بیشتری نیاز دارد؟
- آیا نرخ یادگیری انتخابشده برای یک روش نامناسب به نظر میرسد؟
انتخاب مدل و ارزیابی نهایی رویTest
انتخاب را با خطایValidation انجام میدهیم. سپس فقط مدل انتخابشده را روی Test ارزیابی میکنیم:
best_name = min(
    experiments,
    key=lambda name: (
        experiments[name]["best_val_loss"]
    ),
)

test_loader = DataLoader(
    test_dataset,
    batch_size=BATCH_SIZE,
    shuffle=False,
)

best_model = experiments[
    best_name
]["model"]

test_metrics = evaluate(
    best_model,
    test_loader,
    device,
)

print("Selected optimizer:", best_name)

print(
    "Test loss:",
    round(test_metrics["loss"], 4),
)

print(
    "Test accuracy:",
    round(test_metrics["accuracy"], 4),
)
اگر بعد از دیدن نتیجه Test نرخ یادگیری، معماری یا بهینهساز را تغییر دهید و دوباره همان Test را برای انتخاب استفاده کنید، مجموعه Test نیز عملاً وارد فرایند تنظیم مدل شده است. برای گزارش نهایی قابلاعتماد، آن را تا پایان انتخابها کنار بگذارید.
چرا این مقایسه هنوز قطعی نیست؟
با وجود کنترل وزن اولیه و تقسیم داده، یک آزمایش کوچک محدودیت دارد:
- برای هر بهینهساز فقط یک نرخ یادگیری تعیین کردهایم.
- داده
Digitsکوچک است. - نتیجه یک بذر تصادفی ممکن است نماینده همه اجراها نباشد.
- زمان واقعی آموزش و مصرف حافظه را اندازه نگرفتهایم.
- معماریهای دیگر ممکن است رفتار متفاوتی نشان دهند.
برای بررسی دقیقتر، برای هر بهینهساز چند نرخ یادگیری مناسب و چند بذر تصادفی آزمایش کنید. سپس میانگین و پراکندگی نتایج Validation و زمان آموزش را گزارش دهید. مقایسه با نرخ یادگیری یکسان برای همه بهینهسازها معمولاً پرسش مفیدی را پاسخ نمیدهد، چون هر روش ممکن است در بازه متفاوتی بهتر کار کند.
افزودنLearning Rate Scheduler
گاهی بهتر است نرخ یادگیری در طول آموزش تغییر کند. PyTorch برای این کار ابزارهایی مانند CosineAnnealingLR دارد. این زمانبند طبق مستندات رسمی، نرخ یادگیری را در مسیر کسینوسی تغییر میدهد و نسخه یادشده بازآغاز دورهای ندارد. PyTorch main documentation
نمونه استفاده:
optimizer = torch.optim.SGD(
    model.parameters(),
    lr=0.05,
    momentum=0.9,
)

scheduler = (
    torch.optim.lr_scheduler.CosineAnnealingLR(
        optimizer,
        T_max=30,
    )
)

for epoch in range(30):
    model.train()

    for features, labels in train_loader:
        features = features.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        logits = model(features)
        loss = criterion(logits, labels)

        loss.backward()
        optimizer.step()

    scheduler.step()

    print(
        epoch + 1,
        optimizer.param_groups[0]["lr"],
    )
این قطعهکد فرض میکند model، train_loader و criterion از قبل ساخته شدهاند. برای مقایسه منصفانه، اگر به یک بهینهساز زمانبند اضافه میکنید، باید روشن کنید که دارید پیکربندیهای آموزش را مقایسه میکنید، نه فقط نام بهینهسازها را.
آیا برای هر لایه باید نرخ یادگیری یکسان داشت؟
خیر. PyTorch اجازه میدهد پارامترها را در گروههای مختلف با تنظیمات جداگانه به بهینهساز بدهید. این قابلیت هنگام Fine-tuning مفید است؛ برای مثال، شاید بخواهید لایههای یک مدل از پیش آموزشدیده را با نرخ یادگیری کوچکتری نسبت به سر طبقهبندی تازهساختهشده تغییر دهید.
نمونه مفهومی:
optimizer = torch.optim.AdamW(
    [
        {
            "params": model.backbone.parameters(),
            "lr": 0.00001,
        },
        {
            "params": model.classifier.parameters(),
            "lr": 0.001,
        },
    ],
    weight_decay=0.01,
)
این کد برای مدلی است که واقعاً دو بخش backbone و classifier دارد؛ مدل ساده DigitClassifier بالا چنین نامهایی ندارد. مستندات PyTorch گروههای پارامتر را بهعنوان راهی برای تعیین تنظیمات جداگانه از جمله نرخ یادگیری و Weight Decay معرفی میکند. PyTorch main documentation
چه زمانی SGD را انتخاب کنیم؟
SGDبا مومنتوم انتخاب خوبی برای آزمایش است وقتی:
- یک مبنای ساده و روشن میخواهید.
- برای تنظیم نرخ یادگیری و زمانبندی آن فرصت دارید.
- میخواهید رفتار مدل را در چند پیکربندی آموزش بررسی کنید.
- چارچوب آزمایش شما از قبل با SGD تنظیم شده است.
اگر SGD در چند Epoch اول از Adam عقب افتاد، لزوماً آن را کنار نگذارید. ابتدا بررسی کنید نرخ یادگیری، مومنتوم و تعداد Epoch برای آن مناسب بودهاند یا خیر.
چه زمانی Adam را انتخاب کنیم؟
Adamمیتواند انتخاب اولیه خوبی باشد وقتی:
- در حال آزمایش یک مدل جدید هستید.
- میخواهید بدون تنظیمات فراوان، یک مبنای اولیه بسازید.
- مقیاس گرادیان پارامترهای مختلف متفاوت است.
- لازم است چند معماری را بهسرعت بررسی کنید.
اگر هدف کنترل اندازه وزنها نیز هست، تفاوت Adam و AdamW را آگاهانه بررسی کنید. واردکردن عددی یکسان در گزینه weight_decay به این معنا نیست که دو روش Weight Decay را یکسان اعمال میکنند. arxiv.org
چه زمانی AdamW را انتخاب کنیم؟
AdamW زمانی ارزش آزمایش دارد که میخواهید بهینهسازی تطبیقی Adamرا همراه با Weight Decayمستقل به کار ببرید.
در بسیاری از پروژهها، AdamW یک نقطه شروع عملی برای تنظیم lr و weight_decay است؛ اما مقدار مناسب این دو پارامتر را باید روی مجموعه اعتبارسنجی تعیین کرد. حتی اگر در یک آموزش نمونه مقدار 0.001 و 0.01 ببینید، آن اعداد برای مسئله شما تضمینشده نیستند.
خطاهای رایج هنگام استفاده از بهینهسازها
مقایسه بهینهسازها با نرخ یادگیری یکسان
عدد یکسان الزاماً شرایط برابر ایجاد نمیکند. برای هر روش، نرخ یادگیری مناسب خودش را جستوجو کنید.
فراموشکردن optimizer.zero_grad()
در PyTorch گرادیانها بهطور پیشفرض انباشته میشوند. اگر قصد انباشت گرادیان ندارید، در هر مرحله آنها را پاک کنید. PyTorch Tutorials 2.14.0+cu130 documentation
تصور اینکه AdamW همان Adam با یک نام دیگر است
تفاوت اصلی در نحوه اعمال Weight Decay است. همچنین مقدار پیشفرض Weight Decay این دو کلاس در مستندات فعلی PyTorch یکسان نیست. PyTorch main documentation
قضاوت فقط بر اساس Loss آموزش
بهینهسازی بهتر روی داده آموزش الزاماً به معنی عملکرد بهتر روی داده جدید نیست. Validation و Test نیز باید بررسی شوند.
تغییر همزمان چند عامل در آزمایش
اگر معماری، نرخ یادگیری، Batch Size و بهینهساز را همزمان تغییر دهید، مشخص نمیشود کدام تغییر عامل تفاوت نتیجه بوده است.
استفاده از Test برای انتخاب تنظیمات
Test باید برای ارزیابی نهایی بماند. تصمیمهای آموزشی را با داده Validationبگیرید.
تفسیر یک اجرای تصادفی بهعنوان نتیجه عمومی
اگر تفاوت نتایج کوچک است، آزمایش را با چند بذر تصادفی تکرار کنید و پراکندگی نتیجه را ببینید.
نادیدهگرفتن مقدار پیشفرضWeight Decay
هنگام ساخت AdamW بهتر است weight_decay را صریح وارد کنید تا پیکربندی مقاله یا پروژه به پیشفرض یک نسخه از کتابخانه وابسته نباشد.
پرسشهای متداول
Optimizerدر یادگیری ماشین چیست؟
بهینهساز روشی است که با استفاده از گرادیانها و تنظیمات آموزش، پارامترهای قابلیادگیری مدل را بهروزرسانی میکند تا خطا کاهش یابد.
Adamمخفف چیست؟
Adamاز عبارت Adaptive Moment Estimation گرفته شده است. این روش برای تنظیم گامهای بهروزرسانی، برآوردهایی از گرادیانها و توان دوم آنها نگه میدارد. arxiv.org
تفاوت Adam و SGD چیست؟
SGD با نرخ یادگیری تعیینشده و در صورت نیاز مومنتوم، وزنها را بهروزرسانی میکند. Adamعلاوه بر استفاده از اطلاعات گذشته، مقیاس بهروزرسانی هر پارامتر را با برآوردهای متحرک گرادیان تنظیم میکند.
تفاوت Adam و AdamW چیست؟
AdamW، Weight Decay را مستقل از میانگینهای متحرک مورد استفاده Adam اعمال میکند. این تفاوت در حضور Weight Decayاهمیت پیدا میکند. PyTorch main documentation
آیا AdamW همیشه از Adam بهتر است؟
خیر. نتیجه به داده، معماری، نرخ یادگیری، مقدار Weight Decay و معیار ارزیابی بستگی دارد. باید هر دو پیکربندی را با روش ارزیابی مشخص آزمایش کنید.
بهترین نرخ یادگیری برای Adam چیست؟
یک مقدار همگانی وجود ندارد. 0.001 در مستندات PyTorch مقدار پیشفرض Adam است، اما انتخاب نهایی باید با عملکرد Validation و رفتار منحنی آموزش انجام شود. PyTorch main documentation
آیا Adam به Learning Rate Scheduler نیاز دارد؟
همیشه خیر. زمانبند میتواند در بعضی برنامههای آموزش مفید باشد، اما باید اثر آن را جداگانه ارزیابی کنید.
آیا Weight Decay همان Dropout است؟
خیر. Weight Decay بر بهروزرسانی پارامترها اثر میگذارد. Dropout در مرحله آموزش، بخشی از خروجی واحدهای شبکه را بهطور تصادفی صفر میکند. این دو سازوکار میتوانند در یک مدل استفاده شوند، اما کار یکسانی انجام نمیدهند.
آیا میتوان بهینهساز را وسط آموزش عوض کرد؟
از نظر فنی بله، اما بهینهسازهایی مانند Adam وضعیت داخلی مربوط به گرادیانهای گذشته دارند. با ساختن بهینهساز تازه، این وضعیت نیز از نو شروع میشود. چنین تغییری را باید آگاهانه طراحی و ارزیابی کرد.
برای Fine-tuning مدل از پیش آموزشدیده کدام بهتر است؟
پاسخ قطعی وجود ندارد. AdamW و SGD با مومنتوم هر دو قابلآزمایشاند. نرخ یادگیری لایههای از پیش آموزشدیده، تنظیمات سر جدید مدل و کیفیت داده Validation معمولاً از انتخاب نام بهینهساز مهمترند.
جمعبندی
SGD، Adam و AdamW هر سه پارامترهای مدل را با استفاده از گرادیان بهروزرسانی میکنند، اما اطلاعات گذشته و Weight Decayرا به شکلهای متفاوتی به کار میگیرند.
SGDبا مومنتوم یک مبنای روشن و قابلتنظیم است. Adam اندازه مؤثر بهروزرسانی پارامترها را بهصورت تطبیقی تنظیم میکند. AdamW همین خانواده بهینهسازی را با Weight Decay مستقل ترکیب میکند.
بهترین انتخاب را با یک عدد ثابت یا قاعده کلی تعیین نکنید. مدل، تقسیم داده و معیار ارزیابی را مشخص کنید؛ برای هر روش نرخ یادگیری مناسبی بیابید؛ منحنیهای آموزش و اعتبارسنجی را بررسی کنید؛ و فقط پس از انتخاب نهایی سراغ Test بروید.
از آموزش مدل تا استفاده از هوش مصنوعی در محصول
اگر در حال ساخت قابلیت هوش مصنوعی برای یک محصول هستید، بهینهسازی یک مدل اختصاصی تنها بخشی از مسیر است. برای قابلیتهایی مانند پردازش متن، تولید محتوا یا استفاده از مدلهای آماده نیز میتوانید امکان اتصال محصول به مدلها از طریق API را بررسی کنید. درواره خدمات دسترسی یکپارچه به مدلهای هوش مصنوعی را معرفی کرده است؛ پیش از انتخاب، مدلهای در دسترس و شرایط استفاده را در سایت بررسی کنید. hub.darvareh.ir
برای بررسی خدمات و شروع کار، به darvareh.ir سر بزنید.
مقالات مرتبط
- گرادیان کاهشی در یادگیری ماشین چیست؟
- بیشبرازش و کمبرازش در یادگیری ماشین
- Dropout چیست؟ آموزش کاهش بیشبرازش با PyTorch
- Batch Normalizationچیست؟
- تابع فعالسازی در شبکه عصبی چیست؟
- PyTorchچیست؟
- یادگیری انتقالی و Fine-tuning باPyTorch
- آموزش استفاده از API هوش مصنوعی
منابع
- مقاله اصلیAdam: A Method for Stochastic Optimization
- مقاله اصلیDecoupled Weight Decay Regularization
- مستندات رسمیPyTorch: Adam
- مستندات رسمیPyTorch: AdamW
- مستندات رسمیPyTorch: SGD
- آموزش رسمی PyTorch: بهینهسازی پارامترهای مدل
- مستندات رسمی scikit-learn: مجموعهدادهDigits
- مستندات رسمی scikit-learn: تقسیم داده باtrain_test_split
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و صفحه سلب مسئولیت درواره را نیز مطالعه کنید.



