
Gradient Clipping چیست؟ آموزش کنترل گرادیان انفجاری با PyTorch
Gradient Clipping چیست و چگونه از بهروزرسانیهای بسیار بزرگ در آموزش شبکه عصبی جلوگیری میکند؟ در این آموزش، گرادیان انفجاری، تفاوت برش اندازه و مقدار گرادیان و پیادهسازی درست آن در PyTorch،انباشت گرادیان و آموزش با دقت ترکیبی را میآموزید.

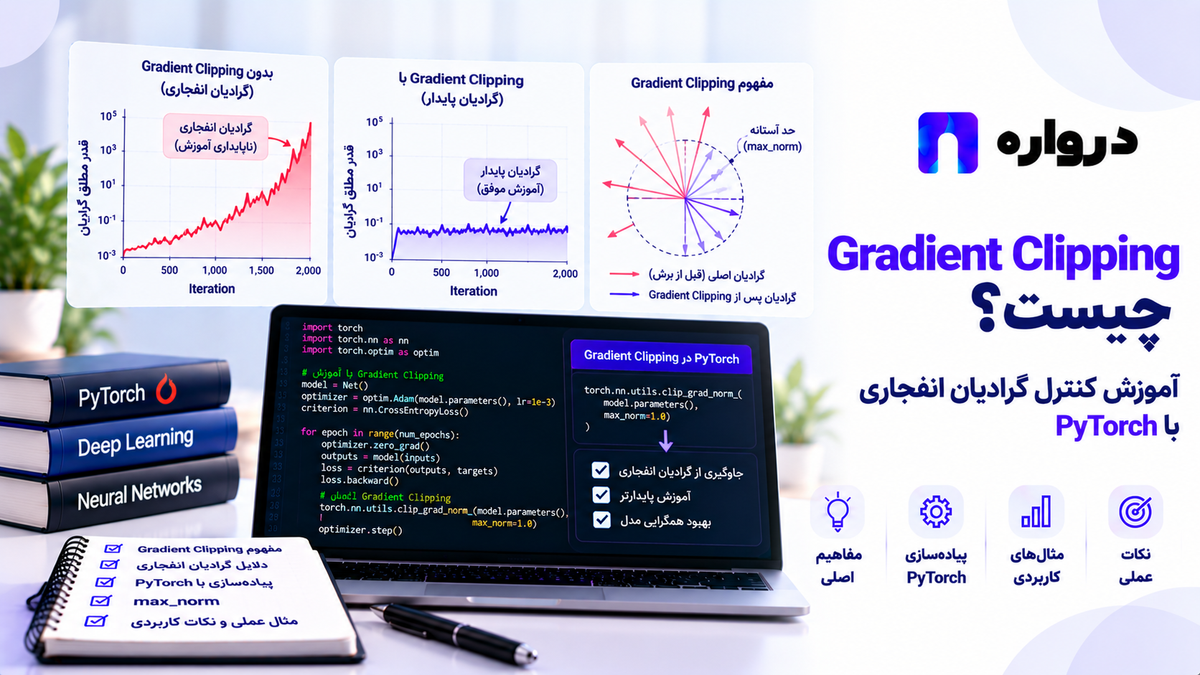
در آموزش شبکه عصبی، پس از محاسبه خطا، فرایند پسانتشار گرادیان هر پارامتر را به دست میآورد. بهینهساز از این گرادیانها برای تغییر وزنها استفاده میکند.
گاهی اندازه گرادیانها بسیار بزرگ میشود. اگر بهینهساز بر اساس چنین گرادیانهایی گام بزرگی بردارد، ممکن است خطای آموزش جهش کند یا فرایند آموزش ناپایدار شود. Gradient Clipping یا برش گرادیان روشی است که پیش از گام بهینهساز، اندازه گرادیانها را به یک حد مشخص محدود میکند.
در PyTorch، الگوی رایج چنین است:
optimizer.zero_grad()loss.backward()torch.nn.utils.clip_grad_norm_( model.parameters(), max_norm=1.0,)optimizer.step()جای این دستور اهمیت دارد: گرادیانها باید ابتدا با backward() محاسبه شوند و سپس، پیش از optimizer.step()، محدود شوند.
مستندات PyTorch دو ابزار اصلی برای این کار معرفی میکند: clip_grad_norm_ برای محدودکردن اندازه کلی گرادیانها و clip_grad_value_ برای محدودکردن مقدار اجزای گرادیان. PyTorch main documentation
در این مقاله، تفاوت این دو روش، نحوه تشخیص گرادیانهای مشکلساز و پیادهسازی درست آنها در یک مثال کامل PyTorch را بررسی میکنیم.
گرادیان چیست و چرا اندازه آن مهم است؟
گرادیان نشان میدهد تغییر یک پارامتر چه اثری بر خطای مدل دارد. در هر مرحله آموزش، شبکه روی یک Batch پیشبینی میکند، خطا محاسبه میشود و پسانتشار برای پارامترهای قابلآموزش گرادیان میسازد.
سپس بهینهساز با توجه به گرادیانها و تنظیماتی مانند نرخ یادگیری، وزنها را تغییر میدهد.
اگر گرادیانها بزرگ باشند، امکان دارد تغییر وزنها در یک مرحله بیشازحد شدید شود. البته هر گرادیان بزرگ، نشانه خرابی نیست. اندازه آن باید همراه با Loss، نرخ یادگیری، رفتار Validation و روند چندین مرحله آموزش تفسیر شود.
گرادیان انفجاری چیست؟
Exploding Gradients یا گرادیان انفجاری به وضعیتی گفته میشود که گرادیانها در جریان آموزش یا پسانتشار به اندازههای بسیار بزرگ میرسند و آموزش را دشوار یا ناپایدار میکنند.
این مسئله در پژوهشهای مربوط به شبکههای بازگشتی بهطور مشخص بررسی شده است. مقاله On the Difficulty of Training Recurrent Neural Networks راهبرد برش اندازه گرادیان را برای برخورد با گرادیانهای انفجاری پیشنهاد میکند. proceedings.mlr.press
نشانههای احتمالی عبارتاند از:
- جهش شدید Loss پس از چند گام آموزش.
- تغییرات بسیار بزرگ در وزنها.
- نوسان شدید معیارهای آموزش.
- ظاهرشدن
infیاnanدر Loss یا گرادیانها. - ناپایداریای که با کاهش نرخ یادگیری کمتر میشود.
هیچکدام از این نشانهها بهتنهایی ثابت نمیکند علت مشکل حتماً گرادیان انفجاری است. ورودی نامعتبر، تابع خطای نامناسب، نرخ یادگیری بالا و خطاهای محاسباتی نیز میتوانند نشانههای مشابهی ایجاد کنند.
تفاوت گرادیان انفجاری و گرادیان محوشونده
| وضعیت | رفتار کلی | پیامد احتمالی |
|---|---|---|
| گرادیان انفجاری | اندازه گرادیانها بسیار بزرگ میشود. | بهروزرسانی ناپایدار و جهش Loss |
| گرادیان محوشونده | گرادیان لایههای موردنظر بسیار کوچک میشود. | یادگیری کند یا ناکافی در آن لایهها |
Gradient Clippingبرای محدودکردن گرادیانهای بزرگ است. اگر گرادیانها از ابتدا بسیار کوچکاند، برش گرادیان آنها را بزرگ نمیکند. برای بررسی گرادیان محوشونده باید معماری، فعالسازها، مقداردهی اولیه و مسیر انتقال گرادیان را جداگانه بررسی کرد.
مقاله اصلی مربوط به دشواری آموزش شبکههای بازگشتی نیز مسئله گرادیان انفجاری و محوشونده را جداگانه تحلیل میکند. proceedings.mlr.press
Gradient Clippingچگونه کار میکند؟
پس از loss.backward()، گرادیان پارامترها در ویژگی .grad آنها قرار میگیرد. تابع برش، همین گرادیانهای محاسبهشده را درجا تغییر میدهد.
برش گرادیان:
- وزنهای مدل را مستقیماً تغییر نمیدهد.
- جایگزین Optimizer نیست.
- تابع Loss را تغییر نمیدهد.
- معمولاً فقط وقتی اندازه گرادیان از حد تعیینشده عبور کند، اثر عملی دارد.
برای درک رفتار آن، باید دو شیوه اصلی برش را از هم جدا کنیم.
برش بر اساس اندازه کلی: clip_grad_norm_
تابع clip_grad_norm_ اندازه کلی گرادیانهای پارامترهای دادهشده را محاسبه میکند. اگر این اندازه از حد مجاز بیشتر باشد، گرادیانها را برای قرارگرفتن در محدوده موردنظر مقیاس میدهد.
total_norm = ( torch.nn.utils.clip_grad_norm_( model.parameters(), max_norm=1.0, ))در مستندات PyTorch، اندازه کلی گرادیانها چنان محاسبه میشود که گویی گرادیانهای پارامترها به یک بردار واحد متصل شدهاند. تابع گرادیانها را درجا تغییر میدهد و اندازه کلی پیش از برش را برمیگرداند. PyTorch main documentation
این مقدار برگشتی برای ثبت و عیبیابی بسیار مفید است.
برش مقدار هر جزء: clip_grad_value_
روش دوم، مقدار هر جزء گرادیان را به یک بازه محدود میکند:
torch.nn.utils.clip_grad_value_( model.parameters(), clip_value=0.5,)در این نمونه، هر مقدار گرادیان به بازهای میان منفی 0.5 و مثبت 0.5 محدود میشود. مستندات PyTorch تصریح میکند که این تابع نیز گرادیانها را درجا تغییر میدهد. PyTorch main documentation
تفاوت دو روش در یک نگاه
| ویژگی | برش اندازه کلی | برش مقدار |
|---|---|---|
| تابع PyTorch | clip_grad_norm_ | clip_grad_value_ |
| چیزی که محدود میشود | اندازه کلی گرادیان پارامترهای انتخابشده | مقدار هر جزء گرادیان |
| حفظ نسبی جهت گرادیان هنگام مقیاسدهی | معمولاً بله | ممکن است تغییر کند |
| ورودی اصلی | max_norm | clip_value |
| کاربرد برای شروع عیبیابی | رایج و قابلردیابی | مناسب برای آزمایشهای مشخص |
در بسیاری از مثالهای آموزشی، برش اندازه کلی نقطه شروع روشنتری است؛ اما نوع و آستانه مناسب باید برای مسئله شما آزمایش شود.
یک مثال کوچک برای فهم برش اندازه
در کد زیر گرادیان یک پارامتر را بهصورت دستی تعیین میکنیم تا اثر تابع را مستقیم ببینیم:
import torchparameter = torch.nn.Parameter( torch.zeros(2))parameter.grad = torch.tensor( [3.0, 4.0])norm_before = ( torch.nn.utils.clip_grad_norm_( [parameter], max_norm=1.0, ))print( "Norm before:", norm_before.item(),)print( "Gradient after:", parameter.grad,)print( "Norm after:", parameter.grad.norm().item(),)اندازه اولیه این گرادیان برابر ۵ است. با max_norm=1.0، گرادیان به اندازهای کوچک میشود که اندازه پس از برش نزدیک به ۱ باشد. مقدار برگشتی تابع همچنان اندازه پیش از برش را گزارش میکند؛ بنابراین آن را با اندازه نهایی اشتباه نگیرید. PyTorch main documentation
مقدار مناسب max_norm چقدر است؟
یک عدد مناسب برای همه مدلها وجود ندارد. انتخاب max_norm به معماری، مقیاس Loss، طول توالی، اندازه Batch و تنظیمات آموزش وابسته است.
بهجای کپیکردن یک عدد از پروژهای دیگر:
- ابتدا اندازه گرادیانها را بدون برش ثبت کنید.
- ببینید جهشهای بزرگ چند وقت یک بار رخ میدهند.
- رفتار Loss و Validation را کنار اندازه گرادیان بررسی کنید.
- چند آستانه معقول را مقایسه کنید.
- تعداد دفعات فعالشدن برش را ثبت کنید.
اگر تقریباً در همه گامها گرادیانها برش میخورند، ممکن است آستانه بیشازحد کوچک باشد یا لازم باشد مشکل دیگری در آموزش بررسی شود. اگر هیچوقت برش رخ نمیدهد، این تنظیم در اجرای فعلی عملاً اثری ندارد.
اینها قواعد تشخیصیاند، نه معیار قطعی خوب یا بد بودن مدل.
آموزش عملی Gradient Clipping درPyTorch
برای مثال عملی، یک مسئله طبقهبندی توالی میسازیم. مدل باید از روی یک توالی عددی پیشبینی کند که مجموع مقادیر آن در کدام سمت یک مرز قرار میگیرد.
از یک شبکه بازگشتی ساده استفاده میکنیم تا بتوانیم اندازه گرادیانها را در آموزش توالی بررسی کنیم.
محدودیت مثال: این داده مصنوعی تضمین نمیکند گرادیان انفجاری رخ دهد. اگر در خروجی شما برش گرادیان کمتعداد یا بیاثر بود، این یک نتیجه معتبر از همان پیکربندی است؛ نباید برای ادعای اثربخشی آن عددی ساختگی گزارش کرد.
نصب کتابخانهها
pip install torch scikit-learn matplotlibساخت داده و تقسیم Train، Validation وTest
import numpy as npimport torchfrom sklearn.model_selection import ( train_test_split,)from torch.utils.data import ( DataLoader, TensorDataset,)SEED = 42SEQUENCE_LENGTH = 30NUM_SAMPLES = 3000BATCH_SIZE = 64EPOCHS = 18rng = np.random.default_rng( SEED)torch.manual_seed(SEED)device = torch.device( "cuda" if torch.cuda.is_available() else "cpu")sequences = rng.normal( size=( NUM_SAMPLES, SEQUENCE_LENGTH, 1, )).astype(np.float32)مجموعه Test در تنظیم آستانه برش یا انتخاب پیکربندی شرکت نمیکند.
ساخت مدل بازگشتی
from torch import nnclass SequenceClassifier(nn.Module): def __init__( self, hidden_size=48, ): super().__init__() self.rnn = nn.RNN( input_size=1, hidden_size=hidden_size, num_layers=1, nonlinearity="tanh", batch_first=True, ) self.classifier = nn.Linear( hidden_size, 1, ) def forward(self, sequences): outputs, hidden = self.rnn( sequences ) last_hidden = hidden[-1] return self.classifier( last_hidden )nn.RNN در اینجا برای نمایش فرایند آموزش توالی و بررسی گرادیانها استفاده شده است. برای یک مسئله واقعی، انتخاب میان RNN، GRU، LSTM یا معماری دیگر باید بر اساس داده و معیار ارزیابی انجام شود.
تابع ارزیابی
def evaluate( model, data_loader, device,): model.eval() criterion = nn.BCEWithLogitsLoss( reduction="sum" ) total_loss = 0.0 total_correct = 0 total_samples = 0 with torch.inference_mode(): for sequences, labels in ( data_loader ): sequences = sequences.to( device ) labels = labels.to( device ) logits = model( sequences ) total_loss += criterion( logits, labels, ).item()از BCEWithLogitsLoss استفاده کردهایم، بنابراین خروجی مدل یک امتیاز خام است و برای تصمیم دودویی میتوان آن را با صفر مقایسه کرد.
ثبت اندازه گرادیان بدون اعمال برش
اگر میخواهید مقدار گرادیانها را در اجرای بدون Clipping نیز ثبت کنید، میتوانید اندازه کلی آنها را جداگانه محاسبه کنید:
def measure_gradient_norm(model): gradient_norms = [] for parameter in ( model.parameters() ): if parameter.grad is None: continue gradient_norms.append( parameter.grad.detach() .norm(2) ) if not gradient_norms: return 0.0 return ( torch.stack( gradient_norms ) .norm(2) .item() )این تابع گرادیانها را تغییر نمیدهد. در مقابل، clip_grad_norm_ هم اندازه را گزارش میکند و هم در صورت نیاز گرادیانها را درجا محدود میکند.
مقایسه آموزش با و بدونClipping
در تابع زیر دو اجرای جدا خواهیم داشت. معماری، بذر ساخت مدل، داده و ترتیب Batchها یکساناند؛ تفاوت در فعالبودن یا نبودن برش گرادیان است.
from copy import deepcopydef train_experiment( use_clipping, train_dataset, val_dataset, device,): torch.manual_seed(SEED) model = SequenceClassifier().to( device ) criterion = nn.BCEWithLogitsLoss() optimizer = torch.optim.AdamW( model.parameters(), lr=0.002, weight_decay=0.001, ) generator = torch.Generator() generator.manual_seed( SEED ) train_loader = DataLoader( train_dataset, batch_size=BATCH_SIZE, shuffle=True, generator=generator, ) val_loader = DataLoader(در این کد، مقدار ثبتشده در gradient_norms برای اجرای دارایClipping، اندازه پیش از برش است؛ زیرا این همان چیزی است که clip_grad_norm_ برمیگرداند. PyTorch main documentation
گزینه error_if_nonfinite=True باعث میشود اگر اندازه کلی گرادیان nan یا بینهایت باشد، خطا ثبت شود. این گزینه ابزاری برای آشکارکردن مشکل است؛ علت پیدایش مقادیر نامعتبر را برطرف نمیکند. PyTorch main documentation
اجرای دو پیکربندی
without_clipping = train_experiment( use_clipping=False, train_dataset=train_dataset, val_dataset=val_dataset, device=device,)with_clipping = train_experiment( use_clipping=True, train_dataset=train_dataset, val_dataset=val_dataset, device=device,)print( "Best validation loss " "without clipping:", without_clipping[ "best_val_loss" ],)print( "Best validation loss " "with clipping:", with_clipping[ "best_val_loss" ],)اگر اجرای بدون Clipping در مسئله شما از همان ابتدا پایدار باشد و اندازه گرادیانها بهندرت از ۱ فراتر رود، نباید انتظار داشت محدودکردن آنها بهطور خودکار کیفیت مدل را بهتر کند.
رسم نمودار اندازه گرادیانها
import matplotlib.pyplot as pltplt.figure( figsize=(10, 5))for label, result in ( ( "Without clipping", without_clipping, ), ( "With clipping", with_clipping, ),): history = result[ "history" ] epochs = [ row["epoch"] for row in history ] max_norms = [ row["max_grad_norm"] for row in history ] plt.plot( epochs, max_norms, label=label, )خط قرمز آستانه برش را نشان میدهد. توجه کنید نمودار اندازه پیش از برش را نمایش میدهد؛ پس مشاهده نقاط بالاتر از خط در اجرای دارای Clipping، به معنی اجرا نشدن تابع برش نیست.
نمودار Loss وAccuracy
figure, axes = plt.subplots( 1, 2, figsize=(12, 4),)for label, result in ( ( "Without clipping", without_clipping, ), ( "With clipping", with_clipping, ),): history = result[ "history" ] epochs = [ row["epoch"] for row in history ] val_losses = [ row["val_loss"] for row in history ] val_accuracies = [ row["val_accuracy"] for row in history ] axes[0].plot(برای نتیجهگیری، فقط بزرگی گرادیان را نگاه نکنید. باید دید آیا تغییر آن به آموزش پایدارتر و عملکرد بهتر رویValidation منجر شده است یا خیر.
انتخاب پیکربندی و ارزیابی نهایی
پس از مقایسه روی Validation، پیکربندی بهتر را انتخاب و فقط همان مدل را روی Test ارزیابی کنید:
candidates = { "without_clipping": ( without_clipping ), "with_clipping": ( with_clipping ),}selected_name = min( candidates, key=lambda name: ( candidates[name][ "best_val_loss" ] ),)test_loader = DataLoader( test_dataset, batch_size=BATCH_SIZE, shuffle=False,)selected_model = candidates[ selected_name]["model"]test_metrics = evaluate( selected_model, test_loader, device,)print( "Selected setup:",در این مقاله نتیجه عددی اجرای کد را از پیش اعلام نمیکنیم. نوع دستگاه، نسخه کتابخانهها و جزئیات اجرا میتوانند بر نتیجه اثر بگذارند.
برش گرادیان باGradient Accumulation
انباشت گرادیان زمانی به کار میرود که بخواهید گرادیان چند مینیبچ را جمع کنید و سپس یک بار optimizer.step() انجام دهید.
در این حالت، برش گرادیان را معمولاً بعد از تکمیل انباشت و پیش از گام بهینهساز اجرا میکنید. اگر پس از هر backward() گرادیانها را برش دهید، عملیات برش روی گرادیان نهاییِ انباشتهشده انجام نشده است.
نمونه زیر فرض میکند train_loader با drop_last=True ساخته شده و تعداد Batchها با تعداد گامهای انباشت سازگار است:
ACCUMULATION_STEPS = 4optimizer.zero_grad()for batch_index, ( sequences, labels,) in enumerate( train_loader, start=1,): sequences = sequences.to( device ) labels = labels.to( device ) logits = model( sequences ) loss = criterion( logits, labels, ) scaled_loss = ( loss / ACCUMULATION_STEPS ) scaled_loss.backward() if (در کد تولیدی باید وضعیت Batchهای باقیمانده در پایان Epoch را نیز مدیریت کنید؛ در غیر این صورت ممکن است آخرین گرادیانهای انباشتهشده اصلاً به گام بهینهساز نرسند. همچنین اگر گروه پایانی کوچکتر است، نحوه مقیاسکردن Loss آن گروه را آگاهانه تعیین کنید.
برش گرادیان در آموزش با دقت ترکیبی یاAMP
وقتی از GradScaler استفاده میکنید، گرادیانهای حاصل از scaler.scale(loss).backward() مقیاسدار هستند. پیش از اندازهگیری یا برش آنها باید با scaler.unscale_(optimizer) مقیاس را برگردانید:
optimizer.zero_grad()with torch.autocast( device_type="cuda", dtype=torch.float16,): logits = model( inputs ) loss = criterion( logits, targets, )scaler.scale( loss).backward()scaler.unscale_( optimizer)torch.nn.utils.clip_grad_norm_( model.parameters(), max_norm=1.0,)scaler.step( optimizer)scaler.update()این قطعه برای اجرای CUDA با AMP نوشته شده و فرض میکند scaler، model، optimizer، inputs، targets و criterion از پیش ساخته شدهاند.
ترتیب unscale_ و سپس Clipping مهم است: اگر گرادیانهای هنوز مقیاسدار را برش دهید، آستانهای که تعیین کردهاید دیگر نسبت به گرادیان واقعی معنای موردنظر را ندارد. دستورالعمل رسمی PyTorch همین ترتیب را نشان میدهد. PyTorch Tutorials 2.14.0+cu130 documentation
آیا Gradient Clipping خطای nan را برطرف میکند؟
لزومی ندارد.
اگر گرادیان یاLoss پیش از اجرایClipping نامعتبر شده باشد، صرف محدودکردن گرادیان یک راهحل مطمئن نیست. ابتدا علت را پیدا کنید.
مواردی که باید بررسی شوند:
- داده ورودی شامل
nanیاinfنباشد. - برچسبها و محدوده آنها درست باشند.
- تابع Loss با خروجی مدل هماهنگ باشد.
- نرخ یادگیری بسیار بزرگ نباشد.
- محاسبات AMP با ترتیب درست انجام شوند.
- عملیات سفارشی مدل ناپایداری عددی ایجاد نکنند.
- Lossپیش از
backward()مقدار معتبر داشته باشد.
مستندات PyTorch برای clip_grad_norm_ گزینه error_if_nonfinite را ارائه میکند تا وجود اندازه گرادیان نامعتبر آشکار شود. این گزینه ابزار تشخیص است. PyTorch main documentation
آیا با AdamW هم باید Gradient Clipping استفاده کرد؟
AdamWبهروزرسانی پارامترها را بهصورت تطبیقی انجام میدهد، اما استفاده از آن بهتنهایی تضمین نمیکند هر نوع ناپایداری ناشی از گرادیانهای بزرگ از بین برود.
میتوانید AdamW و Gradient Clipping را با هم به کار ببرید؛ همانطور که در مثال عملی انجام دادیم. بااینحال، ضرورت و آستانه مناسب آن باید بر اساس رفتار آموزش بررسی شود.
اگر مدل با AdamW پایدار است و برش هیچوقت فعال نمیشود، وجود این دستور ممکن است تغییری در نتیجه ایجاد نکند.
تفاوت Gradient Clipping با کاهشLearning Rate
هر دو میتوانند بر اندازه تغییر وزنها اثر بگذارند، اما سازوکارشان متفاوت است:
| روش | چه چیزی را تغییر میدهد؟ | زمان اثر |
|---|---|---|
| کاهش Learning Rate | اندازه کلی گامهای بهینهساز | تا زمانی که نرخ جدید برقرار باشد |
| Gradient Clipping | گرادیانهای بزرگتر از حد انتخابشده | فقط در گامهایی که آستانه فعال میشود |
اگر تقریباً همه گرادیانها در هر مرحله برش میخورند، بررسی نرخ یادگیری و آستانه Clipping اهمیت بیشتری پیدا میکند. برای تشخیص دقیقتر، فراوانی برش و عملکردValidation را همراه هم ثبت کنید.
تفاوت Gradient Clipping باWeight Decay
Weight Decay به فرایند بهروزرسانی وزنها مربوط است. Gradient Clippingروی گرادیانهای محاسبهشده پیش از گام بهینهساز اعمال میشود.
بنابراین استفاده از Weight Decay جایگزین بررسی گرادیانهای بسیار بزرگ نیست و Clipping نیز همان نقش Weight Decay را انجام نمیدهد.
آیا در Transformer هم از Gradient Clipping استفاده میشود؟
امکان استفاده از آن وجود دارد. سازوکار برش به RNN محدود نیست و میتوان آن را برای پارامترهای مدلهای دیگر نیز اعمال کرد.
بااینحال، آستانه و شیوه اجرا باید با حلقه آموزش همان مدل هماهنگ باشد. در آموزشهای بزرگتر، عواملی مانند انباشت گرادیان، دقت ترکیبی و آموزش توزیعشده بر محل صحیح اندازهگیری و برش گرادیان اثر میگذارند.
در پیادهسازیهای توزیعشده، پیش از کپیکردن یک دستور ساده از مدل تکدستگاهی، راهنمای رسمی همان روش توزیعشده را بررسی کنید. برای مثال، مستندات PyTorch در بعضی پیکربندیهای FSDP روش اختصاصی برش اندازه گرادیان را مطرح میکند. PyTorch main documentation
اشتباهات رایج هنگامGradient Clipping
اجرای برش پیش از loss.backward()
در آن لحظه گرادیانهای مرحله فعلی هنوز محاسبه نشدهاند. ترتیب معمول: پاککردن گرادیانها، پسانتشار، برش و سپس گام بهینهساز است.
اجرای برش پس از optimizer.step()
بهینهساز قبلاً از گرادیانهای بدون برش برای همان بهروزرسانی استفاده کرده است.
تفسیر خروجی clip_grad_norm_ بهعنوان اندازه پس از برش
مقدار برگشتی این تابع اندازه کلی گرادیانها پیش از تغییر آنها است. PyTorch main documentation
انتخاب آستانه بدون ثبت اندازه گرادیان
اگر نمیدانید اندازه معمول گرادیانها چقدر است، نمیدانید آستانه شما چند بار فعال میشود.
برش بیشازحد شدید
اگر آستانه بسیار کوچک باشد، ممکن است بخش زیادی از بهروزرسانیهای مدل محدود شود و آموزش کند یا ناکافی پیش برود.
استفاده از Clipping برای پنهانکردن مشکل داده
وجود nan، برچسب اشتباه یا محاسبه نامعتبر باید در منبع آن بررسی شود.
برش گرادیانهای AMP پیش از unscale_
در این حالت آستانه برش روی گرادیانهای مقیاسدار اعمال میشود. ابتدا scaler.unscale_(optimizer) را اجرا کنید. PyTorch Tutorials 2.14.0+cu130 documentation
برش در میانه انباشت گرادیان بدون توجه به هدف
اگر هدف محدودکردن گرادیان نهاییِ چند Batch است، برش را پس از تکمیل انباشت و پیش از گام بهینهساز انجام دهید.
فرض اینکه Clipping همیشه دقت را بالا میبرد
ممکن است هیچ گرادیانی به آستانه نرسد، یا آستانه نامناسب کیفیت یادگیری را کاهش دهد. اثر را روی Validation بسنجید.
چگونه Gradient Clipping را در پروژه واقعی ارزیابی کنیم؟
یک روال عملی:
- چند اجرای بدون Clipping انجام دهید و اندازه گرادیانها را ثبت کنید.
- زمانهای جهش Loss یا ناپایداری را با اندازه گرادیان مقایسه کنید.
- یک روش برش، مثلاً
clip_grad_norm_، انتخاب کنید. - چند مقدار
max_normرا روی Validation آزمایش کنید. - درصد گامهایی را که واقعاً برش خوردهاند گزارش دهید.
- منحنی Train Loss، Validation Loss و معیار نهایی را مقایسه کنید.
- اگر نتیجه کوچک یا متغیر است، آزمایش را با چند بذر تصادفی تکرار کنید.
- پس از انتخاب تنظیمات، ارزیابی نهایی را روی Test کنارگذاشتهشده انجام دهید.
این روال کمک میکند Clipping را بهعنوان یک تنظیم قابلاندازهگیری بررسی کنید، نه دستوری که بدون دلیل به هر حلقه آموزش اضافه شود.
پرسشهای متداول
Gradient Clippingچیست؟
روشی است که پیش از گام بهینهساز، اندازه کلی یا مقدار گرادیانها را به حد تعیینشده محدود میکند.
گرادیان انفجاری چیست؟
وضعیتی است که در آن گرادیانهای بسیار بزرگ میتوانند آموزش را ناپایدار کنند یا به تغییرات شدید پارامترها منجر شوند.
تفاوت clip_grad_norm_ و clip_grad_value_ چیست؟
اولی اندازه کلی گرادیانهای پارامترهای انتخابشده را محدود میکند. دومی هر مقدار گرادیان را در یک بازه مشخص نگه میدارد.
max_norm=1.0 همیشه بهترین انتخاب است؟
خیر. این مقدار تنها یک تنظیم قابلآزمایش است. آستانه مناسب به مدل، Loss و رفتار گرادیانها بستگی دارد.
آیا Clipping فقط برای RNN است؟
خیر. پژوهشهای مربوط به RNN در شناختهشدن این روش مهم بودهاند، اما ابزار PyTorch را میتوان در مدلهای دیگر نیز به کار برد.
آیا Clipping مشکل گرادیان محوشونده را حل میکند؟
خیر. برش، گرادیانهای بزرگ را محدود میکند و گرادیانهای کوچک را بهطور خودکار افزایش نمیدهد.
چه زمانی دستور Clipping را اجرا کنیم؟
پس از loss.backward() و پیش از optimizer.step(). اگر از AMP با GradScaler استفاده میکنید، پس از scaler.unscale_(optimizer) آن را اجرا کنید.
خروجی clip_grad_norm_ چه چیزی است؟
اندازه کلی گرادیانها پیش از برش را برمیگرداند. از این مقدار میتوان برای ثبت و تشخیص تعداد گامهای مشمول برش استفاده کرد. PyTorch main documentation
آیا با Clipping دیگر به تنظیم Learning Rate نیاز نداریم؟
خیر. نرخ یادگیری همچنان یکی از تنظیمات اصلی آموزش است و باید جداگانه ارزیابی شود.
چرا با وجود Clipping هنوز Loss من nan میشود؟
ممکن است Loss پیش از پسانتشار نامعتبر شده باشد، ورودیها مشکل داشته باشند یا ناپایداری عددی دیگری رخ دهد. مقدار داده، Loss و گرادیان را در مرحلهای که نخستین بار نامعتبر میشوند بررسی کنید.
جمعبندی
Gradient Clippingابزاری برای محدودکردن گرادیانهای بزرگ پیش از بهروزرسانی وزنها است. درPyTorch، clip_grad_norm_ اندازه کلی گرادیانها و clip_grad_value_ مقدار اجزای آنها را محدود میکند.
برای استفاده درست، محل فراخوانی تابع در حلقه آموزش را رعایت کنید، اندازه گرادیان پیش از برش را ثبت کنید و فراوانی فعالشدن آستانه را بسنجید. هنگام انباشت گرادیان، برش را متناسب با گام واقعی بهینهساز انجام دهید؛ هنگام استفاده از AMP نیز ابتدا گرادیانها را از حالت مقیاسدار خارج کنید.
مهمترین معیار انتخاب، عملکرد پایدار روی داده اعتبارسنجی است. Clipping زمانی ارزش دارد که در مسئله واقعی شما به کنترل آموزش کمک کند.
از آموزش مدل تا استفاده از هوش مصنوعی در محصول
اگر برای بخشی از محصول خود مدل اختصاصی آموزش میدهید، کنترل گرادیان یکی از جزئیات مهم توسعه آن است. برای قابلیتهایی که میخواهید از مدلهای آماده استفاده کنند نیز میتوانید مدلها و خدمات API درواره را بررسی کنید. درواره دسترسی یکپارچه به مدلهای هوش مصنوعی را برای توسعهدهندگان ارائه میکند؛ انتخاب هر مدل را با نیاز فنی و شرایط فعلی سرویس تطبیق دهید. hub.darvareh.ir
برای بررسی خدمات و شروع اتصال محصول، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- شبکه عصبی بازگشتی، LSTM و GRU چیست؟
- گرادیان کاهشی در یادگیری ماشین
- Adam چیست؟ مقایسه AdamW و SGD با PyTorch
- مقداردهی اولیه وزنها با Xavier وHe
- Batch Normalizationچیست؟
- Early Stoppingچیست؟
- Transformer و Self-Attentionچیست؟
- PyTorchچیست؟
- آموزش استفاده از API هوش مصنوعی
منابع
- Pascanu، Mikolov و Bengio: On the Difficulty of Training Recurrent Neural Networks
- مستندات PyTorch: تابع
clip_grad_norm_ - مستندات PyTorch: تابع
clip_grad_value_ - راهنمای رسمیPyTorch: Automatic Mixed Precision
- مستندات PyTorch: نمونههای AMP و برش گرادیان
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و صفحه سلب مسئولیت درواره را نیز مطالعه کنید.



