
Regularization چیست؟ آموزش L1، L2 و Weight Decay با Python و PyTorch
Regularization چیست و L1، L2 و Weight Decay چه تفاوتی دارند؟ در این آموزش، نقش منظمسازی در کنترل بیشبرازش، تفاوت Ridge و Lasso، مفهوم AdamW و روش انتخاب تنظیمات با کد عملی Python و PyTorchرا میآموزید.

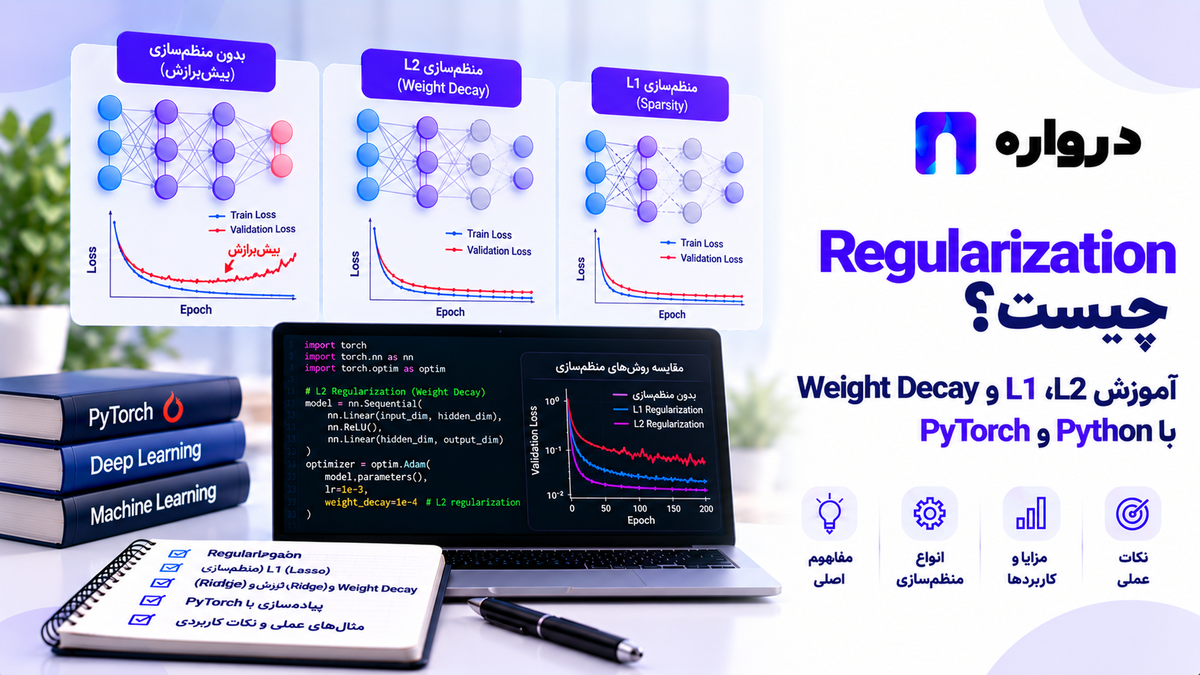
مدلی را تصور کنید که روی داده آموزش عملکرد بسیار خوبی دارد، اما روی نمونههای جدید اشتباه میکند. یکی از علتهای احتمالی، بیشبرازش است: مدل به جای یادگیری الگوهایی که به داده جدید تعمیم مییابند، بیشازحد به جزئیات داده آموزش وابسته شده است.
Regularization یا منظمسازی نام خانوادهای از روشهاست که به کنترل رفتار و پیچیدگی مدل کمک میکنند. دو روش شناختهشده در مدلهای آماری و یادگیری ماشین L1 و L2 هستند. در آموزش شبکههای عصبی نیز زیاد با گزینهای به نام Weight Decay روبهرو میشوید.
این مفاهیم به هم نزدیکاند، اما نباید آنها را در همه شرایط معادل فرض کرد:
- L1 اندازه مطلق ضرایب را در جریمه مدل در نظر میگیرد و در مدلهایی مانند Lasso میتواند برخی ضرایب را دقیقاً صفر کند.
- L2 ضرایب بزرگ را بیشتر جریمه میکند و در مدلهایی مانند Ridge معمولاً باعث کوچکشدن آنها میشود.
- Weight Decay وزنها را هنگام فرایند بهروزرسانی کوچک میکند. رابطه دقیق آن با جریمه L2 به نوع بهینهساز بستگی دارد.
مقاله اصلی AdamW نشان میدهد که جریمه L2 و Weight Decay مستقل در بهینهسازهای تطبیقی مانند Adam رفتار یکسانی ندارند. بنابراین در پروژه PyTorch باید دقیق بدانید هر گزینه چه کاری انجام میدهد. arxiv.org
در این مقاله ابتدا مفهومها را توضیح میدهیم، سپس Ridge، Lasso و Elastic Net را روی یک داده جدولی مقایسه میکنیم و در پایان پیادهسازی جریمه وزنها و AdamW را در PyTorch میبینیم.
منظمسازی قرار است چه مشکلی را حل کند؟
در آموزش معمول، مدل تلاش میکند خطای پیشبینی روی نمونههای Train را کاهش دهد. اگر مدل انعطاف زیادی داشته باشد، ممکن است برای کاهش همین خطا به ضرایبی برسد که روی دادههای دیگر خوب کار نمیکنند.
منظمسازی یک محدودیت یا ترجیح اضافی وارد فرایند آموزش میکند. برای مثال، ممکن است مدل را به سمت استفاده از ضرایب کوچکتر سوق دهد.
هدف عملی این است که میان دو خواسته تعادل برقرار کنیم:
- مدل اطلاعات مفید داده آموزش را یاد بگیرد.
- تصمیمهای آن روی نمونههای جدید نیز قابلاتکا باشد.
منظمسازی شدید هم میتواند مشکل ایجاد کند. اگر مدل را بیشازحد محدود کنیم، ممکن است حتی الگوهای اصلی Train را نیز یاد نگیرد. به همین دلیل، شدت منظمسازی باید با داده اعتبارسنجی انتخاب شود.
بیشبرازش و کمبرازش چه ارتباطی با Regularization دارند؟
دو حالت رایج:
- بیشبرازش: خطای Train کم است، اما خطای Validation بهمراتب بیشتر است.
- کمبرازش: مدل حتی روی Train نیز بهخوبی الگوهای داده را یاد نمیگیرد.
افزایش منظمسازی گاهی به کاهش بیشبرازش کمک میکند. اما اگر مقدار آن بیشازحد زیاد باشد، خود میتواند به کمبرازش منجر شود.
پس پرسش مناسب این نیست که «چطور بیشترین Regularization را اعمال کنیم؟»؛ پرسش این است که چه مقدار منظمسازی برای هدف و داده این مدل مناسب است؟
منظمسازی L1 چیست؟
در L1 Regularization، مدل بابت بزرگی مقدار مطلق ضرایب جریمه میشود. در مدل رگرسیون خطی، روش Lasso از این ایده استفاده میکند.
ویژگی مهم Lasso این است که بسته به داده و شدت منظمسازی، میتواند بعضی ضرایب را دقیقاً صفر کند. در نتیجه مدلی با ضرایب پراکندهتر میسازد. این رفتار در مقاله اصلی رابرت تیبشیرانی درباره Lasso و مستندات رسمی scikit-learn توضیح داده شده است. Oxford Academic
اگر یک مدل خطی ۵۰ ویژگی ورودی دارد و ضریب ۳۰ ویژگی پس از آموزش دقیقاً صفر شده است، آن ۳۰ ویژگی در پیشبینی همان مدل سهم مستقیمی ندارند.
اما صفرشدن ضریب بهتنهایی اثبات نمیکند یک ویژگی در جهان واقعی بیاهمیت است. انتخاب ویژگی به نمونههای آموزشی، همبستگی میان ویژگیها، شدت جریمه و شیوه پیشپردازش وابسته است.
Lassoچه زمانی مفید است؟
Lassoمیتواند نقطه شروع مناسبی باشد وقتی:
- داده جدولی با تعداد زیادی ویژگی دارید.
- میخواهید یک مدل خطی با ضرایب قابلبررسی بسازید.
- احتمال میدهید بعضی ویژگیها سهم محدودی داشته باشند.
- میخواهید اثر انتخاب ویژگی را در کنار کیفیت پیشبینی بررسی کنید.
اگر چند ویژگی بسیار به هم شبیهاند، تفسیر انتخاب یک ویژگی و حذف دیگری باید با احتیاط انجام شود. Lasso قرار نیست بهتنهایی رابطه علّی میان ویژگی و خروجی را کشف کند.
منظمسازی L2 چیست؟
در L2 Regularization، ضرایب بزرگ جریمه بیشتری میگیرند. Ridge Regression یک نمونه شناختهشده از مدل خطی دارای جریمه L2 است.
در Ridge، ضرایب معمولاً به سمت مقادیر کوچکتر حرکت میکنند؛ اما انتظار نداریم این روش مانند Lasso بهطور معمول آنها را دقیقاً صفر کند. مستندات scikit-learn، Ridge را رگرسیونی با منظمسازی L2 معرفی میکند. scikit-learn 1.9.1 documentation
این رفتار میتواند وقتی مفید باشد که چند ویژگی اطلاعات مشترک دارند و نمیخواهید مدل را وادار کنید بسیاری از ضرایب را کاملاً حذف کند.
تفاوت رفتاری L1 وL2
| ویژگی | L1 | L2 |
|---|---|---|
| مدل خطی شناختهشده | Lasso | Ridge |
| اثر رایج بر ضرایب | کوچککردن و گاهی صفرکردن دقیق | کوچککردن ضرایب |
| امکان ساخت ضرایب پراکنده | بله | معمولاً خیر |
| استفاده برای بررسی انتخاب ویژگی | رایج | کاربرد اصلی آن نیست |
| نیاز به تنظیم شدت جریمه | بله | بله |
| تضمین عملکرد بهتر روی هر مسئله | ندارد | ندارد |
رفتار واقعی این دو به داده، مقیاس ویژگیها و تنظیمات مدل وابسته است.
Elastic Netچیست؟
Elastic Net ترکیبی از جریمههای L1 و L2 را در یک مدل خطی به کار میگیرد.
این روش زمانی ارزش آزمایش دارد که بخواهید هم اثر ضرایب پراکندهتر را بررسی کنید و هم از بخش L2 بهره بگیرید. در scikit-learn، پارامتر l1_ratio نسبت سهم L1 در این ترکیب را کنترل میکند. مستندات رسمی Elastic Net آن را مدلی با هر دو نوع منظمسازی معرفی میکند. scikit-learn 1.9.1 documentation
Elastic Net بهصورت خودکار از Ridge و Lasso بهتر نیست. مانند سایر روشها، باید آن را روی Validationارزیابی کرد.
alpha چه چیزی را کنترل میکند؟
در مدلهای Ridge، Lasso و ElasticNet در scikit-learn، پارامتر alpha به شدت منظمسازی مربوط است.
در مقایسه عملی:
- مقدار بسیار کوچک ممکن است محدودیت کمی بر ضرایب ایجاد کند.
- مقدار بسیار بزرگ ممکن است مدل را بیشازحد محدود کند.
- مقدار مناسب را باید با داده اعتبارسنجی تعیین کرد.
عدد یکسان alpha الزاماً به معنی اثر یکسان در Lasso، Ridge و Elastic Net نیست. تعریف جریمه، داده و مقیاس آن در تفسیر نتیجه دخیلاند؛ بنابراین مقادیر کاندید را برای هر خانواده مدل جداگانه انتخاب کنید.
چرا مقیاسبندی ویژگیها مهم است؟
فرض کنید یک ستون مقدارهای بین صفر و یک دارد و ستونی دیگر مقدارهایی در حد چند میلیون. جریمهکردن ضرایب بدون توجه به مقیاس ویژگیها میتواند مقایسه و تفسیر آنها را دشوار کند.
برای مدلهای خطی دارای جریمه، معمولاً ویژگیها را مقیاسبندی میکنیم. اما مقیاسساز باید فقط روی Train برازش شود و سپس همان تبدیل روی Validation و Test اعمال شود.
استفاده از Pipeline در scikit-learn کمک میکند پیشپردازش و مدل در یک جریان مشخص قرار بگیرند و خطر نشت اطلاعات مجموعه ارزیابی به آموزش کاهش یابد. scikit-learn 1.8.0 documentation
آموزش عملی L1، L2 و Elastic Net باPython
در این بخش یک مسئله رگرسیون میسازیم و چهار خانواده مدل را مقایسه میکنیم:
- رگرسیون خطی بدون جریمه بهعنوانBaseline.
- Ridge با L2.
- Lasso با L1.
- Elastic Net با ترکیب L1 و L2.
سپس مدل منتخب را فقط یک بار روی Test ارزیابی میکنیم.
نصب کتابخانهها
pip install numpy scikit-learn matplotlibساخت داده و تقسیم آن
import numpy as npfrom sklearn.datasets import ( make_regression,)from sklearn.model_selection import ( train_test_split,)SEED = 42X, y = make_regression( n_samples=900, n_features=50, n_informative=8, noise=20.0, random_state=SEED,)X = X.astype(np.float32)y = y.astype(np.float32)X_train_val, X_test, y_train_val, y_test = ( train_test_split( X, y, test_size=0.20, random_state=SEED, ))X_train, X_val, y_train, y_val = ( train_test_split( X_train_val,n_informative=8 نحوه ساخت داده مصنوعی را تعیین میکند. این به آن معنا نیست که هر مدل باید دقیقاً ۸ ضریب غیرصفر یاد بگیرد. نویز، نمونهگیری و شدت جریمه بر نتیجه اثر میگذارند.
تعریف مدلها و مقادیر کاندید
برای هر مدل از Pipeline استفاده میکنیم تا مقیاسبندی تنها بر اساس داده Train یاد گرفته شود.
from sklearn.linear_model import (
    ElasticNet,
    Lasso,
    LinearRegression,
    Ridge,
)

from sklearn.pipeline import (
    make_pipeline,
)

from sklearn.preprocessing import (
    StandardScaler,
)


candidates = {
    "linear": [
        make_pipeline(
            StandardScaler(),
            LinearRegression(),
        )
    ],

    "ridge": [
        make_pipeline(
            StandardScaler(),
            Ridge(
                alpha=alpha,
            ),
        )
        for alpha in (
            0.1,
            1.0,
            10.0,
            100.0,
        )
    ],

    "lasso": [
        make_pipeline(
            StandardScaler(),
            Lasso(
                alpha=alpha,
                max_iter=20000,
            ),
        )
        for alpha in (
            0.01,
            0.1,
            1.0,
            10.0,
        )
    ],

    "elastic_net": [
        make_pipeline(
            StandardScaler(),
            ElasticNet(
                alpha=alpha,
                l1_ratio=l1_ratio,
                max_iter=20000,
            ),
        )
        for alpha in (
            0.01,
            0.1,
            1.0,
            10.0,
        )
        for l1_ratio in (
            0.25,
            0.5,
            0.75,
        )
    ],
}
این مقادیر فقط یک شبکه کوچک آموزشی هستند. برای داده واقعی باید بازه کاندیدها را با توجه به رفتار Validation گسترش یا تغییر دهید.
آموزش و مقایسه رویValidation
برای مقایسه از MAE استفاده میکنیم: میانگین قدر مطلق اختلاف میان پیشبینی و مقدار واقعی. هرچه MAE کمتر باشد، از دید این معیار پیشبینی بهتر است.
from sklearn.metrics import ( mean_absolute_error, r2_score,)results = []for family, models in ( candidates.items()): for pipeline in models: pipeline.fit( X_train, y_train, ) train_predictions = ( pipeline.predict( X_train ) ) val_predictions = ( pipeline.predict( X_val ) ) estimator = ( pipeline.steps[-1][1] ) results.append( { "family": family,برای تفسیر نتایج:
- اگر Train MAE بسیار بهتر از Validation MAE است، احتمال بیشبرازش یا تفاوت توزیع دادهها را بررسی کنید.
- اگر با افزایش شدت جریمه هر دو معیار ضعیف میشوند، ممکن است مدل بیشازحد محدود شده باشد.
- اگر اختلاف مدلها بسیار کوچک است، یک تقسیم تصادفی برای انتخاب قطعی کافی نیست.
در این مقاله کد اجرا نشده و هیچ نتیجه عددی ساختگی به آن نسبت نمیدهیم.
انتخاب مدل و ارزیابی نهایی رویTest
best_result = results[0]best_pipeline = ( best_result["pipeline"])test_predictions = ( best_pipeline.predict( X_test ))test_mae = mean_absolute_error( y_test, test_predictions,)test_r2 = r2_score( y_test, test_predictions,)print( "Selected family:", best_result["family"],)print( "Selected alpha:", best_result["alpha"],)print( "Validation MAE:", round( best_result["val_mae"],مجموعه Test در انتخاب روش و مقدار alpha نقشی نداشت. اگر پس از دیدن Test دوباره تنظیمات را با هدف بهترشدن همان Test تغییر دهید، آن مجموعه دیگر ارزیابی مستقل نهایی نخواهد بود.
بررسی تعداد ضرایب صفر
برای مشاهده اثر منظمسازی بر ضرایب، مدلهای برازششده را بررسی میکنیم:
for family in (
    "ridge",
    "lasso",
    "elastic_net",
):
    family_results = [
        row
        for row in results
        if row["family"] == family
    ]

    best_family_result = min(
        family_results,
        key=lambda row: (
            row["val_mae"]
        ),
    )

    estimator = (
        best_family_result[
            "pipeline"
        ]
        .steps[-1][1]
    )

    coefficients = (
        estimator.coef_
    )

    zero_count = int(
        np.count_nonzero(
            coefficients == 0
        )
    )

    print(
        family,
        "zero coefficients:",
        zero_count,
        "of",
        len(coefficients),
    )
چون StandardScaler در Pipeline وجود دارد، ضرایب به ویژگیهای مقیاسبندیشده مربوطاند. برای نتیجهگیری درباره اهمیت ویژگیها در واحدهای اصلی داده باید این موضوع را در نظر بگیرید.
همچنین صفرشدن یک ضریب در Lasso به معنی اثبات بیفایدهبودن آن ویژگی در همه مدلها نیست.
رسم اندازه ضرایب
import matplotlib.pyplot as plt


figure, axes = plt.subplots(
    3,
    1,
    figsize=(12, 9),
    sharex=True,
)

for axis, family in zip(
    axes,
    (
        "ridge",
        "lasso",
        "elastic_net",
    ),
):
    family_results = [
        row
        for row in results
        if row["family"] == family
    ]

    selected = min(
        family_results,
        key=lambda row: (
            row["val_mae"]
        ),
    )

    coefficients = (
        selected["pipeline"]
        .steps[-1][1]
        .coef_
    )

    axis.bar(
        range(
            len(coefficients)
        ),
        coefficients,
    )

    axis.set_title(
        family
    )

    axis.set_ylabel(
        "Coefficient"
    )

axes[-1].set_xlabel(
    "Feature index"
)

plt.tight_layout()
plt.show()
این نمودار برای مشاهده رفتار ضرایب مفید است، اما کیفیت مدل را باید با معیار Validation و Test بررسی کرد؛ صرف کمشدن تعداد ضرایب معیار کافی نیست.
Weight Decayچیست؟
Weight Decay روشی برای کوچککردن وزنها هنگام آموزش است. در کد شبکههای عصبی، معمولاً آن را بهصورت پارامتر بهینهساز میبینید:
optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=0.001,
    weight_decay=0.01,
)
در مستندات فعلیPyTorch، AdamW بهینهسازی است که Weight Decay را بهطور مستقل اعمال میکند تا این بخش در میانگینهای گرادیان Adam انباشته نشود. مقدار پیشفرض weight_decay در مستندات AdamW برابر 0.01 ثبت شده است؛ در پروژه واقعی بهتر است آن را صریح بنویسید. PyTorch main documentation
آیا Weight Decay همان L2 است؟
همیشه خیر. این یکی از مهمترین تفاوتهای این مقاله است.
در بعضی شرایط مرتبط با SGD، میتوان میان جریمه L2 و نوعی از Weight Decay رابطه معادل برقرار کرد؛ البته ضرایب آنها باید متناسب با نرخ یادگیری در نظر گرفته شوند. مقاله AdamW نشان میدهد این معادلبودن به همان شکل برای بهینهسازهای تطبیقی مانند Adam برقرار نیست. arxiv.org
بنابراین هنگام خواندن کد یک مدل، این موارد را جداگانه ببینید:
- آیا L2 به تابعLoss اضافه شده است؟
- آیا پارامتر
weight_decayبه بهینهساز داده شده است؟ - بهینهساز
Adamاست یاAdamW؟ - مقدار Weight Decay برای کدام پارامترها اعمال میشود؟
نام مشابه دو تنظیم، تضمینکننده رفتار یکسان آنها نیست.
تفاوت Adam و AdamW درWeight Decay
در مستندات فعلیPyTorch، torch.optim.Adam گزینه decoupled_weight_decay دارد که مقدار پیشفرض آن False است. torch.optim.AdamW نیز بهطور مشخص با Weight Decay مستقل تعریف شده است. PyTorch main documentation
نمونه:
adam = torch.optim.Adam(
    model.parameters(),
    lr=0.001,
    weight_decay=0.01,
)

adamw = torch.optim.AdamW(
    model.parameters(),
    lr=0.001,
    weight_decay=0.01,
)
این دو پیکربندی را فقط بهدلیل یکسانبودن مقدار weight_decay معادل ندانید. روش اعمال آنها متفاوت است.
پیادهسازی L1 و L2 درPyTorch
برای اضافهکردن جریمه مستقیم به Loss، میتوان مقدار آن را از پارامترهای موردنظر مدل محاسبه کرد.
در مثال زیر، فقط وزنهای ماتریسی را جریمه میکنیم و پارامترهای تکبعدی مانند بایاس را کنار میگذاریم:
import torch
from torch import nn


class SmallRegressor(nn.Module):
    def __init__(
        self,
        input_size,
    ):
        super().__init__()

        self.network = nn.Sequential(
            nn.Linear(
                input_size,
                64,
            ),
            nn.ReLU(),
            nn.Linear(
                64,
                1,
            ),
        )

    def forward(self, features):
        return self.network(
            features
        )


def weight_penalties(model):
    l1_penalty = None
    l2_penalty = None

    for parameter in (
        model.parameters()
    ):
        if parameter.ndim < 2:
            continue

        current_l1 = (
            parameter.abs().sum()
        )

        current_l2 = (
            parameter.square().sum()
        )

        if l1_penalty is None:
            l1_penalty = current_l1
            l2_penalty = current_l2
        else:
            l1_penalty = (
                l1_penalty
                + current_l1
            )

            l2_penalty = (
                l2_penalty
                + current_l2
            )

    if l1_penalty is None:
        raise ValueError(
            "No weight matrices found"
        )

    return (
        l1_penalty,
        l2_penalty,
    )
سپس در حلقه آموزش:
model = SmallRegressor(
    input_size=X_train.shape[1]
).to(device)

optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=0.001,
    weight_decay=0.0,
)

criterion = nn.MSELoss()

L1_STRENGTH = 1e-5
L2_STRENGTH = 1e-5

for features, targets in (
    train_loader
):
    features = features.to(device)

    targets = targets.to(
        device
    ).unsqueeze(1)

    optimizer.zero_grad()

    predictions = model(
        features
    )

    prediction_loss = criterion(
        predictions,
        targets,
    )

    l1_penalty, l2_penalty = (
        weight_penalties(
            model
        )
    )

    total_loss = (
        prediction_loss
        + L1_STRENGTH
        * l1_penalty
        + L2_STRENGTH
        * l2_penalty
    )

    total_loss.backward()
    optimizer.step()
این قطعه فرض میکند device و train_loader از قبل ساخته شدهاند و targets در هر Batch یک بردار عددی هستند.
برای پرهیز از اعمال همزمان دو سازوکار L2مانند بدون قصد قبلی، در این نمونه weight_decay=0.0 گذاشتهایم و جریمهها را صریحاً به Loss اضافه کردهایم. مقادیر L1_STRENGTH و L2_STRENGTH نیز فقط نمونهاند؛ مقیاس Loss، تعداد پارامترها و داده تعیین میکنند چه بازهای باید آزمایش شود.
آیا L1 در شبکه عصبی هم وزنها را دقیقاً صفر میکند؟
افزودن یک جریمه L1 به Loss شبکه عصبی الزاماً مانند خروجی یک حلکننده تخصصی Lasso، ضرایب دقیقاً صفر تولید نمیکند. نتیجه به بهینهساز و روش آموزش وابسته است.
اگر هدف شما حذف واقعی پارامترها یا ساخت شبکه تنک است، تعداد وزنهای صفر یا نزدیک صفر، عملکرد مدل و روش هرسکردن را جداگانه بررسی کنید. صرف وجود عبارت L1 در Loss به معنی کوچکترشدن فایل مدل یا سریعترشدن استنتاج نیست.
استفاده از AdamW برای Weight Decay مستقل
اگر هدف شما Weight Decay مستقل در آموزش شبکه عصبی است، نمونه ساده چنین است:
model = SmallRegressor(
    input_size=X_train.shape[1]
).to(device)

optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=0.001,
    weight_decay=0.01,
)
در این حالت لازم نیست همان جریمه را دوباره بدون هدف مشخص به Loss اضافه کنید.
اما آیا همه پارامترها باید Weight Decay بگیرند؟ پاسخ به معماری و طرح آموزش بستگی دارد. در برخی پیادهسازیها، برای وزنهای ماتریسی و پارامترهای تکبعدی مانند بایاس، گروههای جداگانه تعریف میشود.
نمونه گروهبندی:
decayed_parameters = []
other_parameters = []

for parameter in (
    model.parameters()
):
    if not parameter.requires_grad:
        continue

    if parameter.ndim >= 2:
        decayed_parameters.append(
            parameter
        )
    else:
        other_parameters.append(
            parameter
        )

optimizer = torch.optim.AdamW(
    [
        {
            "params": (
                decayed_parameters
            ),
            "weight_decay": 0.01,
        },
        {
            "params": (
                other_parameters
            ),
            "weight_decay": 0.0,
        },
    ],
    lr=0.001,
)
این یک سیاست مشخص برای آزمایش است: پارامترهای دو یا چندبعدی Weight Decay میگیرند و پارامترهای تکبعدی نمیگیرند. آن را برای همه معماریها قانون قطعی فرض نکنید. مستندات PyTorch امکان تعریف گروههای پارامتر با تنظیمات جداگانه را در بهینهساز ارائه میکند. PyTorch main documentation
تفاوت L1، L2، Weight Decay وDropout
این روشها در یک پروژه ممکن است کنار هم دیده شوند، اما نقطه اثرشان یکسان نیست:
| روش | نقطه اثر | هدف قابلآزمایش |
|---|---|---|
| L1 در Loss | جریمه مستقیم ضرایب انتخابشده | کوچککردن وزنها و در برخی مدلها ایجاد ضرایب صفر |
| L2 در Loss | جریمه مستقیم ضرایب انتخابشده | محدودکردن ضرایب بزرگ |
| Weight Decay در AdamW | بهروزرسانی مستقل وزنها | کوچککردن وزنها هنگام آموزش |
| Dropout | خروجی بعضی واحدهای شبکه هنگام آموزش | کاهش وابستگی شبکه به مسیرهای خاص |
| Early Stopping | زمان پایان آموزش | پایاندادن آموزش پس از توقف بهبود Validation |
وجود چند روش به معنی لزوم فعالکردن همزمان همه آنها نیست. هر تغییری را با یک فرض روشن وارد آزمایش کنید و اثر آن را روی داده اعتبارسنجی بسنجید.
Regularizationبرای داده جدولی
در دادههای جدولی، پیش از انتخاب مدل پیچیده این موارد را بررسی کنید:
- آیا ویژگیها مقیاسهای بسیار متفاوت دارند؟
- آیا ستونهایی وجود دارند که اطلاعات آینده را به Train منتقل کنند؟
- آیا داده کمحجم است؟
- آیا چند ویژگی همبستگی زیادی دارند؟
- آیا هدف، دقت پیشبینی است یا مدل با ضرایب قابلبررسی؟
- آیا توزیع داده در زمان تغییر میکند؟
برای بسیاری از مسائل جدولی، ساختن Baseline با Ridge، Lasso و Elastic Net میتواند از آموزش فوری یک شبکه عصبی مفیدتر باشد. انتخاب نهایی را باید بر اساس کیفیت روی داده جدید و محدودیتهای کاربرد انجام داد.
آیا Lasso برای انتخاب ویژگی کافی است؟
Lassoمیتواند برخی ضرایب را صفر کند و از این جهت برای بررسی انتخاب ویژگی مفید است. اما صفر یا غیرصفرشدن ضریب، به داده آموزش و شدت جریمه وابسته است.
برای استفاده جدی از نتیجه انتخاب ویژگی:
- انتخاب را با چند تقسیم داده یا اعتبارسنجی تکرار کنید.
- پایداری ویژگیهای انتخابشده را بررسی کنید.
- عملکرد مدل را با و بدون ویژگیها مقایسه کنید.
- اطلاعات تخصصی حوزه مسئله را نیز لحاظ کنید.
- از تعبیر ضریب غیرصفر بهعنوان رابطه علّی خودداری کنید.
اشتباهات رایج درRegularization
انتخاب شدت جریمه بر اساسTrain
هدف صرفاً کمکردن خطای Train نیست. شدت مناسب را با Validation انتخاب کنید.
مقیاسبندی پیش از جداسازی داده
مقیاسساز نباید با Validation و Test برازش شود. استفاده از Pipeline و تقسیم درست داده خطر نشت اطلاعات را کاهش میدهد. scikit-learn 1.8.0 documentation
فرض اینکه L1 همیشه ویژگیهای «واقعاً مهم» را کشف میکند
در دادههای همبسته، انتخاب ویژگی میتواند با تغییر نمونهها یا alpha تغییر کند.
استفاده از منظمسازی بسیار شدید
اگر هم Train و هم Validation عملکرد ضعیفی دارند، مدل ممکن است بیشازحد محدود شده باشد.
یکسان فرضکردن L2 وAdamW
مقاله AdamW نشان میدهد جریمه L2 و Weight Decay مستقل در بهینهسازهای تطبیقی رفتار یکسانی ندارند. arxiv.org
بیتوجهی به پیشفرضAdamW
مقدار پیشفرض weight_decay در مستندات فعلی AdamW صفر نیست. اگر هدف آزمایش شما غیرفعالبودن آن است، weight_decay=0.0 را صریح وارد کنید. PyTorch main documentation
انتظار افزایش سرعت استنتاج فقط باL1
کوچک یا نزدیک صفر شدن وزنها لزوماً ساختار مدل را تغییر نمیدهد. برای کاهش واقعی هزینه اجرا، باید ساختار مدل و روش ذخیره و اجرای آن نیز بررسی شود.
مقایسه مدلها با معیارهای متفاوت
اگر یک روش را با MAE و دیگری را با R² انتخاب کنید، نتیجه مقایسه روشن نیست. معیار انتخاب را پیش از آزمایش تعیین کنید.
چگونه مقدار منظمسازی را انتخاب کنیم؟
یک مسیر عملی:
- یک مدل بدون جریمه اضافی بهعنوان Baseline بسازید.
- Train و Validationرا با تقسیم مناسب مسئله جدا کنید.
- چند مقدار متفاوت برای شدت منظمسازی آزمایش کنید.
- Train Loss و معیار Validationرا در کنار هم ببینید.
- در صورت کوچکبودن داده، نتیجه را با چند تقسیم یا اعتبارسنجی تکرار کنید.
- اگر چند مدل کیفیت مشابه دارند، پیچیدگی، پایداری و تفسیرپذیری آنها را مقایسه کنید.
- پس از انتخاب نهایی، Test کنارگذاشتهشده را ارزیابی کنید.
اگر داده زمانی، گروهی یا وابسته به کاربران مختلف است، تقسیم تصادفی معمولی ممکن است نماینده کاربرد واقعی نباشد. روش اعتبارسنجی باید با شیوه استفاده آینده از مدل هماهنگ باشد.
پرسشهای متداول
Regularizationچیست؟
خانوادهای از روشها برای کنترل رفتار یا پیچیدگی مدل در آموزش است تا عملکرد آن روی داده جدید بهتر ارزیابی و تنظیم شود.
تفاوت L1 و L2 چیست؟
L1 از جریمهای مبتنی بر مقدار مطلق ضرایب استفاده میکند و در مدلهایی مانند Lasso میتواند ضرایب صفر بسازد. L2 ضرایب را، بهویژه ضرایب بزرگتر را، محدود میکند و در Ridgeبه کار میرود.
Ridgeچیست؟
یک مدل رگرسیون خطی با منظمسازی L2 است.
Lassoچیست؟
یک مدل رگرسیون خطی با منظمسازی L1 است که میتواند برخی ضرایب را دقیقاً صفر کند.
Elastic Netچیست؟
مدلی است که جریمههای L1 و L2 را ترکیب میکند و نسبت آنها را میتوان تنظیم کرد.
آیا Weight Decay همان L2 است؟
در همه بهینهسازها خیر. بهویژه در Adam، افزودن جریمه L2 به Loss با Weight Decay مستقل AdamW یکسان نیست. arxiv.org
weight_decay پیشفرض AdamW چقدر است؟
در مستندات فعلی PyTorch مقدار پیشفرض torch.optim.AdamW برابر 0.01 است. برای خوانایی و تکرارپذیری بهتر، مقدار موردنظر خود را صریح بنویسید. PyTorch main documentation
آیا L1 حتماً کیفیت پیشبینی را بهتر میکند؟
خیر. ممکن است عملکرد را بهتر، بدتر یا تقریباً ثابت کند. نتیجه به داده، مدل و شدت جریمه بستگی دارد.
آیا Regularization جایگزین داده بیشتر است؟
همیشه نه. داده بیشتر و باکیفیتتر میتواند مشکلهای متفاوتی را حل کند. منظمسازی نیز نمیتواند نشت داده یا برچسبهای اشتباه را اصلاح کند.
آیا میتوان Dropout و Weight Decay را همزمان استفاده کرد؟
بله، اما اثر هر کدام و ترکیبشان باید روی Validation سنجیده شود. افزودن چند محدودیت بدون ارزیابی ممکن است مدل را بیشازحد محدود کند.
جمعبندی
L1، L2 و Weight Decayهمگی به کنترل وزنهای مدل مربوطاند، اما رفتار یکسانی ندارند. Lasso با L1 میتواند ضرایب صفر ایجاد کند. Ridge با L2 ضرایب را کوچک میکند. Elastic Net هر دو را ترکیب میکند. در شبکه عصبی نیز AdamW راهی برای اعمال Weight Decay مستقل از سازوکار تطبیقی Adam فراهم میکند.
برای تصمیمگیری، ابتدا یک Baseline بسازید؛ پیشپردازش را فقط روی Train برازش کنید؛ شدت منظمسازی را با Validation انتخاب کنید؛ و عملکرد نهایی را روی Test کنارگذاشتهشده بسنجید. مقدار جریمه و نوع مدل باید از نتیجه آزمایش بیاید، نه از یک عدد ثابت که برای همه پروژهها تکرار شود.
از آموزش مدل تا استفاده از هوش مصنوعی در محصول
اگر برای دادههای اختصاصی خود مدل میسازید، منظمسازی یکی از ابزارهای بهبود فرایند آموزش آن است. برای قابلیتهایی که به مدلهای هوش مصنوعی آماده نیاز دارند نیز میتوانید خدمات API درواره را بررسی کنید. درواره دسترسی یکپارچه به مدلهای هوش مصنوعی را برای توسعهدهندگان ارائه میکند؛ مدل مناسب را بر اساس نیاز محصول، کیفیت خروجی و شرایط فعلی سرویس انتخاب کنید. hub.darvareh.ir
برای بررسی خدمات و شروع اتصال محصولتان، به darvareh.ir سر بزنید.
مقالات مرتبط
- بیشبرازش و کمبرازش در یادگیری ماشین
- Dropout چیست؟ آموزش کاهش بیشبرازش با PyTorch
- Adam چیست؟ مقایسه AdamW و SGD با PyTorch
- Early Stoppingچیست؟
- مهندسی ویژگی و انتخاب ویژگی باPython
- رگرسیون خطی در یادگیری ماشین
- PyTorchچیست؟
- آموزش استفاده از API هوش مصنوعی
منابع
- مقاله اصلیLasso: Regression Shrinkage and Selection Via the Lasso
- مقاله اصلیDecoupled Weight Decay Regularization
- مستندات رسمی scikit-learn: مدلهای خطی
- مستندات رسمیscikit-learn: Lasso
- مستندات رسمیscikit-learn: Ridge
- مستندات رسمی scikit-learn: خطاهای رایج و نشت داده
- مستندات رسمیPyTorch: AdamW
- مستندات رسمیPyTorch: Adam
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و صفحه سلب مسئولیت درواره را نیز مطالعه کنید.



