
نشت داده در یادگیری ماشین چیست؟ تشخیص و پیشگیری از Data Leakage با Python
چرا مدلی که در آزمایش دقت بالایی دارد، پس از استقرار ضعیف عمل میکند؟ نشت داده یکی از علتهای مهم است. در این آموزش، انواع Data Leakage را میشناسید و با Python تفاوت ارزیابی اشتباه و Pipeline صحیح را میبینید.

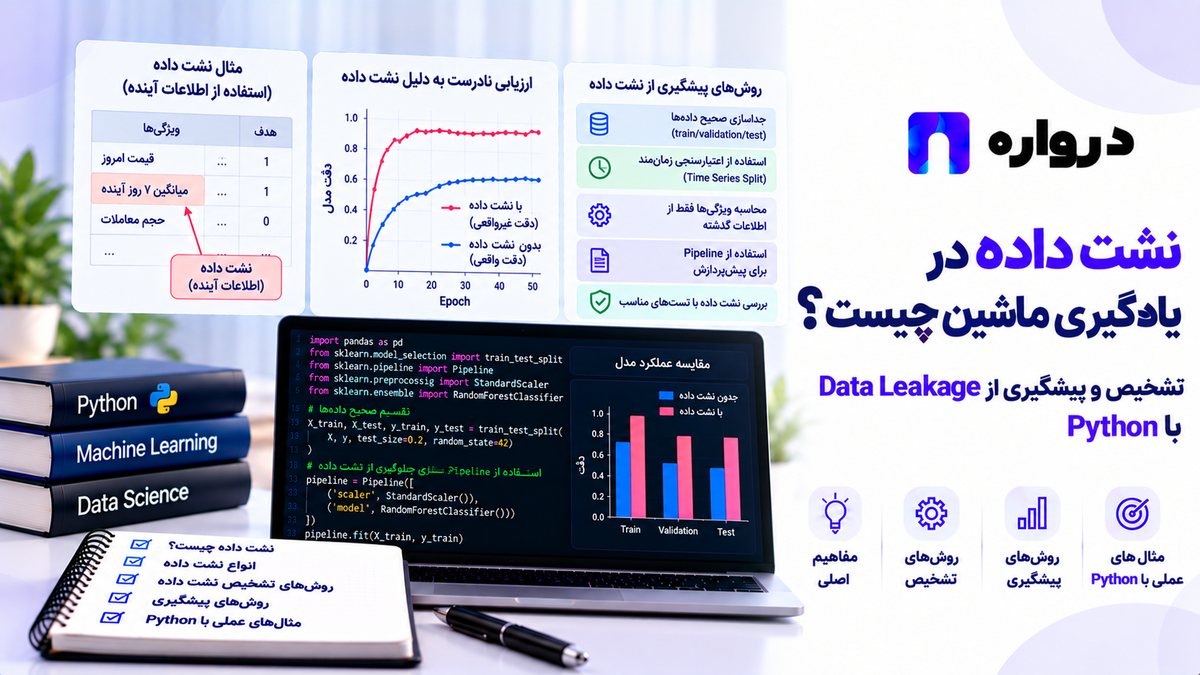
مدلی را تصور کنید که در مرحله آزمایش دقت ۹۵ درصدی دارد، اما پس از استفاده در محصول، بسیاری از پیشبینیهایش اشتباه از آب درمیآیند. ممکن است علت، تغییر رفتار کاربران یا کیفیت پایین داده جدید باشد. اما پیش از این نتیجهگیری، باید یک احتمال مهم را بررسی کرد: آیا هنگام توسعه، اطلاعاتی به مدل رسیده که در زمان پیشبینی واقعی در دسترس نخواهد بود؟
این مشکل Data Leakage یا نشت داده نام دارد.
نشت داده گاهی آشکار است؛ برای مثال، ستونی که نتیجه نهایی پرونده را ثبت میکند بهاشتباه وارد ویژگیهای مدل شده است. گاهی هم بسیار پنهانتر رخ میدهد: انتخاب ویژگی پیش از تفکیک داده، تنظیم مقیاس روی کل دیتاست، حضور پیامهای یک کاربر در هر دو مجموعه آموزش و آزمون، یا ساخت ویژگی با استفاده از اطلاعات آینده.
پیامد معمول نشت داده این است که ارزیابی، عملکرد مدل را بهتر از چیزی نشان میدهد که در شرایط واقعی قابل دستیابی است. مستندات scikit-learn نیز انتخاب ویژگی روی کل داده پیش از تفکیک را نمونهای روشن از این خطا معرفی میکند. scikit-learn.org
در این مقاله، انواع نشت داده را بررسی میکنیم و سپس با یک آزمایش قابلاجرا نشان میدهیم چگونه دادهای که هیچ رابطه واقعی با برچسب ندارد میتواند بهدلیل نشت اطلاعات، ظاهراً نتیجه خوبی تولید کند.
نشت داده چیست؟
نشت داده زمانی رخ میدهد که اطلاعاتی از بیرونِ محدوده مجاز آموزش یا از آینده وارد فرایند ساخت مدل و ارزیابی آن شود.
«محدوده مجاز» به مسئله بستگی دارد. برای مدلی که قرار است در لحظه ثبت درخواست پشتیبانی پیشبینی انجام دهد، فقط اطلاعات موجود تا همان لحظه مجاز هستند. نتیجه رسیدگی فردا، یادداشت کارشناس پس از حل مشکل و مدت نهایی بستن پرونده نباید در ویژگیهای ورودی قرار بگیرند.
در ارزیابی نیز مجموعه آزمون باید مستقل بماند. اگر از آن برای انتخاب ویژگی، تنظیم مدل یا انتخاب آستانه استفاده کنیم، دیگر یک آزمون مستقل از تصمیمهای توسعه نیست.
یک پرسش عملی برای شناسایی نشت داده این است:
اگر همین پیشبینی را امروز در محصول اجرا کنم، آیا تمام اطلاعاتی که مدل استفاده میکند واقعاً در همین زمان و با همین کیفیت در دسترساند؟
پرسش دوم به ارزیابی مربوط است:
آیا هیچ اطلاعاتی از نمونههای آزمون، مستقیم یا غیرمستقیم، در تصمیمهای مربوط به آموزش وارد شده است؟
چرا نشت داده خطرناک است؟
نشت داده میتواند باعث شود:
- Accuracy، F1 یا AUCآزمایش بیش از حد خوشبینانه باشد.
- تیم ویژگیهای اشتباه را مهم تشخیص دهد.
- مدلی پیچیده بهاشتباه بهتر از یک مدل ساده انتخاب شود.
- پس از استقرار، کیفیت پیشبینی افت کند.
- آستانه هشدار بر اساس نرخ خطای غیرواقعی تنظیم شود.
- تصمیمهای محصول و ظرفیت تیم پشتیبانی بر پایه برآورد نادرست اتخاذ شود.
نکته مهم این است که بالا بودن عملکرد بهتنهایی اثبات وجود نشت نیست. برخی مسائل واقعاً قابل پیشبینیاند. نشت داده باید با بررسی زمان دسترسی به ویژگیها، روش تفکیک، کد پیشپردازش و مسیر ارزیابی شناسایی شود.
انواع رایج نشت داده
۱. نشت هدف یاTarget Leakage
در این حالت یک ویژگی، مستقیم یا غیرمستقیم، اطلاعاتی درباره نتیجهای دارد که قرار است پیشبینی شود؛ در حالی که هنگام تصمیمگیری واقعی هنوز در دسترس نیست.
فرض کنید میخواهیم هنگام ثبت تیکت پیشبینی کنیم آیا رسیدگی به آن طولانی میشود یا خیر. ستونهای زیر مشکوکاند:
- تاریخ بسته شدن تیکت
- تعداد ارجاعهای انجامشده تا پایان رسیدگی
- امتیاز رضایت ثبتشده پس از حل مشکل
- برچسب نهایی کارشناس
- زمان واقعی حل مسئله
مدل ممکن است با این ستونها بسیار دقیق شود، اما چنین عملکردی برای تصمیمگیری در لحظه ثبت تیکت قابل استفاده نیست.
۲. نشت در پیشپردازش
برخی مراحل پیشپردازش باید پارامترهایی را از داده یاد بگیرند. مثالها:
- میانگین و انحراف معیار در
StandardScaler - مقدار جایگزین برای داده گمشده در
SimpleImputer - محدوده تبدیل در بعضی روشهای مقیاسبندی
- واژگان و وزنهای آماری در بعضی روشهای پردازش متن
- دستههای مشاهدهشده یا آمار مرتبط با آنها در روشهای رمزگذاری
اگر این مراحل را روی کل داده، شاملTest آموزش دهید و بعد داده را تفکیک کنید، اطلاعاتی از مجموعه آزمون وارد فرایند توسعه شده است.
میزان اثر این خطا به روش، داده و اندازه نمونه بستگی دارد؛ گاهی کوچک است و گاهی ارزیابی را بهشدت مخدوش میکند. قاعده اجرایی روشن است: ابتدا تفکیک کنید، سپس پارامترهای پیشپردازش را فقط از بخش آموزش یاد بگیرید. scikit-learn.org
۳. نشت در انتخاب ویژگی
اگر برای انتخاب ستونهای «بهترین» از رابطه هر ستون با برچسب تمام نمونهها استفاده کنید، برچسبهای Test نیز در انتخاب ستونها اثر گذاشتهاند.
حتی اگر مدل نهایی را فقط با ردیفهای Train آموزش دهید، مجموعه Test دیگر مستقل نیست؛ زیرا در مرحله انتخاب ویژگی دیده شده است.
این حالت بهخصوص در دیتاستهایی با ستونهای بسیار زیاد خطرناک است. از میان هزاران ویژگی تصادفی، ممکن است تعدادی صرفاً بهطور اتفاقی با برچسب نمونههای Test همبستگی نشان دهند.
۴. نشت اطلاعات آینده یاTemporal Leakage
اگر هدف پیشبینی رویداد آینده است، ویژگیها باید با یک زمان برش مشخص ساخته شوند.
برای مثال، برای پیشبینی احتمال لغو اشتراک در روز اول ماه:
- مصرف سه ماه گذشته ممکن است مجاز باشد.
- تعداد تماسهای کاربر در پایان همان ماه مجاز نیست.
- وضعیت اشتراک پس از پایان ماه مجاز نیست.
- میانگین متحرکی که ناخواسته روزهای آینده را هم در بر میگیرد مجاز نیست.
تقسیم تصادفی دادههای زمانی نیز میتواند مسئله ایجاد کند: مدل روی نمونههای آینده آموزش ببیند و سپس روی گذشته ارزیابی شود. TimeSeriesSplit در scikit-learn برای ارزیابی مبتنی بر ترتیب زمانی طراحی شده است. scikit-learn 1.9.0 documentation
۵. نشت میان گروههای مرتبط
گاهی ردیفهای دیتاست مستقل نیستند. چند ردیف ممکن است متعلق به:
- یک کاربر
- یک سازمان
- یک دستگاه
- یک پرونده
- یک مکالمه
- یک سند یا نسخههای مشابه آن
باشند.
اگر نمونههای یک گروه در Train و Test پخش شوند، مدل ممکن است الگوی اختصاصی همان گروه را یاد بگیرد. نتیجه آزمون دیگر الزاماً نشاندهنده عملکرد روی کاربر یا سازمان جدید نیست.
در این شرایط باید تفکیک را بر اساس گروه انجام داد. GroupShuffleSplit برای کنار گذاشتن گروههای مستقل در تقسیم تصادفی گروهمحور قابل استفاده است. scikit-learn.org
۶. نشت در بازنمونهگیری داده نامتوازن
فرض کنید قبل از تقسیم Train و Test، روی کل دیتاست SMOTE یا یک روش بازنمونهگیری دیگر اجرا شود. در این صورت داده ارزیابی میتواند تحت تأثیر نمونههای آموزشی یا فرایند ساخت نمونههای جدید قرار بگیرد و توزیع آزمون نیز از شرایط واقعی فاصله بگیرد.
مستندات imbalanced-learn بازنمونهگیری پیش از تفکیک داده را یک خطای رایج معرفی میکند و استفاده از Pipeline مناسب را برای اجرای بازنمونهگیری در بخشهای آموزشی توصیه میکند. imbalanced-learn.org
۷. نشت از طریق نمونههای تکراری یا بسیار مشابه
اگر یک تصویر، متن، قطعه صوتی یا نسخه نزدیک به آن در Train و Test باشد، مدل ممکن است بهجای یادگیری الگوی قابل تعمیم، همان نمونه را تشخیص دهد.
برای مثال:
- دو تصویر از یک محصول با برشهای اندک متفاوت
- دو نسخه از یک متن با تغییر جزئی
- قطعههای صوتی جداشده از یک فایل اصلی
- چند پیام از یک مکالمه واحد
در این مسائل باید «واحد استقلال» را مشخص کرد و نمونههای وابسته را با هم در یک بخش نگه داشت.
۸. نشت ناشی از انتخاب مکرر رویTest
حتی اگر کد آموزش به Test دسترسی مستقیم نداشته باشد، استفاده مکرر از نتیجه Test برای انتخاب معماری، ویژگی، آستانه یا Prompt میتواند استقلال ارزیابی را از بین ببرد.
وقتی بارها بر اساس نتیجه Test تصمیم میگیرید، Test عملاً بخشی از فرایند توسعه میشود. برای انتخابها از Validation استفاده کنید و Test را برای ارزیابی نهایی کنار بگذارید.
آزمایش عملی: دقت ظاهری روی داده کاملاً تصادفی
اکنون یک آزمایش میسازیم که در آن:
- ویژگیها تصادفی هستند.
- برچسبها نیز مستقل و تصادفی هستند.
- بنابراین هیچ رابطه واقعی برای یادگیری وجود ندارد.
با این حال، اگر انتخاب ویژگی را پیش از تفکیک داده انجام دهیم، ممکن است نتیجه آزمون بهظاهر خوب شود.
این آزمایش از نوع نمونههای آموزشی مستندات scikit-learn درباره نشت در انتخاب ویژگی الهام گرفته است. scikit-learn.org
نصب کتابخانهها
pip install numpy scikit-learnساخت داده تصادفی
import numpy as npfrom sklearn.model_selection import ( train_test_split,)rng = np.random.default_rng(42)X = rng.normal( size=(400, 10_000))y = rng.integers( low=0, high=2, size=400,)train_indices, test_indices = ( train_test_split( np.arange(len(y)), test_size=0.30, stratify=y, random_state=42, ))print("Samples:", len(y))print("Features:", X.shape[1])print("Positive rate:", y.mean())در این داده، هیچ ویژگیای از روی برچسب تولید نشده است. اگر یک مدل در آزمون عددی بالا نشان دهد، باید روش ارزیابی را با دقت بررسی کنیم.
روش اشتباه: انتخاب ویژگی روی کل داده
کد زیر عمداً نشت داده دارد:
from sklearn.feature_selection import (
SelectKBest,
f_classif,
)
from sklearn.linear_model import (
LogisticRegression,
)
from sklearn.pipeline import (
make_pipeline,
)
from sklearn.preprocessing import (
StandardScaler,
)
from sklearn.metrics import (
accuracy_score,
)
# اشتباه: انتخاب ویژگی با برچسب همه نمونهها،
# از جمله نمونههای Test
selector = SelectKBest(
score_func=f_classif,
k=25,
)
X_selected_all = (
selector.fit_transform(
X,
y,
)
)
leaky_model = make_pipeline(
StandardScaler(),
LogisticRegression(
max_iter=1000,
),
)
leaky_model.fit(
X_selected_all[
train_indices
],
y[train_indices],
)
leaky_predictions = (
leaky_model.predict(
X_selected_all[
test_indices
]
)
)
leaky_accuracy = accuracy_score(
y[test_indices],
leaky_predictions,
)
print(
"Accuracy with leakage:",
leaky_accuracy,
)مشکل در خط آموزش مدل نهایی نیست. مشکل پیش از آن رخ داده است: selector برای انتخاب ۲۵ ستون از برچسب تمام ۴۰۰ نمونه استفاده کرده است؛ بنابراین برچسبهای نمونههای Test در تصمیم انتخاب ستون اثر داشتهاند.
در یک اجرای این مثال با نسخههای استفادهشده در زمان تهیه مقاله، دقت روش آلوده حدود ۰٫۷۷ بود. ممکن است عدد در محیط یا نسخه دیگری تغییر کند؛ نکته اصلی، نامعتبر بودن ارزیابی حاصل از این مسیر است.
روش صحیح: انتخاب ویژگی داخلPipeline
اکنون ابتدا داده را تفکیک میکنیم و انتخاب ویژگی را داخل Pipeline قرار میدهیم:
clean_model = make_pipeline(
    SelectKBest(
        score_func=f_classif,
        k=25,
    ),
    StandardScaler(),
    LogisticRegression(
        max_iter=1000,
    ),
)

clean_model.fit(
    X[train_indices],
    y[train_indices],
)

clean_predictions = (
    clean_model.predict(
        X[test_indices]
    )
)

clean_accuracy = accuracy_score(
    y[test_indices],
    clean_predictions,
)

print(
    "Accuracy with leakage:",
    leaky_accuracy,
)

print(
    "Accuracy without leakage:",
    clean_accuracy,
)
این بار SelectKBest فقط در مرحله fit روی Train آموزش میبیند. هنگام اجرای predict روی Test، همان ستونهای انتخابشده از Train استفاده میشوند، بیآنکه برچسبهای Test در انتخاب آنها نقش داشته باشند.
در اجرای بررسیشده هنگام تهیه این مقاله، دقت مسیر صحیح حدود ۰٫۴۰ بود. در دادهای که واقعاً تصادفی است، انتظار عملکرد قابل اتکای بهتر از حد شانس نداریم؛ یک مقدار منفرد روی Test کوچک میتواند بالاتر یا پایینتر از ۰٫۵ قرار بگیرد.
نتیجه مهم: دقت ظاهراً بهتر روش اول هیچ توان پیشبینی واقعی را ثابت نمیکند. آن روش پاسخهای مجموعه آزمون را هنگام انتخاب ویژگی دیده است.
چرا Pipeline جلوی این نوع نشت را میگیرد؟
Pipeline مراحل وابسته را در یک مسیر مشخص قرار میدهد:
- انتخاب ویژگی
- مقیاسبندی
- آموزش مدل
- اجرای همان تبدیلهای یادگرفتهشده روی داده جدید
- تولید پیشبینی
وقتی fit را فقط روی Train اجرا کنید، هر مرحلهای که نیاز به یادگیری پارامتر دارد فقط اطلاعات Train را میبیند. مستندات scikit-learn نیز Pipeline را یکی از ابزارهای اصلی برای کاهش خطاهای رایج پیشپردازش و نشت داده معرفی میکند. scikit-learn.org
بااینحال،Pipeline همه انواع نشت داده را بهطور خودکار حل نمیکند. اگر یک ستون حاوی نتیجه آینده باشد یا ردیفهای یک کاربر را میان Train و Test تقسیم کرده باشید، باید طراحی داده و تقسیمبندی را نیز اصلاح کنید.
مقیاسبندی اشتباه و صحیح
یک الگوی اشتباه رایج این است:
from sklearn.preprocessing import ( StandardScaler,)scaler = StandardScaler()# اشتباه: یادگیری میانگین و انحراف معیار# از کل داده، شامل TestX_scaled_all = scaler.fit_transform( X)X_train_wrong = ( X_scaled_all[ train_indices ])X_test_wrong = ( X_scaled_all[ test_indices ])در این حالت میانگین و انحراف معیار هر ستون از دادههای Test نیز تأثیر گرفته است.
نسخه صحیح:
scaler = StandardScaler()

X_train_scaled = (
    scaler.fit_transform(
        X[train_indices]
    )
)

X_test_scaled = (
    scaler.transform(
        X[test_indices]
    )
)
در عمل بهتر است StandardScaler همراه مدل در یک Pipeline باشد تا این ترتیب در آموزش و ارزیابی حفظ شود.
همین اصل برای روشهای جایگزینی مقدار گمشده و بسیاری از تبدیلهای آماری نیز صدق میکند: پارامترها را روی Train یاد بگیرید و روی Test فقط اعمال کنید.
نشت داده درCross-Validation
ممکن است Train و Test بیرونی را درست تفکیک کرده باشید، اما هنگام اعتبارسنجی متقاطع خطا رخ دهد.
برای مثال، اگر یک بار روی کلTrain انتخاب ویژگی انجام دهید و سپس Cross-Validation اجرا کنید، بخش اعتبارسنجی هر Fold قبلاً در انتخاب ویژگی دیده شده است.
روش درست این است که انتخاب ویژگی درون Pipeline قرار بگیرد تا در هر Fold، فقط روی قسمت آموزشی همانFold آموزش ببیند:
from sklearn.model_selection import (
    StratifiedKFold,
    cross_val_score,
)


cross_validation = (
    StratifiedKFold(
        n_splits=5,
        shuffle=True,
        random_state=42,
    )
)

fold_model = make_pipeline(
    SelectKBest(
        f_classif,
        k=25,
    ),
    StandardScaler(),
    LogisticRegression(
        max_iter=1000,
    ),
)

scores = cross_val_score(
    fold_model,
    X[train_indices],
    y[train_indices],
    cv=cross_validation,
    scoring="accuracy",
)

print("Fold accuracies:", scores)
print("Mean CV accuracy:", scores.mean())
در این کد، cross_val_score مدل Pipeline را برای هر Fold بهطور جداگانه آموزش میدهد. Test بیرونی نیز همچنان برای ارزیابی نهایی دستنخورده میماند.
اگر چندین معماری و تنظیم مختلف را با همین Foldها امتحان کنید، بهترین امتیاز Validation نیز ممکن است بر اثر انتخابهای مکرر خوشبینانه باشد. برای برآورد دقیقتر عملکرد فرایند انتخاب مدل میتوان از آزمون مستقل یا در شرایط مناسب از اعتبارسنجی متقاطع تودرتو استفاده کرد. scikit-learn.org
نشت داده هنگام استفاده ازSMOTE
برای داده نامتوازن، اجرای SMOTE روی کل دیتاست پیش از تقسیم اشتباه است:
# الگوی اشتباه؛ برای استفاده عملی اجرا نکنید
X_resampled, y_resampled = (
smote.fit_resample(
X,
y,
)
)
# تقسیم پس از بازنمونهگیری:
# ارزیابی ممکن است مخدوش شود.مسیر مناسب این است که ابتدا مجموعه ارزیابی را جدا کنید و سپس بازنمونهگیری را فقط در بخش آموزش هر Fold انجام دهید. برای این کار باید از Pipeline کتابخانه imbalanced-learn استفاده کرد؛ Pipeline معمولی scikit-learn برای این مرحله با همان الگوی fit_resample طراحی نشده است.
نمونه:
from imblearn.over_sampling import (
    SMOTE,
)

from imblearn.pipeline import (
    Pipeline as ImbPipeline,
)

from sklearn.linear_model import (
    LogisticRegression,
)

from sklearn.preprocessing import (
    StandardScaler,
)


smote_pipeline = ImbPipeline(
    steps=[
        (
            "scaler",
            StandardScaler(),
        ),
        (
            "smote",
            SMOTE(
                random_state=42,
            ),
        ),
        (
            "model",
            LogisticRegression(
                max_iter=1000,
            ),
        ),
    ]
)
اگر این Pipeline را با تقسیمبندی مناسب آموزش دهید، مرحله بازنمونهگیری هنگام آموزش اجرا میشود و مجموعه ارزیابی مانند داده عملیاتی دستنخورده میماند. مستندات رسمی imbalanced-learn نیز این الگو را برای جلوگیری از خطای بازنمونهگیری پیش از تفکیک توضیح میدهد. imbalanced-learn.org
برای ارزیابی مدل نامتوازن، صرف Accuracy کافی نیست؛ Precision، Recall، نرخ هشدار اشتباه و در صورت نیاز کیفیت احتمالها را نیز بسنجید.
تفکیک گروهی برای کاربران یا سازمانها
فرض کنید از هر کاربر چند نمونه دارید و میخواهید عملکرد مدل روی کاربران جدید را بسنجید. تقسیم تصادفی ردیفها ممکن است پیامهای یک کاربر را در هر دو طرف قرار دهد.
از شناسه گروه برای تفکیک استفاده کنید:
import numpy as np

from sklearn.model_selection import (
    GroupShuffleSplit,
)


# مثال: ۱۰۰ کاربر، از هر کاربر ۴ ردیف
user_ids = np.repeat(
    np.arange(100),
    4,
)

splitter = GroupShuffleSplit(
    n_splits=1,
    test_size=0.20,
    random_state=42,
)

group_train_indices, (
    group_test_indices
) = next(
    splitter.split(
        np.zeros(
            (len(user_ids), 1)
        ),
        groups=user_ids,
    )
)

train_users = set(
    user_ids[
        group_train_indices
    ]
)

test_users = set(
    user_ids[
        group_test_indices
    ]
)

print(
    "Shared users:",
    len(
        train_users
        & test_users
    ),
)
خروجی تعداد کاربران مشترک باید صفر باشد. در این مثال test_size به سهمی از گروهها مربوط است؛ اگر اندازه گروهها متفاوت باشد، سهم ردیفهای Test لزوماً دقیقاً ۲۰ درصد نخواهد بود.
یک نکته ظریف: تقسیم گروهی را بر اساس هدف استقرار انتخاب کنید. اگر مدل در محصول قرار است برای همان کاربران فعلی در روزهای آینده پیشبینی کند، ارزیابی فقط روی کاربران کاملاً جدید شاید دقیقاً همان سناریوی استفاده نباشد. گاهی باید هم وابستگی گروهی و هم ترتیب زمانی را در طراحی آزمون لحاظ کرد.
تفکیک زمانی و جلوگیری از دیدن آینده
برای دادههای رویدادی، تفکیک زمانی معمولاً به واقعیت استقرار نزدیکتر است: روی گذشته آموزش میدهید و روی دورهای دیرتر ارزیابی میکنید.
نمونه ساده از TimeSeriesSplit:
import pandas as pd

from sklearn.model_selection import (
    TimeSeriesSplit,
)


events = pd.DataFrame(
    {
        "event_time": pd.date_range(
            "2025-01-01",
            periods=120,
            freq="D",
        ),
        "feature": np.arange(120),
    }
)

events = (
    events.sort_values(
        "event_time"
    )
    .reset_index(
        drop=True
    )
)

time_splitter = TimeSeriesSplit(
    n_splits=4,
    gap=2,
)

for fold, (
    train_idx,
    validation_idx,
) in enumerate(
    time_splitter.split(events),
    start=1,
):
    latest_train_time = (
        events.loc[
            train_idx,
            "event_time",
        ].max()
    )

    earliest_validation_time = (
        events.loc[
            validation_idx,
            "event_time",
        ].min()
    )

    print(
        f"Fold {fold}:",
        latest_train_time.date(),
        "→",
        earliest_validation_time.date(),
    )
gap=2 در این مثال دو ردیف فاصله میان بخش آموزش و اعتبارسنجی هر Fold میگذارد. این فاصله فقط یک نمونه آموزشی است؛ فاصله لازم در پروژه واقعی به تأخیر برچسب، طول پنجره ویژگیها و وابستگی زمانی داده مربوط میشود.
تفکیک زمانی بهتنهایی کافی نیست. اگر پیش از تقسیم، یک ویژگی را با اطلاعات روزهای آینده ساخته باشید، همان ویژگی همچنان نشت دارد.
نشت داده در ساخت ویژگیهای زمانی
فرض کنید میخواهید از تعداد درخواستهای قبلی یک کاربر برای پیشبینی درخواست بعدی استفاده کنید.
ویژگی «تعداد درخواستهای قبلی» باید فقط رخدادهای پیش از زمان پیشبینی را بشمارد. اگر در یک جدول نهایی، تعداد کل درخواستهای کاربر تا پایان ماه را محاسبه و آن را برای رخدادهای ابتدای ماه استفاده کنید، اطلاعات آینده وارد داده شده است.
برای هر ویژگی زمانی، این چهار زمان را مشخص کنید:
| زمان | پرسش |
|---|---|
| زمان وقوع رویداد | اتفاق اصلی چه زمانی رخ داده است؟ |
| زمان ثبت داده | اطلاعات چه زمانی واقعاً در سامانه موجود شده است؟ |
| زمان پیشبینی | مدل چه زمانی باید پاسخ بدهد؟ |
| زمان مشخصشدن برچسب | نتیجه واقعی چه زمانی معلوم میشود؟ |
ممکن است یک رویداد در ساعت ۱۰ اتفاق افتاده باشد، اما اطلاعاتش ساعت ۱۱ در پایگاه داده ثبت شود. مدلی که ساعت ۱۰:۳۰ تصمیم میگیرد نباید از آن اطلاعات استفاده کند.
نشت درTarget Encoding
در Target Encoding، یک دسته با آماری مرتبط با برچسب همان دسته نمایش داده میشود. اگر این آمار را روی کل داده محاسبه کنیم، برچسبهای Validation یا Test وارد نمایش ویژگی شدهاند.
حتی روی داده Train نیز روش سادهای که برای هر ردیف از برچسب همان ردیف در ساخت نمایش آن دسته کمک میگیرد، میتواند بیشبرازش ایجاد کند؛ بهویژه وقتی دستهها نادر باشند.
مستندات scikit-learn در مثال TargetEncoder توضیح میدهد که fit_transform برای داده آموزش از Cross-fittingداخلی استفاده میکند و رفتارش با اجرای جداگانه fit و سپس transform روی همان داده یکسان نیست. scikit-learn 1.9.1 documentation
در این نوع ویژگیها، محل اجرای Encoder در Pipeline و زمان محاسبه آمار باید دقیقاً مشخص باشد.
نشانههای احتمالی نشت داده
هیچ نشانهای بهتنهایی اثبات قطعی نیست، اما موارد زیر ارزش بررسی دارند:
- عملکرد مدل بسیار بالاتر از انتظار کارشناسان مسئله است.
- یک ویژگی پس از وقوع نتیجه ثبت میشود، ولی در ورودی مدل وجود دارد.
- با حذف یک ستون شناسهمانند، عملکرد ناگهان افت شدید میکند.
- عملکرد ارزیابی تصادفی عالی است، اما آزمون زمانی ضعیف است.
- مدل روی کاربران دیدهشده خوب و روی کاربران جدید ضعیف است.
- دقت آفلاین بالا است، ولی عملکرد پس از استقرار کاهش زیادی دارد.
- تعداد زیادی نمونه تکراری یا نزدیک به هم در دو بخش داده دیده میشود.
- انتخاب ویژگی یا پیشپردازش خارج از حلقه Cross-Validation انجام شده است.
برای پیدا کردن علت، مسیر تولید تکتک ویژگیها و کد آمادهسازی داده را بررسی کنید.
چکلیست پیشگیری از نشت داده
پیش از آموزش
- زمان تصمیمگیری مدل را دقیق تعریف کنید.
- فهرست ویژگیهای مجاز در همان زمان را تهیه کنید.
- واحد مستقل تقسیمبندی را تعیین کنید: ردیف، کاربر، سازمان، دستگاه یا پرونده.
- نیاز به تفکیک زمانی را بررسی کنید.
- نمونههای تکراری و مشتقشده از یک منبع را شناسایی کنید.
هنگام ساختPipeline
- تفکیک داده را پیش از مراحل یادگیرنده انجام دهید.
- مقیاسبندی، جایگزینی مقدار گمشده و انتخاب ویژگی را داخل Pipeline قرار دهید.
- بازنمونهگیری را فقط در بخش آموزش انجام دهید.
- Cross-Validationرا متناسب با زمان و گروه طراحی کنید.
- مراقب آمارهای ساختهشده از برچسب باشید.
هنگام ارزیابی
- برای انتخابها از Validation استفاده کنید.
- Testرا برای ارزیابی نهایی نگه دارید.
- معیارهای متناسب با مسئله را گزارش کنید.
- عملکرد را بر اساس زمان و گروههای مستقل مقایسه کنید.
- نسخه داده، کد پیشپردازش و روش تقسیم را ثبت کنید.
آیا هر استفاده از کل داده نشت محسوب میشود؟
خیر. باید میان عملیات ثابت و عملیاتی که از داده چیزی یاد میگیرد تفاوت گذاشت.
برای مثال، تغییر نام یک ستون یا تبدیل یک واحد اندازهگیری با یک ضریب ثابت و از پیش تعیینشده، معمولاً آمار Train و Test را با هم مخلوط نمیکند. در مقابل، محاسبه میانگین کل ستون برای مقیاسبندی یا انتخاب ستون بر اساس برچسبها، اطلاعات داده را وارد تصمیمهای مدلسازی میکند.
همچنین زمانی که ارزیابی مستقل تمام شده و مدل نهایی انتخاب شده است، ممکن است برای آموزش نسخه نهایی از دادههای توسعه مجاز بیشتری استفاده شود. در این صورت دیگر نباید عملکرد آن نسخه را با همان دادهها بهعنوان آزمون مستقل گزارش کرد.
تفاوت نشت داده و بیشبرازش
این دو میتوانند همزمان رخ دهند، اما یکسان نیستند.
بیشبرازش یعنی مدل الگوهای خاص داده آموزش را بیش از اندازه یاد گرفته و روی داده جدید خوب تعمیم نمیدهد.
نشت داده یعنی مرز اطلاعات مجاز شکسته شده است؛ مثلاً Test در انتخاب ویژگی دیده شده یا یک ستون از آینده به مدل رسیده است.
ممکن است یک مدل بهدلیل بیشبرازش، عملکرد Train عالی و Test ضعیفی داشته باشد. در نشت داده، حتی خود Testنیز میتواند ظاهراً عالی باشد، چون فرایند توسعه به شکلی از اطلاعات آن استفاده کرده است.
نشت داده در سامانههای هوش مصنوعی وRAG
در سامانههای مبتنی بر مدل زبانی نیز باید مرز ارزیابی را رعایت کرد. چند نمونه:
- پاسخهای مجموعه آزمون در اسناد قابل بازیابی قرار گرفتهاند.
- نمونههای آزمون برای بازنویسی مکرر Prompt استفاده شدهاند و همان مجموعه همچنان «آزمون مستقل» نامیده میشود.
- دادهای که هنگام ارزیابی در پایگاه دانش موجود است، در زمان واقعی سؤال کاربر هنوز منتشر نشده بوده است.
- مکالمههای یک پرونده در Train و Test جدا افتادهاند.
- نسخههای نزدیک به هم یک پرسش در توسعه و آزمون وجود دارند.
برای ارزیابی معتبر، باید نسخه پایگاه دانش، زمان دسترسی اسناد، مجموعه سؤالها و تصمیمهای تنظیم Prompt یا مدل ثبت شوند.
پرسشهای متداول
Data Leakageچیست؟
نشت داده یعنی اطلاعاتی که هنگام آموزش یا تصمیمگیری واقعی نباید در دسترس مدل باشد، مستقیم یا غیرمستقیم وارد ساخت ویژگی، آموزش، انتخاب مدل یا ارزیابی شود.
آیا مقیاسبندی قبل از Train/Test Split اشتباه است؟
اگر روش مقیاسبندی پارامترهایش را از کل داده یاد بگیرد، بله؛ داده Test بر آن اثر گذاشته است. ابتدا تقسیم کنید و مقیاسبند را فقط روی Train آموزش دهید.
آیا Pipeline همه انواع نشت را حل میکند؟
خیر. Pipeline برای حفظ ترتیب صحیح بسیاری از تبدیلهای یادگیرنده بسیار مفید است، اما ستونهای حاوی اطلاعات آینده، دادههای تکراری و تقسیمبندی نادرست کاربران یا زمان را خودبهخود اصلاح نمیکند.
آیا SMOTE را قبل از تقسیم داده اجرا کنیم؟
خیر. داده ارزیابی را ابتدا جدا کنید. بازنمونهگیری باید در بخش آموزش و در صورت استفاده از Cross-Validation، داخل قسمت آموزشی هر Fold انجام شود.
اگر مدل روی Test دقت خیلی بالایی داشت، یعنی نشت وجود دارد؟
الزاماً خیر. دقت بالا نشانهای برای بررسی دقیقتر است، نه اثبات نشت. مسیر ساخت ویژگیها و استقلال داده آزمون را بررسی کنید.
آیا حذف شناسه کاربر جلوی نشت گروهی را میگیرد؟
نه همیشه. ویژگیهای دیگر ممکن است هویت کاربر را بهطور غیرمستقیم نشان دهند و نمونههای مرتبط همچنان در هر دو بخش حضور داشته باشند. اگر هدف، تعمیم به کاربران جدید است، تفکیک گروهی را بررسی کنید.
چرا انتخاب ویژگی قبل از Cross-Validation اشتباه است؟
چون اطلاعات بخش اعتبارسنجی هر Fold در تصمیم انتخاب ستونها اثر میگذارد. انتخاب ویژگی باید درون Pipeline و داخل حلقه اعتبارسنجی انجام شود.
آیا داده بدون برچسب Test هم میتواند باعث نشت شود؟
بله. بعضی مراحل مانند مقیاسبندی آمار ویژگیها را از داده یاد میگیرند. استفاده از ویژگیهای Test برای یادگیری این آمار میتواند ارزیابی معمولِ تعمیم به داده ندیده را مخدوش کند. طراحیهای خاصی که عمداً دسترسی به داده بدون برچسب آینده را مجاز میدانند، باید جداگانه تعریف و همانطور گزارش شوند.
جمعبندی
نشت داده یکی از دلایلی است که مدل میتواند در آزمایش موفق و در استفاده واقعی ناموفق باشد. این مشکل فقط به وجود یک «ستون واضح حاوی پاسخ» محدود نمیشود؛ انتخاب ویژگی، مقیاسبندی، بازنمونهگیری، دادههای تکراری، گروههای مرتبط، اطلاعات آینده و استفاده مکرر از Test هم میتوانند ارزیابی را مخدوش کنند.
در مثال Python، ویژگیها و برچسبها کاملاً تصادفی بودند. بااینحال انتخاب ویژگی پیش از تفکیک، دقتی ظاهراً خوب ساخت. وقتی همان مرحله را داخل Pipeline و فقط بر اساس Train اجرا کردیم، آن مزیت ساختگی از بین رفت.
راه پیشگیری از تعریف دقیق زمان پیشبینی، اطلاعات مجاز و واحد مستقل آزمون شروع میشود. سپس باید همه مراحل یادگیرنده را در مرز درست آموزش قرار داد و مجموعه ارزیابی نهایی را مستقل نگه داشت.
از ارزیابی معتبر تا محصول هوش مصنوعی
اگر قرار است مدل طبقهبندی، تحلیل پیام یا سامانه پشتیبانی هوشمند را وارد محصول کنید، ارزیابی باید همان اطلاعاتی را در اختیار مدل بگذارد که در زمان استفاده واقعی موجود خواهد بود. این کار کمک میکند پیش از سرمایهگذاری روی استقرار، کیفیت واقعی راهکار را بسنجید.
برای آشنایی با خدمات و زیرساخت هوش مصنوعی درواره و بررسی کاربرد آن در محصول خود، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- اعتبارسنجی متقاطع و K-Fold درPython
- مهندسی ویژگی و انتخاب ویژگی
- داده نامتوازن وSMOTE
- بیشبرازش و کمبرازش در یادگیری ماشین
- کالیبراسیون احتمال و انتخاب آستانه
- توضیحپذیری مدل با SHAP وLIME
- ارزیابی مدل هوش مصنوعی وEvals
- MLOps و LLMOpsچیست؟
منابع
- scikit-learn: Common Pitfalls and Recommended Practices scikit-learn.org
- scikit-learn: Feature Selection in a Pipeline scikit-learn 1.9.1 documentation
- imbalanced-learn: Common Pitfalls and Data Leakage imbalanced-learn.org
- scikit-learn: TimeSeriesSplit scikit-learn 1.9.0 documentation
- scikit-learn: GroupShuffleSplit scikit-learn.org
- scikit-learn: Target Encoder’s Internal Cross-fitting scikit-learn 1.9.1 documentation
- scikit-learn: Nested versus Non-nested Cross-validation scikit-learn.org
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و صفحه سلب مسئولیت درواره را مطالعه کنید.



