
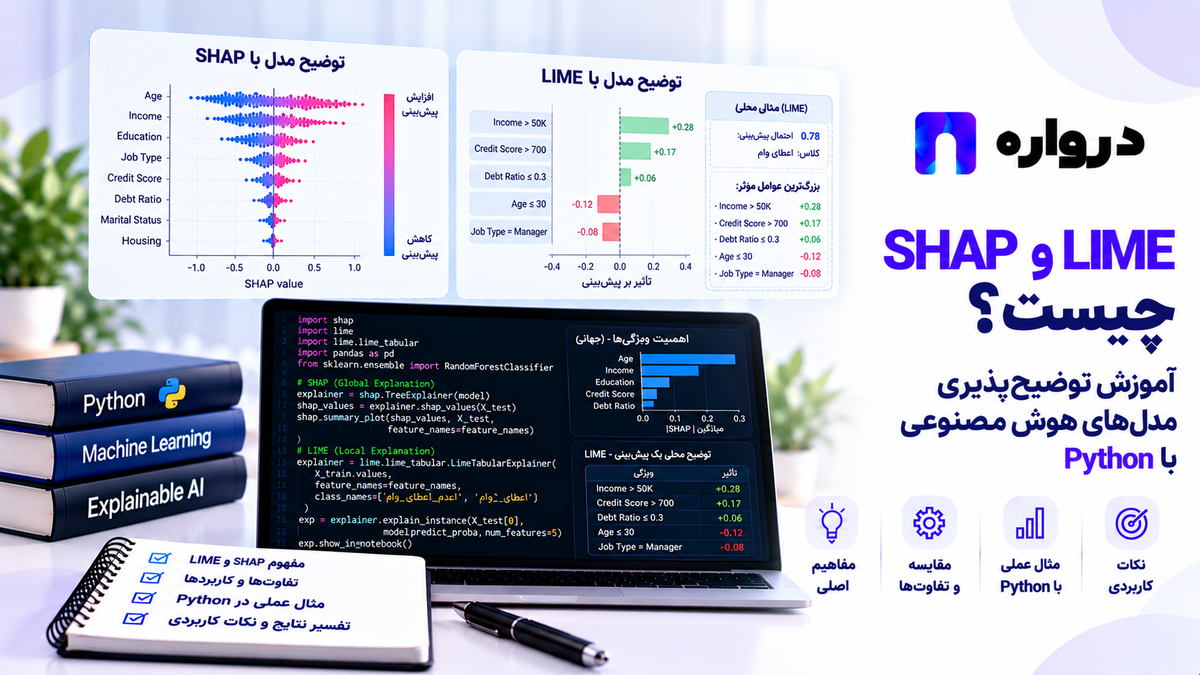
SHAP و LIME چیست؟ آموزش توضیحپذیری مدلهای هوش مصنوعی با Python
چرا یک مدل برای نمونهای خاص این پیشبینی را انجام داده است؟ در این آموزش جامع، توضیحپذیری هوش مصنوعی، SHAP، LIME و Permutation Importance را میشناسید و با Python سهم ویژگیها را در پیشبینیهای یک مدل بررسی میکنید.

یک مدل یادگیری ماشین پیشبینی میکند که یک درخواست پشتیبانی امتیاز اولویت بالایی دارد. اما چرا؟ آیا تعداد خطاهای اخیر اثرگذار بوده است، مدت انتظار کاربر، یا ویژگی دیگری که اصلاً نباید مبنای تصمیم باشد؟
معیارهایی مانند دقت و خطای میانگین نشان میدهند مدل در مجموع چگونه عمل میکند. آنها بهتنهایی توضیح نمیدهند که برای یک نمونه مشخص، کدام ویژگیها خروجی را تغییر دادهاند.
Explainable AI یا هوش مصنوعی توضیحپذیر مجموعهای از روشها برای بررسی رفتار مدل است. دو روش شناختهشده در این حوزه SHAP و LIME هستند. هر دو میتوانند برای یک پیشبینی مشخص توضیحی درباره اثر ویژگیها ارائه دهند، اما تعریف «اثر»، نحوه محاسبه و محدودیتهای آنها یکسان نیست.
در این مقاله ابتدا مفاهیم را روشن میکنیم و سپس با Python یک مدل میسازیم، عملکرد آن را میسنجیم و پیشبینیهایش را با SHAP، LIME و Permutation Importance بررسی میکنیم.
توضیحپذیری مدل یعنی چه؟
توضیحپذیری یعنی بتوانیم رفتار یک مدل را برای پرسشهای مشخص بررسی کنیم؛ برای مثال:
- کدام ویژگیها در عملکرد کلی مدل نقش بیشتری دارند؟
- چرا پیشبینی یک نمونه از مقدار مرجع بالاتر است؟
- آیا مدل به ویژگیای وابسته شده که احتمال نشت اطلاعات دارد؟
- آیا توضیح یک نمونه با توضیح نمونههای مشابه سازگار است؟
- وقتی مقدار یک ویژگی تغییر میکند، خروجی مدل چگونه تغییر میکند؟
پاسخ هر پرسش به روش متفاوتی نیاز دارد. توضیح یک پیشبینی منفرد را نباید بدون بررسی بیشتر به کل مدل تعمیم داد.
همچنین توضیحپذیری مدل با توضیح علت واقعی یک رخداد تفاوت دارد. اگر یک ویژگی در خروجی مدل اثرگذار باشد، از این مشاهده بهتنهایی نمیتوان نتیجه گرفت آن ویژگی علت وقوع رویداد در جهان واقعی است.
تفاوت توضیح سراسری و توضیح محلی
روشهای توضیحپذیری معمولاً به دو نوع پرسش پاسخ میدهند.
توضیح سراسری یاGlobal Explanation
این نوع تحلیل رفتار مدل را روی مجموعهای از نمونهها بررسی میکند:
- کدام ویژگیها در میان نمونهها اهمیت بیشتری دارند؟
- مدل در بخشهای مختلف داده چگونه رفتار میکند؟
- آیا وابستگی مدل به یک ویژگی در زمان تغییر کرده است؟
برای مثال، میتوان میانگین اندازه اثر یک ویژگی را روی صدها نمونه محاسبه کرد. حاصل، تصویری کلی از رفتار مدل روی همان مجموعه بررسیشده است.
توضیح محلی یاLocal Explanation
توضیح محلی روی یک نمونه تمرکز دارد:
- چرا مدل برای این درخواست امتیاز ۷۵ پیشبینی کرده است؟
- کدام ویژگیها پیشبینی این نمونه را بالا بردهاند؟
- کدام ویژگیها آن را پایین آوردهاند؟
SHAP و LIME هر دو برای توضیح محلی استفاده میشوند. توضیحهای SHAPرا میتوان روی چندین نمونه تجمیع کرد تا نمایی کلیتر نیز به دست آید.
SHAPچیست؟
SHAP مخفف SHapley Additive exPlanations است. این چارچوب سهم ویژگیها را در خروجی یک مدل برای یک نمونه مشخص بررسی میکند.
در یک توضیح SHAP معمولاً با دو بخش روبهرو هستیم:
- مقدار مرجع: خروجی مبنا که بر اساس نحوه تعریف توضیح و داده مرجع به دست میآید.
- سهم ویژگیها: مقدارهایی که نشان میدهند هر ویژگی، پیشبینی آن نمونه را نسبت به مقدار مرجع در چه جهتی تغییر داده است.
برای مثال، اگر خروجی مرجع مدل ۵۰ و پیشبینی یک نمونه ۷۰ باشد، توضیح نشان میدهد ویژگیها چگونه در مجموع خروجی آن نمونه را از مقدار مرجع به ۷۰ رساندهاند.
مقاله اصلی SHAP این چارچوب را برای نسبت دادن سهم به ویژگیها در یک پیشبینی معرفی میکند. papers.nips.cc
سهم مثبت و منفی درSHAP
برای مدلی که یک امتیاز عددی پیشبینی میکند:
- مقدارSHAP مثبت یعنی آن ویژگی، پیشبینی این نمونه را نسبت به مقدار مرجع بالاتر برده است.
- مقدارSHAP منفی یعنی آن ویژگی، پیشبینی را پایینتر برده است.
علامت اثر همیشه باید نسبت به خروجی مشخصی که توضیح میدهید خوانده شود. در طبقهبندی، توضیح احتمال یک کلاس و توضیح خروجی خام مدل ممکن است مقیاس متفاوتی داشته باشند.
داده مرجع در SHAP چرا مهم است؟
برای گفتن اینکه یک ویژگی خروجی را «نسبت به چه چیزی» تغییر داده، به یک وضعیت مرجع نیاز داریم. انتخاب داده پسزمینه یا Background Data میتواند بر مقدار مرجع و سهمهای محاسبهشده اثر بگذارد.
برای نمونه، اگر مدل را روی همه کاربران آموزش دادهاید اما پسزمینه را فقط از کاربران یک گروه انتخاب کنید، توضیحها نسبت به همان گروه مرجع تفسیر میشوند.
بنابراین هنگام ارائه یک توضیح SHAP، بهتر است ثبت کنید:
- نسخه مدل چه بوده است؟
- کدام خروجی مدل توضیح داده شده است؟
- داده پسزمینه از کجا آمده است؟
- پیشپردازش ویژگیها چگونه انجام شده است؟
مستندات TreeExplainer نیز رفتار روش را به انتخاب داده پسزمینه و شیوه برخورد با وابستگی ویژگیها مرتبط میداند. SHAP latest documentation
LIMEچیست؟
LIME مخفف Local Interpretable Model-agnostic Explanations است. ایده آن این است که برای توضیح یک پیشبینی، نمونههایی در اطراف ورودی موردنظر بسازد، خروجی مدل اصلی را برای آنها بگیرد و سپس یک مدل سادهتر را برای تقریب رفتار محلی مدل آموزش دهد.
به زبان ساده، LIME میپرسد:
نزدیک این نمونه، تغییر ویژگیها چگونه با تغییر پیشبینی مدل همراه است؟
مقاله اصلی LIME این روش را برای توضیح پیشبینی طبقهبندها معرفی کرده است. پیادهسازی رسمی آن مثالهایی برای داده جدولی، متن، تصویر و رگرسیون نیز دارد. doi.org
ویژگی مهمLIME
LIMEمعمولاً برای استفاده نیازی به دانستن ساختار داخلی مدل ندارد. اگر بتوانید تابعی برای گرفتن پیشبینی مدل فراهم کنید، میتوانید رفتار محلی آن را بررسی کنید.
بااینحال، توضیح حاصل به نحوه ساخت نمونههای اطراف ورودی، تعریف «نزدیکی»، تعداد نمونههای مصنوعی و تنظیمات روش وابسته است.
تفاوت SHAP وLIME
| معیار | SHAP | LIME |
|---|---|---|
| ایده اصلی | نسبت دادن سهم به ویژگیها نسبت به یک مقدار مرجع | تقریب رفتار مدل در نزدیکی یک نمونه |
| خروجی رایج | سهم هر ویژگی در پیشبینی | وزن ویژگیها در مدل ساده محلی |
| تمرکز | توضیح محلی و امکان تجمیع روی نمونهها | توضیح محلی |
| وابستگی به مدل | به روش انتخابی بستگی دارد؛ روشهای ویژه مدلهای درختی نیز دارد | معمولاً مستقل از ساختار داخلی مدل |
| عامل اثرگذار در نتیجه | داده مرجع، تعریف خروجی و شیوه توضیح | نمونهسازی، تعریف همسایگی و تنظیمات تقریب |
| تفسیر عددها | سهمها در مقیاس خروجی توضیحدادهشدهاند | وزنهای یک تقریب محلیاند |
| خطر تفسیر نادرست | تبدیل سهم مدل به ادعای علت واقعی | تعمیم توضیح محلی به همه دادهها |
اگر SHAP و LIME برای یک نمونه پاسخهایی متفاوت دادند، الزاماً یکی «خراب» نیست. ابتدا بررسی کنید آیا واقعاً یک خروجی، یک نسخه مدل و یک نمایش یکسان از ویژگیها را توضیح میدهند یا خیر. سپس پایداری توضیحها را آزمایش کنید.
Permutation Importanceچیست؟
Permutation Importance روش دیگری برای بررسی اهمیت ویژگیهاست. در این روش عملکرد مدل روی داده ارزیابی سنجیده میشود؛ سپس مقدارهای یک ویژگی در میان نمونهها جابهجا میشوند و عملکرد دوباره سنجیده میشود.
اگر پس از جابهجایی یک ویژگی، عملکرد مدل بهطور محسوس افت کند، این ویژگی برای عملکرد آن مدل روی آن داده مهم بوده است.
این روش به پرسش متفاوتی پاسخ میدهد:
اگر رابطه مشاهدهشده میان این ستون و نمونههای دیگر را بر هم بزنیم، عملکرد مدل چه مقدار تغییر میکند؟
مستندات scikit-learn تأکید میکند که این اهمیت به مدل آموزشدیده، داده ارزیابی و معیار عملکرد انتخابی وابسته است؛ ویژگی یک خاصیت ثابت و مستقل از این شرایط ندارد. scikit-learn 1.9.1 documentation
Permutation Importance معمولاً برای نمای کلی مفید است، اما مانند توضیح SHAPیک پیشبینی منفرد را به سهم ویژگیها تجزیه نمیکند.
آموزش عملی SHAP و LIME باPython
برای قابلاجرا بودن مثال بدون دریافت دیتاست بیرونی، داده عددی ساختگی تولید میکنیم. مسئله از نوع رگرسیون است؛ مدل یک امتیاز پیوسته را پیشبینی میکند.
انتخاب رگرسیون کمک میکند مقیاس خروجی و سهم ویژگیها روشن باشد. مفاهیم توضیحپذیری در طبقهبندی نیز کاربرد دارند، ولی باید مشخص کنید خروجی خام مدل، امتیاز یا احتمال کدام کلاس را توضیح میدهید.
نصب کتابخانهها
pip install numpy pandas matplotlib scikit-learn shap limeاز آنجا که API کتابخانههای نرمافزاری ممکن است تغییر کند، برای اجرای دوباره پروژه در آینده نسخه بستههای استفادهشده را ثبت کنید.
ساخت دیتاست
import numpy as npimport pandas as pdfrom sklearn.datasets import make_regressionfrom sklearn.model_selection import train_test_splitRANDOM_STATE = 42feature_names = [ f"feature_{index}" for index in range(1, 9)]X_array, y = make_regression( n_samples=1200, n_features=8, n_informative=5, noise=12, random_state=RANDOM_STATE,)X = pd.DataFrame( X_array, columns=feature_names,)X_development, X_test, y_development, y_test = ( train_test_split( X, y, test_size=0.20, random_state=RANDOM_STATE, ))با این تقسیم، حدود ۶۰ درصد نمونهها برای آموزش، ۲۰ درصد برای اعتبارسنجی و ۲۰ درصد برای آزمون نهایی استفاده میشوند.
نام ویژگیها عمداً عمومی است. در پروژه واقعی نام هر ویژگی، واحد اندازهگیری و زمان در دسترس بودن آن باید مشخص باشد.
آموزش مدلRandom Forest
from sklearn.ensemble import RandomForestRegressorfrom sklearn.metrics import ( mean_absolute_error, r2_score,)model = RandomForestRegressor( n_estimators=150, max_depth=6, min_samples_leaf=5, n_jobs=-1, random_state=RANDOM_STATE,)model.fit( X_train, y_train,)validation_predictions = model.predict( X_val)print( "Validation MAE:", mean_absolute_error( y_val, validation_predictions, ),)print( "Validation R2:", r2_score( y_val,پیش از توضیحدادن مدل، عملکرد آن را بسنجید. توضیح دقیق رفتار مدلی که روی داده مستقل عملکرد ضعیفی دارد، بهتنهایی آن مدل را برای استفاده عملی مناسب نمیکند.
توضیح پیشبینیها باSHAP
برای مدل درختی از TreeExplainer استفاده میکنیم. یک نمونه کوچک از داده آموزش را بهعنوان پسزمینه انتخاب میکنیم و توضیحها را برای بخشی از داده Validation محاسبه میکنیم.
import shap


background = X_train.sample(
    n=60,
    random_state=RANDOM_STATE,
)

examples_to_explain = X_val.iloc[:40]

explainer = shap.TreeExplainer(
    model,
    data=background,
    feature_perturbation="interventional",
)

shap_values = explainer(
    examples_to_explain
)

print("SHAP values shape:", shap_values.values.shape)
در این مثال، اندازه پسزمینه و تعداد نمونههای توضیحدادهشده را محدود کردهایم تا اجرای آموزشی سبکتر باشد. در پروژه واقعی باید بررسی کنید انتخاب پسزمینه تا چه حد نماینده دادهای است که قصد توضیح آن را دارید.
مستنداتSHAP، TreeExplainer را برای بسیاری از مدلهای درختی، از جمله مدلهای درختی scikit-learn، معرفی میکند. SHAP latest documentation
بررسی یک پیشبینی مشخص
sample_index = 0

sample = examples_to_explain.iloc[
    [sample_index]
]

model_prediction = float(
    model.predict(sample)[0]
)

base_value = float(
    np.asarray(
        shap_values[
            sample_index
        ].base_values
    ).item()
)

feature_contributions = (
    shap_values[
        sample_index
    ].values
)

reconstructed_prediction = (
    base_value
    + feature_contributions.sum()
)

print("Model prediction:", model_prediction)
print("SHAP base value:", base_value)

print(
    "Base plus contributions:",
    reconstructed_prediction,
)
مقدار مرجع و سهم ویژگیها باید پیشبینی مدل را در همان مقیاس توضیحدادهشده بازسازی کنند. اگر تفاوت غیرمنتظرهای دیدید، نسخه کتابخانه، نوع خروجی مدل و تنظیمات توضیحدهنده را بررسی کنید.
نمایش سهم هر ویژگی بهصورت جدول
contribution_table = pd.DataFrame( { "feature": feature_names, "feature_value": ( sample.iloc[0].to_numpy() ), "shap_contribution": ( feature_contributions ), })contribution_table[ "absolute_contribution"] = ( contribution_table[ "shap_contribution" ].abs())contribution_table = ( contribution_table.sort_values( "absolute_contribution", ascending=False, ))print( contribution_table.to_string( index=False ))این جدول نشان میدهد کدام ویژگیها برای همین نمونه اثر عددی بزرگتری در توضیح دارند. بزرگ بودن قدر مطلق سهم به معنای خوب یا بد بودن آن ویژگی برای همه نمونهها نیست.
نمودار Waterfall درSHAP
نمودار Waterfall توضیح یک نمونه را از مقدار مرجع تا پیشبینی نهایی نشان میدهد:
import matplotlib.pyplot as pltshap.plots.waterfall( shap_values[sample_index], max_display=8, show=False,)plt.tight_layout()plt.show()در این نمودار میتوان دید کدام ویژگیها خروجی را به سمت بالا و کدامها به سمت پایین بردهاند.
برای استفاده در گزارش، کنار تصویر بنویسید:
- خروجی چه چیزی را نشان میدهد؟
- واحد خروجی چیست؟
- نمونه مربوط به کدام بازه زمانی است؟
- داده مرجع توضیح از چه مجموعهای انتخاب شده است؟
بدون این زمینه، نمودار ممکن است ظاهراً روشن باشد ولی برداشت اشتباه ایجاد کند.
نمودار Beeswarm درSHAP
نمودار Beeswarm چندین توضیح محلی را در کنار هم نمایش میدهد:
shap.plots.beeswarm(
    shap_values,
    max_display=8,
    show=False,
)

plt.tight_layout()
plt.show()
در این نمودار:
- هر نقطه به یک نمونه مربوط است.
- موقعیت افقی، سهم ویژگی در خروجی آن نمونه را نشان میدهد.
- ویژگیها معمولاً بر اساس بزرگی اثر در مجموعه نمایشدادهشده مرتب میشوند.
- رنگ نقطه، در حالت معمول، اطلاعاتی از مقدار همان ویژگی نشان میدهد.
نمودار Beeswarm به شما کمک میکند ببینید یک ویژگی فقط برای چند نمونه خاص اثر زیادی دارد یا در نمونههای متعددی اثرگذار است. مستندات رسمی SHAP نیز این نمودار را برای نمایش مجموعهای از توضیحها ارائه میکند. SHAP latest documentation
محدودیت مهم: در کد ما نمودار فقط بر اساس ۴۰ نمونه نخست Validation ساخته میشود. برای نتیجهگیری درباره رفتار گستردهتر مدل، نمونههای کافی و نماینده انتخاب کنید.
اهمیت کلی ویژگیها با میانگین سهمSHAP
mean_absolute_shap = np.abs(
    shap_values.values
).mean(axis=0)

shap_importance = (
    pd.Series(
        mean_absolute_shap,
        index=feature_names,
        name="mean_absolute_shap",
    )
    .sort_values(
        ascending=False
    )
)

print(shap_importance)
این مقدار، میانگین بزرگی سهم هر ویژگی روی نمونههای توضیحدادهشده است. چون قدر مطلق گرفتهایم، جهت اثر در آن دیده نمیشود. برای بررسی اینکه یک ویژگی در چه شرایطی پیشبینی را بالا یا پایین میبرد، به نمودارهای توزیعی و نمونههای منفرد رجوع کنید.
توضیح همان نمونه باLIME
اکنون همان نمونهای را که با SHAP توضیح دادیم، به LIME میدهیم. در این مثال، LIME برای رگرسیون تنظیم میشود.
from lime.lime_tabular import (
    LimeTabularExplainer,
)


lime_explainer = (
    LimeTabularExplainer(
        training_data=(
            X_train.to_numpy()
        ),
        feature_names=feature_names,
        mode="regression",
        discretize_continuous=True,
        random_state=RANDOM_STATE,
    )
)
تابع پیشبینی را طوری مینویسیم که داده تولیدشده توسط LIME با همان ترتیب ستونها به مدل برسد:
def predict_for_lime(
    data: np.ndarray,
) -> np.ndarray:
    frame = pd.DataFrame(
        data,
        columns=feature_names,
    )

    return model.predict(frame)
حالا توضیح محلی را میسازیم:
lime_explanation = (
    lime_explainer.explain_instance(
        data_row=(
            sample.iloc[0].to_numpy()
        ),
        predict_fn=predict_for_lime,
        num_features=8,
        num_samples=1000,
    )
)

for condition, weight in (
    lime_explanation.as_list()
):
    print(
        condition,
        round(weight, 4),
    )
در این خروجی ممکن است بهجای نام ساده ویژگی، بازهای از مقدار ویژگی دیده شود. این موضوع با discretize_continuous=True ارتباط دارد.
وزنهای LIME متعلق به مدل سادهای هستند که در نزدیکی این نمونه ساخته شده است. آنها را بدون توجه به شیوه ساخت همسایگی، معادل مستقیم سهمهای SHAP نگیرید.
برای نمایش نمودار:
lime_explanation.as_pyplot_figure()

plt.tight_layout()
plt.show()
نمونه رسمی LIME نیز برای رگرسیون از LimeTabularExplainer همراه با تابع predict مدل استفاده میکند. marcotcr.github.io
آیا توضیح LIME پایدار است؟
LIMEبرای ساخت توضیح از نمونهسازی در اطراف ورودی استفاده میکند. برای بررسی پایداری، میتوانید توضیح همان نمونه را با چند مقدار مختلف random_state بسازید و ویژگیهای برجسته را مقایسه کنید.
اگر توضیحها با تغییر کوچک تنظیمات مرتباً دگرگون میشوند، باید هنگام استفاده عملی محتاط باشید. این ناپایداری ممکن است به ویژگیهای بهشدت وابسته، رفتار پیچیده مدل در اطراف نمونه یا شیوه نمونهسازی مربوط باشد.
یک بررسی ساده:
for seed in [11, 22, 33]:
    repeated_explainer = (
        LimeTabularExplainer(
            training_data=(
                X_train.to_numpy()
            ),
            feature_names=feature_names,
            mode="regression",
            discretize_continuous=True,
            random_state=seed,
        )
    )

    explanation = (
        repeated_explainer.explain_instance(
            data_row=(
                sample.iloc[0].to_numpy()
            ),
            predict_fn=predict_for_lime,
            num_features=5,
            num_samples=1000,
        )
    )

    print(
        f"Seed {seed}:",
        explanation.as_list(),
    )
برابری کامل خروجیها شرط لازم نیست؛ هدف این است که بفهمید روایت کلی توضیح با تغییر معقول تنظیمات تا چه حد حفظ میشود.
اهمیت ویژگیها باPermutation Importance
برای مقایسه، اهمیت ویژگیها را با جابهجایی ستونها روی مجموعه Validation نیز میسنجیم:
from sklearn.inspection import (
    permutation_importance,
)


permutation_result = (
    permutation_importance(
        model,
        X_val,
        y_val,
        scoring=(
            "neg_mean_absolute_error"
        ),
        n_repeats=10,
        random_state=RANDOM_STATE,
        n_jobs=-1,
    )
)

permutation_table = (
    pd.DataFrame(
        {
            "feature": feature_names,
            "importance_mean": (
                permutation_result
                .importances_mean
            ),
            "importance_std": (
                permutation_result
                .importances_std
            ),
        }
    )
    .sort_values(
        "importance_mean",
        ascending=False,
    )
)

print(
    permutation_table.to_string(
        index=False
    )
)
چون معیار انتخابی neg_mean_absolute_error است، مقدار مثبت و بزرگتر معمولاً نشان میدهد جابهجایی آن ویژگی عملکرد مدل را بیشتر خراب کرده است.
این مقدار را با میانگین قدر مطلق SHAP برابر ندانید؛ تعریف، واحد و پرسش این دو روش متفاوت است.
چرا نتایج روشهای اهمیت ویژگی ممکن است فرق کنند؟
فرض کنید دو ستون تقریباً اطلاعات یکسانی دارند. مدل میتواند برای پیشبینی از یکی، دیگری یا ترکیبی از هر دو استفاده کند.
در چنین وضعی:
- جابهجایی یکی از ستونها ممکن است افت عملکرد کمی ایجاد کند، چون ستون دیگر بخشی از اطلاعات را حفظ کرده است.
- سهم محلی میان دو ویژگی ممکن است به انتخاب داده مرجع و شیوه توضیح وابسته باشد.
- ترتیب اهمیت ویژگیها میان روشها تفاوت پیدا میکند.
مستندات scikit-learn نمونهای از مشکل ویژگیهای همبسته در Permutation Importance نشان میدهد: با وجود عملکرد خوب مدل، اهمیت تکتک ویژگیهای همبسته میتواند کم به نظر برسد. scikit-learn 1.9.1 documentation
برای تحلیل دقیقتر، ویژگیهای همبسته را شناسایی کنید و در صورت لزوم اثر گروهی آنها را بررسی کنید. از روی رتبه یک ویژگی در یک نمودار، درباره بیاهمیت بودن واقعی آن نتیجه قطعی نگیرید.
آیا SHAP رابطه علت و معلولی را نشان میدهد؟
خیر؛ SHAP رفتار مدل را در چارچوب داده، خروجی و فرضهای روش توضیح میدهد. از مشاهده سهم یک ویژگی نمیتوان بهتنهایی نتیجه گرفت تغییر آن ویژگی در جهان واقعی باعث تغییر همانقدر در نتیجه خواهد شد.
برای مثال، اگر «تعداد تماسهای قبلی» سهم مثبتی در امتیاز اولویت یک درخواست داشته باشد، ممکن است این ستون نشانهای از دشواری مسئله باشد. کم کردن مصنوعی تعداد تماسهای ثبتشده، مسئله واقعی کاربر را حل نمیکند.
برای تصمیم علّی باید طراحی مطالعه، ترتیب زمانی، عوامل مخدوشکننده و امکان مداخله واقعی را جداگانه بررسی کرد.
توضیحپذیری در مدلهای طبقهبندی
در طبقهبندی، پیش از تفسیر عددها این پرسشها را پاسخ دهید:
- کدام کلاس توضیح داده میشود؟
- خروجی مورد بررسی احتمال است یا امتیاز خام؟
- آیا احتمالهای مدل کالیبره شدهاند؟
- پیشپردازش در داده توضیح و داده پیشبینی یکسان است؟
اگر ویژگیای سهم مثبتی در احتمال کلاس مثبت داشته باشد، تفسیر آن با سهم مثبت در یک خروجی خام با مقیاس متفاوت یکسان نیست.
همچنین توضیح اینکه چرا مدلی به یک پیام برچسب «فوری» داده، با انتخاب آستانهای که پیام را فوری میکند فرق دارد. برای تصمیمگیری عملی، احتمال، کالیبراسیون و آستانه را نیز بررسی کنید.
SHAP و LIMEبرای متن فارسی
در طبقهبندی متن فارسی میتوان از روشهای توضیح محلی برای بررسی اثر بخشهایی از متن بر پیشبینی مدل استفاده کرد. برای مثال، یک مدل دستهبندی تیکت ممکن است به واژهها یا عبارتهایی درباره «عدم دسترسی»، «خطا» یا «پرداخت» حساس باشد.
اما حذف یا پوشاندن توکنهای متن ممکن است ورودیهای غیرطبیعی بسازد. در فارسی نیز مواردی مانند نیمفاصله، پسوندها، شکلهای مختلف نوشتاری و توکنسازی بر تحلیل اثر دارند.
برای تفسیر چنین توضیحهایی:
- روش توکنسازی را ثبت کنید.
- متنهای طبیعی و غیرطبیعی تولیدشده در فرایند توضیح را بررسی کنید.
- توضیحها را روی مثالهای متعدد بسنجید.
- تغییر یک واژه را معادل تغییر مستقل یک مفهوم در دنیای واقعی ندانید.
- برای نتیجه عملی، از بازبینی انسانی و مجموعه ارزیابی مستقل استفاده کنید.
SHAPدر مستندات خود ابزارهایی برای توضیح داده متنی نیز معرفی میکند. روش مناسب به مدل، نوع خروجی و هزینه محاسباتی وابسته است. SHAP latest documentation
توضیحپذیری در سامانههای مبتنی بر مدل زبانی
در یک سامانه پاسخگویی یا پشتیبانی، «توضیح پاسخ» ممکن است به چند پرسش متفاوت اشاره کند:
- کدام سند بازیابیشده پشتوانه پاسخ بوده است؟
- مدل برای انتخاب یک ابزار چه اطلاعاتی دریافت کرده است؟
- چه قاعدهای اجازه اجرای یک اقدام را داده است؟
- چرا درخواست به انسان ارجاع داده شده است؟
- آیا پاسخ نهایی واقعاً با منبع استنادش سازگار است؟
نمودار SHAP یک مدل طبقهبندی میتواند رفتار همان طبقهبند را توضیح دهد؛ اما بهتنهایی پاسخ همه این پرسشها درباره یک سامانه چندمرحلهای را نمیدهد.
برای محصولی که از بازیابی دانش، مدل زبانی و ابزارهای اجرایی استفاده میکند، ثبت منبع، نسخه مدل، ورودی، تصمیم ابزار، نتیجه اعتبارسنجی و ارزیابی پاسخ نیز اهمیت دارد.
چگونه توضیحپذیری را در پروژه واقعی استفاده کنیم؟
۱. پرسش را دقیق تعریف کنید
«مدل را توضیح بده» بیش از حد کلی است. مشخص کنید میخواهید یک پیشبینی را بررسی کنید، وابستگی کلی مدل به ویژگیها را بسنجید یا خطای یک گروه از نمونهها را پیدا کنید.
۲. ابتدا کیفیت مدل را ارزیابی کنید
خطای مدل، عملکرد روی داده مستقل و نتیجه به تفکیک گروهها را بررسی کنید. توضیحپذیری جایگزین ارزیابی عملکرد نیست.
۳. داده و خروجی توضیح را ثبت کنید
نسخه مدل، ترتیب ستونها، پیشپردازش، داده مرجع، نوع خروجی و نسخه کتابخانه را کنار توضیح نگه دارید.
۴. چند روش را متناسب با پرسش مقایسه کنید
برای یک مدل جدولی میتوانید توضیح محلی SHAP یا LIME را با Permutation Importance روی داده اعتبارسنجی همراه کنید. اختلاف نتایج را بررسی کنید، چون هر روش رفتار متفاوتی را اندازه میگیرد.
۵. نمونههای دشوار را عمداً بررسی کنید
فقط چند نمونهای را که مدل در آنها درست عمل کرده انتخاب نکنید. خطاهای بزرگ، موارد مرزی، نمونههای نادر و تغییرات زمانی را نیز ببینید.
۶. پایداری توضیح را بسنجید
بررسی کنید توضیح با تغییر معقول نمونههای مرجع، انتخاب بازه زمانی یا تنظیمات روش چقدر تغییر میکند.
۷. توضیح را به تصمیم قابل بررسی تبدیل کنید
اگر توضیح نشان میدهد مدل به یک ویژگی نامناسب متکی است، کیفیت داده و فرایند ساخت ویژگی را اصلاح کنید؛ صرفاً نمایش یک نمودار کافی نیست.
اشتباهات رایج در استفاده از SHAP وLIME
تفسیر سهم ویژگی بهعنوان علت واقعی
این روشها رفتار مدل را بررسی میکنند. برای ادعای علت و معلول شواهد و طراحی جداگانه لازم است.
نمایش توضیح بدون بیان مقدار مرجع
«این ویژگی پیشبینی را افزایش داد» ناقص است، مگر روشن باشد افزایش نسبت به کدام وضعیت مرجع سنجیده شده است.
جمعبندی کلی از چند نمونه محدود
یک Waterfall برای یک نمونه، نماینده کل کاربران یا همه دورههای زمانی نیست.
مقایسه عددهای SHAP و LIME مانند واحدهای یکسان
SHAP سهمها را در مقیاس خروجی مورد توضیح گزارش میکند؛ LIMEوزنهای یک تقریب محلی را میدهد. عددهای آنها را مستقیم رتبهبندی نکنید.
فراموشکردن وابستگی ویژگیها
ویژگیهای همبسته میتوانند تفسیر اهمیت را دشوار کنند. لازم است وابستگی آنها بررسی شود.
توضیحدادن داده پس از پیشپردازش بدون نگاشت به ویژگی اصلی
اگر مدل صدها ستون حاصل از رمزگذاری ویژگیهای دستهای دارد، توضیح ستونهای فنی برای کاربر نهایی کافی نیست. در گزارش باید ارتباط آنها با ویژگیهای اصلی روشن باشد.
استفاده از توضیح بهجای ارزیابی کیفیت
ممکن است توضیح یک پیشبینی بسیار منسجم به نظر برسد، در حالی که پیشبینی مدل اشتباه است. دقت و پایداری را جداگانه بسنجید.
پرسشهای متداول
Explainable AIچیست؟
هوش مصنوعی توضیحپذیر به روشهایی گفته میشود که برای بررسی و فهم رفتار مدلها به کار میروند؛ از جمله تحلیل اثر ویژگیها و توضیح پیشبینی یک نمونه.
SHAPچیست؟
SHAPچارچوبی برای نسبت دادن سهم به ویژگیها در خروجی یک مدل است. توضیح حاصل نشان میدهد ویژگیهای یک نمونه چگونه پیشبینی آن را نسبت به یک مقدار مرجع تغییر دادهاند.
LIMEچیست؟
LIMEروشی برای توضیح محلی است که رفتار مدل اصلی را در اطراف یک نمونه با مدلی سادهتر تقریب میزند.
فرق SHAP و LIME چیست؟
SHAP سهم ویژگیها را در چارچوب روش انتخابی و مقدار مرجع محاسبه میکند. LIMEیک تقریب محلی از رفتار مدل میسازد. تفاوت فرضها و روش محاسبه میتواند به توضیحهای متفاوت منجر شود.
TreeExplainerبرای چه مدلهایی مناسب است؟
برای بسیاری از مدلهای مبتنی بر درخت، از جمله برخی مدلهای scikit-learn و کتابخانههای رایج مدلهای درختی، استفاده میشود. سازگاری مدل و تنظیمات خروجی را در مستندات نسخه مورد استفاده بررسی کنید.
آیا مقدار SHAP مثبت یعنی آن ویژگی خوب است؟
خیر. مقدار مثبت یعنی آن ویژگی، خروجی توضیحدادهشده را نسبت به مقدار مرجع افزایش داده است. مطلوب یا نامطلوب بودن این افزایش به معنای خروجی و مسئله بستگی دارد.
آیا SHAP به من میگوید کدام ویژگی علت نتیجه است؟
خیر. سهم SHAP درباره رفتار مدل در چارچوب توضیح انتخابی است و بهتنهایی رابطه علّی را ثابت نمیکند.
آیا میتوان از SHAP برای مدلهای زبانی استفاده کرد؟
روشهای توضیح برای برخی خروجیهای متنی و وظایف مدلهای زبانی وجود دارند، اما باید دقیقاً مشخص باشد کدام خروجی توضیح داده میشود. برای سامانههای چندمرحلهای، بررسی منابع، ابزارها و اعتبار پاسخ نیز لازم است.
آیا Permutation Importance همان SHAP است؟
خیر. Permutation Importance افت عملکرد مدل پس از جابهجایی یک ویژگی را روی مجموعه ارزیابی میسنجد. SHAP سهم ویژگیها را برای پیشبینی نمونهها توضیح میدهد.
جمعبندی
SHAP، LIME و Permutation Importance سه ابزار برای پاسخ به پرسشهای مرتبط اما متفاوت درباره رفتار مدل هستند. SHAP سهم ویژگیها را برای یک پیشبینی نسبت به مقدار مرجع نشان میدهد. LIME رفتار مدل را در نزدیکی یک نمونه با مدل سادهتر تقریب میزند. Permutation Importanceبررسی میکند بههمزدن یک ویژگی چه اثری بر عملکرد مدل در داده ارزیابی دارد.
در مثال عملی، یک Random Forest ساختیم، عملکردش را روی داده مستقل سنجیدیم، یک نمونه را با SHAP و LIME توضیح دادیم و اهمیت ویژگیها را با جابهجایی ستونها نیز بررسی کردیم.
توضیح مفید باید همراه با تعریف روشن خروجی، داده مرجع، ارزیابی عملکرد و بررسی محدودیتها ارائه شود. نمودار توضیحپذیری بهتنهایی تضمین نمیکند مدل درست، منصفانه یا قابل استفاده در یک تصمیم واقعی است.
از توضیح مدل تا ساخت محصول هوش مصنوعی
در محصولاتی مانند دستهبندی درخواستها، تحلیل پیامها و پشتیبانی هوشمند، علاوه بر انتخاب مدل باید بدانید خروجی چگونه ارزیابی، بررسی و به تصمیم عملی تبدیل میشود. توضیحپذیری میتواند به کشف وابستگیهای نامناسب مدل و بررسی مواردی که نیاز به بازبینی انسان دارند کمک کند.
برای آشنایی با خدمات و زیرساخت هوش مصنوعی درواره و بررسی راههای استفاده از مدلها در محصول خود، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- مهندسی ویژگی و انتخاب ویژگی درPython
- درخت تصمیم و Random Forest درPython
- XGBoost چیست؟ آموزش با Python
- بیشبرازش و کمبرازش در یادگیری ماشین
- کالیبراسیون احتمال و انتخاب آستانه تصمیم
- ارزیابی مدل هوش مصنوعی وEvals
- MLOps و LLMOpsچیست؟
- آموزش استفاده از API هوش مصنوعی
منابع
- مقاله اصلیSHAP: A Unified Approach to Interpreting Model Predictions papers.nips.cc
- مستندات رسمی SHAP وTreeExplainer SHAP latest documentation
- راهنمای رسمی نمودار Beeswarm درSHAP SHAP latest documentation
- مقاله اصلیLIME: “Why Should I Trust You?” doi.org
- نمونه رسمی LIME برای رگرسیون marcotcr.github.io
- مستندات Permutation Importance درscikit-learn scikit-learn 1.9.1 documentation
- مثال رسمی scikit-learn درباره ویژگیهای همبسته scikit-learn 1.9.1 documentation
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و صفحه سلب مسئولیت درواره را مطالعه کنید.



