
MLOps چیست؟ راهنمای عملیات یادگیری ماشین و تفاوت آن با LLMOps و DevOps
MLOps مجموعهای از روشها و ابزارها برای آزمایش، نسخهبندی، استقرار، پایش و بهروزرسانی مدلهای یادگیری ماشین است. در این راهنمای عملی، چرخه MLOps، تفاوت آن با DevOps و LLMOps و پیادهسازی نمونه با MLflow و API درواره را بررسی میکنیم.

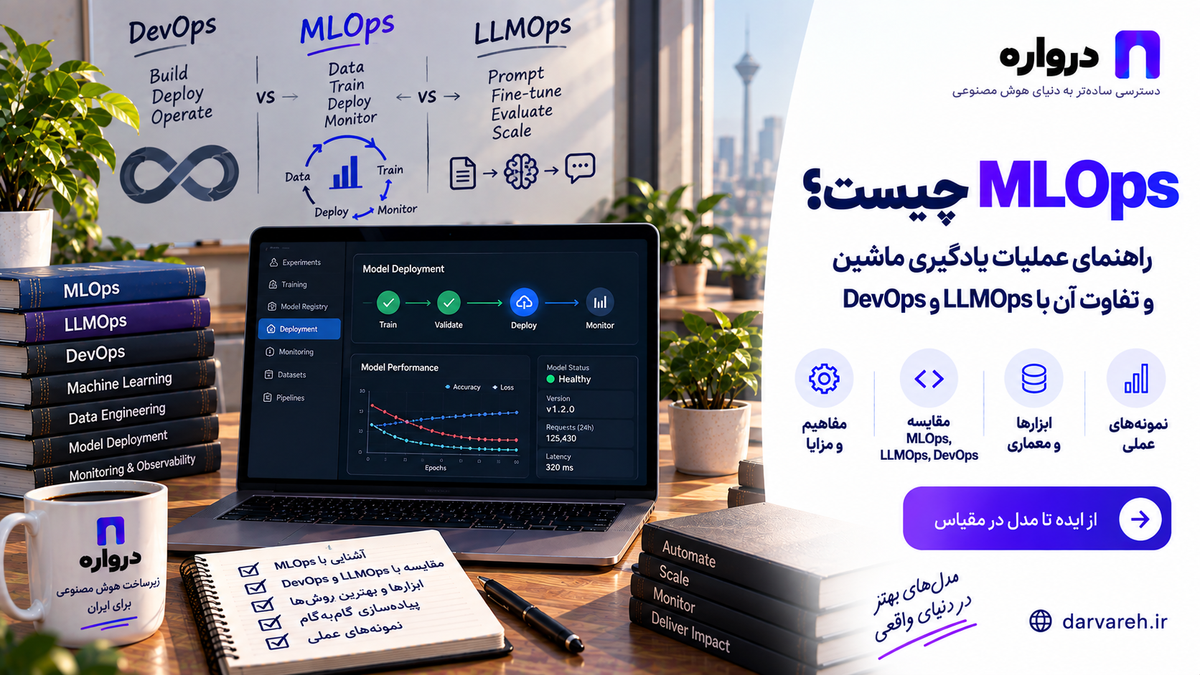
ساخت یک مدل در محیط آزمایش تنها بخش کوچکی از یک محصول یادگیری ماشین است. چالش اصلی زمانی آغاز میشود که بخواهیم مدل را وارد یک نرمافزار واقعی کنیم.
در محیط عملی باید بتوانیم به پرسشهای زیر پاسخ دهیم:
- مدل با کدام نسخه داده آموزش دیده است؟
- چه پارامترهایی برای آموزش استفاده شدهاند؟
- آیا نسخه جدید واقعاً از نسخه قبلی بهتر است؟
- کدام مدل اکنون در محیط Production فعال است؟
- اگر کیفیت مدل کاهش پیدا کرد چه اتفاقی میافتد؟
- چگونه نسخه قبلی را بازگردانی کنیم؟
- آیا دادههای واقعی با دادههای زمان آموزش متفاوت شدهاند؟
- هر پیشبینی چقدر زمان و هزینه دارد؟
- چه زمانی باید مدل دوباره آموزش داده شود؟
- چه کسی انتشار نسخه جدید را تأیید کرده است؟
MLOps برای مدیریت همین چرخه ساخته شده است.
در این مقاله ابتدا مفهوم MLOps را توضیح میدهیم، سپس تفاوت آن با DevOps، DataOps، LLMOps و GenAIOps را بررسی میکنیم. در ادامه یک پروژه عملی با Python و MLflow میسازیم و در پایان نشان میدهیم تیمهایی که از مدلهای آماده از طریق API درواره استفاده میکنند، به کدام بخشهای LLMOps نیاز دارند.
MLOps چیست؟
MLOps مخفف Machine Learning Operations و به معنای عملیات یادگیری ماشین است.
MLOps مجموعهای از فرایندها، ابزارها و استانداردهای مهندسی برای مدیریت چرخه کامل مدلهای یادگیری ماشین است؛ از آمادهسازی داده و اجرای آزمایشها تا استقرار، پایش، بازآموزی و بازنشستهکردن مدل.
به زبان ساده، MLOps تلاش میکند فاصله میان این دو محیط را کاهش دهد:
محیط آزمایش Data Scientist
             ↓
محیط واقعی و پایدار Production
MLOps اصول DevOps را وارد پروژههای یادگیری ماشین میکند، اما فقط با کد نرمافزار سروکار ندارد. داده، ویژگیها، مدل، آزمایشها و کیفیت پیشبینی نیز باید مدیریت شوند.
راهنمای رسمی Google Cloud اجزایی مانند جمعآوری و اعتبارسنجی داده، تست، مدیریت منابع، تحلیل مدل، مدیریت Metadata، زیرساخت Serving و Monitoring را از بخشهای مهم محیط MLOps معرفی میکند.
چرا MLOps به وجود آمد؟
یک پروژه یادگیری ماشین معمولاً با Notebook و آزمایشهای دستی آغاز میشود.
پژوهشگر داده ممکن است:
- یک Dataset را بارگذاری کند.
- داده را پاکسازی کند.
- چند ویژگی بسازد.
- چند الگوریتم را آزمایش کند.
- بهترین نتیجه را در Notebook مشاهده کند.
- فایل مدل را روی سیستم ذخیره کند.
این روش برای آزمایش اولیه مناسب است؛ اما برای محصول واقعی مشکلات زیادی دارد:
- مشخص نیست مدل با کدام داده ساخته شده است.
- پارامترهای آزمایش ثبت نشدهاند.
- اجرای آزمایش قابلتکرار نیست.
- مدل بهصورت دستی منتقل میشود.
- تست خودکار وجود ندارد.
- نسخه Production مشخص نیست.
- بازگشت به نسخه قبلی دشوار است.
- تغییر توزیع داده شناسایی نمیشود.
- کیفیت مدل پس از استقرار اندازهگیری نمیشود.
- مسئولیت تیم داده و تیم زیرساخت از هم جداست.
MLOps این مراحل پراکنده را به یک چرخه قابلتکرار و قابلاندازهگیری تبدیل میکند.
چرخه عمر MLOps
چرخه MLOps معمولاً از مراحل زیر تشکیل میشود:
۱. تعریف مسئله
پیش از انتخاب مدل باید مشخص شود:
- چه مسئلهای حل میشود؟
- خروجی مدل چیست؟
- معیار موفقیت چیست؟
- خطای مدل چه پیامد تجاری دارد؟
- Baseline چیست؟
- چه محدودیتهایی وجود دارد؟
برای مثال، معیار موفقیت یک مدل تشخیص تقلب فقط Accuracy نیست. ممکن است Recall تراکنشهای مشکوک یا هزینه False Negative اهمیت بیشتری داشته باشد.
۲. جمعآوری و نسخهبندی داده
داده بخشی از محصول مدل است و باید مانند کد مدیریت شود.
موارد قابلثبت عبارتاند از:
- منبع داده
- زمان استخراج
- Schema
- نسخه Dataset
- روش پاکسازی
- Featureهای تولیدشده
- کیفیت داده
- مجوز استفاده
- ارتباط Dataset با Run آموزشی
۳. اعتبارسنجی داده
پیش از آموزش باید کنترل شود:
- ستونهای الزامی وجود دارند.
- نوع دادهها صحیح است.
- مقدارهای گمشده از حد مجاز بیشتر نیستند.
- بازه عددها معتبر است.
- توزیع داده تغییر غیرعادی نکرده است.
- داده تکراری یا خراب نیست.
- برچسبها کیفیت کافی دارند.
۴. آزمایش و آموزش
در هر Experiment باید این اطلاعات ثبت شوند:
- نسخه کد
- نسخه Dataset
- پارامترها
- Featureها
- الگوریتم
- محیط اجرا
- معیارهای ارزیابی
- فایلها و نمودارها
- مدل تولیدشده
۵. ارزیابی مدل
مدل جدید باید با موارد زیر مقایسه شود:
- Baseline
- مدل فعال Production
- نسخه قبلی
- زیرگروههای مهم داده
- سناریوهای مرزی
- محدودیت سرعت و حافظه
۶. ثبت مدل
مدلی که شرایط لازم را دارد وارد Model Registry میشود.
Registry میتواند اطلاعات زیر را نگه دارد:
- نام مدل
- نسخه
- وضعیت
- Metrics
- مالک
- توضیحات
- Alias
- Tag
- فایل مدل
- Signature ورودی و خروجی
۷. استقرار
روش استقرار میتواند یکی از این موارد باشد:
- Batch Prediction
- API همزمان
- پردازش Streaming
- اجرای Edge
- اجرای داخل اپلیکیشن
- Serverless Inference
- Kubernetes Model Serving
۸. پایش
پس از استقرار باید عملکرد فنی و کیفیت مدل پایش شود:
- Latency
- Throughput
- نرخ خطا
- مصرف CPU و GPU
- هزینه
- Data Drift
- Prediction Drift
- کیفیت پیشبینی
- نرخ ورودی نامعتبر
- تغییر رفتار زیرگروهها
۹. بازآموزی و انتشار مجدد
بازآموزی میتواند بر اساس یکی از این Triggerها انجام شود:
- زمانبندی ثابت
- ورود داده جدید
- کاهش کیفیت
- تشخیص Drift
- تغییر مسئله کسبوکار
- تغییر Featureها
- تغییر الگوریتم
۱۰. بازنشستهکردن مدل
نسخههای قدیمی باید بهشکل کنترلشده از چرخه خارج شوند، اما Metadata لازم برای Audit و بازتولید نتایج حفظ شود.
تفاوت DevOps و MLOps چیست؟
DevOps روی چرخه ساخت، تست و استقرار نرمافزار تمرکز دارد. در MLOps علاوه بر کد، داده و مدل نیز تغییر میکنند.
| موضوع | DevOps | MLOps |
|---|---|---|
| دارایی اصلی | کد نرمافزار | کد، داده، Feature و مدل |
| خروجی Build | برنامه یا Container | مدل، Pipeline و سرویس پیشبینی |
| تست | Unit و Integration Test | تست کد، داده، مدل و کیفیت |
| نسخهبندی | کد و Artifact | کد، داده، مدل و Experiment |
| انتشار | نسخه نرمافزار | نسخه Pipeline و مدل |
| پایش | خطا، منابع و Latency | معیارهای فنی، Drift و کیفیت مدل |
| بهروزرسانی | تغییر کد | تغییر کد، داده یا بازآموزی |
| Rollback | نسخه برنامه | نسخه مدل، Feature و Pipeline |
MLOps جایگزین DevOps نیست. یک سیستم یادگیری ماشین همچنان به Git، تست، Container، CI/CD، Monitoring و مدیریت زیرساخت نیاز دارد.
CI، CD و CT در MLOps
CI یا Continuous Integration
در MLOps، CI فقط اجرای تستهای کد نیست. این مرحله ممکن است شامل موارد زیر باشد:
- تست Pipeline داده
- بررسی Schema
- تست Feature Engineering
- تست کد آموزش
- تست سازگاری مدل
- بررسی کیفیت حداقلی
- ساخت Container
- بررسی Reproducibility
CD یا Continuous Delivery
CD فرایند آمادهسازی و انتشار نسخه جدید Pipeline یا مدل است.
انتشار میتواند شامل این مراحل باشد:
- ثبت مدل
- ساخت Image
- استقرار در Staging
- اجرای تست آنلاین
- تأیید انتشار
- Canary Deployment
- انتقال تدریجی ترافیک
- Rollback
CT یا Continuous Training
CT به معنای آموزش یا بازآموزی خودکار مدل پس از رخدادن یک Trigger است.
Google Cloud مفهوم CT را در کنار CI/CD از تفاوتهای مهم سیستمهای MLOps معرفی میکند.
بازآموزی خودکار نباید الزاماً به انتشار خودکار منجر شود. مدل جدید ابتدا باید ارزیابی شود و فقط در صورت عبور از معیارهای پذیرش منتشر شود.
LLMOps چیست؟
LLMOps مخفف Large Language Model Operations است و به مدیریت چرخه عمر اپلیکیشنهای مبتنی بر مدلهای زبانی بزرگ اشاره دارد.
در بعضی منابع جدیدتر، اصطلاح GenAIOps نیز استفاده میشود؛ زیرا کاربردها فقط به مدل زبانی محدود نیستند و میتوانند شامل تصویر، صوت، ویدئو و Agent باشند.
Microsoft، GenAIOps را توسعه قابلیتهای MLOps برای مدیریت Prompt، RAG، ایمنی خروجی، ارزیابی و کنترل هزینه مدلهای مولد معرفی میکند.
تفاوت MLOps و LLMOps چیست؟
| موضوع | MLOps | LLMOps |
|---|---|---|
| نوع سیستم | مدلهای پیشبینی و یادگیری ماشین | اپلیکیشنهای مدل زبانی و مولد |
| تغییرات اصلی | داده، Feature، الگوریتم و وزن مدل | Prompt، مدل، Context، RAG، Tool و Workflow |
| آموزش مدل | معمولاً بخش اصلی چرخه | ممکن است از مدل آماده API استفاده شود |
| معیارها | Accuracy، Precision، Recall، RMSE | کیفیت پاسخ، ارتباط، صحت، Hallucination، هزینه |
| Artifact مهم | فایل مدل و Dataset | Prompt، Dataset ارزیابی، Retrieval Config و Trace |
| پایش | Data Drift و Model Drift | کیفیت پاسخ، Prompt Drift، Retrieval و Tool Call |
| هزینه | زیرساخت آموزش و Serving | Token، درخواست، Tool و مدل |
| استقرار | Model Server | اپلیکیشن، Gateway، RAG و Agent Runtime |
| بازگشت نسخه | نسخه مدل | مدل، Prompt، Workflow و Knowledge Base |
اجزای اصلی LLMOps
نسخهبندی Prompt
Prompt بخشی از منطق برنامه است و باید مانند کد نسخهبندی شود.
برای هر Prompt بهتر است ثبت شود:
- شناسه
- نسخه
- متن System Prompt
- متغیرها
- مدل هدف
- تاریخ انتشار
- مالک
- Dataset ارزیابی
- Metrics
- وضعیت Production
ارزیابی مدل
مدلها باید روی مجموعهای ثابت از ورودیهای واقعی مقایسه شوند.
معیارها میتوانند شامل این موارد باشند:
- صحت
- ارتباط پاسخ
- کاملبودن
- پیروی از دستور
- کیفیت فارسی
- صحت JSON
- استفاده صحیح از Tool
- Faithfulness به منابع
- Latency
- هزینه
- نرخ پاسخ ناموفق
مدیریت RAG
در اپلیکیشن RAG فقط مدل اهمیت ندارد. این اجزا نیز باید نسخهبندی و ارزیابی شوند:
- مدل Embedding
- روش Chunking
- اندازه Chunk
- Metadata
- Vector Database
- Hybrid Search
- Reranker
- تعداد نتایج
- Prompt پاسخ
- نسخه پایگاه دانش
Trace کردن Agent
در یک Agent باید مسیر کامل اجرا ثبت شود:
پیام کاربر
→ تشخیص هدف
→ انتخاب Tool
→ آرگومان Tool
→ نتیجه Tool
→ تصمیم بعدی
→ پاسخ نهایی
کنترل هزینه
LLMOps باید مصرف را در سطوح مختلف ثبت کند:
- کاربر
- سازمان
- قابلیت
- Agent
- مدل
- Prompt
- Tool
- درخواست
مسیریابی مدل
ممکن است یک مدل برای تمام وظایف مناسب نباشد.
برای مثال:
- مدل اقتصادی برای طبقهبندی
- مدل سریع برای چت
- مدل قویتر برای تحلیل
- مدل Vision برای تصویر
- مدل تخصصی برای کدنویسی
Fallback
اگر مدل اصلی در دسترس نبود، برنامه میتواند به مدل یا مسیر دیگری منتقل شود. Fallback باید از نظر ساختار پاسخ و قابلیتهای موردنیاز آزمایش شده باشد.
تفاوت MLOps، LLMOps، DataOps و AIOps
| اصطلاح | تمرکز |
|---|---|
| DevOps | توسعه، تست، انتشار و عملیات نرمافزار |
| DataOps | کیفیت، انتقال و مدیریت Pipelineهای داده |
| MLOps | چرخه عمر مدل یادگیری ماشین |
| LLMOps | چرخه اپلیکیشنهای مبتنی بر LLM |
| GenAIOps | عملیات سیستمهای هوش مصنوعی مولد |
| AIOps | استفاده از هوش مصنوعی برای عملیات فناوری اطلاعات |
AIOps با MLOps اشتباه گرفته میشود. AIOps یعنی استفاده از هوش مصنوعی برای تحلیل Log، تشخیص ناهنجاری، مدیریت Incident یا عملیات IT؛ اما MLOps درباره عملیاتیکردن خود مدلهای یادگیری ماشین است.
معماری پیشنهادی MLOps
یک معماری متداول MLOps شامل این لایهها است:
منابع داده
↓
اعتبارسنجی و نسخهبندی داده
↓
Feature Engineering
↓
Training Pipeline
↓
Experiment Tracking
↓
Evaluation
↓
Model Registry
↓
Staging
↓
Production Serving
↓
Monitoring
↓
Feedback و Retraining
در این معماری هر اجرای آموزش باید قابلردیابی باشد و مشخص باشد مدل Production از کدام نسخه کد و داده ساخته شده است.
ابزارهای پرطرفدار MLOps
Git
برای نسخهبندی کد، Pipeline و تنظیمات استفاده میشود.
DVC
برای نسخهبندی Dataset، Pipeline داده و Artifactهای حجیم کاربرد دارد.
MLflow
قابلیتهای اصلی MLflow عبارتاند از:
- Experiment Tracking
- ثبت Parameters و Metrics
- ذخیره Artifact
- بستهبندی مدل
- Model Registry
- مدیریت نسخه مدل
- Deployment
مستندات رسمی MLflow، Model Registry را یک مخزن مرکزی همراه API و رابط کاربری برای مدیریت چرخه عمر مدل معرفی میکند.
Kubeflow Pipelines
برای ساخت و اجرای Workflowهای قابلحمل و مقیاسپذیر یادگیری ماشین روی Kubernetes استفاده میشود.
Kubeflow Pipeline ساختار منطقی اجرای Componentها، ترتیب، شرطها، پارامترها و جریان داده را بهشکل Graph تعریف میکند.
Airflow و Prefect
برای Orchestration فرایندهای داده و Workflowهای زمانبندیشده استفاده میشوند.
Feast
برای مدیریت و ارائه Featureها در Training و Serving کاربرد دارد.
BentoML، KServe و Seldon
برای بستهبندی و Serving مدلها استفاده میشوند.
Prometheus و Grafana
برای ثبت Metrics، ساخت Dashboard و Alerting زیرساخت و سرویس مدل مناسباند.
Evidently
برای بررسی Data Drift، کیفیت داده و عملکرد مدل کاربرد دارد.
Langfuse و Phoenix
برای Trace، ارزیابی و مشاهدهپذیری اپلیکیشنهای مبتنی بر مدلهای زبانی و RAG استفاده میشوند.
تیم لازم نیست تمام این ابزارها را همزمان نصب کند. Stack باید متناسب با اندازه تیم، نوع مدل، حجم ترافیک و نیاز عملیاتی انتخاب شود.
پروژه عملی MLOps با MLflow
در این مثال یک مدل طبقهبندی میسازیم و موارد زیر را ثبت میکنیم:
- Parameters
- Accuracy
- مدل آموزشدیده
- Signature
- نمونه ورودی
- نسخه ثبتشده مدل
- Alias نسخه Candidate
ایجاد پروژه
mkdir mlops-mlflow-demo
cd mlops-mlflow-demo

python -m venv .venv
فعالسازی در Linux و macOS:
source .venv/bin/activate
فعالسازی در Windows:
.venv\Scripts\Activate.ps1
نصب وابستگیها:
pip install mlflow scikit-learn pandas
اجرای MLflow Tracking Server
برای آزمایش محلی:
mlflow server \
  --host 127.0.0.1 \
  --port 5000
رابط MLflow در این آدرس در دسترس خواهد بود:
http://127.0.0.1:5000
برای محیط سازمانی بهتر است Metadata در پایگاه دادهای مانند PostgreSQL و Artifactها در Object Storage نگهداری شوند.
کد آموزش و ثبت مدل
فایل train.py را ایجاد کنید:
from pathlib import Path

import mlflow
import mlflow.sklearn
from mlflow import MlflowClient
from mlflow.models import infer_signature
from sklearn.datasets import load_iris
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    classification_report,
)
from sklearn.model_selection import train_test_split


TRACKING_URI = "http://127.0.0.1:5000"
EXPERIMENT_NAME = "iris-classification"
MODEL_NAME = "iris-classifier"

mlflow.set_tracking_uri(TRACKING_URI)
mlflow.set_experiment(EXPERIMENT_NAME)

dataset = load_iris(as_frame=True)

X = dataset.data
y = dataset.target

X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.2,
        random_state=42,
        stratify=y,
    )
)

params = {
    "n_estimators": 150,
    "max_depth": 6,
    "random_state": 42,
}

with mlflow.start_run() as run:
    model = RandomForestClassifier(**params)
    model.fit(X_train, y_train)

    predictions = model.predict(X_test)
    accuracy = accuracy_score(
        y_test,
        predictions,
    )

    report = classification_report(
        y_test,
        predictions,
        output_dict=False,
    )

    report_path = Path(
        "classification_report.txt"
    )
    report_path.write_text(
        report,
        encoding="utf-8",
    )

    mlflow.log_params(params)

    mlflow.log_metric(
        "accuracy",
        accuracy,
    )

    mlflow.log_param(
        "dataset_name",
        "sklearn_iris",
    )

    mlflow.log_param(
        "dataset_rows",
        len(dataset.frame),
    )

    mlflow.log_artifact(
        report_path,
        artifact_path="reports",
    )

    signature = infer_signature(
        X_test,
        predictions,
    )

    model_info = mlflow.sklearn.log_model(
        sk_model=model,
        name="model",
        signature=signature,
        input_example=X_test.head(3),
        registered_model_name=MODEL_NAME,
    )

    print(f"Run ID: {run.info.run_id}")
    print(f"Accuracy: {accuracy:.4f}")
    print(f"Model URI: {model_info.model_uri}")

client = MlflowClient(
    tracking_uri=TRACKING_URI,
)

versions = client.search_model_versions(
    f"name='{MODEL_NAME}'"
)

latest_version = max(
    int(item.version)
    for item in versions
)

client.set_registered_model_alias(
    name=MODEL_NAME,
    alias="candidate",
    version=latest_version,
)

print(
    f"Candidate version: {latest_version}"
)
اجرای آموزش:
python train.py
اکنون در رابط MLflow میتوانید موارد زیر را مشاهده کنید:
- Run
- Parameters
- Accuracy
- گزارش طبقهبندی
- فایل مدل
- Signature
- نسخه ثبتشده
- Alias مدل
چرا Model Signature مهم است؟
Signature ساختار ورودی و خروجی مدل را ثبت میکند.
برای مثال مشخص میشود مدل انتظار دارد این ستونها را دریافت کند:
sepal length
sepal width
petal length
petal width
اگر سرویس Production دادهای با ساختار متفاوت ارسال کند، میتوان ناسازگاری را زودتر تشخیص داد.
ارتقای مدل از Candidate به Champion
مدل جدید نباید فقط به دلیل تمامشدن آموزش وارد Production شود.
نمونه ساده:
MINIMUM_ACCURACY = 0.90

if accuracy >= MINIMUM_ACCURACY:
    client.set_registered_model_alias(
        name=MODEL_NAME,
        alias="champion",
        version=latest_version,
    )

    print(
        "مدل به نسخه Champion ارتقا یافت."
    )
else:
    print(
        "مدل معیار لازم برای انتشار را ندارد."
    )
در پروژه واقعی باید مدل جدید با مدل Champion فعلی مقایسه شود، نه فقط با یک حد ثابت.
سرو مدل ثبتشده
پس از تعیین Alias میتوان مدل را بهصورت یک سرویس محلی اجرا کرد:
mlflow models serve \
  -m "models:/iris-classifier@champion" \
  -p 5001 \
  --no-conda
مستندات MLflow امکان اجرای مدل بهصورت Local Inference Server را فراهم میکند.
ساختار Endpoint و ورودی را مطابق نسخه جاری MLflow بررسی کنید.
MLOps بدون آموزش مدل اختصاصی
بسیاری از محصولات جدید مدل را از ابتدا آموزش نمیدهند و از API مدلهای آماده استفاده میکنند.
در این حالت تیم مسئول موارد زیر نیست:
- تهیه GPU برای آموزش مدل پایه
- مدیریت وزنهای مدل
- اجرای Distributed Training
- نگهداری Model Server پایه
- بهینهسازی سطح پایین Inference
اما همچنان باید این بخشها را مدیریت کند:
- انتخاب مدل
- نسخه Prompt
- Dataset ارزیابی
- RAG
- Toolها
- Structured Output
- Latency
- هزینه
- Rate Limit
- Fallback
- کیفیت فارسی
- تغییر رفتار مدل
- Trace درخواست
- Feedback کاربران
این بخش بیشتر در حوزه LLMOps یا GenAIOps قرار میگیرد.
نمونه عملی LLMOps با API درواره
در این مثال چند ورودی ثابت را به مدل ارسال میکنیم و اطلاعات زیر را ثبت میکنیم:
- موفق یا ناموفقبودن درخواست
- زمان پاسخ
- وجود عبارتهای موردانتظار
- طول پاسخ
- شناسه مدل
- نتیجه هر Test Case
ابتدا کتابخانهها را نصب کنید:
pip install openai python-dotenv
فایل .env:
DARVAREH_API_KEY=YOUR_DARVAREH_API_KEY
DARVAREH_MODEL=YOUR_MODEL_ID
فایل evaluate_llm.py:
import csv
import os
import time
from datetime import datetime, timezone
from pathlib import Path
from dotenv import load_dotenv
from openai import OpenAI
load_dotenv()
MODEL_ID = os.environ["DARVAREH_MODEL"]
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
TEST_CASES = [
{
"id": "faq-001",
"input": (
"API چیست؟ در دو جمله توضیح بده."
),
"must_include": [
"نرمافزار",
"ارتباط",
],
},
{
"id": "faq-002",
"input": (
"سه مزیت استفاده از API هوش مصنوعی "
"برای یک فروشگاه اینترنتی را فهرست کن."
),
"must_include": [
"پاسخ",
"محصول",
],
},
{
"id": "faq-003",
"input": (
"چرا نباید کلید API را در کد "
"Frontend قرار داد؟"
),
"must_include": [
"کلید",
"سرور",
],
},
]
output_path = Path("evaluation_results.csv")
rows = []
for test_case in TEST_CASES:
started_at = time.perf_counter()
try:
completion = (
client.chat.completions.create(
model=MODEL_ID,
temperature=0,
max_tokens=300,
messages=[
{
"role": "system",
"content": (
"به زبان فارسی، دقیق و "
"مختصر پاسخ بده."
),
},
{
"role": "user",
"content": test_case["input"],
},
],
)
)
content = (
completion.choices[0]
.message.content
or ""
)
latency_ms = round(
(
time.perf_counter()
- started_at
)
* 1000,
2,
)
normalized = content.lower()
missing_terms = [
term
for term in test_case[
"must_include"
]
if term.lower() not in normalized
]
passed = len(missing_terms) == 0
rows.append(
{
"test_id": test_case["id"],
"model": MODEL_ID,
"passed": passed,
"latency_ms": latency_ms,
"response_length": len(content),
"missing_terms": "|".join(
missing_terms
),
"response": content,
"error": "",
"evaluated_at": (
datetime.now(timezone.utc)
.isoformat()
),
}
)
except Exception as error:
latency_ms = round(
(
time.perf_counter()
- started_at
)
* 1000,
2,
)
rows.append(
{
"test_id": test_case["id"],
"model": MODEL_ID,
"passed": False,
"latency_ms": latency_ms,
"response_length": 0,
"missing_terms": "",
"response": "",
"error": type(error).__name__,
"evaluated_at": (
datetime.now(timezone.utc)
.isoformat()
),
}
)
with output_path.open(
"w",
newline="",
encoding="utf-8-sig",
) as file:
writer = csv.DictWriter(
file,
fieldnames=rows[0].keys(),
)
writer.writeheader()
writer.writerows(rows)
passed_count = sum(
1
for row in rows
if row["passed"]
)
success_rate = (
passed_count / len(rows)
) * 100
average_latency = sum(
row["latency_ms"]
for row in rows
) / len(rows)
print(
f"Model: {MODEL_ID}"
)
print(
f"Pass rate: {success_rate:.2f}%"
)
print(
f"Average latency: "
f"{average_latency:.2f} ms"
)
print(
f"Results: {output_path}"
)
این مثال یک ارزیابی ساده و قطعی است و برای سنجش عمیق کیفیت پاسخ کافی نیست؛ اما ساختار اولیه یک Dataset ثابت، اجرای تکرارپذیر و مقایسه مدلها را نشان میدهد.
توسعه ارزیابی LLM
برای ارزیابی دقیقتر میتوان معیارهای زیر را اضافه کرد:
- مقایسه با پاسخ مرجع
- اعتبارسنجی JSON
- بررسی Citation
- ارزیابی Faithfulness
- تشخیص ادعای بدون پشتوانه
- بررسی استفاده درست از Tool
- امتیازدهی انسانی
- LLM-as-a-Judge
- مقایسه زوجی دو مدل
- هزینه هر Test Case
- Token ورودی و خروجی
- نرخ Timeout
- ثبات پاسخ در چند اجرا
نتیجه هر ارزیابی باید همراه این اطلاعات ذخیره شود:
model_id
prompt_version
dataset_version
application_version
retrieval_version
temperature
max_tokens
timestamp
metrics
نقش درواره در LLMOps
درواره بخشی از زیرساخت دسترسی به مدل را ساده میکند:
- یک API سازگار با OpenAI
- یک کلید API
- یک کیف پول ریالی
- دسترسی به مدلهای مختلف
- امکان تغییر مدل
- گزارش مصرف
- کاهش نیاز به اتصال جداگانه به Providerها
اما استفاده از Gateway جایگزین LLMOps داخل محصول نیست.
تیم توسعه همچنان باید موارد زیر را مدیریت کند:
- معیار موفقیت
- Prompt
- ارزیابی
- داده اختصاصی
- RAG
- Toolها
- کنترل خروجی
- تجربه کاربری
- ثبت Feedback
- محدودیت هزینه
- منطق کسبوکار
آدرس پایه API درواره:
https://api.darvareh.ir/v1
معماری پیشنهادی LLMOps با API درواره
Dataset ارزیابی
       ↓
نسخه Prompt و Workflow
       ↓
اجرای چند مدل از طریق درواره
       ↓
ارزیابی کیفیت، سرعت و هزینه
       ↓
انتخاب مدل و تنظیمات
       ↓
استقرار محدود
       ↓
Tracing و Monitoring
       ↓
Feedback واقعی کاربران
       ↓
ارزیابی مجدد و بهبود
Model Drift چیست؟
Model Drift به کاهش عملکرد مدل در طول زمان اشاره دارد.
علتها میتوانند شامل موارد زیر باشند:
- تغییر رفتار کاربران
- تغییر بازار
- تغییر فرایند کسبوکار
- قدیمیشدن داده آموزش
- تغییر رابطه ورودی و خروجی
- تغییر منبع داده
Data Drift چیست؟
Data Drift زمانی رخ میدهد که توزیع دادههای واقعی با دادههای زمان آموزش متفاوت شود.
برای مثال، اگر مدل اعتبارسنجی با داده مشتریان یک گروه خاص آموزش دیده باشد و بعداً ترکیب مشتریان تغییر کند، ورودیهای جدید ممکن است از توزیع قبلی فاصله بگیرند.
Data Drift لزوماً به معنای کاهش کیفیت نیست، اما یک نشانه مهم برای بررسی مدل محسوب میشود.
Drift در اپلیکیشنهای LLM
در برنامههای مبتنی بر API مدل آماده، Drift شکل متفاوتی دارد:
- رفتار مدل Provider تغییر میکند.
- نسخه مدل تغییر میکند.
- Prompt تغییر کرده است.
- محتوای پایگاه دانش تغییر کرده است.
- Queryهای کاربران تغییر کردهاند.
- ابزار جدیدی به Agent اضافه شده است.
- Retrieval نتایج متفاوتی میدهد.
- الگوی هزینه یا Latency تغییر کرده است.
به همین دلیل، Dataset ارزیابی باید بهطور دورهای با نمونههای واقعی جدید بهروزرسانی شود.
سطوح بلوغ MLOps
سازمانها لازم نیست از روز اول پیچیدهترین زیرساخت را بسازند.
یک مسیر تدریجی میتواند چنین باشد:
سطح صفر: فرایند دستی
- آموزش داخل Notebook
- انتقال دستی مدل
- نبود Registry
- نبود Monitoring
سطح یک: آزمایشهای قابلردیابی
- ثبت Experiment
- نسخهبندی کد
- ذخیره Metrics
- ثبت Artifactها
سطح دو: Pipeline قابلتکرار
- مراحل داده و آموزش خودکار
- تست داده
- ثبت خودکار مدل
- اجرای زمانبندیشده
سطح سه: استقرار کنترلشده
- CI/CD
- محیط Staging
- Canary یا Shadow Test
- Rollback
سطح چهار: بهبود مستمر
- Drift Detection
- CT
- Feedback Loop
- ارزیابی خودکار
- کنترل هزینه و کیفیت
Microsoft نیز مدل بلوغ MLOps را روشی برای سنجش قابلیت سازمان و توسعه تدریجی، بهجای پیادهسازی تمام پیچیدگیها از ابتدا، معرفی میکند.
اشتباهات رایج در MLOps
خرید ابزار قبل از تعریف فرایند
ابزار نمیتواند مسئولیتها، معیار موفقیت و فرایند انتشار نامشخص را اصلاح کند.
ساخت زیرساخت پیچیده برای پروژه کوچک
یک تیم کوچک ممکن است با Git، MLflow، Docker و Monitoring ساده شروع کند و هنوز نیازی به Kubernetes نداشته باشد.
نسخهبندی مدل بدون نسخهبندی داده
اگر Dataset مشخص نباشد، بازتولید مدل امکانپذیر نیست.
انتشار مدل فقط بر اساس یک Metric
مدل ممکن است Accuracy مناسبی داشته باشد اما Latency، هزینه یا عملکرد ضعیفی روی زیرگروههای مهم نشان دهد.
بازآموزی خودکار بدون دروازه ارزیابی
هر مدل جدید الزاماً بهتر نیست. بازآموزی باید با ارزیابی و معیار پذیرش همراه باشد.
پایش فقط CPU و حافظه
سلامت زیرساخت به معنای صحت پیشبینی مدل نیست.
نداشتن Rollback
نسخه قبلی مدل، Prompt و تنظیمات باید قابلبازگردانی باشند.
ثبتنکردن Metadata
بدون ارتباط میان کد، داده، Run و مدل، Model Registry ارزش محدودی خواهد داشت.
اشتباهات رایج در LLMOps
تغییر مدل بدون اجرای Evals
ممکن است مدل جدید روی بعضی ورودیها بهتر و روی موارد دیگر ضعیفتر باشد.
ذخیرهنکردن نسخه Prompt
اگر Prompt ثبت نشود، تشخیص علت تغییر کیفیت دشوار است.
استفاده از ارزیابی کاملاً ذهنی
عبارت «به نظر میرسد بهتر شده» جایگزین Dataset و Metric نیست.
تمرکز فقط روی پاسخ نهایی
در Agentها باید Tool Call، Retrieval و مسیر تصمیم نیز بررسی شوند.
نادیدهگرفتن هزینه
کیفیت بیشتر ممکن است با چند برابرشدن هزینه و Latency همراه باشد.
استفاده از یک مدل برای تمام قابلیتها
وظایف مختلف میتوانند به مدلهای متفاوت نیاز داشته باشند.
ثبت اطلاعات بدون Request ID
هر درخواست باید از ورودی تا پاسخ، Tool Call و هزینه قابلردیابی باشد.
چکلیست اجرای MLOps
- مسئله و معیار موفقیت مشخص است.
- Baseline تعریف شده است.
- کد در Git نسخهبندی میشود.
- Dataset قابلشناسایی و نسخهبندی است.
- آزمایشها ثبت میشوند.
- Parameters و Metrics ذخیره میشوند.
- Model Signature تعریف شده است.
- مدلها در Registry قرار میگیرند.
- معیار ارتقای Candidate مشخص است.
- Staging از Production جداست.
- Rollback آزمایش شده است.
- Data Drift پایش میشود.
- کیفیت واقعی مدل اندازهگیری میشود.
- Trigger بازآموزی تعریف شده است.
- مسئول تأیید انتشار مشخص است.
چکلیست اجرای LLMOps
- Dataset ارزیابی واقعی دارید.
- Promptها نسخهبندی میشوند.
- شناسه مدل ثبت میشود.
- RAG و Retrieval قابلنسخهبندی هستند.
- Structured Output اعتبارسنجی میشود.
- Tool Callها Trace میشوند.
- هزینه و Token ثبت میشود.
- Latency و نرخ خطا پایش میشود.
- Fallback آزمایش شده است.
- تغییر مدل قبل از انتشار ارزیابی میشود.
- Feedback کاربران ذخیره میشود.
- Request ID در تمام مراحل وجود دارد.
- نسخه قبلی Prompt و مدل قابلبازگردانی است.
- کیفیت فارسی جداگانه ارزیابی میشود.
پرسشهای متداول
MLOps مخفف چیست؟
MLOps مخفف Machine Learning Operations و به معنای عملیات یادگیری ماشین است.
MLOps چه کاری انجام میدهد؟
MLOps چرخه آمادهسازی داده، آموزش، آزمایش، نسخهبندی، استقرار، پایش و بازآموزی مدل را قابلتکرار و کنترلپذیر میکند.
تفاوت MLOps و DevOps چیست؟
DevOps بیشتر روی کد و سرویس نرمافزاری تمرکز دارد. MLOps علاوه بر کد، داده، Feature، آزمایش و مدل را نیز مدیریت میکند.
LLMOps چیست؟
LLMOps مجموعه روشها و ابزارهای مدیریت اپلیکیشنهای مدل زبانی است و موضوعاتی مانند Prompt، RAG، Evals، Tool Calling، هزینه و Trace را پوشش میدهد.
تفاوت LLMOps و GenAIOps چیست؟
LLMOps بیشتر روی مدلهای زبانی متمرکز است. GenAIOps اصطلاح گستردهتری است که سایر مدلهای مولد مانند تصویر، صوت و ویدئو را نیز پوشش میدهد.
آیا برای استفاده از API مدل آماده به MLOps نیاز داریم؟
اگر مدل پایه را آموزش و میزبانی نمیکنید، به تمام زیرساخت MLOps نیاز ندارید؛ اما همچنان به بخشهایی از LLMOps مانند ارزیابی، نسخهبندی Prompt، پایش، کنترل هزینه و Fallback نیاز خواهید داشت.
ابزارهای معروف MLOps کداماند؟
MLflow، DVC، Kubeflow، Airflow، Prefect، Feast، BentoML، KServe، Prometheus و Grafana از ابزارهای شناختهشده این حوزه هستند.
MLflow چیست؟
MLflow پلتفرمی برای ثبت آزمایشها، ذخیره Metrics و Artifactها، بستهبندی مدل، Model Registry و Deployment است.
آیا MLOps فقط برای شرکتهای بزرگ است؟
خیر. تیم کوچک نیز میتواند با نسخهبندی کد، ثبت آزمایش، Dataset ثابت، تست خودکار و Monitoring ساده شروع کند.
چگونه مدلهای زبانی را از طریق درواره ارزیابی کنیم؟
میتوانید Dataset ثابتی از ورودیهای واقعی بسازید، مدلهای مختلف را با API درواره اجرا کنید و کیفیت، سرعت، هزینه و ثبات آنها را مقایسه کنید.
جمعبندی
MLOps پلی میان آزمایش مدل و استفاده پایدار از آن در محیط واقعی است. هدف آن فقط خودکارکردن آموزش نیست؛ بلکه باید امکان بازتولید، ارزیابی، نسخهبندی، انتشار، پایش و بهبود مستمر مدل را فراهم کند.
در این مقاله یاد گرفتیم:
- MLOps چیست و چرا به وجود آمده است.
- چرخه عمر مدل چگونه مدیریت میشود.
- تفاوت DevOps، DataOps، MLOps و LLMOps چیست.
- CI، CD و CT در یادگیری ماشین چه معنایی دارند.
- چگونه آزمایش و مدل را با MLflow ثبت کنیم.
- Model Registry و Alias چه کاربردی دارند.
- چگونه یک مدل ثبتشده را Serve کنیم.
- LLMOps چه اجزایی دارد.
- چگونه مدلهای زبانی را با API درواره ارزیابی کنیم.
- چگونه MLOps را متناسب با اندازه تیم توسعه دهیم.
اگر مدلهای پایه را خودتان آموزش نمیدهید، استفاده از API مدل آماده بخش بزرگی از پیچیدگی زیرساخت Training و Serving را حذف میکند. بااینحال، کیفیت محصول همچنان به ارزیابی، Prompt، داده، Workflow، پایش و کنترل هزینه وابسته است.
برای دریافت کلید API و مقایسه مدلهای مختلف روی Dataset واقعی خود میتوانید از مستندات API درواره شروع کنید.
مقالات مرتبط
- ارزیابی مدلهای هوش مصنوعی و Evals
- مانیتورینگ و Observability در API هوش مصنوعی
- ساخت API هوش مصنوعی آماده Production
- معماری چندمدلی و چندارائهدهنده
- کاهش هزینه API هوش مصنوعی
- محاسبه هزینه API هوش مصنوعی
- هوش مصنوعی بهعنوان سرویس چیست؟
- راهنمای API سازگار با OpenAI
منابع
- Google Cloud: MLOps Continuous Delivery and Automation Pipelines
- Microsoft: Machine Learning Operations Architecture
- Microsoft: MLOps Maturity Model
- Microsoft: GenAIOps for Organizations with MLOps
- MLflow Documentation
- MLflow Model Registry
- Kubeflow Pipelines
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



