
الگوریتم Naive Bayes چیست؟ آموزش بیز ساده با پایتون و طبقهبندی متن فارسی
Naive Bayes الگوریتمی سریع برای طبقهبندی متن، تشخیص اسپم و دستهبندی پیامها است. در این راهنما انواع بیز ساده، پیادهسازی با پایتون، پردازش متن فارسی و ترکیب آن با API درواره را میآموزید.

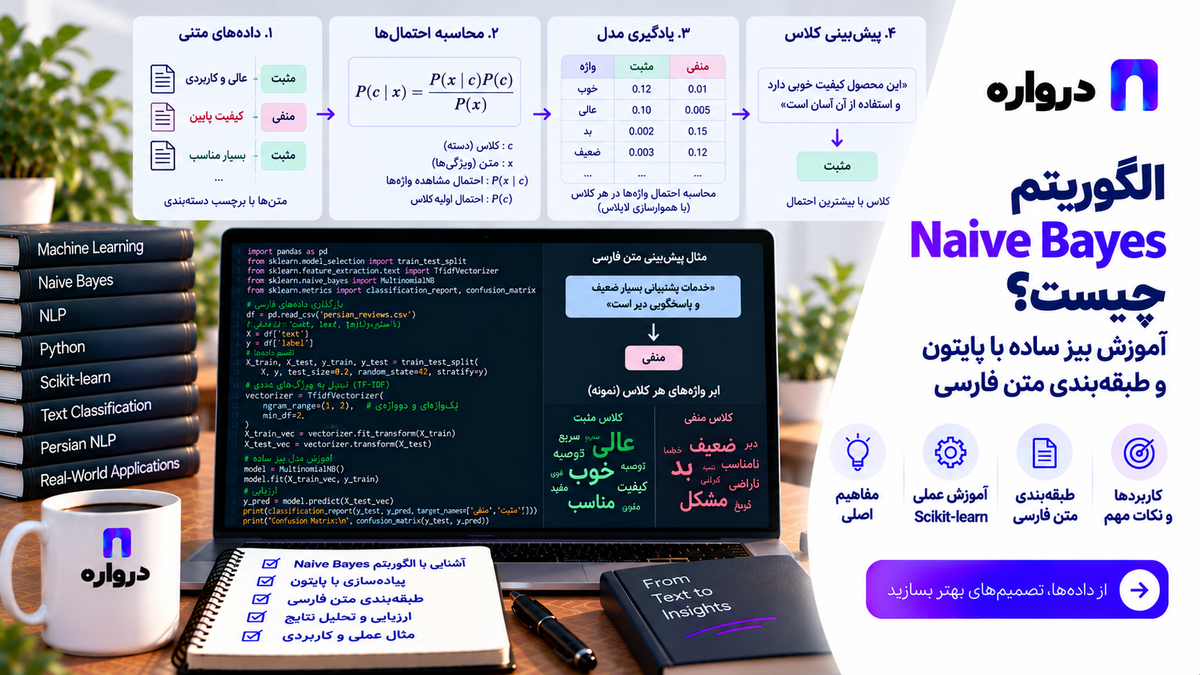
الگوریتم Naive Bayes که در فارسی با نامهایی مانند «بیز ساده»، «بیز سادهلوحانه» یا «بیز سادهانگار» شناخته میشود، یکی از الگوریتمهای سریع و کاربردی یادگیری ماشین برای طبقهبندی داده است.
این الگوریتم بهویژه در پردازش متن کاربرد دارد و میتوان از آن برای پروژههایی مانند موارد زیر استفاده کرد:
- تشخیص پیام اسپم
- دستهبندی ایمیل
- تشخیص موضوع تیکت پشتیبانی
- تحلیل اولیه دیدگاه کاربران
- دستهبندی خبر
- تشخیص زبان متن
- مسیریابی درخواست مشتری
- طبقهبندی اسناد
- شناسایی پیامهای تبلیغاتی
- ساخت مدل پایه برای مقایسه الگوریتمها
Naive Bayes از نظر محاسباتی سبک است، با داده نسبتاً کم نیز میتواند نتیجه قابل قبولی ارائه کند و آموزش آن روی مجموعههای متنی بزرگ معمولاً سریع است.
در این مقاله، الگوریتم Naive Bayes را بدون استفاده از فرمولهای ریاضی توضیح میدهیم و سپس یک سامانه طبقهبندی پیام فارسی را با پایتون، Scikit-learn و API درواره پیادهسازی میکنیم.
الگوریتم Naive Bayes چیست؟
Naive Bayes مجموعهای از الگوریتمهای یادگیری نظارتشده است که برای پیشبینی کلاس یک نمونه استفاده میشوند.
این الگوریتم ابتدا بررسی میکند هر کلاس در دادههای آموزشی چقدر رایج است. سپس بررسی میکند ویژگیهای نمونه جدید تا چه اندازه با الگوی هر کلاس هماهنگ هستند.
در پایان، کلاسی انتخاب میشود که با توجه به دادههای موجود، محتملتر به نظر میرسد.
مستندات رسمی Scikit-learn، Naive Bayes را مجموعهای از الگوریتمهای یادگیری نظارتشده معرفی میکند که بر قضیه بیز و فرض استقلال شرطی ویژگیها متکی هستند.
یک مثال ساده برای درک Naive Bayes
فرض کنید مجموعهای از پیامهای قبلی مشتریان را در سه گروه دستهبندی کردهایم:
پیامهای مربوط به پرداخت
- پول از حسابم کم شد.
- پرداخت موفق بود اما سفارش ثبت نشد.
- درگاه بانکی خطا میدهد.
- فاکتور پرداخت را دریافت نکردم.
پیامهای مربوط به ارسال
- سفارش چه زمانی ارسال میشود؟
- کد رهگیری مرسوله را میخواهم.
- بسته هنوز به دستم نرسیده است.
- وضعیت تحویل سفارش چیست؟
پیامهای مربوط به مرجوعی
- میخواهم کالا را پس بدهم.
- محصول آسیب دیده است.
- شرایط بازگشت کالا چیست؟
- درخواست تعویض محصول دارم.
اگر پیام جدید این باشد:
مبلغ از حسابم کسر شده ولی خرید در پنل نیست.
Naive Bayes به کلمات و الگوهایی مانند «مبلغ»، «حساب»، «کسر شده» و «خرید ثبت نشده» توجه میکند. چون این ویژگیها در پیامهای مربوط به پرداخت بیشتر مشاهده شدهاند، مدل احتمالاً پیام جدید را در گروه پرداخت قرار میدهد.
چرا نام آن Naive یا سادهانگار است؟
این الگوریتم فرض میکند ویژگیها با دانستن کلاس هدف، مستقل از یکدیگر هستند.
در طبقهبندی متن، ویژگیها معمولاً کلمات یا عبارتها هستند. مدل برای سادهکردن محاسبات فرض میکند حضور هر کلمه مستقل از سایر کلمات است.
این فرض در زبان طبیعی کاملاً درست نیست. برای مثال، عبارت «ثبت نشد» معنایی دارد که از ترکیب دو کلمه ایجاد شده است. بااینحال، Naive Bayes با وجود این سادهسازی در بسیاری از مسائل طبقهبندی متن عملکرد مناسبی دارد.
همین سادهسازی باعث میشود مدل:
- سریع آموزش ببیند.
- حافظه کمی مصرف کند.
- با تعداد زیادی ویژگی متنی کار کند.
- روی دادههای کوچکتر نیز قابل استفاده باشد.
- برای ساخت مدل پایه مناسب باشد.
مستندات Scikit-learn اشاره میکند که Naive Bayes با وجود فرضهای ساده، در کاربردهایی مانند طبقهبندی سند و تشخیص اسپم موفق بوده و در مقایسه با بسیاری از روشهای پیچیدهتر، آموزش و پیشبینی بسیار سریعی دارد.
قضیه بیز به زبان ساده
قضیه بیز به ما کمک میکند یک احتمال اولیه را با مشاهده شواهد جدید اصلاح کنیم.
فرض کنید در دادههای آموزشی، بیشتر پیامهایی که شامل عبارت «کد رهگیری» هستند در گروه ارسال قرار دارند. وقتی این عبارت در پیام جدید دیده شود، احتمال تعلق پیام به گروه ارسال افزایش پیدا میکند.
Naive Bayes برای هر کلاس دو نوع اطلاعات را در نظر میگیرد:
- کلاس موردنظر در دادههای آموزشی چقدر رایج است.
- ویژگیهای پیام جدید در آن کلاس چقدر مشاهده شدهاند.
سپس این اطلاعات را ترکیب میکند و مناسبترین کلاس را انتخاب میکند.
Naive Bayes یک الگوریتم طبقهبندی است
Naive Bayes معمولاً برای مسائل طبقهبندی استفاده میشود.
خروجی میتواند دودستهای باشد:
- اسپم یا غیر اسپم
- مثبت یا منفی
- مرتبط یا نامرتبط
- فوری یا عادی
خروجی میتواند چندکلاسه نیز باشد:
- فروش
- پرداخت
- پشتیبانی فنی
- مرجوعی
- ارسال
- سایر موارد
Naive Bayes برای رگرسیون و پیشبینی یک مقدار عددی طراحی نشده است. برای پیشبینی قیمت، هزینه یا فروش بهتر است روشهایی مانند رگرسیون خطی یا مدلهای رگرسیون درختی بررسی شوند.
انواع الگوریتم Naive Bayes
در Scikit-learn چند نوع Naive Bayes وجود دارد. انتخاب نوع مناسب به شکل ویژگیهای ورودی بستگی دارد.
| نوع مدل | داده مناسب | کاربرد رایج |
|---|---|---|
| GaussianNB | ویژگیهای عددی پیوسته | دادههای جدولی و اندازهگیریها |
| MultinomialNB | شمارش یا وزن کلمات | طبقهبندی متن و سند |
| ComplementNB | متن با کلاسهای نامتوازن | تیکت و اسناد نامتوازن |
| BernoulliNB | ویژگیهای صفر و یک | حضور یا نبود کلمه |
| CategoricalNB | ویژگیهای دستهای کدگذاریشده | دادههای دستهای |
Gaussian Naive Bayes چیست؟
GaussianNB برای ویژگیهای عددی پیوسته طراحی شده است. این مدل فرض میکند توزیع مقادیر هر ویژگی در هر کلاس از یک الگوی زنگولهای متداول پیروی میکند.
نمونه ویژگیها:
- سن مشتری
- مبلغ خرید
- تعداد ورود
- مدت عضویت
- میانگین زمان پاسخ
- تعداد درخواستها
کاربرد احتمالی میتواند طبقهبندی مشتری به گروههای رفتاری بر اساس ویژگیهای عددی باشد.
Scikit-learn برای دادههای عددی پیوسته، کلاس GaussianNB را ارائه میکند.
Multinomial Naive Bayes چیست؟
MultinomialNB یکی از رایجترین انواع Naive Bayes برای طبقهبندی متن است.
متن ابتدا به بردار عددی تبدیل میشود. هر ویژگی میتواند نشاندهنده تعداد تکرار یا وزن یک کلمه و عبارت باشد.
این مدل معمولاً در کنار ابزارهای زیر استفاده میشود:
- CountVectorizer
- TfidfVectorizer
مستندات رسمی Scikit-learn، MultinomialNB را یکی از مدلهای کلاسیک طبقهبندی متن معرفی میکند و توضیح میدهد که ویژگیهای شمارشی و در عمل بردارهای TF-IDF میتوانند برای آن استفاده شوند.
Complement Naive Bayes چیست؟
ComplementNB نسخهای از Naive Bayes است که برای دادههای نامتوازن، بهویژه مسائل طبقهبندی متن، طراحی شده است.
فرض کنید تعداد پیامهای گروهها به این شکل باشد:
- پشتیبانی عمومی: ۱۰ هزار پیام
- پرداخت: ۲ هزار پیام
- لغو سفارش: ۵۰۰ پیام
- همکاری تجاری: ۱۰۰ پیام
در چنین دادهای، کلاسهای کوچکتر ممکن است نادیده گرفته شوند. ComplementNB از اطلاعات کلاسهای مکمل استفاده میکند تا اثر این نامتوازنبودن را کاهش دهد.
مستندات Scikit-learn توضیح میدهد که ComplementNB برای مجموعههای نامتوازن مناسب است و در بسیاری از مسائل طبقهبندی متن میتواند از MultinomialNB بهتر عمل کند.
Bernoulli Naive Bayes چیست؟
BernoulliNB برای ویژگیهایی مناسب است که فقط دو حالت دارند:
- وجود دارد
- وجود ندارد
در طبقهبندی متن، این مدل میتواند فقط بررسی کند یک واژه در متن وجود دارد یا خیر، بدون اینکه تعداد تکرار آن را مهم بداند.
برای مثال:
- آیا کلمه «پرداخت» وجود دارد؟
- آیا عبارت «کد رهگیری» وجود دارد؟
- آیا کلمه «خراب» وجود دارد؟
BernoulliNB ممکن است برای متنهای کوتاه عملکرد مناسبی داشته باشد. Scikit-learn پیشنهاد میکند در صورت امکان، MultinomialNB و BernoulliNB روی داده واقعی با یکدیگر مقایسه شوند.
Categorical Naive Bayes چیست؟
CategoricalNB برای ویژگیهای دستهای مناسب است.
برای مثال:
- نوع دستگاه: موبایل، دسکتاپ یا تبلت
- کانال ارتباطی: وب، تلفن یا پیامرسان
- نوع مشتری: حقیقی یا حقوقی
- وضعیت حساب: فعال، محدود یا غیرفعال
پیش از استفاده، دستهها باید به مقادیر عددی متوالی تبدیل شوند. Scikit-learn برای این مدل استفاده از کدگذاری مناسب، مانند OrdinalEncoder، را ضروری میداند.
آموزش Gaussian Naive Bayes با پایتون
ابتدا کتابخانههای موردنیاز را نصب کنید:
pip install numpy pandas scikit-learn joblib openai pydantic
در مثال زیر از مجموعهداده Wine موجود در Scikit-learn استفاده میکنیم:
from sklearn.datasets import load_wine
from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix,
)
from sklearn.model_selection import (
    train_test_split,
)
from sklearn.naive_bayes import GaussianNB


data = load_wine()

X = data.data
y = data.target

X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.25,
        random_state=42,
        stratify=y,
    )
)

model = GaussianNB()

model.fit(
    X_train,
    y_train,
)

predictions = model.predict(
    X_test
)

print(
    "Accuracy:",
    accuracy_score(
        y_test,
        predictions,
    ),
)

print(
    confusion_matrix(
        y_test,
        predictions,
    )
)

print(
    classification_report(
        y_test,
        predictions,
        target_names=data.target_names,
    )
)
در این مثال:
- ویژگیها عددی هستند.
- داده به بخش آموزش و آزمایش تقسیم شده است.
- گزینه
stratifyنسبت کلاسها را حفظ میکند. - مدل با داده آموزشی یاد میگیرد.
- عملکرد روی دادهای ارزیابی میشود که مدل در آموزش ندیده است.
آمادهسازی متن فارسی برای طبقهبندی
متن فارسی معمولاً به نرمالسازی نیاز دارد. یک کلمه ممکن است با نویسههای عربی یا فارسی، فاصلههای متفاوت و نیمفاصله نوشته شود.
برای مثال، این عبارتها ممکن است از نظر ظاهری مشابه باشند اما در پردازش خام متفاوت دیده شوند:
- میروم
- می روم
- ميروم
- میروم
یک تابع ساده نرمالسازی میتواند بخشی از این تفاوتها را کاهش دهد:
import re


def normalize_persian_text(
    text: str,
) -> str:
    text = text.strip().lower()

    replacements = {
        "ي": "ی",
        "ى": "ی",
        "ك": "ک",
        "ۀ": "ه",
        "ة": "ه",
        "ؤ": "و",
    }

    for source, target in (
        replacements.items()
    ):
        text = text.replace(
            source,
            target,
        )

    text = re.sub(
        r"\s+",
        " ",
        text,
    )

    return text
این تابع پایه است. در یک پروژه واقعی ممکن است نیاز داشته باشید موارد زیر را نیز مدیریت کنید:
- اعداد فارسی و انگلیسی
- نیمفاصله
- نشانهگذاری
- لینک
- ایموجی
- شماره سفارش
- شماره تلفن
- کد رهگیری
- شکلهای مختلف جمع
- غلطهای تایپی رایج
- متن Pinglish
نباید تمام نشانهها و اعداد را بدون بررسی حذف کرد. برای مثال، عدد خطا یا کد وضعیت میتواند برای طبقهبندی پیام فنی مفید باشد.
ساخت مجموعهداده طبقهبندی پیام فارسی
برای شروع، یک فایل CSV با ساختار زیر ایجاد کنید:
text,label
"مبلغ از حسابم کم شد ولی سفارش ثبت نشد",payment
"درگاه بانکی خطا میدهد",payment
"کد رهگیری سفارش را میخواهم",shipping
"بسته هنوز به دستم نرسیده است",shipping
"میخواهم محصول را مرجوع کنم",return
"کالا آسیب دیده به دستم رسید",return
در پروژه واقعی باید برای هر دسته نمونههای متنوعتری داشته باشید:
- پیام کوتاه
- پیام بلند
- متن رسمی
- متن محاورهای
- متن دارای غلط تایپی
- ترکیب فارسی و انگلیسی
- پیام مبهم
- پیام دارای چند موضوع
- پیام خارج از دستههای تعریفشده
طبقهبندی متن فارسی با TF-IDF و MultinomialNB
کد زیر یک Pipeline کامل برای طبقهبندی متن میسازد:
import pandas as pd

from sklearn.feature_extraction.text import (
    TfidfVectorizer,
)
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
)
from sklearn.model_selection import (
    train_test_split,
)
from sklearn.naive_bayes import (
    MultinomialNB,
)
from sklearn.pipeline import Pipeline


data = pd.read_csv(
    "persian_messages.csv"
)

data["text"] = data["text"].map(
    normalize_persian_text
)

X = data["text"]
y = data["label"]

X_train, X_test, y_train, y_test = (
    train_test_split(
        X,
        y,
        test_size=0.2,
        random_state=42,
        stratify=y,
    )
)

pipeline = Pipeline(
    steps=[
        (
            "tfidf",
            TfidfVectorizer(
                ngram_range=(1, 2),
                min_df=2,
                max_df=0.95,
                sublinear_tf=True,
            ),
        ),
        (
            "model",
            MultinomialNB(
                alpha=1.0
            ),
        ),
    ]
)

pipeline.fit(
    X_train,
    y_train,
)

predictions = pipeline.predict(
    X_test
)

print(
    confusion_matrix(
        y_test,
        predictions,
    )
)

print(
    classification_report(
        y_test,
        predictions,
    )
)
در این Pipeline:
TfidfVectorizerمتن را به بردار عددی تبدیل میکند.- تککلمهها و عبارتهای دوکلمهای بررسی میشوند.
- کلمات بسیار نادر حذف میشوند.
- کلمات بسیار پرتکرار محدود میشوند.
MultinomialNBبردارها را طبقهبندی میکند.
TfidfVectorizer متن خام را به ماتریسی از ویژگیهای TF-IDF تبدیل میکند و امکاناتی مانند انتخاب n-gram، محدودکردن واژههای بسیار نادر یا پرتکرار و کنترل واژگان را ارائه میدهد.
چرا عبارتهای دوکلمهای مهماند؟
استفاده از عبارتهای دوکلمهای کمک میکند مدل بعضی ترکیبهای معنادار را بهتر تشخیص دهد.
برای مثال:
- ثبت نشد
- کد رهگیری
- کم شده
- مرجوع کردن
- خطای پرداخت
- ارسال نشده
- پاسخ نمیدهد
اگر فقط تککلمهها بررسی شوند، بخشی از معنای این عبارتها از بین میرود.
البته افزایش دامنه n-gram تعداد ویژگیها و مصرف حافظه را بالا میبرد. بهتر است چند تنظیم مختلف با Cross-Validation مقایسه شوند.
پارامتر Alpha چیست؟
پارامتر alpha برای هموارسازی استفاده میشود.
اگر یک واژه در داده آموزشی یک کلاس دیده نشده باشد، مدل نباید احتمال آن کلاس را بهطور کامل کنار بگذارد. هموارسازی کمک میکند واژههای جدید یا کمتکرار باعث تصمیمهای بیش از حد قطعی نشوند.
مقدار مناسب alpha باید با اعتبارسنجی انتخاب شود. مقدار پیشفرض همیشه بهترین انتخاب نیست.
تنظیم MultinomialNB با GridSearchCV
from sklearn.model_selection import (
    GridSearchCV,
)


pipeline = Pipeline(
    steps=[
        (
            "tfidf",
            TfidfVectorizer(),
        ),
        (
            "model",
            MultinomialNB(),
        ),
    ]
)

parameter_grid = {
    "tfidf__ngram_range": [
        (1, 1),
        (1, 2),
        (1, 3),
    ],
    "tfidf__min_df": [
        1,
        2,
        3,
    ],
    "tfidf__sublinear_tf": [
        True,
        False,
    ],
    "model__alpha": [
        0.1,
        0.5,
        1.0,
        2.0,
    ],
}

search = GridSearchCV(
    estimator=pipeline,
    param_grid=parameter_grid,
    scoring="f1_macro",
    cv=5,
    n_jobs=-1,
)

search.fit(
    X_train,
    y_train,
)

print(
    "Best parameters:",
    search.best_params_,
)

print(
    "Best validation score:",
    search.best_score_,
)

best_model = (
    search.best_estimator_
)
برای داده نامتوازن، استفاده از f1_macro معمولاً تصویر بهتری از عملکرد همه کلاسها نسبت به Accuracy ارائه میکند.
استفاده از ComplementNB برای داده نامتوازن
اگر تعداد نمونههای کلاسها بسیار متفاوت است، ComplementNB را نیز آزمایش کنید:
from sklearn.naive_bayes import (
    ComplementNB,
)


complement_pipeline = Pipeline(
    steps=[
        (
            "tfidf",
            TfidfVectorizer(
                ngram_range=(1, 2),
                min_df=2,
            ),
        ),
        (
            "model",
            ComplementNB(
                alpha=1.0
            ),
        ),
    ]
)

complement_pipeline.fit(
    X_train,
    y_train,
)

predictions = (
    complement_pipeline.predict(
        X_test
    )
)

print(
    classification_report(
        y_test,
        predictions,
    )
)
ComplementNB را نباید بدون ارزیابی جایگزین MultinomialNB کرد. هر دو مدل را روی تقسیمهای یکسان داده مقایسه کنید.
استفاده از BernoulliNB برای پیامهای کوتاه
برای پیامهای بسیار کوتاه، حضور یا نبود کلمات ممکن است از تعداد تکرار آنها مهمتر باشد:
from sklearn.naive_bayes import (
    BernoulliNB,
)


bernoulli_pipeline = Pipeline(
    steps=[
        (
            "tfidf",
            TfidfVectorizer(
                binary=True,
                use_idf=False,
                norm=None,
                ngram_range=(1, 2),
            ),
        ),
        (
            "model",
            BernoulliNB(
                alpha=1.0
            ),
        ),
    ]
)

bernoulli_pipeline.fit(
    X_train,
    y_train,
)
عملکرد این مدل را با MultinomialNB و ComplementNB مقایسه کنید. انتخاب مدل باید بر اساس نتیجه واقعی باشد، نه صرفاً توصیه عمومی.
ارزیابی مدل Naive Bayes
Accuracy بهتنهایی برای ارزیابی کافی نیست؛ بهویژه وقتی کلاسها نامتوازن هستند.
Precision
نشان میدهد از میان پیامهایی که مدل در یک دسته قرار داده، چه نسبتی واقعاً متعلق به همان دسته بودهاند.
Recall
نشان میدهد مدل چه تعداد از پیامهای واقعی یک دسته را پیدا کرده است.
F1-score
تعادلی میان Precision و Recall ایجاد میکند.
Macro F1
برای هر کلاس بهصورت برابر اهمیت قائل میشود. بنابراین عملکرد ضعیف روی کلاسهای کوچکتر را بهتر آشکار میکند.
Confusion Matrix
مشخص میکند هر دسته بیشتر با کدام دسته اشتباه گرفته شده است.
برای مثال، ممکن است پیامهای «پرداخت» و «ثبت سفارش» مرتب با یکدیگر اشتباه شوند. این نتیجه میتواند نشان دهد دستهها تعریف شفافی ندارند یا داده بیشتری لازم است.
احتمال خروجی Naive Bayes چقدر قابلاعتماد است؟
مدلهای Naive Bayes میتوانند با predict_proba برای هر کلاس عددی شبیه احتمال ارائه کنند:
message = [
    "پول از حسابم کم شده اما سفارش ثبت نشده"
]

probabilities = (
    best_model.predict_proba(
        message
    )[0]
)

classes = (
    best_model.classes_
)

for label, probability in zip(
    classes,
    probabilities,
):
    print(
        label,
        round(
            float(probability),
            3,
        ),
    )
اما این اعداد نباید بدون ارزیابی بهعنوان اطمینان واقعی مدل تفسیر شوند.
مستندات Scikit-learn هشدار میدهد که Naive Bayes میتواند طبقهبند مناسبی باشد، اما برآورد احتمال آن لزوماً دقیق و کالیبره نیست.
اگر تصمیم کسبوکار به احتمال دقیق وابسته است، باید کالیبراسیون احتمال را بررسی کنید. Scikit-learn برای این کار ابزارهایی مانند CalibratedClassifierCV و نمودارهای کالیبراسیون ارائه میدهد.
تعریف حالت Unknown
Naive Bayes همیشه یکی از کلاسهای موجود را انتخاب میکند، حتی اگر پیام به هیچکدام مربوط نباشد.
فرض کنید مدل فقط این دستهها را میشناسد:
- پرداخت
- ارسال
- مرجوعی
- پشتیبانی فنی
اگر مشتری درباره همکاری تجاری سؤال کند، مدل باز هم یکی از همین چهار کلاس را برمیگرداند.
برای محیط واقعی باید یک سیاست پذیرش تعریف شود:
- اگر امتیاز مدل پایین بود، خروجی
unknownشود. - اگر اختلاف دو کلاس برتر کم بود، پیام برای بررسی بیشتر ارسال شود.
- اگر پیام دارای چند موضوع بود، از مدل چندبرچسبی یا مدل زبانی استفاده شود.
- اگر کلاس ناشناخته پرتکرار شد، دسته جدیدی به داده آموزشی اضافه شود.
به دلیل کالیبرهنبودن احتمالات Naive Bayes، آستانه نباید فقط با حدس انتخاب شود. باید آن را روی مجموعه اعتبارسنجی شامل پیامهای مرتبط و نامرتبط تنظیم کرد.
مشاهده کلمات اثرگذار هر کلاس
در MultinomialNB میتوان بررسی کرد کدام ویژگیهای متنی با هر کلاس بیشتر مرتبط هستند:
import numpy as np


vectorizer = (
    best_model.named_steps[
        "tfidf"
    ]
)

classifier = (
    best_model.named_steps[
        "model"
    ]
)

feature_names = (
    vectorizer
    .get_feature_names_out()
)

for class_index, class_name in (
    enumerate(
        classifier.classes_
    )
):
    top_indices = np.argsort(
        classifier
        .feature_log_prob_[
            class_index
        ]
    )[-15:][::-1]

    top_features = (
        feature_names[
            top_indices
        ]
    )

    print(
        class_name,
        top_features.tolist(),
    )
این خروجی برای یافتن مشکلات داده مفید است.
برای مثال، اگر نام یک کارشناس یا تاریخ خاص بهعنوان ویژگی اصلی یک کلاس ظاهر شود، احتمال دارد مدل به جای مفهوم پیام، اطلاعات تصادفی داده آموزشی را یاد گرفته باشد.
مقایسه Naive Bayes با رگرسیون لجستیک و SVM
| الگوریتم | مزیت اصلی | محدودیت اصلی | کاربرد مناسب |
|---|---|---|---|
| Naive Bayes | سرعت بالا و نیاز کمتر به داده | فرض ساده درباره ویژگیها | طبقهبندی متن و مدل پایه |
| رگرسیون لجستیک | عملکرد پایدار و تفسیرپذیر | نیاز به تنظیم منظمسازی | متن و داده جدولی |
| Linear SVM | کیفیت مناسب روی متن پُربعد | احتمال مستقیم ارائه نمیکند | طبقهبندی سند و تیکت |
| KNN | تصمیم بر اساس نمونههای مشابه | پیشبینی کند در داده بزرگ | داده کوچک و جستوجوی شباهت |
| مدل زبانی | درک بهتر متن پیچیده و مبهم | هزینه و زمان پاسخ بیشتر | پیامهای دشوار و چندموضوعی |
بهتر است Naive Bayes را بهعنوان یکی از مدلهای پایه اجرا و با رگرسیون لجستیک و Linear SVM مقایسه کنید.
در بسیاری از پروژههای متن، کیفیت داده و تعریف دستهها بیشتر از پیچیدهبودن الگوریتم اهمیت دارد.
معماری ترکیبی Naive Bayes و مدل زبانی
برای همه پیامها به یک مدل زبانی بزرگ نیاز ندارید. میتوان از معماری ترکیبی استفاده کرد:
۱. پیام دریافت و نرمالسازی شود.
۲. Naive Bayes دسته اولیه را پیشبینی کند.
۳. اگر نتیجه واضح و مطابق قواعد بود، پیام مستقیماً مسیریابی شود.
۴. اگر پیام مبهم، چندموضوعی یا ناشناخته بود، به مدل زبانی ارسال شود.
۵. مدل زبانی از طریق API درواره تحلیل دقیقتری انجام دهد.
۶. خروجی مدل زبانی با ساختار JSON اعتبارسنجی شود.
۷. نتیجه نهایی در سامانه ثبت شود.
این معماری میتواند:
- زمان پاسخ را کاهش دهد.
- هزینه استفاده از مدل زبانی را کنترل کند.
- درخواستهای ساده را محلی پردازش کند.
- پیامهای پیچیده را به مدل قویتر بسپارد.
- امکان مقایسه خروجی دو مدل را فراهم کند.
استفاده از API درواره برای پیامهای مبهم
ابتدا متغیرهای محیطی را تنظیم کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
سپس کلاینت را ایجاد کنید:
import os
from typing import Literal

from openai import OpenAI
from pydantic import BaseModel


client = OpenAI(
    api_key=os.environ[
        "DARVAREH_API_KEY"
    ],
    base_url=(
        "https://api.darvareh.ir/v1"
    ),
)

MODEL_ID = os.environ[
    "DARVAREH_MODEL"
]


class MessageAnalysis(BaseModel):
    category: Literal[
        "payment",
        "shipping",
        "return",
        "technical",
        "sales",
        "other",
    ]
    summary: str
    needs_human_review: bool
    reason: str
تابع تحلیل پیام:
def analyze_with_llm(
message: str,
) -> MessageAnalysis:
prompt = f"""
پیام مشتری را تحلیل کن.
دستههای مجاز:
- payment
- shipping
- return
- technical
- sales
- other
قواعد:
- فقط JSON معتبر برگردان.
- summary حداکثر دو جمله باشد.
- اگر پیام مبهم، چندموضوعی یا خارج از دستهها است،
needs_human_review را true قرار بده.
- هیچ Markdown یا توضیحی خارج از JSON ننویس.
ساختار خروجی:
{{
"category": "payment | shipping | return | technical | sales | other",
"summary": "خلاصه فارسی",
"needs_human_review": false,
"reason": "دلیل کوتاه"
}}
پیام:
{message}
"""
response = (
client.chat.completions.create(
model=MODEL_ID,
temperature=0,
messages=[
{
"role": "system",
"content": (
"شما پیامهای "
"فارسی مشتریان را "
"طبقهبندی میکنید."
),
},
{
"role": "user",
"content": prompt,
},
],
)
)
content = (
response
.choices[0]
.message
.content
)
if not content:
raise ValueError(
"پاسخی از مدل دریافت نشد."
)
return (
MessageAnalysis
.model_validate_json(
content
)
)
ساخت مسیریاب ترکیبی
در این مثال، ابتدا Naive Bayes اجرا میشود. اگر خروجی مدل به اندازه کافی قابل پذیرش نباشد، درخواست به مدل زبانی ارسال میشود.
def route_message(
    message: str,
    threshold: float = 0.75,
) -> dict:
    normalized = (
        normalize_persian_text(
            message
        )
    )

    probabilities = (
        best_model.predict_proba(
            [normalized]
        )[0]
    )

    classes = (
        best_model.classes_
    )

    best_index = int(
        probabilities.argmax()
    )

    local_category = (
        classes[best_index]
    )

    local_score = float(
        probabilities[best_index]
    )

    if local_score >= threshold:
        return {
            "source": "naive_bayes",
            "category": (
                local_category
            ),
            "score": round(
                local_score,
                4,
            ),
            "needs_human_review": (
                False
            ),
        }

    llm_result = (
        analyze_with_llm(
            message
        )
    )

    return {
        "source": "darvareh_llm",
        **llm_result.model_dump(),
    }
این کد یک نمونه آموزشی است. در محیط واقعی، آستانه باید با داده اعتبارسنجی تنظیم شود و احتمال خام Naive Bayes نباید مستقیماً معادل اطمینان واقعی در نظر گرفته شود.
استفاده از مدل زبانی برای برچسبگذاری اولیه داده
یکی از دشوارترین مراحل پروژه، ساخت مجموعهداده برچسبخورده است. مدل زبانی میتواند برای پیشنهاد برچسب اولیه استفاده شود، اما خروجی آن باید توسط انسان بررسی شود.
یک فرایند مناسب:
۱. پیامهای واقعی و مجاز جمعآوری شوند.
۲. اطلاعات غیرضروری حذف یا ناشناسسازی شوند.
۳. تعریف دقیق هر دسته نوشته شود.
۴. مدل زبانی برچسب اولیه پیشنهاد دهد.
۵. کارشناس انسانی برچسب را تأیید یا اصلاح کند.
۶. اختلافهای پرتکرار برای اصلاح تعریف دستهها بررسی شوند.
۷. داده تأییدشده برای آموزش Naive Bayes استفاده شود.
این روش سرعت آمادهسازی داده را افزایش میدهد، اما نباید مدل زبانی را مرجع قطعی برچسبگذاری در نظر گرفت.
آموزش افزایشی با Partial Fit
در مجموعهدادههای بسیار بزرگ، ممکن است همه دادهها بهطور همزمان در حافظه قرار نگیرند.
برخی مدلهای Naive Bayes از partial_fit پشتیبانی میکنند. این قابلیت اجازه میدهد مدل با بخشهای مختلف داده بهصورت تدریجی آموزش ببیند.
Scikit-learn برای MultinomialNB، BernoulliNB و GaussianNB قابلیت آموزش افزایشی ارائه میکند. در اولین اجرای partial_fit باید تمام کلاسهای مورد انتظار مشخص شوند.
نمونه ساده:
import numpy as np

from sklearn.naive_bayes import (
    MultinomialNB,
)


classes = np.array(
    [
        "payment",
        "shipping",
        "return",
        "technical",
    ]
)

model = MultinomialNB()

for X_batch, y_batch in (
    training_batches
):
    model.partial_fit(
        X_batch,
        y_batch,
        classes=classes,
    )
در طبقهبندی متن باید واژگان و تبدیل بردار نیز بهشکلی سازگار مدیریت شوند. برای آموزش جریانی، HashingVectorizer میتواند گزینه قابل بررسی باشد؛ زیرا به مرحله یادگیری واژگان نیاز ندارد.
ذخیره Pipeline آموزشدیده
import joblib


joblib.dump(
    best_model,
    "persian_message_classifier.joblib",
)
بارگذاری مدل:
import joblib


model = joblib.load(
    "persian_message_classifier.joblib"
)

prediction = model.predict(
    [
        "سفارشم هنوز ارسال نشده"
    ]
)

print(prediction[0])
فقط فایلهای مدل مورداعتماد را بارگذاری کنید. همراه فایل مدل، اطلاعات زیر را نیز ثبت کنید:
- نسخه داده آموزشی
- تاریخ آموزش
- نام و نسخه الگوریتم
- تنظیمات TF-IDF
- فهرست کلاسها
- معیارهای ارزیابی
- نسخه کتابخانهها
- تابع نرمالسازی متن
- آستانههای مسیریابی
ساخت API طبقهبندی با FastAPI
import joblib

from fastapi import FastAPI
from pydantic import BaseModel


app = FastAPI()

classifier = joblib.load(
    "persian_message_classifier.joblib"
)


class ClassificationRequest(
    BaseModel
):
    text: str


class ClassificationResponse(
    BaseModel
):
    category: str
    score: float


@app.post(
    "/classify",
    response_model=(
        ClassificationResponse
    ),
)
def classify(
    request: ClassificationRequest,
) -> ClassificationResponse:
    normalized = (
        normalize_persian_text(
            request.text
        )
    )

    probabilities = (
        classifier.predict_proba(
            [normalized]
        )[0]
    )

    best_index = int(
        probabilities.argmax()
    )

    category = (
        classifier.classes_[
            best_index
        ]
    )

    score = float(
        probabilities[
            best_index
        ]
    )

    return (
        ClassificationResponse(
            category=category,
            score=round(
                score,
                4,
            ),
        )
    )
در نسخه عملی باید موارد زیر نیز اضافه شوند:
- احراز هویت
- محدودیت نرخ
- ثبت زمان پاسخ
- کنترل طول پیام
- مدیریت پیام خالی
- مدیریت دسته ناشناخته
- ثبت نسخه مدل
- ثبت بازخورد اپراتور
- پایش افت کیفیت
نقاط قوت Naive Bayes
سرعت بالا
آموزش و پیشبینی در این الگوریتم معمولاً سریع است.
مناسب برای متن
Naive Bayes با ویژگیهای پراکنده و تعداد زیاد واژهها سازگاری خوبی دارد.
نیاز کمتر به داده
در بسیاری از مسائل، با داده کمتر از مدلهای پیچیدهتر نیز میتواند یک خط پایه قابل قبول ایجاد کند.
پیادهسازی ساده
ساخت Pipeline متن با Scikit-learn پیچیدگی زیادی ندارد.
مصرف محدود منابع
این الگوریتم برای سرورها و محیطهای دارای منابع محدود مناسب است.
پشتیبانی از آموزش افزایشی
برخی نسخهها میتوانند داده را بهصورت مرحلهای دریافت کنند.
مناسب برای مدل پایه
مقایسه مدلهای پیچیدهتر با Naive Bayes کمک میکند ارزش واقعی پیچیدگی اضافه را اندازهگیری کنید.
محدودیتهای Naive Bayes
فرض استقلال ویژگیها
کلمات و ویژگیها در داده واقعی مستقل نیستند.
درک محدود معنا
مدل TF-IDF تفاوت معنایی عمیق جملهها را بهاندازه مدلهای زبانی یا Embedding درک نمیکند.
ضعف در پیامهای مبهم
پیام کوتاه یا چندموضوعی ممکن است بهدرستی طبقهبندی نشود.
احتمالهای غیرقابلاعتماد
خروجی predict_proba الزاماً اطمینان واقعی مدل را نشان نمیدهد.
حساسیت به کیفیت برچسبها
برچسبهای اشتباه یا تعریف مبهم دستهها مستقیماً کیفیت مدل را کاهش میدهند.
ضعف در کلاسهای جدید
مدل نمیتواند کلاسی را که در آموزش وجود نداشته است، بهصورت خودکار کشف کند.
تأثیر نامتوازنبودن داده
کلاسهای پرتکرار ممکن است بر تصمیم مدل مسلط شوند؛ هرچند ComplementNB میتواند در بعضی مجموعهها کمک کند.
اشتباهات رایج در استفاده از Naive Bayes
استفاده از Accuracy بهتنهایی
در داده نامتوازن ممکن است Accuracy بالا باشد، اما مدل کلاسهای کمتعداد را تشخیص ندهد.
پردازش متن قبل از تقسیم داده
TfidfVectorizer باید فقط با داده آموزشی یاد بگیرد. استفاده از Pipeline از نشت اطلاعات جلوگیری میکند.
حذف بیرویه نشانهها و اعداد
بعضی اعداد، کدهای خطا و نشانهها اطلاعات مهمی برای طبقهبندی دارند.
اعتماد کامل به احتمال خروجی
احتمال Naive Bayes ممکن است بیش از حد مطمئن به نظر برسد.
نبود دسته Unknown
مدل نباید مجبور باشد هر ورودی را در یکی از کلاسهای موجود قرار دهد.
تعریف دستههای همپوشان
اگر مرز میان «مشکل پرداخت» و «ثبت سفارش» مشخص نباشد، مدل و حتی برچسبگذاران انسانی دچار اختلاف میشوند.
حذف پیامهای دشوار از ارزیابی
مجموعه آزمایشی باید شامل پیامهای محاورهای، مبهم، کوتاه، ترکیبی و دارای غلط تایپی باشد.
تغییر نرمالسازی بعد از آموزش
همان تابع پردازش متن باید در آموزش و Production استفاده شود.
مقایسه نکردن با مدلهای دیگر
Naive Bayes سریع است، اما ممکن است رگرسیون لجستیک یا Linear SVM روی همان داده عملکرد بهتری داشته باشند.
چه زمانی از Naive Bayes استفاده کنیم؟
Naive Bayes میتواند انتخاب مناسبی باشد اگر:
- مسئله شما طبقهبندی متن است.
- به یک مدل سریع و سبک نیاز دارید.
- داده آموزشی محدود است.
- تعداد ویژگیهای متنی زیاد است.
- میخواهید یک مدل پایه بسازید.
- هزینه زیرساخت باید پایین باشد.
- نیاز به آموزش افزایشی دارید.
- زمان پاسخ اهمیت زیادی دارد.
چه زمانی مدل دیگری مناسبتر است؟
روش دیگری را بررسی کنید اگر:
- معنا و زمینه متن اهمیت زیادی دارد.
- پیامها طولانی و چندموضوعی هستند.
- دستهها شباهت معنایی زیادی دارند.
- متنها با واژگان متفاوت، مفهوم مشابهی بیان میکنند.
- احتمال کالیبره برای تصمیمگیری ضروری است.
- داده آموزشی کافی برای مدل قویتر دارید.
- نیاز به تحلیل استدلالی یا استخراج چندمرحلهای دارید.
در این شرایط میتوان رگرسیون لجستیک، SVM، Embedding، مدلهای Transformer یا مدلهای زبانی در دسترس از طریق API درواره را بررسی کرد.
معماری پیشنهادی برای محیط Production
یک سامانه عملی طبقهبندی پیام میتواند این مراحل را داشته باشد:
۱. پیام کاربر در سرور دریافت شود.
۲. متن فارسی نرمالسازی شود.
۳. اطلاعات ساختاریافته مانند شناسه سفارش جداگانه استخراج شوند.
۴. Naive Bayes طبقه اولیه را پیشبینی کند.
۵. سیاست پذیرش نتیجه بررسی شود.
۶. پیامهای مبهم به مدل زبانی درواره ارسال شوند.
۷. اطلاعات قطعی از CRM، فروشگاه یا پایگاه داده دریافت شوند.
۸. پاسخ پیشنهادی تولید و اعتبارسنجی شود.
۹. نتیجه و نسخه مدل ثبت شوند.
۱۰. اصلاح اپراتور بهعنوان بازخورد ذخیره شود.
۱۱. کیفیت مدل به تفکیک هر کلاس پایش شود.
۱۲. مدل جدید ابتدا در حالت آزمایشی با نسخه فعلی مقایسه شود.
اتصال به API درواره
درواره دسترسی یکپارچه به مدلهای مختلف هوش مصنوعی را از طریق API سازگار با OpenAI فراهم میکند.
آدرس پایه API:
https://api.darvareh.ir/v1
در معماری ترکیبی، Naive Bayes میتواند پیامهای ساده و پرتکرار را محلی طبقهبندی کند و مدلهای زبانی درواره فقط برای پیامهای دشوار، مبهم یا چندموضوعی فراخوانی شوند.
این روش میتواند تعادل مناسبی میان کیفیت، سرعت و هزینه ایجاد کند.
برای شروع، مستندات API درواره را مطالعه کنید.
پرسشهای متداول
الگوریتم Naive Bayes چیست؟
Naive Bayes یک الگوریتم یادگیری نظارتشده برای طبقهبندی است که با توجه به فراوانی کلاسها و ویژگیهای مشاهدهشده، محتملترین کلاس را انتخاب میکند.
چرا به آن بیز سادهلوحانه میگویند؟
زیرا فرض میکند ویژگیها با دانستن کلاس هدف، مستقل از یکدیگر هستند. این فرض در داده واقعی کاملاً برقرار نیست، اما محاسبات را ساده میکند.
Naive Bayes برای چه کاربردهایی مناسب است؟
برای طبقهبندی متن، تشخیص اسپم، دستهبندی خبر، مسیریابی تیکت، تشخیص موضوع و ساخت مدل پایه مناسب است.
بهترین نوع Naive Bayes برای متن چیست؟
MultinomialNB گزینه رایجی است. برای داده نامتوازن ComplementNB و برای ویژگیهای حضور یا نبود واژه BernoulliNB نیز باید بررسی شوند.
آیا Naive Bayes برای متن فارسی مناسب است؟
بله، بهشرط آنکه نرمالسازی فارسی، مجموعهداده مناسب، تعریف روشن دستهها و ارزیابی دقیق انجام شود.
آیا Naive Bayes به Embedding نیاز دارد؟
خیر. معمولاً با CountVectorizer یا TF-IDF استفاده میشود. برای Embeddingهای متراکم، الگوریتمهای دیگری مانند رگرسیون لجستیک، SVM یا KNN ممکن است انتخاب مناسبتری باشند.
آیا احتمال خروجی Naive Bayes قابلاعتماد است؟
نه همیشه. مدل ممکن است احتمالهای بیش از حد مطمئن تولید کند. برای کاربردهای حساس باید کالیبراسیون و ارزیابی جداگانه انجام شود.
پارامتر Alpha چه کاری انجام میدهد؟
Alpha برای هموارسازی استفاده میشود تا واژههای دیدهنشده یا کمتکرار باعث حذف کامل احتمال یک کلاس نشوند.
آیا Naive Bayes از یادگیری آنلاین پشتیبانی میکند؟
برخی نسخههای آن از partial_fit پشتیبانی میکنند و میتوانند داده را بهصورت مرحلهای دریافت کنند.
آیا میتوان Naive Bayes را با API درواره ترکیب کرد؟
بله. Naive Bayes میتواند طبقهبندی سریع اولیه را انجام دهد و پیامهای دشوار برای تحلیل دقیقتر به مدل زبانی از طریق API درواره ارسال شوند.
جمعبندی
Naive Bayes یکی از سریعترین و سادهترین الگوریتمهای طبقهبندی در یادگیری ماشین است. این الگوریتم بهویژه برای متن، اسناد، پیامها و دادههای دارای ویژگیهای فراوان کاربرد دارد.
برای استفاده درست از Naive Bayes:
۱. نوع مدل را با توجه به ساختار داده انتخاب کنید.
۲. برای متن، MultinomialNB، ComplementNB و BernoulliNB را مقایسه کنید.
۳. پردازش متن و مدل را داخل Pipeline قرار دهید.
۴. متن فارسی را بهشکل ثابت نرمالسازی کنید.
۵. بهجای Accuracy، معیارهای هر کلاس و Macro F1 را نیز بررسی کنید.
۶. برای داده نامتوازن ComplementNB را آزمایش کنید.
۷. آستانه پذیرش و دسته unknown تعریف کنید.
۸. احتمال خام مدل را معادل اطمینان واقعی در نظر نگیرید.
۹. مدل را با رگرسیون لجستیک و Linear SVM مقایسه کنید.
۱۰. برای پیامهای مبهم از مدل زبانی بهعنوان مسیر تکمیلی استفاده کنید.
ترکیب Naive Bayes با API درواره میتواند یک معماری سریع و اقتصادی برای دستهبندی پیامهای فارسی ایجاد کند: درخواستهای ساده با مدل محلی پردازش میشوند و درخواستهای پیچیده به مدل زبانی مناسب ارجاع داده میشوند.
مقالات مرتبط
- یادگیری ماشین چیست؟
- یادگیری نظارتشده چیست؟
- پردازش زبان طبیعی چیست؟
- رگرسیون لجستیک چیست؟
- الگوریتم SVM چیست؟
- الگوریتم KNN چیست؟
- Embedding چیست؟
- آموزش طبقهبندی تیکت با هوش مصنوعی
- آموزش اتصال API هوش مصنوعی به نرمافزار
منابع
- راهنمای Naive Bayes در Scikit-learn
- مستندات MultinomialNB
- مستندات ComplementNB
- مستندات BernoulliNB
- مستندات TfidfVectorizer
- راهنمای کالیبراسیون احتمال
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



