
نرمالسازی و استانداردسازی داده چیست؟ آموزش Feature Scaling باPython
StandardScaler، MinMaxScaler و RobustScaler چه تفاوتی دارند و چه زمانی باید از هرکدام استفاده کرد؟ در این آموزش، اثر مقیاس ویژگیها بر KNN و سایر مدلها را میبینید و روش صحیح پیادهسازی بدون نشت داده را با Pythonیاد میگیرید.

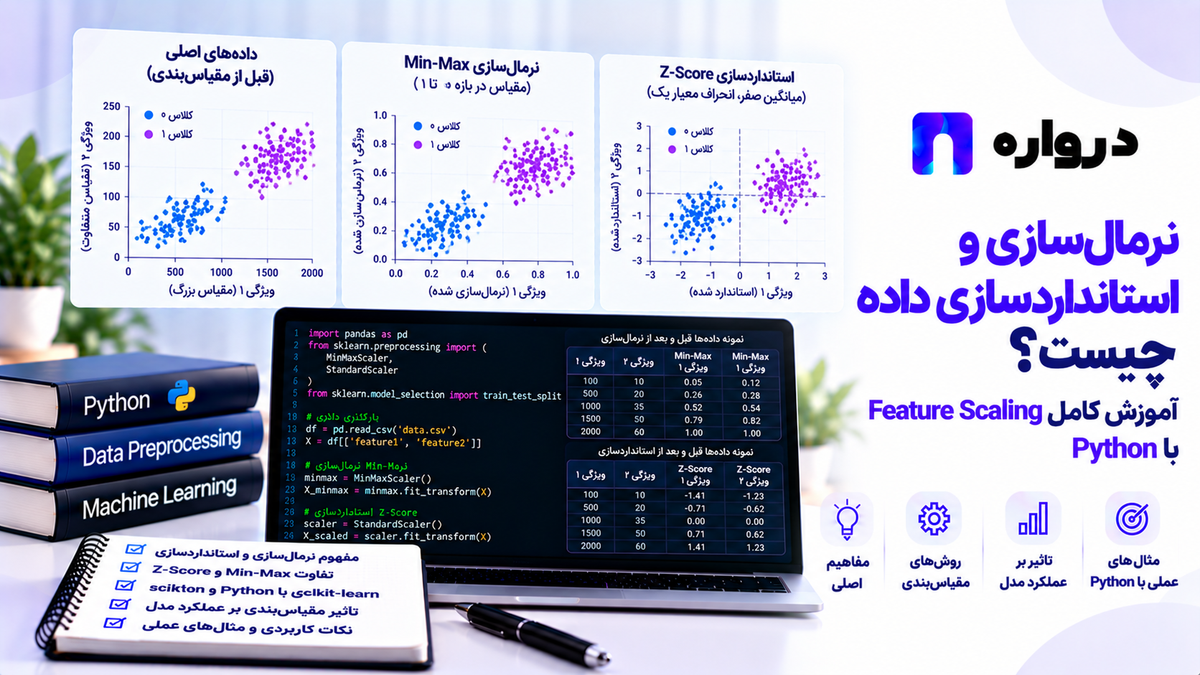
فرض کنید برای پیشبینی یک نتیجه از دو ویژگی استفاده میکنید: یکی عددی در حدود ۱ تا ۱۰ دارد و دیگری در حدود ۱۰۰۰ تا ۱۰٬۰۰۰. اگر مدل بر پایه فاصله نمونهها کار کند، ویژگی دوم ممکن است صرفاً بهدلیل مقیاس عددی بزرگتر اثر بسیار بیشتری بر محاسبه فاصله بگذارد؛ حتی اگر از نظر پیشبینی مهمتر نباشد.
Feature Scaling یا مقیاسبندی ویژگیها، مجموعهای از تبدیلها برای تغییر مقیاس عددی ورودی مدل است. روشهایی مانند StandardScaler، MinMaxScaler و RobustScaler هرکدام مقدارها را به شکل متفاوتی تبدیل میکنند.
انتخاب روش به مدل، توزیع داده، وجود مقدارهای پرت و هدف استفاده بستگی دارد. همچنین زمان اجرای مقیاسبندی اهمیت دارد: اگر پارامترهای تبدیل را از مجموعه آزمون یاد بگیرید، ارزیابی مدل دچار نشت داده میشود.
در این مقاله، ابتدا تفاوت روشها را توضیح میدهیم و سپس با یک مثال قابلاجرا در Python نشان میدهیم چگونه مقیاس نامتوازن میتواند عملکرد KNN را تغییر دهد.
مقیاسبندی ویژگیها چیست؟
مقیاسبندی یعنی مقدارهای یک یا چند ویژگی عددی را با قاعدهای مشخص به مقیاس دیگری ببریم.
برای مثال، یک دیتاست ممکن است شامل این ستونها باشد:
| ویژگی | نمونه مقدار | واحد |
|---|---|---|
| تعداد درخواست | ۸ | درخواست |
| مدت استفاده | ۲۴۰ | روز |
| مبلغ سفارش | ۴٬۵۰۰٬۰۰۰ | تومان |
بزرگتر بودن عدد مبلغ سفارش بهتنهایی نشان نمیدهد این ویژگی از تعداد درخواست مهمتر است. هر ستون واحد و دامنه متفاوتی دارد.
بعضی الگوریتمها به این تفاوت حساساند؛ زیرا فاصله، پراکندگی یا اندازه ضرایب را در فرایند آموزش به کار میبرند. نمونه رسمی scikit-learn نشان میدهد مقیاس ویژگیها میتواند بر همسایهیابی در KNN و نتیجه PCA اثر محسوس داشته باشد. scikit-learn 1.8.0 documentation
تفاوت اصطلاحهای Scaling، Standardization وNormalization
این اصطلاحها گاهی در متنهای آموزشی بهجای یکدیگر استفاده میشوند؛ بنابراین هنگام کار با کد، نام تبدیل مشخص را بررسی کنید.
- Scaling: عنوان کلی تغییر مقیاس داده.
- Standardization: معمولاً تبدیل هر ستون بر اساس میانگین و انحراف معیار داده آموزش؛ کاری که
StandardScalerانجام میدهد. - Min-Max Scaling: بردن هر ستون به بازهای تعریفشده بر اساس کمینه و بیشینه داده آموزش.
- Normalization: اصطلاحی چندمعنایی است. در scikit-learn، کلاس
Normalizerمعمولاً هر ردیف یا نمونه را جداگانه از نظر اندازه بردار تبدیل میکند؛ در حالی کهStandardScalerوMinMaxScalerروی هر ستون عمل میکنند.
این تفاوت ستون و ردیف یکی از مهمترین نکات این مقاله است. مستندات رسمی Normalizer نیز آن را تبدیل جداگانه هر نمونه معرفی میکند. scikit-learn.org
StandardScalerچیست؟
StandardScaler برای هر ویژگی عددی، میانگین و انحراف معیار داده آموزش را یاد میگیرد و سپس مقدارها را بر همان اساس تبدیل میکند.
پس از تبدیل، ویژگیهای داده آموزش معمولاً حول صفر قرار میگیرند و مقیاس پراکندگی آنها مشابهتر میشود.
برای مثال، اگر یک ستون برحسب میلیون تومان و ستون دیگر برحسب تعداد روز باشد، استانداردسازی میتواند از غلبه عددی صرفِ ستون اول در برخی الگوریتمها جلوگیری کند.
نکته مهم: استانداردسازی به معنای «نرمالکردن توزیع داده» نیست. اگر ستون اصلی نامتقارن یا دارای چند قله باشد، StandardScaler آن را خودکار به توزیع زنگولهای تبدیل نمیکند.
حساسیت StandardScaler به مقدار پرت
میانگین و انحراف معیار از مقدارهای بسیار بزرگ یا کوچک تأثیر میگیرند. بنابراین یک مقدار پرت میتواند مقیاس تبدیلشده نمونههای معمول را تغییر دهد. مثال رسمی scikit-learn این اثر را در مقایسه چند Scaler نشان میدهد. scikit-learn.org
این موضوع به معنای ممنوع بودن StandardScaler در حضور مقدار پرت نیست؛ باید عملکرد آن را با گزینههای دیگر مقایسه کنید و ابتدا مشخص کنید مقدار پرت خطای ثبت است یا یک مشاهده واقعی.
MinMaxScalerچیست؟
MinMaxScaler کمینه و بیشینه هر ویژگی را در داده آموزش یاد میگیرد و مقدارهای آن ویژگی را به بازهای تعیینشده، معمولاً صفر تا یک، تبدیل میکند.
برای داده آموزش، کوچکترین مقدار مشاهدهشده به یک سر بازه و بزرگترین مقدار به سر دیگر میرود.
نکته مهم درباره داده جدید
اگر پس از استقرار مقداری خارج از محدوده مشاهدهشده هنگام آموزش وارد شود، خروجی MinMaxScaler با تنظیم پیشفرض لزوماً در بازه صفر تا یک باقی نمیماند.
برای مثال:
from sklearn.preprocessing import (
    MinMaxScaler,
)


scaler = MinMaxScaler()

scaler.fit(
    [
        [0],
        [10],
    ]
)

print(
    scaler.transform(
        [
            [15]
        ]
    )
)
مقدار جدید ۱۵ از بیشینه آموزش بزرگتر است؛ بنابراین خروجی آن از یک بیشتر میشود. مستندات scikit-learn نیز بازه تبدیل را بر اساس داده آموزش تعریف میکند. scikit-learn 1.9.0 documentation
گزینه clip=True میتواند خروجیهای بیرون از بازه را محدود کند، اما در این صورت تفاوت میان بعضی مقدارهای خارج از محدوده از بین میرود. آن را بر اساس نیاز مدل و محصول انتخاب کنید.
حساسیت MinMaxScaler به مقدار پرت
اگر بیشتر مقدارهای یک ستون بین صفر تا ۱۰۰ باشند و یک مقدار بهاشتباه ۱۰۰٬۰۰۰ ثبت شده باشد، مقدارهای معمول پس از Min-Max Scaling در بخش کوچکی از بازه فشرده میشوند.
بنابراین استفاده از بازه صفر تا یک بهتنهایی مشکل مقدار پرت را حل نمیکند. scikit-learn.org
RobustScalerچیست؟
RobustScaler بهجای میانگین و انحراف معیار، از آمارهایی مانند میانه و فاصله میان چارکها برای تبدیل هر ویژگی استفاده میکند.
این آمارها معمولاً از چند مقدار بسیار دورافتاده کمتر تأثیر میگیرند. به همین دلیل RobustScaler گزینهای مناسب برای آزمایش روی ستونهایی است که مقدار پرت دارند.
بااینحال، Robust Scaling مقدار پرت را حذف نمیکند و تضمین نمیکند مدل نهایی بهتر شود. در بعضی مسائل، مقدارهای بسیار بزرگ اطلاعات واقعی و مهمی دارند. مقایسه باید با داده اعتبارسنجی انجام شود. scikit-learn.org
تفاوت StandardScaler، MinMaxScaler وRobustScaler
| روش | مبنای تبدیل هر ستون | رفتار در برابر مقدار پرت | کاربرد اولیه برای آزمایش |
|---|---|---|---|
StandardScaler | میانگین و انحراف معیار | حساس | بسیاری از مدلهای حساس به مقیاس |
MinMaxScaler | کمینه و بیشینه | حساس | وقتی بازه آموزش مشخص و مفید است |
RobustScaler | میانه و چارکها | مقاومتر در برابر چند مقدار پرت | داده عددی دارای مقدارهای دورافتاده |
هیچ ردیف این جدول به معنای «همیشه بهترین» نیست. برای انتخاب، نوع مدل و عملکرد روی داده مستقل تعیینکنندهاند.
Normalizer چه تفاوتی با Scalerهای ستونی دارد؟
سه روش قبلی معمولاً برای هر ویژگی یا ستون آماری از نمونههای آموزش یاد میگیرند.
Normalizer هر نمونه یا ردیف را مستقل از سایر ردیفها تبدیل میکند تا اندازه بردار آن به یک مقدار معیار برسد. در تنظیم پیشفرض scikit-learn این کار بر اساس اندازهگیری L2 انجام میشود. scikit-learn.org
مثال مفهومی:
- اگر دو سند از نظر ترکیب واژهها مشابهاند ولی طول بسیار متفاوتی دارند، نرمالسازی بردارهای هر سند ممکن است برای بعضی روشهای شباهتسنجی مناسب باشد.
- اگر بزرگی کل بردار خودش اطلاعات مهمی دارد، نرمالکردن هر ردیف ممکن است آن اطلاعات را از بین ببرد.
برای داده جدولی معمولی، جایگزینکردن بیبررسی StandardScaler با Normalizer اشتباه است؛ این دو تبدیل پرسش متفاوتی را حل میکنند.
کدام مدلها به مقیاس ویژگی حساسترند؟
KNNو روشهای مبتنی بر فاصله
KNNنزدیکترین نمونهها را بر اساس فاصله پیدا میکند. اگر مقیاس یک ستون بسیار بزرگ باشد، همان ستون ممکن است در فاصله محاسبهشده نقش غالب پیدا کند.
SVM
در بسیاری از تنظیمات SVM، بهویژه زمانی که محاسبه شباهت میان نمونهها مهم است، مقیاس ویژگیها میتواند بر نتیجه اثر بگذارد.
رگرسیون لجستیک و مدلهای خطی دارای منظمسازی
در مدلهای خطی، مقیاس میتواند روی فرایند بهینهسازی و اثر منظمسازی بر ضرایب تأثیر بگذارد.
PCA
PCA به پراکندگی ویژگیها توجه میکند. اگر یک ستون صرفاً بهدلیل واحد اندازهگیری خود پراکندگی عددی بسیار بزرگی داشته باشد، ممکن است جهتهای بهدستآمده را تحت تأثیر قرار دهد. مثال رسمی scikit-learnاین اثر را نشان میدهد. scikit-learn 1.8.0 documentation
مدلهای مبتنی بر درخت
درخت تصمیم و بسیاری از مدلهای درختی معمولاً نسبت به تغییر مقیاس یکنوای یک ستون حساسیت کمتری دارند؛ زیرا تقسیمها را بر اساس ترتیب و آستانه ویژگی انجام میدهند. بااینحال، این مشاهده را به همه مراحل یک Pipeline تعمیم ندهید. ممکن است پیشپردازش، الگوریتم ترکیبی یا تفسیر خروجی شما همچنان به مقیاس وابسته باشد. مستندات مقایسه Scalerها در scikit-learn نیز مدلهای مبتنی بر درخت را از مواردی میداند که معمولاً به مقیاسبندی نیاز کمتری دارند. scikit-learn 1.8.0 documentation
آموزش عملی Feature Scaling باPython
برای نشاندادن اثر مقیاس، یک دیتاست دودویی با دو ویژگی میسازیم. سپس مقیاس عددی ویژگی دوم را عمداً هزار برابر میکنیم.
این تغییر، رابطه اطلاعاتی ویژگی با برچسب را عوض نمیکند؛ فقط اندازه عددهای آن را تغییر میدهد.
چهار نسخه KNN را مقایسه میکنیم:
- بدون مقیاسبندی
- همراه با
StandardScaler - همراه با
MinMaxScaler - همراه با
RobustScaler
نصب کتابخانهها
pip install numpy pandas matplotlib scikit-learnساخت داده
import numpy as np
from sklearn.datasets import (
make_classification,
)
RANDOM_STATE = 42
X, y = make_classification(
n_samples=2000,
n_features=2,
n_informative=2,
n_redundant=0,
n_clusters_per_class=1,
class_sep=1.0,
random_state=RANDOM_STATE,
)
# فقط واحد عددی ویژگی دوم
# را تغییر میدهیم.
X[:, 1] *= 1000
print(
"First feature range:",
X[:, 0].min(),
X[:, 0].max(),
)
print(
"Second feature range:",
X[:, 1].min(),
X[:, 1].max(),
)در این مثال، هر دو ستون میتوانند برای پیشبینی مفید باشند؛ اما ویژگی دوم در محاسبه فاصله بدون مقیاسبندی بهدلیل اندازه عددی بزرگتر غلبه میکند.
تفکیک Train، Validation وTest
پیش از آموزش Scaler، داده را تفکیک میکنیم:
from sklearn.model_selection import (
    train_test_split,
)


X_development, (
    X_test
), y_development, (
    y_test
) = train_test_split(
    X,
    y,
    test_size=0.20,
    stratify=y,
    random_state=RANDOM_STATE,
)

X_train, (
    X_val
), y_train, (
    y_val
) = train_test_split(
    X_development,
    y_development,
    test_size=0.25,
    stratify=y_development,
    random_state=RANDOM_STATE,
)

print(
    "Train:",
    len(y_train),
)

print(
    "Validation:",
    len(y_val),
)

print(
    "Test:",
    len(y_test),
)
این تقسیم حدود ۶۰ درصد داده را به Train، ۲۰ درصد را به Validation و ۲۰ درصد را به Test اختصاص میدهد.
مهمترین قاعده: Scaler باید پارامترهای خود را فقط از Trainیاد بگیرد. اگر آن را پیش از این تقسیم روی کل داده اجرا کنیم، آمار Validation و Test وارد فرایند آموزش میشود.
ساخت مدلها باPipeline
from sklearn.neighbors import ( KNeighborsClassifier,)from sklearn.pipeline import ( make_pipeline,)from sklearn.preprocessing import ( MinMaxScaler, RobustScaler, StandardScaler,)models = { "Without scaling": ( make_pipeline( KNeighborsClassifier( n_neighbors=7, ) ) ), "StandardScaler": ( make_pipeline( StandardScaler(), KNeighborsClassifier( n_neighbors=7, ), ) ), "MinMaxScaler": ( make_pipeline( MinMaxScaler(),Pipeline اطمینان میدهد هنگام fit، Scaler فقط از نمونههای Trainآمار یاد میگیرد و هنگام predict همان تبدیل را روی Validation و Test اعمال میکند.
ارزیابی رویValidation
from sklearn.metrics import ( accuracy_score, roc_auc_score,)validation_results = {}for name, model in models.items(): model.fit( X_train, y_train, ) predictions = model.predict( X_val ) probabilities = ( model.predict_proba( X_val )[:, 1] ) accuracy = accuracy_score( y_val, predictions, ) roc_auc = roc_auc_score( y_val, probabilities, ) validation_results[ nameبا داده و بذر تصادفی همین مثال، در یک اجرای بررسیشده KNN بدون مقیاسبندی Accuracy نزدیک ۰٫۵۱ داشت؛ نسخههای مقیاسبندیشده نزدیک ۰٫۹۶ بودند. نتیجه در محیط یا نسخههای دیگر ممکن است اندکی فرق کند.
این آزمایش نشان میدهد تغییر واحد عددی یک ویژگی میتواند نتیجه یک روش فاصلهمحور را شدیداً تغییر دهد. قرار نیست نتیجه بگیریم مقیاسبندی در همه دیتاستها همین میزان بهبود ایجاد میکند.
دیدن اثر مقیاسبندی در نمودار
ابتدا یک Scaler را فقط روی Train آموزش میدهیم:
import matplotlib.pyplot as plt


scaler_for_plot = StandardScaler()

X_train_scaled = (
    scaler_for_plot.fit_transform(
        X_train
    )
)

X_val_scaled = (
    scaler_for_plot.transform(
        X_val
    )
)

figure, axes = plt.subplots(
    1,
    2,
    figsize=(12, 5),
)

axes[0].scatter(
    X_val[:, 0],
    X_val[:, 1],
    c=y_val,
    alpha=0.5,
    s=18,
)

axes[0].set_title(
    "Before scaling"
)

axes[0].set_xlabel(
    "Feature 1"
)

axes[0].set_ylabel(
    "Feature 2"
)

axes[1].scatter(
    X_val_scaled[:, 0],
    X_val_scaled[:, 1],
    c=y_val,
    alpha=0.5,
    s=18,
)

axes[1].set_title(
    "After StandardScaler"
)

axes[1].set_xlabel(
    "Scaled feature 1"
)

axes[1].set_ylabel(
    "Scaled feature 2"
)

plt.tight_layout()
plt.show()
در نمودار نخست، تفاوت مقیاس محورهای افقی و عمودی میتواند شکل پراکندگی را فریبنده نشان دهد. برای تفسیر تصویری نیز باید به مقیاس محورها توجه کنید.
انتخاب روش و ارزیابی نهایی
روش را بر اساس Accuracy روی Validation انتخاب میکنیم:
best_name = max( validation_results, key=lambda name: ( validation_results[ name ]["accuracy"] ),)best_model = ( models[ best_name ])print( "Selected method:", best_name,)اکنون Test مستقل را فقط برای ارزیابی نهایی استفاده میکنیم:
test_predictions = ( best_model.predict( X_test ))test_probabilities = ( best_model.predict_proba( X_test )[:, 1])print( "Test accuracy:", accuracy_score( y_test, test_predictions, ),)print( "Test ROC AUC:", roc_auc_score( y_test, test_probabilities, ),)اگر پس از مشاهده Test، نوع Scaler را بارها تغییر دهید، دیگر همان مجموعه Test آزمون مستقل انتخابها نخواهد بود.
چه زمانی از MinMaxScaler استفاده کنیم؟
MinMaxScaler وقتی ارزش آزمایش دارد که بردن ویژگیها به بازهای مشخص برای مدل یا پردازش بعدی مفید باشد.
برای مثال، ممکن است یک بخش از Pipeline با مقدارهای ورودی در بازهای مشخص بهتر کار کند. اما به این موارد توجه کنید:
- بازه بر اساس Train یاد گرفته میشود.
- مقدار جدید میتواند خارج از بازه Train باشد.
- چند مقدار پرت ممکن است بقیه داده را فشرده کنند.
- صفر شدن مقدار تبدیلشده لزوماً به معنی صفر بودن مقدار اصلی نیست.
اگر دامنه عددی یک ویژگی از نظر مسئله ثابت و از قبل مشخص است، میتوان تبدیل مبتنی بر همان دامنه قراردادی را نیز بررسی کرد؛ این موضوع با یادگیری کمینه و بیشینه از نمونههای Train تفاوت دارد.
چه زمانی از RobustScaler استفاده کنیم؟
اگر داده عددی مقدارهای دورافتاده دارد، RobustScaler یک گزینه مناسب برای مقایسه است. اما ابتدا علت مقدارهای دورافتاده را مشخص کنید:
- آیا اشتباه ثبت شدهاند؟
- آیا حاصل تغییر واحدند؟
- آیا رخداد واقعی و مهماند؟
- آیا فقط در یک بازه زمانی یا منبع داده دیده میشوند؟
اگر مقدار پرت یک خطای کیفیت داده باشد، تغییر Scaler بهتنهایی راهحل کامل نیست.
آیا مقیاسبندی مقدار پرت را حذف میکند؟
خیر. مقیاسبندی، داده را تبدیل میکند؛ لزوماً مقدارهای پرت را شناسایی یا حذف نمیکند.
RobustScaler از آمار مقاومتری برای تعیین مقیاس استفاده میکند، اما نمونه پرت همچنان در داده حضور دارد. MinMaxScaler نیز مقدار پرت را در تعیین کمینه یا بیشینه لحاظ میکند.
روشهایی مانند QuantileTransformer تغییر غیرخطی بیشتری ایجاد میکنند و میتوانند اثر مقدارهای بسیار دورافتاده را کاهش دهند؛ در عوض ممکن است بعضی رابطههای عددی و فاصلهها را تغییر دهند. باید بررسی کنید این تغییر برای مدل و تفسیر ویژگیها مناسب است یا خیر. scikit-learn 1.8.0 documentation
مقیاسبندی همراه با داده گمشده
اگر ستونها مقدار NaN دارند، باید ترتیب تبدیلها را مشخص کنید. یک مسیر رایج:
- جایگزینی مقدار گمشده بر اساسTrain
- مقیاسبندی بر اساس داده تبدیلشدهTrain
- آموزش مدل
from sklearn.impute import (
    SimpleImputer,
)

from sklearn.linear_model import (
    LogisticRegression,
)


model_with_missing_data = (
    make_pipeline(
        SimpleImputer(
            strategy="median",
        ),
        StandardScaler(),
        LogisticRegression(
            max_iter=1000,
        ),
    )
)
این Pipeline هنگام آموزش روی Train، مقدار جایگزین و آمار Scaler را فقط از همان بخش یاد میگیرد. هنگام پیشبینی نیز همان مراحل به همان ترتیب اجرا میشوند.
در بعضی مسیرها میتوان Scaler را پیش از Imputer قرار داد؛ برای مثال StandardScaler در scikit-learn مقدار NaN را هنگام fit نادیده میگیرد و در transform حفظ میکند. اما ترتیب مناسب را باید با توجه به روش جایگزینی و هدف محاسبه انتخاب کرد. scikit-learn.org
مقیاسبندی داده عددی در کنار داده دستهای
در دیتاستهای واقعی، همه ستونها عدد پیوسته نیستند. برای مثال:
- مدت استفاده: عددی
- تعداد درخواست: عددی
- کانال ثبت درخواست: دستهای
- نوع محصول: دستهای
نباید کد دستهها را بدون بررسی معنای آنها مانند یک ویژگی عددی پیوسته مقیاسبندی کرد. برای هر گروه از ستونها مسیر جداگانهای بسازید:
from sklearn.compose import (
    ColumnTransformer,
)

from sklearn.impute import (
    SimpleImputer,
)

from sklearn.linear_model import (
    LogisticRegression,
)

from sklearn.pipeline import (
    Pipeline,
)

from sklearn.preprocessing import (
    OneHotEncoder,
    StandardScaler,
)


numeric_columns = [
    "usage_days",
    "ticket_count",
]

categorical_columns = [
    "request_channel",
    "product_type",
]

numeric_pipeline = Pipeline(
    steps=[
        (
            "imputer",
            SimpleImputer(
                strategy="median",
            ),
        ),
        (
            "scaler",
            StandardScaler(),
        ),
    ]
)

categorical_pipeline = Pipeline(
    steps=[
        (
            "imputer",
            SimpleImputer(
                strategy=(
                    "most_frequent"
                ),
            ),
        ),
        (
            "encoder",
            OneHotEncoder(
                handle_unknown=(
                    "ignore"
                ),
            ),
        ),
    ]
)

preprocessor = (
    ColumnTransformer(
        transformers=[
            (
                "numeric",
                numeric_pipeline,
                numeric_columns,
            ),
            (
                "categorical",
                categorical_pipeline,
                categorical_columns,
            ),
        ]
    )
)

mixed_model = Pipeline(
    steps=[
        (
            "preprocessor",
            preprocessor,
        ),
        (
            "classifier",
            LogisticRegression(
                max_iter=1000,
            ),
        ),
    ]
)
این کد قالبی برای دیتاستی است که ستونهای نامبرده را دارد؛ با دیتاست دوویژگی بخش قبل اجرا نمیشود.
داده تنک و بردارهای متنی
بسیاری از نمایشهای متن، مانند بعضی خروجیهای شمارش واژه یاTF-IDF، تنک هستند: بیشتر خانههای ماتریس صفرند.
اگر چنین ماتریسی را با کمکردن میانگین هر ستون مرکزدهی کنید، ممکن است تعداد زیادی صفر به مقدار غیرصفر تبدیل شود و مصرف حافظه شدیداً افزایش یابد.
مستندات StandardScaler برای کار با ماتریسهای تنک استفاده از with_mean=False را مطرح میکند تا ساختار تنک حفظ شود. scikit-learn 1.10.dev0 documentation
from sklearn.preprocessing import (
    StandardScaler,
)


sparse_safe_scaler = (
    StandardScaler(
        with_mean=False,
    )
)
این به معنای آن نیست که هر بردار متنی حتماً به StandardScaler نیاز دارد. نوع نمایش متن، مدل و روش شباهتسنجی را در نظر بگیرید.
مقیاسبندی وEmbedding
در بردارهای Embedding، گاهی جهت بردار برای مقایسه معنایی اهمیت بیشتری از اندازه آن دارد. به همین دلیل ممکن است نرمالسازی هر بردار پیش از استفاده در بعضی روشهای جستوجو یا فاصلهسنجی بررسی شود.
اما این تصمیم به روش جستوجو و قرارداد مدل Embedding بستگی دارد:
- آیا شاخص جستوجو از Cosine Similarity استفاده میکند؟
- آیا بردارها از ابتدا نرمال شدهاند؟
- آیا مقدار طول بردار اطلاعاتی دارد؟
- آیا بردارهای ثبتشده و بردار پرسوجو دقیقاً یک روش تبدیل را طی میکنند؟
Normalizer سطری، StandardScaler ستونی و نرمالسازی داخلی یک پایگاهداده برداری را نباید یک عملیات یکسان فرض کرد.
آیا باید متغیر هدف را هم مقیاسبندی کنیم؟
در مسائل رگرسیون، گاهی مقیاس متغیر هدف نیز روی آموزش مدل اثر میگذارد. اگر تصمیم گرفتید هدف را تبدیل کنید، پیشبینی نهایی باید به مقیاس اصلی بازگردانده شود تا برای کاربر قابل استفاده باشد.
درscikit-learn، TransformedTargetRegressor میتواند آموزش تبدیل هدف و بازگرداندن پیشبینی را در یک ساختار نگه دارد:
from sklearn.compose import (
    TransformedTargetRegressor,
)

from sklearn.linear_model import (
    Ridge,
)

from sklearn.preprocessing import (
    StandardScaler,
)


regression_model = (
    TransformedTargetRegressor(
        regressor=Ridge(),
        transformer=(
            StandardScaler()
        ),
    )
)
این مثال مخصوص رگرسیون است. در طبقهبندی دودویی، برچسبهای صفر و یک را صرفاً برای پیروی از یک قاعده عمومی مقیاسبندی نکنید.
مقیاسبندی درCross-Validation
اگر از اعتبارسنجی متقاطع استفاده میکنید، Scaler باید در هرFold فقط روی بخش آموزشی همان Fold آموزش ببیند.
الگوی صحیح:
from sklearn.model_selection import (
    StratifiedKFold,
    cross_val_score,
)


pipeline = make_pipeline(
    StandardScaler(),
    KNeighborsClassifier(
        n_neighbors=7,
    ),
)

cross_validation = (
    StratifiedKFold(
        n_splits=5,
        shuffle=True,
        random_state=42,
    )
)

scores = cross_val_score(
    pipeline,
    X_train,
    y_train,
    scoring="accuracy",
    cv=cross_validation,
)

print(
    "Fold scores:",
    scores,
)

print(
    "Mean score:",
    scores.mean(),
)
در این مسیر، ساختار Pipeline در هر Fold دوباره آموزش میبیند. مقیاسبندی یکباره کل X_train پیش از Cross-Validation میتواند اطلاعات Fold اعتبارسنجی را به مرحله تبدیل وارد کند. مستندات scikit-learn بر استفاده از Pipeline برای پیشگیری از این نوع نشت تأکید میکند. scikit-learn.org
مقیاسبندی در دادههای زمانی
در پیشبینی سری زمانی، آمار Scaler باید فقط از دادههای تا زمان آموزش همان مرحله به دست آید.
اگر برای ارزیابی ماه آینده از میانگین کل سال، شامل ماههای آینده، استفاده کنید، اطلاعات آینده وارد پیشپردازش شده است.
در Backtesting نیز برای هر پنجره زمانی، Scaler باید با داده مجاز همان پنجره آموزش ببیند. پس از استقرار، لازم است مشخص کنید آیا پارامترهای Scaler همراه مدل ثابت میمانند یا با بازآموزی مدل بهروز میشوند.
پس از استقرار چه چیزهایی را پایش کنیم؟
مقیاسبندی معمولاً در زمان آموزش ثابت میشود، اما داده عملیاتی ممکن است تغییر کند.
موارد زیر را پایش کنید:
- مقدارهای جدید خارج از دامنه مشاهدهشده درTrain
- تغییر میانگین یا پراکندگی ستونهای مهم
- افزایش مقدارهای پرت
- تغییر واحد اندازهگیری در یک سرویس
- جابهجایی ترتیب ستونها
- تغییر رفتار پس از انتشار نسخه جدید محصول
- اختلاف مقیاسبندی در سرویس آموزش و سرویس پیشبینی
اگر یک سرویس مبلغ را قبلاً به تومان و اکنون به ریال ارسال میکند، Scaler قدیمی این تغییر معنایی را «خودکار اصلاح» نمیکند. باید قرارداد داده و مسیر تولید ویژگی بررسی شود.
اشتباهات رایج
مقیاسبندی قبل ازTrain/Test Split
Scaler از Test نیز آمار یاد میگیرد و ارزیابی مستقل مخدوش میشود. آن را فقط روی Trainآموزش دهید.
اعمال Scaler متفاوت در آموزش و استقرار
اگر مدل با StandardScaler آموزش دیده است، هنگام پیشبینی باید همان Scaler آموزشدیده با همان ترتیب ستونها اعمال شود.
فرض اینکه MinMaxScaler همیشه خروجی صفر تا یک میدهد
این بازه برای داده آموزش تعریف شده است. داده جدید خارج از محدوده آموزش میتواند خروجی خارج از بازه داشته باشد.
استفاده از Normalizer بهجای StandardScaler بدون بررسی محور تبدیل
Normalizer معمولاً ردیفها را تبدیل میکند؛ StandardScaler ستونها را.
بیتوجهی به مقدارهای پرت
Standard و Min-Maxبه آمارهای حساس به مقدار پرت متکیاند. علت مقدار پرت و گزینههای جایگزین را بررسی کنید.
مقیاسبندی شناسهها مانند عدد پیوسته
شناسه کاربر یا کد محصول معمولاً صرفاً برچسب شناسایی است. کوچک و بزرگ شدن عدد آن الزاماً فاصله معنایی ندارد.
مقیاسبندی همه ویژگیها برای همه مدلها
مدلهای مختلف حساسیت یکسانی ندارند. اگر روش سادهتر بدون Scaler عملکرد و نگهداری بهتری دارد، پیچیدگی اضافی را فقط بهخاطر قاعده کلی وارد نکنید.
گزارش بهبود فقط رویValidation
روش را روی Validation انتخاب کنید و نتیجه نهایی را یک بار روی Test مستقل بسنجید.
پرسشهای متداول
نرمالسازی داده چیست؟
اصطلاحی عمومی برای تغییر مقیاس داده است، اما معنای دقیق آن به ابزار بستگی دارد. درscikit-learn، Normalizer معمولاً هر نمونه یا ردیف را جداگانه تبدیل میکند.
استانداردسازی داده چیست؟
در کاربرد رایج، تبدیل هر ویژگی عددی بر اساس میانگین و انحراف معیار داده آموزش است. StandardScaler این کار را انجام میدهد.
تفاوت StandardScaler و MinMaxScaler چیست؟
StandardScaler بر میانگین و انحراف معیار تکیه دارد؛ MinMaxScaler بر کمینه و بیشینه داده آموزش و بازه خروجی تعیینشده تکیه میکند.
RobustScalerچه زمانی مفید است؟
وقتی ویژگی عددی مقدارهای دورافتاده دارد، ارزش آزمایش دارد؛ زیرا از میانه و چارکها استفاده میکند. نتیجه نهایی باید روی داده مستقل بررسی شود.
آیا KNN به مقیاسبندی نیاز دارد؟
اگر ویژگیها مقیاسهای بسیار متفاوت داشته باشند، نتیجه فاصلهسنجی KNN میتواند شدیداً تحت تأثیر مقیاس باشد. نوع تبدیل را با ارزیابی انتخاب کنید.
آیا Random Forest به StandardScaler نیاز دارد؟
معمولاً به اندازه مدلهای فاصلهمحور به مقیاسبندی حساس نیست. بااینحال، نیاز کل Pipeline و روشهای همراه آن را بررسی کنید.
آیا StandardScaler مقدارهای پرت را حذف میکند؟
خیر. داده را بر اساس میانگین و انحراف معیار تبدیل میکند و خود این آمارها از مقدارهای پرت تأثیر میگیرند.
چرا مقیاسبندی روی کل دیتاست اشتباه است؟
زیرا پارامترهای تبدیل از مجموعه آزمون نیز تأثیر میگیرند. برای ارزیابی معتبر، Scaler را فقط روی داده آموزش fit کنید.
آیا پس از مقیاسبندی میتوان به واحد اصلی برگشت؟
بسیاری از Scalerهای scikit-learn متد inverse_transform دارند. برای استفاده درست باید همان Scaler آموزشدیده و ترتیب درست ویژگیها را نگه دارید.
جمعبندی
مقیاسبندی ویژگیها یکی از مراحل مهم آمادهسازی داده برای مدلهای حساس به فاصله، پراکندگی یا اندازه ضرایب است. StandardScaler از میانگین و انحراف معیار، MinMaxScaler از کمینه و بیشینه و RobustScaler از آمار مقاومتر مانند میانه و چارکها استفاده میکند. Normalizer نیز معمولاً هر ردیف را جداگانه تبدیل میکند.
در مثال Python، فقط مقیاس عددی یکی از دو ویژگی را تغییر دادیم. KNN بدون مقیاسبندی عملکرد ضعیفی نشان داد، در حالی که نسخههای دارای Scaler توانستند از اطلاعات هر دو ویژگی بهتر استفاده کنند. این نتیجه به مسئله و داده مثال وابسته است؛ انتخاب نهایی باید با Validation و Test مستقل انجام شود.
برای استفاده عملی، Scaler را در Pipeline همراه مدل ذخیره کنید، آن را فقط روی Train آموزش دهید و تغییر مقیاس یا واحد ویژگیها را پس از استقرار پایش کنید.
از داده آماده تا محصول هوشمند
اگر در حال ساخت مدل دستهبندی پیام، تحلیل درخواست یا جستوجوی مبتنی بر Embedding هستید، پیشپردازش باید در آموزش و استفاده واقعی یکسان باشد. انتخاب درست تبدیل داده بخشی از کیفیت محصول است، نه صرفاً مرحلهای پیش از اجرای مدل.
برای آشنایی با خدمات و زیرساخت هوش مصنوعی درواره و بررسی راههای افزودن قابلیتهای هوشمند به محصول خود، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- نشت داده در یادگیری ماشین و پیشگیری باPipeline
- KNNچیست؟ آموزش نزدیکترین همسایهها
- SVMچیست؟ آموزش ماشین بردار پشتیبان
- مهندسی ویژگی و انتخاب ویژگی
- آموزش scikit-learn باPython
- کالیبراسیون احتمال و انتخاب آستانه تصمیم
- پیشبینی سری زمانی با SARIMA وProphet
- آموزش استفاده از API هوش مصنوعی
منابع
- scikit-learn: Importance of Feature Scaling scikit-learn 1.8.0 documentation
- scikit-learn: Compare the Effect of Different Scalers on Data with Outliers scikit-learn.org
- مستنداتStandardScaler scikit-learn.org
- مستنداتMinMaxScaler scikit-learn 1.9.0 documentation
- مستنداتNormalizer scikit-learn.org
- scikit-learn: Common Pitfalls and Data Leakage scikit-learn.org
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و صفحه سلب مسئولیت درواره را مطالعه کنید.



