
BERT فارسی چیست؟ آموزش جامع طبقهبندی متن با ParsBERTو پایتون
BERT فارسی چگونه متن را درک میکند؟ در این راهنما با ParsBERT،آمادهسازی داده فارسی، آموزش مدل طبقهبندی با پایتون، ارزیابی علمی و کاربرد آن در محصول آشنا میشوید.

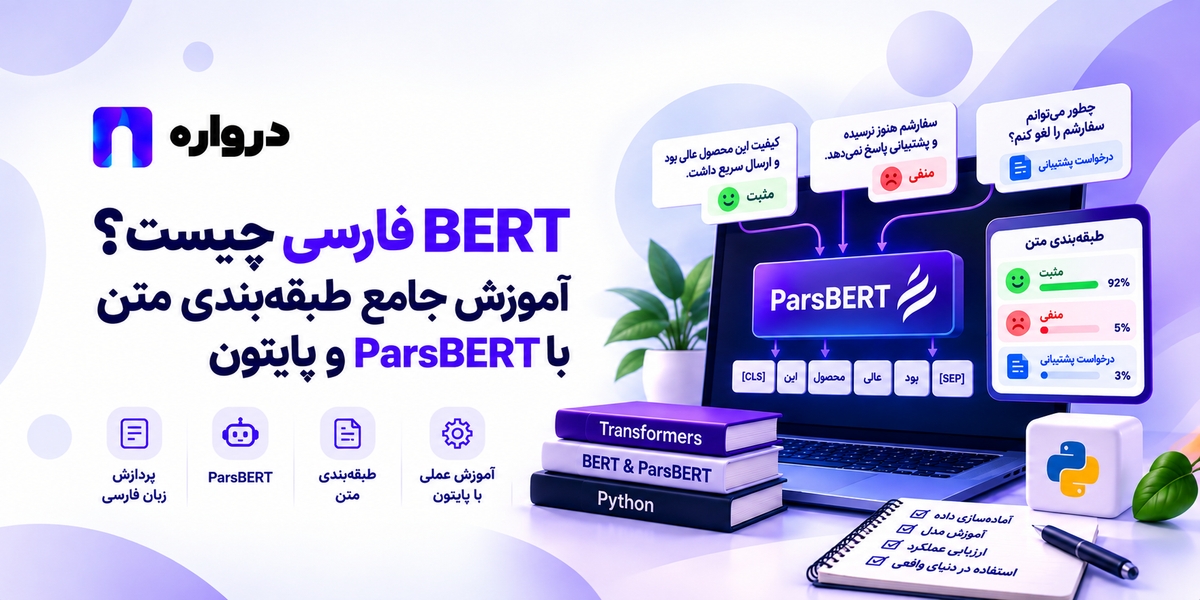
فرض کنید فروشگاهی روزانه هزاران دیدگاه دریافت میکند. بخشی از مشتریان از کیفیت کالا راضیاند، گروهی از تأخیر ارسال شکایت دارند و عدهای هم در یک جمله هم تعریف میکنند و هم انتقاد. اگر بخواهید این پیامها را بهصورت خودکار دستهبندی کنید، تطبیق چند کلمه مانند «خوب» و «بد» کافی نیست؛ مدل باید واژهها را در بافت جمله بخواند.
BERT یک معماری برای ساخت بازنمایی زبان است که هنگام پردازش متن، اطلاعات دو سوی واژه را در نظر میگیرد. ParsBERT مدلی مبتنی بر BERT است که برای زبان فارسی پیشآموزش دیده است. با افزودن یک لایه طبقهبندی و آموزش روی نمونههای برچسبدار، میتوان از آن برای کارهایی مانند تشخیص احساس دیدگاه، دستهبندی موضوع تیکت یا تشخیص نوع پیام استفاده کرد. مقاله اصلی BERT و پژوهش ParsBERT این دو مرحله، یعنی پیشآموزش و تنظیم مدل برای وظیفه مشخص، را توضیح میدهند. arxiv.org
در این آموزش، یک طبقهبند دوکلاسه برای دیدگاههای فارسی میسازیم. سپس بررسی میکنیم نتیجه آن را چگونه بسنجیم و چه زمانی استفاده از یک مدل مولد از طریق API انتخاب مناسبتری است.
در این مقاله چه میخوانید؟
- تفاوت BERT، ParsBERT و مدلهای چت
- سازوکار توکنسازی و طبقهبندی متن
- آمادهسازی داده فارسی و جلوگیری از ارزیابی گمراهکننده
- آموزش عملی ParsBERT با Python وTransformers
- ارزیابی با معیارهای مناسب، از جملهMacro F1
- محدودیتهای مدل در متنهای واقعی
- مسیر استفاده از طبقهبندی متن در یک محصول
اگر با مفاهیم پایه آشنا نیستید، ابتدا راهنماهای پردازش زبان طبیعی، معماری ترنسفورمر و یادگیری انتقالی را بخوانید.
BERTچگونه متن را پردازش میکند؟
نام BERT کوتاهشده عبارت Bidirectional Encoder Representations from Transformers است. این مدل بر بخش رمزگذار معماری ترنسفورمر تکیه دارد. ویژگی مهم آن این است که بازنمایی یک واژه را با توجه به متن اطراف همان واژه میسازد.
برای نمونه، معنای «شیر» در این دو جمله یکسان نیست:
- «شیر آب آشپزخانه خراب شده است.»
- «شیر در زیستگاه خود شکار میکند.»
مدلی که تنها خود واژه را ببیند، اطلاعات کافی برای تمایز ندارد. BERT با استفاده از بافت جمله میتواند برای آن واژه بازنمایی متفاوتی ایجاد کند. البته این مثال صرفاً برای توضیح ایده است؛ عملکرد واقعی مدل در هر وظیفه باید با داده همان وظیفه اندازهگیری شود.
BERTدر پیشآموزش، از جمله با پنهان کردن بخشی از واژهها و یادگیری پیشبینی آنها، الگوهای زبان را میآموزد. سپس میتوان مدل پیشآموزشدیده را برای یک وظیفه مشخص تنظیم کرد. مقاله اصلی نشان میدهد افزودن یک لایه خروجی متناسب با وظیفه، امکان استفاده از بازنماییهای آموختهشده را در چندین مسئله پردازش زبان فراهم میکند. arxiv.org
مدل پایه با طبقهبند آماده چه فرقی دارد؟
این تفاوت برای اجرای درست آموزش ضروری است:
| نوع مدل | خروجی مورد انتظار | نمونه کاربرد |
|---|---|---|
| مدل پایه ParsBERT | بازنمایی متن یا خروجی مرتبط با وظیفه پیشآموزش | نقطه شروع برای تنظیم مدل |
| ParsBERT تنظیمشده برای طبقهبندی | برچسبهای تعریفشده هنگام آموزش | مثبت یا منفی بودن دیدگاه |
| مدل مولد | متن یا پاسخ تازه | توضیح شکایت، خلاصهسازی و پاسخنویسی |
| مدل embedding | بردار عددی متن | جستوجوی معنایی و یافتن متن مشابه |
صفحه مدل HooshvareLab/bert-base-parsbert-uncased نسخه پایه را معرفی میکند. نمونه استفاده پیشفرض آن در صفحه مدل، پر کردن جای خالی متن است. بنابراین بارگذاری همان نسخه پایه بهتنهایی به معنی داشتن یک تحلیلگر احساسات آموزشدیده نیست. huggingface.co
ParsBERTچیست و چرا برای فارسی مطرح است؟
ParsBERT یک مدل تکزبانه مبتنی بر BERT است که با متن فارسی پیشآموزش دیده است. پژوهش معرفی آن، عملکرد مدل را در وظایفی مانند تحلیل احساسات، طبقهبندی متن و تشخیص موجودیت نامدار بررسی کرده است. در نتایج همان پژوهش، ParsBERT روی مجموعهدادههای بررسیشده از برخی مدلهای مقایسهشده، از جمله BERTچندزبانه، بهتر عمل کرده است. این نتیجه تضمین برتری روی داده هر شرکت یا هر نوع متن فارسی نیست؛ برای چنین ادعایی باید مدلها را روی مجموعه آزمون مرتبط با کاربرد خود مقایسه کنید. arxiv.org
برای نمونه، متنهای یک فروشگاه اینترنتی با پیامهای یک سامانه بانکی تفاوت دارند. واژهها، لحن، طول پیام و حتی معنای برچسب «منفی» ممکن است عوض شود. به همین دلیل، انتخاب مدل پایه تنها شروع کار است؛ کیفیت داده و روش ارزیابی به همان اندازه اهمیت دارند.
آیا ParsBERT همیشه بهترین مدل فارسی است؟
خیر. «بهترین» بدون مشخص کردن وظیفه، داده آزمون، هزینه و زمان پاسخ معنای دقیقی ندارد. برای یک پروژه واقعی، ParsBERT را با دستکم یک خط مبنا و گزینههای مناسب دیگر مقایسه کنید. حتی یک روش سادهتر ممکن است با هزینه کمتر به کیفیت کافی برسد. در مقابل، اگر علاوه بر برچسب به توضیح نتیجه نیاز دارید، یک مدل مولد هم باید در مقایسه قرار بگیرد.
چه مسئلهای را میخواهیم حل کنیم؟
پیش از کدنویسی باید خروجی مطلوب را مشخص کنیم. «تحلیل پیام مشتری» میتواند به چند مسئله مستقل اشاره کند:
| مسئله | ورودی نمونه | خروجی |
|---|---|---|
| تحلیل احساسات | «کالا خوب بود اما دیر رسید» | مثبت، منفی یا ترکیبی |
| دستهبندی موضوع | «هزینه ارسال اشتباه محاسبه شده» | ارسال، پرداخت، کالا و مانند آن |
| تشخیص فوریت | «سفارش امروز لازم است و هنوز ارسال نشده» | عادی یا فوری |
| مسیردهی تیکت | «وجه از حساب کم شد ولی سفارش ثبت نشد» | تیم پرداخت |
برای جلوگیری از ابهام، در نمونه عملی این مقاله فقط تحلیل احساسات دوکلاسه را انجام میدهیم: 0 برای دیدگاه منفی و 1 برای دیدگاه مثبت. این سادهسازی برای آموزش مفید است، اما در محیط واقعی باید درباره نظرهای خنثی یا ترکیبی نیز تصمیم بگیرید.
داده آموزشی فارسی باید چه ویژگیهایی داشته باشد؟
مدل طبقهبندی از نمونههایی یاد میگیرد که متن و برچسب درست دارند. برای این آموزش، فایل reviews.csv دو ستون دارد:
text,label
"ارسال سفارش خیلی سریع بود",1
"بسته با تأخیر رسید",0
"پشتیبانی مسئله را حل کرد",1
"کیفیت کالا مطابق توضیح نبود",0
این چهار ردیف فقط قالب فایل را نشان میدهند و برای آموزش مدل کافی نیستند. اندازه مناسب مجموعهداده عدد ثابتی ندارد؛ به تنوع متن، دشواری مسئله، تعداد کلاسها و کیفیت برچسبها بستگی دارد. با یک نمونه کوچک و بازبینیشده شروع کنید، خطاها را تحلیل کنید و سپس دادههای لازم برای رفع خطاهای پرتکرار را جمعآوری کنید.
هنگام گردآوری و برچسبگذاری به چه نکاتی توجه کنیم؟
تعریف برچسبها را بنویسید. آیا «کالا عالی بود اما پشتیبانی پاسخ نداد» منفی است یا ترکیبی؟ اگر افراد برچسبگذار درباره چنین نمونههایی توافق ندارند، مدل هم مرز روشنی برای یادگیری نخواهد داشت.
نمونههای تکراری را بررسی کنید. اگر یک دیدگاه با تغییر جزئی در هر دو بخش آموزش و آزمون ظاهر شود، امتیاز آزمون میتواند بیش از عملکرد واقعی مدل باشد.
داده را از محیط واقعی بردارید. متن تبلیغاتی مرتب، جایگزین خوبی برای پیامهای واقعی با غلط املایی، ایموجی، کنایه و جملههای ناقص نیست.
توزیع کلاسها را ثبت کنید. اگر ۹۰ درصد پیامها مثبت باشند، یک مدل ممکن است با پیشبینی مداوم «مثبت» به دقت ظاهری بالایی برسد و شکایتهای مهم را از دست بدهد.
مرز زمانی را جدی بگیرید. در بعضی کاربردها، ارزیابی روی پیامهای جدیدتر از آموزش، تصویر واقعیتری از عملکرد پس از استقرار میدهد. اگر پیامهای بسیار مشابه از یک مشتری یا یک کمپین در هر دو طرف تقسیم قرار بگیرند، نتیجه نیز ممکن است خوشبینانه شود.
آمادهسازی متن فارسی: چه چیزهایی را یکسانسازی کنیم؟
در داده فارسی، شکل نوشتاری یک واژه همیشه یکسان نیست. برای مثال ممکن است «ی» فارسی و «ي» عربی، یا «ک» فارسی و «ك» عربی در یک مجموعه داده دیده شوند. نیمفاصله، شکل اعداد و فاصلههای اضافی نیز متغیرند.
یک سیاست ساده و قابلتکرار برای یکسانسازی تعریف کنید و همان سیاست را در آموزش و هنگام پیشبینی اعمال کنید. هر تغییری را پیش از استفاده گسترده روی چند نمونه بررسی کنید؛ حذف بیدلیل علامتها یا ایموجیها ممکن است نشانههای مهم احساس را پاک کند.
برای شروع میتوانید چنین تابع محدودی داشته باشید:
import redef normalize_persian(text: str) -> str: text = str(text) text = text.replace("ي", "ی").replace("ك", "ک") text = re.sub(r"\s+", " ", text) return text.strip()این تابع عمداً همه موارد فارسی را «حل» نمیکند. برای مثال، درباره یکسانسازی نیمفاصله یا حذف نشانی وب باید بر اساس داده و نتیجه آزمایش تصمیم بگیرید. مهمتر از پیچیدگی تابع، ثبات آن در کل چرخه مدل است.
توکنسازی در ParsBERT به چه معناست؟
مدل، متن خام را مستقیماً به شکل جمله انسانی پردازش نمیکند. ابتدا توکنایزر متن را به بخشهایی تبدیل میکند که مدل میشناسد. یک واژه ممکن است یک توکن یا چند بخش باشد. سپس شناسههای توکنها به مدل داده میشوند.
سه نکته عملی در این مرحله مهم است:
- توکنایزر باید با همان مدل پایه هماهنگ باشد. توکنایزر یک مدل دیگر را بهجای توکنایزر ParsBERT قرار ندهید.
- متنهای بلند ممکن است کوتاه شوند. در نمونه کد، سقف ورودی
256توکن است. اگر نشانه اصلی شکایت معمولاً در انتهای متن قرار دارد، کوتاهسازی میتواند نتیجه را خراب کند. - طول متن روی حافظه و زمان پاسخ اثر دارد. سقف را با بررسی طول واقعی داده و سنجش کیفیت انتخاب کنید.
مستندات رسمی Transformers برای طبقهبندی متن نیز توکنسازی، کوتاهسازی ورودی و تکمیل طول نمونههای هر دسته در زمان پردازش را شرح میدهد. huggingface.co
آموزش عملی ParsBERT با پایتون
در این بخش از کتابخانههای PyTorch، Transformers، Datasets و scikit-learn استفاده میکنیم. نمونه کد یک مسیر آموزشی کامل از خواندن CSV تا ذخیره مدل است.
مرحله اول: نصب وابستگیها
python -m pip install torch transformers datasets accelerate scikit-learn pandasبرای دریافت مدل در اولین اجرا، محیط شما باید به فایلهای آن دسترسی داشته باشد. اگر سرور عملیاتی دسترسی مستقیم ندارد، میتوانید فایلهای مدل و توکنایزر را از مسیر مجاز از پیش آماده کنید و مسیر محلی پوشه را بهجای شناسه مدل بگذارید. امکان اجرای محلی پس از تهیه فایلها، به معنی یکسان بودن شرایط دسترسی و مجوز استفاده همه مدلها نیست؛ صفحه مدل انتخابی را بررسی کنید.
مرحله دوم: ساخت فایل آموزش
کد زیر را در train.py ذخیره کنید و فایل reviews.csv را کنار آن بگذارید:
import reimport numpy as npimport pandas as pdfrom datasets import Datasetfrom sklearn.metrics import accuracy_score, f1_scorefrom sklearn.model_selection import train_test_splitfrom transformers import ( AutoModelForSequenceClassification, AutoTokenizer, DataCollatorWithPadding, Trainer, TrainingArguments,)MODEL_NAME = "HooshvareLab/bert-base-parsbert-uncased"OUTPUT_DIR = "./parsbert-sentiment"def normalize_persian(text: str) -> str: text = str(text) text = text.replace("ي", "ی").replace("ك", "ک") text = re.sub(r"\s+", " ", text) return text.strip()# خواندن و بررسی اولیه دادهframe = pd.read_csv("reviews.csv")frame = frame.dropna(subset=["text", "label"])frame = frame[["text", "label"]].copy()frame["text"] = frame["text"].map(normalize_persian)frame = frame[frame["text"] != ""]frame["label"] = frame["label"].astype(int)if set(frame["label"].unique()) != {0, 1}:انتخاب learning_rate، اندازه دسته، تعداد دورهها و طول ورودی در اینجا مقدار آغازین برای آزمایش است؛ هیچکدام بهترین مقدار تضمینشده برای داده شما نیست. اگر داده کم دارید، نتیجه میتواند به تقسیم داده و مقداردهی اولیه حساس باشد. بهتر است چند اجرای کنترلشده انجام دهید و نتیجه نهایی را روی مجموعه آزمونی گزارش کنید که برای انتخاب تنظیمات به آن نگاه نکردهاید.
این ساختار کد با مسیر رسمی Hugging Face برای طبقهبندی متن، شامل AutoTokenizer، AutoModelForSequenceClassification، TrainingArguments و Trainer همخوان است. در زمان بارگذاری مدل پایه، هشدار درباره مقداردهی تازه وزنهای سرِ طبقهبندی طبیعی است؛ آن بخش هنوز برای برچسبهای شما آموزش ندیده است. huggingface.co
مرحله سوم: اجرای مدل روی متن جدید
پس از آموزش، مدل ذخیرهشده را میتوان بهصورت محلی بارگذاری کرد:
from transformers import pipelinedef normalize_persian(text: str) -> str: import re text = str(text) text = text.replace("ي", "ی").replace("ك", "ک") text = re.sub(r"\s+", " ", text) return text.strip()classifier = pipeline( task="text-classification", model="./parsbert-sentiment", tokenizer="./parsbert-sentiment",)text = "کیفیت خوب بود اما ارسال سفارش خیلی دیر انجام شد"result = classifier(normalize_persian(text))print(result)نتیجه نمونه را از پیش نمیتوان اعلام کرد. مدل بر اساس دادهای که واقعاً با آن آموزش دیده است، برچسب و نمرهای برمیگرداند. چون جمله مثال هم نشانه مثبت دارد و هم منفی، یک مسئله دوکلاسه ممکن است برای چنین متنی تعریف مناسبی نداشته باشد.
چگونه مدل طبقهبندی فارسی را علمی ارزیابی کنیم؟
یک عدد بهتنهایی کیفیت مدل را نشان نمیدهد. نخست باید بدانید کدام اشتباه در کاربرد شما پرهزینهتر است. برای تیم پشتیبانی، از دست رفتن پیامهای ناراضی شاید مهمتر از فرستادن چند پیام عادی برای بازبینی باشد. برای نمایش خودکار برچسب به مشتری، خطای مثبت کاذب هم ممکن است پیامد متفاوتی داشته باشد.
Accuracyیا دقت کلی
Accuracyسهم پیشبینیهای درست از همه نمونههاست. تفسیر آن ساده است، اما در داده نامتوازن میتواند گمراهکننده باشد. فرض کنید تقریباً همه دیدگاهها مثبتاند؛ مدلی که بیشتر پیامها را مثبت مینامد، ممکن است دقت کلی خوبی ثبت کند و در شناسایی شکایتها ضعیف باشد.
Precision، Recall و F1
- Precision برای یک کلاس نشان میدهد از مواردی که مدل در آن کلاس قرار داده، چه سهمی درست بودهاند.
- Recall نشان میدهد مدل چه سهمی از موارد واقعی آن کلاس را پیدا کرده است.
- F1 این دو جنبه را با هم خلاصه میکند.
- Macro F1 ابتدا عملکرد هر کلاس را جدا محاسبه و سپس به کلاسها وزن برابر میدهد؛ به همین دلیل برای دیدن ضعف پنهانشده در کلاس کمتعداد مفید است.
برای توضیح همراه با مثال، مقاله ماتریس درهمریختگی، Precision، Recall وF1 را ببینید. ابزارهای رسمی scikit-learn نیز محاسبه این معیارها و گزارش طبقهبندی را پشتیبانی میکنند. scikit-learn 1.9.1 documentation
ماتریس خطا و بررسی نمونههای اشتباه
پس از محاسبه معیارها، نمونههای اشتباه را بخوانید. خطاها را به گروههای قابلاقدام تقسیم کنید:
| نوع خطا | مثال احتمالی | اقدام بررسی |
|---|---|---|
| کنایه | «واقعاً عالی بود؛ فقط سه هفته طول کشید!» | افزودن نمونههای کنایهدار |
| نظر ترکیبی | «کالا خوب است، ارسال افتضاح بود» | بازنگری تعریف برچسبها |
| موضوع جدید | شکایت درباره قابلیت تازه محصول | گردآوری داده جدید |
| غلط نوشتاری | متن کوتاه با چند غلط املایی | بررسی پوشش داده واقعی |
| متن طولانی | شکایت اصلی پس از چند پاراگراف | بازنگری حد طول ورودی |
| فینگلیش | «ersal kheili dir bood» | مسیر جدا یا داده آموزشی متناسب |
این تحلیل ارزش بیشتری از تغییر تصادفی تنظیمات آموزش دارد؛ زیرا نشان میدهد مشکل از داده، تعریف مسئله، پیشپردازش یا خود مدل است.
آزمون نهایی را از انتخاب مدل جدا نگه دارید
اگر بارها با مشاهده نتیجه مجموعه آزمون، مدل و تنظیمات را تغییر دهید، آن مجموعه دیگر یک سنجش مستقل از عملکرد نهایی نیست. یک مسیر مناسب این است:
- آموزش: یادگیری مدل از نمونههای برچسبدار.
- اعتبارسنجی: مقایسه نسخهها و انتخاب تنظیمات.
- آزمون نهایی: گزارش عملکرد نسخه انتخابشده روی دادهای که در تصمیمهای قبلی استفاده نشده است.
تقسیم train_test_split با گزینه stratify میتواند در یک مثال آموزشی نسبت کلاسها را در دو بخش حفظ کند، اما بهتنهایی مشکل دادههای تکراری، وابستگی زمانی یا پیامهای متعلق به یک مشتری را حل نمیکند. scikit-learn.org
محدودیتهای ParsBERT در محیط عملیاتی
۱. محدودیت طول ورودی
اگر متن از سقف تعیینشده در توکنسازی بلندتر باشد، بخشهایی از آن حذف میشوند. در پیامهای پشتیبانی، نکته اصلی ممکن است در انتهای متن آمده باشد. پیش از استقرار، توزیع طول متنها و کیفیت مدل روی پیامهای بلند را بسنجید.
۲. تغییر زبان و موضوع داده
مدلی که روی دیدگاه کالا آموزش دیده، لزوماً برای پیام بیمه، بانک یا خدمات درمانی همان کیفیت را ندارد. حتی در یک شرکت نیز تغییر محصول یا الگوی شکایت میتواند کیفیت مدل را کاهش دهد.
۳. دشواری برچسبهای مبهم
عبارت «خوب بود، ولی دوباره نمیخرم» را نمیتوان بدون تعریف دقیق برچسبها همیشه به یکی از دو کلاس فروکاست. گاهی مسئله باید به چند برچسب، استخراج جنبههای مختلف یا ارجاع موارد مبهم برای بازبینی تغییر کند.
۴. نمره خروجی معادل قطعیت نیست
نمره بالای یک برچسب بهخودیخود ثابت نمیکند پاسخ درست است. اگر قصد دارید بر پایه نمره مدل تصمیم خودکار بگیرید، کیفیت آن تصمیم و آستانه انتخابی را روی داده واقعی بسنجید. برای موارد حساس، مسیر بازبینی انسانی تعریف کنید.
۵. هزینه نگهداری
آموزش تنها بخش کار نیست. نسخه مدل، نسخه داده، سیاست یکسانسازی متن، معیارهای ارزیابی و نتیجه آزمون باید ثبت شوند تا بتوانید بفهمید تغییرات بعدی واقعاً بهبود ایجاد کردهاند یا خیر.
BERT فارسی بهتر است یا مدل مولد از طریق API؟
پاسخ به نوع خروجی و شرایط محصول بستگی دارد:
| معیار | ParsBERT تنظیمشده | مدل مولد از طریق API |
|---|---|---|
| برچسبهای ثابت و مشخص | مناسب برای آزمایش | قابل استفاده |
| نیاز به داده برچسبدار برای تنظیم اختصاصی | بله | برای شروع با پرامپت، الزاماً خیر |
| تولید توضیح و خلاصه تازه | کاربرد اصلی آن نیست | مناسب برای آزمایش |
| تغییر مداوم دستهها | نیازمند بازنگری داده یا آموزش | تغییر دستور و ارزیابی مجدد ممکن است سریعتر باشد |
| اجرای کاملاً محلی | با آمادهسازی مدل ممکن است | به شیوه ارائه مدل بستگی دارد |
| تصمیم نهایی | بر اساس آزمون روی داده خودتان | بر اساس همان آزمون، زمان پاسخ و هزینه |
برای نمونه، اگر هدف فقط تشخیص «پیام مثبت یا منفی» در حجم بالاست، ساخت یک طبقهبند اختصاصی ارزش بررسی دارد. اگر میخواهید از یک پیام، موضوع، فوریت، خلاصه و پاسخ پیشنهادی را هم بگیرید، یک مدل مولد میتواند گردش کار دیگری فراهم کند. هیچکدام را بدون مقایسه روی مجموعه داده مشترک، برنده قطعی اعلام نکنید.
جایگاه API درواره در این مسیر
اگر توسعهدهنده هستید، میتوانید نسخه اولیه یک قابلیت پردازش متن را با APIدرواره بسازید، نمونه خروجیها را با برچسب انسانی مقایسه کنید و سپس درباره استفاده ادامهدار از API یا آموزش مدل اختصاصی تصمیم بگیرید. برای انتخاب مدل، قابلیت و شناسه فعلی آن را در مستندات و فهرست مدلهای درواره بررسی کنید.
نکته فنی: شناسه مدل محلی HooshvareLab/bert-base-parsbert-uncased در این آموزش به معنی آن نیست که همین مدل با همین شناسه از API درواره ارائه میشود. همچنین متن خروجی یک مدل مولد و برچسب خروجی یک طبقهبند اختصاصی باید با معیارهای متناسب با همان وظیفه ارزیابی شوند.
برای معماری اتصال مدل به نرمافزار، راهنمای استفاده از API هوش مصنوعی در برنامهنویسی را بخوانید.
یک مسیر پیشنهادی برای تبدیل آزمایش به محصول
اگر پروژه را از صفر شروع میکنید، این ترتیب از پیچیدگی بیمورد جلوگیری میکند:
- یک تصمیم مشخص انتخاب کنید. مثلاً «آیا این پیام باید برای بررسی نارضایتی در صف ویژه قرار بگیرد؟»
- راهنمای برچسبگذاری بنویسید. نمونههای واضح و مبهم را با نظر تیم عملیاتی تعیین تکلیف کنید.
- خط مبنا بسازید. نتیجه یک روش ساده را ثبت کنید تا بهبود مدل پیشرفته قابلاندازهگیری باشد.
- ParsBERTو گزینههای دیگر را روی داده مشترک بسنجید. معیار هر کلاس، زمان پاسخ و هزینه اجرا را ثبت کنید.
- نمونههای اشتباه را بازبینی کنید. ببینید مشکل از داده، تعریف برچسب یا مدل است.
- برای موارد نامطمئن مسیر بازبینی بگذارید. پوشش خودکار را همراه با نرخ خطا اندازه بگیرید.
- پس از استقرار نیز ارزیابی را ادامه دهید. متن مشتریان و نوع درخواستها ثابت نمیماند.
این مراحل کمک میکنند هدف پروژه به یک عدد نمایشی مانند Accuracy محدود نشود. خروجی مفید، تصمیمی است که در روند واقعی کار شرکت قابلاعتماد باشد.
پرسشهای متداول درباره BERT فارسی
آیا ParsBERT بدون داده آموزشی، احساس متن را تشخیص میدهد؟
نسخه پایه ParsBERT برای وظیفه مشخص شما برچسب احساسات تعریفشده ندارد. میتوانید آن را با داده برچسبدار تنظیم کنید یا یک مدل از پیش تنظیمشده را انتخاب و روی داده مرتبط با کاربرد خود ارزیابی کنید. نام مشابه مدلها به معنی کیفیت مشابه آنها نیست.
آیا برای آموزش ParsBERT به GPU نیاز است؟
اجرای آزمایش کوچک روی CPU ممکن است، اما آموزش میتواند کند باشد. نیاز سختافزاری به حجم داده، طول ورودی، اندازه دسته و روش آموزش بستگی دارد. اگر حافظه کافی ندارید، ابتدا طول ورودی و اندازه دسته را با توجه به داده خود بازبینی کنید.
آیا BERT میتواند پاسخ پشتیبانی تولید کند؟
طبقهبند ساختهشده در این مقاله فقط یکی از برچسبهای آموزشدیده را برمیگرداند. برای تولید پاسخ تازه، باید از معماری و مدل مناسب تولید متن استفاده کنید. در یک سامانه پشتیبانی، طبقهبندی و تولید پاسخ میتوانند دو مرحله جدا باشند.
آیا مدل فارسی، فینگلیش را هم خوب تشخیص میدهد؟
نمیتوان چنین فرضی کرد. اگر فینگلیش بخش مهمی از پیامهای شماست، آن را بهصورت جداگانه در مجموعه آزمون قرار دهید. در صورت افت کیفیت، داده آموزشی مناسب، پیشپردازش مشخص یا مدل دیگری را آزمایش کنید.
برای متنهای چندموضوعی چه کنیم؟
ابتدا مشخص کنید خروجی مورد نیاز «یک برچسب برای کل پیام»، «چند برچسب همزمان» یا «برچسب برای هر بخش متن» است. تغییر نوع مسئله، نوع داده آموزشی و روش ارزیابی را نیز تغییر میدهد. یک مدل دوکلاسه احساسات جایگزین دستهبندی چندموضوعی نیست.
آیا نتیجه منتشرشده در مقاله ParsBERT برای پروژه من تکرار میشود؟
خیر. نتایج پژوهش مربوط به مجموعهدادهها و شرایط آزمایش همان پژوهشاند. آنها دلیل خوبی برای در نظر گرفتن ParsBERT بهعنوان گزینه آزمایشی هستند، اما نتیجه نهایی پروژه شما فقط با آزمون مستقل روی داده مرتبط مشخص میشود. arxiv.org
جمعبندی
BERTفارسی راهی برای استفاده از بازنماییهای زبانی پیشآموزشدیده در مسائل پردازش متن فارسی است. ParsBERT یک نقطه شروع شناختهشده برای این کار فراهم میکند، اما مدل پایه را باید متناسب با وظیفه تنظیم و روی داده واقعی ارزیابی کرد.
برای طبقهبندی دیدگاهها، مهمترین کارها تعریف دقیق برچسبها، تهیه داده معتبر، حفظ یکسانی پیشپردازش، بررسی خطاهای هر کلاس و آزمون مستقل پس از انتخاب مدلاند. اگر محصول شما به خروجیهای متنوعتری مانند خلاصه، توضیح و پاسخ پیشنهادی نیاز دارد، مدلهای مولد قابلدسترسی از طریق API درواره را نیز در همان شرایط آزمایش کنید.
منابع معتبر
- مقاله اصلی BERT، نوشته Devlin و همکاران. arxiv.org
- پژوهش ParsBERT، نوشته Farahani و همکاران. arxiv.org
- صفحه رسمی مدل پایهParsBERT. huggingface.co
- راهنمای رسمی طبقهبندی متن درTransformers. huggingface.co
- مستندات تقسیم داده و معیارهای ارزیابیscikit-learn. scikit-learn.org
سلب مسئولیت: این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. قابلیتها، عملکرد، دسترسی و شرایط استفاده ابزارها و مدلهای معرفیشده ممکن است تغییر کنند. پیش از استفاده عملیاتی، مستندات رسمی و شرایط ارائه هر سرویس را بررسی کنید.



