
مدل MoE چیست؟ آموزش Mixture of Experts، مسیریابی توکن و پیادهسازی باPyTorch
مدل MoE چیست و چرا تعداد کل پارامترهای آن با پارامترهای فعال در هر توکن فرق دارد؟ در این آموزش، Expert و Router، مسیریابی Top-k، مشکل توازن بار، تفاوت MoE با مدل Dense و یک پیادهسازی آموزشی با PyTorch را بررسی میکنیم.

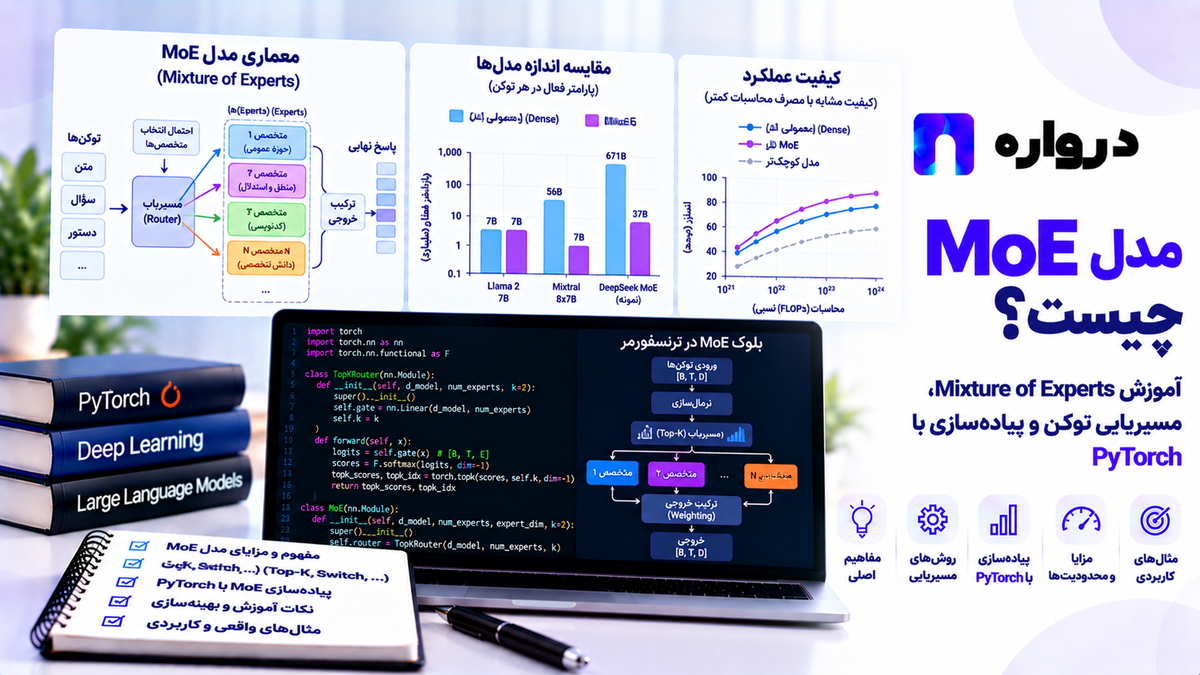
Mixture of Experts یا MoE نوعی معماری شبکه عصبی است که چند بخش قابلآموزش به نام Expert دارد. بخشی دیگر به نام Router یا مسیریاب تصمیم میگیرد برای پردازش هر ورودی، کدام Expertها فعال شوند.
در برخی مدلهای زبانی، این تصمیم برای هر توکن گرفته میشود. بنابراین ممکن است مدل تعداد زیادی پارامتر داشته باشد، اما در پردازش هر توکن فقط بخشی از پارامترهای Expertها را به کار بگیرد.
این تفاوت، یکی از علتهای اصلی توجه به MoE است: امکان افزایش ظرفیت پارامتری مدل، بدون فعالکردن همه Expertها برای هر توکن. البته MoE به معنی اجرای رایگان مدل بزرگ نیست. وزنهای Expertها باید نگهداری شوند و مسیریابی، انتقال داده و نامتوازنشدن بار نیز هزینه دارند.
ایده شبکههای دارای Expertهای انتخابی در پژوهش Sparsely-Gated Mixture-of-Experts مطرح شده و در معماریهایی مانند Switch Transformer توسعه یافته است. arxiv.org
در این مقاله میخوانید:
- Expert و Routerدقیقاً چه کاری میکنند؟
- «پارامتر کل» و «پارامتر فعال» چه تفاوتی دارند؟
- مسیریابی Top-k چگونه کار میکند؟
- چرا توازن بار میان Expertها دشوار است؟
- MoE چه تفاوتی با مدل Denseو سامانه چندمدلی دارد؟
- چگونه یک MoE کوچک را با PyTorch پیادهسازی کنیم؟
- هنگام انتخاب مدل MoE از طریق API چه معیارهایی را بسنجیم؟
Mixture of Expertsبه زبان ساده چیست؟
فرض کنید بهجای یک بخش پردازشی واحد، چند بخش مشابه در شبکه وجود دارد. برای هر ورودی، Router تصمیم میگیرد کدامیک از آنها در پردازش شرکت کنند.
در یک مثال مفهومی:
- نمایش یک توکن وارد لایه میشود.
- Router برای Expertها امتیاز تعیین میکند.
- چند Expert با امتیاز بالاتر انتخاب میشوند.
- Expertهای انتخابشده ورودی را پردازش میکنند.
- خروجی آنها با وزنهای تعیینشده ترکیب میشود.
برای درک اولیه میتوان Expertها را «مسیرهای پردازشی متفاوت» دانست. اما این تشبیه محدودیت دارد: Expertلزوماً یک متخصص انسانی با وظیفه نامگذاریشده مانند ریاضی یا ترجمه نیست. نقش آن طی آموزش و در تعامل با سایر اجزای مدل شکل میگیرد.
مدل Dense یا متراکم چیست؟
در یک شبکه Dense، بخشهای مربوط به مسیر محاسباتی معمول برای هر ورودی فعالاند. در مقابل، در MoE تنک، از میان چند Expert موجود، تنها تعداد مشخصی برای هر ورودی انتخاب میشوند.
| ویژگی | مدل Dense | مدل MoE تنک |
|---|---|---|
| بخش پردازشی متناظر | معمولاً یک مسیر مشترک | چند Expert با انتخاب Router |
| استفاده از پارامترها برای هر ورودی | مسیر معمول مدل فعال است | فقط Expertهای انتخابشده فعالاند |
| مسیریابی میان Expertها | ندارد | دارد |
| پیچیدگی اجرا | معمولاً سادهتر | بیشتر |
| نیاز به مدیریت توازن بار | معمولاً به این شکل ندارد | مهم است |
| نگهداری وزنها | وزنهای مدل | وزنهای مشترک بهعلاوه Expertها |
این جدول به معنی برتری همیشگی یکی نیست. کیفیت، حافظه موردنیاز، سرعت و هزینه نهایی باید در مدلهای واقعی مقایسه شوند.
Expert در مدل MoEچیست؟
Expert بخشی از شبکه است که ورودی انتخابشده را پردازش میکند. در بسیاری از مدلهای زبانی مبتنی بر Transformer، MoE جایگزین یا بخشی از لایههای Feed-Forward میشود.
در چنین طراحیای، Attention و بخشهایی دیگر همچنان میان توکنها مشترکاند؛ انتخاب Expert به قسمت مشخصی از معماری مربوط است. برای نمونه، توضیح رسمی سازنده Mixtral بیان میکند که بلوک Feed-Forward از میان هشت گروه پارامتر، دو گروه را برای هر توکن انتخاب میکند. mistral.ai
پس جمله «در MoE برای هر توکن فقط دو Expert فعال است» نباید به «در تمام مدل فقط دو بخش محاسبه میشود» تبدیل شود. سایر لایهها و عملیات همچنان اجرا میشوند.
Routerیا مسیریاب چیست؟
Router بخشی قابلآموزش است که برای Expertها امتیاز تولید میکند. سپس بر اساس راهبرد مسیریابی، Expertهای مناسب انتخاب میشوند.
در روش متداول Top-k، تعداد ثابتی از Expertهای دارای بالاترین امتیاز انتخاب میشوند.
برای مثال، اگر یک لایه ۸ Expert داشته باشد و k=2 باشد، Router برای یک توکن دو Expert را انتخاب میکند. توکن دیگر ممکن است به ترکیب متفاوتی از Expertها فرستاده شود.
Router تضمین نمیکند توکنهای مربوط به یک موضوع همیشه به Expertواحدی بروند. این تصور باید با تحلیل تجربی همان مدل بررسی شود.
مسیریابی در سطح توکن یعنی چه؟
یک جمله میتواند شامل چند توکن باشد. در بعضی معماریهای MoE، هر توکن جداگانه مسیریابی میشود.
فرض کنید جملهای فارسی درباره «محاسبه هزینه API» وارد مدل شده است. قرار نیست کل جمله الزاماً به یک Expert فرستاده شود. نمایش توکنهای مختلف ممکن است مسیرهای متفاوتی داشته باشد.
از سوی دیگر، مسیریابی به نمایش داخلی توکن در همان لایه وابسته است؛ با عبور داده از لایههای بعدی، تصمیمهای مسیریابی نیز میتوانند تغییر کنند.
این موضوع یکی از دلایلی است که برچسبزدن ساده Expertها با نامهای انسانی مانند «Expert برنامهنویسی» یا «Expert فارسی» ممکن است گمراهکننده باشد.
تفاوت پارامتر کل و پارامتر فعال
هنگام معرفی مدل MoE معمولاً دو عدد دیده میشود:
- پارامتر کل: تمام پارامترهای مدل، شامل Expertها و بخشهای مشترک.
- پارامتر فعال برای هر توکن: پارامترهایی که در مسیر محاسبه آن توکن به کار میروند.
اگر فقط بخشی از Expertها فعال شوند، این دو عدد میتوانند فاصله زیادی داشته باشند.
برای مثال، گزارش فنی DeepSeek-V3 آن را مدلی با ۶۷۱ میلیارد پارامتر کل و ۳۷ میلیارد پارامتر فعال برای هر توکن معرفی میکند. این اعداد مربوط به همان مدل و گزارش هستند و قاعده عمومی همه مدلهای MoE نیستند. arxiv.org
یک سوءبرداشت مهم
«پارامتر فعال کمتر» لزوماً به این معنی نیست که:
- مدل کامل در حافظه یک GPU کوچک جا میشود.
- حجم فایل مدل برابر با پارامترهای فعال است.
- زمان پاسخ حتماً از یک مدل Dense کوچکتر کمتر است.
- هزینه اجرای سرور صرفاً با نسبت پارامتر فعال تعیین میشود.
وزن تمام Expertهایی که ممکن است انتخاب شوند باید در دسترس موتور اجرا باشند؛ نحوه توزیع آنها میان حافظه و دستگاهها به پیادهسازی بستگی دارد.
آیا Expertها واقعاً تخصص پیدا میکنند؟
Router و Expertها همراه هم آموزش میبینند، بنابراین ممکن است الگوهای تخصصی در استفاده از Expertها شکل بگیرد. اما نباید بدون تحلیل نتیجه گرفت هر Expertبه یک مهارت روشن و مستقل اختصاص یافته است.
برای بررسی تخصصیشدن احتمالی باید پرسشهایی مانند موارد زیر را آزمود:
- چه نوع توکنهایی بیشتر به یک Expert میروند؟
- آیا الگو در لایههای مختلف یکسان است؟
- با تغییر زبان یا زمینه، مسیرها چگونه تغییر میکنند؟
- اگر یک Expert حذف یا غیرفعال شود، چه وظایفی بیشتر افت میکنند؟
- آیا نتیجه در دادهای که مدل ندیده نیز برقرار است؟
یک نمودار ساده از چند Prompt برای نامگذاری قطعی Expert کافی نیست.
Top-1 و Top-2 Routingچه تفاوتی دارند؟
در Top-1 Routing، برای هر توکن یک Expert انتخاب میشود. در Top-2 Routing، دو Expert انتخاب میشوند و خروجی آنها ترکیب میشود.
| معیار | Top-1 | Top-2 |
|---|---|---|
| تعداد Expert فعال برای هر توکن | یک | دو |
| هزینه محاسبه بخش Expert | معمولاً کمتر | معمولاً بیشتر |
| امکان ترکیب خروجی چند Expert | ندارد | دارد |
| پیچیدگی توزیع بار | همچنان وجود دارد | همچنان وجود دارد |
Switch Transformer از سادهسازی مسیریابی با انتخاب یک Expert استفاده میکند. در مقابل، Mixtral نمونه شناختهشدهای از انتخاب دو Expert در هر لایه MoEاست. arxiv.org
انتخاب k به معماری، روش آموزش و هدف عملکرد بستگی دارد. بیشترشدن تعداد Expertهای انتخابی همیشه به بهبود کیفیت متناسب با هزینه منجر نمیشود.
خروجی چند Expert چگونه ترکیب میشود؟
در یک طراحی رایج، Router علاوه بر انتخاب Expertها، وزن مشارکت هر Expert را نیز مشخص میکند.
برای مثال، اگر دو Expert انتخاب شده باشند، خروجی نهایی آن بخش میتواند ترکیبی وزندار از دو خروجی باشد. مقدار این وزنها از امتیازهای Router به دست میآید.
جزئیات دقیق در همه معماریها یکسان نیست. ممکن است نرمالسازی امتیازها، Expert مشترک، محدودیت ظرفیت یا قواعد دیگری نیز وجود داشته باشد.
در بخش عملی، یک نمونه ساده از ترکیب وزندار را پیادهسازی میکنیم.
مشکل توازن بار در MoE چیست؟
اگر Router بیشتر توکنها را به چند Expert مشخص بفرستد، دو مشکل پیش میآید:
- بعضی Expertها بسیار شلوغ میشوند.
- Expertهای دیگر کمتر آموزش میبینند یا ظرفیتشان کمتر استفاده میشود.
نامتوازنشدن بار میتواند بر زمان اجرا، استفاده از سختافزار و روند آموزش اثر بگذارد.
پژوهش Switch Transformer مسئله پیچیدگی مسیریابی، هزینه ارتباطی و پایداری آموزش را از چالشهای مهم MoE میداند. arxiv.org
Load Balancing Lossچیست؟
برخی معماریها هنگام آموزش، مؤلفهای به تابع خطا اضافه میکنند تا Router به توزیع مناسبتری از توکنها میان Expertها تشویق شود.
هدف این است که مدل همه بار را به چند Expert محدود نفرستد. اما «توزیع کاملاً برابر» نیز لزوماً هدف همه طراحیها نیست؛ روش دقیق به معماری وابسته است.
گزارش DeepSeek-V3، برای مثال، راهبردی برای توازن بار بدون تابع خطای کمکی رایج آن را توصیف میکند. بنابراین نباید تصور کرد همه مدلهای MoE از یک Loss یکسان استفاده میکنند. arxiv.org
محدودیت ظرفیت Expert چیست؟
در برخی روشهای آموزش و اجرا، هر Expert ظرفیت مشخصی برای پردازش توکنها در یک Batch دارد.
اگر تعداد توکنهای فرستادهشده به یک Expert از ظرفیت آن بیشتر شود، سیستم باید بر اساس طراحی خود تصمیم بگیرد با توکنهای اضافی چه کند. راهبردهای مختلف میتوانند شامل تغییر مسیر، استفاده از ظرفیت دیگر یا رفتارهای تعریفشده برای اضافهبار باشند.
این مسئله نشان میدهد MoE فقط انتخاب چند Expert با topk نیست؛ زمانبندی و جابهجایی توکنها نیز بخشی از معماری اجرایی آن است.
چرا MoE در اجرا پیچیده است؟
وقتی Expertها روی دستگاههای مختلف قرار میگیرند، توکنها باید به دستگاه دارای Expert انتخابشده ارسال شوند و خروجیها بازگردند.
این انتقال میتواند هزینه ارتباطی ایجاد کند. اگر بار Expertها نامتوازن باشد، بعضی دستگاهها منتظر بعضی دیگر میمانند.
مستندات Expert Parallelism در Transformers توضیح میدهد که Router توکنها را به Expertهای مناسب توزیع میکند و خروجیها دوباره گردآوری میشوند. Hugging Face
بنابراین مقایسه MoE و Dense فقط با تعداد عملیات روی کاغذ کامل نیست. باید سرعت و توان عملیاتی روی زیرساخت واقعی اندازهگیری شود.
تفاوت MoE با استفاده از چند مدل مستقل
فرض کنید در یک محصول، یک مدل برای ترجمه و مدل دیگری برای برنامهنویسی دارید و برنامه شما بر اساس درخواست کاربر یکی را انتخاب میکند. این طراحی میتواند مسیریابی میان مدلها باشد، ولی الزاماً MoE در معنای معماری شبکه عصبی نیست.
| ویژگی | MoE داخل یک مدل | مسیریابی میان چند مدل |
|---|---|---|
| محل تصمیم | در لایههای مدل، گاهی برای هر توکن | در برنامه یا دروازه API، معمولاً برای هر درخواست |
| واحدهای انتخابی | Expertهای داخل شبکه | مدلهای مستقل |
| آموزش مشترک | معمولاً بخشی از طراحی مدل | الزامی نیست |
| خروجی | نتیجه یک مدل با اجزای انتخابی | پاسخ مدل منتخب یا ترکیبی از پاسخها |
هر دو طراحی کاربرد دارند. برای آشنایی با انتخاب مدل در سطح محصول، مقاله مسیریابی مدلهای هوش مصنوعی را بخوانید.
آیا MoE همان Agent چندتخصصی است؟
خیر. در سامانه عاملمحور ممکن است چند عامل یا ابزار برای وظایف مختلف تعریف شوند. تصمیمگیری در آن سطح معمولاً بخشی از منطق برنامه، جریان کار یا فراخوانی مدل است.
در MoE، Expertها اجزای درونی یک مدل یادگیری ماشیناند و Router در محاسبات شبکه نقش دارد.
استفاده از واژه «متخصص» در هر دو حوزه نباید باعث شود معماری آنها را یکسان بدانیم.
آموزش عملی ساخت یک MoE کوچک باPyTorch
برای فهم سازوکار Router و Expert، یک مدل آموزشی کوچک میسازیم. این مثال مدل زبانی نیست؛ ورودی آن دو ویژگی عددی است. هدف نشاندادن مسیریابی، ترکیب خروجی و بررسی بار Expertهاست.
اگرچه کد کامل و قابل اجراست، پیادهسازی حلقهای Expertها برای آموزش مدل بزرگ در مقیاس تولیدی بهینه نشده است.
نصبPyTorch
pip install torchساخت داده نمونه
یک مسئله دودستهای مصنوعی ایجاد میکنیم. برچسب هر نمونه به ترکیب دو ویژگی آن بستگی دارد.
import torchfrom torch import nnfrom torch.nn import functional as FSEED = 42torch.manual_seed(SEED)device = torch.device("cpu")sample_count = 2048features = torch.randn( sample_count, 2,)labels = ( features[:, 0] * features[:, 1] > 0).long()train_features = features[ :1536].to(device)train_labels = labels[ :1536].to(device)test_features = features[ 1536:].to(device)چون داده مصنوعی با قانون ساده ساخته شده است، دقت حاصل درباره کیفیت MoE در متن فارسی یا وظایف واقعی چیزی ثابت نمیکند.
ساختExpert
هر Expert در این مثال یک شبکه کوچک است که ورودی دوبعدی را به خروجی دوبعدی تبدیل میکند:
class SmallExpert(nn.Module): def __init__( self, input_dim=2, hidden_dim=16, ): super().__init__() self.network = nn.Sequential( nn.Linear( input_dim, hidden_dim, ), nn.GELU(), nn.Linear( hidden_dim, input_dim, ), ) def forward(self, x): return self.network(x)در مدل زبانی واقعی، شکل و جایگاه Expertها پیچیدهتر است. این مثال فقط مسیر انتخاب و ترکیب را نشان میدهد.
ساخت Router و لایهMoE
Router برای هر نمونه به Expertها امتیاز میدهد. سپس topk تعداد مشخصی Expert را انتخاب میکند.
class ToyMoE(nn.Module): def __init__( self, input_dim=2, hidden_dim=16, num_experts=4, top_k=2, ): super().__init__() if not ( 1 <= top_k <= num_experts ): raise ValueError( "top_k must be between " "1 and num_experts" ) self.num_experts = ( num_experts ) self.top_k = top_k self.router = nn.Linear( input_dim, num_experts, ) self.experts = nn.ModuleList( [ SmallExpert( input_dim=input_dim, hidden_dim=hidden_dim, ) for _ in range(چند نکته مهم در این پیادهسازی:
- انتخاب
topkتعیین میکند کدام Expert محاسبه شود. - وزنهای
selected_weightsخروجی Expertهای انتخابشده را ترکیب میکنند. countsتعداد دفعات انتخاب هر Expert را نشان میدهد.importanceمیانگین احتمالهای Router پیش از انتخاب سخت Expertهاست.
انتخاب گسسته شناسه Expert مستقیماً مانند یک مقدار پیوسته مشتقپذیر نیست؛ اما وزنهای Router در مسیرهای انتخابشده و مؤلفه احتمالی مورد استفاده در مثال آموزش میبینند. مدلهای پژوهشی و تولیدی برای مسیریابی و توازن بار جزئیات بیشتری دارند.
ساخت طبقهبند باMoE
برای تبدیل خروجی لایه MoE به دو کلاس، یک لایه خروجی اضافه میکنیم:
class ToyMoEClassifier(nn.Module): def __init__( self, num_experts=4, top_k=2, ): super().__init__() self.moe = ToyMoE( input_dim=2, hidden_dim=16, num_experts=( num_experts ), top_k=top_k, ) self.classifier = ( nn.Linear( 2, 2, ) ) def forward(self, x): ( hidden, counts, importance, selected, ) = self.moe(x) logits = ( self.classifier( hidden )آموزش مدل و بررسی توازنRouter
در این نمونه، علاوه بر خطای طبقهبندی، یک جریمه آموزشی ساده برای دورشدن میانگین احتمالهایRouter از توزیع یکنواخت در نظر میگیریم.
این جریمه صرفاً آموزشی است؛ همان Loss مورد استفاده در همه مدلهای MoE نیست. همچنین یکنواختی احتمالهای میانگین، بهتنهایی یکنواختی تعداد انتخابهای سخت Expertها را تضمین نمیکند.
model = ToyMoEClassifier( num_experts=4, top_k=2,).to(device)optimizer = torch.optim.Adam( model.parameters(), lr=0.005,)for epoch in range(80): model.train() optimizer.zero_grad() ( logits, counts, importance, _, ) = model( train_features ) classification_loss = ( F.cross_entropy( logits, train_labels, ) ) target_importance = ( torch.full_like( importance, 1.0 / model.moe.num_experts,در این کد، توزیع انتخاب Expertها را در طول آموزش میبینید. اگر شمار انتخابها به هم نزدیک شود، هنوز نمیتوان نتیجه گرفت همه Expertها تخصص یکسان یا عملکرد مطلوب دارند؛ فقط یک جنبه از رفتار Router را مشاهده کردهاید.
ارزیابی مدل روی داده آزمون
model.eval()with torch.inference_mode(): ( test_logits, test_counts, test_importance, test_selected, ) = model( test_features ) predictions = ( test_logits .argmax(dim=-1) ) accuracy = ( ( predictions == test_labels ) .float() .mean() .item() )print( "Test accuracy:", round( accuracy, 4, ),)print(هر نمونه در این مثال به دو Expert فرستاده میشود. بنابراین مجموع test_counts برابر با دو برابر تعداد نمونههای آزمون خواهد بود.
شمارش پارامتر کل و پارامتر فعال در مثال
اکنون تعداد پارامترهای همه Expertها را با پارامترهایی که در مسیر یک نمونه استفاده میشوند مقایسه میکنیم:
total_parameters = sum( parameter.numel() for parameter in ( model.parameters() ))one_expert_parameters = sum( parameter.numel() for parameter in ( model.moe.experts[0] .parameters() ))router_parameters = sum( parameter.numel() for parameter in ( model.moe.router .parameters() ))classifier_parameters = sum( parameter.numel() for parameter in ( model.classifier .parameters() ))active_for_one_sample = ( router_parameters + classifier_parameters + model.moe.top_k * one_expert_parametersدر این مدل کوچک و مشخص، شمارش بالا سهم Router، طبقهبند و Expertهای انتخابشده را در نظر میگیرد. برای مدل زبانی واقعی، محاسبه پارامتر فعال باید تمام لایههای مشترک، Expertهای مشترک احتمالی و جزئیات معماری را نیز شامل شود.
همچنین اگر یک Batch بزرگ به همه Expertها توکن بفرستد، ممکن است همه Expertها در سطح آنBatch فعال شده باشند؛ «فعال برای یک توکن» با «استفادهشده در کل Batch» یکسان نیست.
آیا کد بالا از مدل Dense سریعتر است؟
هیچ چنین ادعایی از این مثال به دست نمیآید.
پیادهسازی ما در Python روی Expertها حلقه میزند و توکنها را جداگانه انتخاب میکند. برای مدل کوچک، سربار این کار ممکن است از صرفهجویی محاسباتی بیشتر باشد.
سامانههای بزرگ از روشهای تخصصی برای گروهبندی توکنها، اجرای موازی Expertها و انتقال داده استفاده میکنند. بنابراین هدف کد بالا آموزش سازوکار است، نه ارائه بنچمارک سرعت یا یک موتور استنتاج تولیدی.
آیا MoE به حافظه کمتر نیاز دارد؟
پاسخ به نوع حافظه و مقایسه موردنظر بستگی دارد.
از یک طرف، برای هر توکن فقط تعدادی Expert محاسبه میشوند. از طرف دیگر، وزن Expertهایی که ممکن است انتخاب شوند باید در سامانه در دسترس باشند.
بنابراین مدلی با پارامتر فعال کمتر از پارامتر کل، همچنان ممکن است برای نگهداری وزنهای کامل به منابع قابل توجهی نیاز داشته باشد.
اگر هدف شما اجرای مدل روی یک GPU مشخص است، این موارد را بررسی کنید:
- حجم وزنهای مدل در قالب واقعی ذخیرهسازی
- حافظه لازم برای بارگذاری و اجرای مدل
- تعداد GPUهای موردنیاز
- KV Cacheو طول زمینه
- تعداد درخواستهای همزمان
- قابلیت توزیع Expertها
- نوع Quantization پشتیبانیشده
عدد پارامتر فعال بهتنهایی برای تعیین امکان استقرار کافی نیست.
MoE و Quantizationرا میتوان ترکیب کرد؟
بله، بسته به پشتیبانی مدل و موتور اجرا میتوان وزنهای یک مدل MoE را با نمایش عددی کمدقتتر ذخیره یا اجرا کرد.
اما باید اثر ترکیب بر موارد زیر آزمایش شود:
- کیفیت پاسخ
- حافظه لازم برای وزنها
- سرعت Expertهای انتخابشده
- هزینه انتقال داده
- سازگاری کرنلهای اجرایی
برای آشنایی با روشهای کاهش دقت، مقاله Quantizationمدلهای هوش مصنوعی را ببینید.
تفاوت MoE و تقطیر دانش
Knowledge Distillation یا تقطیر دانش معمولاً به آموزش مدل دانشآموز با کمک اطلاعات مدل معلم اشاره دارد.
MoE معماریای با چند Expert و Router است.
این دو یک مسئله واحد نیستند. ممکن است یک مدل MoE نقش معلم را در آموزش مدل کوچکتر داشته باشد، اما خود معماری MoE به معنی تقطیر دانش نیست.
برای مطالعه بیشتر، مقاله تقطیر دانش در یادگیری ماشین را بخوانید.
آیا MoE برای فارسی بهتر از مدل Dense است؟
از روی معماری نمیتوان چنین نتیجهای گرفت.
کیفیت فارسی به عوامل زیادی وابسته است:
- داده آموزشی و سهم متن فارسی
- Tokenizer
- کیفیت تنظیم دستورپذیری
- توانایی استدلال و پیروی از دستور
- نوع وظیفه
- طول درخواست
- ارزیابی و بهینهسازی پس از آموزش
ممکن است یک مدل Dense در وظیفه فارسی مشخص از یک مدل MoE بهتر باشد یا برعکس. تنها راه معتبر، آزمون مدلهای واقعی روی مجموعه درخواستهای فارسی مرتبط با محصول است.
در انتخاب مدل MoE برای API به چه چیزهایی توجه کنیم؟
اگر قصد دارید از یک مدل آماده استفاده کنید، اندازه پارامتر کل و فعال فقط بخشی از اطلاعات تصمیمگیری است.
| معیار | پرسش عملی |
|---|---|
| کیفیت فارسی | آیا در متنهای واقعی کاربران پاسخ درست و روان میدهد؟ |
| پیروی از دستور | آیا قالب، محدودیت و هدف درخواست را رعایت میکند؟ |
| زمان پاسخ | نخستین توکن و پاسخ کامل چه زمانی میرسند؟ |
| هزینه | مصرف واقعی درخواستهای شما چقدر است؟ |
| طول زمینه | ورودی و خروجی موردنیاز در محدودیت مدل جا میشوند؟ |
| پایداری | عملکرد زیر بار و در زمانهای مختلف چگونه است؟ |
| قابلیتها | آیا ابزار، خروجی ساختاریافته یا ورودیهای موردنیاز را پشتیبانی میکند؟ |
نباید صرفاً از روی جمله «مدل MoE با صدها میلیارد پارامتر» درباره کیفیت یا سرعت نتیجه گرفت.
ارزیابی منصفانه MoE وDense
برای مقایسه دو مدل، درخواستهای یکسان و معیارهای روشن داشته باشید.
یک مجموعه ارزیابی فارسی میتواند شامل موارد زیر باشد:
- پرسشهای ساده کاربران
- درخواستهای چندمرحلهای
- خلاصهسازی متن بلند
- استخراج داده از متن
- تولید پاسخ با قالب مشخص
- پاسخ مبتنی بر منابع ارائهشده
- تولید کد
- اصطلاحات حوزه تخصصی محصول
سپس برای هر مدل، کیفیت، زمان پاسخ و هزینه را ثبت کنید.
اگر یک مدل پاسخ بلندتری میدهد، مقایسه زمان کل بدون توجه به تعداد توکن خروجی ممکن است ناعادلانه باشد. هم زمان کل و هم سرعت تولید را گزارش کنید.
مقاله ارزیابی مدلهای هوش مصنوعی برای طراحی مجموعه ارزیابی کاربردی مفید است.
محدودیتهای MoE در آموزش
آموزش MoE میتواند با دشواریهایی همراه باشد:
فروپاشی مسیریابی
Router ممکن است بخش زیادی از توکنها را به تعداد کمی Expertبفرستد.
کمآموزشماندن Expertها
اگر Expertی بهندرت انتخاب شود، داده و گرادیان کمتری برای یادگیری دریافت میکند.
هزینه ارتباط میان دستگاهها
توزیع Expertها روی چند GPU میتواند انتقال داده قابل توجهی ایجاد کند.
پیچیدگی پیادهسازی
گروهبندی توکنها، مدیریت ظرفیت و ترکیب خروجیها باید درست و کارآمد انجام شود.
دشواری تحلیل
اینکه یک Expert دقیقاً چه «دانشی» دارد، از روی شماره Expert یا چند نمونه مسیریابی روشن نمیشود.
این چالشها به معنای نامناسببودن MoE نیستند؛ نشان میدهند مزیت معماری به کیفیت طراحی و اجرای آن وابسته است.
اشتباهات رایج درباره مدلهایMoE
یکی دانستن پارامتر فعال و اندازه فایل
ممکن است در هر توکن فقط بخشی از Expertها فعال شوند، ولی وزن تمام Expertها همچنان بخشی از مدل است.
فرض اینکه هر Expert یک مهارت انسانی مشخص دارد
این ادعا بدون تحلیل تجربی قابل اتکا نیست.
فرض اینکه MoE همیشه سریعتر از Dense است
ارتباط میان دستگاهها، پیادهسازی Router و اندازه Batch میتوانند نتیجه را تغییر دهند.
تصور اینکه فقط Expertها اجرا میشوند
لایههای مشترک مدل نیز در مسیر پردازش قرار دارند.
استفاده از پارامتر فعال بهعنوان تنها معیار هزینه
هزینه واقعی شامل محاسبه، حافظه، انتقال داده و ظرفیت سرویس است.
یکسان دانستن MoE با انتخاب مدل در سطحAPI
Routerدرونی مدل با مسیریابی درخواست به چند مدل مستقل تفاوت دارد.
ارزیابی کیفیت فقط با نام معماری
MoE یا Denseبودن، کیفیت پاسخ فارسی، دقت یا پیروی از دستور را تعیین نمیکند.
نتیجهگیری از یک نمونه PyTorch کوچک درباره مدلهای زبانی بزرگ
مثال آموزشی مسیریابی را نشان میدهد، نه پیچیدگی کامل زیرساخت تولیدی را.
پرسشهای متداول
MoEچیست؟
MoE یا Mixture of Experts معماریای است که چند Expert دارد و Router تعیین میکند کدام Expertها برای ورودی یا توکن فعال شوند.
Expert در MoEچیست؟
Expert بخش قابلآموزشی از شبکه است که ورودیهای انتخابشده را پردازش میکند. در بسیاری از مدلهای زبانی، Expertها در بخشهای Feed-Forwardقرار دارند.
Routerچیست؟
Router بخش تصمیمگیرندهای است که برای Expertها امتیاز میسازد و مسیر پردازش ورودی را تعیین میکند.
پارامتر فعال یعنی چه؟
پارامترهایی که در مسیر محاسبه یک توکن به کار میروند. این عدد میتواند از تعداد کل پارامترهای مدل MoE کمتر باشد.
آیا MoE حافظه کمتری از مدل Dense میخواهد؟
الزاماً نه. پاسخ به مدل مقایسهشونده و شیوه نگهداری و توزیع وزن Expertها بستگی دارد.
آیا MoE همیشه پاسخ سریعتری میدهد؟
خیر. زمان واقعی به Router، کرنلهای Expert، انتقال داده، بار همزمان و سختافزار وابسته است.
Top-k Routingچیست؟
روشی است که در آن برای هر ورودی، k Expertدارای امتیاز بالاتر انتخاب میشوند.
چرا توازن بار مهم است؟
اگر بیشتر توکنها به چند Expert محدود فرستاده شوند، آن Expertها شلوغ و Expertهای دیگر کماستفاده میشوند. این وضعیت میتواند آموزش و اجرا را دشوار کند.
آیا MoE همان استفاده از چند مدل هوش مصنوعی است؟
خیر. MoE معمولاً به Expertهای درونی یک مدل اشاره دارد. انتخاب میان چند مدل مستقل در سطح برنامه یا API مفهوم دیگری است.
MoEبرای زبان فارسی بهتر است؟
برتری عمومی ندارد. باید مدلهای مشخص را روی درخواستهای فارسی واقعی و با معیارهای کیفیت، زمان و هزینه مقایسه کرد.
جمعبندی
مدل MoE چند Expert و یک سازوکار مسیریابی دارد. Router مشخص میکند کدام Expertها برای هر ورودی یا توکن فعال شوند. در نتیجه، تعداد کل پارامترهای مدل میتواند بسیار بیشتر از پارامترهای فعال در مسیر یک توکن باشد.
این معماری امکان طراحی مدلهایی با ظرفیت پارامتری زیاد و فعالسازی انتخابی را فراهم میکند، اما اجرای آن به مدیریت دقیق حافظه، انتقال داده، توازن بار و زمانبندی نیاز دارد. عدد پارامتر فعال بهتنهایی درباره سرعت، هزینه یا کیفیت پاسخ کافی نیست.
اگر میخواهید برای یک محصول فارسی مدل انتخاب کنید، MoE و Dense را با مجموعه درخواستهای واقعی خود مقایسه کنید. در darvareh.ir مدلها و API درواره را بررسی کنید و کیفیت پاسخ، زمان اجرا و هزینه هر گزینه را پیش از انتخاب نهایی بسنجید.
مقالات مرتبط
- مدل زبانی بزرگ یا LLM چیست؟
- معماری Transformer وAttention
- مسیریابی مدلهای هوش مصنوعی
- تقطیر دانش در یادگیری ماشین
- Quantizationمدل هوش مصنوعی
- آموزشPyTorch
- ارزیابی مدلهای هوش مصنوعی
- آموزش استفاده از API هوش مصنوعی
منابع
- Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
- معرفی رسمی Mixtral of Experts توسطMistral AI
- DeepSeek-V3 Technical Report
- مستندات Expert Parallelism درHugging Face Transformers
- مستندات مدل Mixtral درHugging Face Transformers
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی مدل و سرویس موردنظر و صفحه سلب مسئولیت درواره را مطالعه کنید.



